Spark 安裝部署與快速上手
Spark 介紹
核心概念
Spark 是 UC Berkeley AMP lab 開發的一個集群計算的框架,類似於 Hadoop,但有很多的區別。
最大的優化是讓計算任務的中間結果可以存儲在記憶體中,不需要每次都寫入 HDFS,更適用於需要迭代的 MapReduce 演算法場景中,可以獲得更好的性能提升。
例如一次排序測試中,對 100TB 數據進行排序,Spark 比 Hadoop 快三倍,並且只需要十分之一的機器。
Spark 集群目前最大的可以達到 8000 節點,處理的數據達到 PB 級別,在互聯網企業中應用非常廣泛。
Spark 的特性
Hadoop 的核心是分散式文件系統 HDFS 和計算框架 MapReduces。Spark 可以替代 MapReduce,並且兼容 HDFS、Hive 等分散式存儲層,良好的融入 Hadoop 的生態系統。
Spark 執行的特點
- 中間結果輸出:Spark 將執行工作流抽象為通用的有向無環圖執行計劃(DAG),可以將多 Stage 的任務串聯或者並行執行。
- 數據格式和記憶體布局:Spark 抽象出分散式記憶體存儲結構彈性分散式數據集 RDD,能夠控制數據在不同節點的分區,用戶可以自定義分區策略。
- 任務調度的開銷:Spark 採用了事件驅動的類庫 AKKA 來啟動任務,通過執行緒池的復用執行緒來避免系統啟動和切換開銷。
Spark 的優勢
- 速度快,運行工作負載快 100 倍。Apache Spark 使用最先進的 DAG 調度器、查詢優化器和物理執行引擎,實現了批處理和流數據的高性能。
- 易於使用,支援用 Java、Scala、Python、R 和 SQL 快速編寫應用程式。Spark 提供了超過 80 個運算元,可以輕鬆構建並行應用程式。您可以從 Scala、Python、R 和 SQL shell 中互動式地使用它。
- 普遍性,結合 SQL、流處理和複雜分析。Spark 提供了大量的庫,包括 SQL 和 DataFrames、用於機器學習的 MLlib、GraphX 和 Spark 流。您可以在同一個應用程式中無縫地組合這些庫。
- 各種環境都可以運行,Spark 在 Hadoop、Apache Mesos、Kubernetes、單機或雲主機中運行。它可以訪問不同的數據源。您可以使用它的獨立集群模式在 EC2、Hadoop YARN、Mesos 或 Kubernetes 上運行 Spark。訪問 HDFS、Apache Cassandra、Apache HBase、Apache Hive 和數百個其他數據源中的數據。
哪些公司在使用 Spark
日常為我們所熟知的,在國外就有 IBM Almaden(IBM 研究實驗室)、Amazon(亞馬遜)等,而在中國有 baidu(百度)、Tencent(騰訊)等等,包括一些其它的公司大部分都使用 Spark 來處理生產過程中產生的大量數據。更多詳情可以參考鏈接: 誰在使用 Spark?
2.3 Spark 生態系統 BDAS
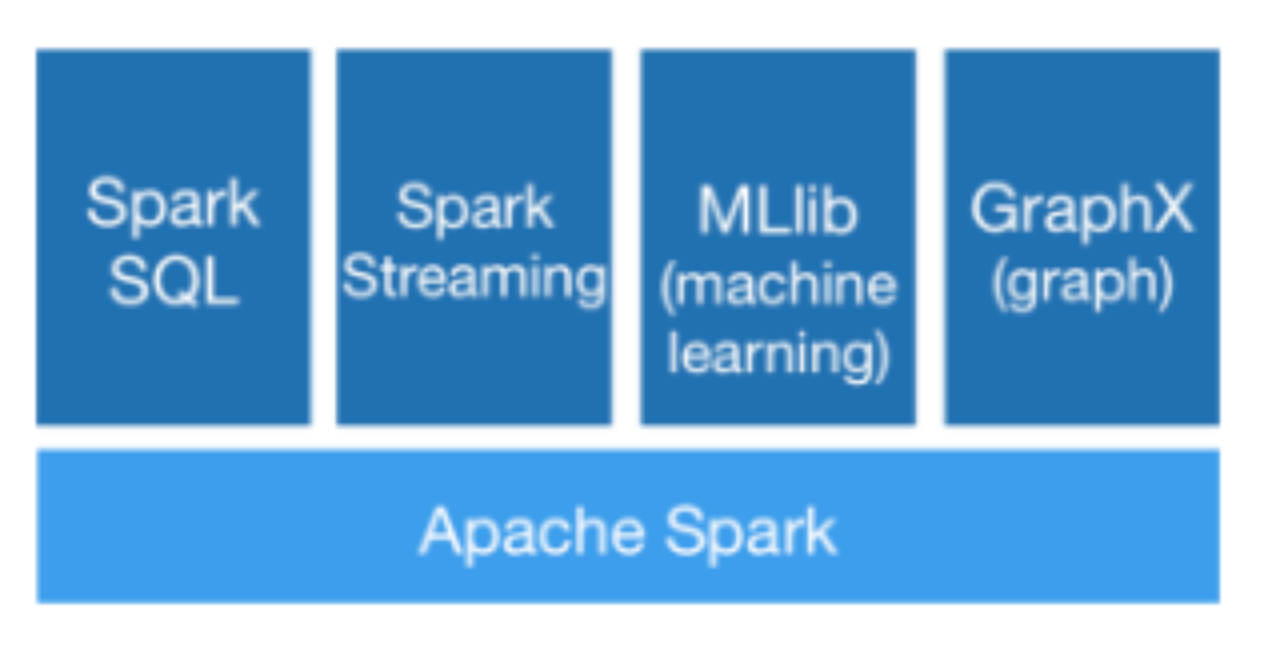
目前,Spark 已經發展成為包含眾多子項目的大數據計算平台。
BDAS 是伯克利大學提出的基於 Spark 的數據分析棧(BDAS)。
其核心框架是 Spark,同時涵蓋支援結構化數據 SQL 查詢與分析的查詢引擎 Spark SQL,提供機器學習功能的系統 MLBase 及底層的分散式機器學習庫 MLlib,並行圖計算框架 GraphX,流計算框架 Spark Streaming,近似查詢引擎 BlinkDB,記憶體分散式文件系統 Tachyon,資源管理框架 Mesos 等子項目。這些子項目在 Spark 上層提供了更高層、更豐富的計算範式。
部署前準備
Spark 安裝非常簡單,簡單到只需要下載 binary 包解壓即可
安裝 Spark 之前需要先安裝 Java,Scala 及 Python。
- java 1.8.0
- scala 2.11.8
- python 2.7
安裝Java
下載
參考清華軟體源://mirrors.tuna.tsinghua.edu.cn/AdoptOpenJDK/
wget wget //mirrors.tuna.tsinghua.edu.cn/AdoptOpenJDK/8/jdk/x64/linux/OpenJDK8U-jdk_x64_linux_openj9_linuxXL_8u282b08_openj9-0.24.0.tar.gz --no-check-certificate
按需求下載之後記得修改環境變數
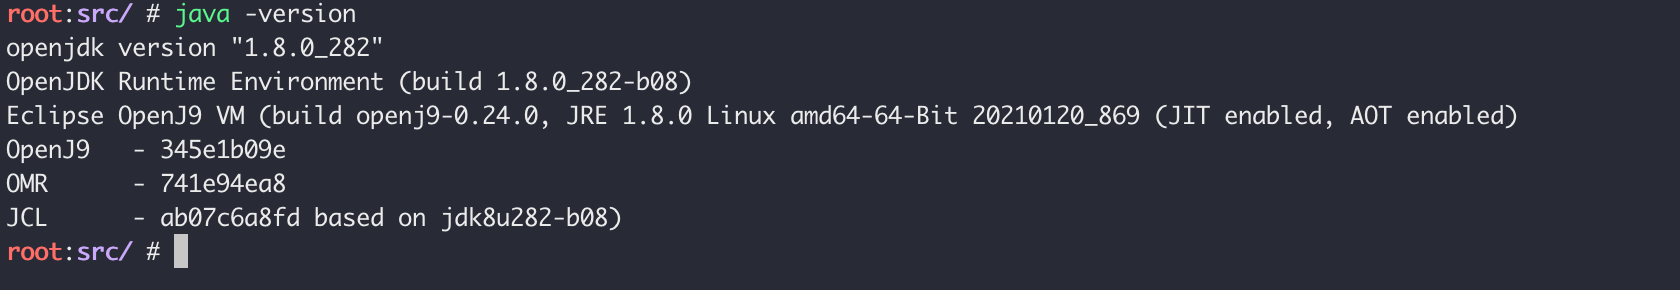
記得配置環境變數,添加 bin 目錄即可
安裝Scala
下載
wget //downloads.lightbend.com/scala/2.11.8/scala-2.11.8.tgz
記得配置環境變數,添加 bin 目錄即可
安裝Python
一般系統自帶 Python2
python --version
如果需要 Python3 可以自行下載
yum -y install python3
Spark 下載
此處使用的是:Spark 2.4.8
官網上下載已經預編譯好的 Spark binary,直接解壓即可。
Spark 官方下載鏈接://spark.apache.org/downloads.html
下載
參考
wget //mirrors.huaweicloud.com/apache/spark/spark-2.4.4/spark-2.4.4-bin-hadoop2.7.tgz
記得配置環境變數,添加 bin 目錄即可
部署模式介紹
Spark on Mesos未嘗試過,大家可以自行嘗試
本文僅介紹 Standalone 模式和 Spark on Yarn模式
按照自己需求配合!
本地模式
Spark單機運行,直接解壓執行start-all.sh即可,一般用於開發測試
Standalone 模式
構建一個由Master+Slave構成的Spark集群,Spark運行在集群中。
即獨立模式,自帶完整的服務,可單獨部署到一個集群中,無需依賴任何其他資源管理系統。
從一定程度上說,該模式是其他兩種的基礎。借鑒 Spark 開發模式,我們可以得到一種開發新型計算框架的一般思路:先設計出它的 standalone 模式,為了快速開發,起初不需要考慮服務(比如 master/slave)的容錯性,之後再開發相應的 wrapper,將 stanlone 模式下的服務原封不動的部署到資源管理系統 yarn 或者 mesos 上,由資源管理系統負責服務本身的容錯。目前 Spark 在 standalone 模式下是沒有任何單點故障問題的,這是藉助 zookeeper 實現的,思想類似於 Hbase master 單點故障解決方案。將 Spark standalone 與 MapReduce 比較,會發現它們兩個在架構上是完全一致的:
- 都是由 master/slaves 服務組成的,且起初 master 均存在單點故障,後來均通過 zookeeper 解決(Apache MRv1 的 JobTracker 仍存在單點問題,但 CDH 版本得到了解決);
- 各個節點上的資源被抽象成粗粒度的 slot,有多少 slot 就能同時運行多少 task。不同的是,MapReduce 將 slot 分為 map slot 和 reduce slot,它們分別只能供 Map Task 和 Reduce Task 使用,而不能共享,這是 MapReduce 資源利率低效的原因之一,而 Spark 則更優化一些,它不區分 slot 類型,只有一種 slot,可以供各種類型的 Task 使用,這種方式可以提高資源利用率,但是不夠靈活,不能為不同類型的 Task 訂製 slot 資源。總之,這兩種方式各有優缺點。
Spark on Yarn 模式
Spark客戶端直接連接Yarn。不需要額外構建Spark集群。
這是一種很有前景的部署模式。但限於 YARN 自身的發展,目前僅支援粗粒度模式(Coarse-grained Mode)。
這是由於 YARN 上的 Container 資源是不可以動態伸縮的,一旦 Container 啟動之後,可使用的資源不能再發生變化,不過這個已經在 YARN 計劃中了。
spark on yarn 的支援兩種模式:
- yarn-cluster:適用於生產環境;
- yarn-client:適用於交互、調試,希望立即看到 app 的輸出
yarn-cluster 和 yarn-client 的區別在於 yarn appMaster,每個 yarn app 實例有一個 appMaster 進程,是為 app 啟動的第一個 container;負責從 ResourceManager 請求資源,獲取到資源後,告訴 NodeManager 為其啟動 container。
yarn-cluster 和 yarn-client 模式內部實現還是有很大的區別。
如果你需要用於生產環境,那麼請選擇 yarn-cluster;而如果你僅僅是 Debug 程式,可以選擇 yarn-client。
Spark on Mesos 模式
Spark客戶端直接連接Mesos。不需要額外構建Spark集群。
這是很多公司採用的模式,官方推薦這種模式(當然,原因之一是血緣關係)。
正是由於 Spark 開發之初就考慮到支援 Mesos,因此,目前而言,Spark 運行在 Mesos 上會比運行在 YARN 上更加靈活,更加自然。
目前在 Spark On Mesos 環境中,用戶可選擇兩種調度模式之一運行自己的應用程式(可參考 Andrew Xia 的「Mesos Scheduling Mode on Spark」):
-
粗粒度模式(Coarse-grained Mode):每個應用程式的運行環境由一個 Dirver 和若干個 Executor 組成,其中,每個 Executor 佔用若干資源,內部可運行多個 Task(對應多少個「slot」)。
應用程式的各個任務正式運行之前,需要將運行環境中的資源全部申請好,且運行過程中要一直佔用這些資源,即使不用,最後程式運行結束後,回收這些資源。舉個例子,比如你提交應用程式時,指定使用 5 個 executor 運行你的應用程式,每個 executor 佔用 5GB 記憶體和 5 個 CPU,每個 executor 內部設置了 5 個 slot,則 Mesos 需要先為 executor 分配資源並啟動它們,之後開始調度任務。
另外,在程式運行過程中,mesos 的 master 和 slave 並不知道 executor 內部各個 task 的運行情況,executor 直接將任務狀態通過內部的通訊機制彙報給 Driver,從一定程度上可以認為,每個應用程式利用 mesos 搭建了一個虛擬集群自己使用。
-
細粒度模式(Fine-grained Mode):鑒於粗粒度模式會造成大量資源浪費,Spark On Mesos 還提供了另外一種調度模式:細粒度模式,這種模式類似於現在的雲計算,思想是按需分配。
與粗粒度模式一樣,應用程式啟動時,先會啟動 executor,但每個 executor 佔用資源僅僅是自己運行所需的資源,不需要考慮將來要運行的任務,之後,mesos 會為每個 executor 動態分配資源,每分配一些,便可以運行一個新任務,單個 Task 運行完之後可以馬上釋放對應的資源。
每個 Task 會彙報狀態給 Mesos slave 和 Mesos Master,便於更加細粒度管理和容錯,這種調度模式類似於 MapReduce 調度模式,每個 Task 完全獨立,優點是便於資源控制和隔離,但缺點也很明顯,短作業運行延遲大。
總結
這三種分散式部署方式各有利弊,通常需要根據實際情況決定採用哪種方案。
進行方案選擇時,往往要考慮公司的技術路線(採用 Hadoop 生態系統還是其他生態系統)、相關技術人才儲備等。上面涉及到 Spark 的許多部署模式,究竟哪種模式好這個很難說,需要根據你的需求,如果你只是測試 Spark Application,你可以選擇 local 模式。而如果你數據量不是很多,Standalone 是個不錯的選擇。當你需要統一管理集群資源(Hadoop、Spark 等),那麼你可以選擇 Yarn 或者 mesos,但是這樣維護成本就會變高。
- 從對比上看,mesos 似乎是 Spark 更好的選擇,也是被官方推薦的
- 但如果你同時運行 hadoop 和 Spark,從兼容性上考慮,Yarn 是更好的選擇。
- 如果你不僅運行了 hadoop,spark。還在資源管理上運行了 docker,Mesos 更加通用。
- Standalone 對於小規模計算集群更適合!
Standalone 模式
Standalone 另可分兩種子模式:
- 單機
- 集群
當然,集群部署的前提是單機的部署完成,根據自己的需求調整即可
單機部署
Spark 雖然是大規模的計算框架,但也支援在單機上運行
修改配置文件
進入 Spark 配置目錄
cd $SPARK_HOME/conf
日誌配置
創建/複製
cp log4j.properties.template log4j.properties
我們修改 log4j.rootCategory 的 「INFO」修改為「WARN」,這一步是修改日誌等級,可避免測試中輸出太多資訊

spark-env.sh
創建/複製
cp spark-env.sh.template spark-env.sh
添加HOME 變數:JAVA_HOME、SPARK_HOME、SCALA_HOME
考慮我們已經添加至環境變數文件里了,所以我們刷新配置的環境文件即可
spark-env.sh腳本會在啟動 Spark 時載入,內容包含很多配置選項及說明,在以後會用到少部分,感興趣可以仔細閱讀這個文件的注釋內容。
啟動Spark 服務
這一節將啟動 Spark 的 master 主節點和 slave 從節點
也會介紹 spark 單機模式和集群模式的部署區別
啟動主節點
前往sbin 目錄
cd $SPARK_HOME/sbin
啟動
./start-master.sh

沒有報錯的話表示 master 已經啟動成功
master 默認可以通過 web 訪問//localhost:8080
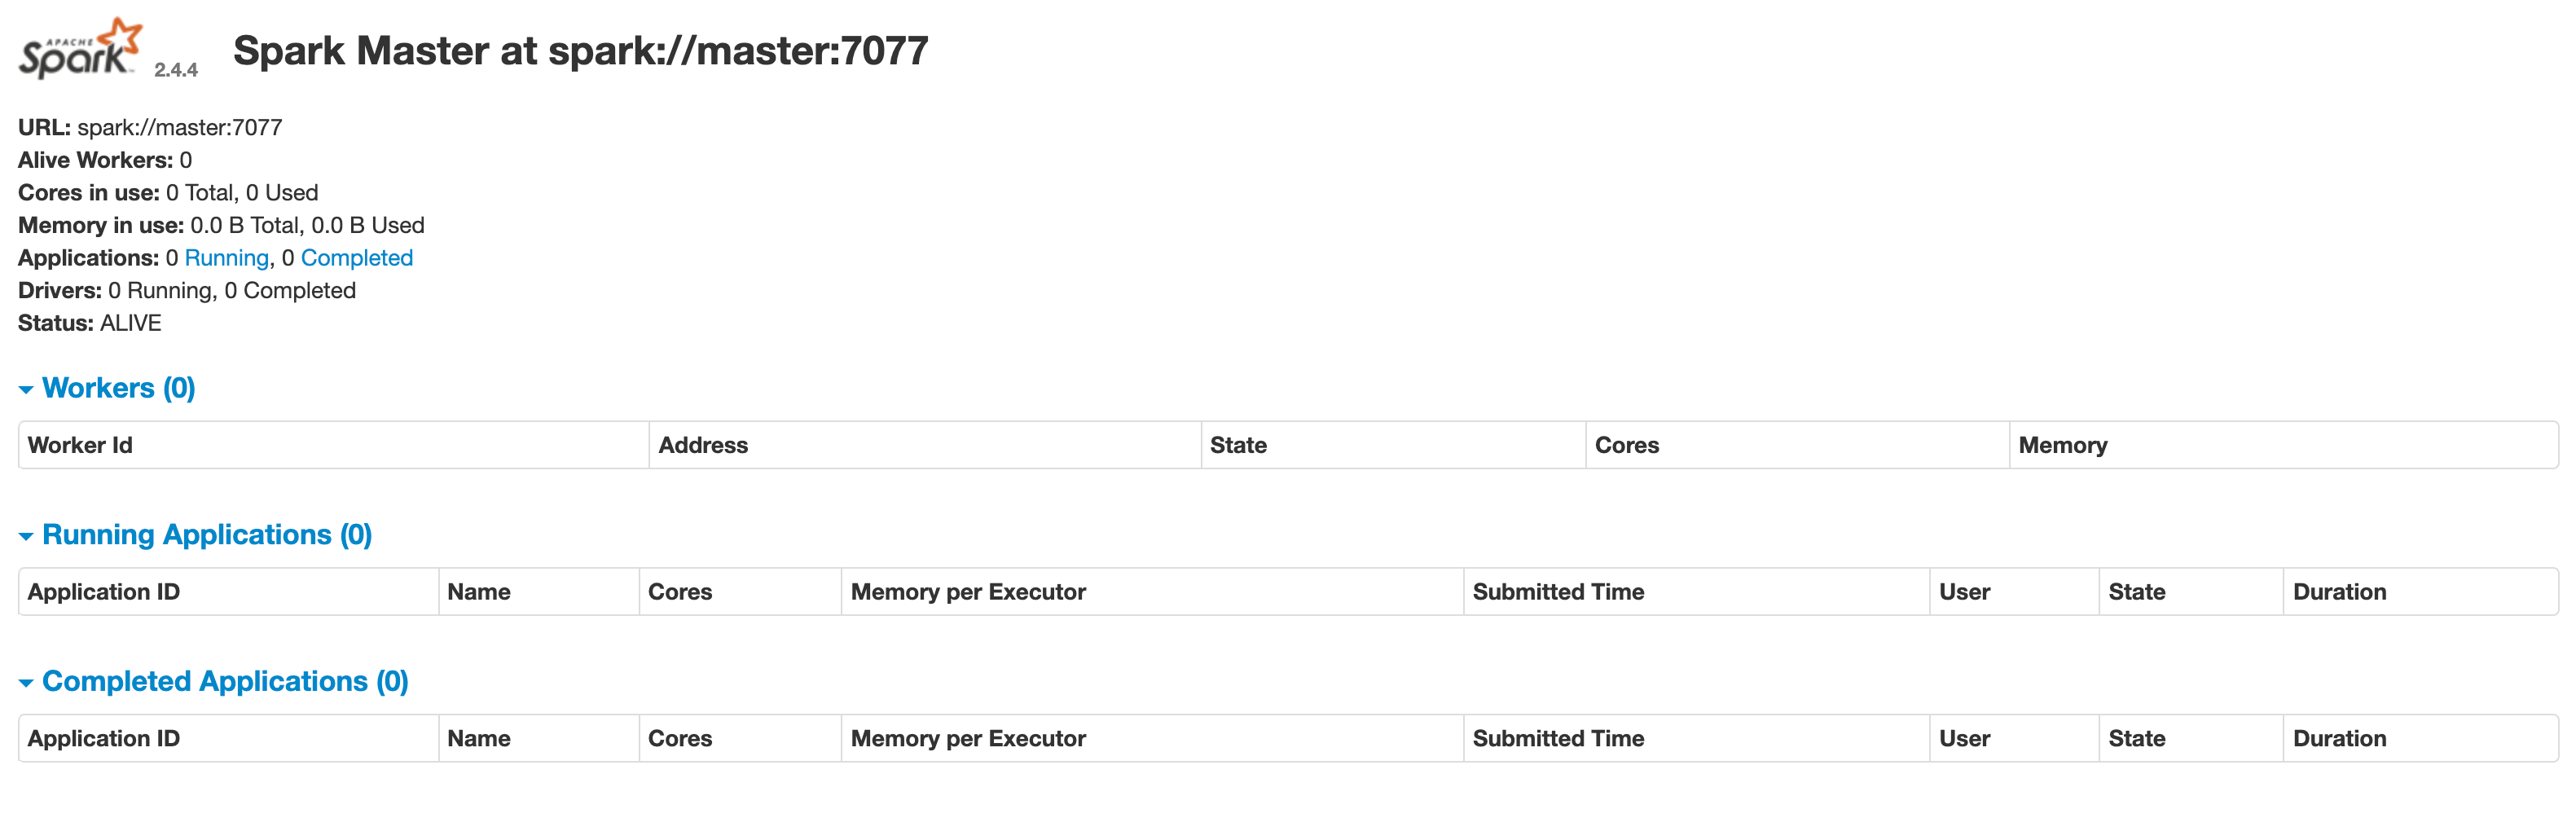
圖中所示,master 中暫時還沒有一個 worker ,我們啟動 worker 時需要 master 的參數,該參數已經在上圖中標誌出來:spark://master:7077,請在執行後續命令時替換成你自己的參數。
啟動從節點
啟動 slave
./start-slave.sh spark://master:7077

沒有報錯表示啟動成功,再次刷新瀏覽器頁面可以看到下圖所示新的 worker 已經添加
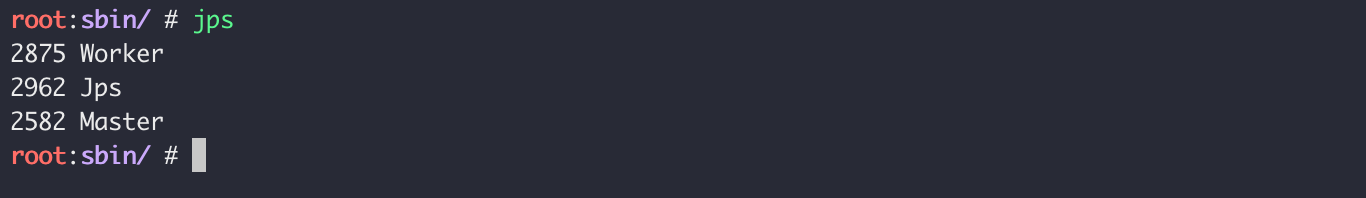
也可以用jps命令查看啟動的服務,應該會列出Master和Worker。
測試實例
使用 spark-shell 連接 master ,注意把 MASTER 參數替換成你實驗環境中的實際參數
MASTER=spark://master:7077 spark-shell
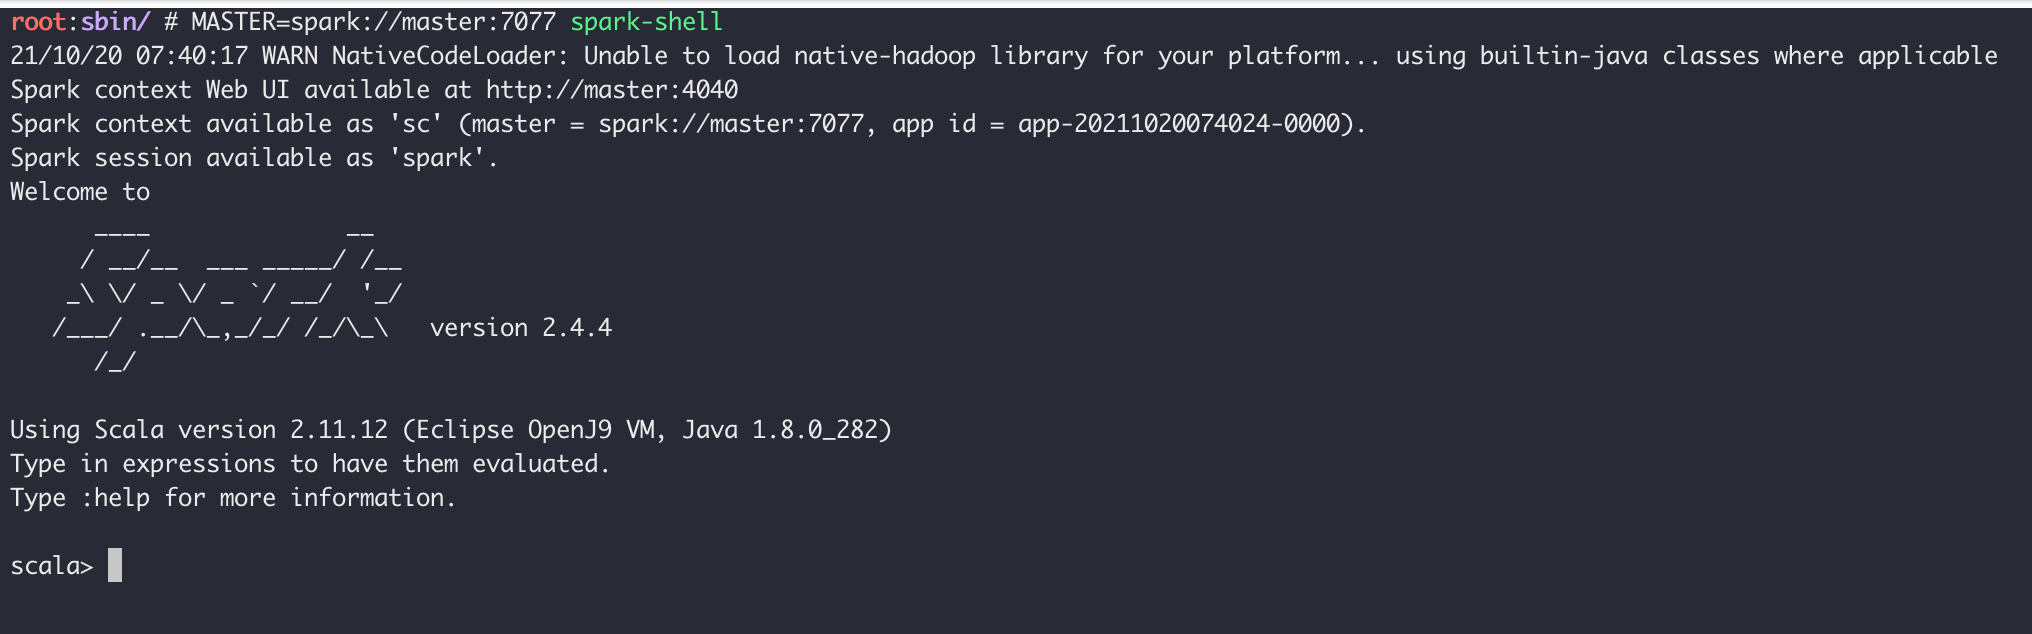
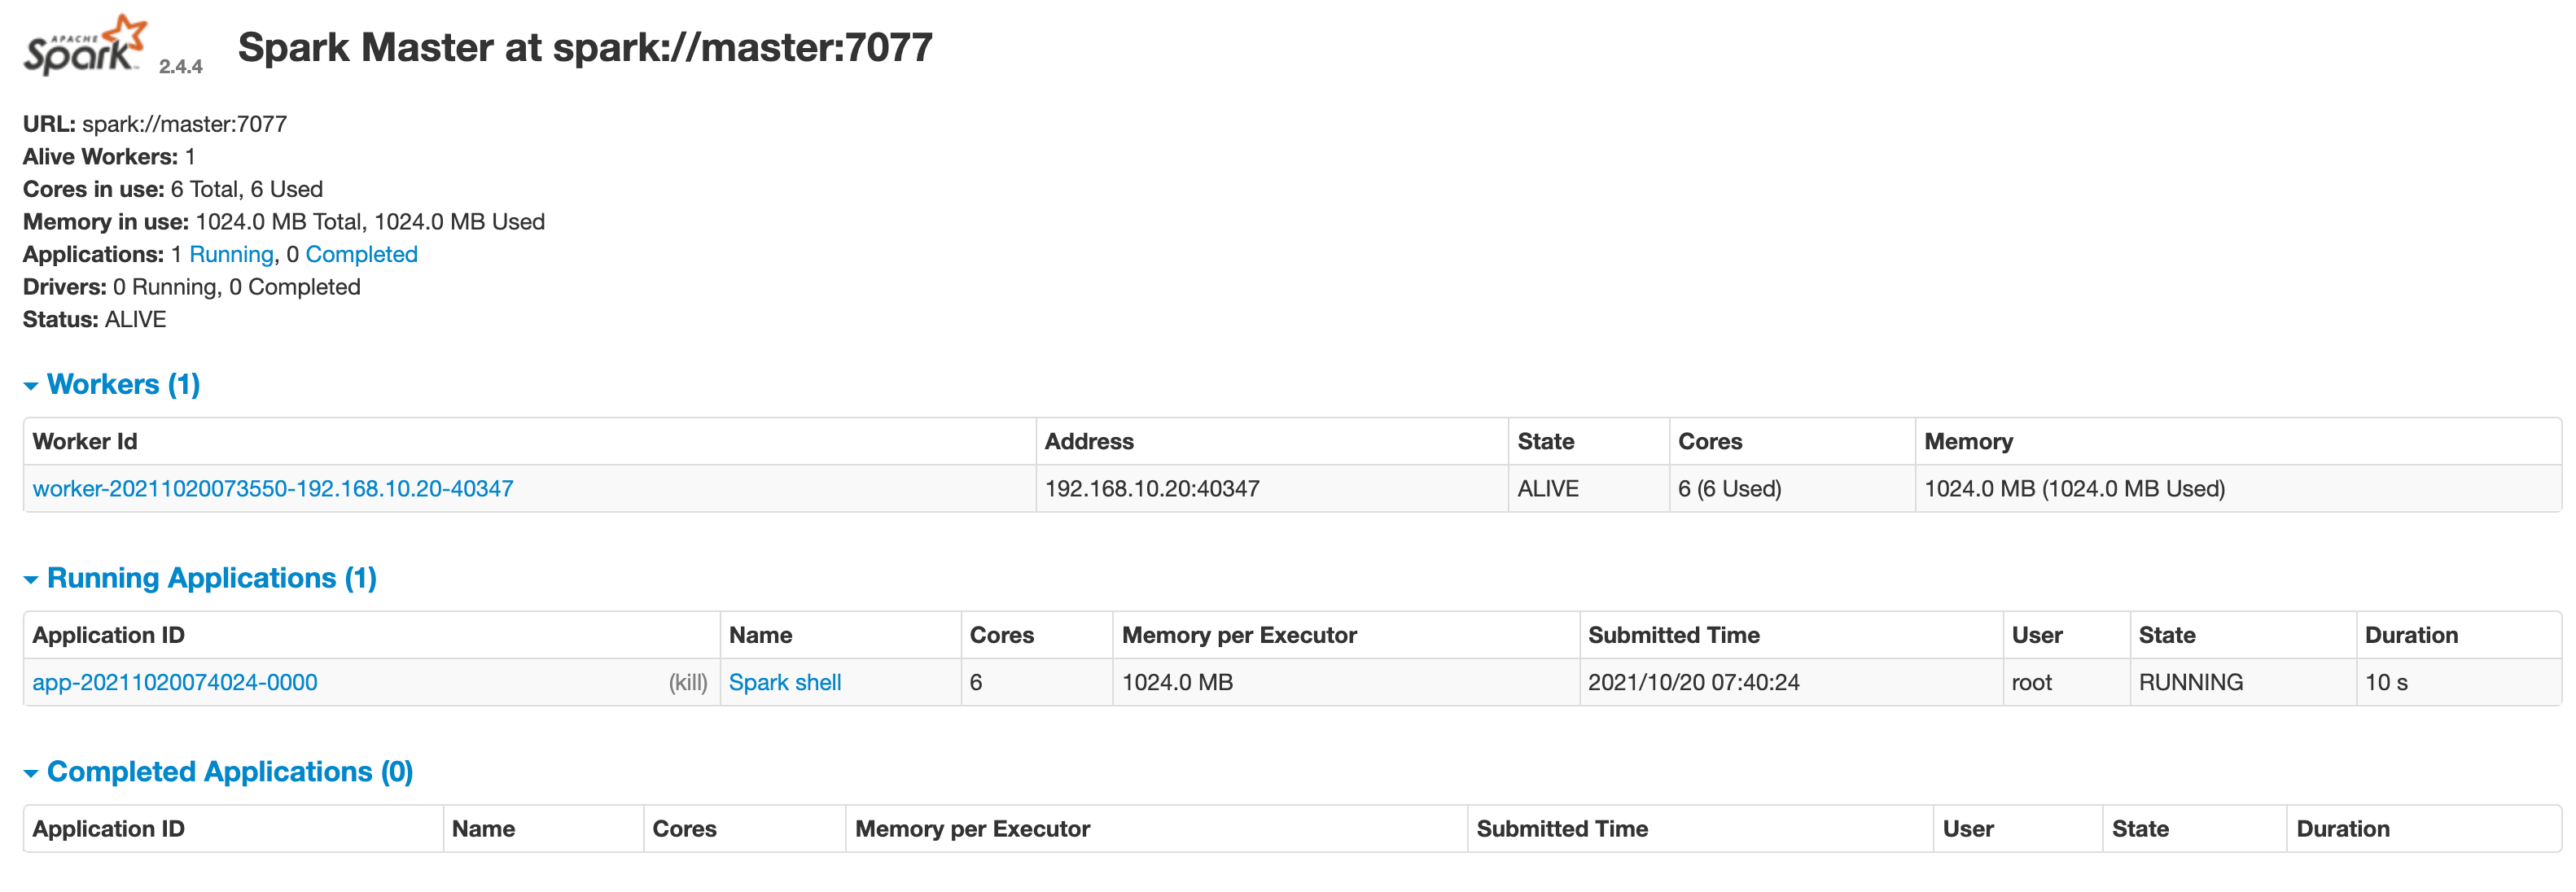
刷新 master 的 web 頁面,可以看到新的Running Applications,如下圖所示:
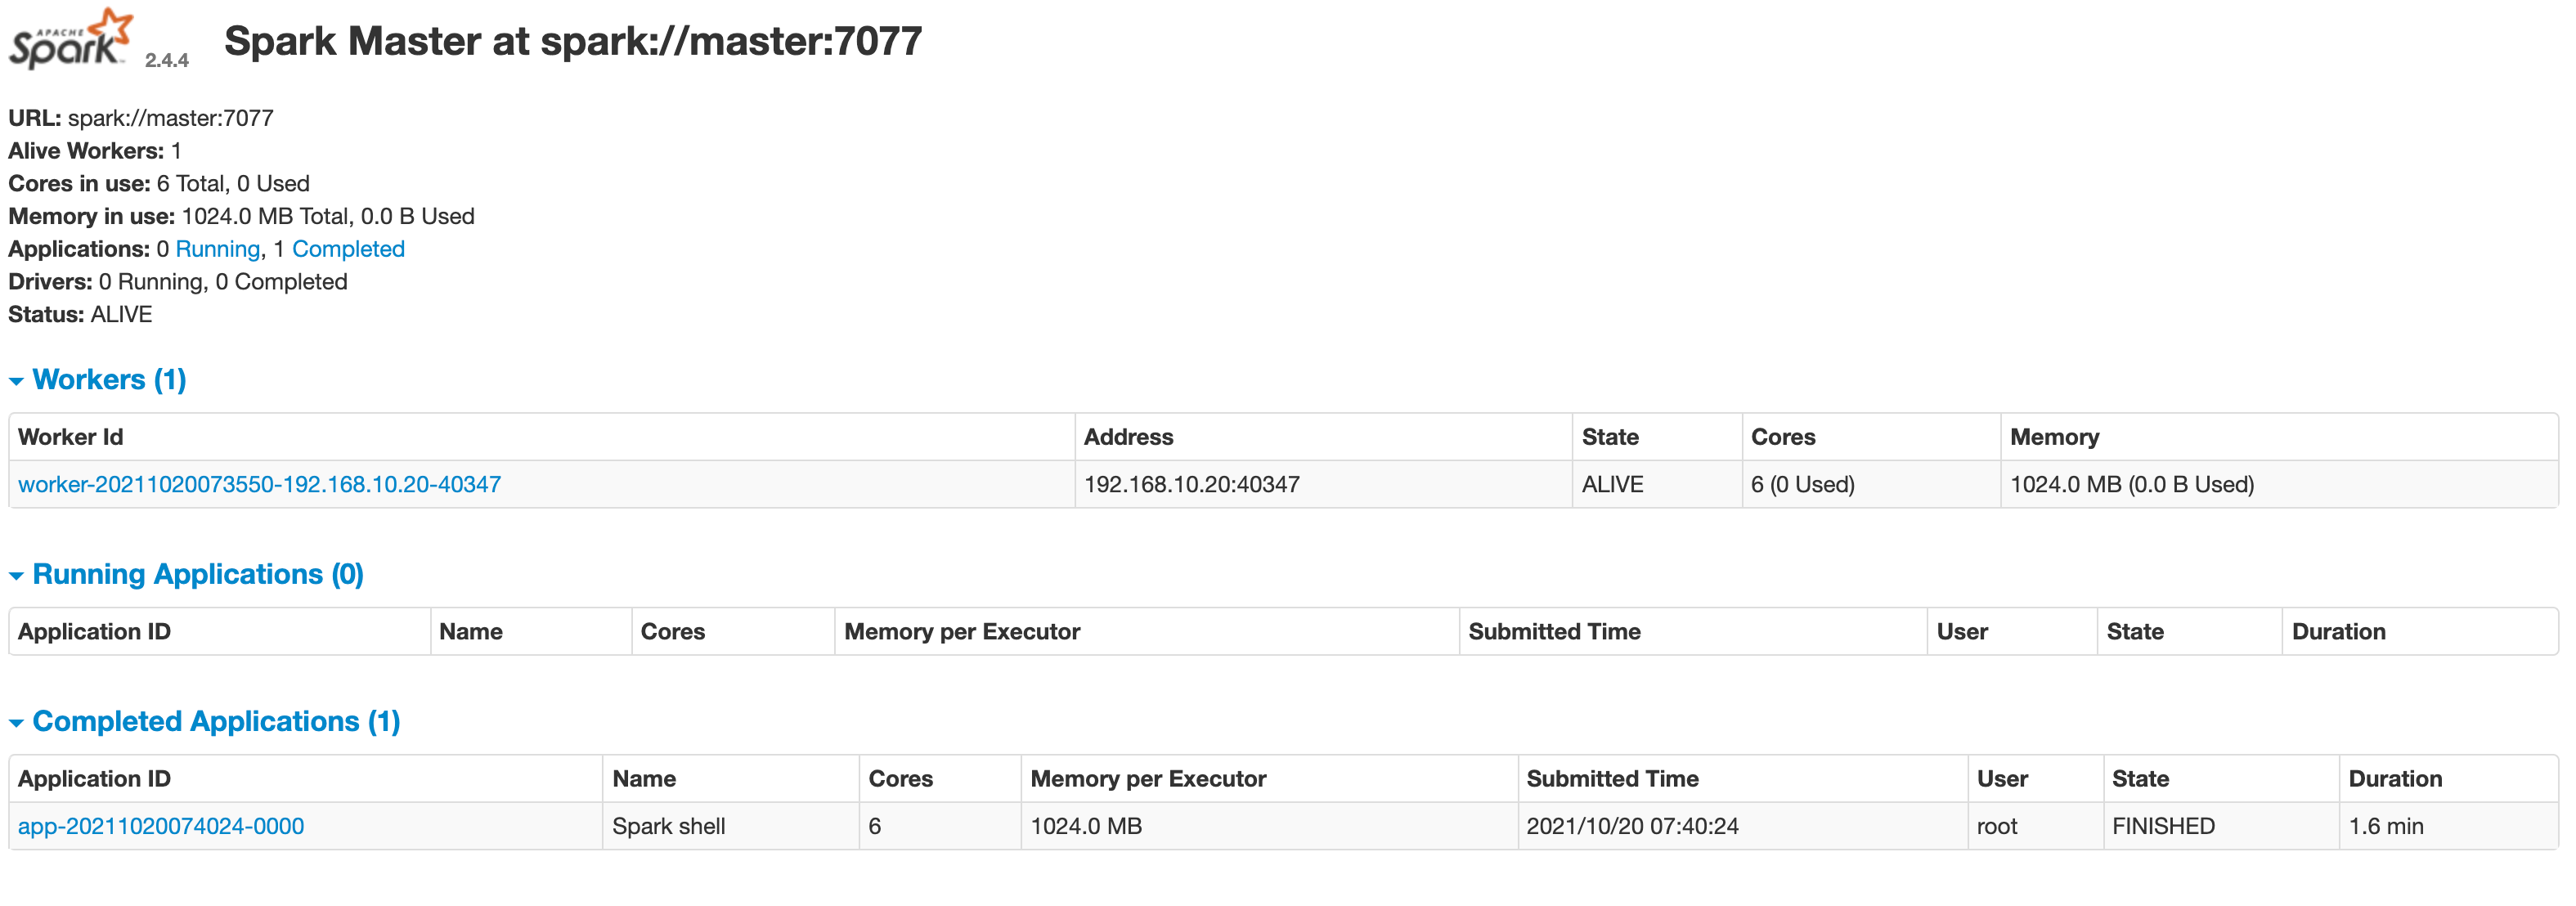
當退出 spark-shell 時,這個 application 會移動到Completed Applications一欄。
可以自己點擊頁面中的 Application 和 Workers 的鏈接查看並了解相關資訊。
停止服務
停止服務的腳本為./sbin/stop-all.sh。
./stop-all.sh
但我建議依次關閉
./stop-master.sh
./stop-slave.sh
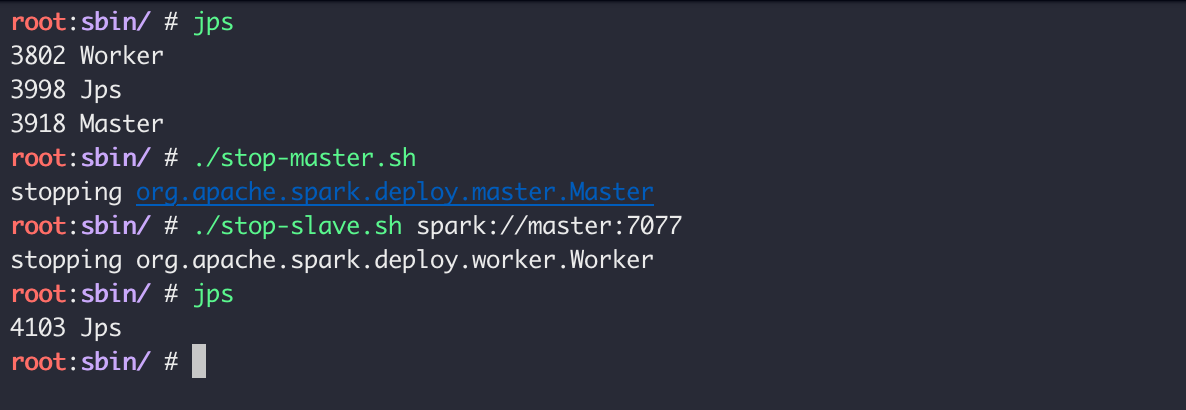
通過 jps 可以看到,master 與 worker 進程都已經停止
集群部署
修改配置
在 「單機模式」小節下的「修改配置文件」的基礎上進行添加/修改
進入 Spark 配置目錄
cd $SPARK_HOME/conf
spark-env.sh
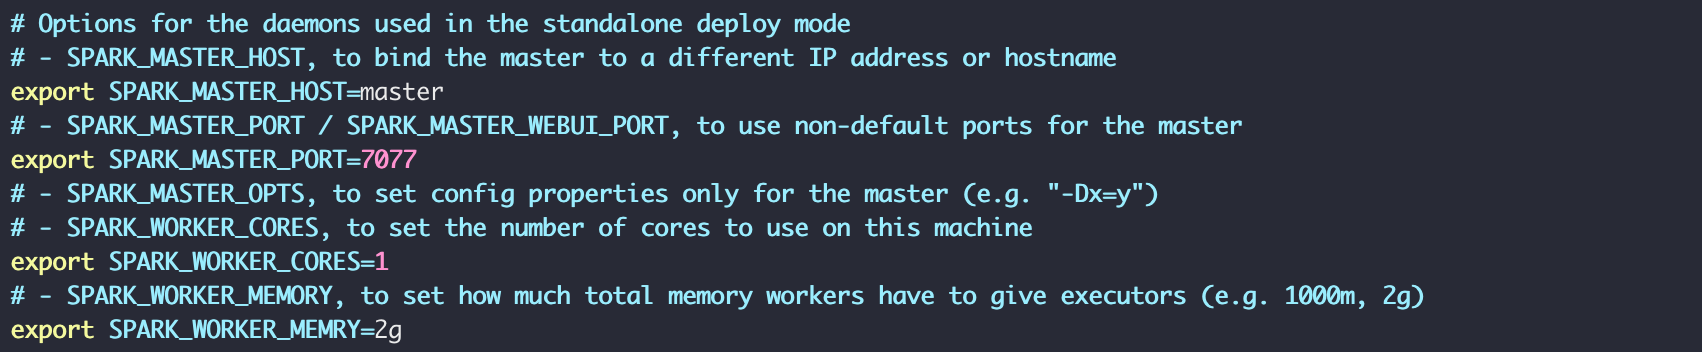
參數解讀:
- SPARK_MASTER_HOST = Master的主機名
- SPARK_MASTER_PORT = 提交Application的埠,默認7077,可更改
- SPARK_WORKER_CORES = 每一個Worker最多可以使用的cpu核個數
- SPARK_WORKER_MEMORY = 每個Worker最多可以使用的記憶體
其實你完全可以參考spark-env.sh內的注釋
編輯
vim spark-env.sh
做出如下修改(位置非固定):
slaves
修改 slaves 配置文件,添加 Worker 的主機列表
複製/創建
cp slaves.template slaves
修改localhost 為你需要的機器的 HostName
你可以參考我的:
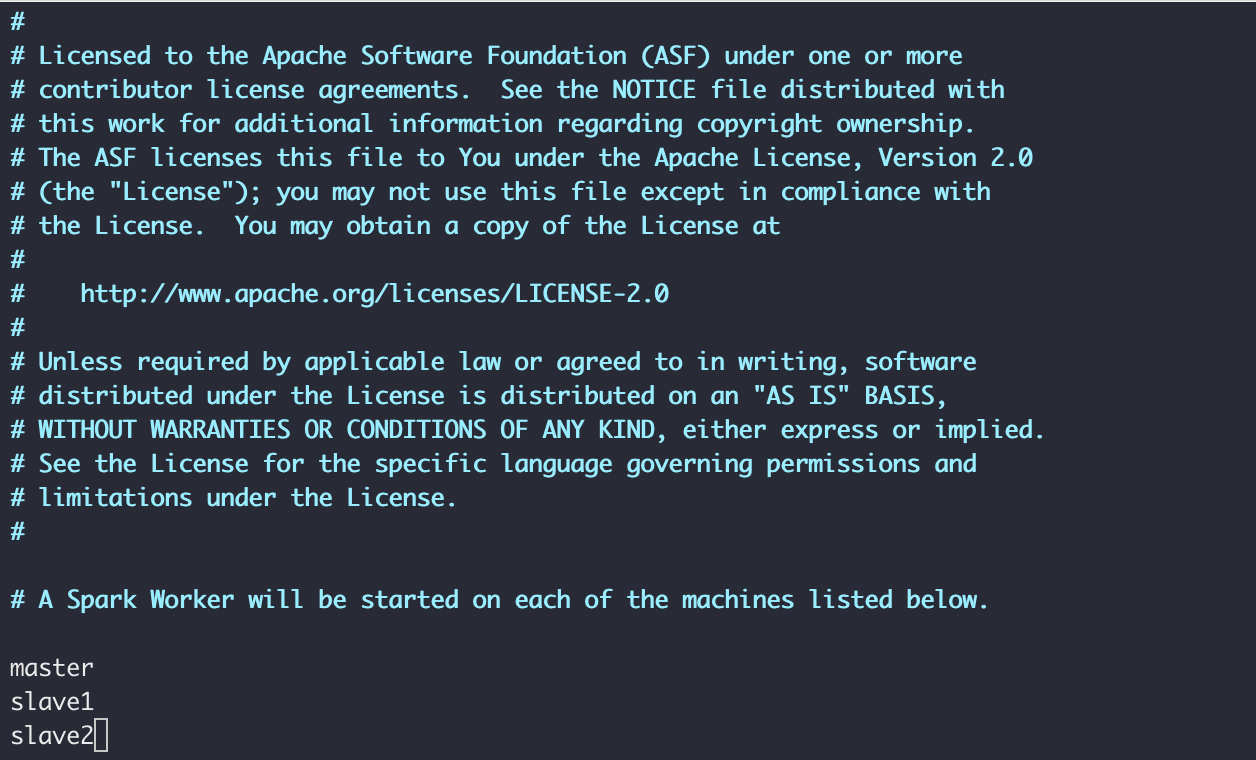
注意需要先把所有主機名輸入到 /etc/hosts 避免無法解析
同步
此處不進行贅述,具體操作大家自行搜索,或者查看我關於 「HADOOP部署」的相關文章
大致操作如下:
- ssh-keygen 命令配合 ssh-copy-id 命令實現ssh免密
- scp 命令同步所有設置(指Spark 下的 conf 文件下,或者同步 Spark 文件)
啟動集群
前往 master 機器下執行
前往sbin 目錄
cd $SPARK_HOME/sbin
在這台機啟動集群
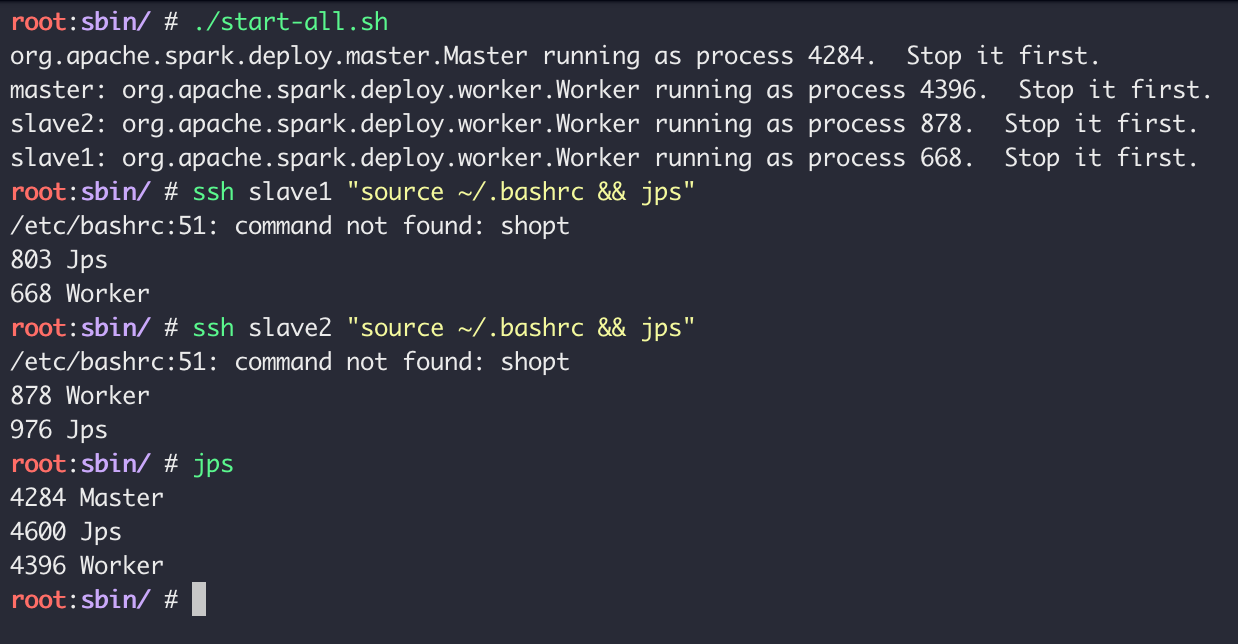
./start-all.sh
啟動的步驟和「單機部署」下的「啟動 Spark 服務」一致,關閉也一致
start-all.sh 和 start-master.sh、start-slave.sh 和 Hadoop 里的 start-all.sh、start-yarn.sh、start-dfs.sh 的關係大致一樣
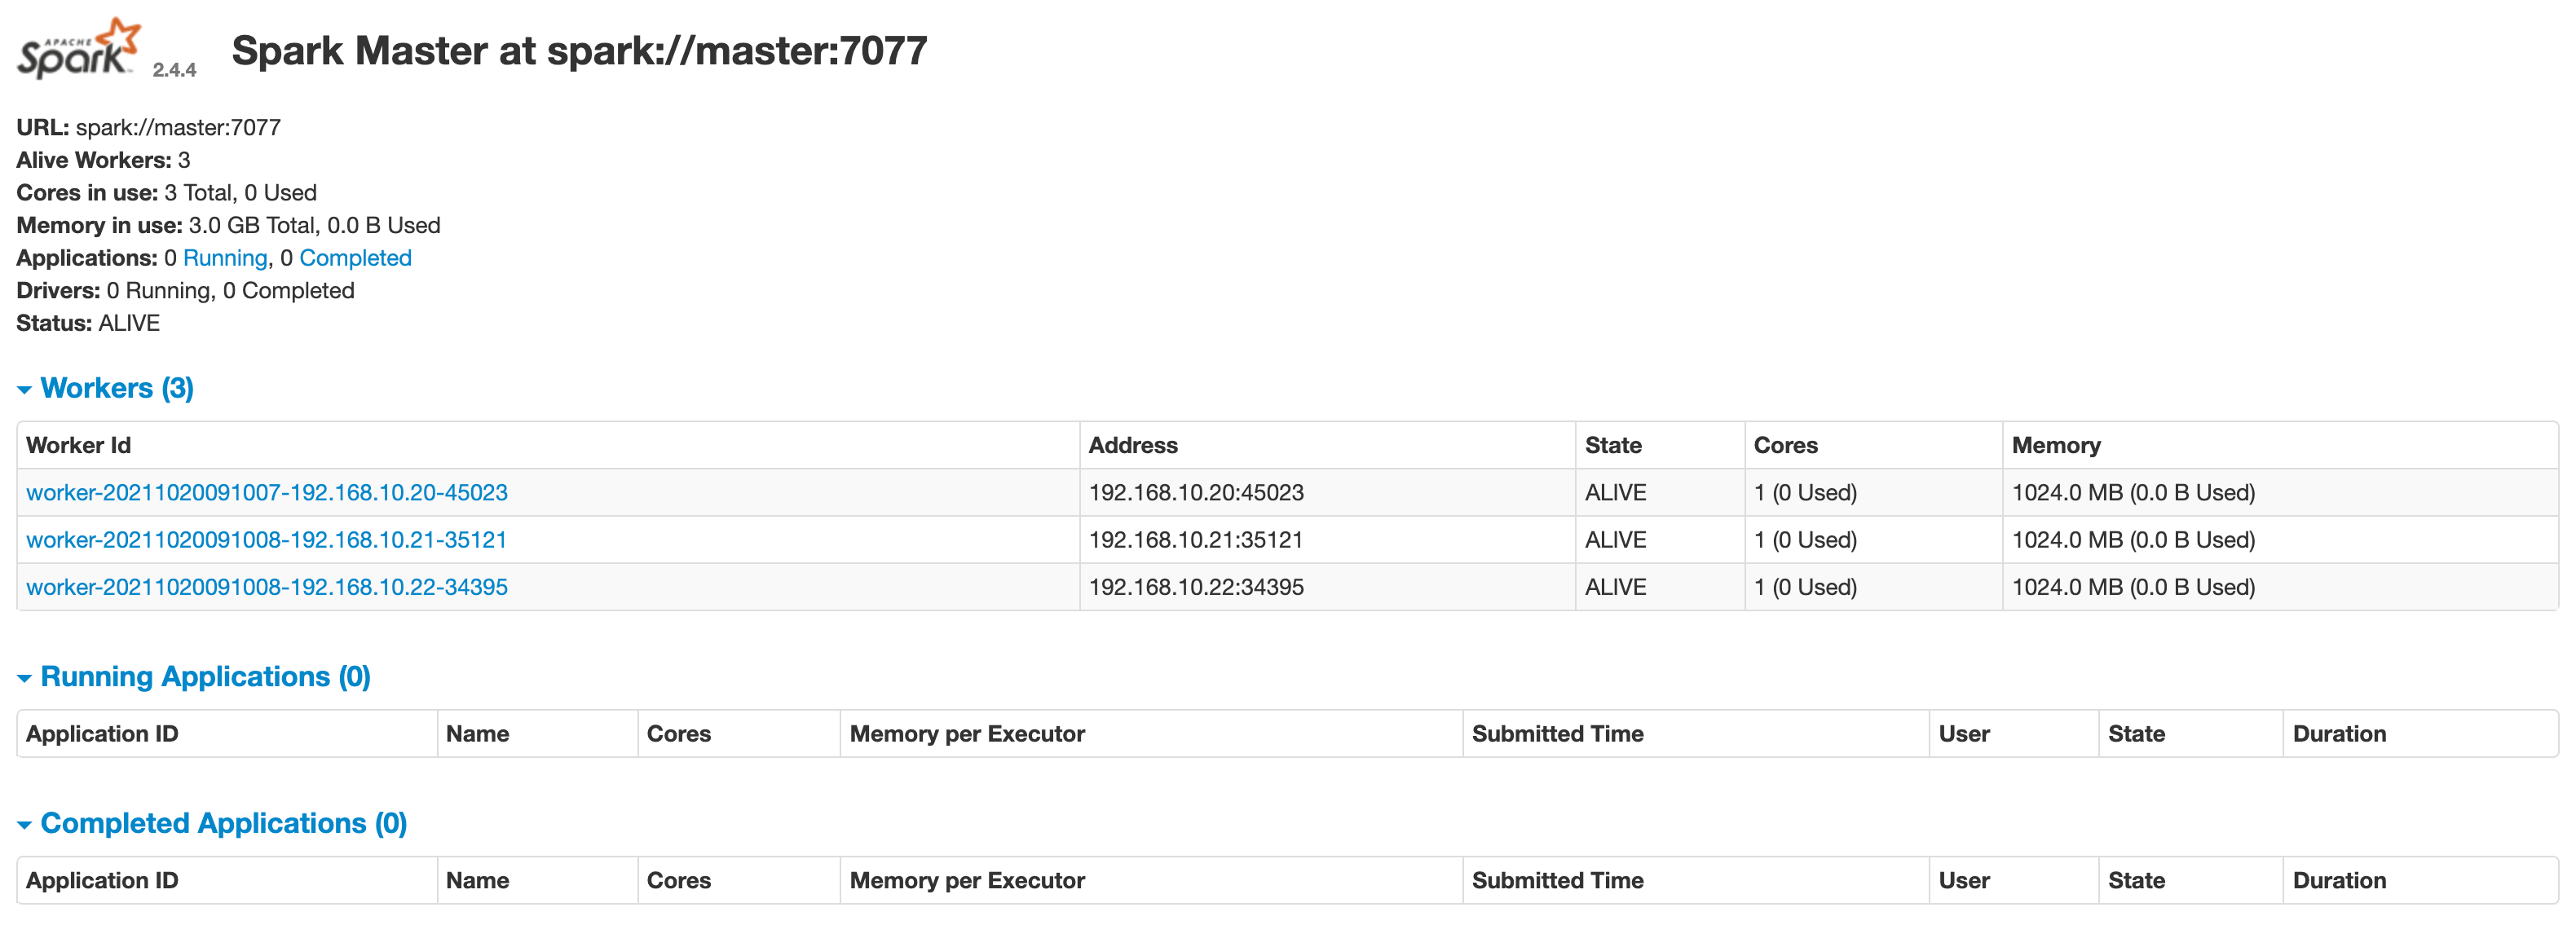
Web:
Spark 互動式執行
Spark-Shell
Spark-Shell是 Spark 自帶的一個 Scala 交互 Shell ,可以以腳本方式進行互動式執行,類似直接用 Python 及其他腳本語言的 Shell 。
進入Spark-Shell只需要執行spark-shell即可:
spark-shell
(前提是你配置好了 Spark 的環境變數)
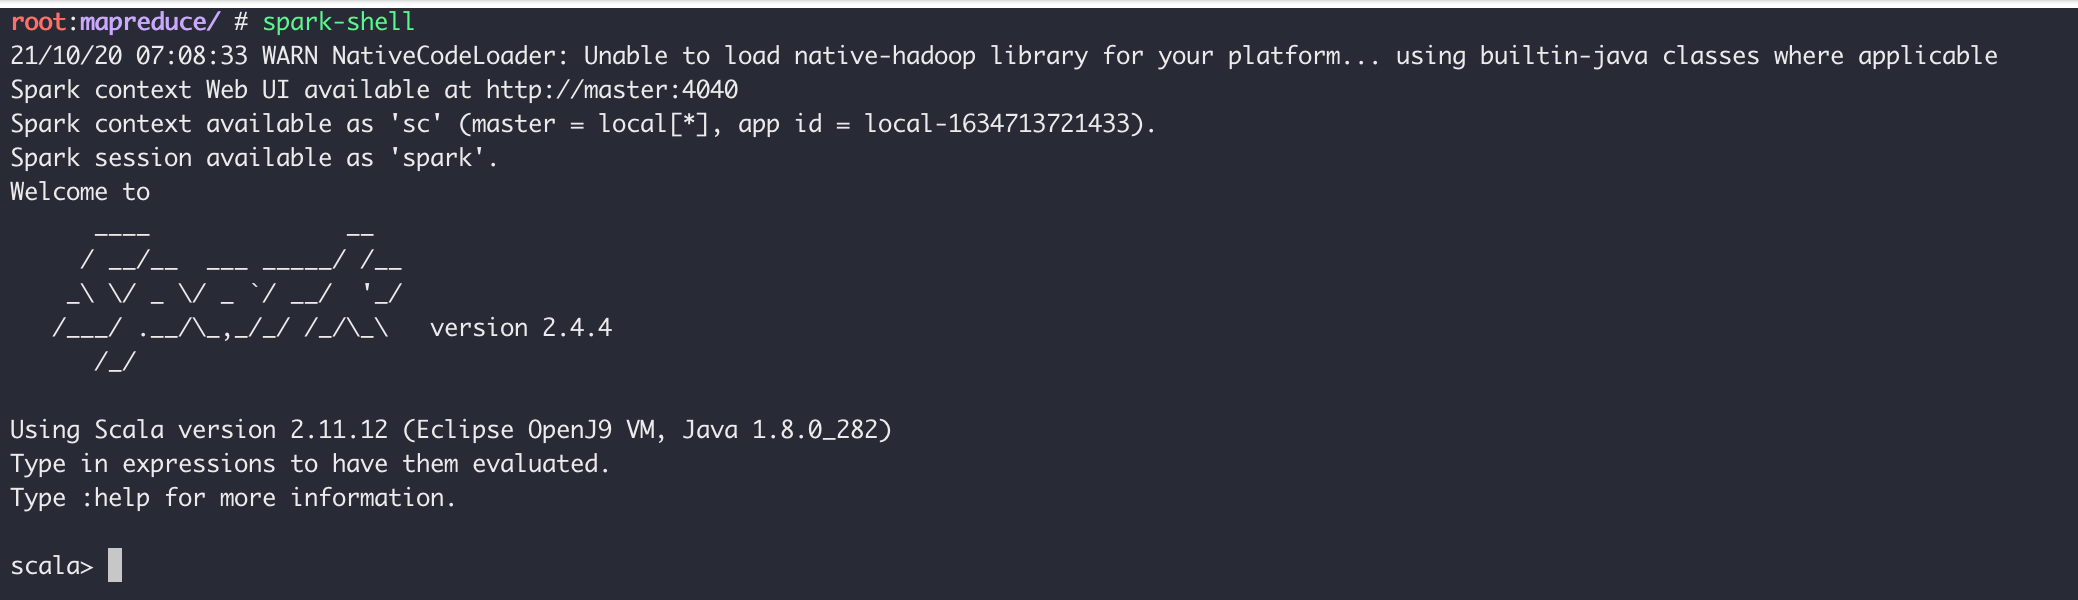
進入到Spark-Shell後可以使用Ctrl D組合鍵退出 Shell。
在Spark-Shell中我們可以使用 Scala 的語法進行簡單的測試,比如我們運行下面幾個語句獲得文件/etc/protocols的行數以及第一行的內容:
var f = sc.textFile("/etc/protocols")
f.count()
f.first()
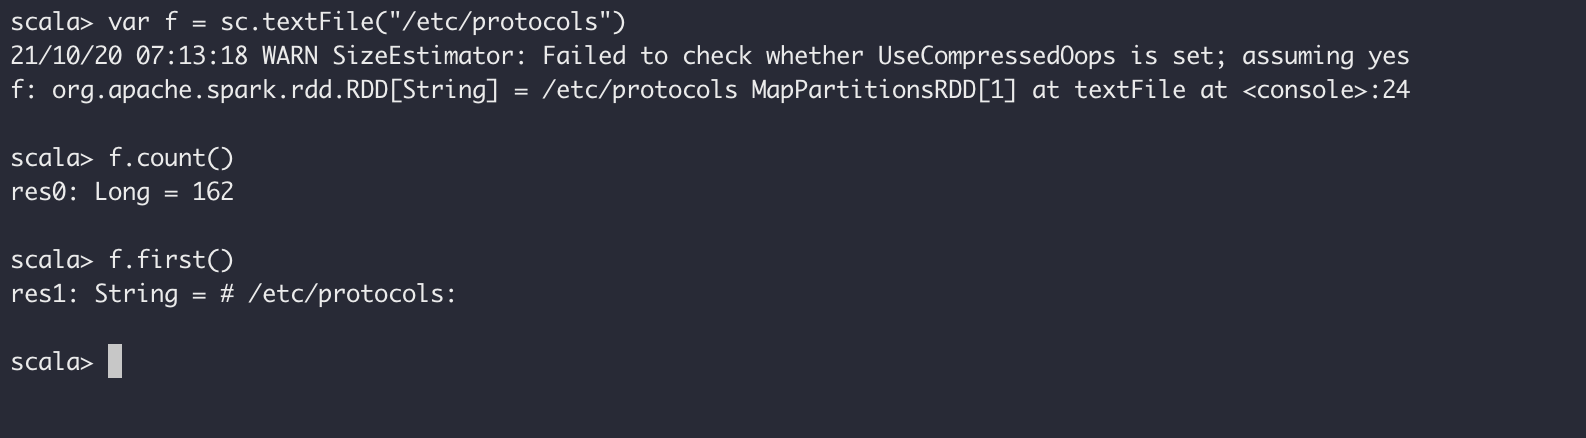
上面的操作中創建了一個 RDD file,執行了兩個簡單的操作:
count()獲取 RDD 的行數first()獲取第一行的內容
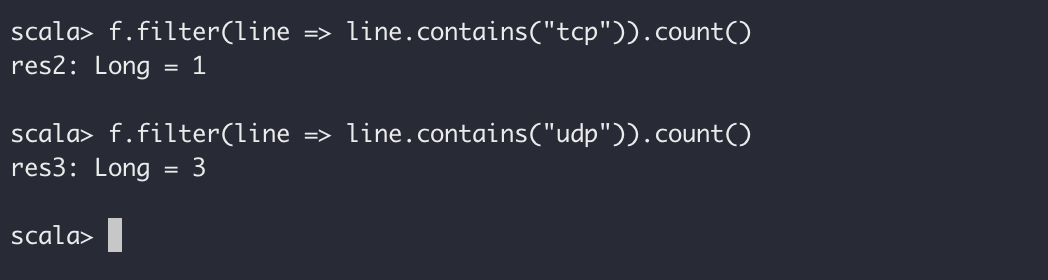
我們繼續執行其他操作,比如查找有多少行含有tcp和udp字元串:
f.filter(line => line.contains("tcp")).count()
f.filter(line => line.contains("udp")).count()
查看一共有多少個不同單詞的方法,這裡用到 Mapreduce 的思路:
var wordcount = file.flatMap(line => line.split(" ")).map(word => (word,1)).reduceByKey(_+_)

wordcount.count()
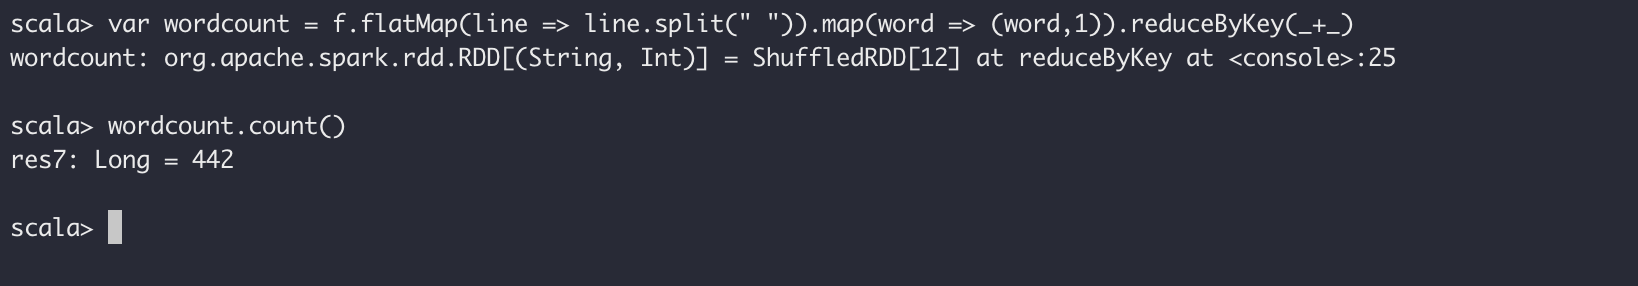
上面兩步驟我們發現,/etc/protocols中各有一行含有tcp與udp字元串,並且一共有 442 個不同的單詞。
上面每個語句的具體含義這裡不展開,可以結合你閱讀的文章進行理解,這裡僅僅提供一個簡單的例子讓大家對 Spark 運算有基本認識。
操作完成後,Ctrl D組合鍵退出 Shell。
Pyspark
Pyspark 類似 Spark-Shell ,是一個 Python 的交互 Shell 。
執行pyspark啟動進入 Pyspark:
pyspark
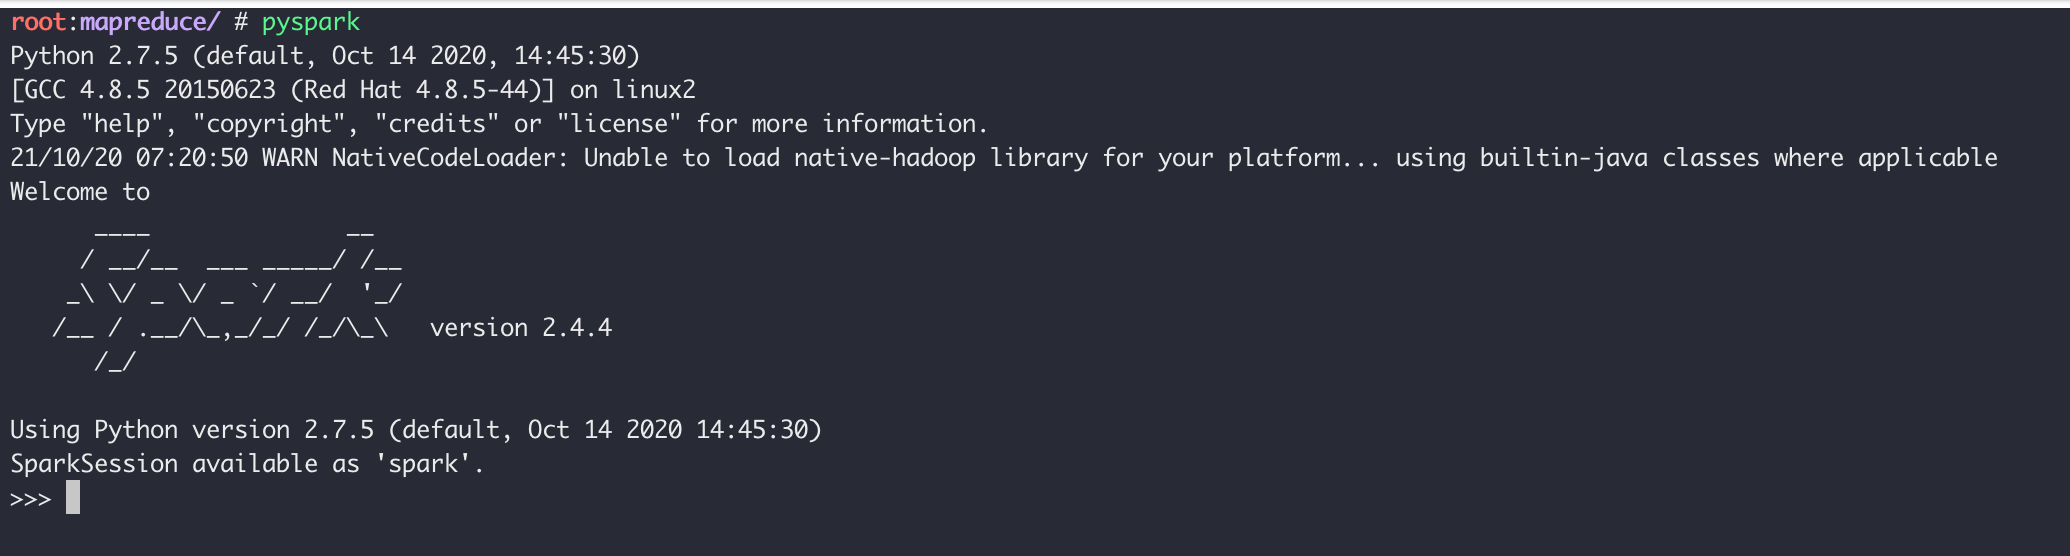
退出方法仍然是Ctrl D組合鍵。
在 Pyspark 中,我們可以用 Python 語法執行 Spark-Shell 中的操作,比如下面的語句獲得文件/etc/protocols 的行數以及第一行的內容:
file = sc.textFile("/etc/protocols")
file.count()
file.first()
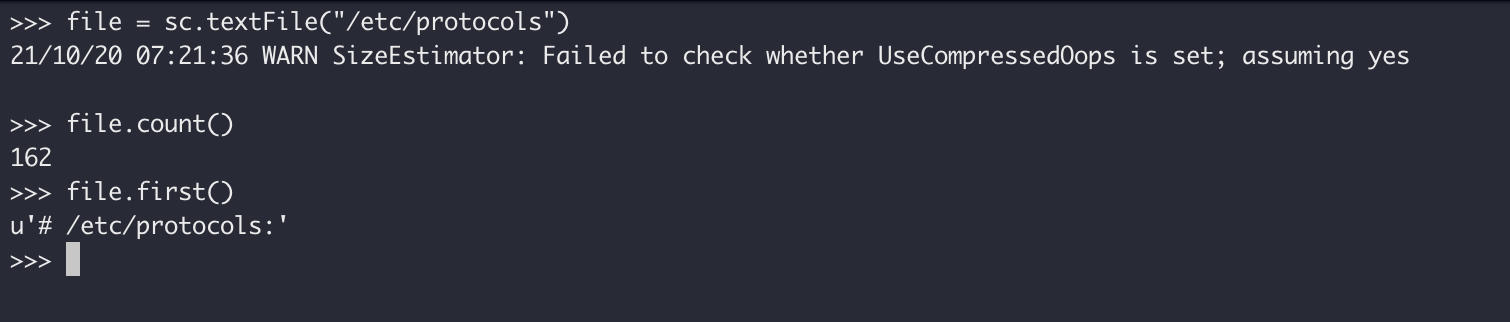
操作完成後,Ctrl D組合鍵退出 Shell。
對於 Pyspark 大家可以自行學習拓展,可以參考官方文檔Spark Python API
提交應用程式
在Spark bin目錄下的spark-submit可以用來在集群上啟動應用程式。它可以通過統一的介面使用Spark支援的所有集群管理器 ,所有你不必為每一個管理器做相應的配置。
用spark-submit啟動應用程式
bin/spark-submit腳本負責建立包含Spark以及其依賴的類路徑(classpath),它支援不同的集群管理器以及Spark支援的載入模式。
./bin/spark-submit \
  --class <main-class>
  --master <master-url> \
  --deploy-mode <deploy-mode> \
  --conf <key>=<value> \
  ... # other options
  <application-jar> \
  [application-arguments]
一些常用的選項是:
--class:你的應用程式的入口點(如org.apache.spark.examples.SparkPi)--master:集群的master URL(如spark://23.195.26.187:7077)--deploy-mode:在worker節點部署你的driver(cluster)或者本地作為外部客戶端(client)。默認是client。--conf:任意的Spark配置屬性,格式是key=value。application-jar:包含應用程式以及其依賴的jar包的路徑。這個URL必須在集群中全局可見,例如,存在於所有節點的hdfs://路徑或file://路徑application-arguments:傳遞給主類的主方法的參數
一個通用的部署策略是從網關集群提交你的應用程式,這個網關機器和你的worker集群物理上協作。在這種設置下,client模式是適合的。在client模式下,driver直接在spark-submit進程 中啟動,而這個進程直接作為集群的客戶端。應用程式的輸入和輸出都和控制台相連接。因此,這種模式特別適合涉及REPL的應用程式。
另一種選擇,如果你的應用程式從一個和worker機器相距很遠的機器上提交,通常情況下用cluster模式減少drivers和executors的網路遲延。注意,cluster模式目前不支援獨立集群、 mesos集群以及python應用程式。
有幾個我們使用的集群管理器特有的可用選項。例如,在Spark獨立集群的cluster模式下,你也可以指定--supervise用來確保driver自動重啟(如果它因為非零退出碼失敗)。 為了列舉spark-submit所有的可用選項,用--help運行它。
# Run application locally on 8 cores
./bin/spark-submit \
  --class org.apache.spark.examples.SparkPi \
  --master local[8] \
  /path/to/examples.jar \
  100

# Run on a Spark Standalone cluster in client deploy mode
./bin/spark-submit \
  --class org.apache.spark.examples.SparkPi \
  --master spark://master:7077 \
  --executor-memory 20G \
  --total-executor-cores 100 \
  /path/to/examples.jar \
  1000

# Run on a Spark Standalone cluster in cluster deploy mode with supervise
./bin/spark-submit \
  --class org.apache.spark.examples.SparkPi \
  --master spark://master:7077 \
  --deploy-mode cluster
  --supervise
  --executor-memory 20G \
  --total-executor-cores 100 \
  /path/to/examples.jar \
  1000

# Run on a YARN cluster
export HADOOP_CONF_DIR=XXX
./bin/spark-submit \
  --class org.apache.spark.examples.SparkPi \
  --master yarn-cluster \  # can also be `yarn-client` for client mode
  --executor-memory 20G \
  --num-executors 50 \
  /path/to/examples.jar \
  1000

# Run a Python application on a Spark Standalone cluster
./bin/spark-submit \
  --master spark://master:7077 \
  examples/src/main/python/pi.py \
  1000
Master URLs
傳遞給Spark的url可以用下面的模式
| Master URL | Meaning |
|---|---|
| local | 用一個worker執行緒本地運行Spark |
| local[K] | 用k個worker執行緒本地運行Spark(理想情況下,設置這個值為你的機器的核數) |
| local[*] | 用儘可能多的worker執行緒本地運行Spark |
| spark://HOST:PORT | 連接到給定的Spark獨立部署集群master。埠必須是master配置的埠,默認是7077 |
| mesos://HOST:PORT | 連接到給定的mesos集群 |
| yarn-client | 以client模式連接到Yarn集群。群集位置將基於通過HADOOP_CONF_DIR變數找到 |
| yarn-cluster | 以cluster模式連接到Yarn集群。群集位置將基於通過HADOOP_CONF_DIR變數找到 |
Spark Standalone擴展
手動啟動集群
你能夠通過下面的方式啟動獨立的master伺服器。
./sbin/start-master.sh
一旦啟動,master將會為自己列印出spark://HOST:PORT URL,你能夠用它連接到workers或者作為"master"參數傳遞給SparkContext。你也可以在master web UI上發現這個URL, master web UI默認的地址是//localhost:8080。
相同的,你也可以啟動一個或者多個workers或者將它們連接到master。
./bin/spark-class org.apache.spark.deploy.worker.Worker spark://IP:PORT
一旦你啟動了一個worker,查看master web UI。你可以看到新的節點列表以及節點的CPU數以及記憶體。
下面的配置參數可以傳遞給master和worker。
| Argument | Meaning |
|---|---|
| -h HOST, --host HOST | 監聽的主機名 |
| -i HOST, --ip HOST | 同上,已經被淘汰 |
| -p PORT, --port PORT | 監聽的服務的埠(master默認是7077,worker隨機) |
| --webui-port PORT | web UI的埠(master默認是8080,worker默認是8081) |
| -c CORES, --cores CORES | Spark應用程式可以使用的CPU核數(默認是所有可用);這個選項僅在worker上可用 |
| -m MEM, --memory MEM | Spark應用程式可以使用的記憶體數(默認情況是你的機器記憶體數減去1g);這個選項僅在worker上可用 |
| -d DIR, --work-dir DIR | 用於暫存空間和工作輸出日誌的目錄(默認是SPARK_HOME/work);這個選項僅在worker上可用 |
| --properties-file FILE | 自定義的Spark配置文件的載入目錄(默認是conf/spark-defaults.conf) |
集群啟動腳本
為了用啟動腳本啟動Spark獨立集群,你應該在你的Spark目錄下建立一個名為conf/slaves的文件,這個文件必須包含所有你要啟動的Spark worker所在機器的主機名,一行一個。如果 conf/slaves不存在,啟動腳本默認為單個機器(localhost),這台機器對於測試是有用的。注意,master機器通過ssh訪問所有的worker。在默認情況下,SSH是並行運行,需要設置無密碼(採用私有密鑰)的訪問。 如果你沒有設置為無密碼訪問,你可以設置環境變數SPARK_SSH_FOREGROUND,為每個worker提供密碼。
一旦你設置了這個文件,你就可以通過下面的shell腳本啟動或者停止你的集群。
- sbin/start-master.sh:在機器上啟動一個master實例
- sbin/start-slaves.sh:在每台機器上啟動一個slave實例
- sbin/start-all.sh:同時啟動一個master實例和所有slave實例
- sbin/stop-master.sh:停止master實例
- sbin/stop-slaves.sh:停止所有slave實例
- sbin/stop-all.sh:停止master實例和所有slave實例
注意,這些腳本必須在你的Spark master運行的機器上執行,而不是在你的本地機器上面。
你可以在conf/spark-env.sh中設置環境變數進一步配置集群。利用conf/spark-env.sh.template創建這個文件,然後將它複製到所有的worker機器上使設置有效。下面的設置可以起作用:
| Environment Variable | Meaning |
|---|---|
| SPARK_MASTER_IP | 綁定master到一個指定的ip地址 |
| SPARK_MASTER_PORT | 在不同的埠上啟動master(默認是7077) |
| SPARK_MASTER_WEBUI_PORT | master web UI的埠(默認是8080) |
| SPARK_MASTER_OPTS | 應用到master的配置屬性,格式是 "-Dx=y"(默認是none),查看下面的表格的選項以組成一個可能的列表 |
| SPARK_LOCAL_DIRS | Spark中暫存空間的目錄。包括map的輸出文件和存儲在磁碟上的RDDs(including map output files and RDDs that get stored on disk)。這必須在一個快速的、你的系統的本地磁碟上。它可以是一個逗號分隔的列表,代表不同磁碟的多個目錄 |
| SPARK_WORKER_CORES | Spark應用程式可以用到的核心數(默認是所有可用) |
| SPARK_WORKER_MEMORY | Spark應用程式用到的記憶體總數(默認是記憶體總數減去1G)。注意,每個應用程式個體的記憶體通過spark.executor.memory設置 |
| SPARK_WORKER_PORT | 在指定的埠上啟動Spark worker(默認是隨機) |
| SPARK_WORKER_WEBUI_PORT | worker UI的埠(默認是8081) |
| SPARK_WORKER_INSTANCES | 每台機器運行的worker實例數,默認是1。如果你有一台非常大的機器並且希望運行多個worker,你可以設置這個數大於1。如果你設置了這個環境變數,確保你也設置了SPARK_WORKER_CORES環境變數用於限制每個worker的核數或者每個worker嘗試使用所有的核。 |
| SPARK_WORKER_DIR | Spark worker運行目錄,該目錄包括日誌和暫存空間(默認是SPARK_HOME/work) |
| SPARK_WORKER_OPTS | 應用到worker的配置屬性,格式是 "-Dx=y"(默認是none),查看下面表格的選項以組成一個可能的列表 |
| SPARK_DAEMON_MEMORY | 分配給Spark master和worker守護進程的記憶體(默認是512m) |
| SPARK_DAEMON_JAVA_OPTS | Spark master和worker守護進程的JVM選項,格式是"-Dx=y"(默認為none) |
| SPARK_PUBLIC_DNS | Spark master和worker公共的DNS名(默認是none) |
注意,啟動腳本還不支援windows。為了在windows上啟動Spark集群,需要手動啟動master和workers。
SPARK_MASTER_OPTS支援一下的系統屬性:
| Property Name | Default | Meaning |
|---|---|---|
| spark.deploy.retainedApplications | 200 | 展示完成的應用程式的最大數目。老的應用程式會被刪除以滿足該限制 |
| spark.deploy.retainedDrivers | 200 | 展示完成的drivers的最大數目。老的應用程式會被刪除以滿足該限制 |
| spark.deploy.spreadOut | true | 這個選項控制獨立的集群管理器是應該跨節點傳遞應用程式還是應努力將程式整合到儘可能少的節點上。在HDFS中,傳遞程式是數據本地化更好的選擇,但是,對於計算密集型的負載,整合會更有效率。 |
| spark.deploy.defaultCores | (infinite) | 在Spark獨立模式下,給應用程式的默認核數(如果沒有設置spark.cores.max)。如果沒有設置,應用程式總數獲得所有可用的核,除非設置了spark.cores.max。在共享集群上設置較低的核數,可用防止用戶默認抓住整個集群。 |
| spark.worker.timeout | 60 | 獨立部署的master認為worker失敗(沒有收到心跳資訊)的間隔時間。 |
SPARK_WORKER_OPTS支援的系統屬性:
| Property Name | Default | Meaning |
|---|---|---|
| spark.worker.cleanup.enabled | false | 周期性的清空worker/應用程式目錄。注意,這僅僅影響獨立部署模式。不管應用程式是否還在執行,用於程式目錄都會被清空 |
| spark.worker.cleanup.interval | 1800 (30分) | 在本地機器上,worker清空老的應用程式工作目錄的時間間隔 |
| spark.worker.cleanup.appDataTtl | 7 24 3600 (7天) | 每個worker中應用程式工作目錄的保留時間。這個時間依賴於你可用磁碟空間的大小。應用程式日誌和jar包上傳到每個應用程式的工作目錄。隨著時間的推移,工作目錄會很快的填滿磁碟空間,特別是如果你運行的作業很頻繁。 |
連接一個應用程式到集群中
為了在Spark集群中運行一個應用程式,簡單地傳遞spark://IP:PORT URL到SparkContext
為了在集群上運行一個互動式的Spark shell,運行一下命令:
./bin/spark-shell --master spark://IP:PORT
你也可以傳遞一個選項--total-executor-cores <numcores>去控制spark-shell的核數。
啟動Spark應用程式
spark-submit腳本支援最直接的提交一個Spark應用程式到集群。對於獨立部署的集群,Spark目前支援兩種部署模式。在client模式中,driver啟動進程與 客戶端提交應用程式所在的進程是同一個進程。然而,在cluster模式中,driver在集群的某個worker進程中啟動,只有客戶端進程完成了提交任務,它不會等到應用程式完成就會退出。
如果你的應用程式通過Spark submit啟動,你的應用程式jar包將會自動分發到所有的worker節點。對於你的應用程式依賴的其它jar包,你應該用--jars符號指定(如--jars jar1,jar2)。
另外,cluster模式支援自動的重啟你的應用程式(如果程式一非零的退出碼退出)。為了用這個特徵,當啟動應用程式時,你可以傳遞--supervise符號到spark-submit。如果你想殺死反覆失敗的應用, 你可以通過如下的方式:
./bin/spark-class org.apache.spark.deploy.Client kill <master url=""> <driver id="">
你可以在獨立部署的Master web UI(//:8080)中找到driver ID。
資源調度
獨立部署的集群模式僅僅支援簡單的FIFO調度器。然而,為了允許多個並行的用戶,你能夠控制每個應用程式能用的最大資源數。在默認情況下,它將獲得集群的所有核,這隻有在某一時刻只 允許一個應用程式才有意義。你可以通過spark.cores.max在SparkConf中設置核數。
val conf = new SparkConf()
             .setMaster(...)
             .setAppName(...)
             .set("spark.cores.max", "10")
val sc = new SparkContext(conf)
另外,你可以在集群的master進程中配置spark.deploy.defaultCores來改變默認的值。在conf/spark-env.sh添加下面的行:
export SPARK_MASTER_OPTS="-Dspark.deploy.defaultCores=<value>"
這在用戶沒有配置最大核數的共享集群中是有用的。
高可用
默認情況下,獨立的調度集群對worker失敗是有彈性的(在Spark本身的範圍內是有彈性的,對丟失的工作通過轉移它到另外的worker來解決)。然而,調度器通過master去執行調度決定, 這會造成單點故障:如果master死了,新的應用程式就無法創建。為了避免這個,我們有兩個高可用的模式。
用ZooKeeper的備用master
利用ZooKeeper去支援領導選舉以及一些狀態存儲,你能夠在你的集群中啟動多個master,這些master連接到同一個ZooKeeper實例上。一個被選為「領導」,其它的保持備用模式。如果當前 的領導死了,另一個master將會被選中,恢復老master的狀態,然後恢復調度。整個的恢復過程大概需要1到2分鐘。注意,這個恢復時間僅僅會影響調度新的應用程式-運行在失敗master中的 應用程式不受影響。
配置
為了開啟這個恢復模式,你可以用下面的屬性在spark-env中設置SPARK_DAEMON_JAVA_OPTS。
| System property | Meaning |
|---|---|
| spark.deploy.recoveryMode | 設置ZOOKEEPER去啟動備用master模式(默認為none) |
| spark.deploy.zookeeper.url | zookeeper集群url(如192.168.1.100:2181,192.168.1.101:2181) |
| spark.deploy.zookeeper.dir | zookeeper保存恢復狀態的目錄(默認是/spark) |
可能的陷阱:如果你在集群中有多個masters,但是沒有用zookeeper正確的配置這些masters,這些masters不會發現彼此,會認為它們都是leaders。這將會造成一個不健康的集群狀態(因為所有的master都會獨立的調度)。
細節
zookeeper集群啟動之後,開啟高可用是簡單的。在相同的zookeeper配置(zookeeper URL和目錄)下,在不同的節點上簡單地啟動多個master進程。master可以隨時添加和刪除。
為了調度新的應用程式或者添加worker到集群,它需要知道當前leader的IP地址。這可以通過簡單的傳遞一個master列表來完成。例如,你可能啟動你的SparkContext指向spark://host1:port1,host2:port2。 這將造成你的SparkContext同時註冊這兩個master-如果host1死了,這個配置文件將一直是正確的,因為我們將找到新的leader-host2。
"registering with a Master"和正常操作之間有重要的區別。當啟動時,一個應用程式或者worker需要能夠發現和註冊當前的leader master。一旦它成功註冊,它就在系統中了。如果 錯誤發生,新的leader將會接觸所有之前註冊的應用程式和worker,通知他們領導關係的變化,所以它們甚至不需要事先知道新啟動的leader的存在。
由於這個屬性的存在,新的master可以在任何時候創建。你唯一需要擔心的問題是新的應用程式和workers能夠發現它並將它註冊進來以防它成為leader master。
用本地文件系統做單節點恢復
zookeeper是生產環境下最好的選擇,但是如果你想在master死掉後重啟它,FILESYSTEM模式可以解決。當應用程式和worker註冊,它們擁有足夠的狀態寫入提供的目錄,以至於在重啟master 進程時它們能夠恢復。
配置
為了開啟這個恢復模式,你可以用下面的屬性在spark-env中設置SPARK_DAEMON_JAVA_OPTS。
| System property | Meaning |
|---|---|
| spark.deploy.recoveryMode | 設置為FILESYSTEM開啟單節點恢復模式(默認為none) |
| spark.deploy.recoveryDirectory | 用來恢復狀態的目錄 |
細節
- 這個解決方案可以和監控器/管理器(如monit)相配合,或者僅僅通過重啟開啟手動恢復。
- 雖然文件系統的恢復似乎比沒有做任何恢復要好,但對於特定的開發或實驗目的,這種模式可能是次優的。特別是,通過
stop-master.sh殺掉master不會清除它的恢復狀態,所以,不管你何時啟動一個新的master,它都將進入恢復模式。這可能使啟動時間增加到1分鐘。 - 雖然它不是官方支援的方式,你也可以創建一個NFS目錄作為恢複目錄。如果原始的master節點完全死掉,你可以在不同的節點啟動master,它可以正確的恢復之前註冊的所有應用程式和workers。未來的應用程式會發現這個新的master。
在YARN上運行Spark
配置
大部分為Spark on YARN模式提供的配置與其它部署模式提供的配置相同。下面這些是為Spark on YARN模式提供的配置。
Hadoop 配置
記得到yarn-site-xml下添加:
vim $HADOOP_HOME/etc/hadoop/yarn-site.xml
<property>
    <name>yarn.nodemanager.pmem-check-enabled</name>
    <value>false</value>
</property>

<property>
    <name>yarn.nodemanager.vmem-check-enabled</name>
    <value>false</value>
</property>
Spark屬性
| Property Name | Default | Meaning |
|---|---|---|
| spark.yarn.applicationMaster.waitTries | 10 | ApplicationMaster等待Spark master的次數以及SparkContext初始化嘗試的次數 |
| spark.yarn.submit.file.replication | HDFS默認的複製次數(3) | 上傳到HDFS的文件的HDFS複製水平。這些文件包括Spark jar、app jar以及任何分散式快取文件/檔案 |
| spark.yarn.preserve.staging.files | false | 設置為true,則在作業結束時保留階段性文件(Spark jar、app jar以及任何分散式快取文件)而不是刪除它們 |
| spark.yarn.scheduler.heartbeat.interval-ms | 5000 | Spark application master給YARN ResourceManager發送心跳的時間間隔(ms) |
| spark.yarn.max.executor.failures | numExecutors * 2,最小為3 | 失敗應用程式之前最大的執行失敗數 |
| spark.yarn.historyServer.address | (none) | Spark歷史伺服器(如host.com:18080)的地址。這個地址不應該包含一個模式(//)。默認情況下沒有設置值,這是因為該選項是一個可選選項。當Spark應用程式完成從ResourceManager.xn--%2C-0n6a5a4i4cx5nm9cq9fs6huv1aztnca24z1v3a0o8d42yb1ma0wy41dt1aeaa8870cga5681b.xn--sparkresourcemanager-0w75an08pwqoodr0t8owxt5j2u2a/) UI到Spark歷史伺服器UI的連接時,這個地址從YARN ResourceManager得到 |
| spark.yarn.dist.archives | (none) | 提取逗號分隔的檔案列表到每個執行器的工作目錄 |
| spark.yarn.dist.files | (none) | 放置逗號分隔的文件列表到每個執行器的工作目錄 |
| spark.yarn.executor.memoryOverhead | executorMemory * 0.07,最小384 | 分配給每個執行器的堆記憶體大小(以MB為單位)。它是VM開銷、interned字元串或者其它本地開銷佔用的記憶體。這往往隨著執行器大小而增長。(典型情況下是6%-10%) |
| spark.yarn.driver.memoryOverhead | driverMemory * 0.07,最小384 | 分配給每個driver的堆記憶體大小(以MB為單位)。它是VM開銷、interned字元串或者其它本地開銷佔用的記憶體。這往往隨著執行器大小而增長。(典型情況下是6%-10%) |
| spark.yarn.queue | default | 應用程式被提交到的YARN隊列的名稱 |
| spark.yarn.jar | (none) | Spark jar文件的位置,覆蓋默認的位置。默認情況下,Spark on YARN將會用到本地安裝的Spark jar。但是Spark jar也可以HDFS中的一個公共位置。這允許YARN快取它到節點上,而不用在每次運行應用程式時都需要分配。指向HDFS中的jar包,可以這個參數為"hdfs:///some/path" |
| spark.yarn.access.namenodes | (none) | 你的Spark應用程式訪問的HDFS namenode列表。例如,spark.yarn.access.namenodes=hdfs://nn1.com:8032,hdfs://nn2.com:8032,Spark應用程式必須訪問namenode列表,Kerberos必須正確配置來訪問它們。Spark獲得namenode的安全令牌,這樣Spark應用程式就能夠訪問這些遠程的HDFS集群。 |
| spark.yarn.containerLauncherMaxThreads | 25 | 為了啟動執行者容器,應用程式master用到的最大執行緒數 |
| spark.yarn.appMasterEnv.[EnvironmentVariableName] | (none) | 添加通過EnvironmentVariableName指定的環境變數到Application Master處理YARN上的啟動。用戶可以指定多個該設置,從而設置多個環境變數。在yarn-cluster模式下,這控制Spark driver的環境。在yarn-client模式下,這僅僅控制執行器啟動者的環境。 |
在YARN上啟動Spark
確保HADOOP_CONF_DIR或YARN_CONF_DIR指向的目錄包含Hadoop集群的(客戶端)配置文件。這些配置用於寫數據到dfs和連接到YARN ResourceManager。
有兩種部署模式可以用來在YARN上啟動Spark應用程式。在yarn-cluster模式下,Spark driver運行在application master進程中,這個進程被集群中的YARN所管理,客戶端會在初始化應用程式 之後關閉。在yarn-client模式下,driver運行在客戶端進程中,application master僅僅用來向YARN請求資源。
和Spark單獨模式以及Mesos模式不同,在這些模式中,master的地址由"master"參數指定,而在YARN模式下,ResourceManager的地址從Hadoop配置得到。因此master參數是簡單的yarn-client和yarn-cluster。
在yarn-cluster模式下啟動Spark應用程式。
./bin/spark-submit --class path.to.your.Class --master yarn-cluster [options] <app jar=""> [app options]
例子:
$ ./bin/spark-submit --class org.apache.spark.examples.SparkPi \
    --master yarn-cluster \
    --num-executors 3 \
    --driver-memory 4g \
    --executor-memory 2g \
    --executor-cores 1 \
    --queue thequeue \
    lib/spark-examples*.jar \
    10
以上啟動了一個YARN客戶端程式用來啟動默認的 Application Master,然後SparkPi會作為Application Master的子執行緒運行。客戶端會定期的輪詢Application Master用於狀態更新並將 更新顯示在控制台上。一旦你的應用程式運行完畢,客戶端就會退出。
在yarn-client模式下啟動Spark應用程式,運行下面的shell腳本
$ ./bin/spark-shell --master yarn-client
添加其它的jar
在yarn-cluster模式下,driver運行在不同的機器上,所以離開了保存在本地客戶端的文件,SparkContext.addJar將不會工作。為了使SparkContext.addJar用到保存在客戶端的文件, 在啟動命令中加上--jars選項。
$ ./bin/spark-submit --class my.main.Class \
    --master yarn-cluster \
    --jars my-other-jar.jar,my-other-other-jar.jar
    my-main-jar.jar
    app_arg1 app_arg2
注意事項
- 在Hadoop 2.2之前,YARN不支援容器核的資源請求。因此,當運行早期的版本時,通過命令行參數指定的核的數量無法傳遞給YARN。在調度決策中,核請求是否兌現取決於用哪個調度器以及 如何配置調度器。
- Spark executors使用的本地目錄將會是YARN配置(yarn.nodemanager.local-dirs)的本地目錄。如果用戶指定了
spark.local.dir,它將被忽略。 --files和--archives選項支援指定帶 # 號文件名。例如,你能夠指定--files localtest.txt#appSees.txt,它上傳你在本地命名為localtest.txt的文件到HDFS,但是將會鏈接為名稱appSees.txt。當你的應用程式運行在YARN上時,你應該使用appSees.txt去引用該文件。- 如果你在yarn-cluster模式下運行
SparkContext.addJar,並且用到了本地文件,--jars選項允許SparkContext.addJar函數能夠工作。如果你正在使用 HDFS, HTTP, HTTPS或FTP,你不需要用到該選項
Spark配置
Spark提供三個位置用來配置系統:
- Spark properties控制大部分的應用程式參數,可以用SparkConf對象或者java系統屬性設置
- Environment variables可以通過每個節點的
conf/spark-env.sh腳本設置每台機器的設置。例如IP地址 - Logging可以通過log4j.properties配置
Spark屬性
Spark屬性控制大部分的應用程式設置,並且為每個應用程式分別配置它。這些屬性可以直接在SparkConf上配置,然後傳遞給SparkContext。SparkConf 允許你配置一些通用的屬性(如master URL、應用程式明)以及通過set()方法設置的任意鍵值對。例如,我們可以用如下方式創建一個擁有兩個執行緒的應用程式。注意,我們用local[2]運行,這意味著兩個執行緒-表示最小的 並行度,它可以幫助我們檢測當在分散式環境下運行的時才出現的錯誤。
val conf = new SparkConf()
             .setMaster("local[2]")
             .setAppName("CountingSheep")
             .set("spark.executor.memory", "1g")
val sc = new SparkContext(conf)
注意,我們在本地模式中擁有超過1個執行緒。和Spark Streaming的情況一樣,我們可能需要一個執行緒防止任何形式的飢餓問題。
動態載入Spark屬性
在一些情況下,你可能想在SparkConf中避免硬編碼確定的配置。例如,你想用不同的master或者不同的記憶體數運行相同的應用程式。Spark允許你簡單地創建一個空conf。
val sc = new SparkContext(new SparkConf())
然後你在運行時提供值。
./bin/spark-submit --name "My app" --master local[4] --conf spark.shuffle.spill=false
  --conf "spark.executor.extraJavaOptions=-XX:+PrintGCDetails -XX:+PrintGCTimeStamps" myApp.jar
Spark shell和spark-submit工具支援兩種方式動態載入配置。第一種方式是命令行選項,例如--master,如上面shell顯示的那樣。spark-submit可以接受任何Spark屬性,用--conf 標記表示。但是那些參與Spark應用程式啟動的屬性要用特定的標記表示。運行./bin/spark-submit --help將會顯示選項的整個列表。
bin/spark-submit也會從conf/spark-defaults.conf中讀取配置選項,這個配置文件中,每一行都包含一對以空格分開的鍵和值。例如:
spark.master            spark://5.6.7.8:7077
spark.executor.memory   512m
spark.eventLog.enabled  true
spark.serializer        org.apache.spark.serializer.KryoSerializer
任何標籤(flags)指定的值或者在配置文件中的值將會傳遞給應用程式,並且通過SparkConf合併這些值。在SparkConf上設置的屬性具有最高的優先順序,其次是傳遞給spark-submit 或者spark-shell的屬性值,最後是spark-defaults.conf文件中的屬性值。
查看Spark屬性
在//<driver>:4040上的應用程式web UI在「Environment」標籤中列出了所有的Spark屬性。這對你確保設置的屬性的正確性是很有用的。注意,只有通過spark-defaults.conf, SparkConf以及 命令行直接指定的值才會顯示。對於其它的配置屬性,你可以認為程式用到了默認的值。
可用的屬性
控制內部設置的大部分屬性都有合理的默認值,一些最通用的選項設置如下:
應用程式屬性
| Property Name | Default | Meaning |
|---|---|---|
| spark.app.name | (none) | 你的應用程式的名字。這將在UI和日誌數據中出現 |
| spark.master | (none) | 集群管理器連接的地方 |
| spark.executor.memory | 512m | 每個executor進程使用的記憶體數。和JVM記憶體串擁有相同的格式(如512m,2g) |
| spark.driver.memory | 512m | driver進程使用的記憶體數 |
| spark.driver.maxResultSize | 1g | 每個Spark action(如collect)所有分區的序列化結果的總大小限制。設置的值應該不小於1m,0代表沒有限制。如果總大小超過這個限制,工作將會終止。大的限制值可能導致driver出現記憶體溢出錯誤(依賴於spark.driver.memory和JVM中對象的記憶體消耗)。設置合理的限制,可以避免出現記憶體溢出錯誤。 |
| spark.serializer | org.apache.spark.serializer.JavaSerializer | 序列化對象使用的類。默認的java序列化類可以序列化任何可序列化的java對象但是它很慢。所有我們建議用org.apache.spark.serializer.KryoSerializer |
| spark.kryo.classesToRegister | (none) | 如果你用Kryo序列化,給定的用逗號分隔的自定義類名列表表示要註冊的類 |
| spark.kryo.registrator | (none) | 如果你用Kryo序列化,設置這個類去註冊你的自定義類。如果你需要用自定義的方式註冊你的類,那麼這個屬性是有用的。否則spark.kryo.classesToRegister會更簡單。它應該設置一個繼承自KryoRegistrator的類 |
| spark.local.dir | /tmp | Spark中暫存空間的使用目錄。在Spark1.0以及更高的版本中,這個屬性被SPARK_LOCAL_DIRS(Standalone, Mesos)和LOCAL_DIRS(YARN)環境變數覆蓋。 |
| spark.logConf | false | 當SparkContext啟動時,將有效的SparkConf記錄為INFO。 |
運行環境
| Property Name | Default | Meaning |
|---|---|---|
| spark.executor.extraJavaOptions | (none) | 傳遞給executors的JVM選項字元串。例如GC設置或者其它日誌設置。注意,在這個選項中設置Spark屬性或者堆大小是不合法的。Spark屬性需要用SparkConf對象或者spark-submit腳本用到的spark-defaults.conf文件設置。堆記憶體可以通過spark.executor.memory設置 |
| spark.executor.extraClassPath | (none) | 附加到executors的classpath的額外的classpath實體。這個設置存在的主要目的是Spark與舊版本的向後兼容問題。用戶一般不用設置這個選項 |
| spark.executor.extraLibraryPath | (none) | 指定啟動executor的JVM時用到的庫路徑 |
| spark.executor.logs.rolling.strategy | (none) | 設置executor日誌的滾動(rolling)策略。默認情況下沒有開啟。可以配置為time(基於時間的滾動)和size(基於大小的滾動)。對於time,用spark.executor.logs.rolling.time.interval設置滾動間隔;對於size,用spark.executor.logs.rolling.size.maxBytes設置最大的滾動大小 |
| spark.executor.logs.rolling.time.interval | daily | executor日誌滾動的時間間隔。默認情況下沒有開啟。合法的值是daily, hourly, minutely以及任意的秒。 |
| spark.executor.logs.rolling.size.maxBytes | (none) | executor日誌的最大滾動大小。默認情況下沒有開啟。值設置為位元組 |
| spark.executor.logs.rolling.maxRetainedFiles | (none) | 設置被系統保留的最近滾動日誌文件的數量。更老的日誌文件將被刪除。默認沒有開啟。 |
| spark.files.userClassPathFirst | false | (實驗性)當在Executors中載入類時,是否用戶添加的jar比Spark自己的jar優先順序高。這個屬性可以降低Spark依賴和用戶依賴的衝突。它現在還是一個實驗性的特徵。 |
| spark.python.worker.memory | 512m | 在聚合期間,每個python worker進程使用的記憶體數。在聚合期間,如果記憶體超過了這個限制,它將會將數據塞進磁碟中 |
| spark.python.profile | false | 在Python worker中開啟profiling。通過sc.show_profiles()展示分析結果。或者在driver退出前展示分析結果。可以通過sc.dump_profiles(path)將結果dump到磁碟中。如果一些分析結果已經手動展示,那麼在driver退出前,它們再不會自動展示 |
| spark.python.profile.dump | (none) | driver退出前保存分析結果的dump文件的目錄。每個RDD都會分別dump一個文件。可以通過ptats.Stats()載入這些文件。如果指定了這個屬性,分析結果不會自動展示 |
| spark.python.worker.reuse | true | 是否重用python worker。如果是,它將使用固定數量的Python workers,而不需要為每個任務fork()一個Python進程。如果有一個非常大的廣播,這個設置將非常有用。因為,廣播不需要為每個任務從JVM到Python worker傳遞一次 |
| spark.executorEnv.[EnvironmentVariableName] | (none) | 通過EnvironmentVariableName添加指定的環境變數到executor進程。用戶可以指定多個EnvironmentVariableName,設置多個環境變數 |
| spark.mesos.executor.home | driver side SPARK_HOME | 設置安裝在Mesos的executor上的Spark的目錄。默認情況下,executors將使用driver的Spark本地(home)目錄,這個目錄對它們不可見。注意,如果沒有通過spark.executor.uri指定Spark的二進位包,這個設置才起作用 |
| spark.mesos.executor.memoryOverhead | executor memory * 0.07, 最小384m | 這個值是spark.executor.memory的補充。它用來計算mesos任務的總記憶體。另外,有一個7%的硬編碼設置。最後的值將選擇spark.mesos.executor.memoryOverhead或者spark.executor.memory的7%二者之間的大者 |
Shuffle行為(Behavior)
| Property Name | Default | Meaning |
|---|---|---|
| spark.shuffle.consolidateFiles | false | 如果設置為"true",在shuffle期間,合併的中間文件將會被創建。創建更少的文件可以提供文件系統的shuffle的效率。這些shuffle都伴隨著大量遞歸任務。當用ext4和dfs文件系統時,推薦設置為"true"。在ext3中,因為文件系統的限制,這個選項可能機器(大於8核)降低效率 |
| spark.shuffle.spill | true | 如果設置為"true",通過將多出的數據寫入磁碟來限制記憶體數。通過spark.shuffle.memoryFraction來指定spilling的閾值 |
| spark.shuffle.spill.compress | true | 在shuffle時,是否將spilling的數據壓縮。壓縮演算法通過spark.io.compression.codec指定。 |
| spark.shuffle.memoryFraction | 0.2 | 如果spark.shuffle.spill為「true」,shuffle中聚合和合併組操作使用的java堆記憶體佔總記憶體的比重。在任何時候,shuffles使用的所有記憶體內maps的集合大小都受這個限制的約束。超過這個限制,spilling數據將會保存到磁碟上。如果spilling太過頻繁,考慮增大這個值 |
| spark.shuffle.compress | true | 是否壓縮map操作的輸出文件。一般情況下,這是一個好的選擇。 |
| spark.shuffle.file.buffer.kb | 32 | 每個shuffle文件輸出流記憶體內快取的大小,單位是kb。這個快取減少了創建只中間shuffle文件中磁碟搜索和系統訪問的數量 |
| spark.reducer.maxMbInFlight | 48 | 從遞歸任務中同時獲取的map輸出數據的最大大小(mb)。因為每一個輸出都需要我們創建一個快取用來接收,這個設置代表每個任務固定的記憶體上限,所以除非你有更大的記憶體,將其設置小一點 |
| spark.shuffle.manager | sort | 它的實現用於shuffle數據。有兩種可用的實現:sort和hash。基於sort的shuffle有更高的記憶體使用率 |
| spark.shuffle.sort.bypassMergeThreshold | 200 | (Advanced) In the sort-based shuffle manager, avoid merge-sorting data if there is no map-side aggregation and there are at most this many reduce partitions |
| spark.shuffle.blockTransferService | netty | 實現用來在executor直接傳遞shuffle和快取塊。有兩種可用的實現:netty和nio。基於netty的塊傳遞在具有相同的效率情況下更簡單 |
Spark UI
| Property Name | Default | Meaning |
|---|---|---|
| spark.ui.port | 4040 | 你的應用程式dashboard的埠。顯示記憶體和工作量數據 |
| spark.ui.retainedStages | 1000 | 在垃圾回收之前,Spark UI和狀態API記住的stage數 |
| spark.ui.retainedJobs | 1000 | 在垃圾回收之前,Spark UI和狀態API記住的job數 |
| spark.ui.killEnabled | true | 運行在web UI中殺死stage和相應的job |
| spark.eventLog.enabled | false | 是否記錄Spark的事件日誌。這在應用程式完成後,重新構造web UI是有用的 |
| spark.eventLog.compress | false | 是否壓縮事件日誌。需要spark.eventLog.enabled為true |
| spark.eventLog.dir | file:///tmp/spark-events | Spark事件日誌記錄的基本目錄。在這個基本目錄下,Spark為每個應用程式創建一個子目錄。各個應用程式記錄日誌到直到的目錄。用戶可能想設置這為統一的地點,像HDFS一樣,所以歷史文件可以通過歷史伺服器讀取 |
壓縮和序列化
| Property Name | Default | Meaning |
|---|---|---|
| spark.broadcast.compress | true | 在發送廣播變數之前是否壓縮它 |
| spark.rdd.compress | true | 是否壓縮序列化的RDD分區。在花費一些額外的CPU時間的同時節省大量的空間 |
| spark.io.compression.codec | snappy | 壓縮諸如RDD分區、廣播變數、shuffle輸出等內部數據的編碼解碼器。默認情況下,Spark提供了三種選擇:lz4, lzf和snappy。你也可以用完整的類名來制定。org.apache.spark.io.LZ4CompressionCodec,org.apache.spark.io.LZFCompressionCodec,org.apache.spark.io.SnappyCompressionCodec |
| spark.io.compression.snappy.block.size | 32768 | Snappy壓縮中用到的塊大小。降低這個塊的大小也會降低shuffle記憶體使用率 |
| spark.io.compression.lz4.block.size | 32768 | LZ4壓縮中用到的塊大小。降低這個塊的大小也會降低shuffle記憶體使用率 |
| spark.closure.serializer | org.apache.spark.serializer.JavaSerializer | 閉包用到的序列化類。目前只支援java序列化器 |
| spark.serializer.objectStreamReset | 100 | 當用org.apache.spark.serializer.JavaSerializer序列化時,序列化器通過快取對象防止寫多餘的數據,然而這會造成這些對象的垃圾回收停止。通過請求'reset',你從序列化器中flush這些資訊並允許收集老的數據。為了關閉這個周期性的reset,你可以將值設為-1。默認情況下,每一百個對象reset一次 |
| spark.kryo.referenceTracking | true | 當用Kryo序列化時,跟蹤是否引用同一對象。如果你的對象圖有環,這是必須的設置。如果他們包含相同對象的多個副本,這個設置對效率是有用的。如果你知道不在這兩個場景,那麼可以禁用它以提高效率 |
| spark.kryo.registrationRequired | false | 是否需要註冊為Kyro可用。如果設置為true,然後如果一個沒有註冊的類序列化,Kyro會拋出異常。如果設置為false,Kryo將會同時寫每個對象和其非註冊類名。寫類名可能造成顯著地性能瓶頸。 |
| spark.kryoserializer.buffer.mb | 0.064 | Kyro序列化快取的大小。這樣worker上的每個核都有一個快取。如果有需要,快取會漲到spark.kryoserializer.buffer.max.mb設置的值那麼大。 |
| spark.kryoserializer.buffer.max.mb | 64 | Kryo序列化快取允許的最大值。這個值必須大於你嘗試序列化的對象 |
Networking
| Property Name | Default | Meaning |
|---|---|---|
| spark.driver.host | (local hostname) | driver監聽的主機名或者IP地址。這用於和executors以及獨立的master通訊 |
| spark.driver.port | (random) | driver監聽的介面。這用於和executors以及獨立的master通訊 |
| spark.fileserver.port | (random) | driver的文件伺服器監聽的埠 |
| spark.broadcast.port | (random) | driver的HTTP廣播伺服器監聽的埠 |
| spark.replClassServer.port | (random) | driver的HTTP類伺服器監聽的埠 |
| spark.blockManager.port | (random) | 塊管理器監聽的埠。這些同時存在於driver和executors |
| spark.executor.port | (random) | executor監聽的埠。用於與driver通訊 |
| spark.port.maxRetries | 16 | 當綁定到一個埠,在放棄前重試的最大次數 |
| spark.akka.frameSize | 10 | 在"control plane"通訊中允許的最大消息大小。如果你的任務需要發送大的結果到driver中,調大這個值 |
| spark.akka.threads | 4 | 通訊的actor執行緒數。當driver有很多CPU核時,調大它是有用的 |
| spark.akka.timeout | 100 | Spark節點之間的通訊超時。單位是s |
| spark.akka.heartbeat.pauses | 6000 | This is set to a larger value to disable failure detector that comes inbuilt akka. It can be enabled again, if you plan to use this feature (Not recommended). Acceptable heart beat pause in seconds for akka. This can be used to control sensitivity to gc pauses. Tune this in combination of spark.akka.heartbeat.interval and spark.akka.failure-detector.threshold if you need to. |
| spark.akka.failure-detector.threshold | 300.0 | This is set to a larger value to disable failure detector that comes inbuilt akka. It can be enabled again, if you plan to use this feature (Not recommended). This maps to akka's akka.remote.transport-failure-detector.threshold. Tune this in combination of spark.akka.heartbeat.pauses and spark.akka.heartbeat.interval if you need to. |
| spark.akka.heartbeat.interval | 1000 | This is set to a larger value to disable failure detector that comes inbuilt akka. It can be enabled again, if you plan to use this feature (Not recommended). A larger interval value in seconds reduces network overhead and a smaller value ( ~ 1 s) might be more informative for akka's failure detector. Tune this in combination of spark.akka.heartbeat.pauses and spark.akka.failure-detector.threshold if you need to. Only positive use case for using failure detector can be, a sensistive failure detector can help evict rogue executors really quick. However this is usually not the case as gc pauses and network lags are expected in a real Spark cluster. Apart from that enabling this leads to a lot of exchanges of heart beats between nodes leading to flooding the network with those. |
Security
| Property Name | Default | Meaning |
|---|---|---|
| spark.authenticate | false | 是否Spark驗證其內部連接。如果不是運行在YARN上,請看spark.authenticate.secret |
| spark.authenticate.secret | None | 設置Spark兩個組件之間的密匙驗證。如果不是運行在YARN上,但是需要驗證,這個選項必須設置 |
| spark.core.connection.auth.wait.timeout | 30 | 連接時等待驗證的實際。單位為秒 |
| spark.core.connection.ack.wait.timeout | 60 | 連接等待回答的時間。單位為秒。為了避免不希望的超時,你可以設置更大的值 |
| spark.ui.filters | None | 應用到Spark web UI的用於過濾類名的逗號分隔的列表。過濾器必須是標準的javax servlet Filter。通過設置java系統屬性也可以指定每個過濾器的參數。spark.<class name="" of="" filter="">.params='param1=value1,param2=value2'。例如-Dspark.ui.filters=com.test.filter1、-Dspark.com.test.filter1.params='param1=foo,param2=testing' |
| spark.acls.enable | false | 是否開啟Spark acls。如果開啟了,它檢查用戶是否有許可權去查看或修改job。 Note this requires the user to be known, so if the user comes across as null no checks are done。UI利用使用過濾器驗證和設置用戶 |
| spark.ui.view.acls | empty | 逗號分隔的用戶列表,列表中的用戶有查看(view)Spark web UI的許可權。默認情況下,只有啟動Spark job的用戶有查看許可權 |
| spark.modify.acls | empty | 逗號分隔的用戶列表,列表中的用戶有修改Spark job的許可權。默認情況下,只有啟動Spark job的用戶有修改許可權 |
| spark.admin.acls | empty | 逗號分隔的用戶或者管理員列表,列表中的用戶或管理員有查看和修改所有Spark job的許可權。如果你運行在一個共享集群,有一組管理員或開發者幫助debug,這個選項有用 |
Spark Streaming
| Property Name | Default | Meaning |
|---|---|---|
| spark.streaming.blockInterval | 200 | 在這個時間間隔(ms)內,通過Spark Streaming receivers接收的數據在保存到Spark之前,chunk為數據塊。推薦的最小值為50ms |
| spark.streaming.receiver.maxRate | infinite | 每秒鐘每個receiver將接收的數據的最大記錄數。有效的情況下,每個流將消耗至少這個數目的記錄。設置這個配置為0或者-1將會不作限制 |
| spark.streaming.receiver.writeAheadLogs.enable | false | Enable write ahead logs for receivers. All the input data received through receivers will be saved to write ahead logs that will allow it to be recovered after driver failures |
| spark.streaming.unpersist | true | 強制通過Spark Streaming生成並持久化的RDD自動從Spark記憶體中非持久化。通過Spark Streaming接收的原始輸入數據也將清除。設置這個屬性為false允許流應用程式訪問原始數據和持久化RDD,因為它們沒有被自動清除。但是它會造成更高的記憶體花費 |
環境變數
通過環境變數配置確定的Spark設置。環境變數從Spark安裝目錄下的conf/spark-env.sh腳本讀取(或者windows的conf/spark-env.cmd)。在獨立的或者Mesos模式下,這個文件可以給機器 確定的資訊,如主機名。當運行本地應用程式或者提交腳本時,它也起作用。
注意,當Spark安裝時,conf/spark-env.sh默認是不存在的。你可以複製conf/spark-env.sh.template創建它。
可以在spark-env.sh中設置如下變數:
| Environment Variable | Meaning |
|---|---|
| JAVA_HOME | java安裝的路徑 |
| PYSPARK_PYTHON | PySpark用到的Python二進位執行文件路徑 |
| SPARK_LOCAL_IP | 機器綁定的IP地址 |
| SPARK_PUBLIC_DNS | 你Spark應用程式通知給其他機器的主機名 |
除了以上這些,Spark standalone cluster scripts也可以設置一些選項。例如 每台機器使用的核數以及最大記憶體。
因為spark-env.sh是shell腳本,其中的一些可以以編程方式設置。例如,你可以通過特定的網路介面計算SPARK_LOCAL_IP。
配置Logging
Spark用log4j logging。你可以通過在conf目錄下添加log4j.properties文件來配置。一種方法是複製log4j.properties.template文件。
Spark調優
由於大部分
Spark計算都是在記憶體中完成的,所以Spark程式的瓶頸可能由集群中任意一種資源導致,如:CPU、網路頻寬、或者記憶體等。最常見的情況是,數據能裝進記憶體,而瓶頸是網路頻寬;當然,有時候我們也需要做一些優化調整來減少記憶體佔用,例如將RDD以序列化格式保存。 本文將主要涵蓋兩個主題:1.數據序列化(這對於優化網路性能極為重要);2.減少記憶體佔用以及記憶體調優。同時,我們也會提及其他幾個比較小的主題。
數據序列化
序列化在任何一種分散式應用性能優化時都扮演幾位重要的角色。如果序列化格式序列化過程緩慢,或者需要佔用位元組很多,都會大大拖慢整體的計算效率。 通常,序列化都是Spark應用優化時首先需要關注的地方。Spark著眼於便利性(允許你在計算過程中使用任何Java類型)和性能的一個平衡。Spark主要提供了兩個序列化庫:
Java serialization:默認情況,Spark使用Java自帶的ObjectOutputStream框架來序列化對象,這樣任何實現了java.io.Serializable介面的對象,都能被序列化。同時,你還可以通過擴展java.io.Externalizable來控制序列化性能。Java序列化很靈活但性能較差,同時序列化後佔用的位元組數也較多。Kryo serialization:Spark還可以使用Kryo庫(版本2)提供更高效的序列化格式。Kryo的序列化速度和位元組佔用都比Java序列化好很多(通常是10倍左右),但Kryo不支援所有實現了Serializable介面的類型,它需要你在程式中register需要序列化的類型,以得到最佳性能。
要切換使用 Kryo,你可以在 SparkConf 初始化的時候調用 conf.set(「spark.serializer」, 「org.apache.spark.serializer.KryoSerializer」)。這個設置不僅控制各個worker節點之間的混洗數據序列化格式,同時還控制RDD存到磁碟上的序列化格式。 目前,Kryo不是默認的序列化格式,因為它需要你在使用前註冊需要序列化的類型,不過我們還是建議在對網路敏感的應用場景下使用Kryo。
Spark對一些常用的Scala核心類型,如在Twitter chill 庫的AllScalaRegistrar中,自動使用Kryo序列化格式。
如果你的自定義類型需要使用Kryo序列化,可以用 registerKryoClasses 方法先註冊:
val conf = new SparkConf().setMaster(...).setAppName(...)
conf.registerKryoClasses(Array(classOf[MyClass1], classOf[MyClass2]))
val sc = new SparkContext(conf)
Kryo的文檔中有詳細描述了更多的高級選項,如:自定義序列化程式碼等。
如果你的對象很大,你可能需要增大 spark.kryoserializer.buffer 配置項。其值至少需要大於最大對象的序列化長度。
最後,如果你不註冊需要序列化的自定義類型,Kryo也能工作,不過每一個對象實例的序列化結果都會包含一份完整的類名,這有點浪費空間。
記憶體調優
記憶體佔用調優主要需要考慮3點:數據佔用的總記憶體(你會希望整個數據集都能裝進記憶體);訪問數據集中每個對象的開銷;垃圾回收的開銷(如果你的數據集中對象周轉速度很快的話)。
一般情況下,Java對象的訪問時很快的,但同時Java對象會比原始數據(僅包含各個欄位值)佔用的空間多2~5倍。主要原因有:
- 每個
Java對象都有一個對象頭(object header),對象頭大約佔用16位元組,其中包含像其對應class的指針這樣的資訊。對於一些包含較少數據的對象(比如只包含一個Int欄位),這個對象頭可能比對象數據本身還大。 Java字元串(String)有大約40位元組額外開銷(Java String以Char數據的形式保存原始數據,所以需要一些額外的欄位,如數組長度等),並且每個字元都以兩位元組的UTF-16編碼在內部保存。因此,10個字元的String很容易就佔了60位元組。- 一些常見的集合類,如
HashMap、LinkedList,使用的是鏈表類數據結構,因此它們對每項數據都有一個包裝器。這些包裝器對象不僅其自身就有「對象頭」,同時還有指向下一個包裝器對象的鏈表指針(通常為8位元組)。 - 原始類型的集合通常也是以「裝箱」的形式包裝成對象(如:
java.lang.Integer)。
本節只是Spark記憶體管理的一個概要,下面我們會更詳細地討論各種Spark記憶體調優的具體策略。特別地,我們會討論如何評估數據的記憶體使用量,以及如何改進 – 要麼改變你的數據結構,要麼以某種序列化格式存儲數據。 最後,我們還會討論如何調整Spark的快取大小,以及如何調優Java的垃圾回收器。
記憶體管理概覽
Spark中記憶體主要用於兩類目的:執行計算和數據存儲。執行計算的記憶體主要用於Shuffle、關聯(join)、排序(sort)以及聚合(aggregation),而數據存儲的記憶體主要用於快取和集群內部數據傳播。Spark中執行計算和數據存儲都是共享同一個記憶體區域(M)。 如果執行計算沒有佔用記憶體,那麼數據存儲可以申請佔用所有可用的記憶體,反之亦然。執行計算可能會搶佔數據存儲使用的記憶體,並將存儲於記憶體的數據逐出記憶體,直到數據存儲佔用的記憶體比例降低到一個指定的比例(R)。 換句話說,R是M基礎上的一個子區域,這個區域的記憶體數據永遠不會被逐出記憶體。然而,數據存儲不會搶佔執行計算的記憶體。
這樣設計主要有這麼幾個需要考慮的點。首先,不需要快取數據的應用可以把整個空間用來執行計算,從而避免頻繁地把數據吐到磁碟上。其次,需要快取數據的應用能夠有一個數據存儲比例(R)的最低保證,也避免這部分快取數據被全部逐出記憶體。最後,這個實現方式能夠在默認情況下,為大多數使用場景提供合理的性能,而不需要專家級用戶來設置記憶體使用如何劃分。
雖然有兩個記憶體劃分相關的配置參數,但一般來說,用戶不需要設置,因為默認值已經能夠適用於絕大部分的使用場景:
spark.memory.fraction:表示上面M的大小,其值為相對於JVM堆記憶體的比例(默認0.75)。剩餘的25%是為其他用戶的數據結構、Spark內部元數據以及避免OOM錯誤的安全預留空間。spark.memory.storageFraction:表示上面R的大小,其值為相對於M的一個比例(默認0.5)。R是M中專門用於快取數據塊的部分,這部分數據塊永遠不會因執行計算任務而逐出記憶體。
評估記憶體消耗
確定一個數據集佔用記憶體總量最好的辦法就是,創建一個RDD,並快取到記憶體中,然後再到web UI上」Storage」頁面查看。頁面上會展示這個RDD總共佔用了多少記憶體。
要評估一個特定對象的記憶體佔用量,可以用 SizeEstimator.estimate 方法。這個方法對試驗哪種數據結構能夠裁剪記憶體佔用量比較有用,同時,也可以幫助用戶了解廣播變數在每個執行器堆上佔用的記憶體量。
數據結構調優
減少記憶體消耗的首要方法就是避免過多的Java封裝(減少對象頭和額外輔助欄位),比如基於指針的數據結構和包裝對象等。以下有幾條建議:
- 設計數據結構的時候,優先使用對象數組和原生類型,減少對複雜集合類型(如:
HashMap)的使用。fastutil提供了一些很方便的原生類型集合,同時兼容Java標準庫。 - 儘可能避免嵌套大量的小對象和指針。
- 對應鍵值應盡量使用數值型或枚舉型,而不是字元串型。
- 如果記憶體小於
32GB,可以設置JVM標誌參數-XX:+UseCompressdOops將指針設為4位元組而不是8位元組。你可以在spark-env.sh中設置這個參數。
序列化RDD存儲
如果經過上面的調整後,存儲的數據對象還是太大,那麼你可以試試將這些對象以序列化格式存儲,所需要做的只是通過 RDD persistence API 設置好存儲級別,如:MEMORY_ONLY_SER。Spark會將RDD的每個分區以一個巨大的位元組數組形式存儲起來。以序列化格式存儲的唯一缺點就是訪問數據會變慢一點,因為Spark需要反序列化每個被訪問的對象。 如果你需要序列化快取數據,我們強烈建議你使用Kryo,和Java序列化相比,Kryo能大大減少序列化對象佔用的空間(當然也比原始Java對象小很多)。
垃圾回收調優
JVM的垃圾回收在某些情況下可能會造成瓶頸,比如,你的RDD存儲經常需要「換入換出」(新RDD搶佔了老RDD記憶體,不過如果你的程式沒有這種情況的話那JVM垃圾回收一般不是問題,比如,你的RDD只是載入一次,後續只是在這一個RDD上做操作)。當Java需要把老對象逐出記憶體的時候,JVM需要跟蹤所有的Java對象,並找出哪些對象已經沒有用了。 概括起來就是,垃圾回收的開銷和對象個數成正比,所以減少對象的個數(比如用Int數組取代LinkedList),就能大大減少垃圾回收的開銷。 當然,一個更好的方法就如前面所說的,以序列化形式存儲數據,這時每個RDD分區都只包含有一個對象了(一個巨大的位元組數組)。在嘗試其他技術方案前,首先可以試試用序列化RDD的方式(serialized caching)評估一下GC是不是一個瓶頸。
如果你的作業中各個任務需要的工作記憶體和節點上存儲的RDD快取佔用的記憶體產生衝突,那麼GC很可能會出現問題。下面我們將討論一下如何控制好RDD快取使用的記憶體空間,以減少這種衝突。
衡量GC的影響
GC調優的第一步是統計一下,垃圾回收啟動的頻率以及GC所使用的總時間。給JVM設置一下這幾個參數(參考Spark配置指南,查看Spark作業中的Java選項參數):-verbose:gc -XX:+PrintGCDetails,就可以在後續Spark作業的worker日誌中看到每次GC花費的時間。 注意,這些日誌是在集群worker節點上(在各節點的工作目錄下stdout文件中),而不是你的驅動器所在節點。
高級GC調優
為了進一步調優GC,我們就需要對JVM記憶體管理有一個基本的了解:
Java堆記憶體可分配的空間有兩個區域:新生代(Young generation)和老年代(Old generation)。新生代用以保存生存周期短的對象,而老年代則是保存生存周期長的對象。- 新生代區域被進一步劃分為三個子區域:
Eden,Survivor1,Survivor2。 - 簡要描述一下垃圾回收的過程:如果
Eden區滿了,則啟動一輪minor GC回收Eden中的對象,生存下來(沒有被回收掉)的Eden中的對象和Survivor1區中的對象一併複製到Survivor2中。 兩個Survivor區域是互相切換使用的(就是說,下次從Eden和Survivor2中複製到Survivor1中)。如果某個對象的年齡(每次GC所有生存下來的對象長一歲)超過某個閾值,或者Survivor2(下次是Survivor1)區域滿了,則將對象移到老年代(Old區)。最終如果老生代也滿了,就會啟動full GC。
Spark GC調優的目標就是確保老年代(Old generation )只保存長生命周期RDD,而同時新生代(Young generation)的空間又能足夠保存短生命周期的對象。這樣就能在任務執行期間,避免啟動full GC。以下是GC調優的主要步驟:
- 從
GC的統計日誌中觀察GC是否啟動太多。如果某個任務結束前,多次啟動了full GC,則意味著用以執行該任務的記憶體不夠。 - 如果
GC統計資訊中顯示,老生代記憶體空間已經接近存滿,可以通過降低spark.memory.storageFraction來減少RDD快取佔用的記憶體;減少快取對象總比任務執行緩慢要強! - 如果
major GC比較少,但minor GC很多的話,可以多分配一些Eden記憶體。你可以把Eden的大小設為高於各個任務執行所需的工作記憶體。如果要把Eden大小設為E,則可以這樣設置新生代區域大小:-Xmn=4/3*E。(放大4/3倍,主要是為了給Survivor區域保留空間) - 舉例來說,如果你的任務會從HDFS上讀取數據,那麼單個任務的記憶體需求可以用其所讀取的
HDFS數據塊的大小來評估。需要特別注意的是,解壓後的HDFS塊是解壓前的2~3倍。所以如果我們希望保留3~4個任務並行的工作記憶體,並且HDFS塊大小為64MB,那麼可以評估Eden的大小應該設為4*3*64MB。 - 最後,再觀察一下垃圾回收的啟動頻率和總耗時有沒有什麼變化。
我們的很多經驗表明,GC調優的效果和你的程式程式碼以及可用的總記憶體相關。網上還有不少調優的選擇,但總體來說,就是控制好full GC的啟動頻率,就能有效減少垃圾回收開銷。
其他事項
並行度
一般來說集群並不會滿負荷運轉,除非你把每個操作的並行度都設得足夠大。Spark會自動根據對應的輸入文件大小來設置「map」類運算元的並行度(當然你可以通過一個SparkContext.textFile等函數的可選參數來控制並行度),而對於想 groupByKey 或reduceByKey這類 「reduce」 運算元,會使用其各父RDD分區數的最大值。你可以將並行度作為構建RDD第二個參數(參考spark.PairRDDFunctions),或者設置 spark.default.parallelism 這個默認值。一般來說,評估並行度的時候,我們建議2~3個任務共享一個CPU。
Reduce任務的記憶體佔用
如果RDD比記憶體要大,有時候你可能收到一個OutOfMemoryError錯誤,其實這是因為你的任務集中的某個任務太大了,如reduce任務groupByKey。Spark的Shuffle運算元(sortByKey,groupByKey,reduceByKey,join等)會在每個任務中構建一個哈希表,以便在任務中對數據分組,這個哈希表有時會很大。最簡單的修復辦法就是增大並行度,以減小單個任務的輸入集。Spark對於200ms以內的短任務支援非常好,因為Spark可以跨任務復用執行器JVM,任務的啟動開銷很小,因此把並行度增加到比集群中總CPU核數沒有任何問題。
廣播大變數
使用SparkContext中的廣播變數相關功能(broadcast functionality)能大大減少每個任務本身序列化的大小,以及集群中啟動作業的開銷。如果你的Spark任務正在使用驅動程式中定義的巨大對象(比如:靜態查詢表),請考慮使用廣播變數替代。Spark會在master上將各個任務的序列化後大小列印出來,所以你可以檢查一下各個任務是否過大;通常來說,大於20KB的任務就值得優化一下。
數據本地性
數據本地性對Spark作業往往會有較大的影響。如果程式碼和其所操作的數據在同一節點上,那麼計算速度肯定會更快一些。但如果二者不在一起,那必然需要移動其中之一。一般來說,移動序列化好的程式碼肯定比挪動一大堆數據要快。Spark就是基於這個一般性原則來構建數據本地性的調度。
數據本地性是指程式碼和其所處理的數據的距離。基於數據當前的位置,數據本地性可以劃分成以下幾個層次(按從近到遠排序):
PROCESS_LOCAL數據和運行的程式碼處於同一個JVM進程內。NODE_LOCAL數據和程式碼處於同一節點。例如,數據處於HDFS上某個節點,而對應的執行器(executor)也在同一個機器節點上。這會比PROCESS_LOCAL稍微慢一些,因為數據需要跨進程傳遞。NO_PREF數據在任何地方處理都一樣,沒有本地性偏好。RACK_LOCAL數據和程式碼處於同一個機架上的不同機器。這時,數據和程式碼處於不同機器上,需要通過網路傳遞,但還是在同一個機架上,一般也就通過一個交換機傳輸即可。ANY數據在網路中未知,即數據和程式碼不在同一個機架上。
Spark傾向於讓所有任務都具有最佳的數據本地性,但這並非總是可行的。某些情況下,可能會出現一些空閑的執行器(executor)沒有待處理的數據,那麼Spark可能就會犧牲一些數據本地性。有兩種可能的選項:a)等待已經有任務的CPU,待其釋放後立即在同一台機器上啟動一個任務;b)立即在其他節點上啟動新任務,並把所需要的數據複製過去。
通常,Spark會等待一會,看看是否有CPU會被釋放出來。一旦等待超時,則立即在其他節點上啟動並將所需的數據複製過去。數據本地性各個級別之間的回落超時可以單獨配置,也可以在統一參數內一起設定;詳細請參考 configuration page 中的 spark.locality 相關參數。如果你的任務執行時間比較長並且數據本地性很差,你就應該試試調大這幾個參數,不過默認值一般都能適用於大多數場景了。

