
Spark簡單介紹,Windows下安裝Scala+Hadoop+Spark運行環境,集成到IDEA中
- 2022 年 11 月 3 日
- 筆記
一、前言 近几年大数据是异常的火爆,今天小编以java开发的身份来会会大数据,提高一下自己的层面! 大数据技术也是有很多: Hadoop Spark Flink 小编也只知道这些了,由于 Hadoop ,存在一定的缺陷(循环迭代式数据流处理:多 并行运行的数据可复用场景 效率不行 )。所以 Spar …
Continue Reading一、前言 近几年大数据是异常的火爆,今天小编以java开发的身份来会会大数据,提高一下自己的层面! 大数据技术也是有很多: Hadoop Spark Flink 小编也只知道这些了,由于 Hadoop ,存在一定的缺陷(循环迭代式数据流处理:多 并行运行的数据可复用场景 效率不行 )。所以 Spar …
Continue Reading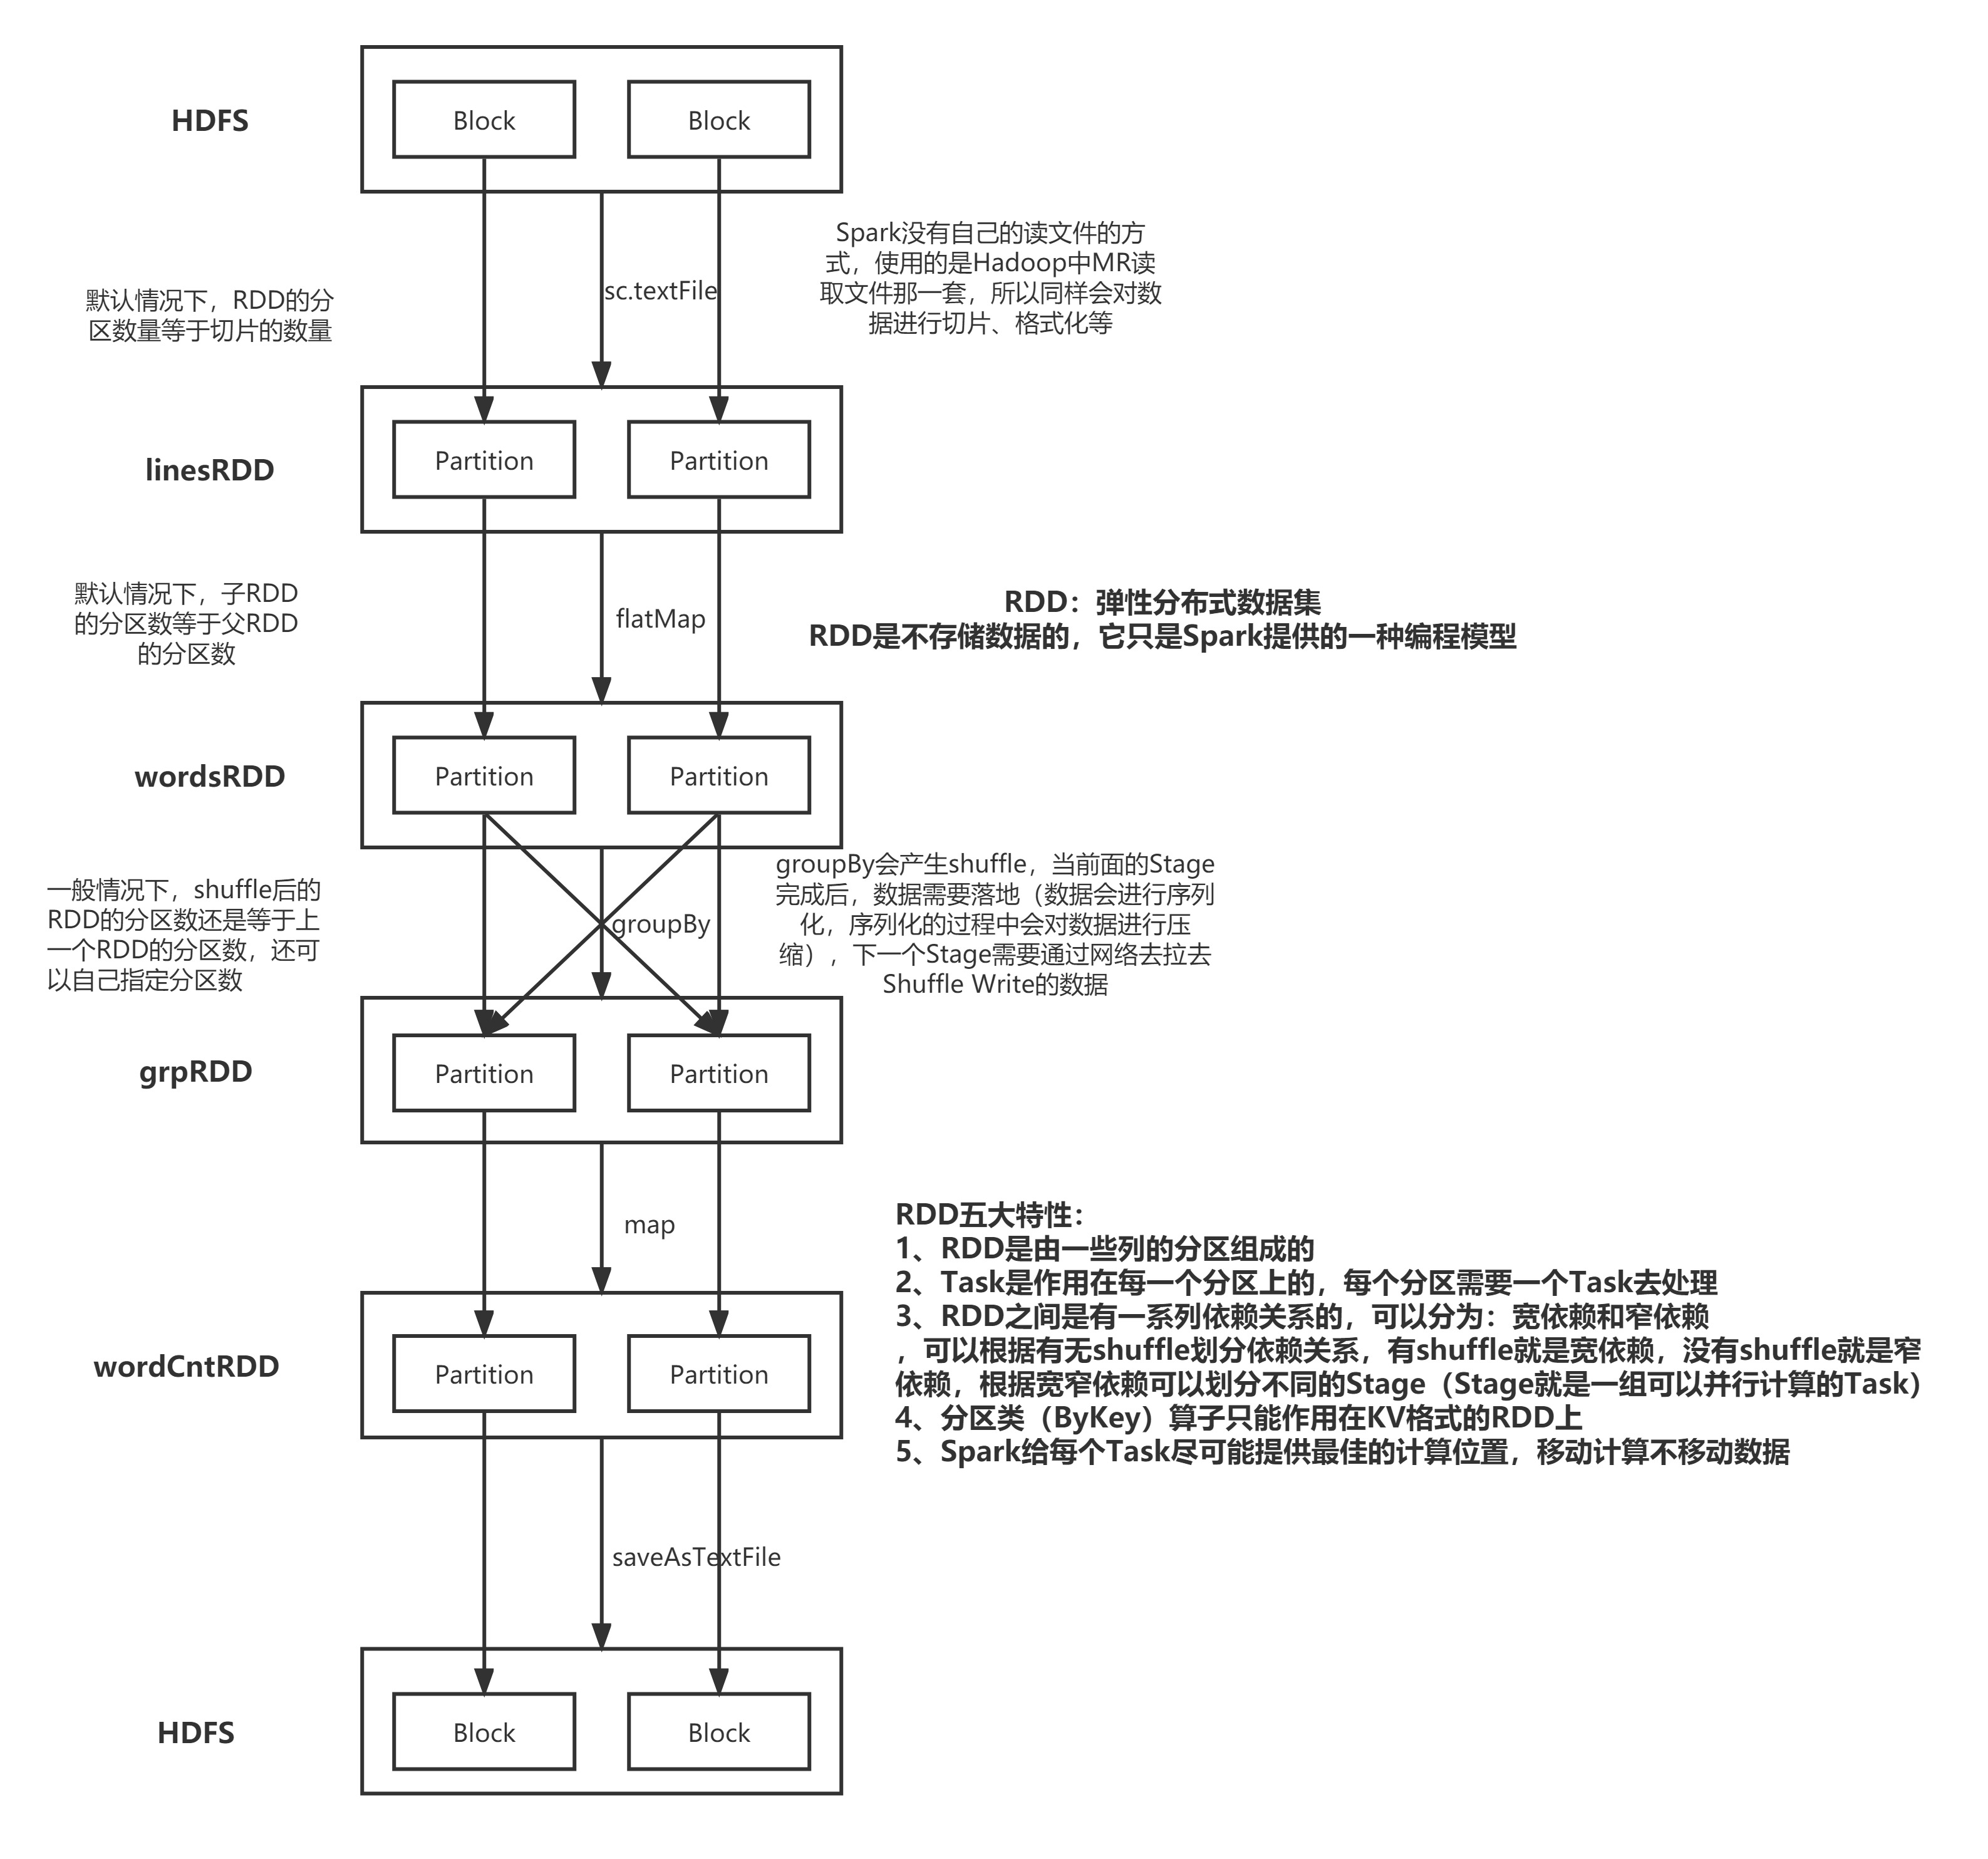
RDD(弹性分布式数据集)及常用算子 RDD(Resilient Distributed Dataset)叫做弹性分布式数据集,是 Spark 中最基本的数据 处理模型。代码中是一个抽象类,它代表一个弹性的、不可变、可分区、里面的元素可并行 计算的集合。 弹性 存储的弹性:内存与磁盘的自动切换; 容 …
Continue Reading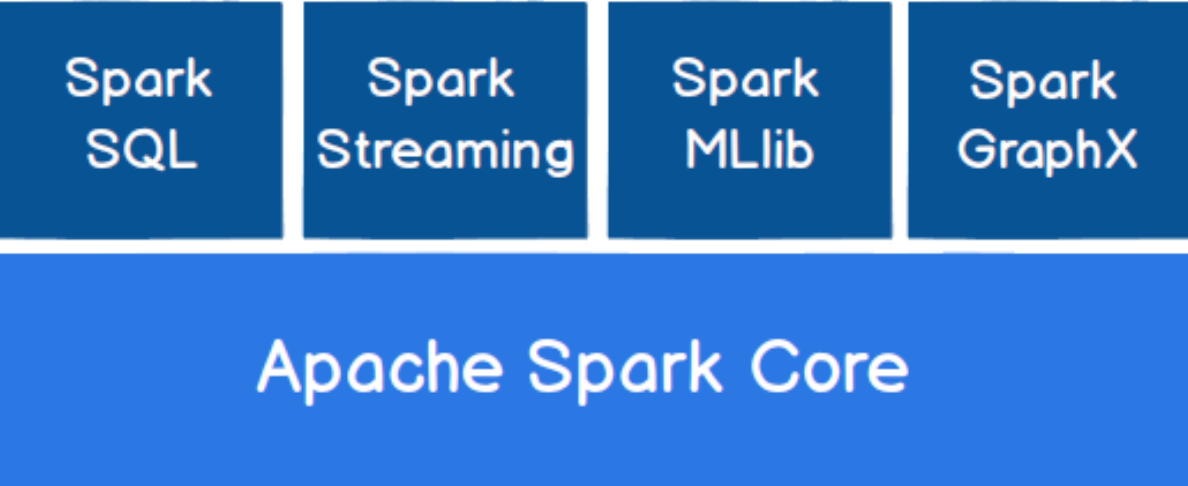
Spark基本知识 Spark 是一种基于内存的快速、通用、可扩展的大数据分析计算引擎。 spark与hadoop的区别 Hadoop Hadoop 是由 java 语言编写的,在分布式服务器集群上存储海量数据并运行分布式 分析应用的开源框架 作为 Hadoop 分布式文件系统,HDFS 处于 Ha …
Continue Reading
1.概述 本篇博客将对Ignite的基础环境、集群快照、分布式计算、SQL查询与处理、机器学习等内容进行介绍。 2.内容 2.1 什么是Ignite? 在学习Ignite之前,我们先来了解一下什么是Ignite?首先,Ignite是Apache开源的顶级项目之一。Ignite 内存数组组织框架是一个 …
Continue Reading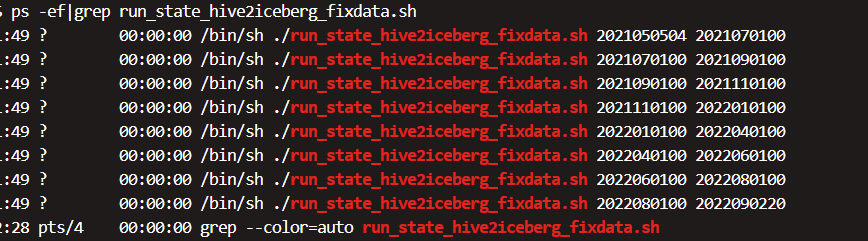
感悟:有时候很简单的笨办法,比那些高大上的技术要实用的多。 有一个数据同步,大约4亿条记录,没有分区。现在要按照天,小时分区写入到iceberg的分区表中。 源数据中本身就是很多几十k大小的非常多的小文件。 于是在读取时,总想着要shuffle,合并小文件,于是是这样的: hive_df = spa …
Continue Reading💡 作者: 韩信子 @ ShowMeAI 📘 大数据技术 ◉ 技能提升系列 : //www.showmeai.tech/tutorials/84 📘 行业名企应用系列 : //www.showmeai.tech/tutorials/63 📘 本文地址 : //www.showmeai.tech/ar …
Continue Reading
摘要: 由于目标和现实的错位,对很多用户来讲,Hadoop成了一个在技术、应用和成本上都很沉重的产品。 本文分享自华为云社区《 Hadoop Spark太重,esProc SPL很轻 》,作者:石臻臻的杂货铺。 随着大数据时代的来临,数据量不断增长,传统小机上跑数据库的模式扩容困难且成本高昂,难以支 …
Continue Reading
1.概述 Kafka系统的灵活多变,让它拥有丰富的拓展性,可以与第三方套件很方便的对接。例如,实时计算引擎Spark。接下来通过一个完整案例,运用Kafka和Spark来合理完成。 2.内容 2.1 初始Spark 在大数据应用场景中,面对实时计算、处理流数据、降低计算耗时等问题时,Apache S …
Continue Reading
作者:vivo 互联网服务器团队-Tang Shutao 现如今推荐无处不在,例如抖音、淘宝、京东App均能见到推荐系统的身影,其背后涉及许多的技术。本文以经典的协同过滤为切入点,重点介绍了被工业界广泛使用的矩阵分解算法,从理论与实践两个维度介绍了该算法的原理,通俗易懂,希望能够给大家带来一些启发。 …
Continue Reading
计算机科学一大定律:许多看似过时的东西可能过一段时间又会以新的形式再次回归。 1 模型平均方法(MA) 1.1 算法描述与实现 我们在博客 《分布式机器学习:同步并行SGD算法的实现与复杂度分析(PySpark)》 中介绍的SSGD算法由于通信比较频繁,在通信与计算比较大时(不同节点位于不同的地理位 …
Continue Reading