KNN演算法之集美大學
- 2022 年 10 月 31 日
- 筆記
在本篇文章中,我即將以在集美大學收集到的一些數據集為基礎,使用KNN演算法進行一系列的操作
一、KNN演算法
首先,什麼是KNN演算法呢,這得用到老祖宗說的一句話「近朱者赤近墨者黑」,簡單來講就是,一個物體它靠近什麼,我們也可以認為它就是什麼。此演算法運用廣泛,生活中就有體現。比如,你是否發現,你好朋友刷到的抖音影片,你也可能提前刷到過,這就是KNN。
KNN也叫K近鄰(K-Nearest Neighbor, KNN)是一種最經典和最簡單的有監督學習方法之一。K-近鄰演算法是最簡單的分類器,沒有顯式的學習過程或訓練過程,是懶惰學習(Lazy Learning)。當對數據的分布只有很少或者沒有任何先驗知識時,K 近鄰演算法是一個不錯的選擇。
二、K自製數據集(基於集美大學)
集美大學於1918年始建,這所大學的名字很有意思,單純從字面上看,這是一所集美麗於一身的大學。集美大學也正如名字所說,不僅學校美,周圍的環境也跟著美。因為這所大學所在的地區被當地叫做集美學村,這個集美學村是一個旅遊區,其中還包含了許多學府,從小學到大學一應俱全,集美大學就在其中,這裡給人的感覺很大很美,既適合出行旅遊觀光,又是學術氛圍濃厚之地。在集美大學讀書感覺猶如在旅遊一般,對於學生來說是一種美好的享受。
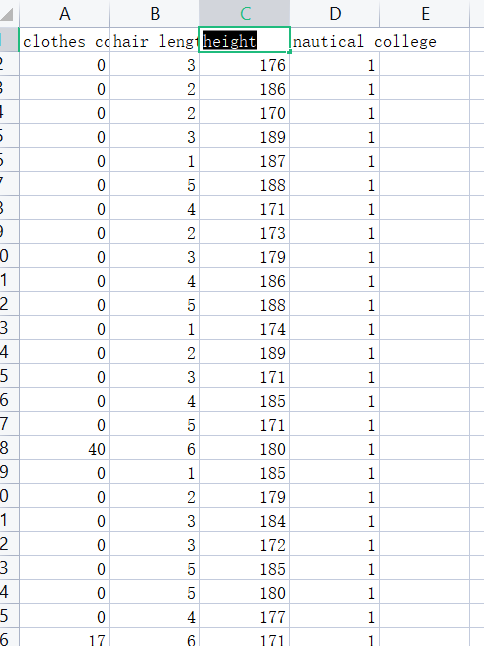
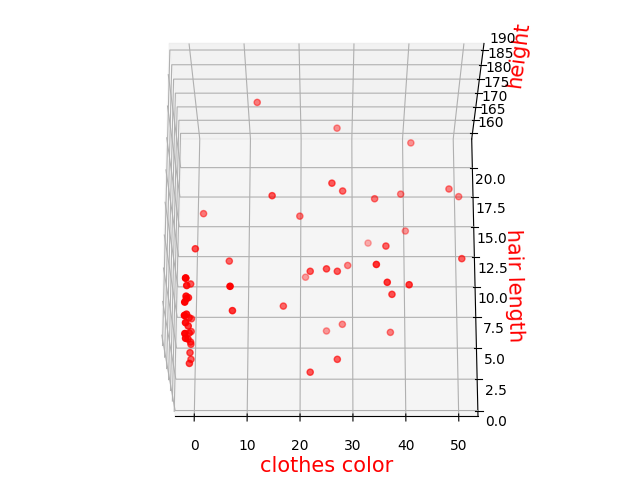
眾所周知,航海是集美大學的特色專業,我運用Excel手動製作了一些數據,內容為航海學院和其他學院的學生數據差異。航海學院紀律嚴格,判斷一個學生是不是航海學院的學子可以從以下角度分析:clothes color(航海學院身穿制度,顏色較為統一),hair length,height。如果是航海學院則nautical college置為1。還有數據三維散點圖如下。

三、程式碼部分(主要運用了sklearn,pandas工具包)
1.預測
    file = "sklearn/file/JMU.csv"
    data = pd.read_csv(file)
    lable = data.iloc[:, -1]
    feature = data.iloc[:, :3]
    # 2.劃分數據集
    x_train, x_test, y_train, y_test = train_test_split(feature, lable, test_size=0.2)
    #網格搜索和交叉驗證
    para_dic={"n_neighbors":[i for i in range(1,20)]}
    estimator=KNeighborsClassifier()
    estimator=GridSearchCV(estimator,param_grid=para_dic)
    estimator.fit(x_train,y_train)
    # 模型評估
    #1.比對真實值與預測值
    # y_pre=estimator.predict(x_test)
    # print("y_pre:\n",y_pre)
    # print(y_pre==y_test)
    #2.計算準確率
    score=estimator.score(x_test,y_test)
    print("準確率:\n",score)

    # 最佳參數
    print("最佳參數:\n",estimator.best_params_)
    # 最佳結果
    print("最佳結果:\n",estimator.best_score_)
    # 最佳估計器
    print("最佳估計器:\n",estimator.best_estimator_)
準確率:
0.9166666666666666
最佳參數:
{'n_neighbors': 1}
最佳結果:
0.8936170212765957
最佳估計器:
KNeighborsClassifier(algorithm='auto', leaf_size=30, metric='minkowski',
metric_params=None, n_jobs=1, n_neighbors=1, p=2,
weights='uniform')
Process finished with exit code 0
2.作圖
    x = data.iloc[:, 0]
    y = data.iloc[:, 1]
    z = data.iloc[:, 2]
    # 繪製散點圖
    fig = plt.figure()
    ax = Axes3D(fig)
    ax.scatter(x, y, z, color='r')

    # 添加坐標軸(順序是Z, Y, X)
    ax.set_zlabel('height', fontdict={'size': 15, 'color': 'red'})
    ax.set_ylabel('hair length', fontdict={'size': 15, 'color': 'red'})
    ax.set_xlabel('clothes color', fontdict={'size': 15, 'color': 'red'})
    plt.show()
3.結果分析
通過網格搜索1到20的K值結果可知,最優K取值為1。也就是說找最近的一位同學是否屬於航海學院,就能大概率判斷這位未知同學是否也為海院學子。
思考,為什麼會是K=1呢,通過散點圖可以清楚看出,海院學子特徵比較集中,所以只要距離海院學子特徵最近,就大概率為海院學子。
