(數據科學學習手札136)Python中基於joblib實現極簡併行計算加速
本文示例程式碼及文件已上傳至我的
Github倉庫//github.com/CNFeffery/DataScienceStudyNotes
1 簡介
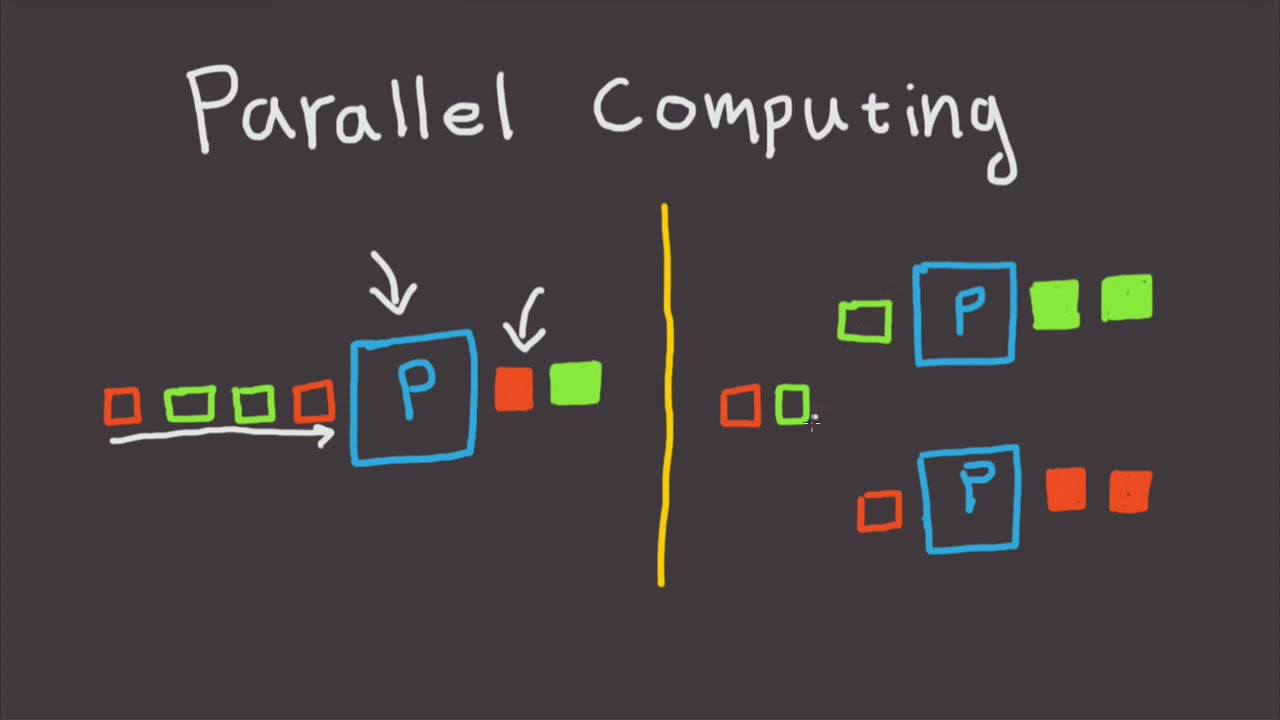
我們在日常使用Python進行各種數據計算處理任務時,若想要獲得明顯的計算加速效果,最簡單明了的方式就是想辦法將默認運行在單個進程上的任務,擴展到使用多進程或多執行緒的方式執行。
而對於我們這些從事數據分析工作的人員而言,以最簡單的方式實現等價的加速運算的效果尤為重要,從而避免將時間過多花費在編寫程式上。而今天的文章費老師我就來帶大家學習如何利用joblib這個非常簡單易用的庫中的相關功能,來快速實現並行計算加速效果。
2 使用joblib進行並行計算
作為一個被廣泛使用的第三方Python庫(譬如scikit-learn項框架中就大量使用joblib進行眾多機器學習演算法的並行加速),我們可以使用pip install joblib對其進行安裝,安裝完成後,下面我們來學習一下joblib中有關並行運算的常用方法:
2.1 使用Parallel與delayed進行並行加速
joblib中實現並行計算只需要使用到其Parallel和delayed方法即可,使用起來非常簡單方便,下面我們直接以一個小例子來演示:
joblib實現並行運算的思想是將一組通過循環產生的串列計運算元任務,以多進程或多執行緒的方式進行調度,而我們針對自定義的運算任務需要做的僅僅是將它們封裝為函數的形式即可,譬如:
import time

def task_demo1():

    time.sleep(1)

    return time.time()
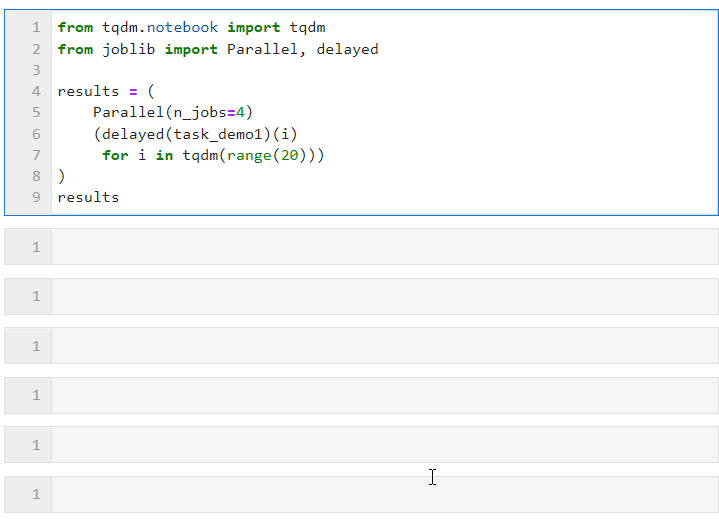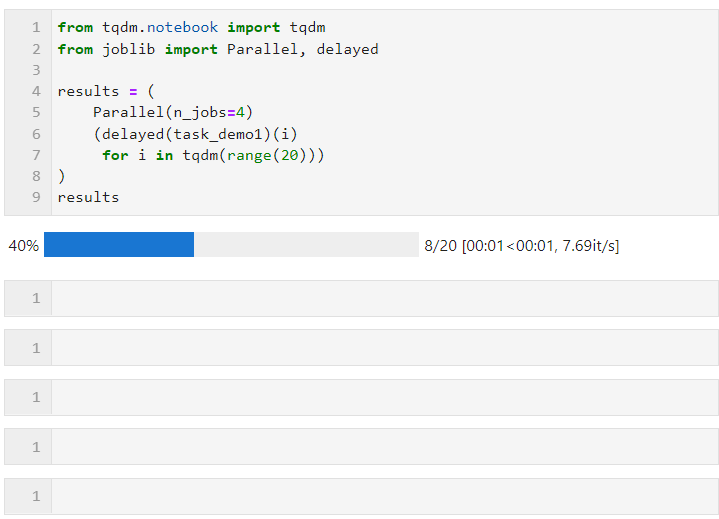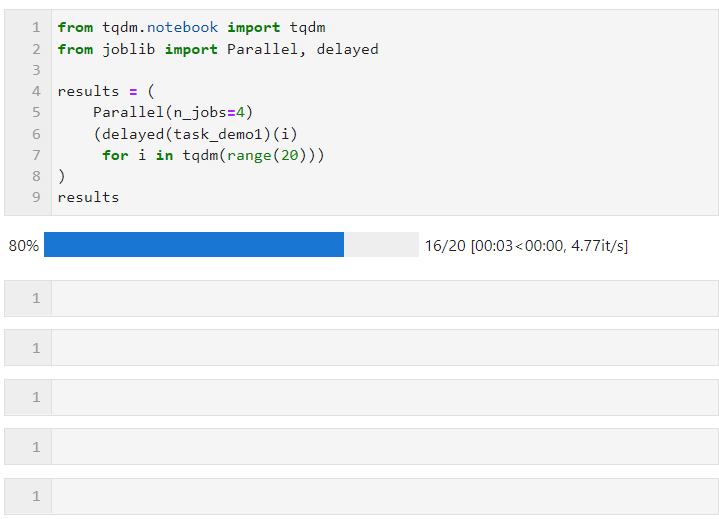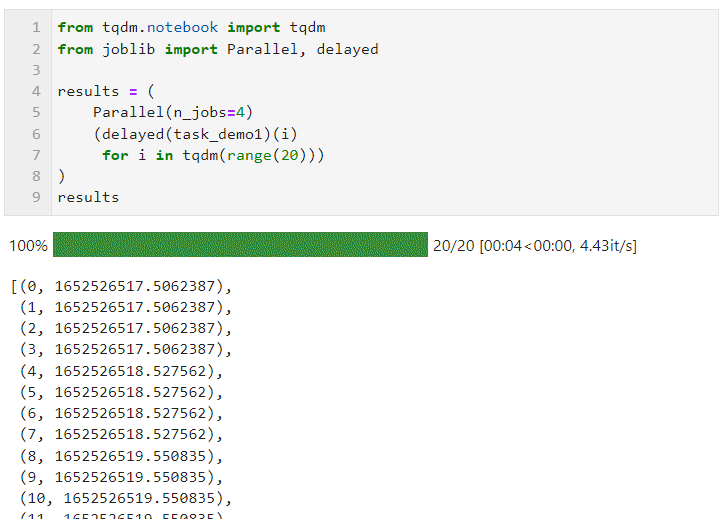
接著只需要像下面的形式一樣,為Parallel()設置相關參數後,銜接循環創建子任務的列表推導過程,其中利用delayed()包裹自定義任務函數,再銜接()傳遞任務函數所需的參數即可,其中n_jobs參數用於設置並行任務同時執行的worker數量,因此在這個例子中可以看到進度條是按照4個一組遞增的,可以看到最終時間開銷也達到了並行加速效果:
其中可以根據計算任務以及機器CPU核心數具體情況為Parallel()調節參數,核心參數有:
- backend:用於設置並行方式,其中多進程方式有
'loky'(更穩定)和'multiprocessing'兩種可選項,多執行緒有'threading'一種選項。默認為'loky' - n_jobs:用於設置並行任務同時執行的worker數量,當並行方式為多進程時,
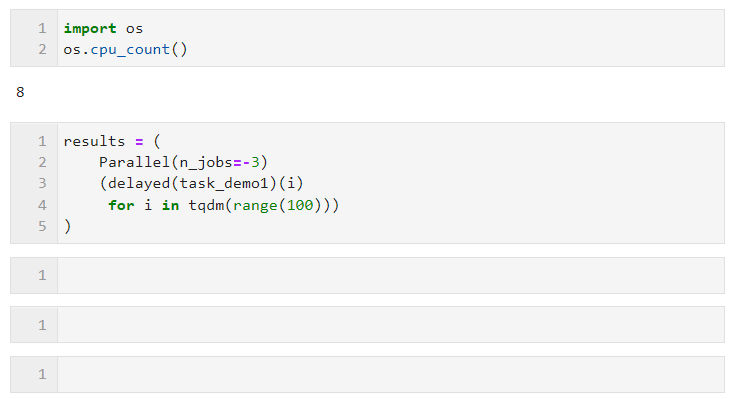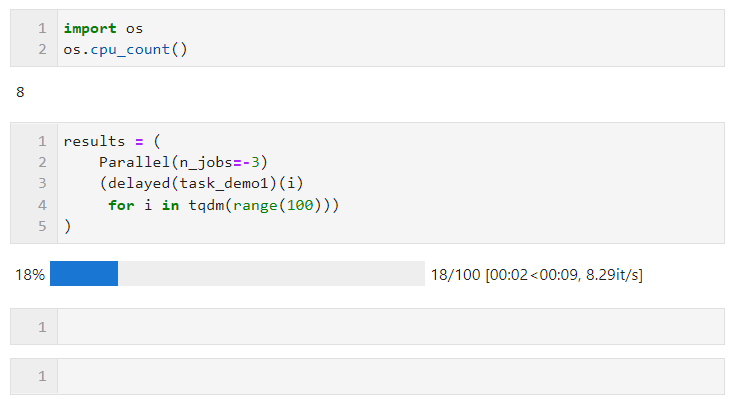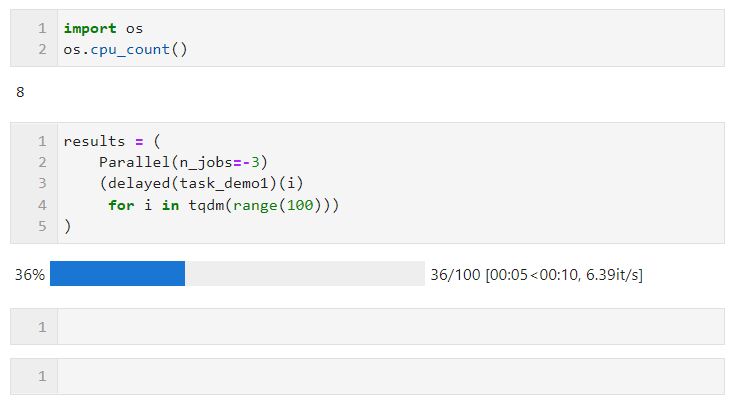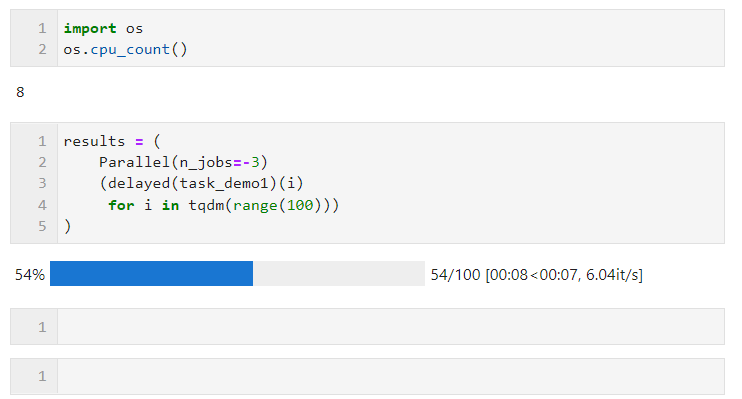
n_jobs最多可設置為機器CPU邏輯核心數量,超出亦等價於開啟全部核心,你也可以設置為-1來快捷開啟全部邏輯核心,若你不希望全部CPU資源均被並行任務佔用,則可以設置更小的負數來保留適當的空閑核心,譬如設置為-2則開啟全部核心-1個核心,設置為-3則開啟全部核心-2個核心
譬如下面的例子,在我這台邏輯核心數為8的機器上,保留兩個核心進行並行計算:
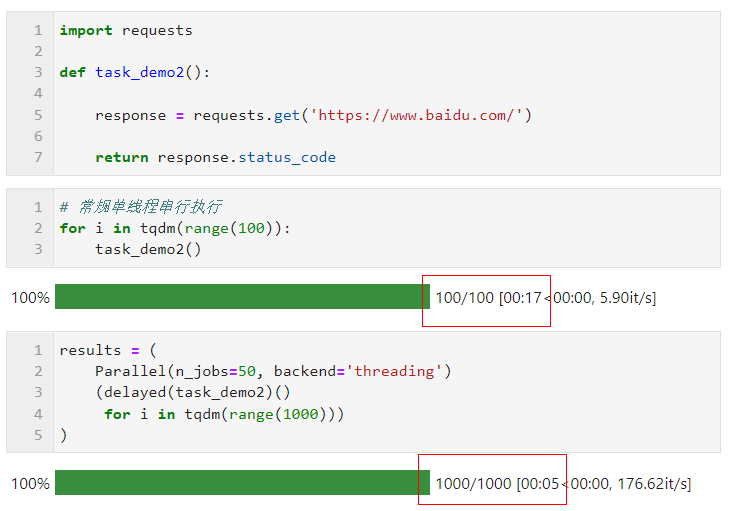
關於並行方式的選擇上,由於Python中多執行緒時全局解釋器鎖的限制,如果你的任務是計算密集型,則推薦使用默認的多進程方式加速,如果你的任務是IO密集型譬如文件讀寫、網路請求等,則多執行緒是更好的方式且可以將n_jobs設置的很大,舉個簡單的例子,可以看到,通過多執行緒並行,我們在5秒的時間裡完成了1000次請求,遠快於單執行緒17秒請求100次的成績:
你可以根據自己實際任務的不同,好好利用joblib來加速你的日常工作。
以上就是本文的全部內容,歡迎在評論區與我進行討論~