自動化不知如何參數化?xlrd來幫你解決
平時在做自動化測試的時候,一直都是要求數據與業務邏輯分離。把測試數據都寫在業務裡面的話,比較混雜。為了方便管理測試數據,所以引入了python的一個擴展庫--xlrd。該庫使用簡單,能滿足自動化測試的數據分離的需求。
閑語少聊,我們直接來看,xlrd是如何完成數據讀取的。
安裝
安裝很簡單,方式①:直接命令pip install xlrd;方式②:在Pycharm中直接安裝即可。
基礎命令
①打開excel文件並創建對象
excel_object = xlrd.open_workbook(excel_path)
②根據工作表名稱獲取數據
sheet_object = excel_object.sheet_by_name('Sheet1')
③獲取excel文件中所有工作表名稱
print(excel_object.sheet_names())
④獲取有效行數
row_nrows = sheet_object.nrows
⑤獲取有效列數
col_ncols = sheet_object.ncols
⑥獲取當前行的單元格長度
row_length = sheet_object.row_len(1)
⑦獲取第一行數據
rows_cell_value = sheet_object.row_values(0)
⑧獲取坐標為第一行、第一列單元格數據
row_cell_value1 = sheet_object.cell_value(0, 0)# 坐標起始位從0開始
或者
row_cell_value1 = sheet_object.cell(0, 0).value
或者
row_cell_value1 = sheet_object.row(0)[0].value
⑨獲取坐標為第二行、第四列單元格數據
row_cell_value2 = sheet_object.cell_value(1, 3)
⑩獲取第四列數據
cols_cell_value = sheet_object.col_values(3)
單元格類型
單元格類型區分為六類,讀取單元格類型如下所示:
0 empty,1 string, 2 number, 3 date, 4 boolean, 5 error
cell_value_type1 = sheet_object.cell_type(2, 0)
或者
cell_value_type1 = sheet_object.cell(2, 0).value
命令實踐
我們來寫個例子驗證下這些命令,示例程式碼如下:
'''
@author: wenyihuqingjiu
@project: Pytest_Auto_Test
@file: demo
@time: 2020-07-23 21:40
@desc:
'''

import xlrd
import os

current_path = os.path.dirname(__file__)
excel_path = os.path.join(current_path, '..', 'file/excel/testcase.xlsx')
excel_object = xlrd.open_workbook(excel_path)
sheet_object = excel_object.sheet_by_name('Sheet1')
# 獲取第一行數據
rows_cell_value = sheet_object.row_values(0)
print('獲取到的第一行數據為:' + str(rows_cell_value))
# 獲取第一行、第一列單元格數據
row_cell_value1 = sheet_object.cell_value(0, 0)
print('獲取坐標為第一行、第一列單元格的數據為:' + row_cell_value1)
# 獲取第二行、第四列單元格數據
row_cell_value2 = sheet_object.cell_value(1, 3)
print('獲取坐標為第二行、第四列單元格的數據為:' + row_cell_value2)
# 獲取第四列數據
cols_cell_value = sheet_object.col_values(3)
print('獲取第四列的數據為:' + str(cols_cell_value))
# 獲取單元格類型
# 0 empty,1 string, 2 number, 3 date, 4 boolean, 5 error
cell_value_type1 = sheet_object.cell_type(2, 0)
print('單元格類型為:' + str(cell_value_type1))
cell_value_type2 = sheet_object.cell_type(1, 0)
print('單元格類型為:' + str(cell_value_type2))
cell_value_type3 = sheet_object.cell_type(1, 7)
print('單元格類型為:' + str(cell_value_type3))
cell_value_type4 = sheet_object.cell_type(1, 8)
print('單元格類型為:' + str(cell_value_type4))
cell_value_type5 = sheet_object.cell_type(2, 8)
print('單元格類型為:' + str(cell_value_type5))
# 獲取有效行數
row_nrows = sheet_object.nrows
print('當前sheet頁中有效行數為:' + str(row_nrows))
# 獲取有效列數
col_ncols = sheet_object.ncols
print('當前sheet頁中有效列數為:' + str(col_ncols))
# 獲取當前行的單元格長度
row_length = sheet_object.row_len(0)
print('第一行的有效單元格長度為:' + str(row_length))
# 獲取所有工作表名稱
print('當前excel中的工作表名稱為:'+ str(excel_object.sheet_names()))
excel文檔內容如下所示:
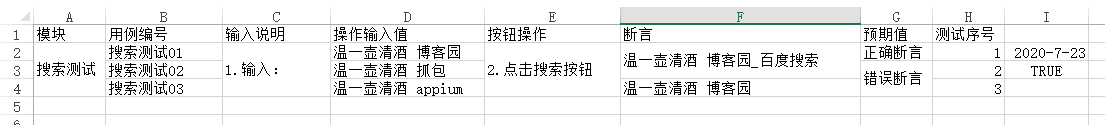
執行程式碼,我們結合excel文檔內容來對比看下輸出結果,如下所示:

我們從上述簡單的命令了解到,讀取數據的方式其實很簡單,程式碼中加上邏輯便可獲取整個sheet頁的數據,如下所示,獲取當前sheet頁的數據程式碼:
# 獲取有效行數
row_index = sheet_object.nrows
# 獲取有效列數
col_index = sheet_object.ncols
# 定義空數組
all_data_list = []
# 獲取首行數據
first_row = sheet_object.row_values(0)
for row in range(1, row_index):
    # 定義空列表
    row_dict = {}
    for col in range(col_index):
        c_cell = sheet_object.cell_value(row, col)
        # 循環每一個有效的單元格,將欄位與值對應存儲到字典中
        row_dict[first_row[col]] = c_cell
    # 再將字典追加到列表中
    all_data_list.append(row_dict)
    print(str(row_dict))
查看控制台,列印出來的數據如下所示:
excel文件內容還是如上截圖,可以對比查看下。
{'模組': '搜索測試', '用例編號': '搜索測試01', '輸入說明': '1.輸入:', '操作輸入值': '溫一壺清酒 部落格園', '按鈕操作': '2.點擊搜索按鈕', '斷言': '溫一壺清酒 部落格園_百度搜索', '預期值': '正確斷言', '測試序號': 1.0, '': 44035.0}
{'模組': '', '用例編號': '搜索測試02', '輸入說明': '', '操作輸入值': '溫一壺清酒 抓包', '按鈕操作': '', '斷言': '', '預期值': '錯誤斷言', '測試序號': 2.0, '': 1}
{'模組': '', '用例編號': '搜索測試03', '輸入說明': '', '操作輸入值': '溫一壺清酒 appium', '按鈕操作': '', '斷言': '溫一壺清酒 部落格園', '預期值': '', '測試序號': 3.0, '': ''}
我們從上述的列印數據來看,細心的博友們應該發現問題了。
我們可以看出,合併單元格的數據,只有首個單元格有數據顯示;單元格數據類型不正確。
數據轉換
今天,我們先來解決單元格數據類型顯示不正確的問題。
解決該問題的方式很簡單,就是將單元格類型獲取後,判斷單元格類型並轉換格式,示例程式碼如下所示:
'''
@author: wenyihuqingjiu
@project: Pytest_Auto_Test
@file: demo
@time: 2020-07-23 21:40
@desc:
'''

import xlrd
import os
import datetime
from xlrd import xldate_as_tuple

current_path = os.path.dirname(__file__)
excel_path = os.path.join(current_path, '..', 'file/excel/testcase.xlsx')
excel_object = xlrd.open_workbook(excel_path)
sheet_object = excel_object.sheet_by_name('Sheet1')

# 獲取有效行數
row_index = sheet_object.nrows
# 獲取有效列數
col_index = sheet_object.ncols
# 定義空數組
all_data_list = []
# 獲取首行數據
first_row = sheet_object.row_values(0)
for row in range(1, row_index):
    # 定義空列表
    row_dict = {}
    for col in range(col_index):
        c_cell = sheet_object.cell_value(row, col)
        # 獲取單元格數據類型
        c_type = sheet_object.cell(row, col).ctype
        if c_type == 2 and c_cell % 1 == 0:  # 如果是整形
            c_cell = int(c_cell)
        elif c_type == 3:
            # 轉成datetime對象
            date = datetime.datetime(*xldate_as_tuple(c_cell, 0))
            c_cell = date.strftime('%Y-%m-%d')
        elif c_type == 4:
            c_cell = True if c_cell == 1 else False
        # 循環每一個有效的單元格,將欄位與值對應存儲到字典中
        row_dict[first_row[col]] = c_cell
    # 再將字典追加到列表中
    all_data_list.append(row_dict)
    print(str(row_dict))
運行程式碼,我們再來看下列印結果,如下所示:
{'模組': '搜索測試', '用例編號': '搜索測試01', '輸入說明': '1.輸入:', '操作輸入值': '溫一壺清酒 部落格園', '按鈕操作': '2.點擊搜索按鈕', '斷言': '溫一壺清酒 部落格園_百度搜索', '預期值': '正確斷言', '測試序號': 1, '': '2020-07-23'}
{'模組': '', '用例編號': '搜索測試02', '輸入說明': '', '操作輸入值': '溫一壺清酒 抓包', '按鈕操作': '', '斷言': '', '預期值': '錯誤斷言', '測試序號': 2, '': True}
{'模組': '', '用例編號': '搜索測試03', '輸入說明': '', '操作輸入值': '溫一壺清酒 appium', '按鈕操作': '', '斷言': '溫一壺清酒 部落格園', '預期值': '', '測試序號': 3, '': ''}
格式轉換後,數據就列印正常了,數據類型錯誤的問題就解決了。
好了,今天的分享就到此結束啦,希望對博友們有幫助,下期分享獲取合併單元格數據問題,敬請期待。
