
Hive架構及搭建方式
- 2021 年 10 月 23 日
- 筆記
目录 前言 hive的基础知识 基本架构 metastore 内嵌服务和数据库 内嵌服务 服务和数据库单独部署 hcatalog 客户端 客户端的本地模式 beeline beeline的自动模式 jdbc 部署 部署hiveserver2 在hdfs中创建hive数据存放路径 配置hive的环境变 …
Continue Reading目录 前言 hive的基础知识 基本架构 metastore 内嵌服务和数据库 内嵌服务 服务和数据库单独部署 hcatalog 客户端 客户端的本地模式 beeline beeline的自动模式 jdbc 部署 部署hiveserver2 在hdfs中创建hive数据存放路径 配置hive的环境变 …
Continue Readingclickhouse 在数据分析技术领域早已声名远扬,如果还不知道可以 点这里 了解下。 最近由于项目需求使用到了 clickhouse 做分析数据库,于是用测试环境做了一个单表 6 亿数据量的性能测试,记录一下测试结果,有做超大数据量分析技术选型需求的朋友可以参考下。 服务器信息 CPU:Inte …
Continue Reading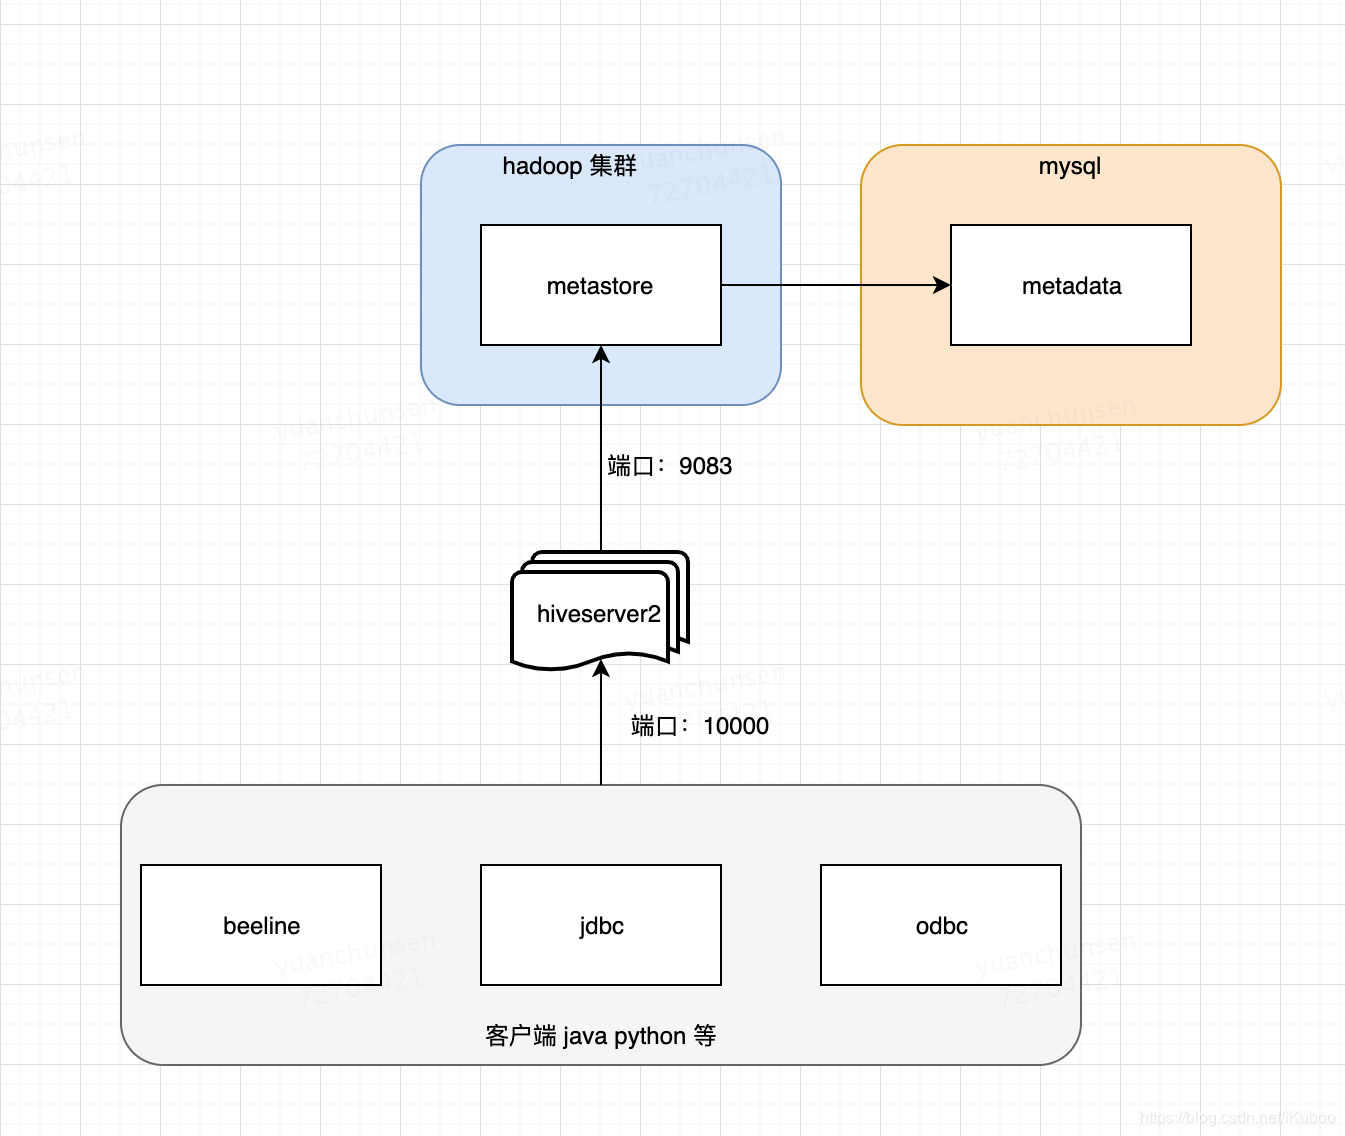
先解释一下几个名词: metadata :hive元数据,即hive定义的表名,字段名,类型,分区,用户这些数据。一般存储关系型书库mysql中,在测试阶段也可以用hive内置Derby数据库。 metastore :hivestore服务端。主要提供将DDL,DML等语句转换为MapReduce, …
Continue ReadingLag和Lead分析函数可以在同一次查询中取出同一字段的后N行的数据(Lag)和前N行的数据(Lead)作为独立的列。 这种操作可以代替表的自联接,并且LAG和LEAD有更高的效率,其中over()表示当前查询的结果集对象,括号里面的语句则表示对这个结果集进行处理。 1 LEAD 与LAG相反,LE …
Continue Reading
建模方法论 数仓的建模或者分层,其实都是为了更好的去组织、管理、维护数据,所以当你站在更高的维度去看的话,所有的划分都是为了更好的管理。小到JVM 内存区域的划分,JVM 中堆空间的划分(年轻代、老年代、方法区等),大到国家的省市区的划分,无一例外的都是为了更好的组织管理 访问性能 :能够快速查询所 …
Continue Reading
目录 1 引言 2 开发环境 3 基于 Mybatis-plus 集成多数据源的数据库访问 3.1 pom 文件中引入 Mybatis-plus 3.2 配置及使用多数据源 4 ExecutionContext 传递参数 4.1 ExecutionContext 概念 4.2 ExecutionCo …
Continue Reading
目前 CSDN , 博客园 , 简书 同步发表中,更多精彩欢迎访问我的 gitee pages 目录 Hadoop完全分布式运行模式 步骤分析: 编写集群分发脚本xsync 集群配置 集群部署规划 配置集群 集群单点启动 SSH无密登陆配置 登录状态的环境变量 群起集群 集群启动/停止方式总结 集群 …
Continue Reading
目前 CSDN , 博客园 , 简书 同步发表中,更多精彩欢迎访问我的 gitee pages Hadoop简介和安装及伪分布式 大数据概念 大数据概论 大数据(Big Data): 指 无法在一定时间范围 内用常规软件工具进行捕捉,管理和处理的数据集合,是需要新处理模式才能具有更强的决策力,洞察发 …
Continue Reading
目录 1 前言 2 分布式存储可靠性常用方法 2.1 冗余 2.2 校验 3 MinIO存储机制 3.1 概念理解 3.2 纠删码EC(Erasure Code) 3.3 存储形式 4 部署实践 4.1 单节点部署多磁盘 4.2 多节点部署 4.2.1 部署脚本 4.2.2 部署注意点 4.2.3 …
Continue ReadingHadoop环境搭建(centos) 本平台密码83953588abc 配置Java环境 下载JDK(本实验从/cgsrc 文件中复制到指定目录) mkdir /usr/local/java cp /cgsrc/jdk-8u171-linux-x64.tar.gz /usr/local/java/ …
Continue Reading