scrapy爬蟲案例--爬取陽關熱線問政平台
- 2021 年 5 月 8 日
- 筆記
阳光热线问政平台: //wz.sun0769.com/political/index/politicsNewest?id=1&page=1 爬取最新问政帖子的编号、投诉标题、投诉内容以及处理状态,并存入到Mongodb数据库中。 1、创建项目 scrapy startproject myProjec …
Continue Reading阳光热线问政平台: //wz.sun0769.com/political/index/politicsNewest?id=1&page=1 爬取最新问政帖子的编号、投诉标题、投诉内容以及处理状态,并存入到Mongodb数据库中。 1、创建项目 scrapy startproject myProjec …
Continue Reading
Scrapy Scrapy是纯python实现的一个为了爬取网站数据、提取结构性数据而编写的应用框架。 Scrapy使用了Twisted异步网络框架来处理网络通讯,可以加快我们的下载速度,并且包含了各种中间件接口,可以灵活的完成各种需求 1、安装 sudo pip3 install scrapy 2 …
Continue Reading
笔者最近对scrapy的学习可谓如火如荼,虽然但是,即使是一整天地学习下来也会有中间两三个小时的“无效学习”,不是笔者开小差,而是掉进了深坑出不来。 在此,给各位分享一下作为一名Scrapy框架的初学者,笔者在学习过程中遇到的各个大坑和小技巧吧。 1. user_agent 这个,在某些网站看来这无 …
Continue ReadingSelenium是一个Web的自动化测试工具,最初是为网站自动化测试而开发的,可以按指定的命令自动操作,但是他需要与第三方浏览器结合在一起才能使用。如果我们把 Selenium和第三方浏览器(比如Chrome)结合在一起,就可以运行一个非常强大的网络爬虫了,这个爬虫可以处理 JavaScrip、Co …
Continue ReadingBeautiful Soup 是一个HTML/XML的解析器,主要的功能也是如何解析和提取 HTML/XML 数据。 一、安装 pip install beautifulsoup4 二、使用 导入模块 from bs4 import BeautifulSoup 创建BeautifulSoup对象 I …
Continue Reading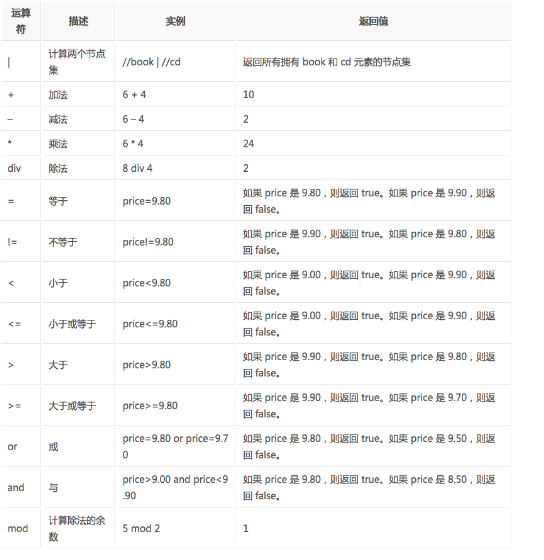
使用lxml之前,我们首先要会使用XPath。利用XPath,就可以将html文档当做xml文档去进行处理解析了。 一、XPath的简单使用: XPath (XML Path Language) 是一门在 XML 文档中查找信息的语言,可用来在 XML 文档中对元素和属性进行遍历。 1.开发工具的安 …
Continue Reading一、什么是正则表达式? 正则表达式,又称规则表达式,通常被用来检索、替换那些符合某个模式(规则)的文本。 正则表达式是对字符串操作的一种逻辑公式,就是用事先定义好的一些特定字符、及这些特定字符的组合,组成一个“规则字符串”,这个“规则字符串”用来表达对字符串的一种过滤逻辑。 二、正则表达式的匹配规则 …
Continue Readingurllib3是一个功能强大,对SAP健全的 HTTP客户端,许多Python生态系统已经使用了urllib3。 一、安装 sudo pips install urllib3 二、创建PoolManager对象 通过urllib3访问网页,首先需要构造一个PoolManager实例对象用于处理与线程 …
Continue Readingurllib是Python中请求url连接的官方标准库,在Python3中将Python2中的urllib和urllib2整合成了urllib。urllib中一共有四个模块,分别如下: request:主要负责构造和发起网络请求,定义了适用于在各种复杂情况下打开 URL (主要为 HTTP) 的函数 …
Continue Reading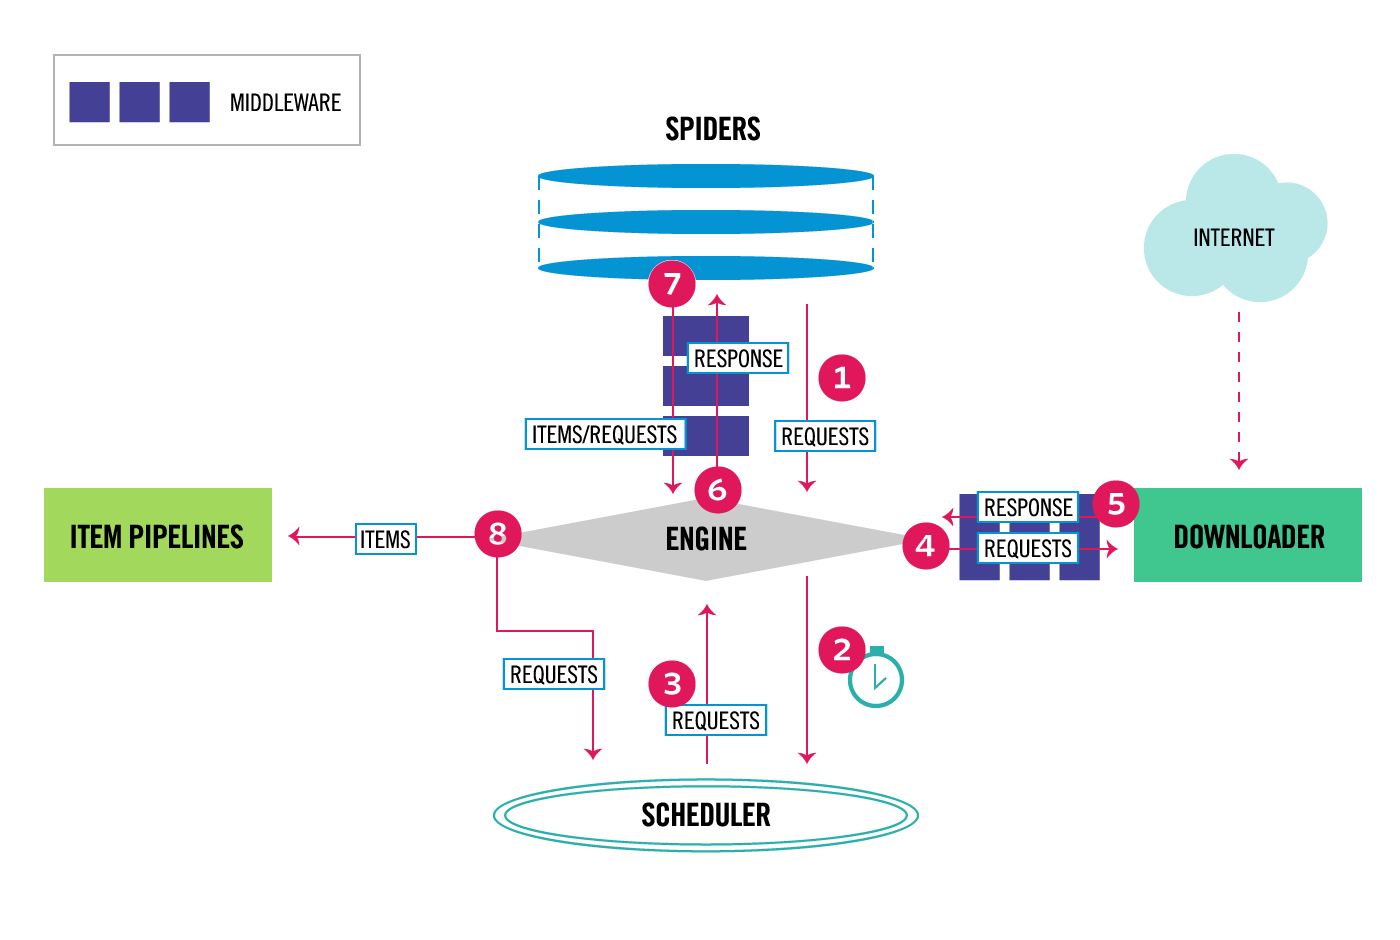
基于Scrapy的B站爬虫 最近又被叫去做爬虫了,不得不拾起两年前搞的东西。 说起来那时也是突发奇想,想到做一个B站的爬虫,然后用的都是最基本的Python的各种库。 不过确实,实现起来还是有点麻烦的,单纯一个下载,就有很多麻烦事。 这回要快速实现一个爬虫,于是想到基于现成的框架来开发。 Scrap …
Continue Reading