【機器學習】數值分析03——任意曲線擬合
- 2022 年 9 月 27 日
- 筆記
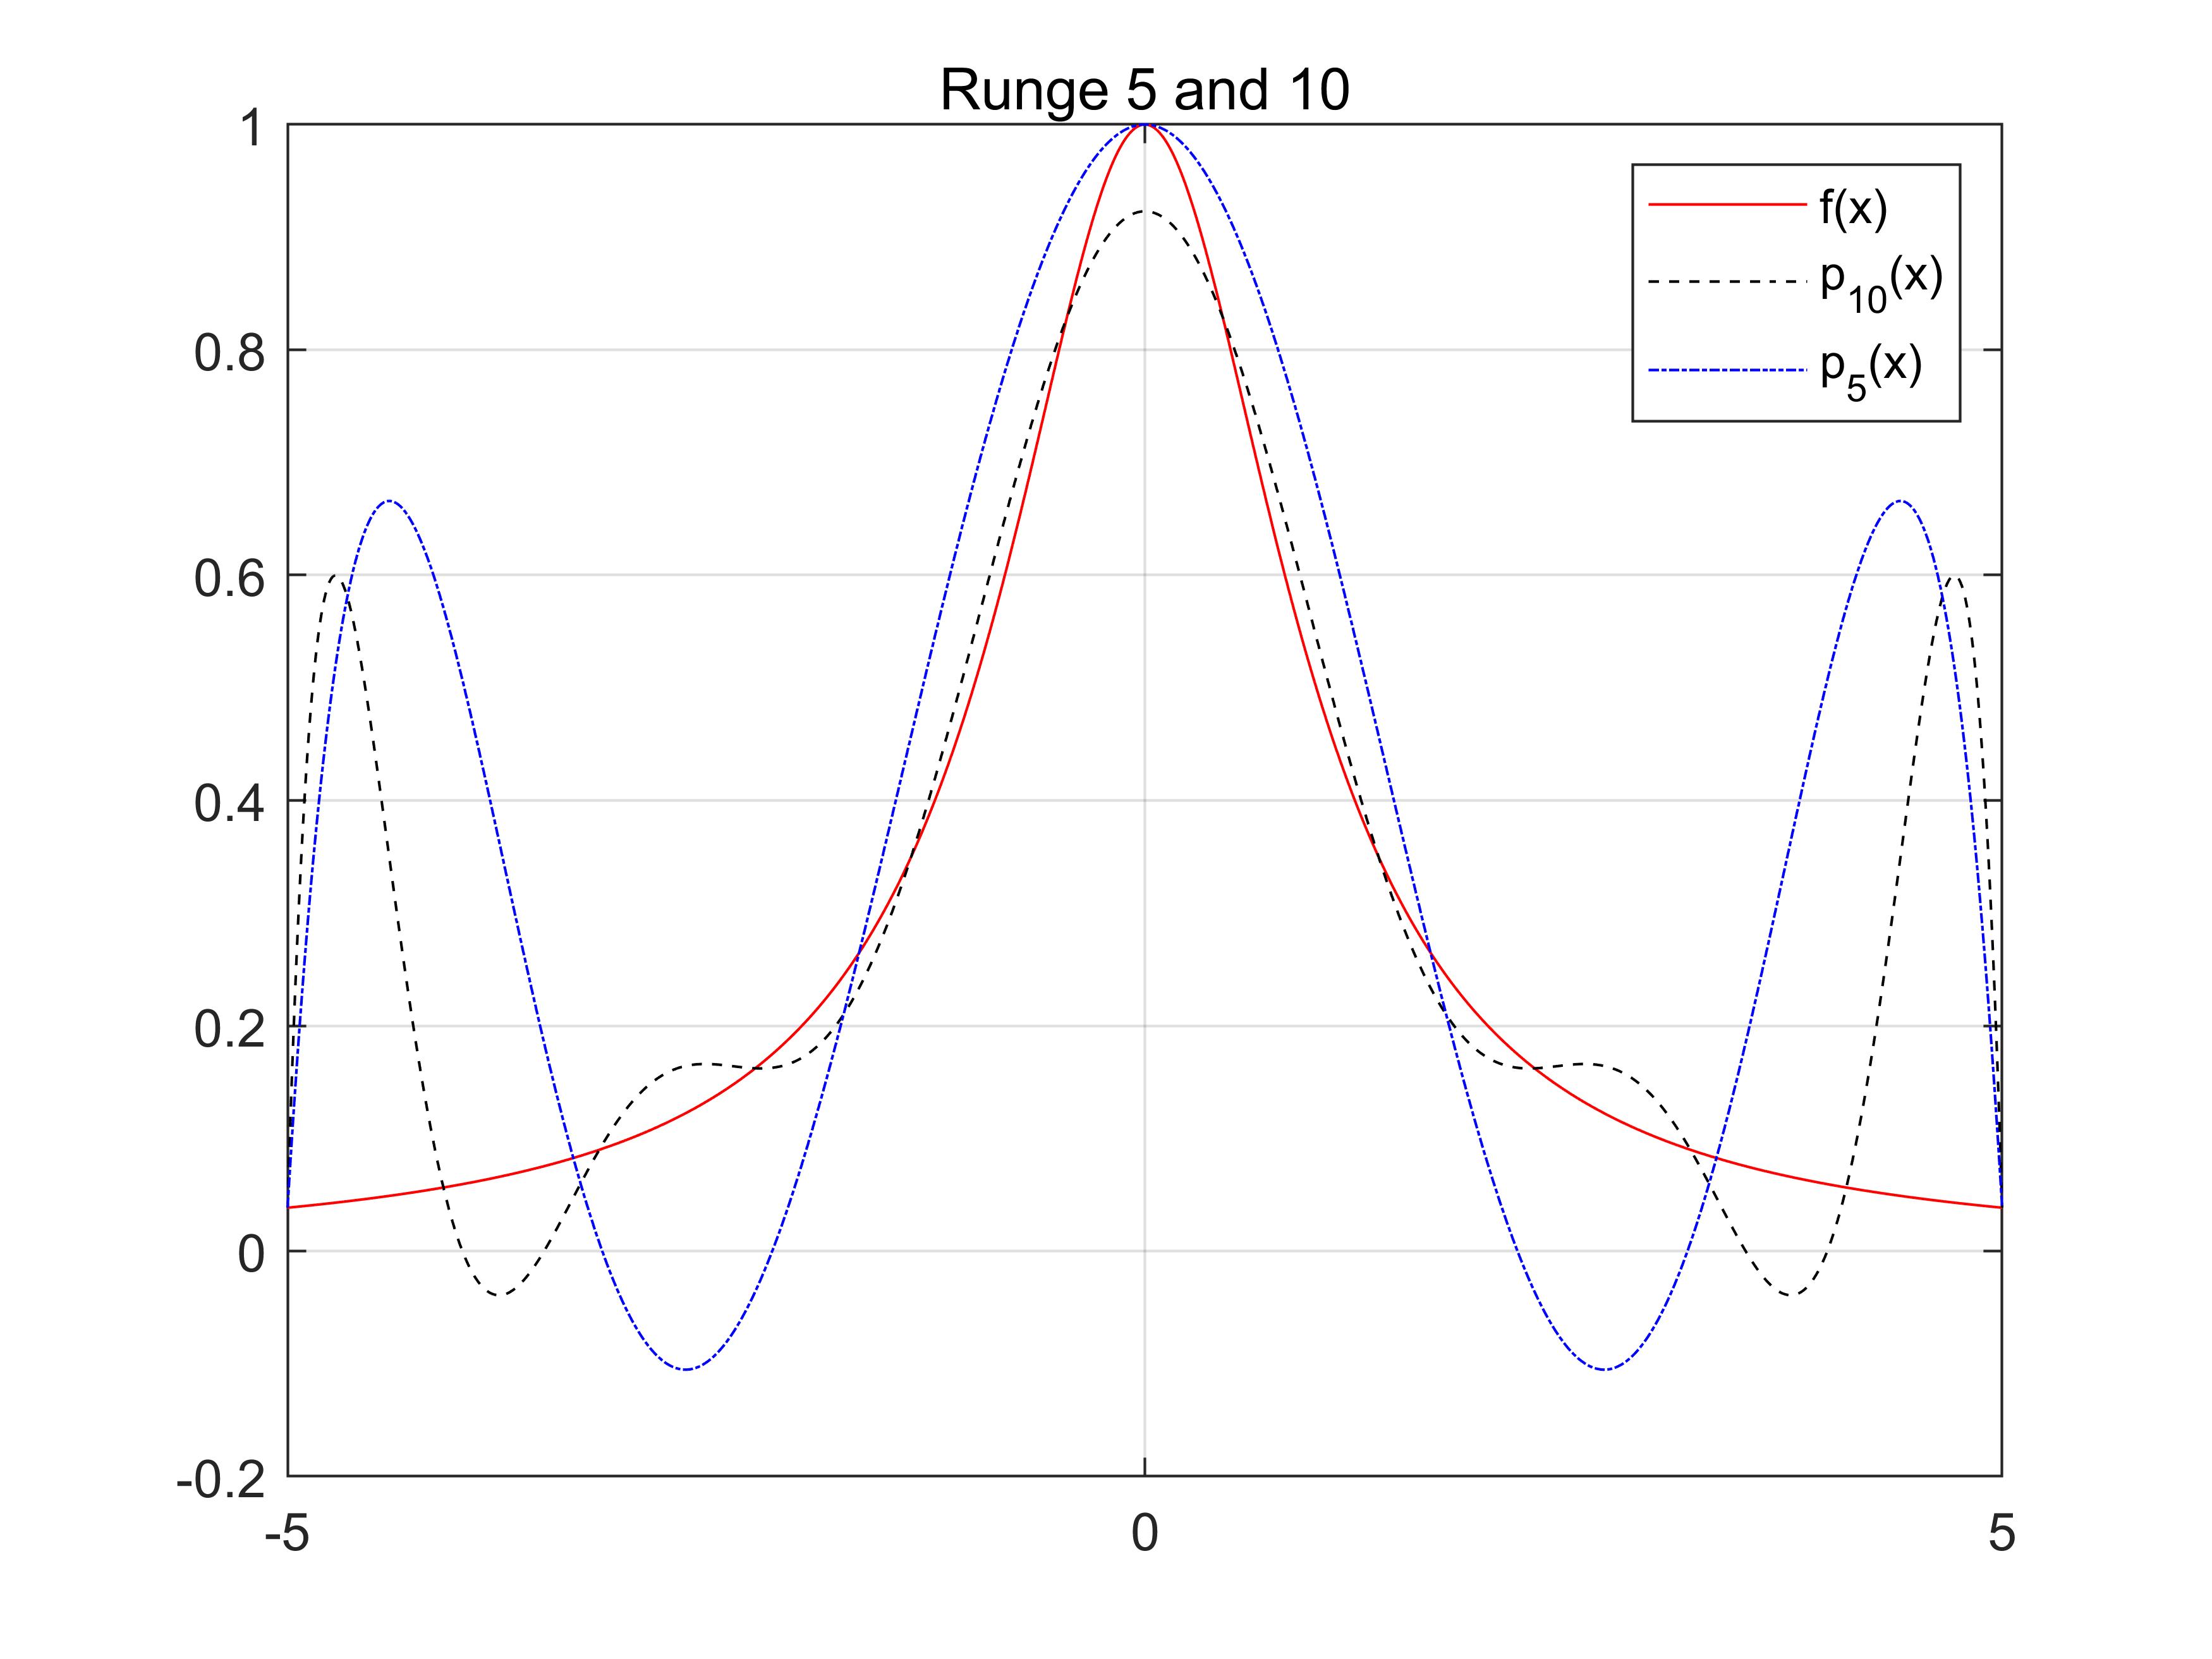
数值分析<3>——任意曲线拟合 全文目录 (博客园)机器学习 (Github)MachineLearning Math 万物皆是展开式 你是否想过这样一个问题,任何的函数,也许都能通过一个“大一统”理论将他们整合在一起。事实上对于任意一种对应关系,我们都能找到一个函数尽可能去贴合它,我们采取的是一种 …
Continue Reading数值分析<3>——任意曲线拟合 全文目录 (博客园)机器学习 (Github)MachineLearning Math 万物皆是展开式 你是否想过这样一个问题,任何的函数,也许都能通过一个“大一统”理论将他们整合在一起。事实上对于任意一种对应关系,我们都能找到一个函数尽可能去贴合它,我们采取的是一种 …
Continue Reading
更多内容请关注微信公众号: 一、集成学习介绍 集成学习要回答的两个问题: 怎么学习基模型? 怎么综合所有基模型的预测结果? 常见框架有三种: Bagging 并行:各个基模型之间不存在强依赖关系,代表是随机森林算法。 每个基模型基于对训练集进行有放回抽样得到子训练集(0.632 采样法)进行训练。 …
Continue Reading
标题取得有点宽泛,本次主要探讨:在梯度下降中雅可比矩阵是用来干嘛的以及我们为什么要在反向传播里使用雅可比矩阵 雅可比矩阵与线性近似 一元函数的线性近似 现在有一个共识:函数在某一点处的导数是它在这一点处的切线的斜率 设有一点x*,在x *附近构造函数f(x)的一个近似: 其中,f'(x*)是函数在x …
Continue ReadingK-means 原理 首先随机选择k个初始点作为质心 1. 对每一个样本点,计算得到距离其最近的质心,将其类别标记为该质心对应的类别 2. 使用归类好的样本点,重新计算K个类别的质心 3. 重复上述过程,直到质心不发生变化 距离计算方法 在K-Means算法中,需要注意的是,对于距离的计算有很多中方 …
Continue Reading3--朴素贝叶斯 原理 朴素贝叶斯本质上就是通过贝叶斯公式来对得到类别概率,但区别于通常的贝叶斯公式,朴素贝叶斯有一个默认条件,就是特征之间条件独立。 条件概率公式: \[P(B|A) = \frac{P(A|B)P(B)}{P(A)} \] 贝叶斯公式可以写成: \[p(y_i|x) = \fra …
Continue Reading决策树 熵的定义 如果一个随机变量X的可能取值为X={x1,x2,..,xk},其概率分布为P(X=x)=pi(i=1,2,...,n),则随机变量X的熵定义为 \(H(x) = -\sum{p(x)logp(x)}=\sum{p(x)log{\frac{1}{p(x)}}}\) 。需要注意的是,熵 …
Continue ReadingAdaboost 适用问题 :二分类问题 模型:加法模型 \[f(x)=\sum_{m=1}^{M} \alpha_{m} G_{m}(x) \] 策略:损失函数为指数函数 \[L(y,f(x))=exp[-yf(x)] \] 算法:前向分步算法 \[\left(\beta_{m}, \gamma_ …
Continue Reading决策树 决策树是一种树形结构,其中每个内部节点表示一个属性上的判断,每个分支代表一个判断结果的输出,最后每个叶子节点代表一种分类结果。 决策树学习的三个步骤: 特征选择 通常使用信息增益最大、信息增益比最大或基尼指数最小作为特征选择的准则。 树的生成 决策树的生成往往通过计算信息增益或其他指标,从根 …
Continue Reading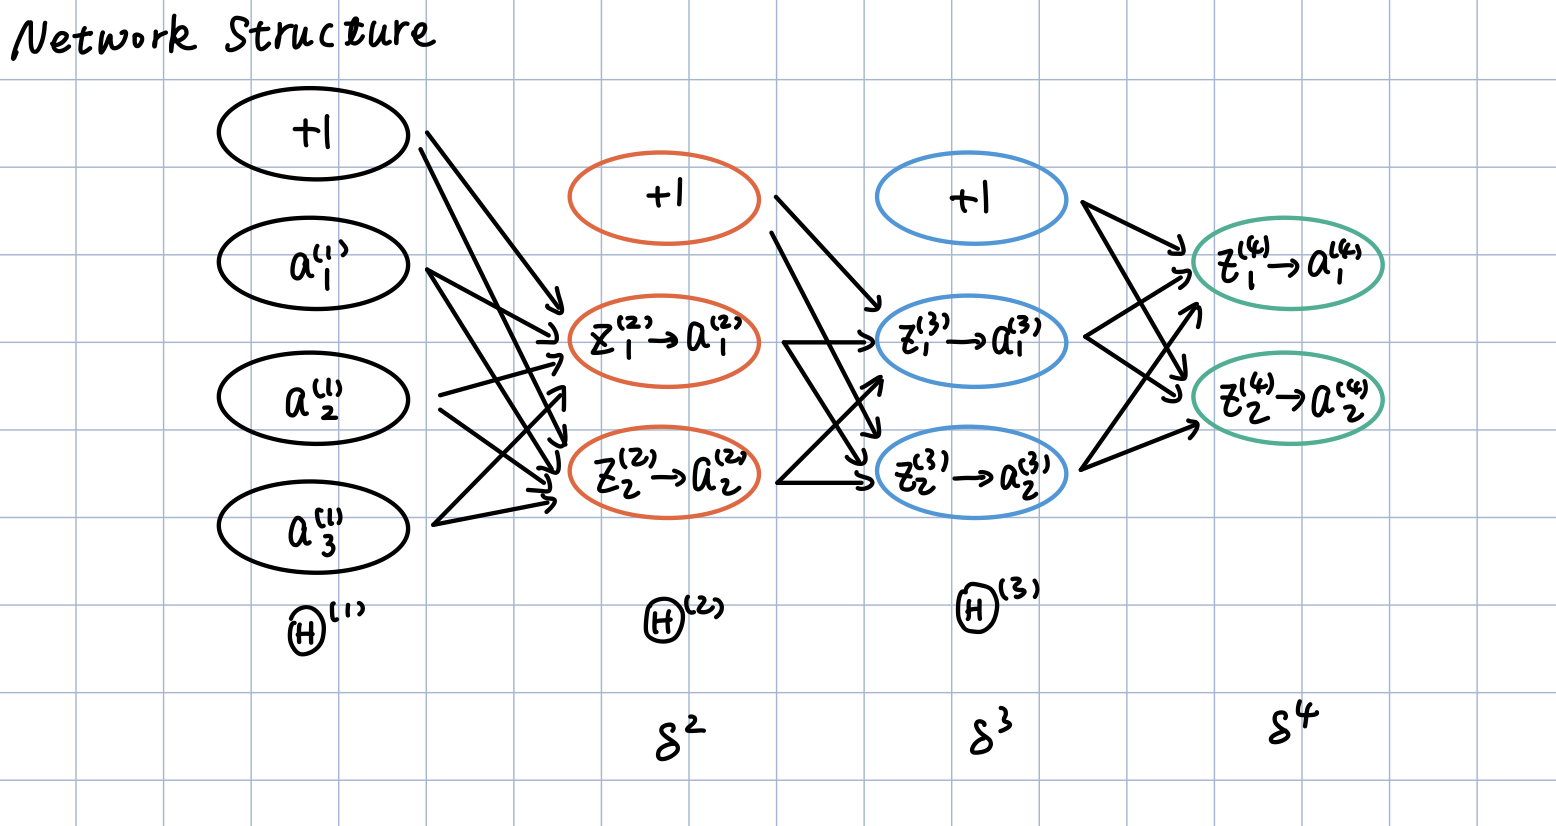
Lec 4 BP神经网络详细推导 本篇博客主要记录一下Coursera上Andrew机器学习BP神经网络的前向传播算法和反向传播算法的具体过程及其详细推导。方便后面手撸一个BP神经网络。 目录 Lec 4 BP神经网络详细推导 4.1 网络结构 4.1.1 损失函数 4.1.2 网络结构 4.2 F …
Continue Reading朴素贝叶斯分类原理 对于给定的训练数据集,首先基于特征条件独立假设学习输入/输出的联合概率分布;然后基于此模型,对给定的输入 \(x\) ,利用贝叶斯定理求出后验概率最大的输出 \(y\) 。 特征独立性假设 :在利用贝叶斯定理进行预测时,我们需要求解条件概率 \(P(x|y_k)=P(x_1,x_ …
Continue Reading