動手學Transformer
動手實現Transformer,所有程式碼基於tensorflow2.0,配合illustrated-transformer更香。
- 模型架構
- Encoder+Decoder
- Encoder
- Decoder
- Attention
- Add&Norm
- FeedForward
- Embedding
- Position Encoding
- Encoder+Decoder
模型架構
transformer使用經典的編碼器-解碼器框架,編碼器接受一個輸入序列 \((x_1,…,x_n)\),經過Embedding轉化為詞向量,和位置編碼相加作為Encoder的輸入,在一頓操作後輸入被映射到\(z=(z_1,…,z_n)\),Decoder基於\(z\)在一頓操作後生成輸出序列\((y_1,…,y_m)\)。
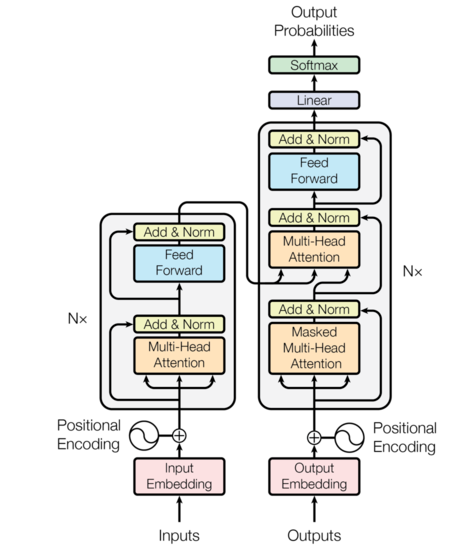
看圖說話
- 左邊是Encoder,輸入為詞ID序列,對應形狀\([batch\ size,max\ input\ sentense\ length]\),如果embedding維度設置為512,輸出形狀為\([batch\ size, max\ input\ sentence\ length, 512]\),\(Nx\)表示將Encoder模組堆疊\(N\)次(論文中\(N=6\))
- 右邊是Decoder,訓練階段,Decoder輸入包括目標句子的詞ID序列和最後一個Encoder部分的輸出,測試階段,Decoder的輸入為上一次輸出的詞。Decoder同樣被堆疊\(N\)次,最後一個Encoder的輸出被接到每一個Decoder塊的輸入。Decoder輸出下一個詞的概率,輸出形狀為\([batch\ size, max\ output\ sentence\ length, \ vocabulary\ length])\) 。
我們先蓋房子在裝修
class Transformer(tf.keras.Model):
    '''
    Transformer架構,Encoder-Decoder;softmax
    params:
    num_layers:堆疊層數
    dim_model:embedding 維度
    num_heads:multihead attention
    dim_ff:FeedForWard 維度
    input_vocab_size:輸入詞典大小
    target_vocab_size:輸出詞典大小
    rate:dropout rate
    '''
    def __init__(self,num_layers, dim_model, num_heads, dim_ff, input_vocab_size,target_vocab_size, rate=0.1):
        super(Transformer, self).__init__()
        self.encoder = Encoder(num_layers, dim_model, num_heads,dim_ff, input_vocab_size, rate)#Encoder
        self.decoder = Decoder(num_layers, dim_model, num_heads,dim_ff, target_vocab_size, rate)#Decoder
        self.output_layer = tf.keras.layers.Dense(target_vocab_size)

    def call(self, inputs, targets, training, enc_padding_mask, look_ahead_mask, dec_padding_mask):
        encoder_output = self.encoder(inputs, training, enc_padding_mask)  # (batch_size, inputs_seq_len, d_model)
        decoder_output, attention_weights = self.decoder(targets, encoder_output, training, look_ahead_mask, dec_padding_mask)
        output = self.output_layer(decoder_output)  # (batch_size, tar_seq_len, target_vocab_size)
        return output, attention_weights
- Encoder

Encoder接受輸入token的embedding和位置編碼,經過N次Encoder layer 堆疊,程式碼如下所示
class Encoder(tf.keras.layers.Layer):
    '''
    Encoder 部分,input embedding ;Encoder layer stack
    '''
    def __init__(self, num_layers, dim_model, num_heads,dim_ff, input_vocab_size, rate=0.1):
        super(Encoder, self).__init__()

        self.dim_model = dim_model
        self.num_layers = num_layers

        self.embedding = tf.keras.layers.Embedding(input_vocab_size, self.dim_model)#輸入Embedding
        self.pos_encoding = positional_encoding(input_vocab_size, self.dim_model)#位置編碼

        self.enc_layers = [EncoderLayer(dim_model, num_heads, dim_ff, rate) for _ in range(num_layers)]#創建Encoder layer

        self.dropout = tf.keras.layers.Dropout(rate)

    def call(self, x, training, mask):

        seq_len = tf.shape(x)[1]

        # adding embedding and position encoding.
        x = self.embedding(x)  # (batch_size, input_seq_len, dim_model)
    #     x *= tf.math.sqrt(tf.cast(self.dim_model, tf.float32))
        x += self.pos_encoding[:, :seq_len, :]

        x = self.dropout(x, training=training)

        for layer in self.enc_layers:
            x = layer(x, training, mask)

        return x  # (batch_size, input_seq_len, d_model)
單個Encoder layer 有兩個子層: attention層和point wise feed forward network.
class EncoderLayer(tf.keras.layers.Layer):
    '''
    Encoder layer:
    multihead attention;add&layer norm;FeedForward;add&layer norm
    '''
    def __init__(self, dim_model, num_heads, dim_ff, rate=0.1):
        super(EncoderLayer, self).__init__()

        self.mha = MultiHeadAttention(dim_model, num_heads)
        self.ffn = point_wise_feed_forward_network(dim_model, dim_ff)

        self.layernorm1 = tf.keras.layers.LayerNormalization(epsilon=1e-6)
        self.layernorm2 = tf.keras.layers.LayerNormalization(epsilon=1e-6)

        self.dropout1 = tf.keras.layers.Dropout(rate)
        self.dropout2 = tf.keras.layers.Dropout(rate)

    def call(self, x, training, mask):

        attn_output, _ = self.mha(x, x, x, mask)  # (batch_size, input_seq_len, d_model)
        attn_output = self.dropout1(attn_output, training=training)
        out1 = self.layernorm1(x + attn_output)  # (batch_size, input_seq_len, d_model)

        ffn_output = self.ffn(out1)  # (batch_size, input_seq_len, d_model)
        ffn_output = self.dropout2(ffn_output, training=training)
        out2 = self.layernorm2(out1 + ffn_output)  # (batch_size, input_seq_len, d_model)

        return out2
- Decoder
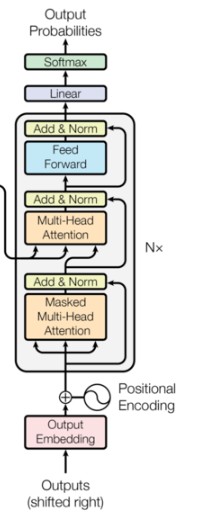
Decoder和Encoder類似,由N個Decoder layer 堆疊而成, 接受輸入有三部分:token embedding、位置編碼、 最後一個Encoder的輸出
class Decoder(tf.keras.layers.Layer):
    '''
    Decoder 部分:
    input embedding;Decoder layer stack;
    '''
    def __init__(self,num_layers,dim_model, num_heads, dim_ff, target_vocab_size, rate=0.1):
        super(Decoder, self).__init__()

        self.dim_model = dim_model
        self.num_layers = num_layers

        self.embedding = tf.keras.layers.Embedding(target_vocab_size, self.dim_model)
        self.pos_encoding = positional_encoding(target_vocab_size, self.dim_model)

        self.dec_layers = [DecoderLayer(dim_model, num_heads, dim_ff, rate) for _ in range(num_layers)]#創建Decoder layer
        self.dropout = tf.keras.layers.Dropout(rate)

    def call(self,x,enc_output,training,look_ahead_mask,padding_mask):
        seq_len = tf.shape(x)[1]
        attention_weights = {}

        x = self.embedding(x)# (batch_size, target_seq_len, d_model)
        x += self.pos_encoding[:,:seq_len,:]

        for i,layer in enumerate(self.dec_layers):
            x,block1,block2 = layer(x,enc_output,training,look_ahead_mask, padding_mask)
            attention_weights['decoder_layer{}_block1'.format(i+1)] = block1
            attention_weights['decoder_layer{}_block2'.format(i+1)] = block2

        # x.shape == (batch_size, target_seq_len, d_model)
        return x, attention_weights
單個Decoder層有三個子層:masked attention層、attention層和point wise feed forward network. masked attention層會掩蓋掉序列中還沒看到的位置,attention層以target token 為query,Encoder輸出為 key和value
class DecoderLayer(tf.keras.layers.Layer):
    '''
    Decoder layer:
    masked multihead attention;add&norm;multihead attention;add&norm;FeedForward;add&norm
    '''
    def __init__(self, dim_model, num_heads,dim_ff,rate=0.1):
        super(DecoderLayer,self).__init__()

        self.mask_mha = MultiHeadAttention(dim_model, num_heads)
        self.mha = MultiHeadAttention(dim_model, num_heads)

        self.ffn = point_wise_feed_forward_network(dim_model, dim_ff)

        self.layernorm1 = tf.keras.layers.LayerNormalization(epsilon=1e-6)
        self.layernorm2 = tf.keras.layers.LayerNormalization(epsilon=1e-6)
        self.layernorm3 = tf.keras.layers.LayerNormalization(epsilon=1e-6)

        self.dropout1 = tf.keras.layers.Dropout(rate)
        self.dropout2 = tf.keras.layers.Dropout(rate)
        self.dropout3 = tf.keras.layers.Dropout(rate)

    def call(self,x,enc_output, training, look_ahead_mask, padding_mask):
        #masked multi-head attention
        mask_attn_output, attn_weights_block1 = self.mask_mha(x,x,x,look_ahead_mask)
        mask_attn_output = self.dropout1(mask_attn_output,training)
        out1 = self.layernorm1(x + mask_attn_output)

        #multi-head attention
        attn_output,attn_weights_block2 = self.mha(out1,enc_output,enc_output,padding_mask)
        attn_ouput = self.dropout2(attn_output, training=training)
        out2 = self.layernorm2(attn_output + out1)  # (batch_size, target_seq_len, d_model)

        # feed-forward
        ffn_output = self.ffn(out2)  # (batch_size, input_seq_len, d_model)
        ffn_output = self.dropout2(ffn_output, training=training)
        out3 = self.layernorm3(out1 + ffn_output)  # (batch_size, input_seq_len, d_model)

        return out3, attn_weights_block1, attn_weights_block2
- Attention
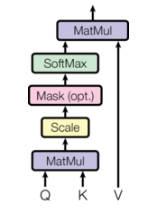
點積attention
def Attention(query,key,value,mask=None):
    qk = tf.matmul(query,key,transpose_b=True)#對key進行轉置

    dk = tf.cast(tf.shape(key)[-1],tf.float32)
    scale = qk / tf.math.sqrt(dk)

    if mask is not None:
        scale = scale + (mask*1e-9)#le-9接近於負無窮,對應softmax輸出就為0

    score = tf.nn.softmax(scale,axis=-1)
    output = tf.matmul(score,value)

    return output,score
- Multihead attention
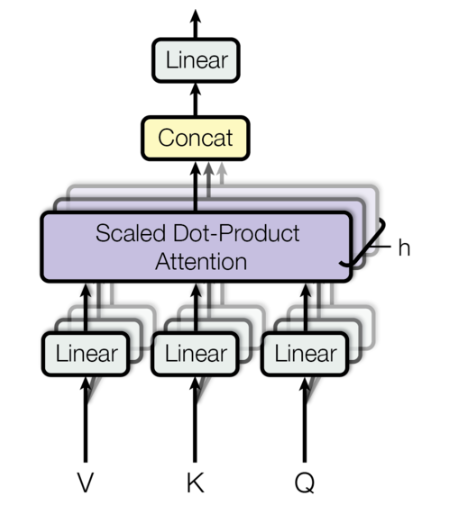
將輸入劃分為多個head,對應維度變化\((batch\_size,seq\_len,dim\_model) \rightarrow (batch\_size,head,seq\_len,d_k)\), 每個head操作不變,將多個head結果拼接經過權重矩陣\(W^O\)輸出
class MultiHeadAttention(tf.keras.layers.Layer):
    '''
    Multihead attention
    '''
    def __init__(self,dim_model,num_heads):
        super(MultiHeadAttention,self).__init__()
        self.num_heads = num_heads
        self.dim_model = dim_model

        assert dim_model%self.num_heads == 0

        self.d_k = dim_model//num_heads

        self.wq = tf.keras.layers.Dense(dim_model)
        self.wk = tf.keras.layers.Dense(dim_model)
        self.wv = tf.keras.layers.Dense(dim_model)

        self.wo = tf.keras.layers.Dense(dim_model)

    def split_heads(self,x,batch_size):
        #split 輸入到多個head,(batch_size,seq_len,dim_model)->(batch_size,head,seq_len,self.d_k)
        x = tf.reshape(x,(batch_size, -1, self.num_heads, self.d_k))
        return tf.transpose(x,perm=[0,2,1,3])#重排輸出維度

    def call(self,q,k,v,mask):
        batch_size = tf.shape(q)[0]

        q = self.wq(q)  # (batch_size, seq_len, dim_model)
        k = self.wk(k)
        v = self.wv(v)

        q = self.split_heads(q, batch_size)  # (batch_size, num_heads, seq_len_q, d_k)
        k = self.split_heads(k, batch_size)
        v = self.split_heads(v, batch_size)

        attention,attention_weights = Attention(q,k,v,mask)

        attention = tf.transpose(attention,perm=[0,2,1,3])
        concat_attention = tf.reshape(attention,(batch_size,-1,self.dim_model))

        return self.wo(concat_attention),attention_weights
- Masking
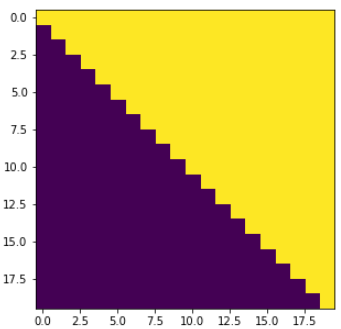
在解碼時,為了保證預測當前詞不會看到後面的詞,需要將後面的詞掩碼掉。如下圖所示,上三角元素為1,表示該位置需要被mask
#mask掉後面的詞,保證預測前面詞時看不到後面的
def look_ahead_mask(size):
    "Mask out subsequent positions."
    mask = tf.linalg.band_part(tf.ones((size, size)), 0, -1)#保留上三角,1表示需要被mask
    return mask
plt.figure(figsize=(5,5))
plt.imshow(look_ahead_mask(20))
None
#序列填充mask,對padding位置輸出1表示被填充
def padding_mask(seq):
  seq = tf.cast(tf.math.equal(seq, 0), tf.float32)

  # add extra dimensions so that we can add the padding
  # to the attention logits.
  return seq[:, tf.newaxis, tf.newaxis, :]  # (batch_size, 1, 1, seq_len)
- Feed-Forward network
接在attention子層後面,用於增強非線性表示能力
def point_wise_feed_forward_network(dim_model, dim_ff):
    model = tf.keras.Sequential()
    model.add(tf.keras.layers.Dense(dim_ff, activation='relu'))
    model.add(tf.keras.layers.Dense(dim_model))
    return model
- position encoding
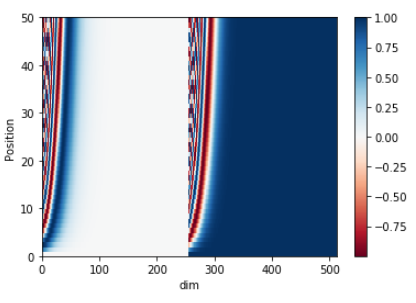
位置編碼是影響Transformer長文本建模的主要因素,由於input embedding 中不包含詞的位置資訊,需要加入位置編碼表示詞在句子中的位置資訊。
為了表示詞的絕對位置資訊和相對位置資訊,本文中使用了正餘弦函數
其中 \(pos\) 表示位置,\(i\) 表示維度,關於為什麼使用正餘弦作為位置編碼,可以參考這裡。
def positional_encoding(maxlen,dim_model):
    position = np.arange(0, maxlen)[:,np.newaxis]
    div = np.array([1/np.power(10000.0,((2*i)/dim_model)) for i in range(dim_model)])[np.newaxis,:]
#     div = np.exp(np.arange(0, dim_model, 2) * -(np.log(10000.0) / dim_model))

    sine = np.sin(position*div[:,0::2])
    cons = np.cos(position*div[:,1::2])

    pos_encoding = np.concatenate([sine,cons], axis=-1)[np.newaxis, :]

    return tf.cast(pos_encoding, dtype=tf.float32)
pos_encoding = positional_encoding(50, 512)
print (pos_encoding.shape)

plt.pcolormesh(pos_encoding[0], cmap='RdBu')
plt.xlabel('dim')
plt.xlim((0, 512))
plt.ylabel('Position')
plt.colorbar()
plt.show()
transformer的基本概念就先學到這裡了
reference:
Illustrated-transformer. //jalammar.github.io/illustrated-transformer/
Transformer_implementation_and_application. //github.com/yuanxiaosc/Transformer_implementation_and_application
The Annotated Transformer. //nlp.seas.harvard.edu/2018/04/03/attention.html#full-model