基於深度學習的影像識別模型發展
- 2020 年 4 月 13 日
- 筆記
一、簡介
AlexNet:(2012)主要貢獻擴展 LeNet 的深度,並應用一些 ReLU、Dropout 等技巧。AlexNet 有 5 個卷積層和 3 個最大池化層,它可分為上下兩個完全相同的分支,這兩個分支在第三個卷積層和全連接層上可以相互交換資訊。它是開啟了卷積神經網路做影像處理的先河。
VGG-Net:2014年。該網路使用3×3卷積核的卷積層堆疊並交替最大池化層,有兩個4096維的全連接層,然後是softmax分類器。16和19分別代表網路中權重層的數量。相比於 AlexNet 有更小的卷積核和更深的層級。VGG 最大的問題就在於參數數量,VGG-19 基本上是參數量最多的卷積網路架構。
ResNet:2015年。該網路使用殘差模組來組成更複雜的網路(網路中的網路),使用標準隨機梯度下降法訓練。與VGG相比,ResNet更深,但是由於使用全局平均池操作而不是全連接密集層,所以模型的尺寸更小。
Inception:2015年。它沒有如同 VGG-Net 那樣大量使用全連接網路,因此參數量非常小。增加了網路的深度的同時也增加了網路的寬度,該網路使用不同大小的卷積核提取特徵,同時計算1×1、3×3、5×5卷積,然後分別把他們的結果concatenate(不同卷積操作輸出的feature map的大小要相同),然後將這些濾波器的輸出沿通道維度堆疊並傳遞到下一層。因為 1*1、3*3 或 5*5 等不同的卷積運算與池化操作可以獲得輸入影像的不同資訊,並行處理這些運算並結合所有結果將獲得更好的影像表徵。問題是計算量太大。
Inception v1:論文:Going deeper with convolutions,
Inception v2
Inception v3
Inception v4
Inception-v4編寫於2016年
Inception-ResNet
Xception:2016年。該網路是Inception網路的擴展,使用了深度可分離卷積運算。其參數數量與Inception-v3相同,由於更高效地利用模型參數,該網路性能獲得提升並在大型影像分類數據集勝過Inception-v3。
AlexNet
《ImageNet Classification with Deep Convolutional Neural Networks》
AlexNet:2012年產生,將錯誤率從原來的25%降到16%,
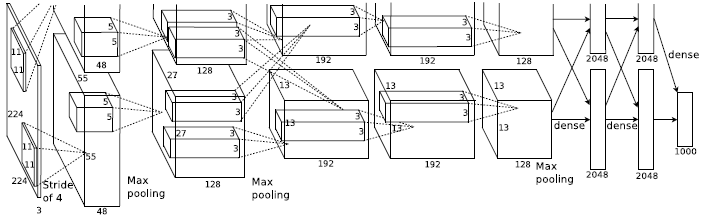
這個網路由上下兩部分組成。輸入的影像會經過5層卷積層(依次是11*11卷積、5*5卷積,3個3*3卷積),有些卷積層後面還使用了池化層。5層卷積之後連接了3層全連接層。由於該網路是由Alex 設計完成的,所以現在一般將此網路簡稱為AlexNet 。
AlexNet的成功得益於以下幾個方面:
- 訓練了較深層的卷積神經網路。
- ImageNet 提供了大量訓練樣本,此外還使用了數據增強技術,因此神經網路的過擬合現象不嚴重。
- 使用了dropout 等技術,進一步降低了過擬合。
VGG
《Very Deep Convolutional Networks for Large-Scale Image Recognition》
詳解:一文讀懂VGG網路
homepage:Visual Geometry Group Home Page
2014年產生,將錯誤率降到了7%,在原始的論文中,作者共訓練了6 個網路,分別命名為VGG-A 、VGG-A-LRN 、VGG-B 、VGG-C 、VGG-D 幸日VGG-E ,在實際應用中,由於VGG-D和VGG-E效果最好,而且VGG-D有16層,VGG-E有19層,所以他們又被分別簡稱為VGG16和VGG19。VGG19 比VGG16 準確率更高,但相應地計算量更大。

簡單解釋表中符號表示的含義。conv3-512 表示使用了3 × 3 的卷積,卷積之後的通道數為512 。而conv3-256 表示使用了3 × 3 的卷積,通道數為256,依此類推。
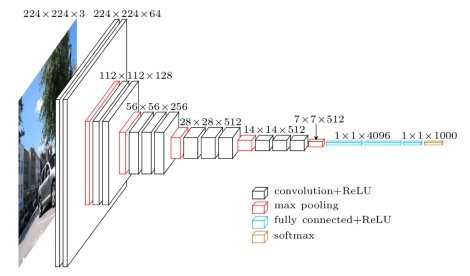
vgg的最主要的思想就是增加網路深度,減小卷積核尺寸(3*3)。減少卷積核的好處就是可以減少參數和計算量,比如,論文中舉了一個例子,把一個7*7的卷積層替換成3個3*3的卷積層,參數上可以減少81%,因為3*3*3 = 27, 7*7 = 49.
文中還提到了1*1的卷積層,比如說下圖的configC的conv1層,這樣做的目的主要是增加卷積層的非線性表達,同時影響卷積層的感受野,這個思想在google的inception系列網路中有了很好的應用,具體可以參考Network in Network這篇論文。
vgg的參數還是很多的,可以看出vgg-16有138百萬個參數。
incception系列
[v1] Going Deeper with Convolutions, 6.67% test error
[v2] Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift, 4.8% test error
[v3] Rethinking the Inception Architecture for Computer Vision, 3.5% test error
[v4] Inception-v4, Inception-ResNet and the Impact of Residual Connections on Learning, 3.08% test error
GoogLeNet:2014年產生,將錯誤率降到了6%,GoogLeNet的創新在於它提出了一種「Inception」結構,它把原來的單個節點又拆成一個神經網路,形成了「網中網」,
在 Inception 出現之前,大部分流行 CNN 僅僅是把卷積層堆疊得越來越多,使網路越來越深,以此希望能夠得到更好的性能。
inception-v1
這個就是GoogleNet,本文的主要工作,就是研究怎麼設計一種網路,更加有效地利用計算資源。
- 由於資訊位置的巨大差異,為卷積操作選擇合適的卷積核大小就比較困難。資訊分布更全局性的影像偏好較大的卷積核,資訊分布比較局部的影像偏好較小的卷積核。
- 非常深的網路意味著巨量的參數,同時更容易過擬合。將梯度更新傳輸到整個網路是很困難的。
- 簡單地堆疊較大的卷積層非常消耗計算資源。因此inception-v1並沒有在網路的深度上做文章而是在網路的寬度上。
文章認為解決上述兩個缺點的根本方法是將全連接甚至一般的卷積都轉化為稀疏連接。一方面現實生物神經系統的連接也是稀疏的,另一方面有文獻表明:對於大規模稀疏的神經網路,可以通過分析激活值的統計特性和對高度相關的輸出進行聚類來逐層構建出一個最優網路。這點表明臃腫的稀疏網路可能被不失性能地簡化。
早些的時候,為了打破網路對稱性和提高學習能力,傳統的網路都使用了隨機稀疏連接。但是,電腦軟硬體對非均勻稀疏數據的計算效率很差,所以在AlexNet中又重新啟用了全連接層,目的是為了更好地優化並行運算。
所以,現在的問題是有沒有一種方法,既能保持網路結構的稀疏性,又能利用密集矩陣的高計算性能。大量的文獻表明可以將稀疏矩陣聚類為較為密集的子矩陣來提高計算性能,據此論文提出了名為Inception 的結構來實現此目的。
inception module
主要就是把稀疏結構近似成幾個密集的子矩陣,從而在減少參數的同時,更加有效地利用計算資源。
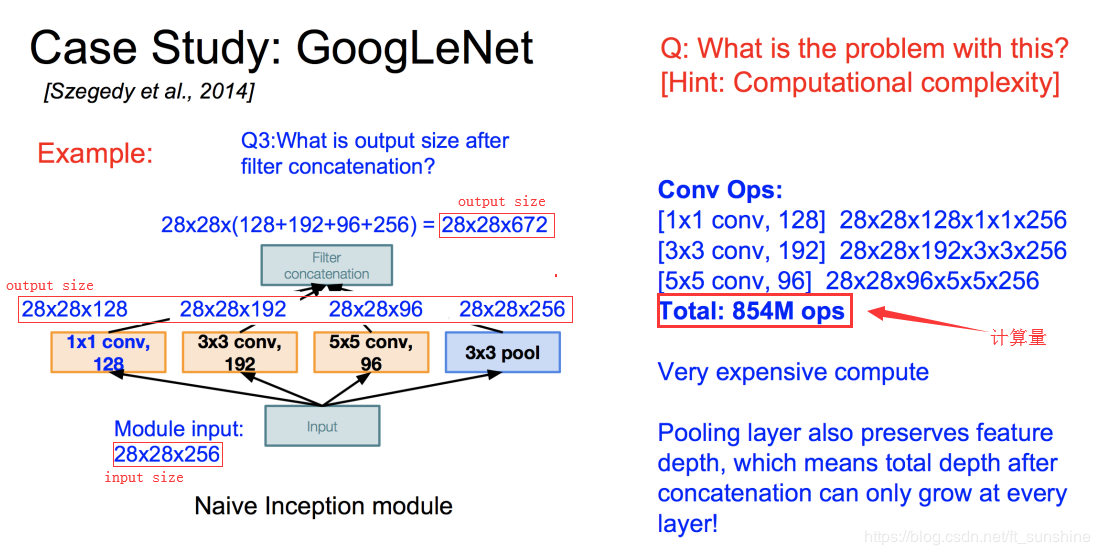
- 採用不同大小的卷積核意味著不同大小的感受野,最後拼接意味著不同尺度特徵的融合;
- 之所以卷積核大小採用1、3和5,主要是為了方便對齊。設定卷積步長stride=1之後,只要分別設定pad=0、1、2,那麼卷積之後便可以得到相同維度的特徵,然後這些特徵就可以直接拼接在一起了;
- 文章說很多地方都表明pooling挺有效,所以Inception裡面也嵌入了。
- 網路越到後面,特徵越抽象,而且每個特徵所涉及的感受野也更大了,因此隨著層數的增加,3x3和5x5卷積的比例也要增加。
但是,這種naive的inception 並不實用,因為不同的feature map拼到一起之後傳遞到下一層inception 的5*5卷積層,計算量仍然是非常巨大的,為了降低算力成本,作者在 3x3 和 5x5 卷積層之前添加額外的1*1的卷積層(bottleneck)做降維操作,下面是改進之後的inception。注意,1x1 卷積是在最大池化層之後。
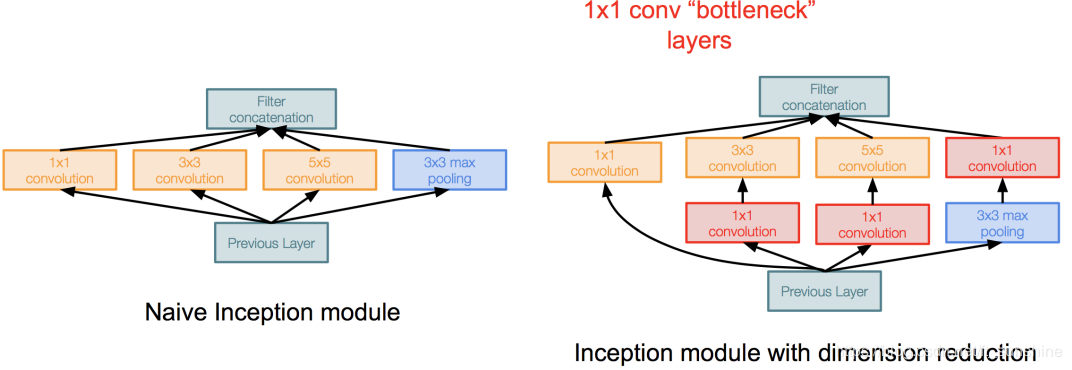
降維Inception模組
此時這一個Inception module的計算量為358M ops,相比之前的854M ops,使用「bottleneck」的Inception module的計算量降低了一半多!
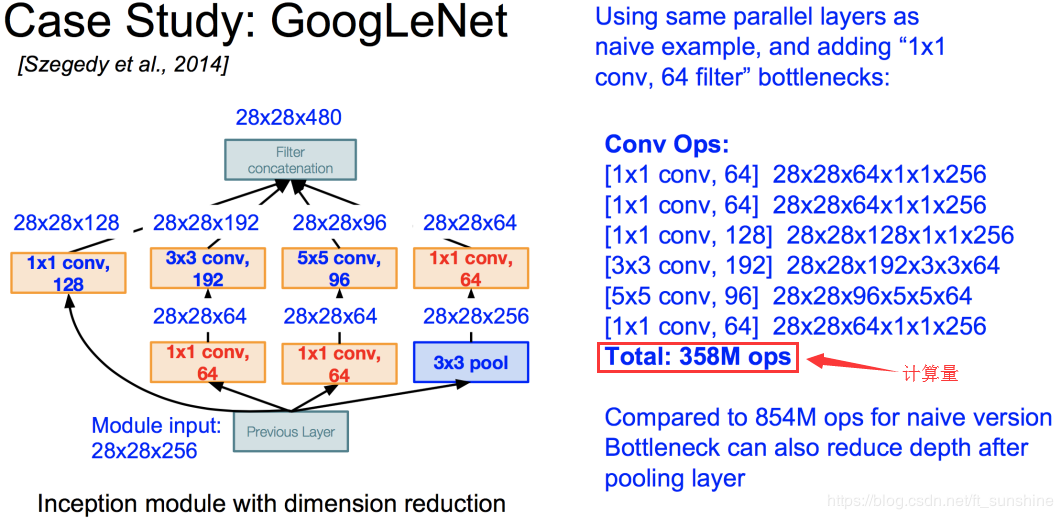
到這裡,Inception module的結構就介紹完了,而GoogLeNet的架構就是多個Inception module一層一層地stack(堆疊)出來的,下面是GoogLeNet的整體架構的介紹。
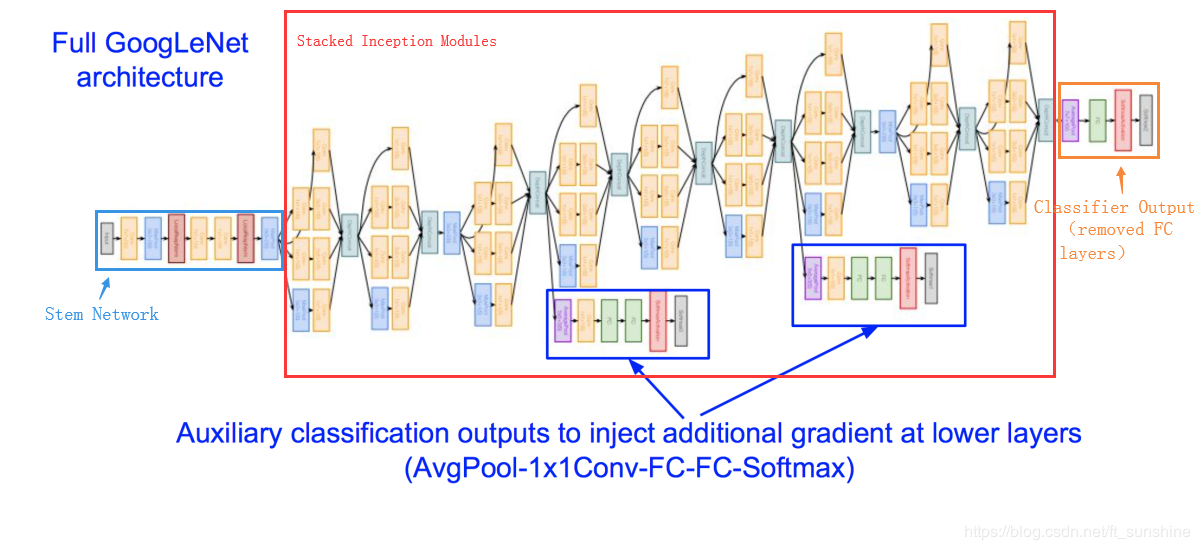
註:淺藍色部分Stem Network是一些初始卷積,深藍色部分有三個輔助分類器,為什麼要用三個classifier呢?結合GoogLeNet的論文,我個人認為有以下幾點原因:
- 一般認為深度越深,越有可能產生梯度消失的問題。這裡深度不同的三個classifier可以有效緩解梯度消失問題,即淺層的classifier的輸出也執行 softmax 操作,然後在同樣的標籤上計算輔助損失。總損失即輔助損失和真實損失的加權和。該論文中對每個輔助損失使用的權重值是 0.3。可見輔助分類器也可以回傳誤差,緩解梯度消失問題。輔助損失只是用於訓練,在推斷過程中並不使用。
- CNN深度越深的層,提取的特徵語義資訊越豐富,深度越淺的層提取的特徵更基礎,包含更多的位置資訊,所以並不是深度越深的層提取的特徵一定好於較淺層提取的特徵。這裡在不同深度的層上面都加了一個output layer,可以做一個模型的ensemble,這可能會提升模型的效果。
Network in Network
NIN有兩個特性,是它對CNN的貢獻:
- MLP代替GLM
- Global Average Pooling
MLPconv
普通的卷積可以看做輸入feature map 和kernel 矩陣相乘的過程,是一個線性變換。MLP是指多層感知機,由於是多層的,f(x) = w*g(x)+b, g(x) = w*x +b,輸出f和輸入x自然是非線性關係,mlpconv的意思就是用mlp代替普通卷積,可以增加網路的抽象表達能力。
所以,基於如上,可以認為,在抽特徵的時候直接做了非線性變換,可以有效的對影像特徵進行更好的抽象。
從而,Linear convolution layer就變成了Mlpconv layer。
值得一提的是,Mlpconv相當於在激活函數後面,再添加一個1×1的卷積層。
當然,1*1卷積層在本文中的最重要的作用還是進行降維。
Global Average Pooling
Global Average Pooling的做法是將全連接層去掉。
全連接層的存在有兩個缺點:
全連接層是傳統的神經網路形式,使用了全連接層以為著卷積層只是作為特徵提取器來提取影像的特徵,而全連接層是不可解釋的,從而CNN也不可解釋了
全連接層中的參數往往佔據CNN整個網路參數的一大部分,從而使用全連接層容易導致過擬合。
而Global Average Pooling則是在最後一層,將卷積層設為與類別數目一致,然後全局pooling,從而輸出類別個數個結果。
但是本文中,在average pooling 後面還跟了一個linear layer,加這個層主要是為了方便起見,能夠更容易擴展到其他的數據集上。
做後的結構如圖所示:
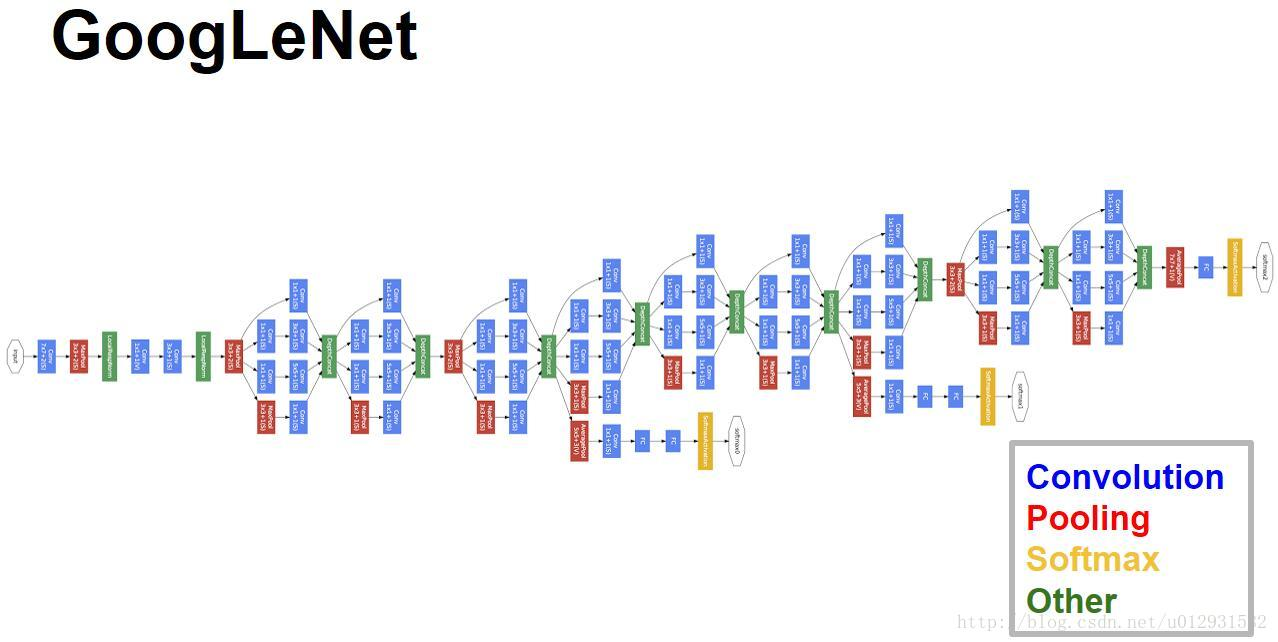
網路在訓練的時候還加了兩個額外的分類器,目的是為了防止梯度消失,最後測試的時候可以把這兩個分類器去掉。
最後的參數相比於alexnet少了12倍,相比於vgg-16來說少了3倍。
值得一提的是, GoogLeNet 又被稱為Inception Vl 模型, Google 又對該模型做了後續研究,相繼提出了Inception V2, Inception V3, Inception V 4模型,每一代模型的性能都高提升。Inception v2 和 Inception v3 來自同一篇論文《Rethinking the Inception Architecture for Computer Vision》,作者提出了一系列能增加準確度和減少計算複雜度的修正方法。
inception-v2
問題:
- 減少特徵的表徵性瓶頸。直觀上來說,當卷積不會大幅度改變輸入維度時,神經網路可能會執行地更好。過多地減少維度可能會造成資訊的損失,這也稱為「表徵性瓶頸」。
- 使用更優秀的因子分解方法,卷積才能在計算複雜度上更加高效。
解決方案:
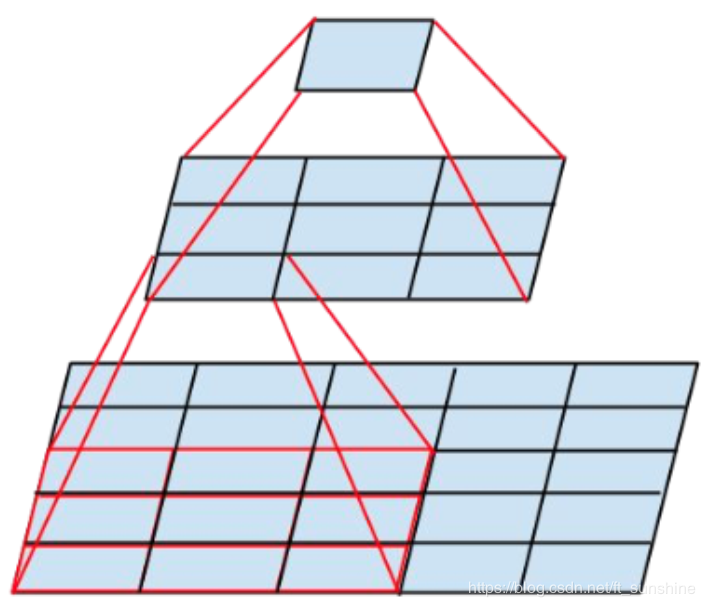
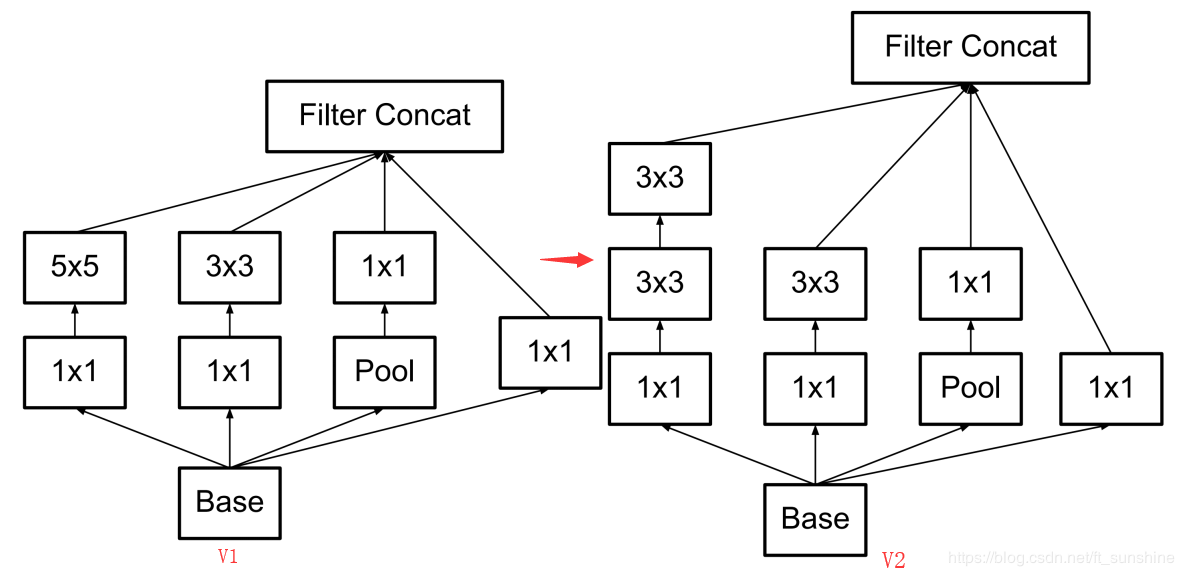
- 將7*7和 5×5 的卷積分解為兩個 3×3 的卷積運算以提升計算速度。儘管這有點違反直覺,但一個 5×5 的卷積在計算成本上是一個 3×3 卷積的 2.78 倍。所以疊加兩個 3×3 卷積實際上在性能上會有所提升
- 在 Inception-V1的基礎上增加了 Batch Normalization
主要貢獻:提出了batch normalization,主要在於加快訓練速度。數據歸一化方法很簡單,就是要讓數據具有0均值和1方差
網路訓練的過程參數不斷的改變導致後續每一層輸入的的分布也發生改變,而學習的過程又要使每一層適應輸入的分布,因此我們不得不降低學習率、小心地初始化。作者將分布發生變化稱之為internal covariate shift。
關於BN層,這一篇部落格講得很好,//blog.csdn.net/app_12062011/article/details/57083447我在這裡轉一下。
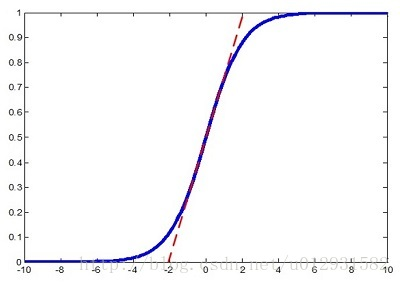
但是作者又說如果簡單的這麼干,會降低層的表達能力。比如下圖,在使用sigmoid激活函數的時候,如果把數據限制到0均值單位方差,那麼相當於只使用了激活函數中近似線性的部分,這顯然會降低模型表達能力。為此,作者又為BN增加了2個參數,
用來保持模型的表達能力把BN放在激活函數之前,這是因為Wx+b具有更加一致和非稀疏的分布。
inception-v3
- n∗n的卷積核都可以通過1∗n一維卷積後接n∗1一維卷積來代替。例如,一個 3×3 的卷積等價於首先執行一個 1×3 的卷積再執行一個 3×1 的卷積。他們還發現這種方法在成本上要比單個 3×3 的卷積降低 33%,這種非對稱的卷積結構拆分,節省了大量的參數,其結果對比將一個大卷積核拆分為幾個相同的小卷積核 ,效果更明顯。這一結構如下圖所示:
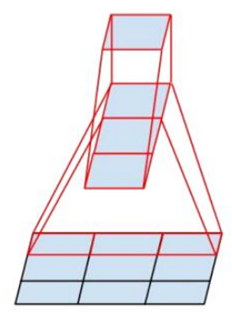
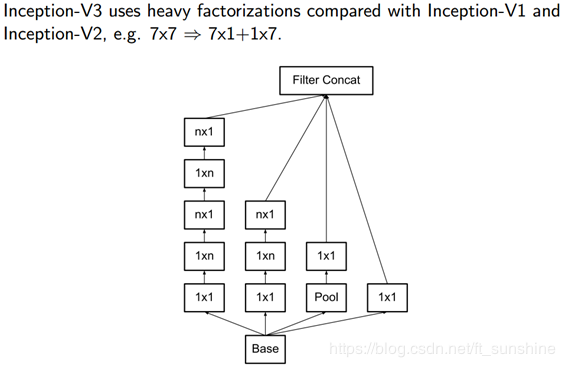
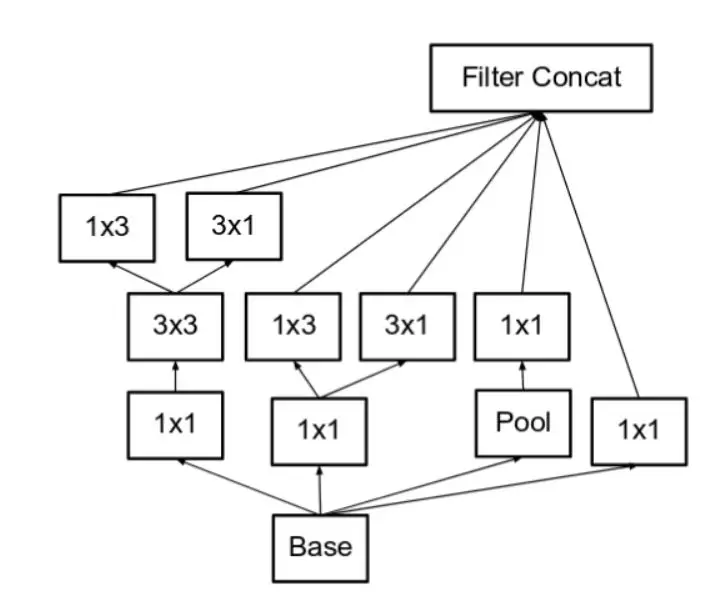
此處如果 n=3,則與上一張影像一致。最左側的 5x5 卷積可被表示為兩個 3x3 卷積,它們又可以被表示為 1x3 和 3x1 卷積。
本文的主要目的是研究如何在增加網路規模的同時,能夠保證計算的高效率。
Rethinking這篇論文中提出了一些CNN調參的經驗型規則,暫列如下:
- 避免特徵表徵的瓶頸。特徵表徵就是指影像在CNN某層的激活值,特徵表徵的大小在CNN中應該是緩慢的減小的。
- 高維的特徵更容易處理,在高維特徵上訓練更快,更容易收斂
- 低維嵌入空間上進行空間匯聚,損失並不是很大。這個的解釋是相鄰的神經單元之間具有很強的相關性,資訊具有冗餘。
- 平衡的網路的深度和寬度。寬度和深度適宜的話可以讓網路應用到分散式上時具有比較平衡的computational budget。
更小的卷積核
Inception Net v3 整合了前面 Inception v2 中提到的所有升級,還使用了:
-
RMSProp 優化器;
-
Factorized 7x7 卷積;
-
輔助分類器使用了 BatchNorm;
-
標籤平滑(添加到損失公式的一種正則化項,旨在阻止網路對某一類別過分自信,即阻止過擬合)。
簡而言之,就是將尺寸比較大的卷積,變成一系列3×3的卷積的疊加,這樣既具有相同的視野,還具有更少的參數。
實驗表明,這樣做不會導致性能的損失。
Grid Size Reduction
Grid就是影像在某一層的激活值,即feature_map,一般情況下,如果想讓影像縮小,可以有如下兩種方式:
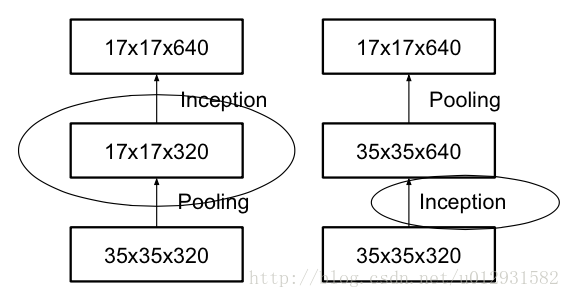
右圖是正常的縮小,但計算量很大。左圖先pooling會導致特徵表徵遇到瓶頸,違反上面所說的第一個規則,為了同時達到不違反規則且降低計算量的作用,將網路改為下圖:
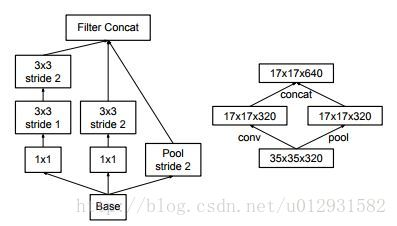
結構如左圖表示,左邊兩個代表的是右圖中的左邊分支。
label smoothing
除了上述的模型結構的改進以外,Rethinking那篇論文還改進了目標函數。
原來的目標函數,在單類情況下,如果某一類概率接近1,其他的概率接近0,那麼會導致交叉熵取log後變得很大很大。從而導致兩個問題:
過擬合
導致樣本屬於某個類別的概率非常的大,模型太過於自信自己的判斷。
所以,使用了一種平滑方法,可以使得類別概率之間的差別沒有那麼大.
Resnet和ResNeXt
《Deep Residual Learning for Image Recognition》
《Identity Mappings in Deep Residual Networks》
解決深度網路的退化問題,常規的網路的堆疊(plain network)在網路很深的時候,效果卻越來越差了。其中的原因之一即是網路越深,梯度消失的現象就越來越明顯,網路的訓練效果也不會很好。
但是現在淺層的網路(shallower network)又無法明顯提升網路的識別效果了,所以現在要解決的問題就是怎樣在加深網路的情況下又解決梯度消失的問題。
作者提出了Residual的結構:
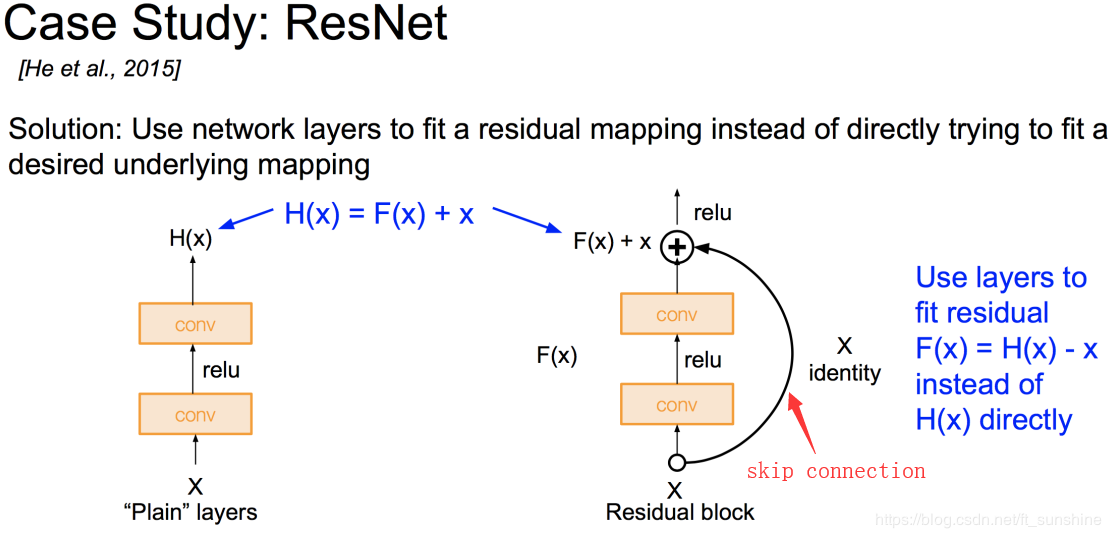
即增加一個identity mapping(恆等映射),將原始所需要學的函數H(x)轉換成F(x)+x,而作者認為這兩種表達的效果相同,但是優化的難度卻並不相同,作者假設F(x)的優化 會比H(x)簡單的多。這一想法也是源於影像處理中的殘差向量編碼,通過一個reformulation,將一個問題分解成多個尺度直接的殘差問題,能夠很好的起到優化訓練的效果。
這個Residual block通過shortcut connection實現,通過shortcut將這個block的輸入和輸出進行一個element-wise的加疊,這個簡單的加法並不會給網路增加額外的參數和計算量,同時卻可以大大增加模型的訓練速度、提高訓練效果,並且當模型的層數加深時,這個簡單的結構能夠很好的解決退化問題。
接下來,作者就設計實驗來證明自己的觀點。
首先構建了一個18層和一個34層的plain網路,即將所有層進行簡單的鋪疊,然後構建了一個18層和一個34層的residual網路,僅僅是在plain上插入了shortcut,而且這兩個網路的參數量、計算量相同,並且和之前有很好效果的VGG-19相比,計算量要小很多。這也是作者反覆強調的地方,也是這個模型最大的優勢所在。
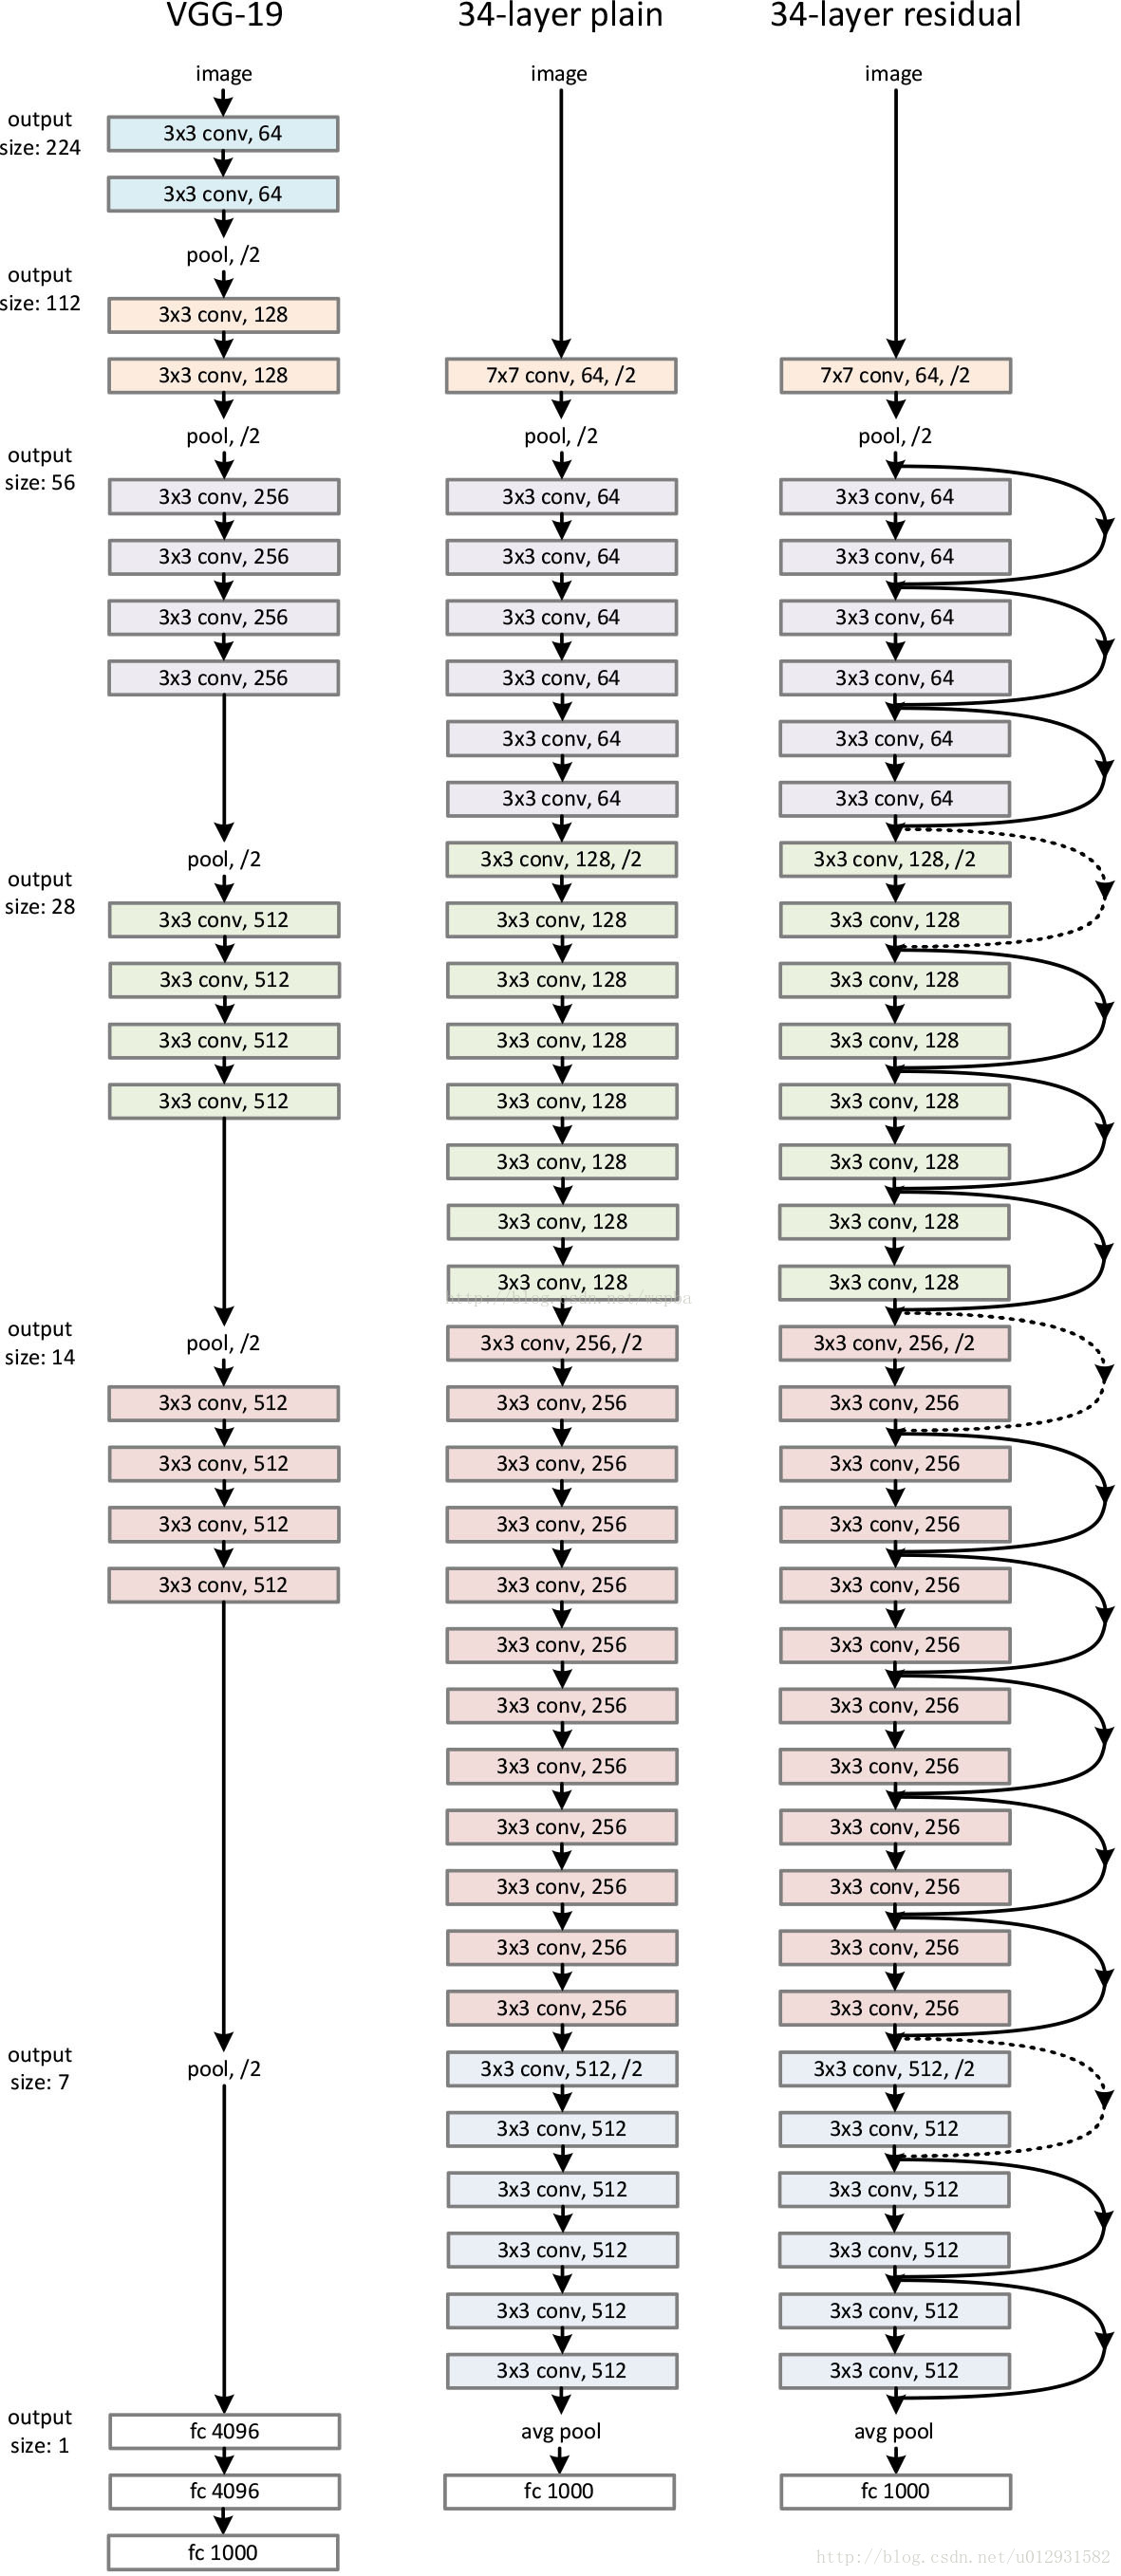
模型構建好後進行實驗,在plain上觀測到明顯的退化現象,而且ResNet上不僅沒有退化,34層網路的效果反而比18層的更好,而且不僅如此,ResNet的收斂速度比plain的要快得多。
對於shortcut的方式,作者提出了三個選項:
- 使用恆等映射,如果residual block的輸入輸出維度不一致,對增加的維度用0來填充;
- 在block輸入輸出維度一致時使用恆等映射,不一致時使用線性投影以保證維度一致;
- 對於所有的block均使用線性投影。
對這三個選項都進行了實驗,發現雖然3的效果好於2的效果好於1的效果,但是差距很小,因此線性投影並不是必需的,而使用0填充時,可以保證模型的複雜度最低,這對於更深的網路是更加有利的。另外,shortcut過程中,stride是2可以保證feature map的大小一致。
進一步實驗,作者又提出了deeper的residual block:
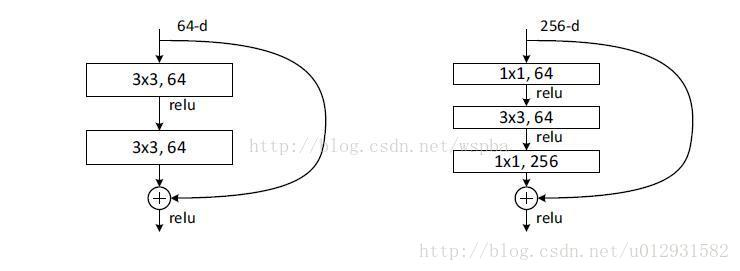
這相當於對於相同數量的層又減少了參數量,因此可以拓展成更深的模型。於是作者提出了50、101、152層的ResNet,而且不僅沒有出現退化問題,錯誤率也大大降低,同時計算複雜度也保持在很低的程度。
這個時候ResNet的錯誤率已經把其他網路落下幾條街了,但是似乎還並不滿足,於是又搭建了更加變態的1202層的網路,對於這麼深的網路,優化依然並不困難,但是出現了過擬合的問題,並且也很容易出現梯度消失或者梯度爆炸問題,這是很正常的,作者也說了以後會對這個1202層的模型進行進一步的改進。
Inception v4 和 Inception -ResNet 在同一篇論文《Inception-v4, Inception-ResNet and the Impact of Residual Connections on Learning》中介紹。為清晰起見,我們分成兩個部分來介紹。
Inception-ResNet v1 和 v2
受 ResNet 的優越性能啟發,研究者提出了一種混合 inception 模組。Inception ResNet 有兩個子版本:v1 和 v2。在我們分析其顯著特徵之前,先看看這兩個子版本之間的微小差異。
-
Inception-ResNet v1 的計算成本和 Inception v3 的接近
-
Inception-ResNetv2 的計算成本和 Inception v4 的接近
-
它們有不同的 stem,正如 Inception v4 部分所展示的
-
兩個子版本都有相同的模組 A、B、C 和縮減塊結構。唯一的不同在於超參數設置。在這一部分,我們將聚焦於結構,並參考論文中的相同超參數設置(影像是關於 Inception-ResNet v1 的)
問題:引入殘差連接,它將 inception 模組的卷積運算輸出添加到輸入上。
方法:為了使殘差加運算可行,卷積之後的輸入和輸出必須有相同的維度。因此,我們在初始卷積之後使用 1x1 卷積來匹配深度(深度在卷積之後會增加)。
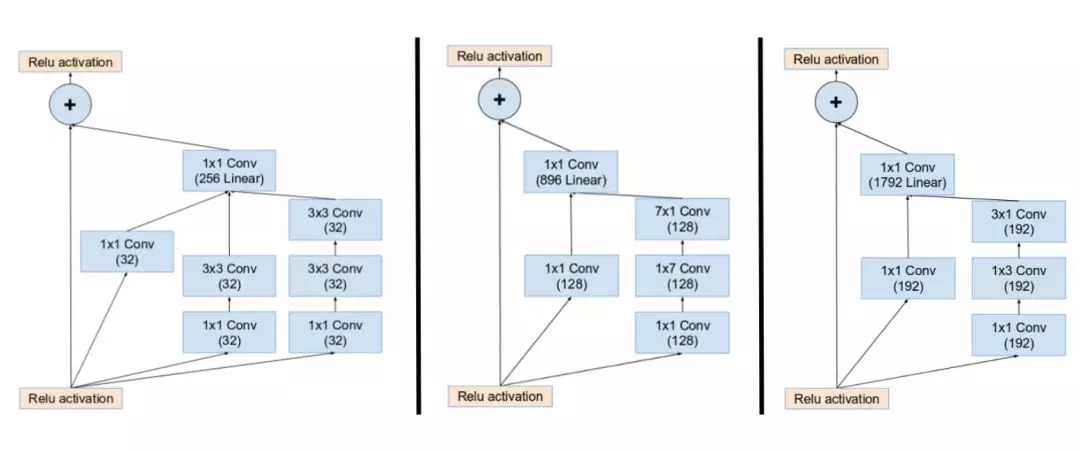
Inception ResNet 中的 Inception 模組 A、B、C。注意池化層被殘差連接所替代,並在殘差加運算之前有額外的 1x1 卷積。
主要 inception 模組的池化運算由殘差連接替代。然而,你仍然可以在縮減塊中找到這些運算。縮減塊 A 和 Inception v4 中的縮減塊相同。
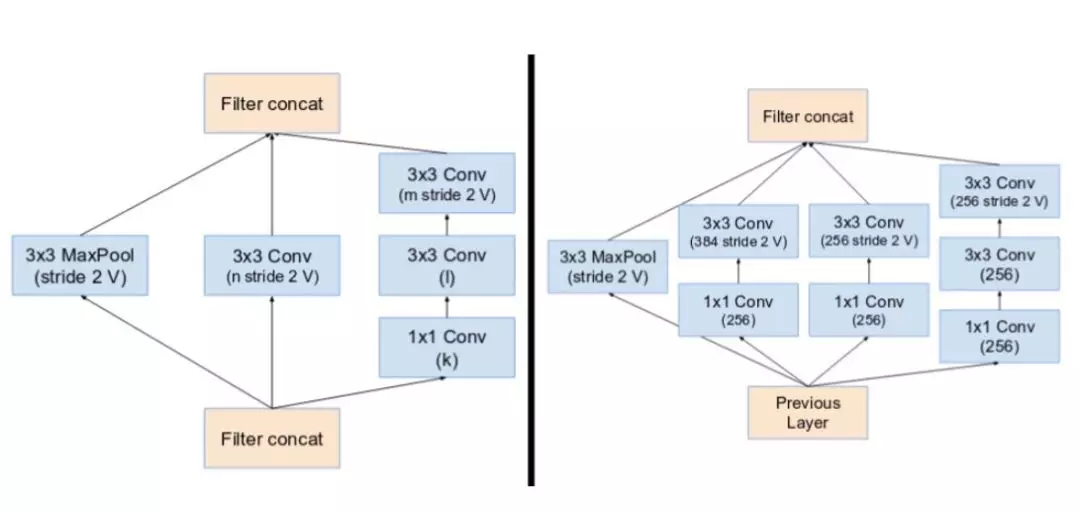
(左起)縮減塊 A(從 35x35 到 17x17 的尺寸縮減)和縮減塊 B(從 17x17 到 8x8 的尺寸縮減)。這裡參考了論文中的相同超參數設置(V,I,K)。(圖源://arxiv.org/pdf/1602.07261.pdf)
如果卷積核的數量超過 1000,則網路架構更深層的殘差單元將導致網路崩潰。因此,為了增加穩定性,作者通過 0.1 到 0.3 的比例縮放殘差激活值。
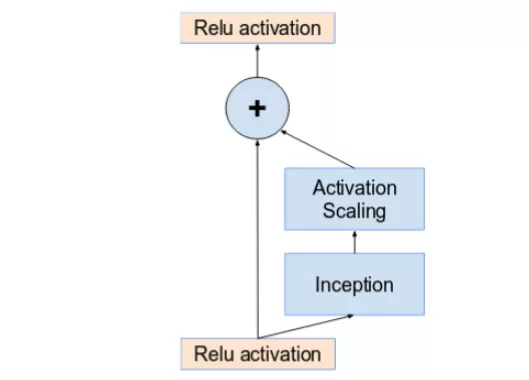
激活值通過一個常數進行比例縮放,以防止網路崩潰。
-
原始論文並沒有在求和之後使用批歸一化,以在單個 GPU 上訓練模型(在單個 GPU 上擬合整個模型)。
-
研究發現 Inception-ResNet 模型可以在更少的 epoch 內達到更高的準確率。
-
Inception v4 和 Inception-ResNet 的網路完整架構如下圖所示:
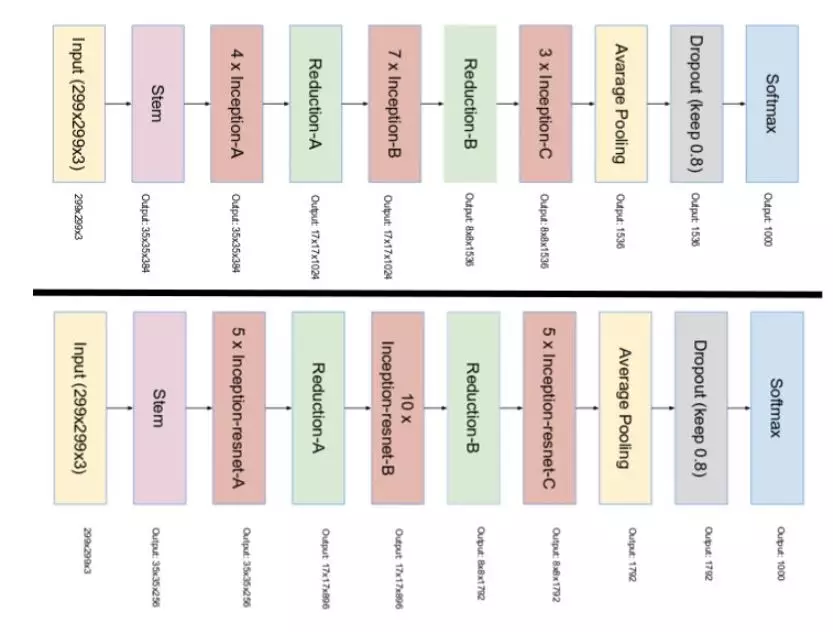
這篇論文里,作者借鑒了resnet的殘差網路的思想,將其應用到了inception-v3當中,結構如下:
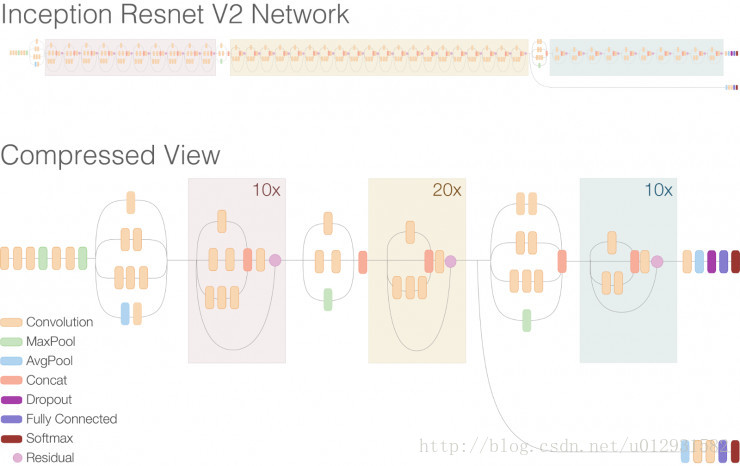
inception-v4:Inception with skip connections
論文:Inception-v4, Inception-ResNet and the Impact of Residual Connections on Learning
問題:某些模組有不必要的複雜性。我們應該添加更多一致的模組來提高性能。
方法:Inception v4 的 stem 被修改了。這裡的 stem 參考了在引入 Inception 塊之前執行的初始運算集。
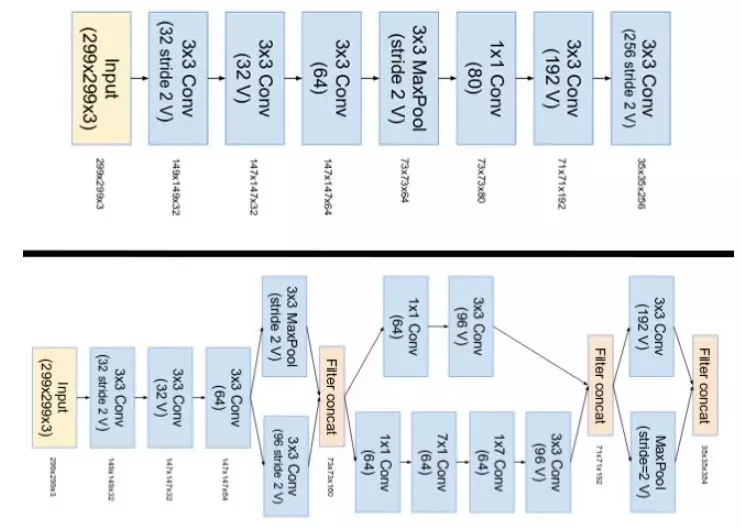
圖上部是 Inception-ResNet v1 的 stem。圖下部是 Inception v4 和 Inception-ResNet v2 的 stem
它們有三個主要的 Inception 模組,稱為 A、B 和 C(和 Inception v2 不同,這些模組確實被命名為 A、B 和 C)。它們看起來和 Inception v2(或 v3)變體非常相似。
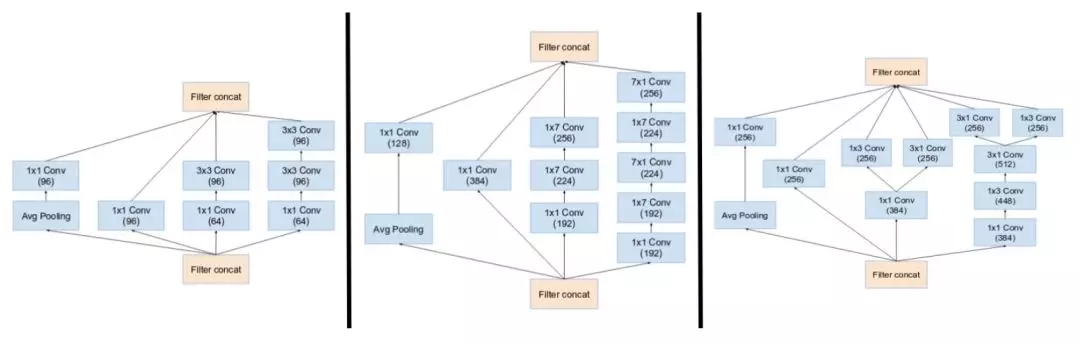
Inception v4 引入了專用的「縮減塊」(reduction block),它被用於改變網格的寬度和高度。早期的版本並沒有明確使用縮減塊,但也實現了其功能。
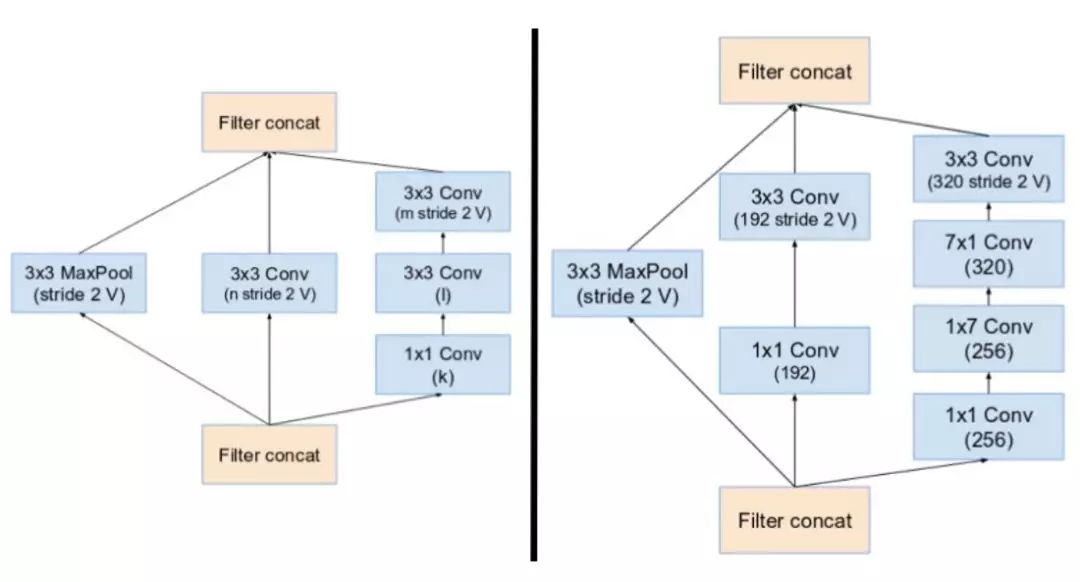
縮減塊 A(從 35x35 到 17x17 的尺寸縮減)和縮減塊 B(從 17x17 到 8x8 的尺寸縮減)。這裡參考了論文中的相同超參數設置(V,I,k)。
inception-v4 是通過提出了更多新的inception module擴展網路結構,能夠達到和inception-resnet-v2相媲美的效果,這個有時間再研究一下。
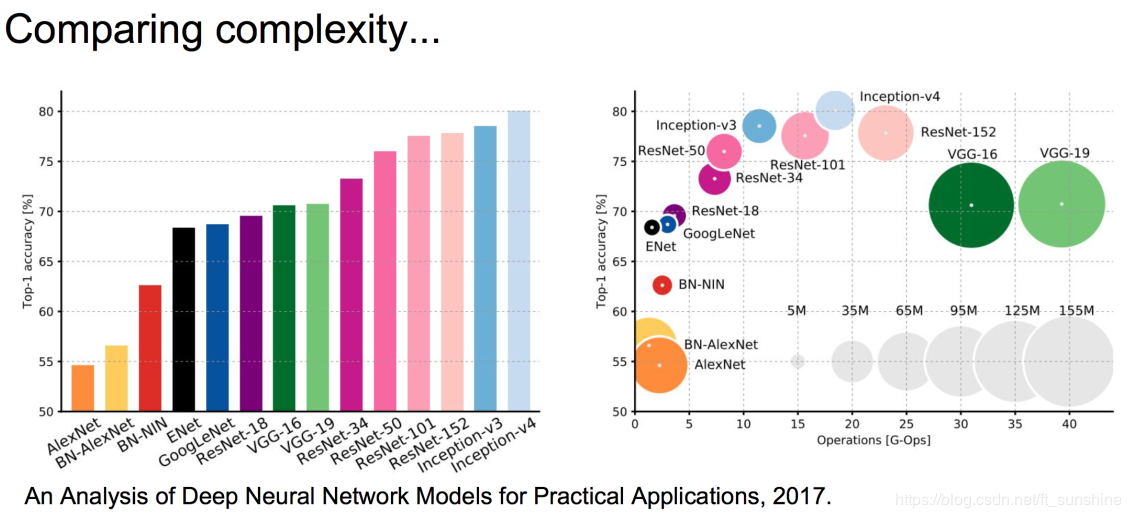
網路的性能分析圖
Xception
Xception 是 Google 繼 Inception 後提出的對 Inception-v3 的另一種改進。
作者認為,通道之間的相關性 與 空間相關性 最好要分開處理。採用 Separable Convolution(極致的 Inception 模組)來替換原來 Inception-v3中的卷積操作。
在 Inception 中,特徵可以通過 1×1卷積,3×3卷積,5×5 卷積,pooling 等進行提取,Inception 結構將特徵類型的選擇留給網路自己訓練,也就是將一個輸入同時輸給幾種提取特徵方式,然後做 concat 。Inception-v3的結構圖如下:
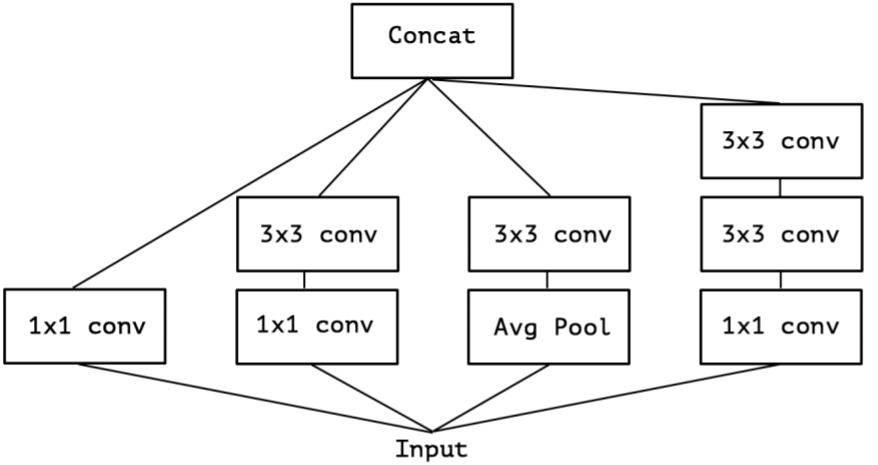
對 Inception-v3 進行簡化,去除 Inception-v3 中的 avg pool 後,輸入的下一步操作就都是 1×1卷積: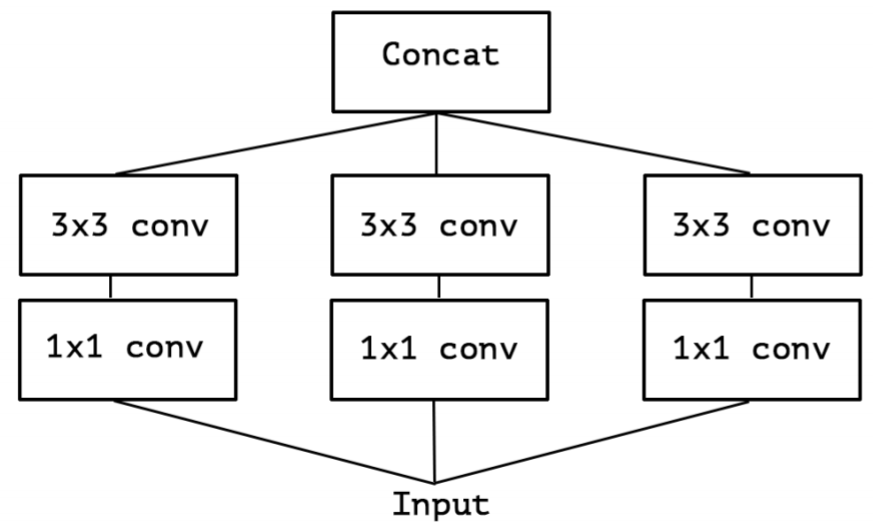
提取 1×11×11×1 卷積的公共部分: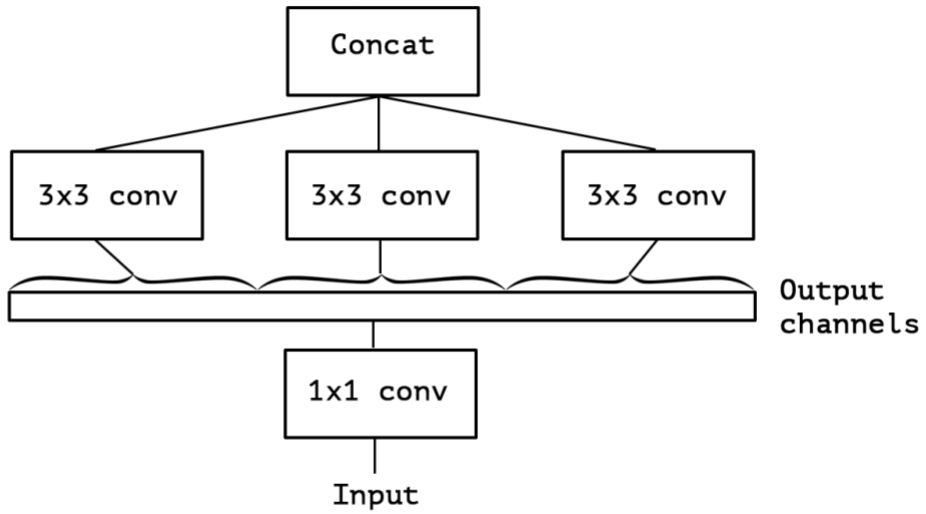
Xception(極致的 Inception):先進行普通卷積操作,再對 1×11×11×1 卷積後的每個channel分別進行 3×33×33×3 卷積操作,最後將結果 concat: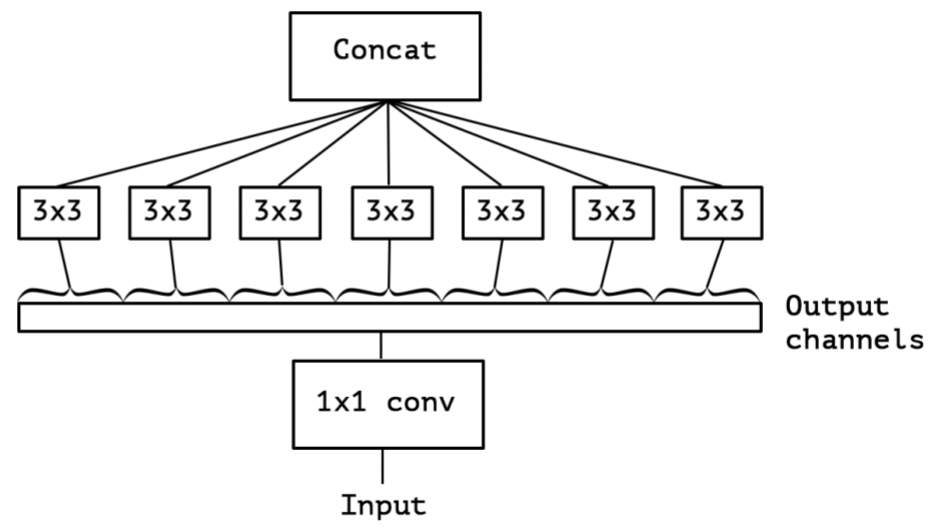
深度可分離卷積 Depthwise Separable Convolution
傳統的卷積實現過程---->Depthwise Separable Convolution 的實現過程:
 --->
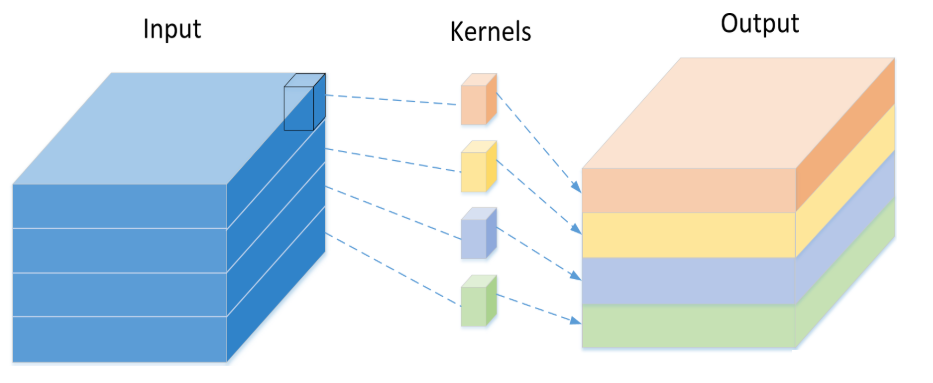
Depthwise Separable Convolution 與 極致的 Inception 區別:
極致的 Inception:
第一步:普通 1×11×11×1 卷積。
第二步:對 1×11×11×1 卷積結果的每個 channel,分別進行 3×33×33×3 卷積操作,並將結果 concat。
Depthwise Separable Convolution:
第一步:Depthwise 卷積,對輸入的每個channel,分別進行 3×33×33×3 卷積操作,並將結果 concat。
第二步:Pointwise 卷積,對 Depthwise 卷積中的 concat 結果,進行 1×11×11×1 卷積操作。
兩種操作的循序不一致:Inception 先進行 1×11×11×1 卷積,再進行 3×33×33×3 卷積;Depthwise Separable Convolution 先進行 3×33×33×3 卷積,再進行 1×11×11×1 卷積。(作者認為這個差異並沒有大的影響)
作者發現,在「極致的 Inception」模組中,用於學習空間相關性的 3×33×33×3 的卷積,和用於學習通道間相關性的 1×11×11×1 卷積之間,不使用非線性激活函數時,收斂過程更快、準確率更高:
DenseNet
現在我們有三種方式來處理不同卷積層之間的特徵圖:
- Standard Connectivity
- Residual/Skip Connectivity
- Densenet: Dense Connectivity
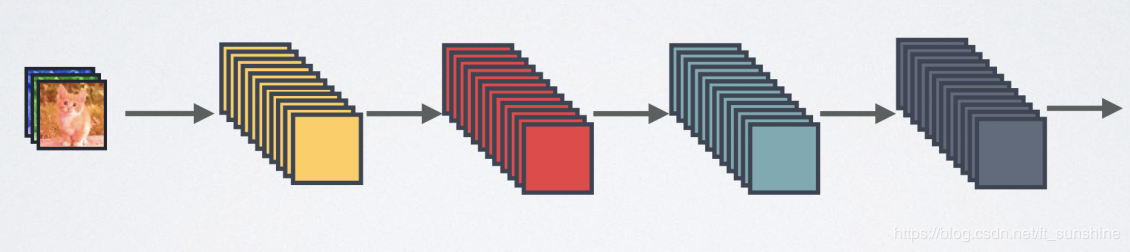
標準連接
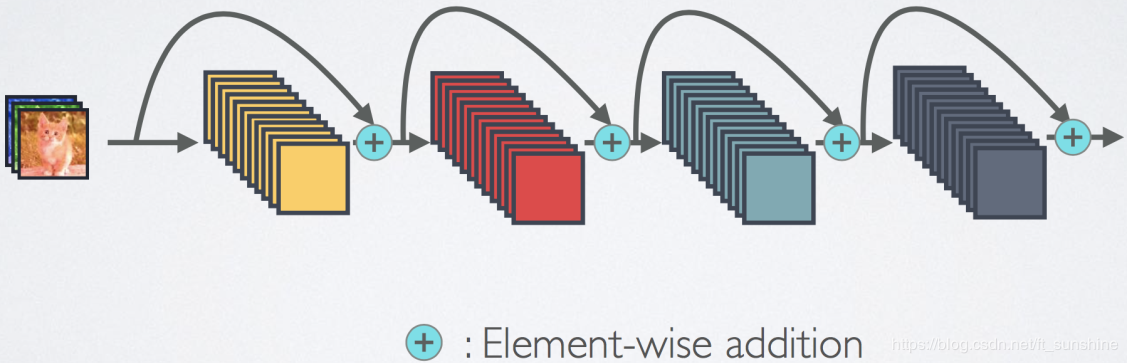
Residual/Skip 連接
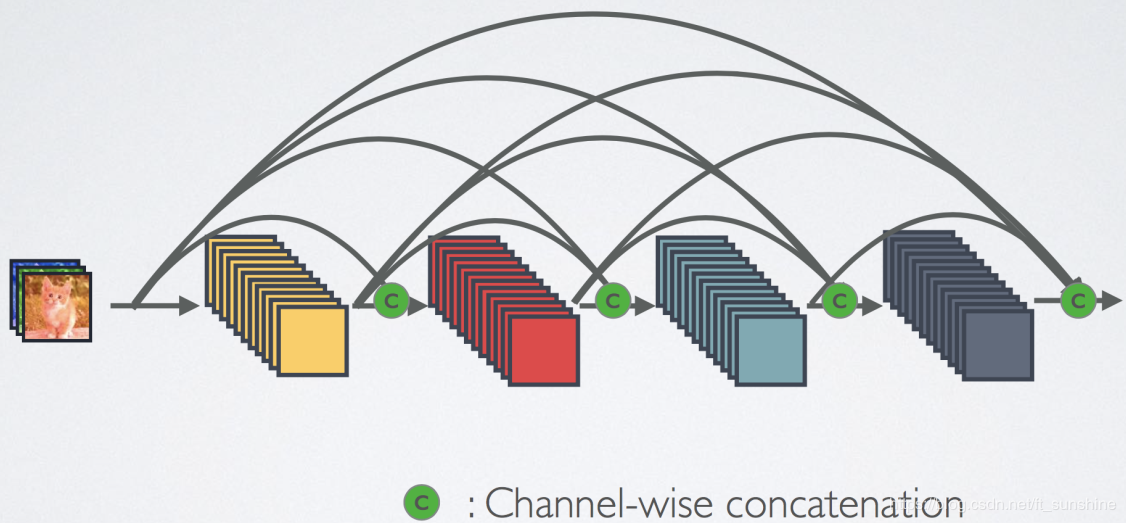
DenseNet:密集連接性
DenseNet的思想是某一層的輸入是其前面每一層的輸出,即將不同層得到的特徵圖進行融合作為某一層的輸入,這樣CNN的每一層就可以得到前面不同層提取的特徵(淺層位置等基礎資訊,深層語義資訊),這樣網路的表達能力會更好。圖示如下:
如果僅僅如之前那麼設計的話,很容易出現梯度爆炸,所以:用之前提到的1∗11*11∗1卷積!bottleneck降維
下圖是Dense Blocks的結構圖,在每個Dense Blocks內部,每層的feature map的大小是一致的(方便特徵融合),不同Dense Blocks之間有Pooling層用於減小feature map的大小。
總結
基礎框架:Lenet、Alexnet、VGG、Prelu
Inception系列(寬網路):從Inception v1 到v4 以及Inception-Resnet系列
Resnet系列 (長網路):從Resnet被提出後,許許多多該架構被相應提出,Desnet表現出其良好的優越性,殘差網路使網路能夠更好的處理梯度消失問題。PreActResNet將bn和relu放在前面,得到了很好的效果。還有Resnetx等,這裡不多介紹了。
輕型模型 (輕網路):受限移動端的設備,主要思想是將卷積核分離,SqueezeNet 大量採用1x1的網路。mobilenet將3x3的網路分離為n個3x3的卷積核和1x1的卷積核。Shufflenet系列考不同channel之間的關聯,提出group1x1,然後再進行混洗。
attention模型(重網路):類似與文本的attention,主要針對不同channel的權重和每個channel不同區域的權重。Residual Attention Network和Senet為典型。
參考
XreCis CSDN部落格://blog.csdn.net/lly1122334/article/details/88717074
SENets-Residual Attention Networks
其中兩個你沒寫道:SegNet、SqueezeNet、YOLO、ResNeXt

