一鍵導出微信讀書的書籍和筆記
- 2020 年 4 月 12 日
- 筆記
簡介
全民閱讀的時代已經來臨,目前使用讀書軟體的用戶數2.1億,日活躍用戶超過500萬,其中19-35歲年輕用戶佔比超過60%,本科及以上學歷用戶佔比高達80%,北上廣深及其他省會城市/直轄市用戶佔比超過80%。本人習慣使用微信讀書,為了方便整理書籍和導出筆記,便開發了這個小工具。
部分截圖
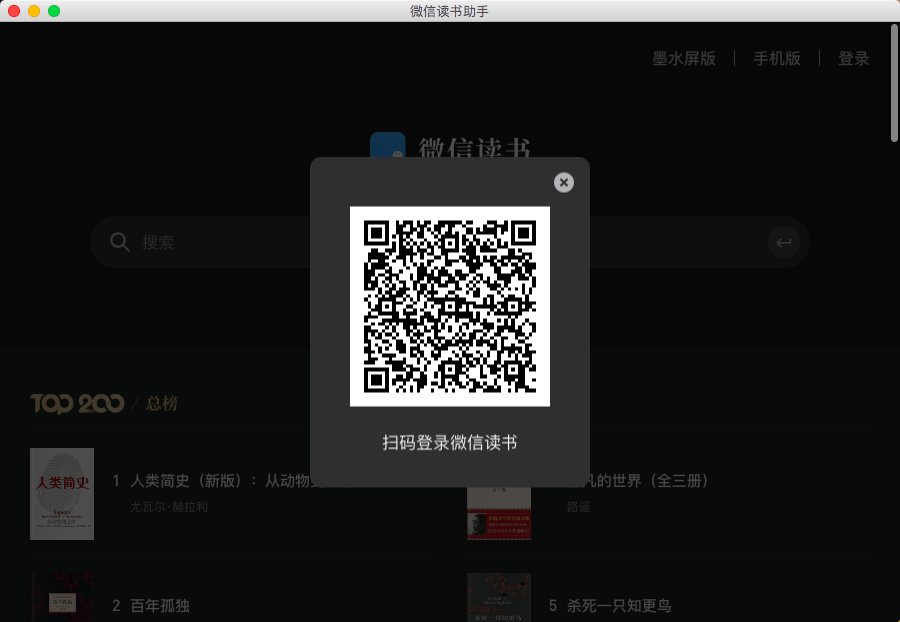
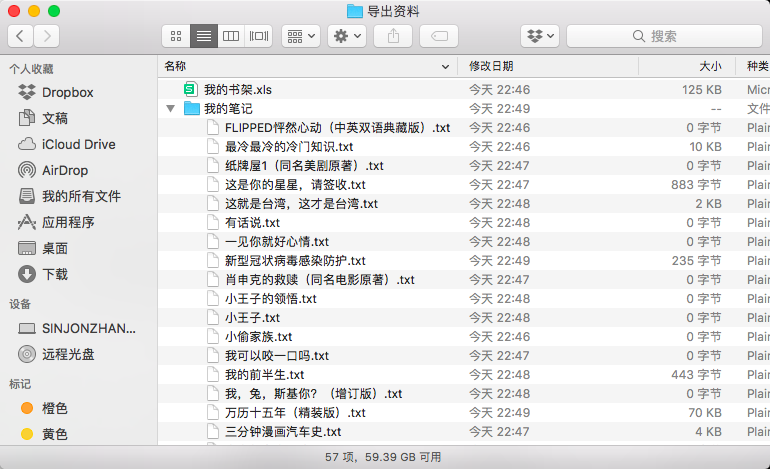

程式碼思路
1. 目錄結構
首先,我們先看一下整體目錄結構
Code ├─ excel_func.py 讀寫excel文件 ├─ pyqt_gui.py PyQt GUI介面 └─ wereader.py 微信讀書相關api -
excel_func.py
使用xlrd和xlwt庫對excel文件進行讀寫操作 -
pyqt_gui.py
使用PyQt繪製GUI介面 -
wereader.py
通過抓包解析獲得相關api
2. excel_func.py
def write_excel_xls(path, sheet_name_list, value): # 新建一個工作簿 workbook = xlwt.Workbook() # 獲取需要寫入數據的行數 index = len(value) for sheet_name in sheet_name_list: # 在工作簿中新建一個表格 sheet = workbook.add_sheet(sheet_name) # 往這個工作簿的表格中寫入數據 for i in range(0, index): for j in range(0, len(value[i])): sheet.write(i, j, value[i][j]) # 保存工作簿 workbook.save(path) 該函數的程式碼流程為:
- 創建excel文件
- 創建表格
- 往表格寫入數據
3. pyqt_gui.py
class MainWindow(QMainWindow): def __init__(self, *args, **kwargs): super().__init__(*args, **kwargs) self.DomainCookies = {} self.setWindowTitle('微信讀書助手') # 設置窗口標題 self.resize(900, 600) # 設置窗口大小 self.setWindowFlags(Qt.WindowMinimizeButtonHint) # 禁止最大化按鈕 self.setFixedSize(self.width(), self.height()) # 禁止調整窗口大小 url = 'https://weread.qq.com/#login' # 目標地址 self.browser = QWebEngineView() # 實例化瀏覽器對象 QWebEngineProfile.defaultProfile().cookieStore().deleteAllCookies() # 初次運行軟體時刪除所有cookies QWebEngineProfile.defaultProfile().cookieStore().cookieAdded.connect(self.onCookieAdd) # cookies增加時觸發self.onCookieAdd()函數 self.browser.loadFinished.connect(self.onLoadFinished) # 網頁載入完畢時觸發self.onLoadFinished()函數 self.browser.load(QUrl(url)) # 載入網頁 self.setCentralWidget(self.browser) # 設置中心窗口 該函數的程式碼流程為:
- 新建QT窗口
- 實例化QWebEngineView對象
- 綁定self.onCookieAdd事件
- 綁定self.onLoadFinished事件
- 載入網頁
# 網頁載入完畢事件 def onLoadFinished(self): global USER_VID global HEADERS # 獲取cookies cookies = ['{}={};'.format(key, value) for key,value in self.DomainCookies.items()] cookies = ' '.join(cookies) # 添加Cookie到header HEADERS.update(Cookie=cookies) # 判斷是否成功登錄微信讀書 if login_success(HEADERS): print('登錄微信讀書成功!') # 獲取用戶user_vid if 'wr_vid' in self.DomainCookies.keys(): USER_VID = self.DomainCookies['wr_vid'] print('用戶id:{}'.format(USER_VID)) # 關閉整個qt窗口 self.close() else: print('請掃描二維碼登錄微信讀書...') 該函數的程式碼流程為:
- 當網頁載入完畢時,檢測是否成功登錄微信讀書
- 如果成功登錄微信讀書,則關閉QT窗口,開始進行數據導出
- 如果失敗登錄微信讀書,則繼續等待用戶掃描二維碼
# 添加cookies事件 def onCookieAdd(self, cookie): if 'weread.qq.com' in cookie.domain(): name = cookie.name().data().decode('utf-8') value = cookie.value().data().decode('utf-8') if name not in self.DomainCookies: self.DomainCookies.update({name: value}) 該函數的程式碼流程為:
- 保存微信讀書網址的cookies,以便後續操作
books = get_bookshelf(USER_VID, HEADERS) # 獲取書架上的書籍 books_finish_read = books['finishReadBooks'] books_recent_read = books['recentBooks'] books_all = books['allBooks'] write_excel_xls_append(data_dir + '我的書架.xls', '已讀完的書籍', books_finish_read) # 追加寫入excel文件 write_excel_xls_append(data_dir + '我的書架.xls', '最近閱讀的書籍', books_recent_read) # 追加寫入excel文件 write_excel_xls_append(data_dir + '我的書架.xls', '所有的書籍', books_all) # 追加寫入excel文件 # 獲取書架上的每本書籍的筆記 for index, book in enumerate(books_finish_read): book_id = book[0] book_name = book[1] notes = get_bookmarklist(book[0], HEADERS) with open(note_dir + book_name + '.txt', 'w') as f: f.write(notes) print('導出筆記 {} ({}/{})'.format(note_dir + book_name + '.txt', index+1, len(books_finish_read))) 該函數的程式碼流程為:
- 調用write_excel_xls_append函數,保存書籍,並且導出筆記
4. wereader.py
def get_bookshelf(userVid, headers): """獲取書架上所有書""" url = "https://i.weread.qq.com/shelf/friendCommon" params = dict(userVid=userVid) r = requests.get(url, params=params, headers=headers, verify=False) if r.ok: data = r.json() else: raise Exception(r.text) books_finish_read = set() # 已讀完的書籍 books_recent_read = set() # 最近閱讀的書籍 books_all = set() # 書架上的所有書籍 for book in data['recentBooks']: if not book['bookId'].isdigit(): # 過濾公眾號 continue b = Book(book['bookId'], book['title'], book['author'], book['cover'], book['intro'], book['category']) books_recent_read.add(b) books_all = books_finish_read + books_recent_read return dict(finishReadBooks=books_finish_read, recentBooks=books_recent_read, allBooks=books_all) 該函數的程式碼流程為:
- 獲取最近閱讀的書籍、已經讀完的書籍、所有書籍
- 過濾公眾號部分
- 將書籍數據保存為字典格式
def get_bookmarklist(bookId, headers): """獲取某本書的筆記返回md文本""" url = "https://i.weread.qq.com/book/bookmarklist" params = dict(bookId=bookId) r = requests.get(url, params=params, headers=headers, verify=False) if r.ok: data = r.json() # clipboard.copy(json.dumps(data, indent=4, sort_keys=True)) else: raise Exception(r.text) chapters = {c['chapterUid']: c['title'] for c in data['chapters']} contents = defaultdict(list) for item in sorted(data['updated'], key=lambda x: x['chapterUid']): # for item in data['updated']: chapter = item['chapterUid'] text = item['markText'] create_time = item["createTime"] start = int(item['range'].split('-')[0]) contents[chapter].append((start, text)) chapters_map = {title: level for level, title in get_chapters(int(bookId), headers)} res = '' for c in sorted(chapters.keys()): title = chapters[c] res += '#' * chapters_map[title] + ' ' + title + 'n' for start, text in sorted(contents[c], key=lambda e: e[0]): res += '> ' + text.strip() + 'nn' res += 'n' return res 該函數的程式碼流程為:
- 獲取某一本書籍的筆記
- 將返回的字元串改寫成markdown格式並輸出
如何運行
# 跳轉到當前目錄 cd 目錄名 # 先卸載依賴庫 pip uninstall -y -r requirement.txt # 再重新安裝依賴庫 pip install -r requirement.txt -i https://pypi.tuna.tsinghua.edu.cn/simple # 開始運行 python pyqt_gui.py 補充
項目持續更新,歡迎您star本項目