曹工說Redis源碼(2)-- redis server 啟動過程解析及簡單c語言基礎知識補充
- 2020 年 4 月 11 日
- 筆記
文章導航
Redis源碼系列的初衷,是幫助我們更好地理解Redis,更懂Redis,而怎麼才能懂,光看是不夠的,建議跟著下面的這一篇,把環境搭建起來,後續可以自己閱讀源碼,或者跟著我這邊一起閱讀。由於我用c也是好幾年以前了,些許錯誤在所難免,希望讀者能不吝指出。
曹工說Redis源碼(1)-- redis debug環境搭建,使用clion,達到和調試java一樣的效果
一些補充知識
項目結構及入口
除了大學那些玩具,一個真正的項目,都是由大量源程式碼文件組成一個工程。在Java里,一個 java 文件要使用其他 java 文件中的函數、類型、變數等,都需要使用import語句來引入。在c語言里,也是一樣的,在c語言中,要引入其他文件的功能,需要使用include語句。
比如,在redis的主入口,redis.c文件中,就包含了如下一堆語句:
#include "redis.h" #include "cluster.h" #include "slowlog.h" #include "bio.h" #include <time.h> #include <signal.h> 其中,以<開頭的,比如<time.h>是標準庫的頭文件,會在系統指定的路徑下查找,可類比為jdk官方的class;"bio.h"這種,以""包裹的,則是工程里自定義的。
比如,time.h,我在linux的以下路徑查找到了:
[root@mini1 src]# locate time.h /usr/include/time.h 其他include相關知識,可以參考:
https://www.runoob.com/cprogramming/c-header-files.html
我對頭文件的理解
一般來說,我們會在.c文件中,去編寫我們的業務邏輯方法,其中,一些方法,可能是只在本文件內部用到的,類似於java class的private方法;一些方法呢,可能是需要在外部的其他源碼文件中,也需要用到的,這些方法,要怎麼才能讓外部可以使用呢?
就是通過頭文件機制,可以理解為各大高級語言中的介面,在java中,定義一個class,雖然可以直接把方法設為public,其他類可以直接訪問;但是,在平時的業務開發中,我們一般並不會直接訪問一個實現類,而是通過它實現的介面去訪問;一個好的實現類,也不應該把沒在介面中定義的方法,設為public許可權。
說回頭文件,比如有個源碼文件test.c 如下:
long long ustime(void) { struct timeval tv; long long ust; gettimeofday(&tv, NULL); ust = ((long long)tv.tv_sec)*1000000; ust += tv.tv_usec; return ust; } /* Return the UNIX time in milliseconds */ // 返回毫秒格式的 UNIX 時間 // 1 秒 = 1 000 毫秒 long long mstime(void) { return ustime()/1000; } 這個文件里,定義了2個方法,但假設我們只需要對外暴露mstime(void)方法,那麼,頭文件test.h應該是下面這樣的:
long long mstime(void); 這樣的話,我們的另一個方法,ustime,對外就不可見了。
總之,大家可以把頭文件理解為實現類要對外暴露的介面;大家可能覺得我的比喻不恰當,為啥把c文件,說成實現類,實際上,我們之前在華為的時候,確實是用c++的思想,面向對象的思想,來寫c語言的。
我看到網上一篇文章,這裡引用一下(https://zhuanlan.zhihu.com/p/57882822):
反觀Redis,他是純C編碼,但是融入了面向對象的思想。和上述觀點截然相反,可謂是『用C++去設計,用C編碼』。當然本文目的並非挑起語言之爭,各種語言自有其利弊,開源項目的語言選擇也主要是由於項目作者的個人經歷和主觀意願。
但是c語言中的頭文件,和java這些語言中的介面,還是不同的;在java中,介面和實現類一樣,最終都是編譯為獨立的class文件。
在c語言中,在編譯實現類之前,會有一個預處理的過程,預處理的過程,就是把include語句,直接替換為被include的頭文件的內容,比如,以菜鳥教程中的例子舉例:
header.h char *test (void); 在如下的 program.c中,需要使用上面的header.h中的test方法,則需要include:
int x; #include "header.h" int main (void) { puts (test ()); } 經過預處理後,(就是進行簡單的replace),效果如下:
int x; char *test (void); int main (void) { puts (test ()); } 我們可以使用如下命令,來演示這個過程:
[root@mini1 test]# gcc -E program.c int x; # 1 "header.h" 1 char *test (void); # 3 "program.c" 2 int main (void) { puts (test ()); } 從上面可以看到,已經replace進去了;如果我們include兩次,會怎樣?
[root@mini1 test]# gcc -E program.c int x; # 1 "header.h" 1 char *test (void); # 3 "program.c" 2 # 1 "header.h" 1 char *test (void); # 4 "program.c" 2 int main (void) { puts (test ()); } 可以發現,這個header的內容,出現了2次,重複了。但是上面這種情況,並不會報錯,無非是方法被定義了兩次。
為什麼頭文件里都要來一句ifndef
大家看頭文件,都會發現如下語句,比如在redis.h中:
#ifndef __REDIS_H #define __REDIS_H #include "fmacros.h" #include "config.h" ... typedef struct redisObject { // 類型 unsigned type:4; // 編碼 unsigned encoding:4; // 對象最後一次被訪問的時間 unsigned lru:REDIS_LRU_BITS; /* lru time (relative to server.lruclock) */ // 引用計數 int refcount; // 指向實際值的指針 void *ptr; } robj; ... #endif 可以看到,最開始,有一句:
#ifndef __REDIS_H #define __REDIS_H 結尾有一句:
#endif 這個就是為了解決如下問題:
在頭文件被重複引入時(間接地,或直接地,被include了兩次),如果不加這個,就會導致頭文件里的內容,被引入兩次;加了這個之後呢,即使被include了兩次,程式在運行時,一開始,發現沒有定義__REDIS_H這個宏,然後定義它;等到程式遇到第二次include的內容時,發現__REDIS_H這個宏已經被定義了,就直接跳過了,這樣保證了同一個頭文件,即使被多次include,也能保證其內容,只被解析一次。
另外,像方法聲明這種,定義多次可能沒事,但是,如果在頭文件里,有如下類型定義呢:
typedef char my_char; char *test (void); 如果重複include同一個頭文件的話,就會造成類型重複定義。不過,很奇怪的是,我在centos 7.3.1611上試了,gcc版本:gcc (GCC) 4.8.5 20150623 (Red Hat 4.8.5-16),竟然沒報錯。看來我之前的c語言知識,也沒學到家。
我在網上暫時也沒找到重複include,具體的害處是啥,網上找到的答案就兩種:
- 在header文件里定義了全局變數;
- 浪費編譯時間
但是,第一個答案,嚴格來說 ,是不存在的,因為公司一般禁止在頭文件中定義變數。
有個知乎問題,大家可以看看:頭文件被重複包含究竟有哪些危害?
華為c語言編程規範中,對頭文件的部分規定
大家可以自行搜索:華為技術有限公司c語言編程規範
我這裡僅截取部分:
規則1.6 禁止在頭文件中定義變數。 說明: 在頭文件中定義變數,將會由於頭文件被其他.c文件包含而導致變數重複定義。 規則1.7 只能通過包含頭文件的方式使用其他.c提供的介面,禁止在.c中通過extern的方式使用外部 函數介面、變數。 說明:若a.c使用了b.c定義的foo()函數,則應當在b.h中聲明extern int foo(int input);並在a.c 中通過#include <b.h>來使用foo。禁止通過在a.c中直接寫extern int foo(int input);來使用foo, 後面這種寫法容易在foo改變時可能導致聲明和定義不一致。 這裡的1.7,也是和我們的理解是一致的,頭文件就是一個實現模組的對外介面,在裡面一般只能允許放以下內容:
- 類型定義
- 宏定義
- 函數的聲明(不包括實現)
- 變數的聲明(不是定義)
最後這一點,我要補充下。我們剛才禁止了,在頭文件中定義變數,所以,我們的變數,是在c文件中定義。比如,在redis.c中,定義了一個全局變數:
/* Global vars */ struct redisServer server; /* server global state */ 這麼一個重要的全局變數,基本維護了redis-server的一個實例的全部狀態值,只在自己redis.c中使用,是不可能的。那要怎麼在其他文件使用呢,就要在redis.h頭文件中進行如下聲明:
/*----------------------------------------------------------------------------- * Extern declarations *----------------------------------------------------------------------------*/ extern struct redisServer server; 關於類型定義
一般使用struct來定義一個結構體,類似高級語言中的class。
比如,redis中的字元串,一般會使用sds這個數據結構來存儲,其結構體定義就像下面這樣:
struct sdshdr { // buf 中已佔用空間的長度 int len; // buf 中剩餘可用空間的長度 int free; // 數據空間 char buf[]; }; 另外,c語言中,會大量使用typedef來定義一個類型的別名。
具體可以參考這個教程看看:
https://www.runoob.com/cprogramming/c-typedef.html
關於指針
基礎知識:https://www.runoob.com/cprogramming/c-pointers.html
我這裡說下我對指針的理解,指針一般指向一個記憶體地址,大家可以先不管這個指針是什麼類型,事實上,當我們不關心其指向的地址上,是什麼數據類型時,可以直接定義為 void * ptr。
這個指針,假設指向A這個地址,當我們認為上面存儲的是一個char時,就可以把這個指針,從void *強轉為char * 類型,然後對該指針解引用的話,因為char類型只佔用一個位元組,所以只需要,從該指針指向的位置開始,取當前這個位元組的內容,然後解析為char,就能獲取到這個地址上的char值。
如果我們把void * 強轉為int *的話,對其解引用時,就會取當前指針位置開始的4個位元組,因為整數佔4個位元組,然後將其轉為整數。
總的來說,對一個指針解引用時,首先就是看當前指針的數據類型,比如 int *指針,那麼說明指向int,就會取4個位元組來進行解引用;如果是指向一個結構體,就會計算結構體佔用的位元組數,然後取對應的位元組,來解引用為結構體類型的變數。
這部分,大家可以看看這塊:
https://www.runoob.com/cprogramming/c-data-types.html
https://www.runoob.com/cprogramming/c-pointer-arithmetic.html
redis啟動過程之配置項初始化
前面說了很多,我們本講也不夠講完全部的redis啟動過程了,可能還要兩講的樣子,本講先講解一部分。
啟動入口在:redis.c中的main 方法,如果使用我這邊的程式碼來搭建調試環境,可以直接啟動redis-server。
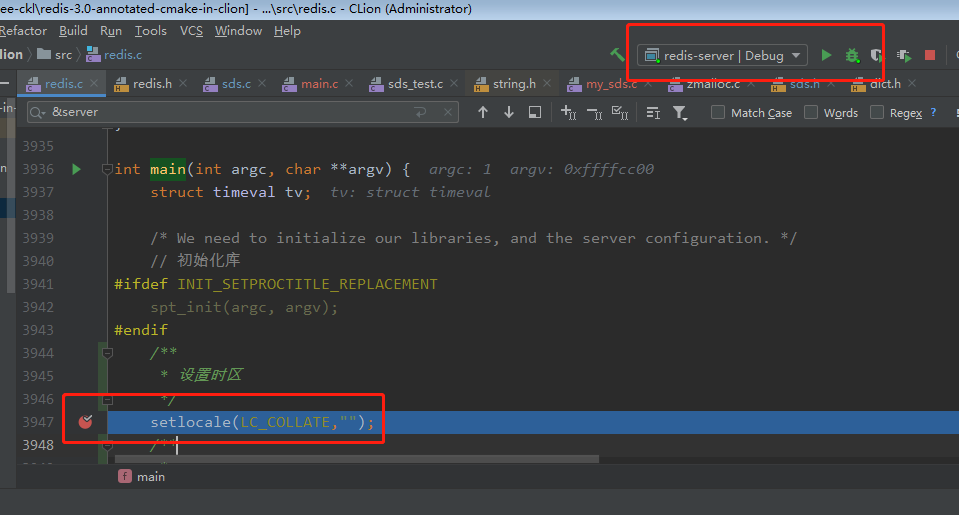
int main(int argc, char **argv) { struct timeval tv; /** * 1 設置時區 */ setlocale(LC_COLLATE,""); /** *2 */ zmalloc_enable_thread_safeness(); // 3 zmalloc_set_oom_handler(redisOutOfMemoryHandler); // 4 srand(time(NULL)^getpid()); // 5 gettimeofday(&tv,NULL); // 6 dictSetHashFunctionSeed(tv.tv_sec^tv.tv_usec^getpid()); // 檢查伺服器是否以 Sentinel 模式啟動 server.sentinel_mode = checkForSentinelMode(argc,argv); // 7 初始化伺服器 initServerConfig(); -
1處,設置時區
-
2處,設置進行記憶體分配的執行緒的數量,這裡會設為1
-
3處,設置oom發生時的函數指針,函數指針指向一個函數,類似於java 8中,lambda表達式中,丟一個方法的引用給流;函數指針會在oom時,被回調,總體來說,就類似於java中的模板設計模式或者策略模式。
-
4處,設置隨機數的種子
-
5處,獲取當前時間,設置到
tv這個變數中注意,這裡把tv的地址傳進去了,這是c語言中典型的用法,類似於java中傳一個對象的引用進去,然後在方法內部,會修改該對象的內部field等
-
6處,設置hash函數的種子
-
7處,初始化伺服器。
這裡重點說下7處:
void initServerConfig() { int j; // 伺服器狀態 // 設置伺服器的運行 ID getRandomHexChars(server.runid,REDIS_RUN_ID_SIZE); // 設置默認配置文件路徑 server.configfile = NULL; // 設置默認伺服器頻率 server.hz = REDIS_DEFAULT_HZ; // 為運行 ID 加上結尾字元 server.runid[REDIS_RUN_ID_SIZE] = ''; // 設置伺服器的運行架構 server.arch_bits = (sizeof(long) == 8) ? 64 : 32; // 設置默認伺服器埠號 server.port = REDIS_SERVERPORT; // tcp 全連接隊列的長度 server.tcp_backlog = REDIS_TCP_BACKLOG; // 綁定的地址的數量 server.bindaddr_count = 0; // UNIX socket path server.unixsocket = NULL; server.unixsocketperm = REDIS_DEFAULT_UNIX_SOCKET_PERM; // 綁定的 TCP socket file descriptors server.ipfd_count = 0; server.sofd = -1; // redis可使用的redis db的數量 server.dbnum = REDIS_DEFAULT_DBNUM; // redis 日誌級別 server.verbosity = REDIS_DEFAULT_VERBOSITY; // Client timeout in seconds,客戶端最大空閑時間;超過這個時間的客戶端,會被強制關閉 server.maxidletime = REDIS_MAXIDLETIME; // Set SO_KEEPALIVE if non-zero. 如果設為非0,則開啟tcp的SO_KEEPALIVE server.tcpkeepalive = REDIS_DEFAULT_TCP_KEEPALIVE; // 打開這個選項,會周期性地清理過期key server.active_expire_enabled = 1; // 客戶端發來的請求中,查詢快取的最大值;比如一個set命令,value的大小就會和這個緩衝區大小比較, // 如果大了,就根本放不進緩衝區 server.client_max_querybuf_len = REDIS_MAX_QUERYBUF_LEN; // rdb保存參數,比如每60s保存,n個鍵被修改了保存,之類的 server.saveparams = NULL; // 如果為1,表示伺服器正在從磁碟載入數據: We are loading data from disk if true server.loading = 0; // 日誌文件位置 server.logfile = zstrdup(REDIS_DEFAULT_LOGFILE); // 開啟syslog等機制 server.syslog_enabled = REDIS_DEFAULT_SYSLOG_ENABLED; server.syslog_ident = zstrdup(REDIS_DEFAULT_SYSLOG_IDENT); server.syslog_facility = LOG_LOCAL0; // 後台運行 server.daemonize = REDIS_DEFAULT_DAEMONIZE; // aof狀態 server.aof_state = REDIS_AOF_OFF; // aof的刷磁碟策略,默認每秒刷盤 server.aof_fsync = REDIS_DEFAULT_AOF_FSYNC; // 正在rewrite時,不刷盤 server.aof_no_fsync_on_rewrite = REDIS_DEFAULT_AOF_NO_FSYNC_ON_REWRITE; // Rewrite AOF if % growth is > M and... server.aof_rewrite_perc = REDIS_AOF_REWRITE_PERC; // the AOF file is at least N bytes. aof達到多大時,觸發rewrite server.aof_rewrite_min_size = REDIS_AOF_REWRITE_MIN_SIZE; // 最後一次執行 BGREWRITEAOF 時, AOF 文件的大小 server.aof_rewrite_base_size = 0; // Rewrite once BGSAVE terminates.開啟該選項時,BGSAVE結束時,觸發rewrite server.aof_rewrite_scheduled = 0; // 最近一次aof進行fsync的時間 server.aof_last_fsync = time(NULL); // 最近一次aof重寫,消耗的時間 server.aof_rewrite_time_last = -1; // Current AOF rewrite start time. server.aof_rewrite_time_start = -1; // 最後一次執行 BGREWRITEAOF 的結果 server.aof_lastbgrewrite_status = REDIS_OK; // 記錄 AOF 的 fsync 操作被推遲了多少次 server.aof_delayed_fsync = 0; // File descriptor of currently selected AOF file server.aof_fd = -1; // AOF 的當前目標資料庫 server.aof_selected_db = -1; /* Make sure the first time will not match */ // UNIX time of postponed AOF flush server.aof_flush_postponed_start = 0; // fsync incrementally while rewriting? 重寫過程中,增量觸發fsync server.aof_rewrite_incremental_fsync = REDIS_DEFAULT_AOF_REWRITE_INCREMENTAL_FSYNC; // pid文件 server.pidfile = zstrdup(REDIS_DEFAULT_PID_FILE); // rdb 文件名 server.rdb_filename = zstrdup(REDIS_DEFAULT_RDB_FILENAME); // aof 文件名 server.aof_filename = zstrdup(REDIS_DEFAULT_AOF_FILENAME); // 是否要密碼 server.requirepass = NULL; // 是否進行rdb壓縮 server.rdb_compression = REDIS_DEFAULT_RDB_COMPRESSION; // rdb checksum server.rdb_checksum = REDIS_DEFAULT_RDB_CHECKSUM; // bgsave失敗,停止寫入 server.stop_writes_on_bgsave_err = REDIS_DEFAULT_STOP_WRITES_ON_BGSAVE_ERROR; // 在執行 serverCron() 時進行漸進式 rehash server.activerehashing = REDIS_DEFAULT_ACTIVE_REHASHING; server.notify_keyspace_events = 0; // 支援的最大客戶端數量 server.maxclients = REDIS_MAX_CLIENTS; // bpop阻塞的客戶端 server.bpop_blocked_clients = 0; // 可以使用的最大記憶體 server.maxmemory = REDIS_DEFAULT_MAXMEMORY; // 記憶體淘汰策略,也就是key的過期策略 server.maxmemory_policy = REDIS_DEFAULT_MAXMEMORY_POLICY; server.maxmemory_samples = REDIS_DEFAULT_MAXMEMORY_SAMPLES; // hash表的元素小於這個值時,使用ziplist 編碼模式;以下幾個類似 server.hash_max_ziplist_entries = REDIS_HASH_MAX_ZIPLIST_ENTRIES; server.hash_max_ziplist_value = REDIS_HASH_MAX_ZIPLIST_VALUE; server.list_max_ziplist_entries = REDIS_LIST_MAX_ZIPLIST_ENTRIES; server.list_max_ziplist_value = REDIS_LIST_MAX_ZIPLIST_VALUE; server.set_max_intset_entries = REDIS_SET_MAX_INTSET_ENTRIES; server.zset_max_ziplist_entries = REDIS_ZSET_MAX_ZIPLIST_ENTRIES; server.zset_max_ziplist_value = REDIS_ZSET_MAX_ZIPLIST_VALUE; server.hll_sparse_max_bytes = REDIS_DEFAULT_HLL_SPARSE_MAX_BYTES; // 該標識打開時,表示正在關閉伺服器 server.shutdown_asap = 0; // 複製相關 server.repl_ping_slave_period = REDIS_REPL_PING_SLAVE_PERIOD; server.repl_timeout = REDIS_REPL_TIMEOUT; server.repl_min_slaves_to_write = REDIS_DEFAULT_MIN_SLAVES_TO_WRITE; server.repl_min_slaves_max_lag = REDIS_DEFAULT_MIN_SLAVES_MAX_LAG; // cluster模式相關 server.cluster_enabled = 0; server.cluster_node_timeout = REDIS_CLUSTER_DEFAULT_NODE_TIMEOUT; server.cluster_migration_barrier = REDIS_CLUSTER_DEFAULT_MIGRATION_BARRIER; server.cluster_configfile = zstrdup(REDIS_DEFAULT_CLUSTER_CONFIG_FILE); // lua腳本 server.lua_caller = NULL; server.lua_time_limit = REDIS_LUA_TIME_LIMIT; server.lua_client = NULL; server.lua_timedout = 0; // server.migrate_cached_sockets = dictCreate(&migrateCacheDictType,NULL); server.loading_process_events_interval_bytes = (1024*1024*2); // 初始化 LRU 時間 server.lruclock = getLRUClock(); // 初始化並設置保存條件 resetServerSaveParams(); // rdb的默認保存策略 appendServerSaveParams(60*60,1); /* save after 1 hour and 1 change */ appendServerSaveParams(300,100); /* save after 5 minutes and 100 changes */ appendServerSaveParams(60,10000); /* save after 1 minute and 10000 changes */ /* Replication related */ // 初始化和複製相關的狀態 server.masterauth = NULL; server.masterhost = NULL; server.masterport = 6379; server.master = NULL; server.cached_master = NULL; server.repl_master_initial_offset = -1; server.repl_state = REDIS_REPL_NONE; server.repl_syncio_timeout = REDIS_REPL_SYNCIO_TIMEOUT; server.repl_serve_stale_data = REDIS_DEFAULT_SLAVE_SERVE_STALE_DATA; server.repl_slave_ro = REDIS_DEFAULT_SLAVE_READ_ONLY; server.repl_down_since = 0; /* Never connected, repl is down since EVER. */ server.repl_disable_tcp_nodelay = REDIS_DEFAULT_REPL_DISABLE_TCP_NODELAY; server.slave_priority = REDIS_DEFAULT_SLAVE_PRIORITY; server.master_repl_offset = 0; /* Replication partial resync backlog */ // 初始化 PSYNC 命令所使用的 backlog server.repl_backlog = NULL; server.repl_backlog_size = REDIS_DEFAULT_REPL_BACKLOG_SIZE; server.repl_backlog_histlen = 0; server.repl_backlog_idx = 0; server.repl_backlog_off = 0; server.repl_backlog_time_limit = REDIS_DEFAULT_REPL_BACKLOG_TIME_LIMIT; server.repl_no_slaves_since = time(NULL); /* Client output buffer limits */ // 設置客戶端的輸出緩衝區限制 for (j = 0; j < REDIS_CLIENT_LIMIT_NUM_CLASSES; j++) server.client_obuf_limits[j] = clientBufferLimitsDefaults[j]; /* Double constants initialization */ // 初始化浮點常量 R_Zero = 0.0; R_PosInf = 1.0/R_Zero; R_NegInf = -1.0/R_Zero; R_Nan = R_Zero/R_Zero; // 初始化命令表,比如get、set、hset等各自的處理函數,放進一個hash表,方便後續處理請求 server.commands = dictCreate(&commandTableDictType,NULL); server.orig_commands = dictCreate(&commandTableDictType,NULL); populateCommandTable(); server.delCommand = lookupCommandByCString("del"); server.multiCommand = lookupCommandByCString("multi"); server.lpushCommand = lookupCommandByCString("lpush"); server.lpopCommand = lookupCommandByCString("lpop"); server.rpopCommand = lookupCommandByCString("rpop"); /* Slow log */ // 初始化慢查詢日誌 server.slowlog_log_slower_than = REDIS_SLOWLOG_LOG_SLOWER_THAN; server.slowlog_max_len = REDIS_SLOWLOG_MAX_LEN; /* Debugging */ // 初始化調試項 server.assert_failed = "<no assertion failed>"; server.assert_file = "<no file>"; server.assert_line = 0; server.bug_report_start = 0; server.watchdog_period = 0; } 以上都加了注釋,我們可以先不看:複製、cluster、lua等相關的,先看其他的。
總結
太久沒碰c了,有些遺忘,不過總體來說,並不難,難的是記憶體泄露之類,但我們只是debug學習使用,不用擔心這些問題。
指針那一塊,需要一點點基礎,大家可以花點時間學一下。
大家看看有啥問題或者建議,歡迎指出。

