Python 【基礎面試題】
- 2020 年 4 月 9 日
- 筆記
前言
面試題僅做學習參考,學習者閱後也要用心鑽研其中的原理,重要知識需要系統學習、透徹學習,形成自己的知識鏈。以下五點建議希望對您有幫助,早日拿到一份心儀的offer。
- 做好細節工作,細緻的人運氣不會差
- 展現特別可以,但要建立在已充分展示實力的基礎上
- 真誠比圓滑重要,請真誠地回答問題
- 把握當下,考場外的表現能起的作用微乎其微
- 沒有通過不代表你不優秀,選人先考慮的是與崗位相匹配

Python 三程三器
- 進程
- 進程是資源分配的最小單位(記憶體、CPU、網路、io)
- 一個運行起來的程式就是一個進程
- 什麼是程式(程式使我們存儲在硬碟里的程式碼)
- 硬碟(256G)、記憶體條(8G)
- 當我們雙擊一個圖標、打開程式的時候,實際上就是通過IO(讀寫)記憶體條裡面
- 記憶體條就是我們所指的資源
- CPU分時
- CPU比你的手速快多了,分時處理每個執行緒,但是由於太快然你覺得每個執行緒都是獨佔cpu
- cpu是計算,只有時間片到了,獲取cpu,執行緒真正執行
- 當你想使用 網路、磁碟等資源的時候,需要cpu的調度
- 進程具有獨立的記憶體空間,所以沒有辦法相互通訊
- 進程如何通訊
- 進程queue(父子進程通訊)
- pipe(同一程式下兩個進程通訊)
- managers(同一程式下多個進程通訊)
- RabbitMQ、redis等(不同程式間通訊)
- 進程如何通訊
- 為什麼需要進程池
- 一次性開啟指定數量的進程
- 如果有十個進程,有一百個任務,一次可以處理多少個(一次性只能處理十個)
- 防止進程開啟數量過多導致伺服器壓力過大
- 執行緒
- 有了進程為什麼還需要執行緒
- 因為進程不能同一時間只能做一個事情
- 什麼是執行緒
- 執行緒是作業系統調度的最小單位
- 執行緒是進程正真的執行者,是一些指令的集合(進程資源的擁有者)
- 同一個進程下的讀多個執行緒共享記憶體空間,數據直接訪問(數據共享)
- 為了保證數據安全,必須使用執行緒鎖
- GIL全局解釋器鎖
- 在python全局解釋器下,保證同一時間只有一個執行緒運行
- 防止多個執行緒都修改數據
- 執行緒鎖(互斥鎖)
- GIL鎖只能保證同一時間只能有一個執行緒對某個資源操作,但當上一個執行緒還未執行完畢時可能就會釋放GIL,其他執行緒就可以操作了
- 執行緒鎖本質把執行緒中的數據加了一把互斥鎖
- mysql中共享鎖 & 互斥鎖
- mysql共享鎖:共享鎖,所有執行緒都能讀,而不能寫
- mysql排它鎖:排它,任何執行緒讀取這個這個數據的權利都沒有
- 加上執行緒鎖之後所有其他執行緒,讀都不能讀這個數據
- mysql中共享鎖 & 互斥鎖
- 有了GIL全局解釋器鎖為什麼還需要執行緒鎖
- 因為cpu是分時使用的
- 死鎖定義
- 兩個以上的進程或執行緒在執行過程中,因爭奪資源而造成的一種互相等待的現象,若無外力作用,它們都將無法推進下去
- 多執行緒
- 為什麼要使用多執行緒?
- 執行緒在程式中是獨立的、並發的執行流。與分隔的進程相比,進程中執行緒之間的隔離程度要小,它們共享記憶體、文件句柄
- 和其他進程應有的狀態。
- 因為執行緒的劃分尺度小於進程,使得多執行緒程式的並發性高。進程在執行過程之中擁有獨立的記憶體單元,而多個執行緒共享
- 記憶體,從而極大的提升了程式的運行效率。
- 執行緒比進程具有更高的性能,這是由於同一個進程中的執行緒都有共性,多個執行緒共享一個進程的虛擬空間。執行緒的共享環境
- 包括進程程式碼段、進程的共有數據等,利用這些共享的數據,執行緒之間很容易實現通訊。
- 作業系統在創建進程時,必須為改進程分配獨立的記憶體空間,並分配大量的相關資源,但創建執行緒則簡單得多。因此,使用多執行緒來實現並發比使用多進程的性能高得要多。
- 總結起來,使用多執行緒編程具有如下幾個優點:?
- 進程之間不能共享記憶體,但執行緒之間共享記憶體非常容易。
- 作業系統在創建進程時,需要為該進程重新分配系統資源,但創建執行緒的代價則小得多。因此使用多執行緒來實現多任務並發執行比使用多進程的效率高
- python語言內置了多執行緒功能支援,而不是單純地作為底層作業系統的調度方式,從而簡化了python的多執行緒編程。
- 為什麼要使用多執行緒?
- 有了進程為什麼還需要執行緒


import threading import time def sayhi(num): #定義每個執行緒要運行的函數 print("running on number:%s" %num) time.sleep(3) for i in range(10): t = threading.Thread(target=sayhi,args=('t-%s'%i,)) t.start()
-
- join/setDaemon
- 當一個進程啟動之後,會默認產生一個主執行緒,因為執行緒是程式執行流的最小單元,當設置多執行緒時,主執行緒會創建多個子執行緒,在python中,默認情況下(其實就是setDaemon(False)),主執行緒執行完自己的任務以後,就退出了,此時子執行緒會繼續執行自己的任務,直到自己的任務結束。
- 當我們使用setDaemon(True)方法,設置子執行緒為守護執行緒時,主執行緒一旦執行結束,則全部執行緒全部被終止執行,可能出現的情況就是,子執行緒的任務還沒有完全執行結束,就被迫停止。此時join的作用就凸顯出來了,join所完成的工作就是執行緒同步,即主執行緒任務結束之後,進入阻塞狀態,一直等待其他的子執行緒執行結束之後,主執行緒在終止。
- join有一個timeout參數:
- 當設置守護執行緒時,含義是主執行緒對於子執行緒等待timeout的時間將會殺死該子執行緒,最後退出程式。所以說,如果有10個子執行緒,全部的等待時間就是每個timeout的累加和。簡單的來說,就是給每個子執行緒一個timeout的時間,讓他去執行,時間一到,不管任務有沒有完成,直接殺死。
- 沒有設置守護執行緒時,主執行緒將會等待timeout的累加和這樣的一段時間,時間一到,主執行緒結束,但是並沒有殺死子執行緒,子執行緒依然可以繼續執行,直到子執行緒全部結束,程式退出。執行緒池
- 對於任務數量不斷增加的程式,每有一個任務就生成一個執行緒,最終會導致執行緒數量的失控,例如,整站爬蟲,假設初始只有一個鏈接a,那麼,這個時候只啟動一個執行緒,運行之後,得到這個鏈接對應頁面上的b,c,d,,,等等新的鏈接,作為新任務,這個時候,就要為這些新的鏈接生成新的執行緒,執行緒數量暴漲。在之後的運行中,執行緒數量還會不停的增加,完全無法控制。所以,對於任務數量不端增加的程式,固定執行緒數量的執行緒池是必要的。
- join/setDaemon
import threading import time start_time = time.time() def sayhi(num): #定義每個執行緒要運行的函數 print("running on number:%s" %num) time.sleep(3) t_objs = [] #將進程實例對象存儲在這個列表中 for i in range(50): t = threading.Thread(target=sayhi,args=('t-%s'%i,)) t.start() #啟動一個執行緒,程式不會阻塞 t_objs.append(t) print(threading.active_count()) #列印當前活躍進程數量 for t in t_objs: #利用for循環等待上面50個進程全部結束 t.join() #阻塞某個程式 print(threading.current_thread()) #列印執行這個命令進程 print("----------------all threads has finished.....") print(threading.active_count()) print('cost time:',time.time() - start_time)
import threading import time start_time = time.time() def sayhi(num): #定義每個執行緒要運行的函數 print("running on number:%s" %num) time.sleep(3) for i in range(50): t = threading.Thread(target=sayhi,args=('t-%s'%i,)) t.setDaemon(True) #把當前執行緒變成守護執行緒,必須在t.start()前設置 t.start() #啟動一個執行緒,程式不會阻塞 print('cost time:',time.time() - start_time)
import requests from concurrent.futures import ThreadPoolExecutor def fetch_request(url): result = requests.get(url) print(result.text) url_list = [ 'https://www.baidu.com', 'https://www.google.com/', #google頁面會卡住,知道頁面超時後這個進程才結束 'http://dig.chouti.com/', #chouti頁面內容會直接返回,不會等待Google頁面的返回 ] pool = ThreadPoolExecutor(10) # 創建一個執行緒池,最多開10個執行緒 for url in url_list: pool.submit(fetch_request,url) # 去執行緒池中獲取一個執行緒,執行緒去執行fetch_request方法 pool.shutdown(True)
- 協程
- 什麼是協程
- 協程微執行緒,纖程,本質是一個單執行緒
- 協程能在單執行緒處理高並發
- 執行緒遇到I/O操作會等待、阻塞,協程遇到I/O會自動切換(剩下的只有CPU操作)
- 執行緒的狀態保存在CPU的暫存器和棧里而協程擁有自己的空間,所以無需上下文切換的開銷,所以快、
- 為甚麼協程能夠遇到I/O自動切換
- 協程有一個gevent模組(封裝了greenlet模組),遇到I/O自動切換
- 協程缺點
- 無法利用多核資源:協程的本質是個單執行緒,它不能同時將 單個CPU 的多個核用上,協程需要和進程配合才能運行在多CPU上
- 執行緒阻塞(Blocking)操作(如IO時)會阻塞掉整個程式
- 協程最大的優點
- 不僅是處理高並發(單執行緒下處理高並發)
- 特別節省資源(500日活,用php寫需要兩百多態機器,但是golang只需要二十多太機器)
- 200多台機器一年
- 二十多天機器一年
- 協程為何能處理大並發
- greeenlet遇到I/O手動切換
- 協程遇到I/O操作就切換,其實Gevent模組僅僅是對greenlet的封裝,將I/O的手動切換變成自動切換
- 協程之所以快是因為遇到I/O操作就切換(最後只有CPU運算)
- 這裡先演示用greenlet實現手動的對各個協程之間切換
- 其實Gevent模組僅僅是對greenlet的再封裝,將I/O間的手動切換變成自動切換
- 什麼是協程
from greenlet import greenlet def test1(): print(12) #4 gr1會調用test1()先列印12 gr2.switch() #5 然後gr2.switch()就會切換到gr2這個協程 print(34) #8 由於在test2()切換到了gr1,所以gr1又從上次停止的位置開始執行 gr2.switch() #9 在這裡又切換到gr2,會再次切換到test2()中執行 def test2(): print(56) #6 啟動gr2後會調用test2()列印56 gr1.switch() #7 然後又切換到gr1 print(78) #10 切換到gr2後會接著上次執行,列印78 gr1 = greenlet(test1) #1 啟動一個協程gr1 gr2 = greenlet(test2) #2 啟動第二個協程gr2 gr1.switch() #3 首先gr1.switch() 就會去執行gr1這個協程
-
-
- Gevent遇到I/O自動切換
- Gevent是一個第三方庫,可以通過gevent實現並發同步或非同步編程,Gevent原理是只要是遇到I/O操作就自動切換下一個協程
- Gevent 是一個第三方庫,可以輕鬆通過gevent實現並發同步或非同步編程
- 在gevent中用到的主要模式是Greenlet, 它是以C擴展模組形式接入Python的輕量級協程
- Greenlet全部運行在主程式作業系統進程的內部,但它們被協作式地調度。
- Gevent原理是只要遇到I/O操作就會自動切換到下一個協程
-
from urllib import request import gevent,time from gevent import monkey monkey.patch_all() #把當前程式所有的I/O操作給我單獨做上標記 def f(url): print('GET: %s' % url) resp = request.urlopen(url) data = resp.read() print('%d bytes received from %s.' % (len(data), url)) #1 並發執行部分 time_binxing = time.time() gevent.joinall([ gevent.spawn(f, 'https://www.python.org/'), gevent.spawn(f, 'https://www.yahoo.com/'), gevent.spawn(f, 'https://github.com/'), ]) print("並行時間:",time.time()-time_binxing) #2 串列部分 time_chuanxing = time.time() urls = [ 'https://www.python.org/', 'https://www.yahoo.com/', 'https://github.com/', ] for url in urls: f(url) print("串列時間:",time.time()-time_chuanxing) # 註:為什麼要在文件開通使用monkey.patch_all() # 1. 因為有很多模組在使用I / O操作時Gevent是無法捕獲的,所以為了使Gevent能夠識別出程式中的I / O操作。 # 2. 就必須使用Gevent模組的monkey模組,把當前程式所有的I / O操作給我單獨做上標記 # 3.使用monkey做標記僅用兩步即可: 第一步(導入monkey模組): from gevent import monkey 第二步(聲明做標記) : monkey.patch_all()
- Gevent實現簡單的自動切換小例子
- 註:在Gevent模仿I/O切換的時候,只要遇到I/O就會切換,哪怕gevent.sleep(0)也要切換一次
import gevent def func1(): print('33[31;1m第一次列印33[0m') gevent.sleep(2) # 為什麼用gevent.sleep()而不是time.sleep()因為是為了模仿I/O print('33[31;1m第六次列印33[0m') def func2(): print('33[32;1m第二次列印33[0m') gevent.sleep(1) print('33[32;1m第四次列印33[0m') def func3(): print('33[32;1m第三次列印33[0m') gevent.sleep(1) print('33[32;1m第五次列印33[0m') gevent.joinall([ # 將要啟動的多個協程放到event.joinall的列表中,即可實現自動切換 gevent.spawn(func1), # gevent.spawn(func1)啟動這個協程 gevent.spawn(func2), gevent.spawn(func3), ]) # 運行結果: # 第一次列印 # 第二次列印 # 第三次列印 # 第四次列印 # 第五次列印 # 第六次列印
-
- select、epool、pool
- I/O的實質是什麼?
- I/O的實質是將硬碟中的數據,或收到的數據實現從內核態 copy到 用戶態的過程
- 本文討論的背景是Linux環境下的network IO。
- 比如微信讀取本地硬碟的過程
- 微信進程會發送一個讀取硬碟的請求----》作業系統
- 只有內核才能夠讀取硬碟中的數據---》數據返回給微信程式(看上去就好像是微信直接讀取)
- 用戶態 & 內核態
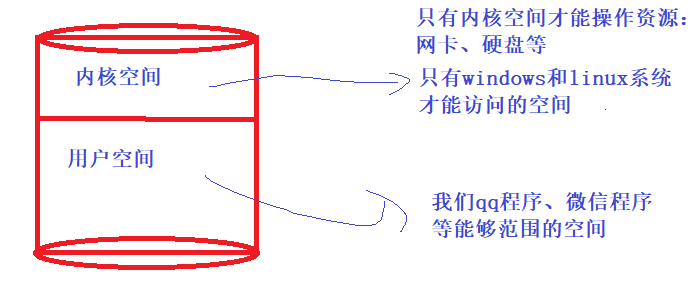
- 系統空間分為兩個部分,一部分是內核態,一部分是用戶態的部分
- 內核態:內核態的空間資源只有作業系統能夠訪問
- 用戶態:我們寫的普通程式使用的空間
- select、epool、pool
-
- select
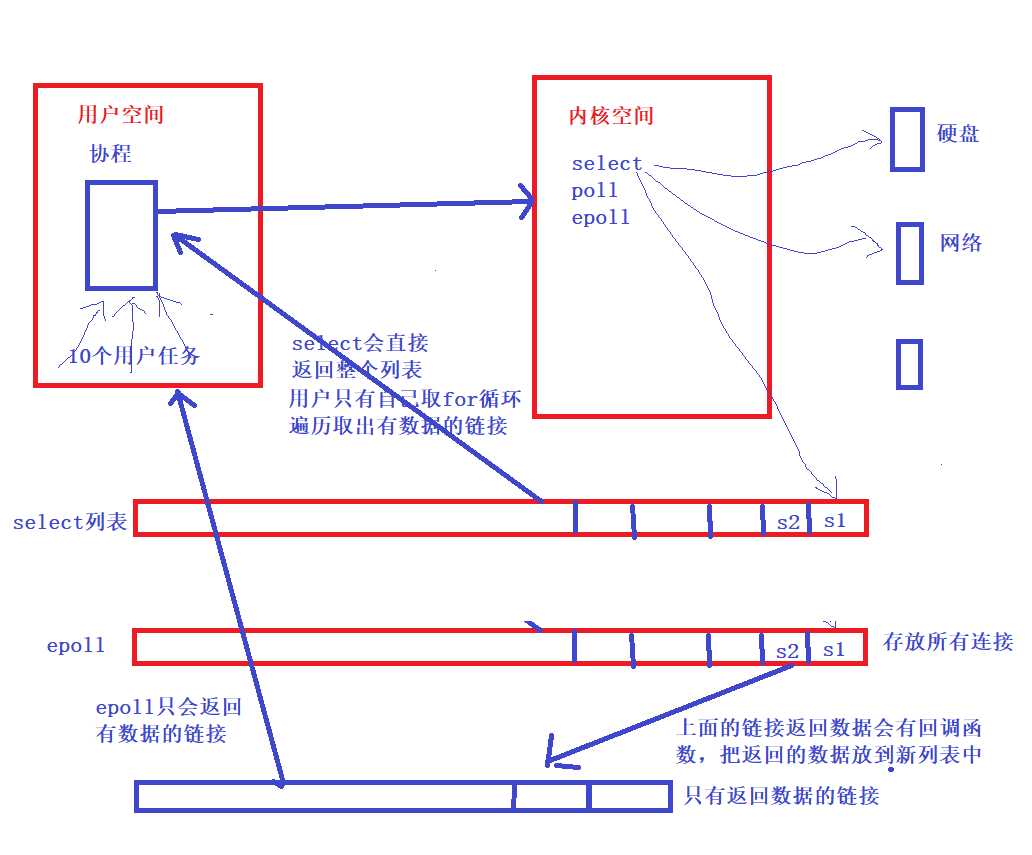
- 只能處理1024個連接(每一個請求都可以理解為一個連接)
- 不能告訴用戶程式,哪一個連接是活躍的
- pool
- 只是取消了最大1024個活躍的限制
- 不能告訴用戶程式,哪一個連接是活躍的
- epool
- 不僅取消了1024這個最大連接限制
- 而且能告訴用戶程式哪一個是活躍的
- select
-
- 猴子修補程式
- monkey patch指的是在運行時動態替換,一般是在startup的時候.
- 用過gevent就會知道,會在最開頭的地方gevent.monkey.patch_all();把標準庫中的thread/socket等給替換掉.這樣我們在後面使用socket的時候可以跟平常一樣使用,無需修改任何程式碼,但是它變成非阻塞的了
- 猴子修補程式
- 裝飾器
-
- 什麼是裝飾器
- 裝飾器本質是函數,用來給其他函數添加新的功能
- 特點:不修改調用方式、不修改源程式碼
- 裝飾器的應用場景
- 用戶認證,判斷用戶是否登錄
- 計算函數運行時間(算是一個功能、在項目里用的不多)
- 插入日誌的時候
- redis快取
- 為什麼使用裝飾器
- 結合應用場景說需求
- 如何使用裝飾器
- 裝飾器求函數運行時間
- Python 閉包
-
- 當一個嵌套函數在其外部區域引用了一個值時,該嵌套函數就是一個閉包。其意義就是會記錄這個值。
- 什麼是裝飾器
def A(x): def B(): print(x) return B
deco(*args,**kwargs): start_time = time.time() func(*args,**kwargs) #run test1 stop_time = time.time() print("running time is %s"%(stop_time-start_time)) return deco # @timer # test1=timer(test1) def test1(): time.sleep(3) print("in the test1") test1()
#! /usr/bin/env python # -*- coding: utf-8 -*- import time def auth(auth_type): print("auth func:",auth_type) def outer_wrapper(func): def wrapper(*args, **kwargs): print("wrapper func args:", *args, **kwargs) print('運行前') func(*args, **kwargs) print('運行後') return wrapper return outer_wrapper @auth(auth_type="local") # home = wrapper() def home(): print("welcome to home page") return "from home" home()
- 生成器
- 什麼是生成器
- 生成器就是一個特殊的迭代器
- 一個有yield關鍵字的函數就是一個生成器
- 生成器是這樣一個函數,它記住上一次返回時在函數體中的位置。
- 對生成器函數的第二次(或第 n 次)調用跳轉至該函數中間,而上次調用的所有局部變數都保持不變。
- yield簡單說來就是一個生成器,這樣函數它記住上次返 回時在函數體中的位置。對生成器第 二次(或n 次)調用跳轉至該函 次)調用跳轉至該函數。
- 生成器哪些場景應用
- 生成器是一個概念,我們平常寫程式碼可能用的並不多,但是python源碼大量使用
- 比如我們tornado框架就是基於 生成器+協程
- 在我們程式碼中使用舉例
- 比如我們要生成一百萬個數據,如果用生成器非常節省空間,用列表浪費大量空間
- 什麼是生成器
import time t1 = time.time() g = (i for i in range(100000000)) t2 = time.time() lst = [i for i in range(100000000)] t3 = time.time() print('生成器時間:',t2 - t1) # 生成器時間: 0.0 print('列表時間:',t3 - t2) # 列表時間: 5.821957349777222
-
- 為什麼使用生成器
- 節省空間
- 高效
- 如何使用
- 為什麼使用生成器
#!/usr/bin/python # -*- coding: utf-8 -*- def read_big_file_v(fname): block_size = 1024 * 8 with open(fname,encoding="utf8") as fp: while True: chunk = fp.read(block_size) # 當文件沒有更多內容時,read 調用將會返回空字元串 '' if not chunk: break print(chunk) path = r'C:aaalutingedc-backendtttt.py' read_big_file_v(path)
- 迭代器
-
- 什麼是迭代器
- 迭代器是訪問集合內元素的一種方法
- 總是從集合內第一個元素訪問,直到所有元素都被訪問過結束,當調用 __next__而元素返回會引發一個,StopIteration異常
- 有兩個方法:_iter_ _next_
- _iter_ : 返回迭代器自身
- _next_: 返回下一個元素
- 可迭代對象
- 內置iter方法的,都是可迭代的對象。 list是可迭代對象,dict是可迭代對象,set也是可迭代對象
- 定義
- 迭代器:可迭代對象執行iter方法,得到的結果就是迭代器,迭代器對象有next方法
- 它是一個帶狀態的對象,他能在你調用next()方法的時候返回容器中的下一個值,任何實現了iter和next()方法的對象都是迭代器,iter返回迭代器自身,next返回容器中的下一個值,如果容器中沒有更多元素了,則拋出StopIteration異常
- 什麼是迭代器
Python 面向對象
- 什麼是面向對象
- 使用模板的思想,將世界完事萬物使用對象來表示一個類型
- 方法
- 靜態方法
- 特點:名義上歸類管理,實際上不能訪問類或者變數中的任意屬性或者方法
- 作用:讓我們程式碼清晰,更好管理
- 調用方式: 既可以被類直接調用,也可以通過實例調用
- 類方法
- 作用:無需實例化直接被類調用
- 特性:類方法只能訪問類變數,不能訪問實例變數
- 類方法使用場景:當我們還未創建實例,但是需要調用類中的方法
- 調用方式:既可以被類直接調用,也可以通過實例調用
- 屬性方法
- 屬性方法把一個方法變成一個屬性,隱藏了實現細節,調用時不必加括弧直接d.eat即可調用self.eat()方
- 魔法方法
- 單例模式
- 單例模式:永遠用一個對象得實例,避免新建太多實例浪費資源
- 實質:使用__new__方法新建類對象時先判斷是否已經建立過,如果建過就使用已有的對象
- 使用場景:如果每個對象內部封裝的值都相同就可以用單例模式
- 單例模式
- 靜態方法
class Foo(object):     instance = None     def __init__(self):        self.name = 'alex'       def __new__(cls, *args, **kwargs):        if Foo.instance:           return Foo.instance        else:           Foo.instance = object.__new__(cls,*args,**kwargs)           return Foo.instance    obj1 = Foo()       # obj1和obj2獲取的就是__new__方法返回的內容  obj2 = Foo()  print(obj1,obj2)   # 運行結果: <__main__.Foo object at 0x00D3B450>
<__main__.Foo object at 0x00D3B450>    # 運行結果說明:  # 這可以看到我們新建的兩個Foo()對象記憶體地址相同,說明使用的•同一個類,沒有重複建立類
-
- __new__
- 產生一個實例
- __init__
- 產生一個對象
- __del__
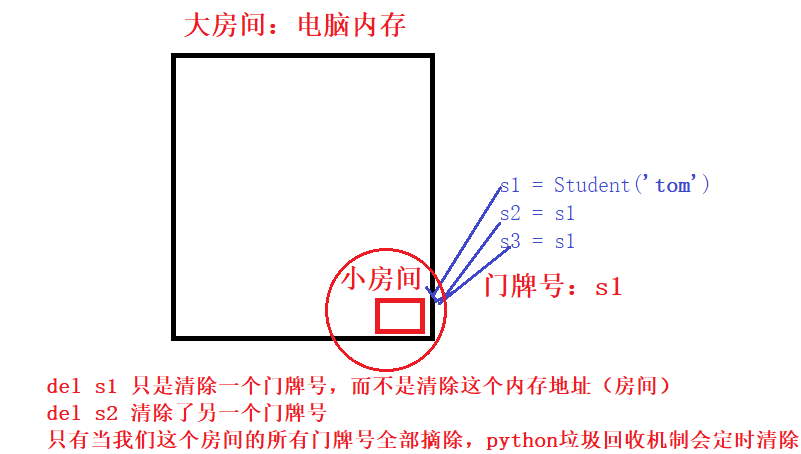
- 析構方法,刪除無用的記憶體對象(當程式結束會自動執行析構方法)
- __new__
- 特性
- 封裝
- 對類中屬性和方法進行一種封裝,隱藏了實現細節
- 繼承
- 之類繼承父類後,就具有了父類的所有屬性和方法,先繼承,後重寫
- 多態
- 一種介面,多種表現形狀
- 中國人、和美國人都能講話,調用中國人類講中文,調用美國人類講英文
- 新式類經典類的區別
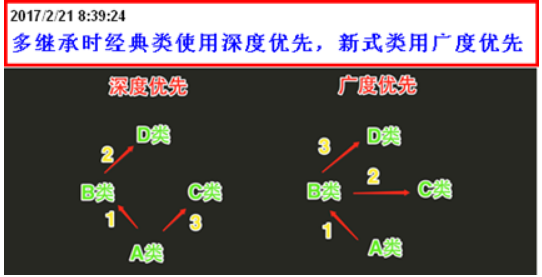
- pythn3無論新式類還是經典類都是用 廣度優先
- python2中,新式類:廣度優先,經典類:深度優先
- 封裝
class D: def talk(self): print('D') class B(D): pass # def talk(self): # print('B') class C(D): pass def talk(self): print('C') class A(B,C): pass # def talk(self): # print('A') a = A() a.talk()
- 屬性
- 公有屬性(類變數)
- 如果函數、方法或者屬性的名稱沒有以兩個下劃線開始,則為公有屬性;
- 普通屬性(實例變數)
- 以self作為前綴的屬性;
- 私有屬性
- 函數、方法或者屬性的名稱以兩個下劃線開始,則為私有類型;
- 局部變數
- 類的方法中定義的變數沒有使用self作為前綴聲明,則該變數為局部變數;
- 公有屬性(類變數)
- 反射
- hasattr: 判斷當前類是否有這個方法
- getattr: 通過字元串反射出這個方法的記憶體地址
- setattr:將當前類添加一個方法
- delatrr: 刪除實例屬性
Python 常識概念
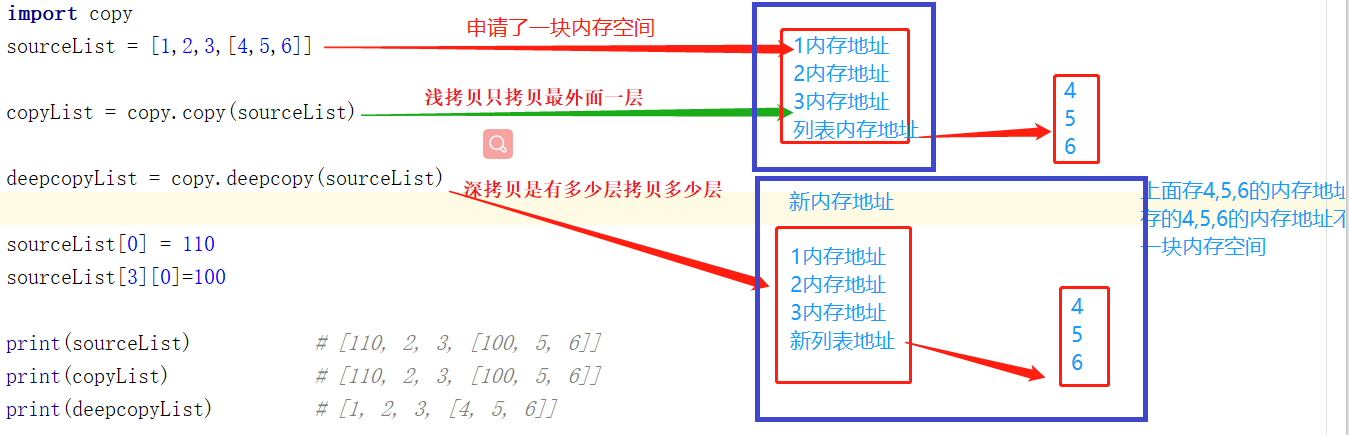
- 深淺拷貝
- 底層原理
- 淺copy: 不管多麼複雜的數據結構,淺拷貝都只會copy一層
- deepcopy : 深拷貝會完全複製原變數相關的所有數據,在記憶體中生成一套完全一樣的內容,我們對這兩個變數中任意一個修改都不會影響其他變數
- 底層原理
-
- 可變與不可變數據的區別
- 可變類型(mutable):列表,字典
- 不可變類型(unmutable):數字,字元串,元組
- 這裡的可變不可變,是指記憶體中的那塊內容(value)是否可以被改變。如果是不可變類型,在對對象本身操作的時候,必須在記憶體中新申請一塊區域(因為老區域#不可變#)。如果是可變類型,對對象操作的時候,不需要再在其他地方申請記憶體,只需要在此對象後面連續申請(+/-)即可,也就是它的address會保持不變,但區域會變長或者變短。
- copy.copy() 淺拷貝
- copy.deepcopy() 深拷貝
- 淺拷貝是新創建了一個跟原對象一樣的類型,但是其內容是對原對象元素的引用。這個拷貝的對象本身是新的,但內容不是。拷貝序列類型對象(列表元組)時,默認是淺拷貝。
- 可變與不可變數據的區別
- 垃圾回收機制
- 引用計數
- 原理
- 當一個對象的引用被創建或者複製時,對象的引用計數加1;當一個對象的引用被銷毀時,對象的引用計數減1.
- 當對象的引用計數減少為0時,就意味著對象已經再沒有被使用了,可以將其記憶體釋放掉。
- 優點
- 引用計數有一個很大的優點,即實時性,任何記憶體,一旦沒有指向它的引用,就會被立即回收,而其他的垃圾收集技術必須在某種特殊條件下才能進行無效記憶體的回收。
- 缺點
- 引用計數機制所帶來的維護引用計數的額外操作與Python運行中所進行的記憶體分配和釋放,引用賦值的次數是成正比的,
- 顯然比其它那些垃圾收集技術所帶來的額外操作只是與待回收的記憶體數量有關的效率要低。
- 同時,因為對象之間相互引用,每個對象的引用都不會為0,所以這些對象所佔用的記憶體始終都不會被釋放掉。
- 原理
- 標記清楚
- 它分為兩個階段:第一階段是標記階段,GC會把所有的活動對象打上標記,第二階段是把那些沒有標記的對象非活動對象進行回收。
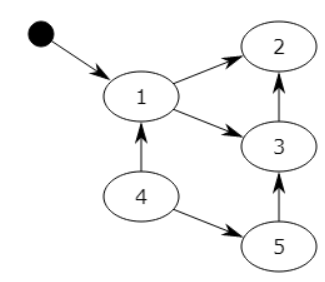
- 對象之間通過引用(指針)連在一起,構成一個有向圖
- 從根對象(root object)出發,沿著有向邊遍歷對象,可達的(reachable)對象標記為活動對象,不可達的對象就是要被清除的非活動對象。
- 根對象就是全局變數、調用棧、暫存器。
- 引用計數
-
-
- 在上圖中,可以從程式變數直接訪問塊1,並且可以間接訪問塊2和3,程式無法訪問塊4和5
- 第一步將標記塊1,並記住塊2和3以供稍後處理。
- 第二步將標記塊2,第三步將標記塊3,但不記得塊2,因為它已被標記。
- 掃描階段將忽略塊1,2和3,因為它們已被標記,但會回收塊4和5。
- 分代回收
- 分代回收是建立在標記清除技術基礎之上的,是一種以空間換時間的操作方式。
- Python將記憶體分為了3“代”,分別為年輕代(第0代)、中年代(第1代)、老年代(第2代)
- 他們對應的是3個鏈表,它們的垃圾收集頻率與對象的存活時間的增大而減小。
- 新創建的對象都會分配在年輕代,年輕代鏈表的總數達到上限時,Python垃圾收集機制就會被觸發
- 把那些可以被回收的對象回收掉,而那些不會回收的對象就會被移到中年代去,依此類推
- 老年代中的對象是存活時間最久的對象,甚至是存活於整個系統的生命周期內。
-
- TCP/UDP
- TCP/UDP比較
- TCP面向連接(如打電話要先撥號建立連接);UDP是無連接的,即發送數據之前不需要建立連接
- TCP提供可靠的服務,也就是說,通過TCP連接傳送的數據,無差錯,不丟失,不重複,且按序到達;UDP盡最大努力交付,即不保證可靠交付
- TCP通過校驗和,重傳控制,序號標識,滑動窗口、確認應答實現可靠傳輸。
- UDP具有較好的實時性,工作效率比TCP高,適用於對高速傳輸和實時性有較高的通訊或廣播通訊。
- 每一條TCP連接只能是點到點的;UDP支援一對一,一對多,多對一和多對多的交互通訊
- TCP對系統資源要求較多,UDP對系統資源要求較少。
- 註:UDP一般用於即時通訊(QQ聊天 對數據準確性和丟包要求比較低,但速度必須快),在線影片等
- 三次揮手四次握手
- 三次握手:
- 第一次握手:建立連接時,客戶端發送SYN包到伺服器,其中包含客戶端的初始序號seq=x,並進入SYN_SENT狀態,等待伺服器確認。
- 第二次握手:伺服器收到請求後,必須確認客戶的數據包。同時自己也發送一個SYN包,即SYN+ACK包,此時伺服器進入SYN_RECV狀態。
- 第三次握手:客戶端收到伺服器的SYN+ACK包,向伺服器發送一個序列號(seq=x+1),確認號為ack(客戶端)=y+1,此包發送完畢,
- 客戶端和伺服器進入ESTAB_LISHED(TCP連接成功)狀態,完成三次握手。
- 四次揮手:
- 第一次揮手:首先,客戶端發送一個FIN,用來關閉客戶端到伺服器的數據傳送,然後等待伺服器的確認。其中終止標誌位FIN=1,序列號seq=u。
- 第二次揮手:伺服器收到這個FIN,它發送一個ACK,確認ack為收到的序號加一。
- 第三次揮手:關閉伺服器到客戶端的連接,發送一個FIN給客戶端。
- 第四次揮手:客戶端收到FIN後,並發回一個ACK報文確認,並將確認序號seq設置為收到序號加一。首先進行關閉的一方將執行主動關閉,而另一方執行被動關閉。
- 三次握手:
- 相關的問題
- 為什麼需要三次握手?
- 目的:為了防止已失效的連接請求報文段突然又傳送到了服務端,因而產生錯誤。主要防止資源的浪費。
- 具體過程:當客戶端發出第一個連接請求報文段時並沒有丟失,而是在某個網路節點出現了長時間的滯留,以至於延誤了連接請求在某個時間之後才到達伺服器。這應該是一個早已失效的報文段。但是伺服器在收到此失效的連接請求報文段後,以為是客戶端的一個新請求,於是就想客戶端發出了確認報文段,同意建立連接。假設不採用三次握手,那麼只要伺服器發出確認後,新的連接就可以建立了。但是由於客戶端沒有發出建立連接的請求,因此不會管伺服器的確認,也不會向伺服器發送數據,但伺服器卻以為新的運輸連接已經建立,一直在等待,所以,伺服器的資源就白白浪費掉了。
- 如果在TCP第三次握手中的報文段丟失了會出現什麼情況?
- 客戶端會認為此連接已建立,如果客戶端向伺服器發送數據,伺服器將以RST包響應,這樣就能感知到伺服器的錯誤了。
- 為什麼要四次揮手?
- 為了保證在最後斷開的時候,客戶端能夠發送最後一個ACK報文段能夠被伺服器接收到。如果客戶端在收到伺服器給它的斷開連接的請求之後,回應完伺服器就直接斷開連接的話,若伺服器沒有收到回應就無法進入CLOSE狀態,所以客戶端要等待兩個最長報文段壽命的時間,以便於伺服器沒有收到請求之後重新發送請求。
- 防止“已失效的連接請求報文”出現在連接中,在釋放連接的過程中會有一些無效的滯留報文,這些報文在經過2MSL的時間內就可以發送到目的地,不會滯留在網路中。這樣就可以避免在下一個連接中出現上一個連接的滯留報文了。
- 為什麼TCP連接的時候是3次?2次不可以嗎?
- 因為需要考慮連接時丟包的問題,如果只握手2次,第二次握手時如果服務端發給客戶端的確認報文段丟失,此時服務端已經準備好了收發數(可以理解服務端已經連接成功)據,而客戶端一直沒收到服務端的確認報文,所以客戶端就不知道服務端是否已經準備好了(可以理解為客戶端未連接成功),這種情況下客戶端不會給服務端發數據,也會忽略服務端發過來的數據。
- 如果是三次握手,即便發生丟包也不會有問題,比如如果第三次握手客戶端發的確認ack報文丟失,服務端在一段時間內沒有收到確認ack報文的話就會重新進行第二次握手,也就是服務端會重發SYN報文段,客戶端收到重發的報文段後會再次給服務端發送確認ack報文。
- 為什麼TCP連接的時候是3次,關閉的時候卻是4次?
-
- 因為只有在客戶端和服務端都沒有數據要發送的時候才能斷開TCP。而客戶端發出FIN報文時只能保證客戶端沒有數據發了,服務端還有沒有數據發客戶端是不知道的。而服務端收到客戶端的FIN報文後只能先回復客戶端一個確認報文來告訴客戶端我服務端已經收到你的FIN報文了,但我服務端還有一些數據沒發完,等這些數據發完了服務端才能給客戶端發FIN報文(所以不能一次性將確認報文和FIN報文發給客戶端,就是這裡多出來了一次)。
- 為什麼客戶端發出第四次揮手的確認報文後要等2MSL的時間才能釋放TCP連接?
- 這裡同樣是要考慮丟包的問題,如果第四次揮手的報文丟失,服務端沒收到確認ack報文就會重發第三次揮手的報文,這樣報文一去一回最長時間就是2MSL,所以需要等這麼長時間來確認服務端確實已經收到了。
- 如果已經建立了連接,但是客戶端突然出現故障了怎麼辦?
- TCP設有一個保活計時器,客戶端如果出現故障,伺服器不能一直等下去,白白浪費資源。伺服器每收到一次客戶端的請求後都會重新複位這個計時器,時間通常是設置為2小時,若兩小時還沒有收到客戶端的任何數據,伺服器就會發送一個探測報文段,以後每隔75秒鐘發送一次。若一連發送10個探測報文仍然沒反應,伺服器就認為客戶端出了故障,接著就關閉連接。
- 為什麼需要三次握手?
- TCP/UDP比較
高階函數
-
- map
- 第一個參數接收一個函數名,第二個參數接收一個可迭代對象
- 利用map,lambda表達式將所有偶數元素加100
# -*- coding:utf8 -*- l1= [11,22,33,44,55] ret = map(lambda x:x-100 if x % 2 != 0 else x + 100,l1) print(list(ret)) # 運行結果: [-89, 122, -67, 144, -45] # lambda x:x-100 if x % 2 != 0 else x + 100 # 如果 "if x % 2 != 0" 條件成立返回 x-100 # 不成立:返回 x+100 def F(x): if x%2 != 0: return x-100 else: return x+100 ret = map(F,l1) print(list(ret))
-
- reduce
- 字元串反轉
- 把上一次的執行結果單做參數返回
# -*- coding:utf8 -*- '''使用reduce將字元串反轉''' s = 'Hello World' from functools import reduce result = reduce(lambda x,y:y+x,s) # # 1、第一次:x=H,y=e => y+x = eH # # 2、第二次:x=l,y=eH => y+x = leH # # 3、第三次:x=l,y=leH => y+x = lleH print( result ) # dlroW olleH
-
- filter
- filter()函數可以對序列做過濾處理,就是說可以使用一個自定的函數過濾一個序列,把序列的每一項傳到自定義的過濾函數里處理,並返回結果做過濾。
- 最終一次性返回過濾後的結果。
- filter()函數有兩個參數:
- 第一個,自定函數名,必須的
- 第二個,需要過濾的列,也是必須的
- filter()函數有兩個參數:
- 利用 filter、lambda表達式 獲取l1中元素小於33的所有元素 l1 = [11, 22, 33, 44, 55]
- filter
l1= [11,22,33,44,55] a = filter(lambda x: x<33, l1) print(list(a)) # -*- coding:utf8 -*- def F(x): if x<33: return x b = filter(F,l1) print(list(b))
-
- sorted
- 經典面試題只 列表排序
- sorted
students = [('john', 'A', 15), ('jane', 'B', 12), ('dave', 'B', 10)] # [('dave', 'B', 10), ('jane', 'B', 12), ('john', 'A', 15)] print( sorted(students, key=lambda s: s[2], reverse=False) ) # 按年齡排序 # 結果:[('dave', 'B', 10), ('jane', 'B', 12), ('john', 'A', 15)] def f(x): # ('john', 'A', 15) return x[2] print( sorted(students, key=f, reverse=False) ) # 按年齡排序
-
-
- 對字典的value排序
-
d = {'k1':1, 'k3': 3, 'k2':2} # d.items() = [('k1', 1), ('k3', 3), ('k2', 2)] a = sorted(d.items(), key=lambda x: x[1]) print(a) # [('k1', 1), ('k2', 2), ('k3', 3)] -
-
- 兩個列表編一個字典
-
L1 = ['k1','k2','k3'] L2 = ['v1','v2','v3'] print( list(zip(L1,L2))) # zip(L1,L2) : [('k1', 'v1'), ('k2', 'v2'), ('k3', 'v3')] # dict( [('k1', 'v1'), ('k2', 'v2'), ('k3', 'v3')] ) = {'k1': 'v1', 'k2': 'v2', 'k3': 'v3'}
-
-
- 匿名函數
-
(x,y,z): return x+y+z f = lambda x:x if x % 2 != 0 else x + 100 print(f(10)) # 110
-
-
- 三元運算
-
name = 'Tom' if 1 == 1 else 'fly' print(omname) # 運行結果: T
- 讀寫文件
- ReadLine():逐行讀取,適合讀大文件
- Readlines():一次性讀取所有文件, 將文件按行讀取成列表
- read():指定讀取指定大小的文件(默認一次讀取所有)
- 經典面試題:現在有一個5G的文件,用python寫入另一個文件里
- 我們使用了一個 while 循環來讀取文件內容,每次最多讀取 8kb 大小
- 這樣可以避免之前需要拼接一個巨大字元串的過程,把記憶體佔用降低非常多
#!/usr/bin/python # -*- coding: utf-8 -*- def read_big_file_v(fname): block_size = 1024 * 8 with open(fname,encoding="utf8") as fp: while True: chunk = fp.read(block_size) # 當文件沒有更多內容時,read 調用將會返回空字元串 '' if not chunk: break print(chunk) path = r'C:aaalutingedc-backendtttt.py' read_big_file_v(path)
- 常用模組
- subprocess模組
- subprocess原理以及常用的封裝函數
- 運行python的時候,我們都是在創建並運行一個進程。像Linux進程那樣,一個進程可以fork一個子進程,並讓這個子進程exec另外一個程式
- 在Python中,我們通過標準庫中的subprocess包來fork一個子進程,並運行一個外部的程式。
- subprocess包中定義有數個創建子進程的函數,這些函數分別以不同的方式創建子進程,所以我們可以根據需要來從中選取一個使用
- 另外subprocess還提供了一些管理標準流(standard stream)和管道(pipe)的工具,從而在進程間使用文本通訊。
- subprocess原理以及常用的封裝函數
- subprocess模組
#1、返回執行狀態:0 執行成功 retcode = subprocess.call(['ping', 'www.baidu.com', '-c5']) #2、返回執行狀態:0 執行成功,否則拋異常 subprocess.check_call(["ls", "-l"]) #3、執行結果為元組:第1個元素是執行狀態,第2個是命令結果 >>> ret = subprocess.getstatusoutput('pwd') >>> ret (0, '/test01') #4、返回結果為 字元串 類型 >>> ret = subprocess.getoutput('ls -a') >>> ret '.n..ntest.py' #5、返回結果為'bytes'類型 >>> res=subprocess.check_output(['ls','-l']) >>> res.decode('utf8') '總用量 4n-rwxrwxrwx. 1 root root 334 11月 21 09:02 test.pyn'
subprocess.check_output(['chmod', '+x', filepath]) subprocess.check_output(['dos2unix', filepath])
-
- subprocess.Popen()
- 實際上,上面的幾個函數都是基於Popen()的封裝(wrapper),這些封裝的目的在於讓我們容易使用子進程
- 當我們想要更個性化我們的需求的時候,就要轉向Popen類,該類生成的對象用來代表子進程
- 與上面的封裝不同,Popen對象創建後,主程式不會自動等待子進程完成。我們必須調用對象的wait()方法,父進程才會等待 (也就是阻塞block)
- 從運行結果中看到,父進程在開啟子進程之後並沒有等待child的完成,而是直接運行print。
- subprocess.Popen()
#1、先列印'parent process'不等待child的完成 import subprocess child = subprocess.Popen(['ping','-c','4','www.baidu.com']) print('parent process') #2、後列印'parent process'等待child的完成 import subprocess child = subprocess.Popen('ping -c4 www.baidu.com',shell=True) child.wait() print('parent process')
child.poll() # 檢查子進程狀態 child.kill() # 終止子進程 child.send_signal() # 向子進程發送訊號 child.terminate() # 終止子進程
-
- subprocess.PIPE 將多個子進程的輸入和輸出連接在一起
- subprocess.PIPE實際上為文本流提供一個快取區。child1的stdout將文本輸出到快取區,隨後child2的stdin從該PIPE中將文本讀取走
- child2的輸出文本也被存放在PIPE中,直到communicate()方法從PIPE中讀取出PIPE中的文本。
- 注意:communicate()是Popen對象的一個方法,該方法會阻塞父進程,直到子進程完成
- subprocess.PIPE 將多個子進程的輸入和輸出連接在一起
import subprocess #下面執行命令等價於: cat /etc/passwd | grep root child1 = subprocess.Popen(["cat","/etc/passwd"], stdout=subprocess.PIPE) child2 = subprocess.Popen(["grep","root"],stdin=child1.stdout, stdout=subprocess.PIPE) out = child2.communicate() #返回執行結果是元組 print(out) #執行結果: (b'root:x:0:0:root:/root:/bin/bashnoperator:x:11:0:operator:/root:/sbin/nologinn', None)
import subprocess list_tmp = [] def main(): p = subprocess.Popen(['ping', 'www.baidu.com', '-c5'], stdin = subprocess.PIPE, stdout = subprocess.PIPE) while subprocess.Popen.poll(p) == None: r = p.stdout.readline().strip().decode('utf-8') if r: # print(r) v = p.stdout.read().strip().decode('utf-8') list_tmp.append(v) main() print(list_tmp[0])
-
- paramiko模組(詳細介紹)
- Paramiko模組作用
- 如果需要使用SSH從一個平台連接到另外一個平台,進行一系列的操作時,
- 比如:批量執行命令,批量上傳文件等操作,paramiko是最佳工具之一。
- paramiko是用python語言寫的一個模組,遵循SSH2協議,支援以加密和認證的方式,進行遠程伺服器的連接
- 由於使用的是python這樣的能夠跨平台運行的語言,所以所有python支援的平台,如Linux, Solaris, BSD,MacOS X, Windows等,paramiko都可以支援
- 如果需要使用SSH從一個平台連接到另外一個平台,進行一系列的操作時,paramiko是最佳工具之一
- 現在如果需要從windows伺服器上下載Linux伺服器文件:
- a. 使用paramiko可以很好的解決以上問題,它僅需要在本地上安裝相應的軟體(python以及PyCrypto)
- b. 對遠程伺服器沒有配置要求,對於連接多台伺服器,進行複雜的連接操作特別有幫助。
- Paramiko模組作用
- re模組(詳細介紹)
- paramiko模組(詳細介紹)
| 函數 | 描述 |
| compile(pattern[, flags]) | 根據正則表達式字元串創建模式對象 |
| search(pattern, string[, flags]) | 在字元串中尋找模式 |
| match(pattern, 常用模組[, flags]) | 在字元串的開始處匹配模式 |
| split(pattern, string[, maxsplit=0]) | 根據模式的匹配項來分割字元串 |
| findall(pattern, string) | 列出字元串中模式的所有匹配項並以列表返回 |
| sub(pat, repl, string[, count=0]) | 將字元串中所有pat的匹配項用repl替換 |
| escape(string) | 將字元串中所有特殊正則表達式字元轉義 |
- Python2和Python3的區別
- 不等於<>比較運算符,python3不識別,pyhon2.7中!=和<>都能運行。
- print函數的使用,python3必須加括弧,python2加不加都行。
- python2 的默認編碼是ASCII,python3的默認編碼是UTF-8。
- python3字元串解碼後會在記憶體里自動轉換成Unicode,而python2不會。如果在文件頭指定了解碼編碼,python2和python3都會按指定解碼,所有系統都支援Unicode,所以python3隻要指定對了解碼編碼,在哪個系統上都可以正常顯示,python2如果不是gbk編碼的,解碼後windous就會是亂碼。
- python2中有Unicode數據類型,python3中沒有,字元串都是Unicode格式的str數據類型。
- 用戶輸入不同,python3中只有input()輸出都是str和python2中的raw_input()一樣,而python2中也有input(),輸入字元串要帶引號,數字輸出相應的數字類型
- python2以前沒有布爾型,0表示False,用1表示True;Python3 把 True 和 False 定義成關鍵字,它們的值還是 1 和 0,可以和數字運算。
- python2的除法中不是浮點數則只返回商,python3除法返回值正常。
- python3運行程式可以識別相同目錄下普通文件夾中的模組,python2隻能識別文件夾標識後的包中的模組。
- 創建類時,python2分為經典類和新式類,新式類就是繼承object的類,經典類是沒有繼承的類,而python3中全部是新式類,默認繼承object。在屬性查找時,經典類查找方式為深度優先,新式類是廣度優先。僅python3中有類的mro函數方法,輸出繼承父類的順序列表。
- with(上下文管理)
- 上下文管理器對象存在的目的是管理 with 語句,就像迭代器的存在是為了管理 for 語句一樣。
- with 語句的目的是簡化 try/finally 模式。這種模式用於保證一段程式碼運行完畢後執行某項操作,即便那段程式碼由於異常、 return 語句或 sys.exit() 調用而中止,也會執行指定的操作。 finally 子句中的程式碼通常用於釋放重要的資源,或者還原臨時變更的狀態。
- ==上下文管理器協議包含enter和exit兩個方法==。 with 語句開始運行時,會在上下文管理器對象上調用enter方法。 with 語句運行結束後,會在上下文管理器對象上調用exit方法,以此扮演 finally 子句的角色。
- ==執行 with 後面的表達式得到的結果是上下文管理器對象,把值綁定到目標變數上(as 子句)是在上下文管理器對象上調用enter方法的結果==。with 語句的 as 子句是可選的。對 open 函數來說,必須加上 as子句,以便獲取文件的引用。不過,有些上下文管理器會返回 None,因為沒什麼有用的對象能提供給用戶。
- is和==比較
- 基本要素
- id(身份標識)
- type(數據類型)
- value(值)。
- is和==都是對對象進行比較判斷作用的,但對對象比較判斷的內容並不相同。
- ==比較操作符和is同一性運算符區別
- ==是python標準操作符中的比較操作符,用來比較判斷兩個對象的value(值)是否相等,例如下面兩個字元串間的比較:
- 基本要素
# >> a = 'yms' # >> b = 'yms' # >> a == b # True
-
- is也被叫做同一性運算符,這個運算符比較判斷的是對象間的唯一身份標識,也就是id是否相同。
>> x = y = [4,5,6] >> z = [4,5,6] >> x == y True >> x == z True >> x is y True >> x is z False >> >> print id(x) 3075326572 >> print id(y) 3075326572 >> print id(z) 3075328140
-
- 前三個例子都是True,這什麼最後一個是False呢?x、y和z的值是相同的,所以前兩個是True沒有問題。至於最後一個為什麼是False,看看三個對象的id分別是什麼就會明白了。
- 下面再來看一個例子,同一類型下的a和b的(a==b)都是為True,而(a is b)則不然。
>> a = 1 #a和b為數值類型 >> b = 1 >> a is b True >> id(a) 14318944 >> id(b) 14318944 >> a = 'cheesezh' #a和b為字元串類型 >> b = 'cheesezh' >> a is b True >> id(a) 42111872 >> id(b) 42111872 >> a = (1,2,3) #a和b為元組類型 >> b = (1,2,3) >> a is b False >> id(a) 15001280 >> id(b) 14790408 >> a = [1,2,3] #a和b為list類型 >> b = [1,2,3] >> a is b False >> id(a) 42091624 >> id(b) 42082016 >> a = {'cheese':1,'zh':2} #a和b為dict類型 >> b = {'cheese':1,'zh':2} >> a is b False >> id(a) 42101616 >> id(b) 42098736 >> a = set([1,2,3])#a和b為set類型 >> b = set([1,2,3]) >> a is b False >> id(a) 14819976 >> id(b) 14822256
- 通過以上三個示例可以看出,只有數值型和字元串型的情況下,a is b才為True,當a和b是tuple,list,dict或set型時,a is b為False
 Python基礎到此就分解完了,有不足的地方請留言,多多支援,持續更新中哦!!