當程式執行一條查詢語句時,MySQL內部到底發生了什麼? (說一下 MySQL 執行一條查詢語句的內部執行過程?
- 2020 年 3 月 26 日
- 筆記
先來個最基本的總結闡述,希望各位小夥伴認真的讀一下,哈哈:
1)客戶端(運行程式)先通過連接器連接到MySql伺服器。
2)連接器通過資料庫許可權身份驗證後,會先查詢資料庫快取是否存在(之前執行過相同條件的SQL查詢),如果有會直接返回快取中的數據。如果沒有則會進入分析器。
3)進入分析器後會對查詢語句進行詞法語法的分析,判斷該查詢語句SQL是否存在語法錯誤,如果存在查詢語法詞法錯誤,會直接返回給客戶端錯誤,如果正確則會進入優化器。
4)優化器會對查詢語句進行優化處理:例如:如果一條語句用到了多個索引會判斷哪個索引性能更好。
5)最終會進入執行器,開始執行查詢語句直到查詢出滿足條件的所有數據,然後進行返回。
下面我們詳細的來說一下:
假如說我們有一張 User 表 ,表裡只有一個欄位 ID,當我們執行下邊這條SQL語句時:
mysql> select * fron T where ID = 10; 在我們眼中能看到的只是輸入一條 SQL語句,返回一條查詢結果,卻不曾知道這條SQL在MySQL的內部經歷了什麼,下面我們來一步一步的分析一下;如下是MySQL的基本架構圖,從圖中可以清楚的看到SQL在MySQL中各個功能模組執行的過程:
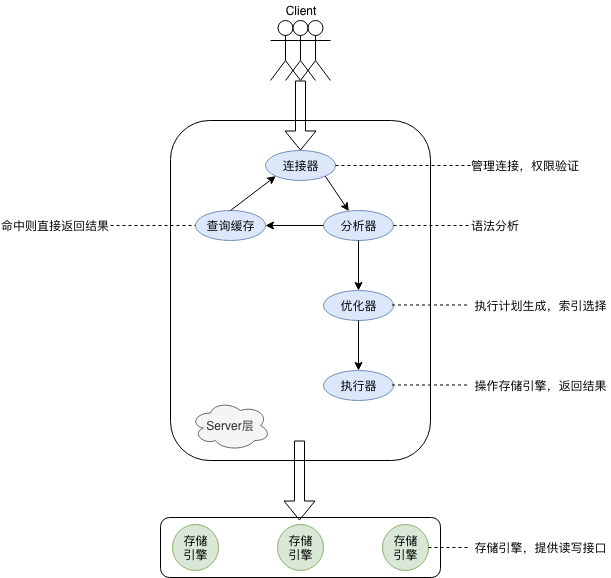
大體來說,MySQL可以分為Server層和存儲引擎兩部分。
Server層:包括連接器、分析器、查詢快取、優化器、執行器等。
存儲引擎:負責數據的存儲和提取。其架構模式是插件式的,支援InnoDB、MyISAM、Memory等多種存儲模式。現如今最常用的存儲引擎是InnoDB,它從MySQL5.5.5開始成為了默認存儲引擎。也就是說當我們不指定存儲引擎時默認使用的就是InnoDB,我們也可以在 create table時通過engine=memory 來指定存儲引擎。
從圖中可以看出:不同的存儲引擎共用同一個 server層,也就是連接器到執行器那一部分。
現在我們跟著開篇提到的那條SQL進入MySQL內部到底是怎麼執行的,Let's go:
連接器:
首先,我們需要連接上資料庫,這時候接待我們的就是連接器,連接器主要負責的工作就是跟客戶端建立連接、獲取許可權、維持和管理連接。連接命令如下:
-- $ip: 伺服器IP -- $port: MySQL埠號 -- $user: 用戶名 mysql -h$ip -P$port -u$user -p
- 如果用戶名或密碼不對,則會收到一個
“Access denied for user”錯誤,然後客戶端程式結束執行。 - 如果用戶名密碼認證通過,連接器則會去許可權表中查詢該用戶所擁有的許可權,這個鏈接裡邊的許可權邏輯判斷,全都依賴於此時讀到的許可權。
這就意味著,當一個用戶成功建立連接後,即使使用管理員賬戶對其許可權做了修改,也不會立即生效,只有重新建立鏈接後才會使用新的許可權設置。
查詢快取:
連接建立成功後,我們就可以執行SQL語句了,這時候會先來查詢快取:
MySQL拿到一個SQL語句之後會先到快取看看是否在此之前執行過這條語句,之前執行的語句可能會以 key-value 的形式直接快取在記憶體中。key是查詢語句,value是查詢結果。如果你的查詢能在快取中找到相應的key,則直接返回其對應的value 給客戶端。
如果語句不在查詢快取中,就會繼續後面的執行階段。執行完成後,執行結果會被存入查詢快取中。你可以看到,如果查詢命中快取,MySQL不需要執行後面的複雜操作,就可以直接返回結果,這個效率會很高。
分析器:
如果沒有命中快取的話,則真正開始執行語句了;首先MySQL要知道我們要做什麼,所以要先對SQL進行解析。
分析器首先進行詞法分析。我們輸入的SQL是由多個字元串組成的,MySQL需要識別出來裡邊的字元串分別是什麼,代表什麼意思。
MySQL從我們輸入的select識別出來這是一個查詢語句,它還需要把字元串T識別成表名User,把ID識別成列ID。
詞法分析結束之後,需要對SQL進行語法分析。根據詞法分析的結果,語法分析器會根據語法規則來判斷我們輸入的這條SQL是否滿足MySQL的語法規則。
如果我們的語法不對的話,我們會受到MySQL的錯誤提示You have an error in your SQL syntax,比如這條SQL中的select少了個s:
mysql> elect * from user where id = 1; ERROR 1064 (42000): You have an error in your SQL syntax; check the manual that corresponds to your MySQL server version for the right syntax to use near 'elect * from t where ID=1' at line 1
優化器
經過了分析器,MySQL知道我們要做什麼了,在它開始執行之前,還要先經過優化器的處理。
優化器是在表裡面有多個索引的時候,決定使用哪個索引;或者在一個語句有多表關聯(join)的時候,決定各個表的連接順序。比如下邊這條語句,這個語句時執行兩個表的join:
mysql> select * from t1 join t2 using(ID) where t1.c=10 and t2.d=20;
- 既可以先從表
t1裡面取出c=10的ID值,再根據ID值去關聯到表t2,在判斷t2裡面的d的值是否等於20; - 也可以先從表
t2裡面取出d=20的記錄的ID值,再根據ID值關聯到t1,再判斷t1裡面的c的值是否等於10;
這兩種執行方式的邏輯和結果都是一樣的,但是執行效率會有所不同,優化器的作用就是決定選擇哪種方案。
執行器
MySQL通過分析器知道了我們要做什麼,通過優化器知道了應該怎麼做,於是就進入執行器階段,開始真正的執行語句。
開始執行的時候,首先要確認我們是否有操作這個表(T)的許可權,如果沒有許可權則會返回沒有許可權的錯誤:
mysql> select * from T where ID=10; ERROR 1142 (42000): SELECT command denied to user 'b'@'localhost' for table 'T'
如果有許可權,就打開表繼續執行,打開表的時候執行器會根據表的引擎定義,去使用這個額引擎提供的介面。
比如在這個例子中的表T中的ID欄位是沒有索引的,那麼執行器的流程是這樣的:
- 調用
InnoDB引擎介面取這個表的第一行,判斷ID是否為10,如果不是則跳過,如果是則將這行存在結果集中。 - 調用引擎介面取
下一行,重複相同的邏輯判斷,直到取到這個表的最後一行。 - 執行器將上述遍歷過程的所有滿足條件的行組成的記錄集作為結果集返回給客戶端。
至此,這個語句就執行完成了。
對於有索引的表,執行的邏輯也差不多。第一次調用的是“取滿足條件的第一行”這個介面,之後循環取“滿足條件的下一行”這個介面,這些介面都是引擎中已經定義好的。你會在資料庫的慢查詢日誌中看到一個 rows_examined 的欄位,表示這個語句執行過程中掃描了多少行。這個值就是在執行器每次調用引擎獲取數據行的時候累加的。
在有些場景下,執行器調用一次,在引擎內部則掃描了多行,因此引擎掃描行數跟 rows_examined 並不是完全相同的。
延伸出的面試題問法,各種變態考察:
1)MySQL 提示“不存在此列”是執行到哪個節點報出的?
此錯誤是執行到分析器階段報出的,因為 MySQL 會在分析器階段檢查 SQL 語句的正確性。
2)MySQL 查詢快取的功能有何優缺點?
MySQL 查詢快取功能是在連接器之後發生的,它的優點是效率高,如果已經有快取則會直接返回結果。 查詢快取的缺點是失效太頻繁導致快取命中率比較低,任何更新表操作都會清空查詢快取,因此導致查詢快取非常容易失效。
3)如何關閉 MySQL 的查詢快取功能?
MySQL 查詢快取默認是開啟的,配置 querycachetype 參數為 DEMAND(按需使用)關閉查詢快取,MySQL 8.0 之後直接刪除了查詢快取的功能。
