Elasticsearch構建全文搜索系統
- 2020 年 3 月 15 日
- 筆記
目錄
前言
Elasticsearch 是一個分散式、可擴展、實時的搜索與數據分析引擎,通過它我們可以構建出一個強大的全文搜索系統,解決諸如文章檢索慢,商品檢索慢、MySQL的like查詢慢這樣的問題。
Elasticsearch是基於hadoop創始人道哥的另一傑作Lucene實現的,速度非常快,核心是使用了倒排索引這樣的結構。關於倒排索引是什麼,可以參考搜索引擎中的倒排索引是什麼
接下來,就以這篇倒排索引中的例子,演示一下ElasticSearch的使用
假設我們有海量文章,如下
| 頁碼 | 內容 |
|---|---|
| 1 | 生命在於運動 |
| 2 | 運動是生命的源泉 |
| 3 | 日復一日地堅持練下去吧,只有活動適量才能保持訓練的熱情和提高運動的技能.——塞涅卡 |
| 4 | 活動是生活的基礎!——歌德 |
| 5 | 人的健全,不但靠飲食,尤靠運動 |
| 6 | 奧林匹克的格言是「更高,更快,更強」 |
| 7 | 身體的健康因靜止不動而破壞,因運動練習而長期保持.——蘇格拉底 |
| 8 | chenqionghe喜歡運動,繩命是如此的精彩,繩命是如此的輝煌 |
我們想像這是千萬級別的表,最後需要實現傳入關鍵字,返回相應的文章
例如:搜索運動返回頁碼1,2,3,5,7,8對應的文章、搜索chenqionghe返回頁碼為8的文章
一、安裝
1.安裝es
查看官網地址,直接下載安裝就行了,我用的是mac直接下了mac版本的,另外也可以使用dokcer安裝
解壓後長這樣
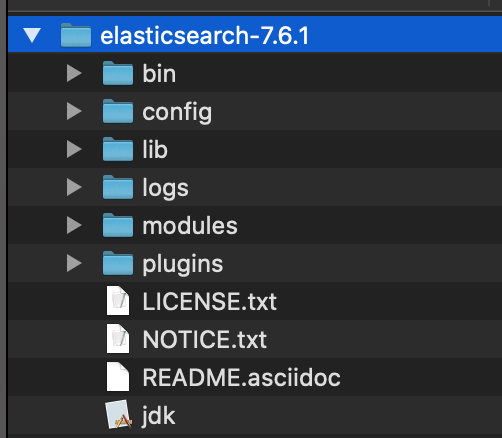
es依賴java環境,需要指定jdk版本,我們加入一下java相關環境變數
export JAVA_HOME=/Users/chenqionghe/web/elk/elasticsearch-7.6.1/jdk.app/Contents/Home/ export PATH=$JAVA_HOME/bin:$PATH啟動一下看看
./bin/elasticsearch看到啟動報錯
uncaught exception in thread [main] ElasticsearchException[Failure running machine learning native code. This could be due to running on an unsupported OS or distribution, missing OS libraries, or a problem with the temp directory. To bypass this problem by running Elasticsearch without machine learning functionality set [xpack.ml.enabled: false].]解決辦法,修改./config/elasticsearch.yml添加
xpack.ml.enabled: false再次啟動,成功運行,畫風如下
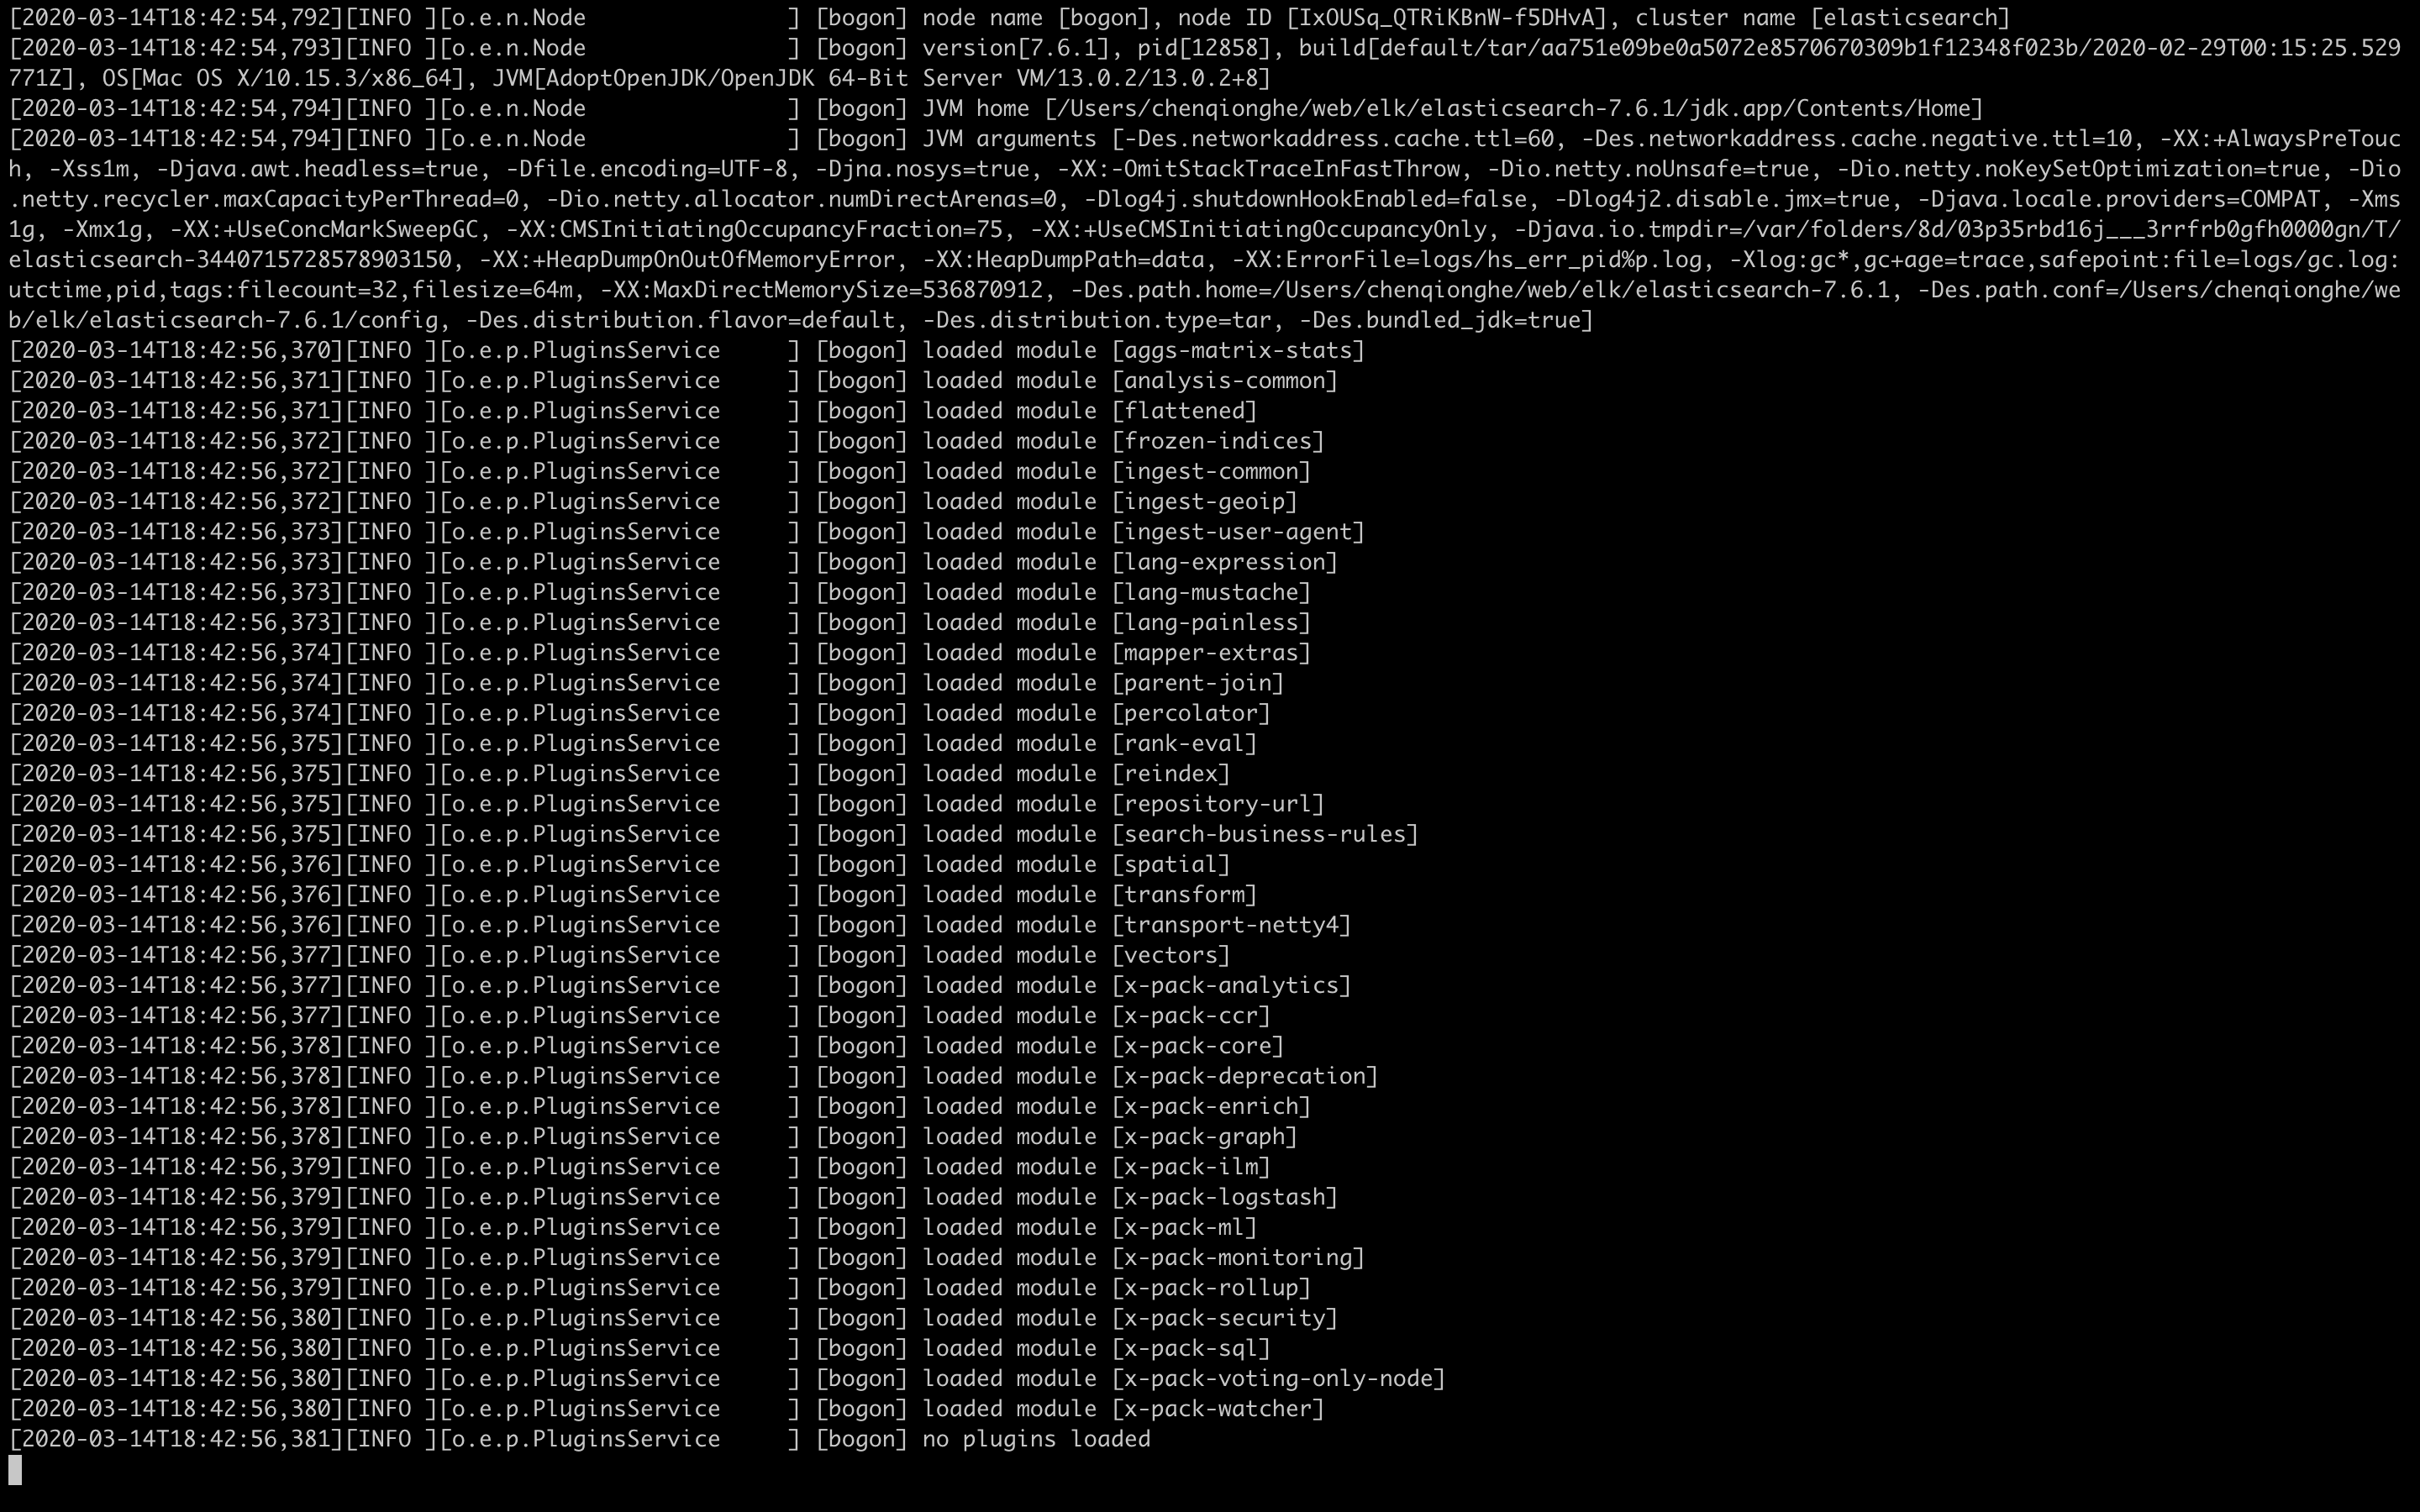
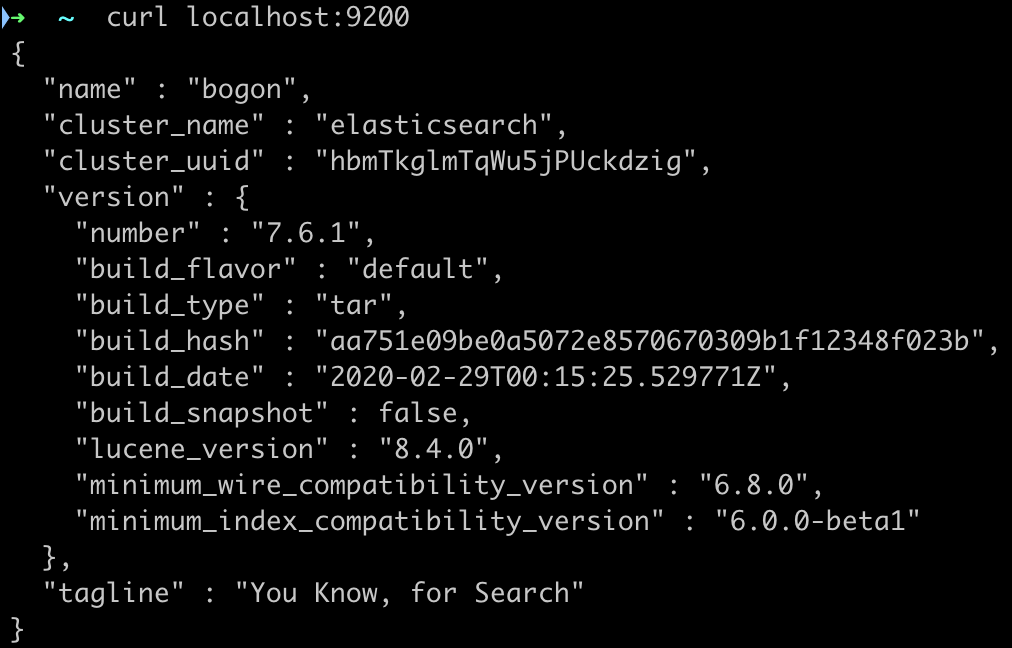
默認啟動的是9200埠,我們來測試一下
➜ ~ curl localhost:9200yeah, it's running,you konw, for search !
2.啟動集群
編輯./config/elasticsearch.yml
指定集群名稱,這裡注釋打開,集群名稱指定成了chenqionghe
cluster.name: chenqionghe指定節點名稱
ode.name: chenqionghe-1設置初始化的節點
cluster.initial_master_nodes: ["chenqionghe-1"]設置監聽的埠,這裡不限定ip,指定為0.0.0.0
network.host: 0.0.0.0埠默認9200
http.port: 9200添加支援elasticsearch-head介面參數
http.cors.enabled: true http.cors.allow-origin: "*" http.cors.allow-methods: OPTIONS, HEAD, GET, POST, PUT, DELETE http.cors.allow-headers: "X-Requested-With, Content-Type, Content-Length, X-User"再次啟動
./bin/elasticsearch3.安裝管理介面
elasticsearch-head可以很方便的查看es集群狀態,查看官網地址:elasticsearch-head
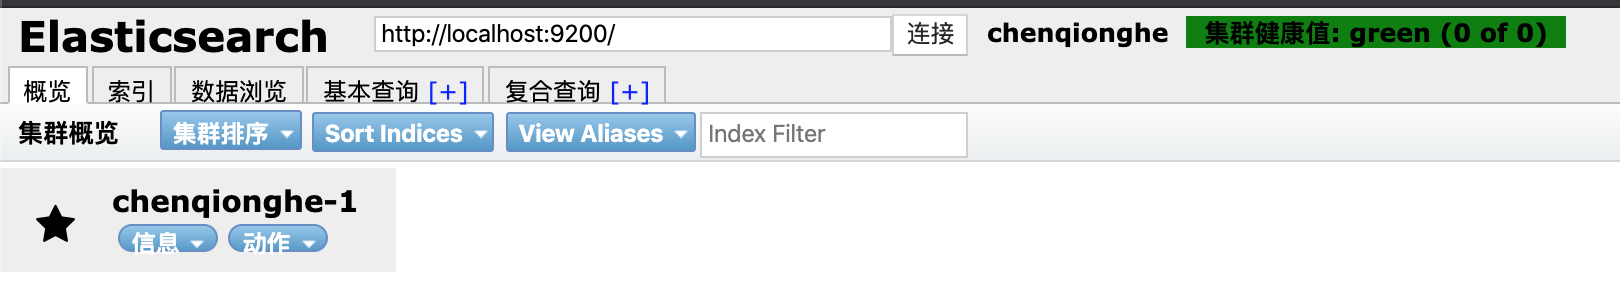
git clone git://github.com/mobz/elasticsearch-head.git cd elasticsearch-head npm install npm run start打開http://localhost:9100/,如下
4.安裝分詞插件
插件我們使用的是elasticsearch-analysis-ik,參考地址:elasticsearch-analysis-ik/
./bin/elasticsearch-plugin install https://github.com/medcl/elasticsearch-analysis-ik/releases/download/v7.6.1/elasticsearch-analysis-ik-7.6.1.zip驗證一下分插件
curl -X POST "localhost:9200/_analyze?pretty" -H 'Content-Type: application/json' -d '{ "analyzer": "ik_smart", "text": "chenqionghe徒手健身" }'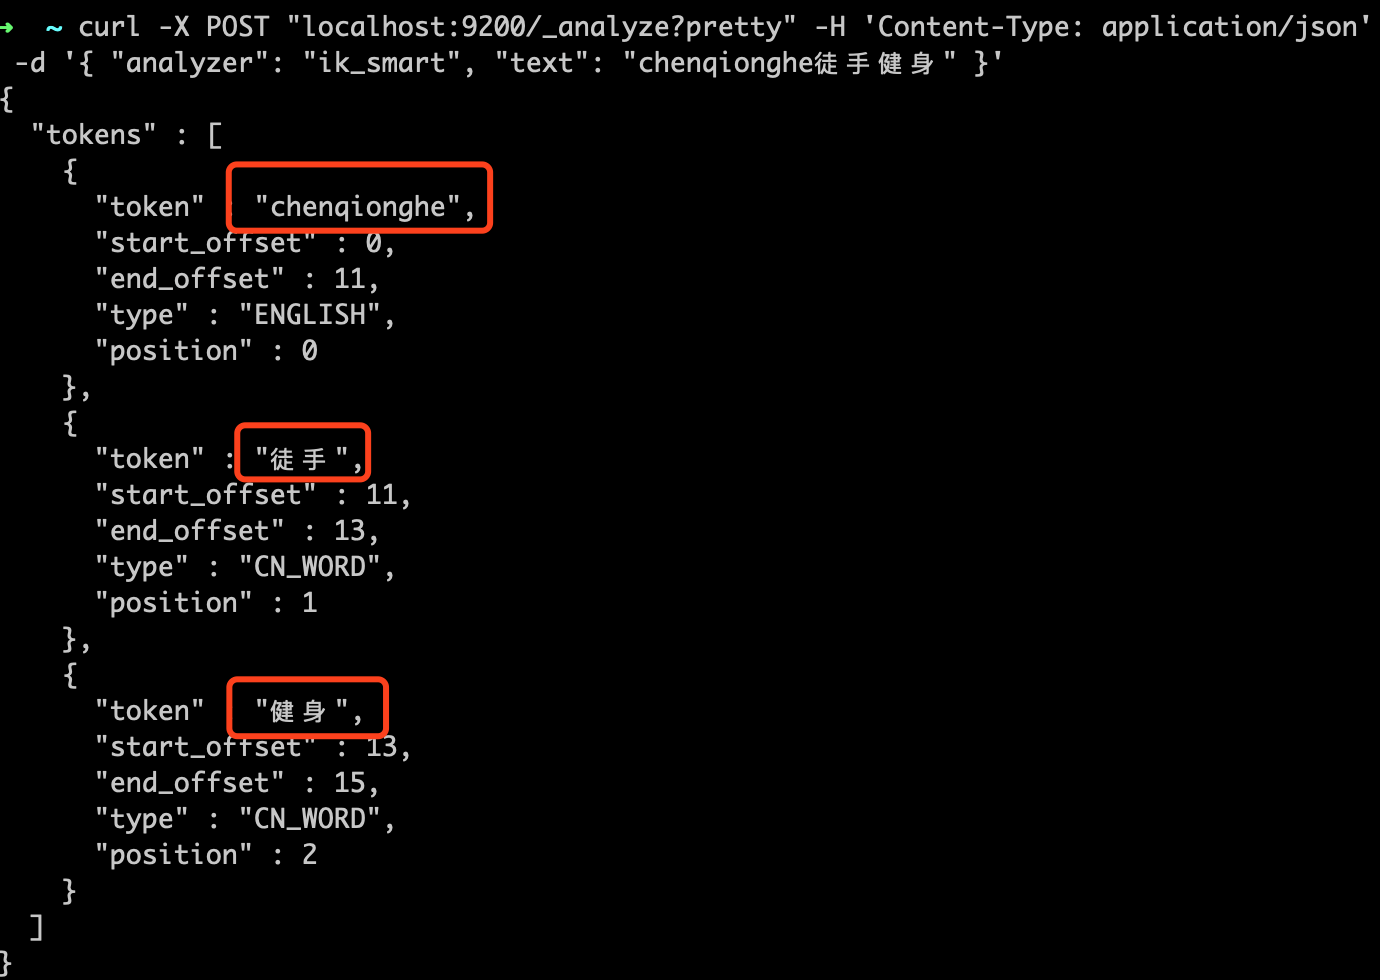
可以看到,已經可以分詞了,oh yeah~
二、使用
ES中有index、document、filed、mapping這樣的概念,我們以MySQL的結構為參考對照一下,如下
| ElasticSearch | MySQL |
|---|---|
| Iindex | 表 |
| document | 行 |
| field | 列 |
| mapping | 表結構 |
Elasticsearch主要還是使用API,具體使用請參考:Document APIs
1.創建索引
這裡index我取名叫book
➜ ~ curl -X PUT "localhost:9200/book" -H 'Content-Type: application/json' -d '{ "mappings": { "properties": { "page": { "type": "long" }, "content": { "type": "text", "analyzer": "ik_max_word", "search_analyzer": "ik_max_word" } } } }' {"acknowledged":true,"shards_acknowledged":true,"index":"book"}創建成功,但是查看head介面,但是這個黃色不怎麼優雅呀,原因是雖然啟用了集群,但是還是單節點運行的,群集無法放置副本。
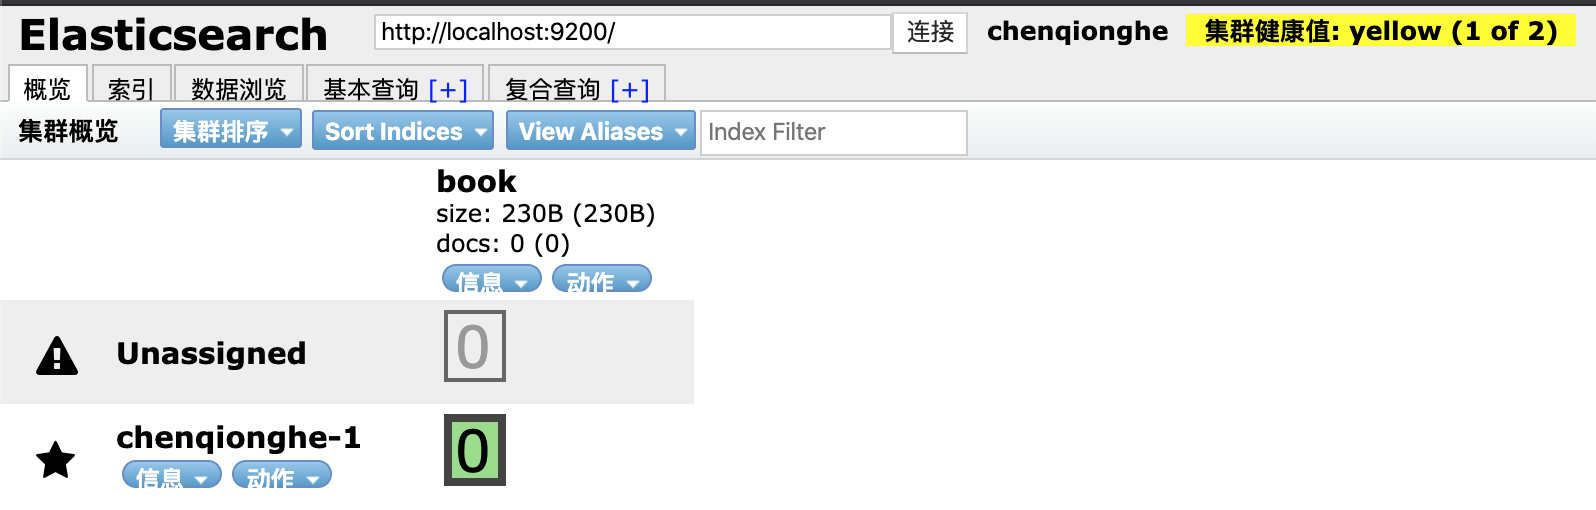
集群的健康狀況為 yellow 則表示全部主分片(number_of_shards)都正常運行,但是副本分片沒有全部處在正常狀態,單節點無論有多少個副本分片(number_of_replicas)都是 unassigned ,它們都沒有被分配到任何節點。
在同一個節點上既保存原始數據又保存副本是沒有意義的,因為一旦失去了那個節點,我們也將丟失該節點上的所有副本數據。
我們需要把這個副本設置為0,因為索引一旦建立,分片數量不能變,我們需要刪除再重新建立一下索引
curl -XDELETE http://localhost:9200/book curl -X PUT "localhost:9200/book" -H 'Content-Type: application/json' -d '{ "settings":{ "number_of_shards": "1", "number_of_replicas": "0" }, "mappings": { "properties": { "page": { "type": "long" }, "content": { "type": "text", "analyzer": "ik_max_word", "search_analyzer": "ik_max_word" } } } }'再次查看,健康了

2.插入數據
curl -X POST "localhost:9200/book/_doc/" -H 'Content-Type: application/json' -d '{ "page":1, "content": "生命在於運動" }'我們可以看到已經成功插入一條數據
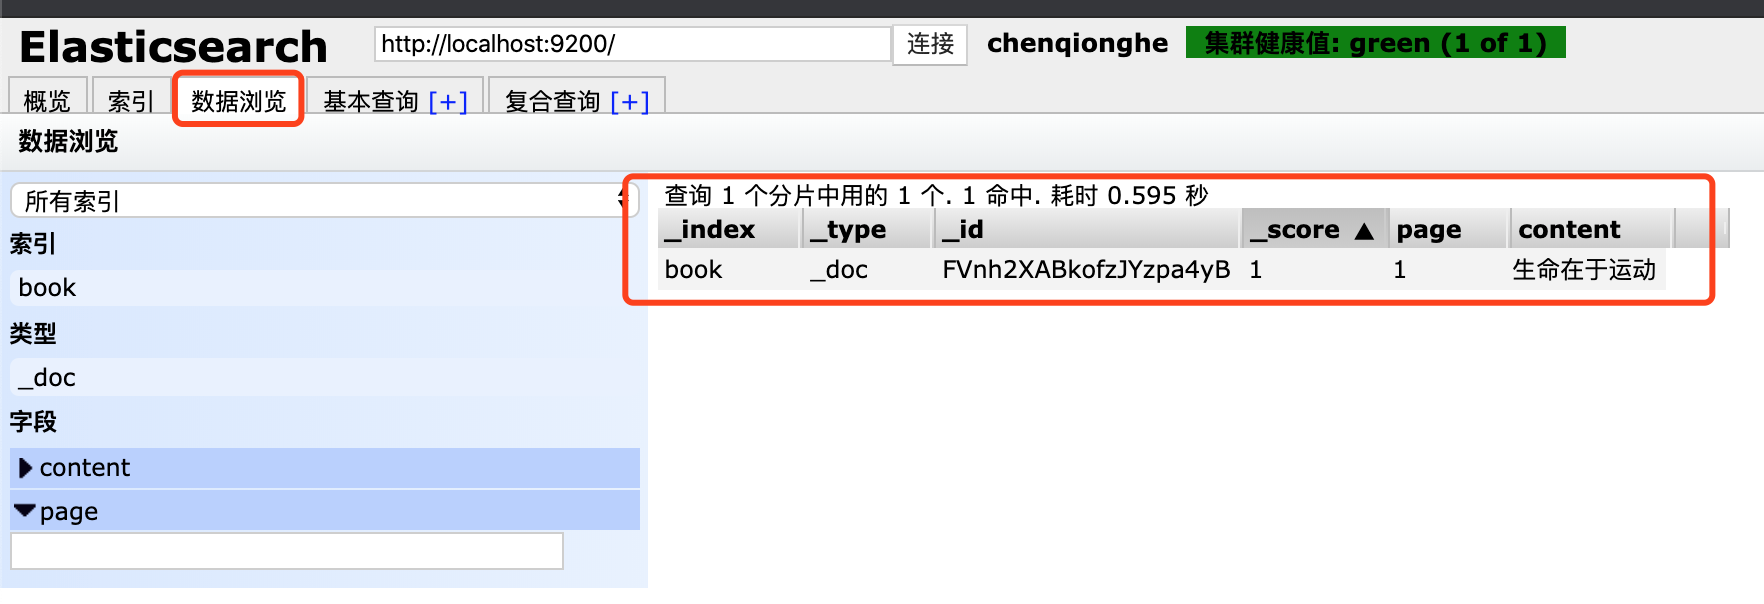
3.批量插入數據
curl -X POST "localhost:9200/book/_doc/_bulk?pretty" -H 'Content-Type: application/json' -d' { "index":{} } { "page":2 , "content": "運動是生命的源泉"} { "index":{} } { "page":3 , "content": "日復一日地堅持練下去吧,只有活動適量才能保持訓練的熱情和提高運動的技能.——塞涅卡"} { "index":{} } { "page":4 , "content": "活動是生活的基礎!——歌德"} { "index":{} } { "page":5 , "content": "人的健全,不但靠飲食,尤靠運動"} { "index":{} } { "page":6 , "content": "奧林匹克的格言是「更高,更快,更強」"} { "index":{} } { "page":7 , "content": "身體的健康因靜止不動而破壞,因運動練習而長期保持.——蘇格拉底"} { "index":{} } { "page":8 , "content": "chenqionghe喜歡運動,繩命是如此的精彩,繩命是如此的輝煌"} '可以看到成功批量插入

4.查詢數據
- 搜索
chenqionghe
curl -s -X GET 'localhost:9200/book/_search?pretty' -H 'Content-Type: application/json' -d '{ "query" : { "match" : { "content" : "chenqionghe" }} }'|jq可以看到匹配到了
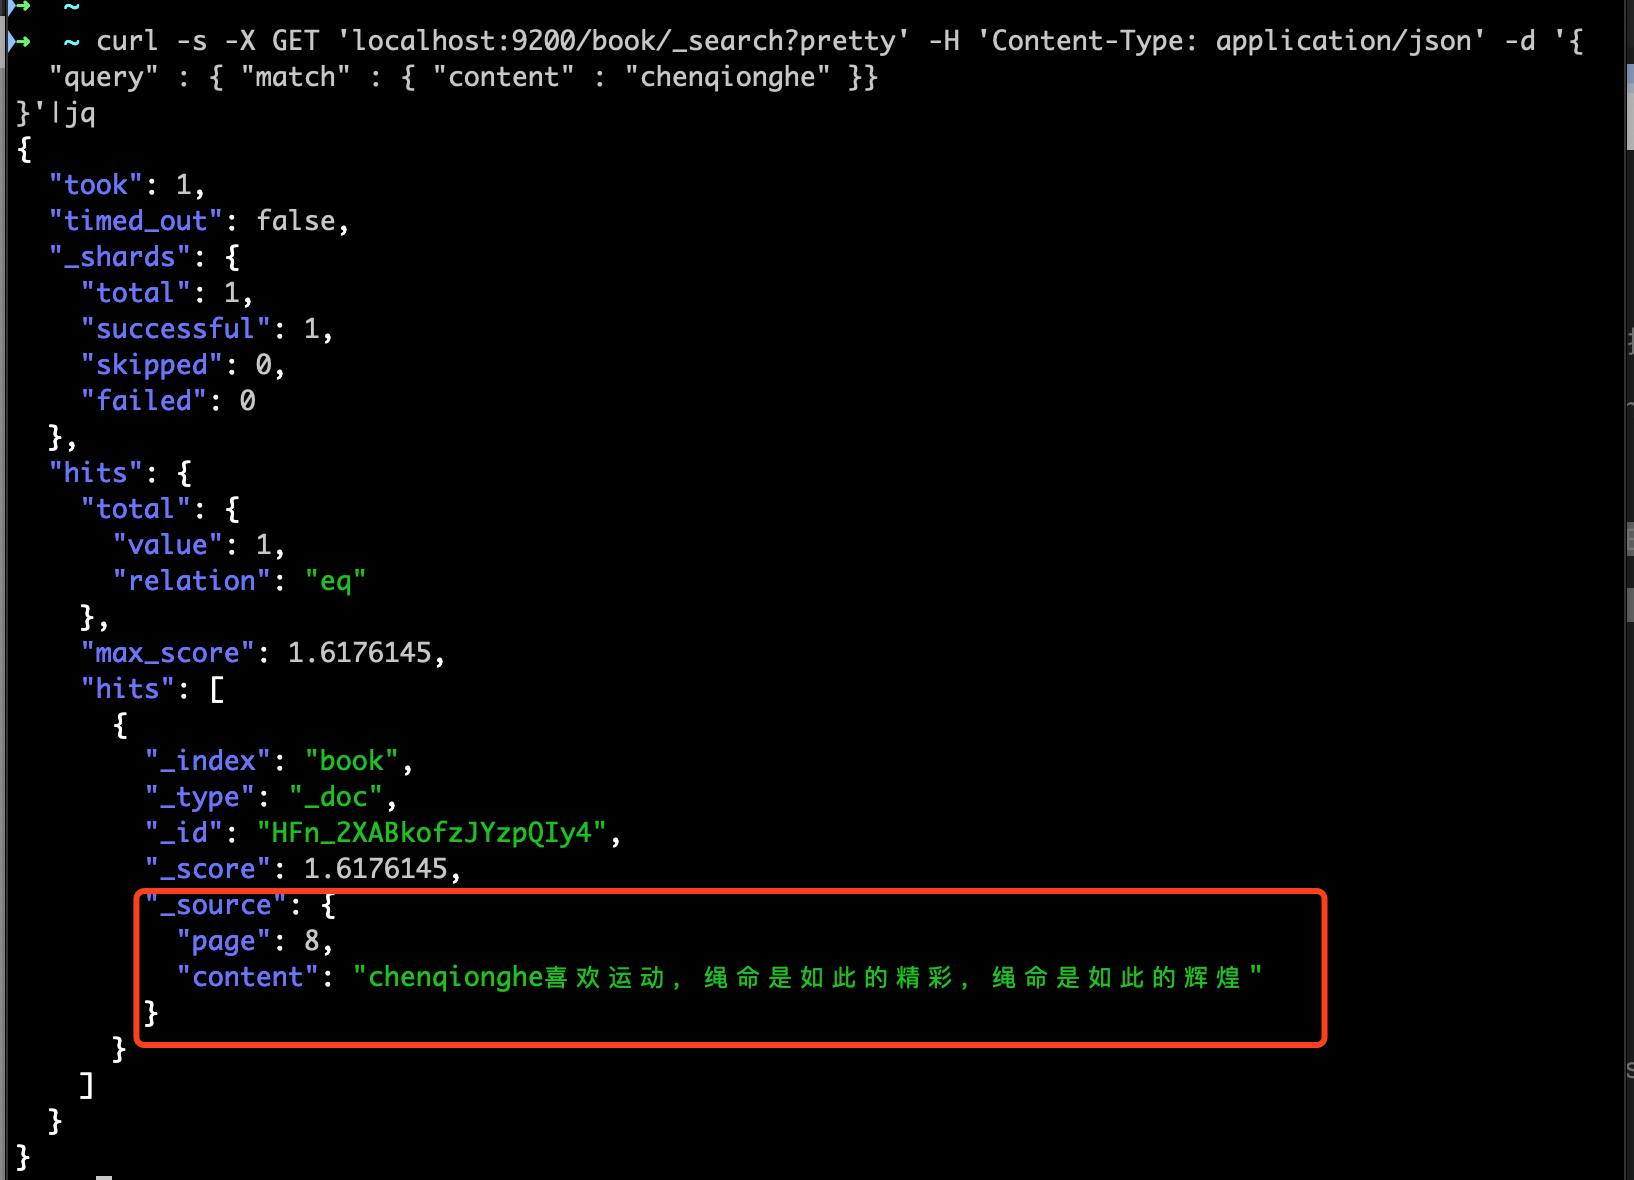
- 搜索
運動,應該是會返回1,2,3,5,7,8這幾條
curl -s -XGET 'localhost:9200/book/_search?pretty' -H 'Content-Type: application/json' -d '{ "query" : { "match" : { "content" : "運動" }} }'|jq .hits.hits|jq '.[]._source'可以看到,驗證通過

5.修改數據
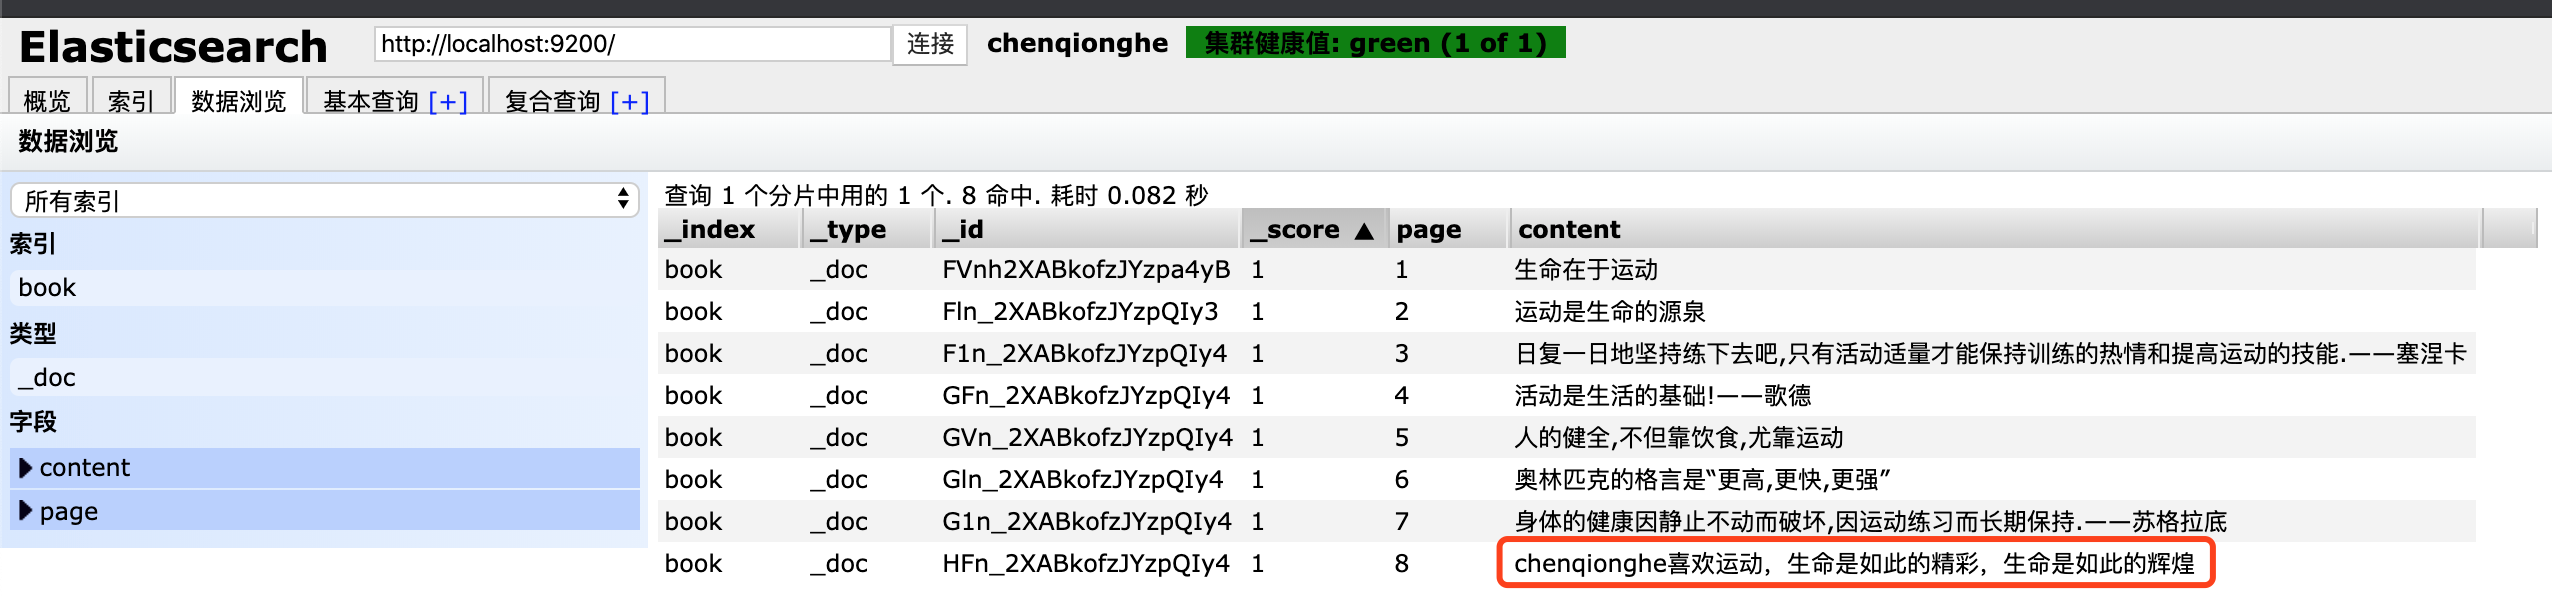
拉下來,我們將chenqionghe這條記錄的繩命改為生命,
curl -X POST "localhost:9200/book/_doc/HFn_2XABkofzJYzpQIy4" -H 'Content-Type: application/json' -d '{ "page":8, "content": "chenqionghe喜歡運動,生命是如此的精彩,生命是如此的輝煌" }'可以看到,更新成功
6.刪除數據
- 根據id刪除
curl -X DELETE "localhost:9200/book/_doc/GFn_2XABkofzJYzpQIy4"- 根據條件刪除
curl -X POST "localhost:9200/book/_delete_by_query?pretty" -H 'Content-Type: application/json' -d' { "query": { "match": { "content": "chenqionghe" } } } '7.索引關閉和開啟
如果關閉了一個索引,就無法通過ES來讀取和寫入其中的數據,直到道再次打開它
# 關閉 curl -XPOST 'localhost:9200/book/_close' # 開啟 curl -XPOST 'localhost:9200/book/_open'總結
通過Elasticsearch,我們可以快速構建出一個強大的全文搜索系統,安裝簡單,通過API使用也簡單。
倒排索引為搜索而生,先對需要索引的欄位進行分詞,再通過詞直接匹配出文檔,速度非常快,這是優點。但是,相比資料庫採用的 B 樹索引,它的寫入和更新性能都比較差,因此倒排索引也只是適合全文搜索,不適合更新頻繁的交易類數據。
總之,安裝使用Elasticsearch其實就是這麼簡單,驚不驚喜,意不意外呀,light weight baby!
更多資料請參考 :Eelasticsearch權威指南

