sklearn 學習 第二篇:特徵預處理
- 2019 年 10 月 3 日
- 筆記
sklearn.preprocessing包提供了幾個常用的轉換函數,用於把原始特徵向量轉換為更適合估計器的表示。
轉化器(Transformer)用於對數據的處理,例如標準化、降維以及特徵選擇等,提供的函數大致是:
- fit(x,y):該方法接受輸入和標籤,計算出數據變換的方式。
- transform(x):根據已經計算出的變換方式,返回對輸入數據x變換後的結果(不改變x)
- fit_transform(x,y) :該方法在計算出數據變換方式之後對輸入x就地轉換。
在轉化器中,fit_transform()函數等價於先執行fit()函數,後執行transform()函數。有如下的數據,使用preprocessing包對數據進行標準化和歸一化處理:
from sklearn import preprocessing import numpy as np X_train = np.array([[ 1., -1., 2.], [ 2., 0., 0.], [ 0., 1., -1.]])
一,數據標準化
數據標準化是指對數據經過處理後,使每個特徵中的數值的均值變為0,標準差變為1。
1,標準正態分布
scale()是數據標準化的快捷方式:
X_scaled = preprocessing.scale(X_train) 對應的fit-transform組合是:
scaler = preprocessing.StandardScaler().fit(X_train) scaler.transform(X_train) 2,把數據縮放到範圍
把數據縮放到給定的範圍內,通常在0和1之間,或者使用每個特徵的最大絕對值按比例縮放到單位大小。
MinMaxScaler(feature_range=(0, 1), copy=True) MaxAbsScaler(copy=True) 舉個例子,MinMaxScaler() 用於把數據按照max和min縮放到0和1之間,其中max和min是縮放區間的最大值和最小值,縮放的公式如下:
X_std = (X - X.min(axis=0)) / (X.max(axis=0) - X.min(axis=0)) X_scaled = X_std * (max - min) + min 使用MinMaxScaler()函數進行縮放:
scaler = preprocessing.MinMaxScaler(feature_range=(0, 1)) X_scaled=scaler.fit_transform(X_train) 二,數據歸一化
通過對原始數據進行線性變換把數據映射到[0,1]或[-1,1]之間,常用的變換函數為:
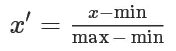
sklearn提供函數normalize或者fit-transform組合來實現數據的歸一化。參數norm是用於標準化每個非0數據的範式,可用的值是 l1和l2 範式,默認值是l2範式。
#X_normalized = preprocessing.normalize(X, norm='l2') normalizer = preprocessing.Normalizer( norm='l2').fit(X) normalizer.transform(X) #out array([[ 0.40..., -0.40..., 0.81...], [ 1. ..., 0. ..., 0. ...], [ 0. ..., 0.70..., -0.70...]])
三,對分類數據進行編碼
把分類數據(標稱數據)轉換為數值編碼,以整數的方式表示,對分類數據編碼,有兩種方式:順序編碼 和 OneHot編碼。
1,順序編碼
順序編碼把每一個categorical 特徵變換成有序的整數數字特徵 (0 到 n_categories - 1),然而,這種整數表示不能直接用於所有scikit-learn估計器,因為估計器期望連續輸入,並且把類別解釋為有序的,但是,集合通常是無序的,無法實現順序。
enc = preprocessing.OrdinalEncoder() X = [['male', 'from US', 'uses Safari'], ['female', 'from Europe', 'uses Firefox']] enc.fit(X) enc.transform([['female', 'from US', 'uses Safari']]) array([[0., 1., 1.]])
有序編碼對象中包含 categories_ 屬性,用於查看分類數據:
>>> enc.categories_ [array(['female', 'male'], dtype=object), array(['from Europe', 'from US'], dtype=object), array(['uses Firefox', 'uses Safari'], dtype=object)]
把轉換的結果 [0., 1., 1.],代入到categories_ 屬性中,數組的第一個元素是0,對應categories_ 屬性中female類別;數組的第二個元素是1,對應categories_ 屬性中from US類別,以此類推。
2,OneHot編碼
另外一種將標稱型特徵轉換為能夠被scikit-learn中模型使用的編碼是OneHot(獨熱碼)、one-out-of-N(N取一編碼)或dummy encoding(虛擬編碼),這種編碼類型已經在類OneHotEncoder中實現,該類把每一個具有n個可能取值的categorical特徵變換為長度為n的特徵向量,裡面只有一個地方是1,其餘位置都是0。
>>> from sklearn import preprocessing >>> enc = preprocessing.OneHotEncoder() >>> X = [['male', 'from US', 'uses Safari'], ['female', 'from Europe', 'uses Firefox']] >>> enc.fit(X) >>> enc.transform([['female', 'from US', 'uses Safari']]).toarray() [[1., 0., 0., 1., 0., 1.]] >>> enc.categories_ [array(['female', 'male'], dtype=object), array(['from Europe', 'from US'], dtype=object), array(['uses Firefox', 'uses Safari'], dtype=object)]
如何理解OneHot編碼的結果?原始數據中,有三個特徵,分別是Gender、From 和 Browser,每個特徵有2個取值,OneHot編碼在原始數據中新增6個特徵,分別是female、male、from Europe、from US、uses Firefox和uses Safari。
對於數據點 ['female', 'from US', 'uses Safari']的取值,對分類數據的編碼結果是:[1., 0., 0., 1., 0., 1.],這對應著新增特徵(female, male, from Europe, from US, uses Firefox, uses Safari)的取值:

屬性categories_ 是長度為n的特徵向量,代表新增特徵(female, male, from Europe, from US, uses Firefox, uses Safari)。
三,離散化
離散化 (Discretization) 也叫 分箱(binning),用於把連續特徵劃分為離散特徵值。
sklearn.preprocessing.KBinsDiscretizer(n_bins=5, encode=’onehot’, strategy=’quantile’)
參數注釋:
n_bins:分箱的數量,默認值是5,也可以是列表,指定各個特徵的分箱數量,例如,[feature1_bins,feature2_bins,...]
encode:編碼方式,{‘onehot’, ‘onehot-dense’, ‘ordinal’}, (default=’onehot’)
- onehot:以onehot方式編碼,返回稀疏矩陣
- onehot-dense:以onehot方式編碼,返回密集矩陣
- ordinal:以ordinal方式編碼,返回分箱的序號
strategy:定義分箱寬度的策略,{‘uniform’, ‘quantile’, ‘kmeans’}, (default=’quantile’)
- uniform:每個分箱等寬
- quantile:每個分箱中擁有相同數量的數據點
- kmeans:每個箱中的值具有與1D k均值簇最近的中心
舉個例子,對於以下二維數組,有三個特徵,可以創建分箱數組,為每個維度指定分箱的數量:
from sklearn import preprocessing X = np.array([[ -3., 5., 15 ], [ 0., 6., 14 ], [ 6., 3., 11 ]]) est = preprocessing.KBinsDiscretizer(n_bins=[3, 2, 2], encode='ordinal').fit(X) est.transform(X) #out array([[ 0., 1., 1.], [ 1., 1., 1.], [ 2., 0., 0.]])
參考文檔: