一步一圖帶你深入理解 Linux 虛擬記憶體管理
- 2022 年 10 月 25 日
- 筆記
- Linux內核, 聊聊 Linux 內核
寫在本文開始之前....
從本文開始我們就正式開啟了 Linux 內核記憶體管理子系統源碼解析系列,筆者還是會秉承之前系列文章的風格,採用一步一圖的方式先是詳細介紹相關原理,在保證大家清晰理解原理的基礎上,我們再來一步一步的解析相關內核源碼的實現。有了源碼的輔證,這樣大家看得也安心,理解起來也放心,最起碼可以證明筆者沒有胡編亂造騙大家,哈哈~~
記憶體管理子系統可謂是 Linux 內核眾多子系統中最為複雜最為龐大的一個,其中包含了眾多繁雜的概念和原理,通過記憶體管理這條主線我們把可以把作業系統的眾多核心系統給拎出來,比如:進程管理子系統,網路子系統,文件子系統等。
由於記憶體管理子系統過於複雜龐大,其中涉及到的眾多繁雜的概念又是一環套一環,層層遞進。如何把這些繁雜的概念具有層次感地,並且清晰地,給大家梳理呈現出來真是一件比較有難度的事情,因此關於這個問題,筆者在動筆寫這個記憶體管理源碼解析系列之前也是思考了很久。
萬事開頭難,那麼到底什麼內容適合作為這個系列的開篇呢 ?筆者還是覺得從大家日常開發工作中接觸最多最為熟悉的部分開始比較好,比如:在我們日常開發中創建的類,調用的函數,在函數中定義的局部變數以及 new 出來的數據容器(Map,List,Set .....等)都需要存儲在物理記憶體中的某個角落。
而我們在程式中編寫業務邏輯程式碼的時候,往往需要引用這些創建出來的數據結構,並通過這些引用對相關數據結構進行業務處理。
當程式運行起來之後就變成了進程,而這些業務數據結構的引用在進程的視角里全都都是虛擬記憶體地址,因為進程無論是在用戶態還是在內核態能夠看到的都是虛擬記憶體空間,物理記憶體空間被作業系統所屏蔽進程是看不到的。
進程通過虛擬記憶體地址訪問這些數據結構的時候,虛擬記憶體地址會在記憶體管理子系統中被轉換成物理記憶體地址,通過物理記憶體地址就可以訪問到真正存儲這些數據結構的物理記憶體了。隨後就可以對這塊物理記憶體進行各種業務操作,從而完成業務邏輯。
-
那麼到底什麼是虛擬記憶體地址 ?
-
Linux 內核為啥要引入虛擬記憶體而不直接使用物理記憶體 ?
-
虛擬記憶體空間到底長啥樣?
-
內核如何管理虛擬記憶體?
-
什麼又是物理記憶體地址 ?如何訪問物理記憶體?
本文筆者就來為大家詳細一一解答上述幾個問題,讓我們馬上開始吧~~~~

1. 到底什麼是虛擬記憶體地址
首先人們提出地址這個概念的目的就是用來方便定位現實世界中某一個具體事物的真實地理位置,它是一種用於定位的概念模型。
舉一個生活中的例子,比如大家在日常生活中給親朋好友郵寄一些本地特產時,都會填寫收件人地址以及寄件人地址。以及在日常網上購物時,都會在相應電商 APP 中填寫自己的收穫地址。
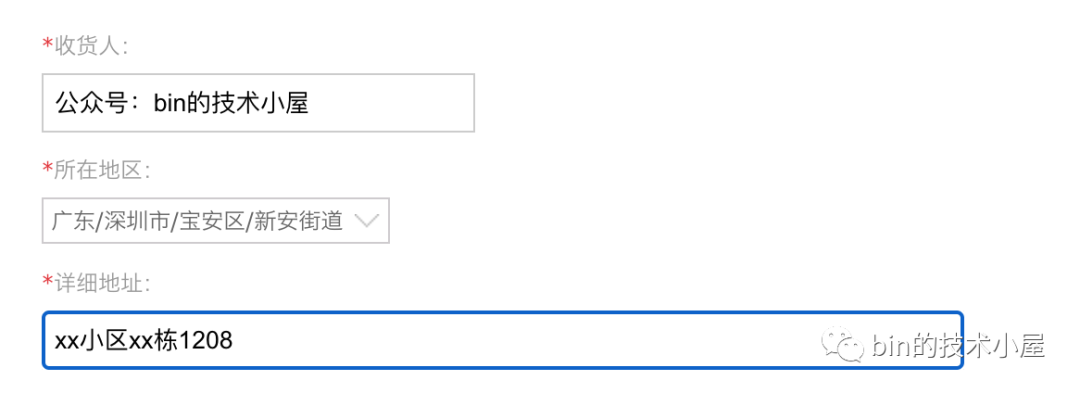
隨後快遞小哥就會根據我們填寫的收貨地址找到我們的真實住所,將我們網購的商品送達到我們的手裡。
收貨地址是用來定位我們在現實世界中真實住所地理位置的,而現實世界中我們所在的城市,街道,小區,房屋都是一磚一瓦,一草一木真實存在的。但收貨地址這個概念模型在現實世界中並不真實存在,它只是人們提出的一個虛擬概念,通過收貨地址這個虛擬概念將它和現實世界真實存在的城市,小區,街道的地理位置一一映射起來,這樣我們就可以通過這個虛擬概念來找到現實世界中的具體地理位置。
綜上所述,收貨地址是一個虛擬地址,它是人為定義的,而我們的城市,小區,街道是真實存在的,他們的地理位置就是物理地址。

比如現在的廣東省深圳市在過去叫寶安縣,河北省的石家莊過去叫常山,安徽省的合肥過去叫瀘州。不管是常山也好,石家莊也好,又或是合肥也好,瀘州也罷,這些都是人為定義的名字而已,但是地方還是那個地方,它所在的地理位置是不變的。也就說虛擬地址可以人為的變來變去,但是物理地址永遠是不變的。
現在讓我們把視角在切換到電腦的世界,在電腦的世界裡記憶體地址用來定義數據在記憶體中的存儲位置的,記憶體地址也分為虛擬地址和物理地址。而虛擬地址也是人為設計的一個概念,類比我們現實世界中的收貨地址,而物理地址則是數據在物理記憶體中的真實存儲位置,類比現實世界中的城市,街道,小區的真實地理位置。
說了這麼多,那麼到底虛擬記憶體地址長什麼樣子呢?
我們還是以日常生活中的收貨地址為例做出類比,我們都很熟悉收貨地址的格式:xx省xx市xx區xx街道xx小區xx室,它是按照地區層次遞進的。同樣,在電腦世界中的虛擬記憶體地址也有這樣的遞進關係。
這裡我們以 Intel Core i7 處理器為例,64 位虛擬地址的格式為:全局頁目錄項(9位)+ 上層頁目錄項(9位)+ 中間頁目錄項(9位)+ 頁內偏移(12位)。共 48 位組成的虛擬記憶體地址。
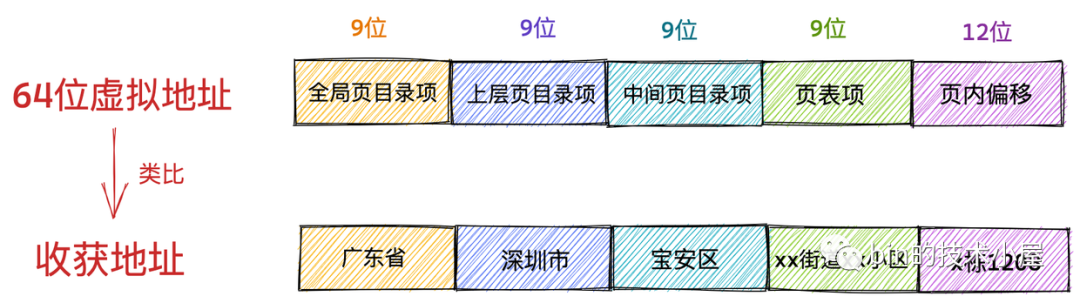
虛擬記憶體地址中的全局頁目錄項就類比我們日常生活中收穫地址里的省,上層頁目錄項就類比市,中間層頁目錄項類比區縣,頁表項類比街道小區,頁內偏移類比我們所在的樓棟和幾層幾號。
這裡大家只需要大體明白虛擬記憶體地址到底長什麼樣子,它的格式是什麼,能夠和日常生活中的收貨地址對比理解起來就可以了,至於頁目錄項,頁表項以及頁內偏移這些電腦世界中的概念,大家暫時先不用管,後續文章中筆者會慢慢給大家解釋清楚。
32 位虛擬地址的格式為:頁目錄項(10位)+ 頁表項(10位) + 頁內偏移(12位)。共 32 位組成的虛擬記憶體地址。
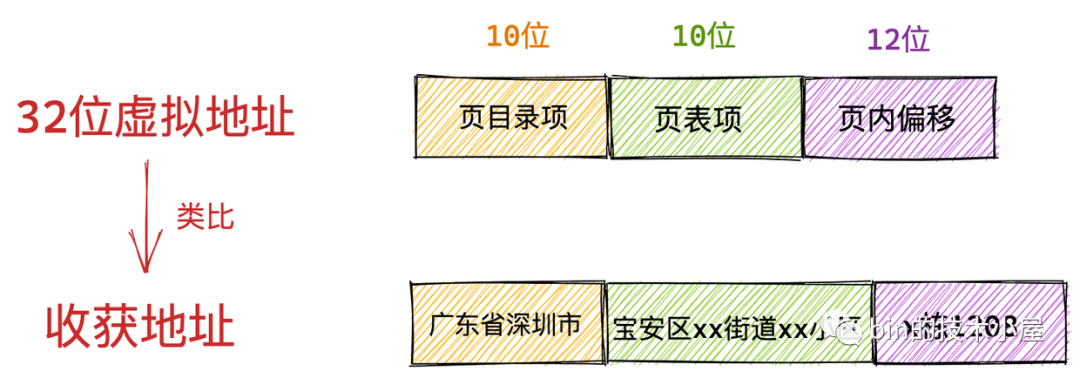
進程虛擬記憶體空間中的每一個位元組都有與其對應的虛擬記憶體地址,一個虛擬記憶體地址表示進程虛擬記憶體空間中的一個特定的位元組。
2. 為什麼要使用虛擬地址訪問記憶體
經過第一小節的介紹,我們現在明白了電腦世界中的虛擬記憶體地址的含義及其展現形式。那麼大家可能會問了,既然物理記憶體地址可以直接定位到數據在記憶體中的存儲位置,那為什麼我們不直接使用物理記憶體地址去訪問記憶體而是選擇用虛擬記憶體地址去訪問記憶體呢?
在回答大家的這個疑問之前,讓我們先來看下,如果在程式中直接使用物理記憶體地址會發生什麼情況?
假設現在沒有虛擬記憶體地址,我們在程式中對記憶體的操作全都都是使用物理記憶體地址,在這種情況下,程式設計師就需要精確的知道每一個變數在記憶體中的具體位置,我們需要手動對物理記憶體進行布局,明確哪些數據存儲在記憶體的哪些位置,除此之外我們還需要考慮為每個進程究竟要分配多少記憶體?記憶體緊張的時候該怎麼辦?如何避免進程與進程之間的地址衝突?等等一系列複雜且瑣碎的細節。
如果我們在單進程系統中比如嵌入式設備上開發應用程式,系統中只有一個進程,這單個進程獨享所有的物理資源包括記憶體資源。在這種情況下,上述提到的這些直接使用物理記憶體的問題可能還好處理一些,但是仍然具有很高的開發門檻。
然而在現代作業系統中往往支援多個進程,需要處理多進程之間的協同問題,在多進程系統中直接使用物理記憶體地址操作記憶體所帶來的上述問題就變得非常複雜了。
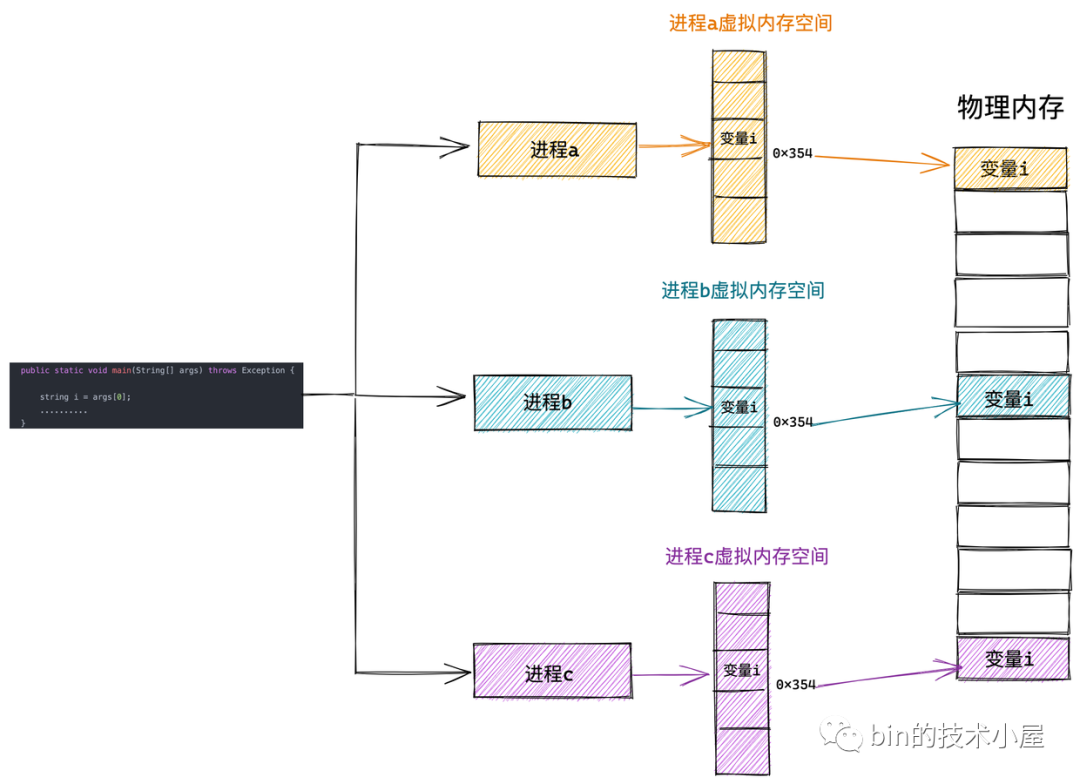
這裡筆者為大家舉一個簡單的例子來說明在多進程系統中直接使用物理記憶體地址的複雜性。
比如我們現在有這樣一個簡單的 Java 程式。
    public static void main(String[] args) throws Exception {

        string i = args[0];
        ..........
    }
在程式程式碼相同的情況下,我們用這份程式碼同時啟動三個 JVM 進程,我們暫時將進程依次命名為 a , b , c 。
這三個進程用到的程式碼是一樣的,都是我們提前寫好的,可以被多次運行。由於我們是直接操作物理記憶體地址,假設變數 i 保存在 0x354 這個物理地址上。這三個進程運行起來之後,同時操作這個 0x354 物理地址,這樣這個變數 i 的值不就混亂了嗎? 三個進程就會出現變數的地址衝突。
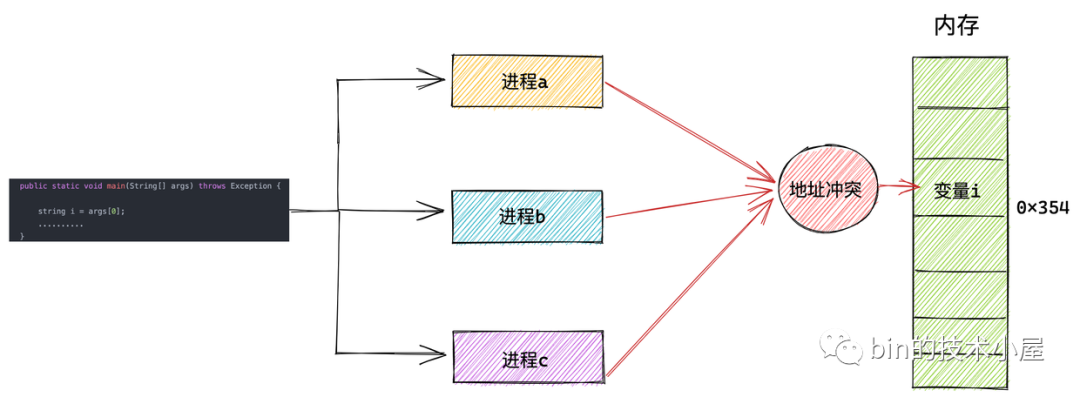
所以在直接操作物理記憶體的情況下,我們需要知道每一個變數的位置都被安排在了哪裡,而且還要注意和多個進程同時運行的時候,不能共用同一個地址,否則就會造成地址衝突。
現實中一個程式會有很多的變數和函數,這樣一來我們給它們都需要計算一個合理的位置,還不能與其他進程衝突,這就很複雜了。
那麼我們該如何解決這個問題呢?程式的局部性原理再一次救了我們~~
程式局部性原理表現為:時間局部性和空間局部性。時間局部性是指如果程式中的某條指令一旦執行,則不久之後該指令可能再次被執行;如果某塊數據被訪問,則不久之後該數據可能再次被訪問。空間局部性是指一旦程式訪問了某個存儲單元,則不久之後,其附近的存儲單元也將被訪問。
從程式局部性原理的描述中我們可以得出這樣一個結論:進程在運行之後,對於記憶體的訪問不會一下子就要訪問全部的記憶體,相反進程對於記憶體的訪問會表現出明顯的傾向性,更加傾向於訪問最近訪問過的數據以及熱點數據附近的數據。
根據這個結論我們就清楚了,無論一個進程實際可以佔用的記憶體資源有多大,根據程式局部性原理,在某一段時間內,進程真正需要的物理記憶體其實是很少的一部分,我們只需要為每個進程分配很少的物理記憶體就可以保證進程的正常執行運轉。
而虛擬記憶體的引入正是要解決上述的問題,虛擬記憶體引入之後,進程的視角就會變得非常開闊,每個進程都擁有自己獨立的虛擬地址空間,進程與進程之間的虛擬記憶體地址空間是相互隔離,互不干擾的。每個進程都認為自己獨佔所有記憶體空間,自己想幹什麼就幹什麼。
系統上還運行了哪些進程和我沒有任何關係。這樣一來我們就可以將多進程之間協同的相關複雜細節統統交給內核中的記憶體管理模組來處理,極大地解放了程式設計師的心智負擔。這一切都是因為虛擬記憶體能夠提供記憶體地址空間的隔離,極大地擴展了可用空間。
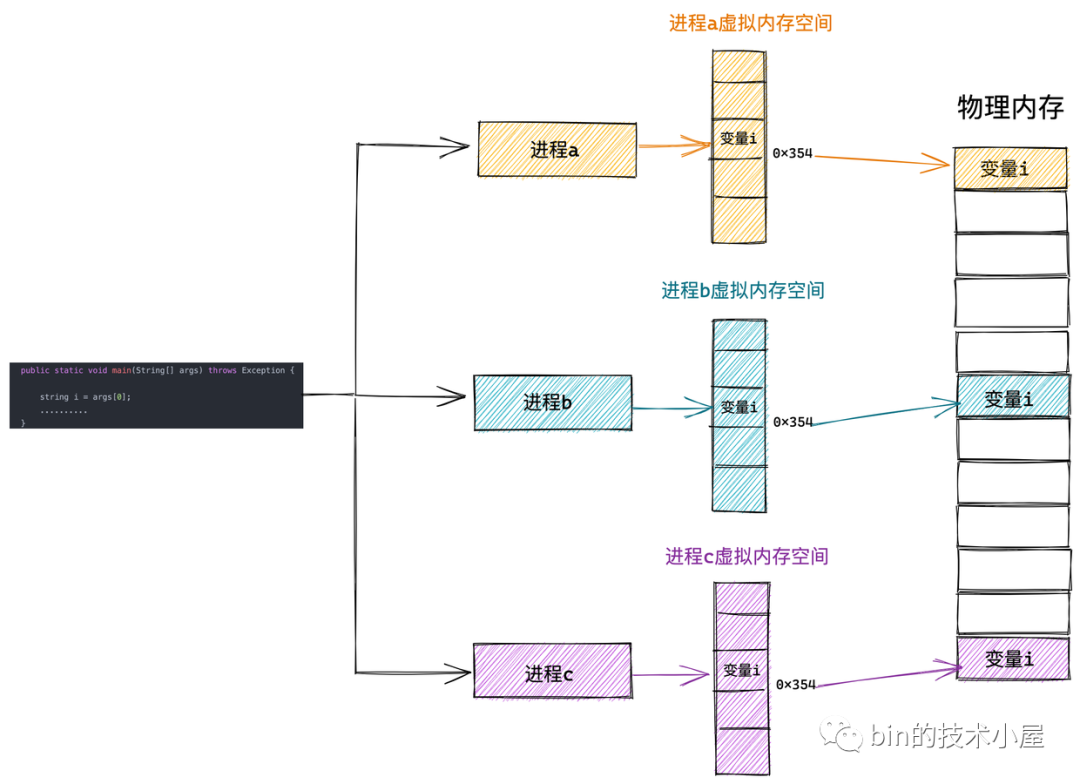
這樣進程就以為自己獨佔了整個記憶體空間資源,給進程產生了所有記憶體資源都屬於它自己的幻覺,這其實是 CPU 和作業系統使用的一個障眼法罷了,任何一個虛擬記憶體里所存儲的數據,本質上還是保存在真實的物理記憶體里的。只不過內核幫我們做了虛擬記憶體到物理記憶體的這一層映射,將不同進程的虛擬地址和不同記憶體的物理地址映射起來。
當 CPU 訪問進程的虛擬地址時,經過地址翻譯硬體將虛擬地址轉換成不同的物理地址,這樣不同的進程運行的時候,雖然操作的是同一虛擬地址,但其實背後寫入的是不同的物理地址,這樣就不會衝突了。
3. 進程虛擬記憶體空間
上小節中,我們介紹了為了防止多進程運行時造成的記憶體地址衝突,內核引入了虛擬記憶體地址,為每個進程提供了一個獨立的虛擬記憶體空間,使得進程以為自己獨佔全部記憶體資源。
那麼這個進程獨佔的虛擬記憶體空間到底是什麼樣子呢?在本小節中,筆者就為大家揭開這層神秘的面紗~~~
在本小節內容開始之前,我們先想像一下,如果我們是內核的設計人員,我們該從哪些方面來規划進程的虛擬記憶體空間呢?
本小節我們只討論進程用戶態虛擬記憶體空間的布局,我們先把內核態的虛擬記憶體空間當做一個黑盒來看待,在後面的小節中筆者再來詳細介紹內核態相關內容。
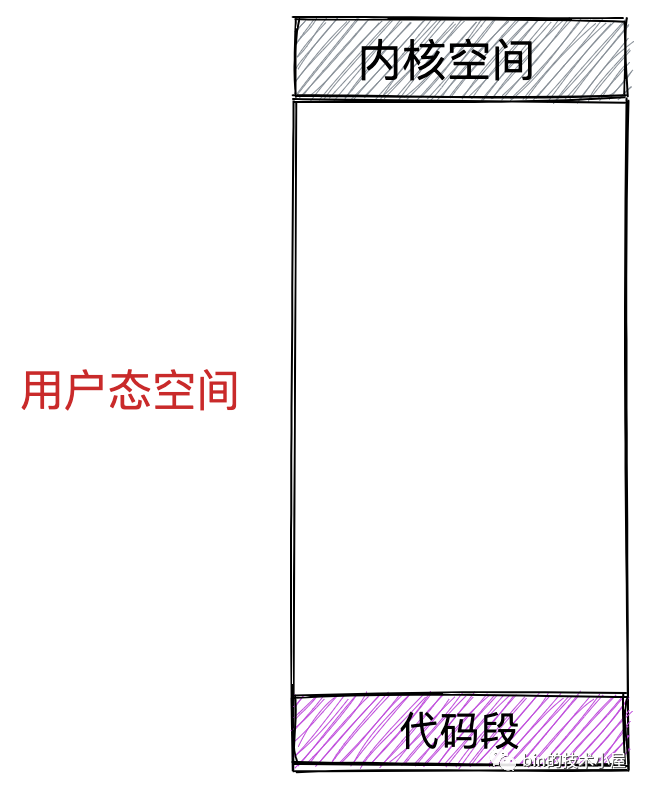
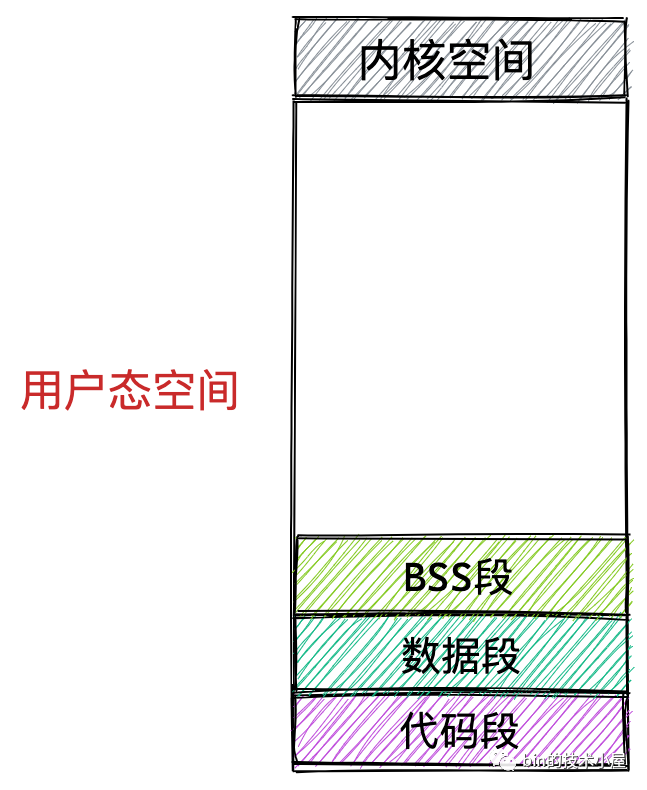
首先我們會想到的是一個進程運行起來是為了執行我們交代給進程的工作,執行這些工作的步驟我們通過程式程式碼事先編寫好,然後編譯成二進位文件存放在磁碟中,CPU 會執行二進位文件中的機器碼來驅動進程的運行。所以在進程運行之前,這些存放在二進位文件中的機器碼需要被載入進記憶體中,而用於存放這些機器碼的虛擬記憶體空間叫做程式碼段。
在程式運行起來之後,總要操作變數吧,在程式程式碼中我們通常會定義大量的全局變數和靜態變數,這些全局變數在程式編譯之後也會存儲在二進位文件中,在程式運行之前,這些全局變數也需要被載入進記憶體中供程式訪問。所以在虛擬記憶體空間中也需要一段區域來存儲這些全局變數。
-
那些在程式碼中被我們指定了初始值的全局變數和靜態變數在虛擬記憶體空間中的存儲區域我們叫做數據段。
-
那些沒有指定初始值的全局變數和靜態變數在虛擬記憶體空間中的存儲區域我們叫做 BSS 段。這些未初始化的全局變數被載入進記憶體之後會被初始化為 0 值。
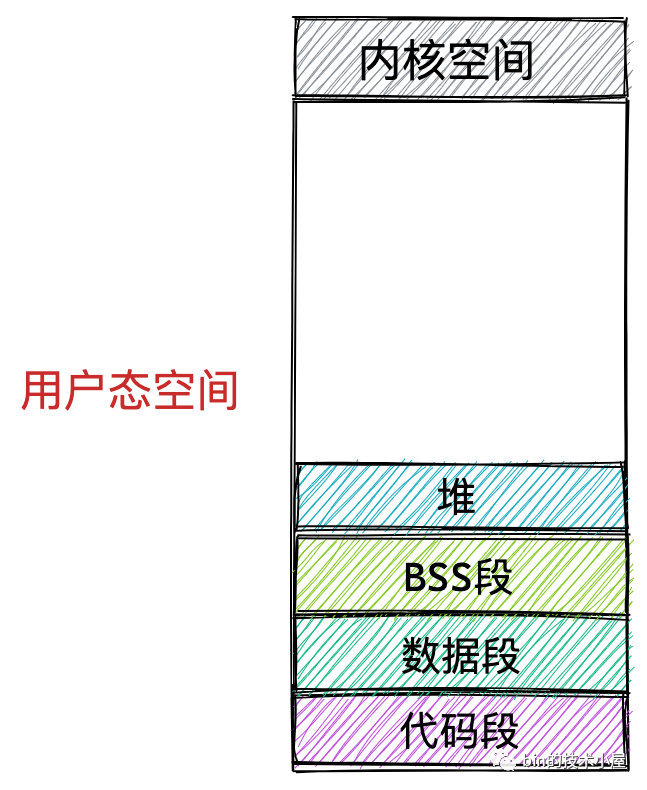
上面介紹的這些全局變數和靜態變數都是在編譯期間就確定的,但是我們程式在運行期間往往需要動態的申請記憶體,所以在虛擬記憶體空間中也需要一塊區域來存放這些動態申請的記憶體,這塊區域就叫做堆。注意這裡的堆指的是 OS 堆並不是 JVM 中的堆。
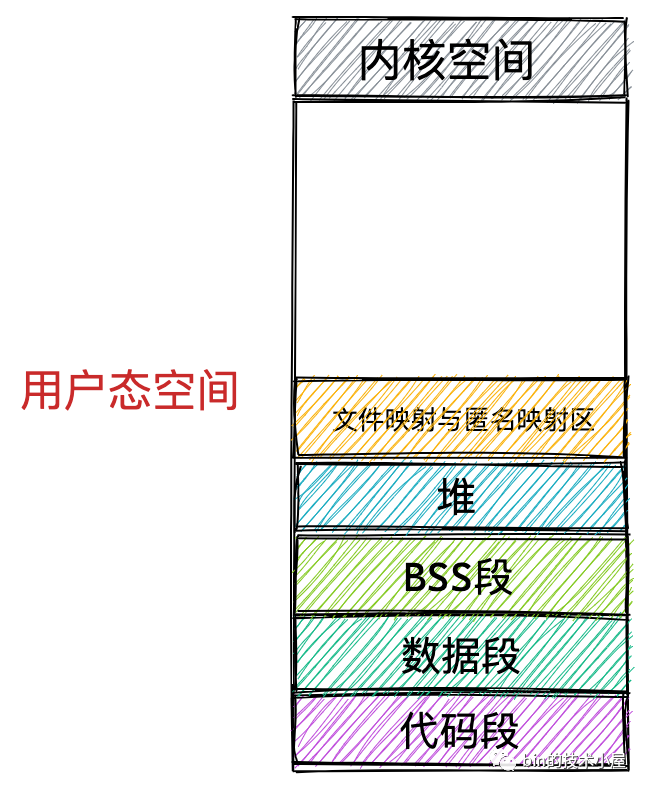
除此之外,我們的程式在運行過程中還需要依賴動態鏈接庫,這些動態鏈接庫以 .so 文件的形式存放在磁碟中,比如 C 程式中的 glibc,裡邊對系統調用進行了封裝。glibc 庫里提供的用於動態申請堆記憶體的 malloc 函數就是對系統調用 sbrk 和 mmap 的封裝。這些動態鏈接庫也有自己的對應的程式碼段,數據段,BSS 段,也需要一起被載入進記憶體中。
還有用於記憶體文件映射的系統調用 mmap,會將文件與記憶體進行映射,那麼映射的這塊記憶體(虛擬記憶體)也需要在虛擬地址空間中有一塊區域存儲。
這些動態鏈接庫中的程式碼段,數據段,BSS 段,以及通過 mmap 系統調用映射的共享記憶體區,在虛擬記憶體空間的存儲區域叫做文件映射與匿名映射區。
最後我們在程式運行的時候總該要調用各種函數吧,那麼調用函數過程中使用到的局部變數和函數參數也需要一塊記憶體區域來保存。這一塊區域在虛擬記憶體空間中叫做棧。
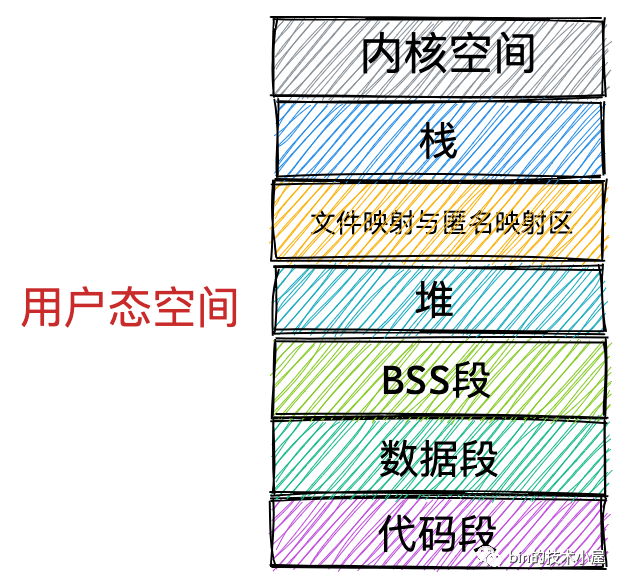
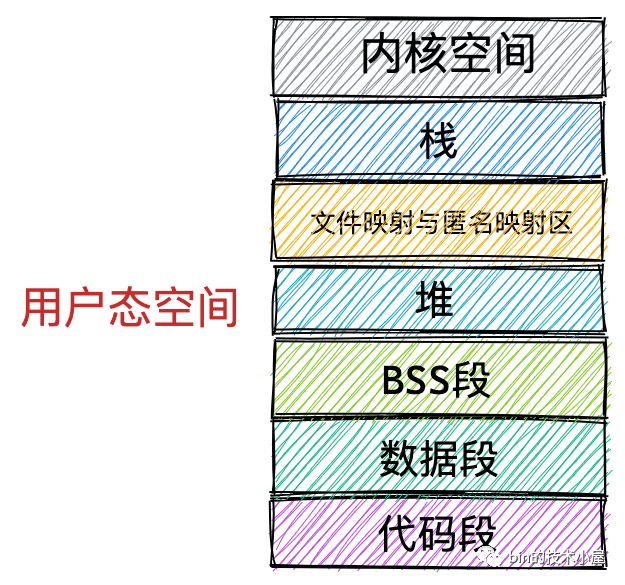
現在進程的虛擬記憶體空間所包含的主要區域,筆者就為大家介紹完了,我們看到內核根據進程運行的過程中所需要不同種類的數據而為其開闢了對應的地址空間。分別為:
-
用於存放進程程式二進位文件中的機器指令的程式碼段
-
用於存放程式二進位文件中定義的全局變數和靜態變數的數據段和 BSS 段。
-
用於在程式運行過程中動態申請記憶體的堆。
-
用於存放動態鏈接庫以及記憶體映射區域的文件映射與匿名映射區。
-
用於存放函數調用過程中的局部變數和函數參數的棧。
以上就是我們通過一個程式在運行過程中所需要的數據所規划出的虛擬記憶體空間的分布,這些只是一個大概的規劃,那麼在真實的 Linux 系統中,進程的虛擬記憶體空間的具體規劃又是如何的呢?我們接著往下看~~
4. Linux 進程虛擬記憶體空間
在上小節中我們介紹了進程虛擬記憶體空間中各個記憶體區域的一個大概分布,在此基礎之上,本小節筆者就帶大家分別從 32 位 和 64 位機器上看下在 Linux 系統中進程虛擬記憶體空間的真實分布情況。
4.1 32 位機器上進程虛擬記憶體空間分布
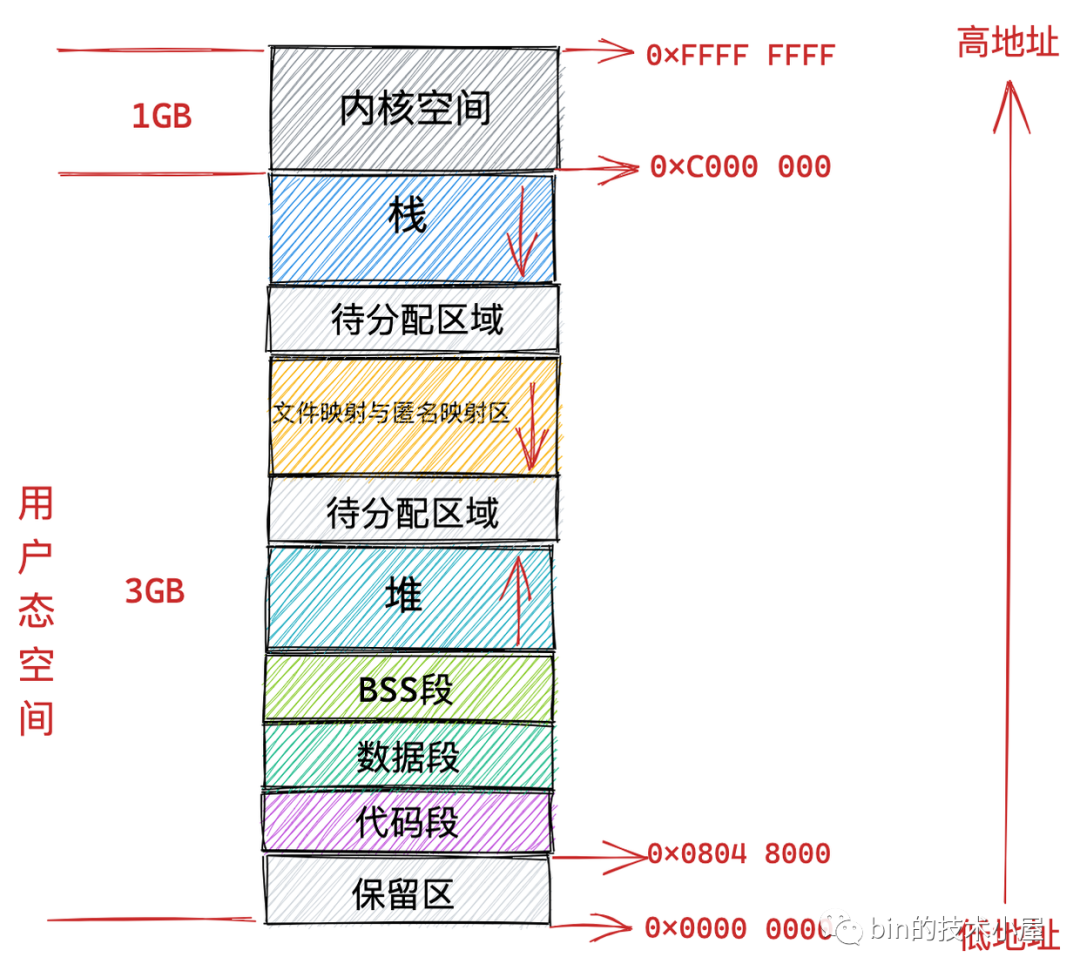
在 32 位機器上,指針的定址範圍為 2^32,所能表達的虛擬記憶體空間為 4 GB。所以在 32 位機器上進程的虛擬記憶體地址範圍為:0x0000 0000 - 0xFFFF FFFF。
其中用戶態虛擬記憶體空間為 3 GB,虛擬記憶體地址範圍為:0x0000 0000 - 0xC000 000 。
內核態虛擬記憶體空間為 1 GB,虛擬記憶體地址範圍為:0xC000 000 - 0xFFFF FFFF。
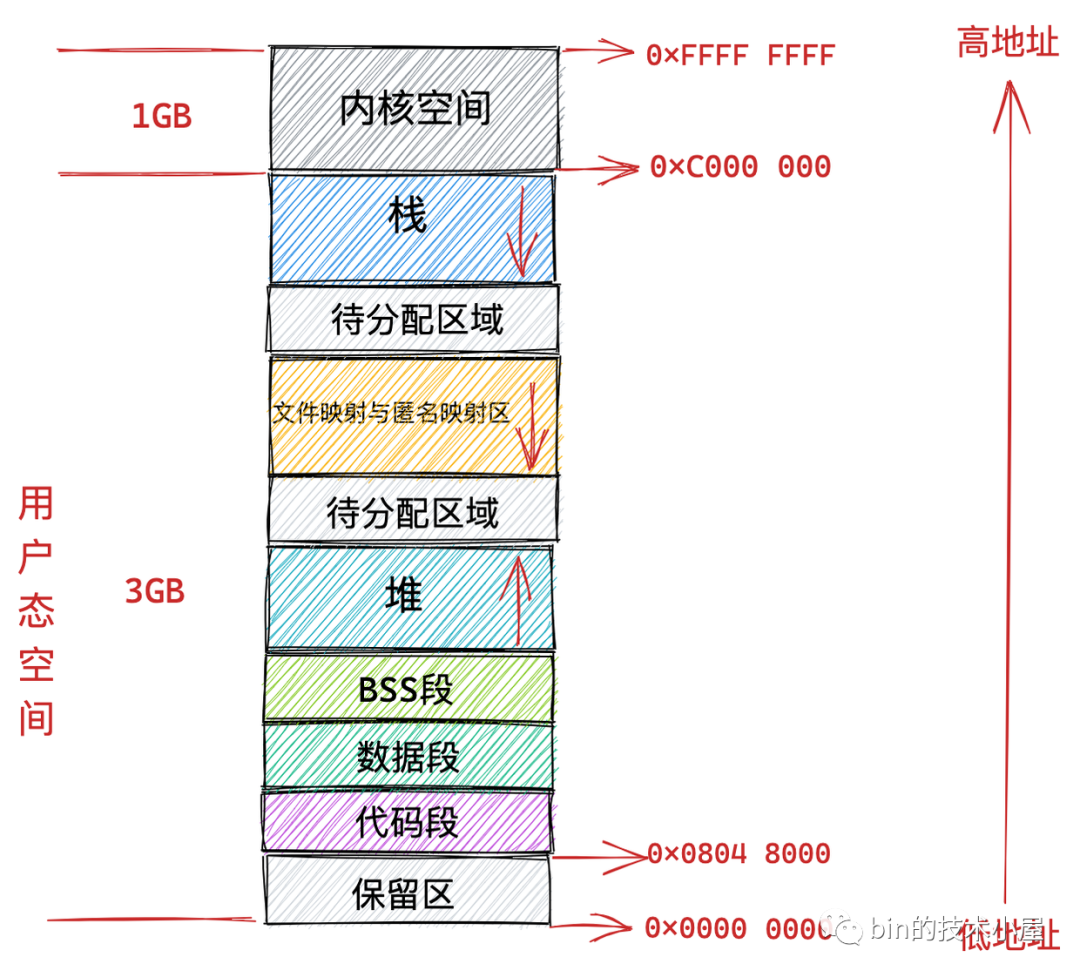
但是用戶態虛擬記憶體空間中的程式碼段並不是從 0x0000 0000 地址開始的,而是從 0x0804 8000 地址開始。
0x0000 0000 到 0x0804 8000 這段虛擬記憶體地址是一段不可訪問的保留區,因為在大多數作業系統中,數值比較小的地址通常被認為不是一個合法的地址,這塊小地址是不允許訪問的。比如在 C 語言中我們通常會將一些無效的指針設置為 NULL,指向這塊不允許訪問的地址。
保留區的上邊就是程式碼段和數據段,它們是從程式的二進位文件中直接載入進記憶體中的,BSS 段中的數據也存在於二進位文件中,因為內核知道這些數據是沒有初值的,所以在二進位文件中只會記錄 BSS 段的大小,在載入進記憶體時會生成一段 0 填充的記憶體空間。
緊挨著 BSS 段的上邊就是我們經常使用到的堆空間,從圖中的紅色箭頭我們可以知道在堆空間中地址的增長方向是從低地址到高地址增長。
內核中使用 start_brk 標識堆的起始位置,brk 標識堆當前的結束位置。當堆申請新的記憶體空間時,只需要將 brk 指針增加對應的大小,回收地址時減少對應的大小即可。比如當我們通過 malloc 向內核申請很小的一塊記憶體時(128K 之內),就是通過改變 brk 位置實現的。
堆空間的上邊是一段待分配區域,用於擴展堆空間的使用。接下來就來到了文件映射與匿名映射區域。進程運行時所依賴的動態鏈接庫中的程式碼段,數據段,BSS 段就載入在這裡。還有我們調用 mmap 映射出來的一段虛擬記憶體空間也保存在這個區域。注意:在文件映射與匿名映射區的地址增長方向是從高地址向低地址增長。
接下來用戶態虛擬記憶體空間的最後一塊區域就是棧空間了,在這裡會保存函數運行過程所需要的局部變數以及函數參數等函數調用資訊。棧空間中的地址增長方向是從高地址向低地址增長。每次進程申請新的棧地址時,其地址值是在減少的。
在內核中使用 start_stack 標識棧的起始位置,RSP 暫存器中保存棧頂指針 stack pointer,RBP 暫存器中保存的是棧基地址。
在棧空間的下邊也有一段待分配區域用於擴展棧空間,在棧空間的上邊就是內核空間了,進程雖然可以看到這段內核空間地址,但是就是不能訪問。這就好比我們在飯店裡雖然可以看到廚房在哪裡,但是廚房門上寫著 「廚房重地,閑人免進」 ,我們就是進不去。
4.2 64 位機器上進程虛擬記憶體空間分布
上小節中介紹的 32 位虛擬記憶體空間布局和本小節即將要介紹的 64 位虛擬記憶體空間布局都可以通過 cat /proc/pid/maps 或者 pmap pid 來查看某個進程的實際虛擬記憶體布局。
我們知道在 32 位機器上,指針的定址範圍為 2^32,所能表達的虛擬記憶體空間為 4 GB。
那麼我們理所應當的會認為在 64 位機器上,指針的定址範圍為 2^64,所能表達的虛擬記憶體空間為 16 EB 。虛擬記憶體地址範圍為:0x0000 0000 0000 0000 0000 - 0xFFFF FFFF FFFF FFFF 。
好傢夥 !!! 16 EB 的記憶體空間,筆者都沒見過這麼大的磁碟,在現實情況中根本不會用到這麼大範圍的記憶體空間,
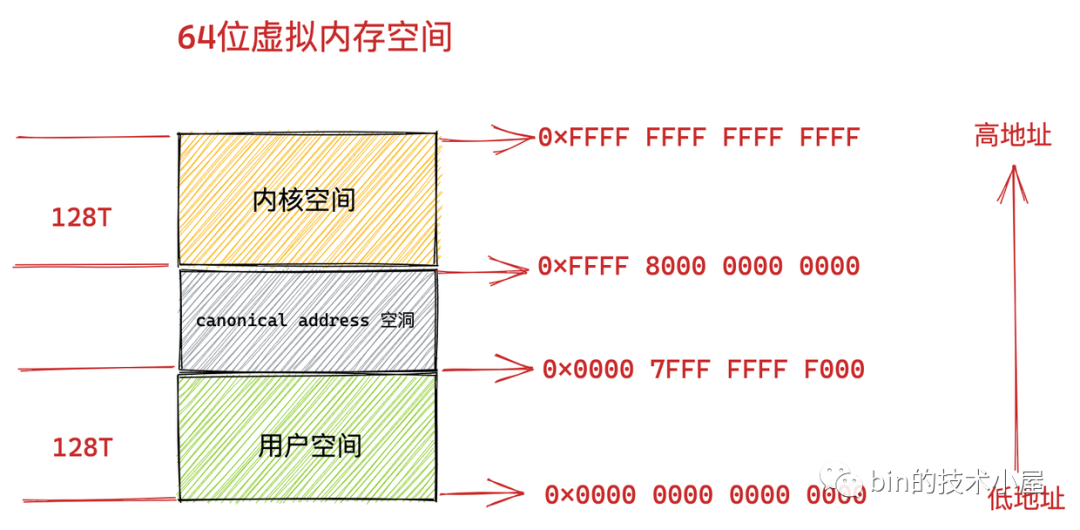
事實上在目前的 64 位系統下只使用了 48 位來描述虛擬記憶體空間,定址範圍為 2^48 ,所能表達的虛擬記憶體空間為 256TB。
其中低 128 T 表示用戶態虛擬記憶體空間,虛擬記憶體地址範圍為:0x0000 0000 0000 0000 - 0x0000 7FFF FFFF F000 。
高 128 T 表示內核態虛擬記憶體空間,虛擬記憶體地址範圍為:0xFFFF 8000 0000 0000 - 0xFFFF FFFF FFFF FFFF 。
這樣一來就在用戶態虛擬記憶體空間與內核態虛擬記憶體空間之間形成了一段 0x0000 7FFF FFFF F000 - 0xFFFF 8000 0000 0000 的地址空洞,我們把這個空洞叫做 canonical address 空洞。
那麼這個 canonical address 空洞是如何形成的呢?
我們都知道在 64 位機器上的指針定址範圍為 2^64,但是在實際使用中我們只使用了其中的低 48 位來表示虛擬記憶體地址,那麼這多出的高 16 位就形成了這個地址空洞。
大家注意到在低 128T 的用戶態地址空間:0x0000 0000 0000 0000 - 0x0000 7FFF FFFF F000 範圍中,所以虛擬記憶體地址的高 16 位全部為 0 。
如果一個虛擬記憶體地址的高 16 位全部為 0 ,那麼我們就可以直接判斷出這是一個用戶空間的虛擬記憶體地址。
同樣的道理,在高 128T 的內核態虛擬記憶體空間:0xFFFF 8000 0000 0000 - 0xFFFF FFFF FFFF FFFF 範圍中,所以虛擬記憶體地址的高 16 位全部為 1 。
也就是說內核態的虛擬記憶體地址的高 16 位全部為 1 ,如果一個試圖訪問內核的虛擬地址的高 16 位不全為 1 ,則可以快速判斷這個訪問是非法的。
這個高 16 位的空閑地址被稱為 canonical 。如果虛擬記憶體地址中的高 16 位全部為 0 (表示用戶空間虛擬記憶體地址)或者全部為 1 (表示內核空間虛擬記憶體地址),這種地址的形式我們叫做 canonical form,對應的地址我們稱作 canonical address 。
那麼處於 canonical address 空洞 :0x0000 7FFF FFFF F000 - 0xFFFF 8000 0000 0000 範圍內的地址的高 16 位 不全為 0 也不全為 1 。如果某個虛擬地址落在這段 canonical address 空洞區域中,那就是既不在用戶空間,也不在內核空間,肯定是非法訪問了。
未來我們也可以利用這塊 canonical address 空洞,來擴展虛擬記憶體地址的範圍,比如擴展到 56 位。
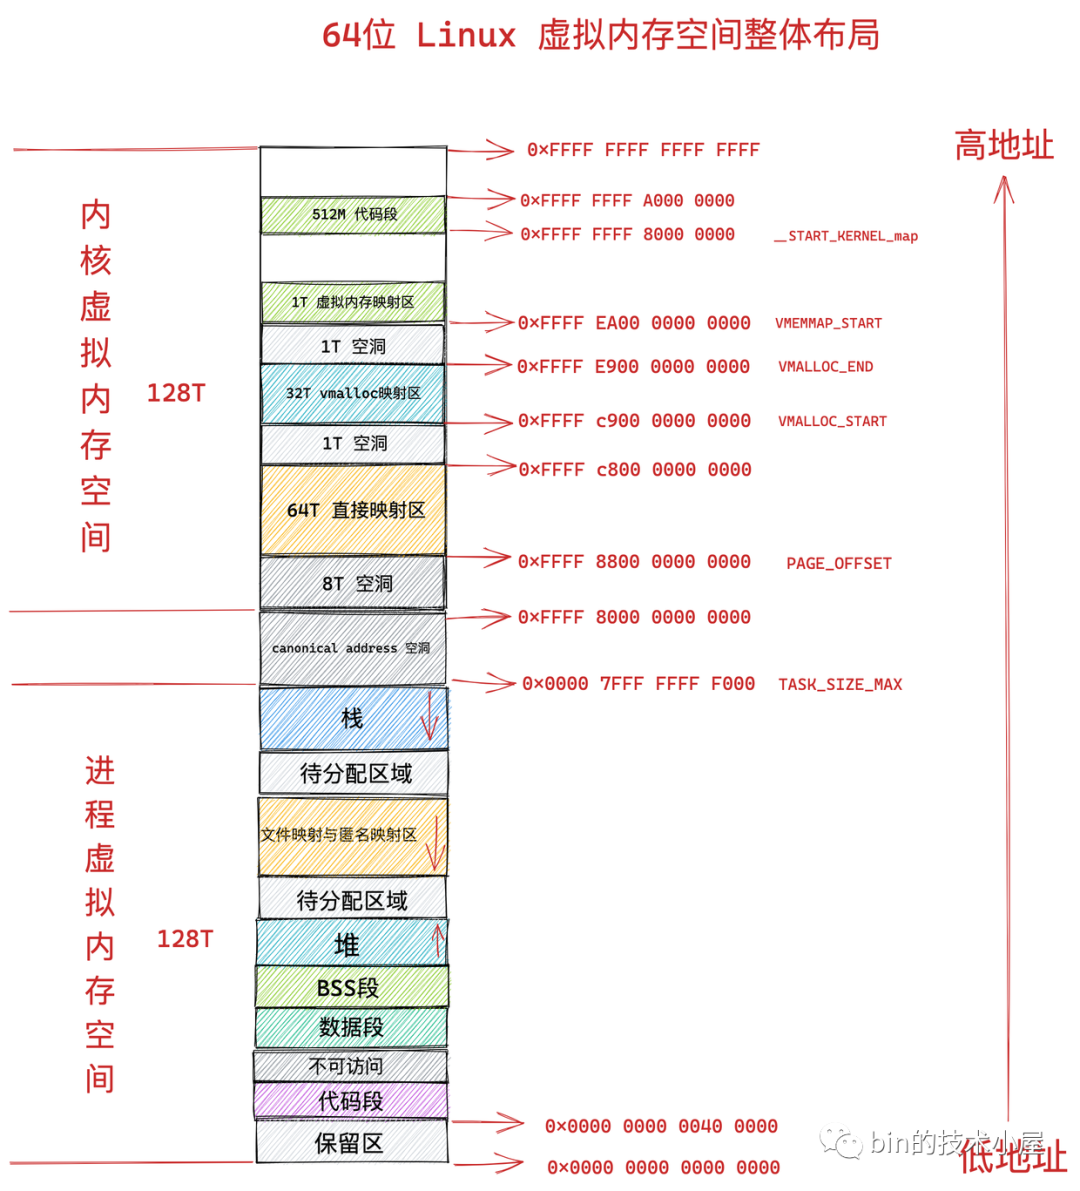
在我們理解了 canonical address 這個概念之後,我們再來看下 64 位 Linux 系統下的真實虛擬記憶體空間布局情況:
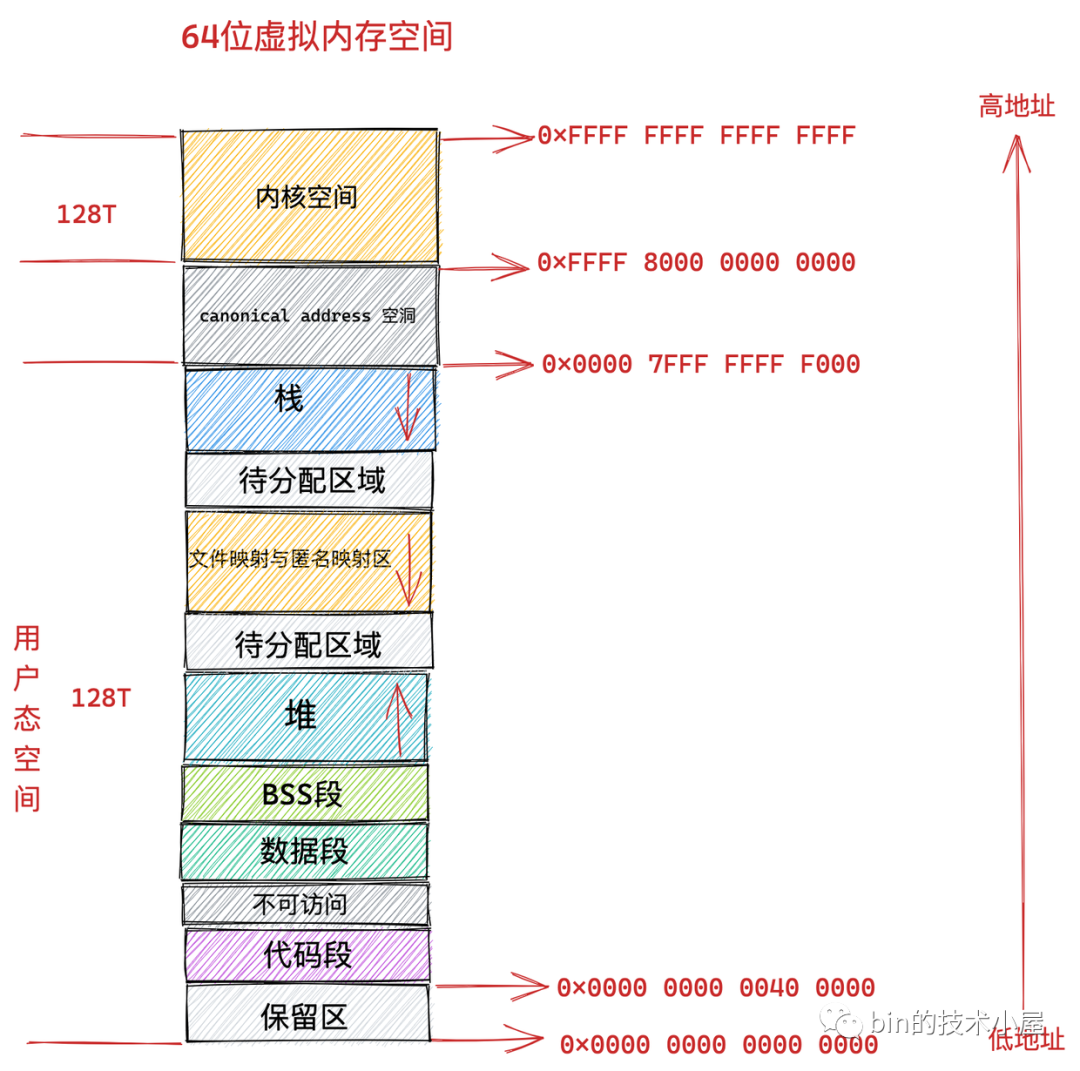
從上圖中我們可以看出 64 位系統中的虛擬記憶體布局和 32 位系統中的虛擬記憶體布局大體上是差不多的。主要不同的地方有三點:
-
就是前邊提到的由高 16 位空閑地址造成的 canonical address 空洞。在這段範圍內的虛擬記憶體地址是不合法的,因為它的高 16 位既不全為 0 也不全為 1,不是一個 canonical address,所以稱之為 canonical address 空洞。
-
在程式碼段跟數據段的中間還有一段不可以讀寫的保護段,它的作用是防止程式在讀寫數據段的時候越界訪問到程式碼段,這個保護段可以讓越界訪問行為直接崩潰,防止它繼續往下運行。
-
用戶態虛擬記憶體空間與內核態虛擬記憶體空間分別佔用 128T,其中低128T 分配給用戶態虛擬記憶體空間,高 128T 分配給內核態虛擬記憶體空間。
5. 進程虛擬記憶體空間的管理
在上一小節中,筆者為大家介紹了 Linux 作業系統在 32 位機器上和 64 位機器上進程虛擬記憶體空間的布局分布,我們發現無論是在 32 位機器上還是在 64 位機器上,進程虛擬記憶體空間的核心區域分布的相對位置是不變的,它們都包含下圖所示的這幾個核心記憶體區域。
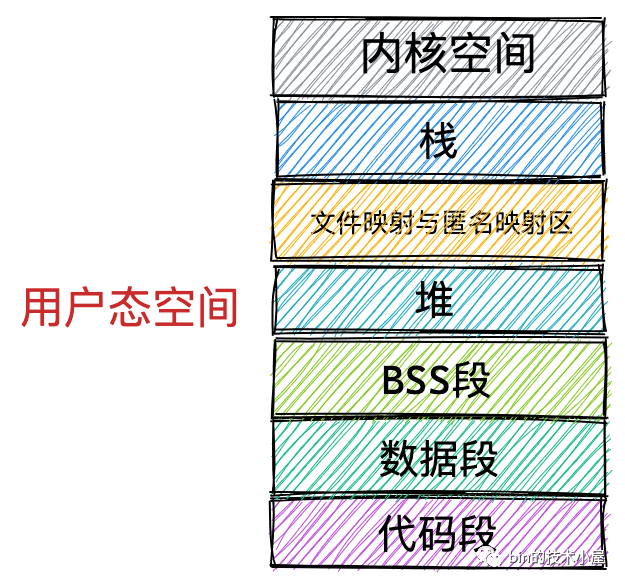
唯一不同的是這些核心記憶體區域在 32 位機器和 64 位機器上的絕對位置分布會有所不同。
那麼在此基礎之上,內核如何為進程管理這些虛擬記憶體區域呢?這將是本小節重點為大家介紹的內容~~
既然我們要介紹進程的虛擬記憶體空間管理,那就離不開進程在內核中的描述符 task_struct 結構。
struct task_struct {
        // 進程id
	    pid_t				pid;
        // 用於標識執行緒所屬的進程 pid
	    pid_t				tgid;
        // 進程打開的文件資訊
        struct files_struct		*files;
        // 記憶體描述符表示進程虛擬地址空間
        struct mm_struct		*mm;

        .......... 省略 .......
}
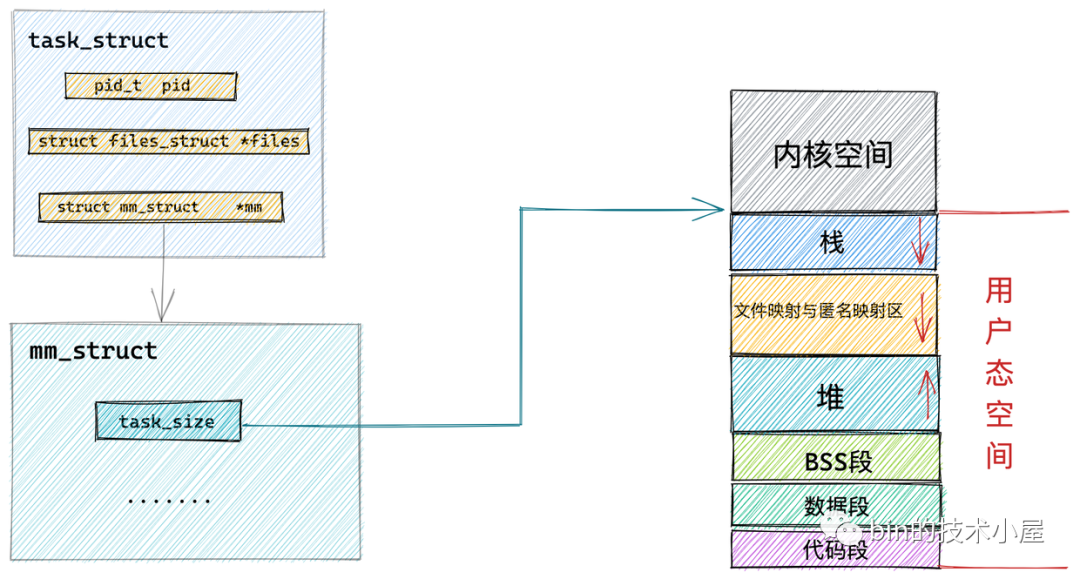
在進程描述符 task_struct 結構中,有一個專門描述進程虛擬地址空間的記憶體描述符 mm_struct 結構,這個結構體中包含了前邊幾個小節中介紹的進程虛擬記憶體空間的全部資訊。
每個進程都有唯一的 mm_struct 結構體,也就是前邊提到的每個進程的虛擬地址空間都是獨立,互不干擾的。
當我們調用 fork() 函數創建進程的時候,表示進程地址空間的 mm_struct 結構會隨著進程描述符 task_struct 的創建而創建。
long _do_fork(unsigned long clone_flags,
	      unsigned long stack_start,
	      unsigned long stack_size,
	      int __user *parent_tidptr,
	      int __user *child_tidptr,
	      unsigned long tls)
{
        ......... 省略 ..........
	struct pid *pid;
	struct task_struct *p;

        ......... 省略 ..........
    // 為進程創建 task_struct 結構,用父進程的資源填充 task_struct 資訊
	p = copy_process(clone_flags, stack_start, stack_size,
			 child_tidptr, NULL, trace, tls, NUMA_NO_NODE);

         ......... 省略 ..........
}
隨後會在 copy_process 函數中創建 task_struct 結構,並拷貝父進程的相關資源到新進程的 task_struct 結構里,其中就包括拷貝父進程的虛擬記憶體空間 mm_struct 結構。這裡可以看出子進程在新創建出來之後它的虛擬記憶體空間是和父進程的虛擬記憶體空間一模一樣的,直接拷貝過來。
static __latent_entropy struct task_struct *copy_process(
					unsigned long clone_flags,
					unsigned long stack_start,
					unsigned long stack_size,
					int __user *child_tidptr,
					struct pid *pid,
					int trace,
					unsigned long tls,
					int node)
{

    struct task_struct *p;
    // 創建 task_struct 結構
    p = dup_task_struct(current, node);

        ....... 初始化子進程 ...........

        ....... 開始繼承拷貝父進程資源  .......
    // 繼承父進程打開的文件描述符
	retval = copy_files(clone_flags, p);
    // 繼承父進程所屬的文件系統
	retval = copy_fs(clone_flags, p);
    // 繼承父進程註冊的訊號以及訊號處理函數
	retval = copy_sighand(clone_flags, p);
	retval = copy_signal(clone_flags, p);
    // 繼承父進程的虛擬記憶體空間
	retval = copy_mm(clone_flags, p);
    // 繼承父進程的 namespaces
	retval = copy_namespaces(clone_flags, p);
    // 繼承父進程的 IO 資訊
	retval = copy_io(clone_flags, p);

      ...........省略.........
    // 分配 CPU
    retval = sched_fork(clone_flags, p);
    // 分配 pid
    pid = alloc_pid(p->nsproxy->pid_ns_for_children);

.     ..........省略.........
}
這裡我們重點關注 copy_mm 函數,正是在這裡完成了子進程虛擬記憶體空間 mm_struct 結構的的創建以及初始化。
static int copy_mm(unsigned long clone_flags, struct task_struct *tsk)
{
    // 子進程虛擬記憶體空間,父進程虛擬記憶體空間
	struct mm_struct *mm, *oldmm;
	int retval;

        ...... 省略 ......

	tsk->mm = NULL;
	tsk->active_mm = NULL;
    // 獲取父進程虛擬記憶體空間
	oldmm = current->mm;
	if (!oldmm)
		return 0;

        ...... 省略 ......
    // 通過 vfork 或者 clone 系統調用創建出的子進程(執行緒)和父進程共享虛擬記憶體空間
	if (clone_flags & CLONE_VM) {
        // 增加父進程虛擬地址空間的引用計數
		mmget(oldmm);
        // 直接將父進程的虛擬記憶體空間賦值給子進程(執行緒)
        // 執行緒共享其所屬進程的虛擬記憶體空間
		mm = oldmm;
		goto good_mm;
	}

	retval = -ENOMEM;
    // 如果是 fork 系統調用創建出的子進程,則將父進程的虛擬記憶體空間以及相關頁表拷貝到子進程中的 mm_struct 結構中。
	mm = dup_mm(tsk);
	if (!mm)
		goto fail_nomem;

good_mm:
    // 將拷貝出來的父進程虛擬記憶體空間 mm_struct 賦值給子進程
	tsk->mm = mm;
	tsk->active_mm = mm;
	return 0;

        ...... 省略 ......
由於本小節中我們舉的示例是通過 fork() 函數創建子進程的情形,所以這裡大家先佔時忽略 if (clone_flags & CLONE_VM) 這個條件判斷邏輯,我們先跳過往後看~~
copy_mm 函數首先會將父進程的虛擬記憶體空間 current->mm 賦值給指針 oldmm。然後通過 dup_mm 函數將父進程的虛擬記憶體空間以及相關頁表拷貝到子進程的 mm_struct 結構中。最後將拷貝出來的 mm_struct 賦值給子進程的 task_struct 結構。
通過 fork() 函數創建出的子進程,它的虛擬記憶體空間以及相關頁表相當於父進程虛擬記憶體空間的一份拷貝,直接從父進程中拷貝到子進程中。
而當我們通過 vfork 或者 clone 系統調用創建出的子進程,首先會設置 CLONE_VM 標識,這樣來到 copy_mm 函數中就會進入 if (clone_flags & CLONE_VM) 條件中,在這個分支中會將父進程的虛擬記憶體空間以及相關頁表直接賦值給子進程。這樣一來父進程和子進程的虛擬記憶體空間就變成共享的了。也就是說父子進程之間使用的虛擬記憶體空間是一樣的,並不是一份拷貝。
子進程共享了父進程的虛擬記憶體空間,這樣子進程就變成了我們熟悉的執行緒,是否共享地址空間幾乎是進程和執行緒之間的本質區別。Linux 內核並不區別對待它們,執行緒對於內核來說僅僅是一個共享特定資源的進程而已。
內核執行緒和用戶態執行緒的區別就是內核執行緒沒有相關的記憶體描述符 mm_struct ,內核執行緒對應的 task_struct 結構中的 mm 域指向 Null,所以內核執行緒之間調度是不涉及地址空間切換的。
當一個內核執行緒被調度時,它會發現自己的虛擬地址空間為 Null,雖然它不會訪問用戶態的記憶體,但是它會訪問內核記憶體,聰明的內核會將調度之前的上一個用戶態進程的虛擬記憶體空間 mm_struct 直接賦值給內核執行緒,因為內核執行緒不會訪問用戶空間的記憶體,它僅僅只會訪問內核空間的記憶體,所以直接復用上一個用戶態進程的虛擬地址空間就可以避免為內核執行緒分配 mm_struct 和相關頁表的開銷,以及避免內核執行緒之間調度時地址空間的切換開銷。
父進程與子進程的區別,進程與執行緒的區別,以及內核執行緒與用戶態執行緒的區別其實都是圍繞著這個 mm_struct 展開的。
現在我們知道了表示進程虛擬記憶體空間的 mm_struct 結構是如何被創建出來的相關背景,那麼接下來筆者就帶大家深入 mm_struct 結構內部,來看一下內核如何通過這麼一個 mm_struct 結構體來管理進程的虛擬記憶體空間的。
5.1 內核如何劃分用戶態和內核態虛擬記憶體空間
通過 《3. 進程虛擬記憶體空間》小節的介紹我們知道,進程的虛擬記憶體空間分為兩個部分:一部分是用戶態虛擬記憶體空間,另一部分是內核態虛擬記憶體空間。
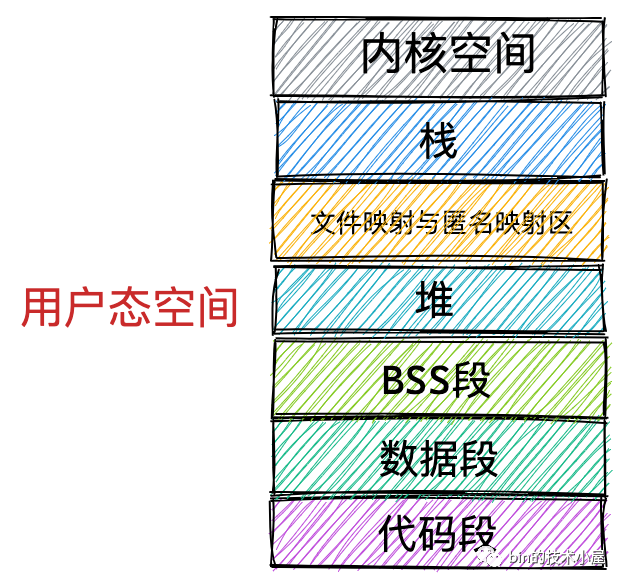
那麼用戶態的地址空間和內核態的地址空間在內核中是如何被劃分的呢?
這就用到了進程的記憶體描述符 mm_struct 結構體中的 task_size 變數,task_size 定義了用戶態地址空間與內核態地址空間之間的分界線。
struct mm_struct {
    unsigned long task_size;	/* size of task vm space */
}
通過前邊小節的內容介紹,我們知道在 32 位系統中用戶態虛擬記憶體空間為 3 GB,虛擬記憶體地址範圍為:0x0000 0000 - 0xC000 000 。
內核態虛擬記憶體空間為 1 GB,虛擬記憶體地址範圍為:0xC000 000 - 0xFFFF FFFF。
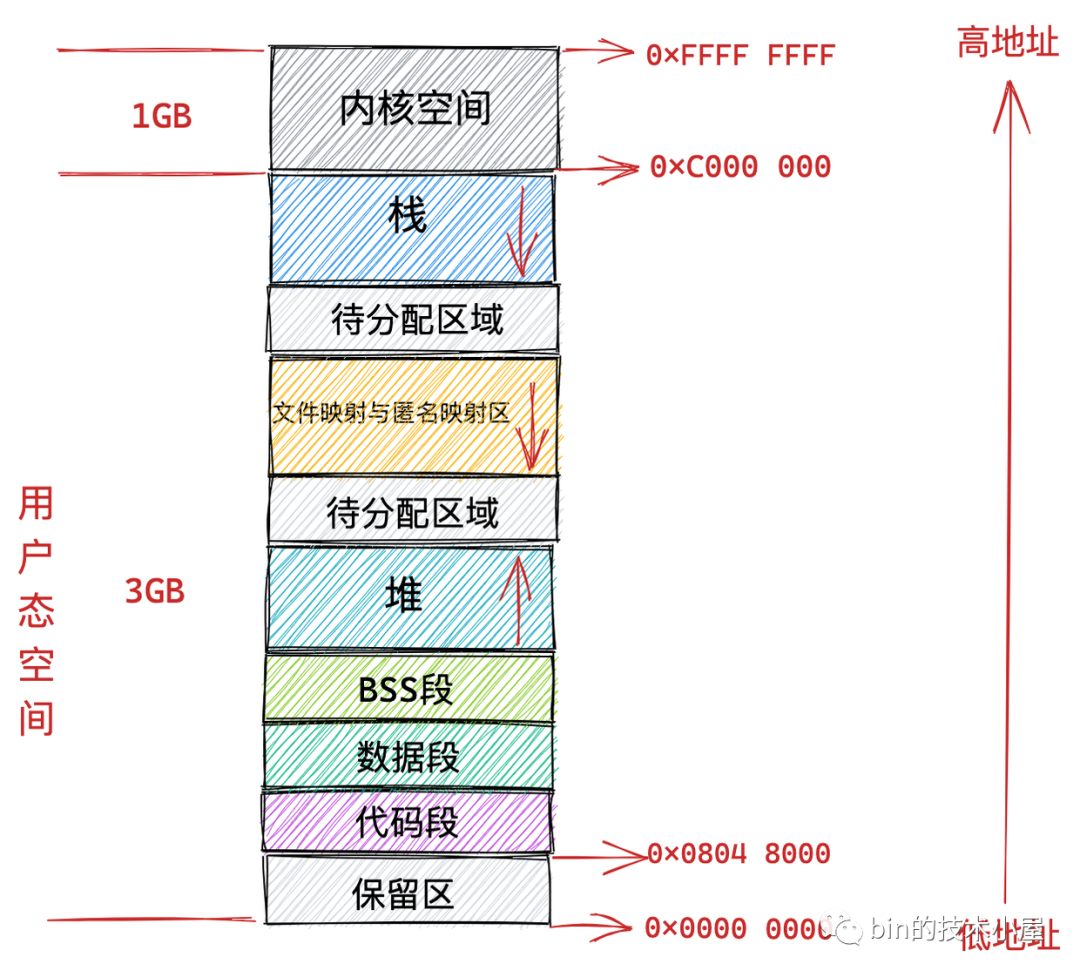
32 位系統中用戶地址空間和內核地址空間的分界線在 0xC000 000 地址處,那麼自然進程的 mm_struct 結構中的 task_size 為 0xC000 000。
我們來看下內核在 /arch/x86/include/asm/page_32_types.h 文件中關於 TASK_SIZE 的定義。
/*
 * User space process size: 3GB (default).
 */
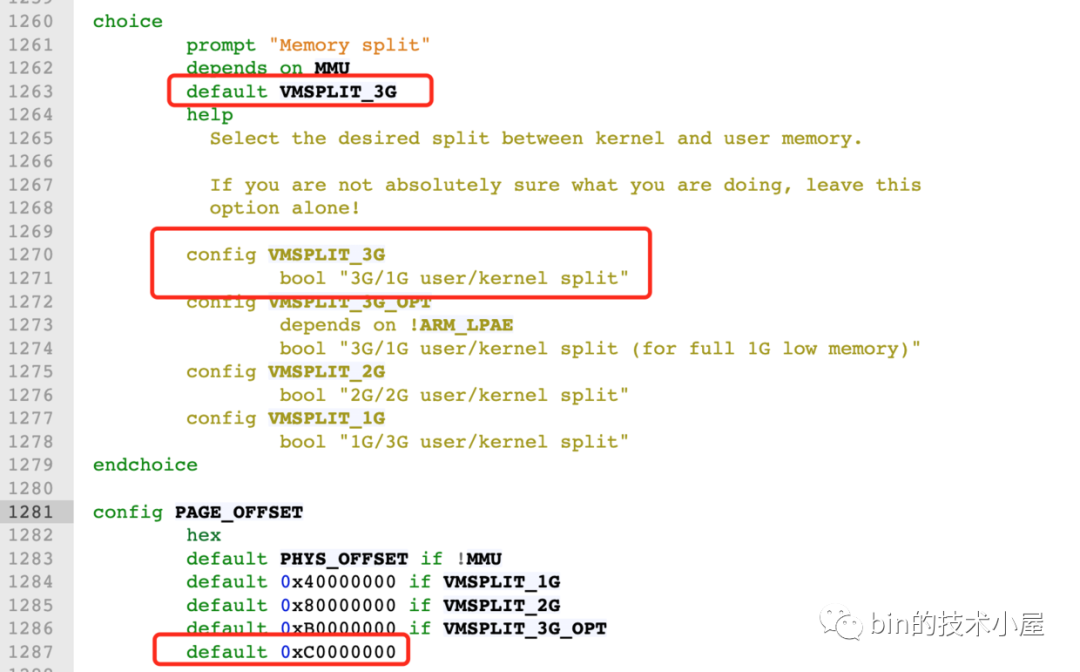
#define TASK_SIZE		__PAGE_OFFSET
如下圖所示:__PAGE_OFFSET 的值在 32 位系統下為 0xC000 000。
而在 64 位系統中,只使用了其中的低 48 位來表示虛擬記憶體地址。其中用戶態虛擬記憶體空間為低 128 T,虛擬記憶體地址範圍為:0x0000 0000 0000 0000 - 0x0000 7FFF FFFF F000 。
內核態虛擬記憶體空間為高 128 T,虛擬記憶體地址範圍為:0xFFFF 8000 0000 0000 - 0xFFFF FFFF FFFF FFFF 。

64 位系統中用戶地址空間和內核地址空間的分界線在 0x0000 7FFF FFFF F000 地址處,那麼自然進程的 mm_struct 結構中的 task_size 為 0x0000 7FFF FFFF F000 。
我們來看下內核在 /arch/x86/include/asm/page_64_types.h 文件中關於 TASK_SIZE 的定義。
#define TASK_SIZE		(test_thread_flag(TIF_ADDR32) ? \
					IA32_PAGE_OFFSET : TASK_SIZE_MAX)

#define TASK_SIZE_MAX		task_size_max()

#define task_size_max()		((_AC(1,UL) << __VIRTUAL_MASK_SHIFT) - PAGE_SIZE)

#define __VIRTUAL_MASK_SHIFT	47
我們來看下在 64 位系統中內核如何來計算 TASK_SIZE,在 task_size_max() 的計算邏輯中 1 左移 47 位得到的地址是 0x0000800000000000,然後減去一個 PAGE_SIZE (默認為 4K),就是 0x00007FFFFFFFF000,共 128T。所以在 64 位系統中的 TASK_SIZE 為 0x00007FFFFFFFF000 。
這裡我們可以看出,64 位虛擬記憶體空間的布局是和物理記憶體頁 page 的大小有關的,物理記憶體頁 page 默認大小 PAGE_SIZE 為 4K。
PAGE_SIZE 定義在 /arch/x86/include/asm/page_types.h文件中:
/* PAGE_SHIFT determines the page size */
#define PAGE_SHIFT		12
#define PAGE_SIZE		(_AC(1,UL) << PAGE_SHIFT)
而內核空間的起始地址是 0xFFFF 8000 0000 0000 。在 0x00007FFFFFFFF000 - 0xFFFF 8000 0000 0000 之間的記憶體區域就是我們在 《4.2 64 位機器上進程虛擬記憶體空間分布》小節中介紹的 canonical address 空洞。
5.2 內核如何布局進程虛擬記憶體空間
在我們理解了內核是如何劃分進程虛擬記憶體空間和內核虛擬記憶體空間之後,那麼在 《3. 進程虛擬記憶體空間》小節中介紹的那些虛擬記憶體區域在內核中又是如何劃分的呢?
接下來筆者就為大家介紹下內核是如何劃分進程虛擬記憶體空間中的這些記憶體區域的,本小節的示例圖中,筆者只保留了進程虛擬記憶體空間中的核心區域,方便大家理解。
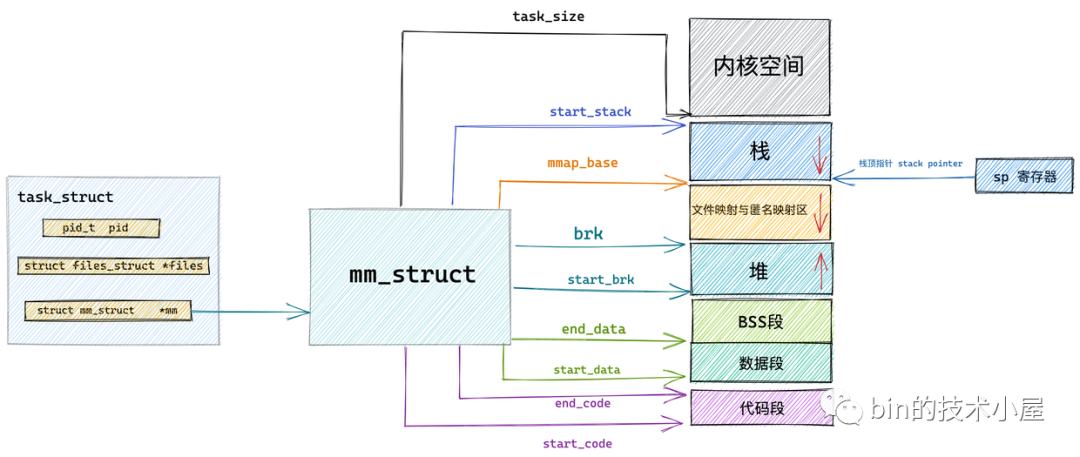
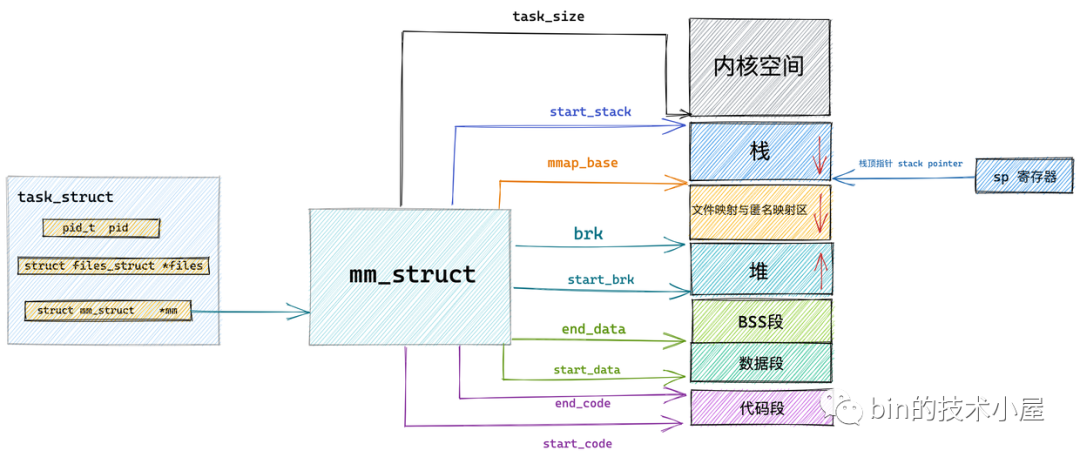
前邊我們提到,內核中採用了一個叫做記憶體描述符的 mm_struct 結構體來表示進程虛擬記憶體空間的全部資訊。在本小節中筆者就帶大家到 mm_struct 結構體內部去尋找下相關的線索。
struct mm_struct {
    unsigned long task_size;    /* size of task vm space */
    unsigned long start_code, end_code, start_data, end_data;
    unsigned long start_brk, brk, start_stack;
    unsigned long arg_start, arg_end, env_start, env_end;
    unsigned long mmap_base;  /* base of mmap area */
    unsigned long total_vm;    /* Total pages mapped */
    unsigned long locked_vm;  /* Pages that have PG_mlocked set */
    unsigned long pinned_vm;  /* Refcount permanently increased */
    unsigned long data_vm;    /* VM_WRITE & ~VM_SHARED & ~VM_STACK */
    unsigned long exec_vm;    /* VM_EXEC & ~VM_WRITE & ~VM_STACK */
    unsigned long stack_vm;    /* VM_STACK */

       ...... 省略 ........
}
內核中用 mm_struct 結構體中的上述屬性來定義上圖中虛擬記憶體空間里的不同記憶體區域。
start_code 和 end_code 定義程式碼段的起始和結束位置,程式編譯後的二進位文件中的機器碼被載入進記憶體之後就存放在這裡。
start_data 和 end_data 定義數據段的起始和結束位置,二進位文件中存放的全局變數和靜態變數被載入進記憶體中就存放在這裡。
後面緊挨著的是 BSS 段,用於存放未被初始化的全局變數和靜態變數,這些變數在載入進記憶體時會生成一段 0 填充的記憶體區域 (BSS 段), BSS 段的大小是固定的,
下面就是 OS 堆了,在堆中記憶體地址的增長方向是由低地址向高地址增長, start_brk 定義堆的起始位置,brk 定義堆當前的結束位置。
我們使用 malloc 申請小塊記憶體時(低於 128K),就是通過改變 brk 位置調整堆大小實現的。
接下來就是記憶體映射區,在記憶體映射區記憶體地址的增長方向是由高地址向低地址增長,mmap_base 定義記憶體映射區的起始地址。進程運行時所依賴的動態鏈接庫中的程式碼段,數據段,BSS 段以及我們調用 mmap 映射出來的一段虛擬記憶體空間就保存在這個區域。
start_stack 是棧的起始位置在 RBP 暫存器中存儲,棧的結束位置也就是棧頂指針 stack pointer 在 RSP 暫存器中存儲。在棧中記憶體地址的增長方向也是由高地址向低地址增長。
arg_start 和 arg_end 是參數列表的位置, env_start 和 env_end 是環境變數的位置。它們都位於棧中的最高地址處。
在 mm_struct 結構體中除了上述用於劃分虛擬記憶體區域的變數之外,還定義了一些虛擬記憶體與物理記憶體映射內容相關的統計變數,作業系統會把物理記憶體劃分成一頁一頁的區域來進行管理,所以物理記憶體到虛擬記憶體之間的映射也是按照頁為單位進行的。這部分內容筆者會在後續的文章中詳細介紹,大家這裡只需要有個概念就行。
mm_struct 結構體中的 total_vm 表示在進程虛擬記憶體空間中總共與物理記憶體映射的頁的總數。
注意映射這個概念,它表示只是將虛擬記憶體與物理記憶體建立關聯關係,並不代表真正的分配物理記憶體。
當記憶體吃緊的時候,有些頁可以換出到硬碟上,而有些頁因為比較重要,不能換出。locked_vm 就是被鎖定不能換出的記憶體頁總數,pinned_vm 表示既不能換出,也不能移動的記憶體頁總數。
data_vm 表示數據段中映射的記憶體頁數目,exec_vm 是程式碼段中存放可執行文件的記憶體頁數目,stack_vm 是棧中所映射的記憶體頁數目,這些變數均是表示進程虛擬記憶體空間中的虛擬記憶體使用情況。
現在關於內核如何對進程虛擬記憶體空間進行布局的內容我們已經清楚了,那麼布局之後劃分出的這些虛擬記憶體區域在內核中又是如何被管理的呢?我們接著往下看~~~
5.3 內核如何管理虛擬記憶體區域
在上小節的介紹中,我們知道內核是通過一個 mm_struct 結構的記憶體描述符來表示進程的虛擬記憶體空間的,並通過 task_size 域來劃分用戶態虛擬記憶體空間和內核態虛擬記憶體空間。
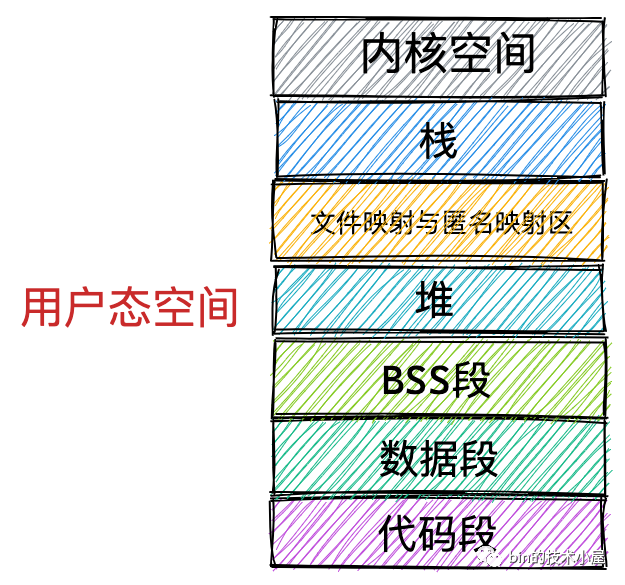
而在劃分出的這些虛擬記憶體空間中如上圖所示,裡邊又包含了許多特定的虛擬記憶體區域,比如:程式碼段,數據段,堆,記憶體映射區,棧。那麼這些虛擬記憶體區域在內核中又是如何表示的呢?
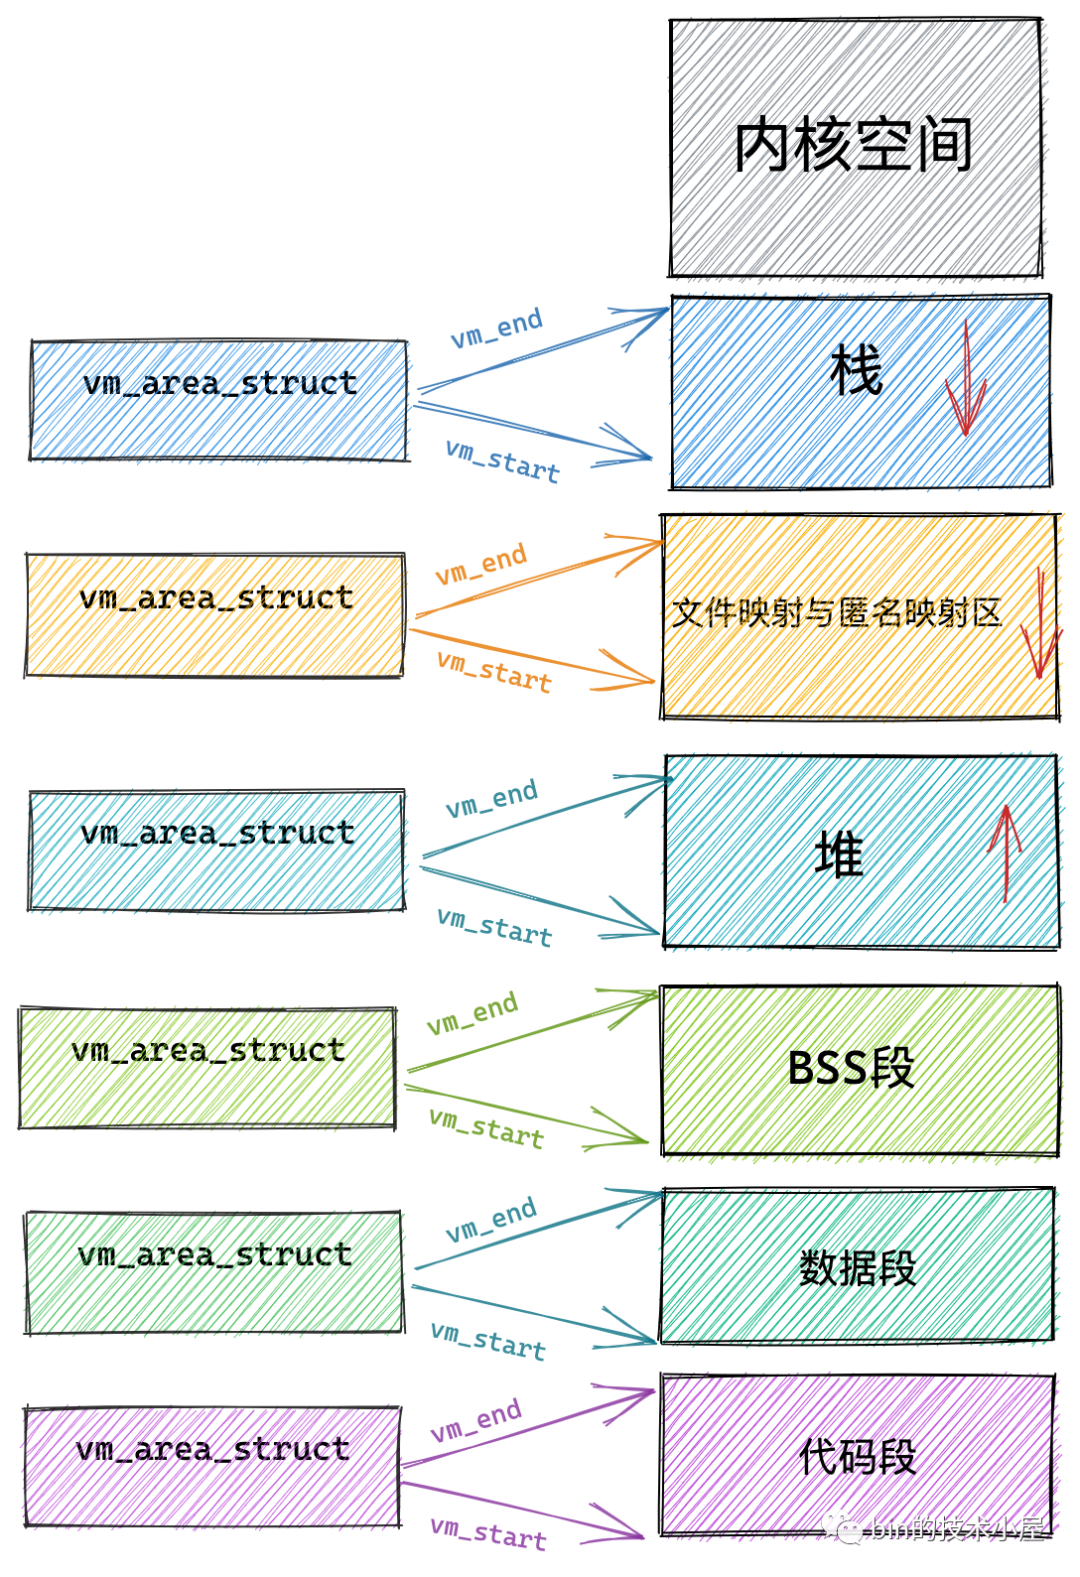
本小節中,筆者將為大家介紹一個新的結構體 vm_area_struct,正是這個結構體描述了這些虛擬記憶體區域 VMA(virtual memory area)。
struct vm_area_struct {

	unsigned long vm_start;		/* Our start address within vm_mm. */
	unsigned long vm_end;		/* The first byte after our end address
					   within vm_mm. */
	/*
	 * Access permissions of this VMA.
	 */
	pgprot_t vm_page_prot;
	unsigned long vm_flags;

	struct anon_vma *anon_vma;	/* Serialized by page_table_lock */
    struct file * vm_file;		/* File we map to (can be NULL). */
	unsigned long vm_pgoff;		/* Offset (within vm_file) in PAGE_SIZE
					   units */
	void * vm_private_data;		/* was vm_pte (shared mem) */
	/* Function pointers to deal with this struct. */
	const struct vm_operations_struct *vm_ops;
}
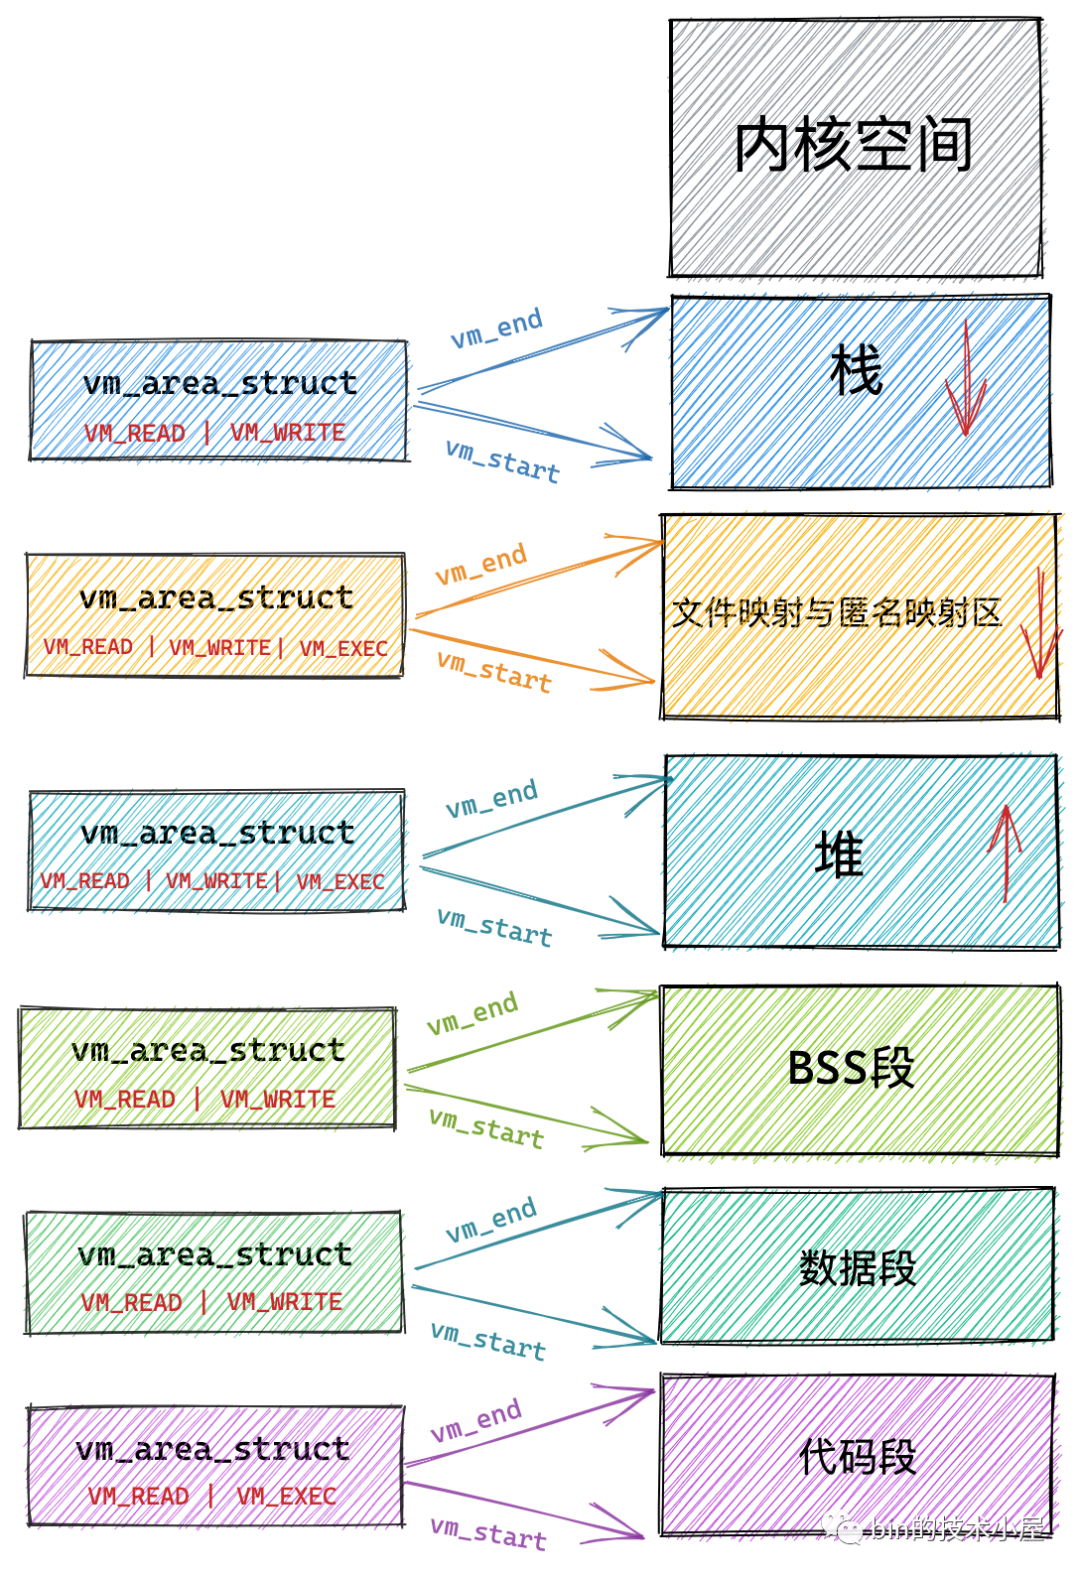
每個 vm_area_struct 結構對應於虛擬記憶體空間中的唯一虛擬記憶體區域 VMA,vm_start 指向了這塊虛擬記憶體區域的起始地址(最低地址),vm_start 本身包含在這塊虛擬記憶體區域內。vm_end 指向了這塊虛擬記憶體區域的結束地址(最高地址),而 vm_end 本身包含在這塊虛擬記憶體區域之外,所以 vm_area_struct 結構描述的是 [vm_start,vm_end) 這樣一段左閉右開的虛擬記憶體區域。
5.4 定義虛擬記憶體區域的訪問許可權和行為規範
vm_page_prot 和 vm_flags 都是用來標記 vm_area_struct 結構表示的這塊虛擬記憶體區域的訪問許可權和行為規範。
上邊小節中我們也提到,內核會將整塊物理記憶體劃分為一頁一頁大小的區域,以頁為單位來管理這些物理記憶體,每頁大小默認 4K 。而虛擬記憶體最終也是要和物理記憶體一一映射起來的,所以在虛擬記憶體空間中也有虛擬頁的概念與之對應,虛擬記憶體中的虛擬頁映射到物理記憶體中的物理頁。無論是在虛擬記憶體空間中還是在物理記憶體中,內核管理記憶體的最小單位都是頁。
vm_page_prot 偏向於定義底層記憶體管理架構中頁這一級別的訪問控制許可權,它可以直接應用在底層頁表中,它是一個具體的概念。
頁表用於管理虛擬記憶體到物理記憶體之間的映射關係,這部分內容筆者後續會詳細講解,這裡大家有個初步的概念就行。
虛擬記憶體區域 VMA 由許多的虛擬頁 (page) 組成,每個虛擬頁需要經過頁表的轉換才能找到對應的物理頁面。頁表中關於記憶體頁的訪問許可權就是由 vm_page_prot 決定的。
vm_flags 則偏向於定於整個虛擬記憶體區域的訪問許可權以及行為規範。描述的是虛擬記憶體區域中的整體資訊,而不是虛擬記憶體區域中具體的某個獨立頁面。它是一個抽象的概念。可以通過 vma->vm_page_prot = vm_get_page_prot(vma->vm_flags) 實現到具體頁面訪問許可權 vm_page_prot 的轉換。
下面筆者列舉一些常用到的 vm_flags 方便大家有一個直觀的感受:
| vm_flags | 訪問許可權 |
|---|---|
| VM_READ | 可讀 |
| VM_WRITE | 可寫 |
| VM_EXEC | 可執行 |
| VM_SHARD | 可多進程之間共享 |
| VM_IO | 可映射至設備 IO 空間 |
| VM_RESERVED | 記憶體區域不可被換出 |
| VM_SEQ_READ | 記憶體區域可能被順序訪問 |
| VM_RAND_READ | 記憶體區域可能被隨機訪問 |
VM_READ,VM_WRITE,VM_EXEC 定義了虛擬記憶體區域是否可以被讀取,寫入,執行等許可權。
比如程式碼段這塊記憶體區域的許可權是可讀,可執行,但是不可寫。數據段具有可讀可寫的許可權但是不可執行。堆則具有可讀可寫,可執行的許可權(Java 中的位元組碼存儲在堆中,所以需要可執行許可權),棧一般是可讀可寫的許可權,一般很少有可執行許可權。而文件映射與匿名映射區存放了共享鏈接庫,所以也需要可執行的許可權。
VM_SHARD 用於指定這塊虛擬記憶體區域映射的物理記憶體是否可以在多進程之間共享,以便完成進程間通訊。
設置這個值即為 mmap 的共享映射,不設置的話則為私有映射。這個等後面我們講到 mmap 的相關實現時還會再次提起。
VM_IO 的設置表示這塊虛擬記憶體區域可以映射至設備 IO 空間中。通常在設備驅動程式執行 mmap 進行 IO 空間映射時才會被設置。
VM_RESERVED 的設置表示在記憶體緊張的時候,這塊虛擬記憶體區域非常重要,不能被換出到磁碟中。
VM_SEQ_READ 的設置用來暗示內核,應用程式對這塊虛擬記憶體區域的讀取是會採用順序讀的方式進行,內核會根據實際情況決定預讀後續的記憶體頁數,以便加快下次順序訪問速度。
VM_RAND_READ 的設置會暗示內核,應用程式會對這塊虛擬記憶體區域進行隨機讀取,內核則會根據實際情況減少預讀的記憶體頁數甚至停止預讀。
我們可以通過 posix_fadvise,madvise 系統調用來暗示內核是否對相關記憶體區域進行順序讀取或者隨機讀取。相關的詳細內容,大家可以看下筆者上篇文章 《從 Linux 內核角度探秘 JDK NIO 文件讀寫本質》中的第 9 小節文件頁預讀部分。
通過這一系列的介紹,我們可以看到 vm_flags 就是定義整個虛擬記憶體區域的訪問許可權以及行為規範,而記憶體區域中記憶體的最小單位為頁(4K),虛擬記憶體區域中包含了很多這樣的虛擬頁,對於虛擬記憶體區域 VMA 設置的訪問許可權也會全部複製到區域中包含的記憶體頁中。
5.5 關聯記憶體映射中的映射關係
接下來的三個屬性 anon_vma,vm_file,vm_pgoff 分別和虛擬記憶體映射相關,虛擬記憶體區域可以映射到物理記憶體上,也可以映射到文件中,映射到物理記憶體上我們稱之為匿名映射,映射到文件中我們稱之為文件映射。
那麼這個映射關係在內核中該如何表示呢?這就用到了 vm_area_struct 結構體中的上述三個屬性。
當我們調用 malloc 申請記憶體時,如果申請的是小塊記憶體(低於 128K)則會使用 do_brk() 系統調用通過調整堆中的 brk 指針大小來增加或者回收堆記憶體。
如果申請的是比較大塊的記憶體(超過 128K)時,則會調用 mmap 在上圖虛擬記憶體空間中的文件映射與匿名映射區創建出一塊 VMA 記憶體區域(這裡是匿名映射)。這塊匿名映射區域就用 struct anon_vma 結構表示。
當調用 mmap 進行文件映射時,vm_file 屬性就用來關聯被映射的文件。這樣一來虛擬記憶體區域就與映射文件關聯了起來。vm_pgoff 則表示映射進虛擬記憶體中的文件內容,在文件中的偏移。
當然在匿名映射中,vm_area_struct 結構中的 vm_file 就為 null,vm_pgoff 也就沒有了意義。
vm_private_data 則用於存儲 VMA 中的私有數據。具體的存儲內容和記憶體映射的類型有關,我們暫不展開論述。
5.6 針對虛擬記憶體區域的相關操作
struct vm_area_struct 結構中還有一個 vm_ops 用來指向針對虛擬記憶體區域 VMA 的相關操作的函數指針。
struct vm_operations_struct {
	void (*open)(struct vm_area_struct * area);
	void (*close)(struct vm_area_struct * area);
    vm_fault_t (*fault)(struct vm_fault *vmf);
    vm_fault_t (*page_mkwrite)(struct vm_fault *vmf);

    ..... 省略 .......
}
-
當指定的虛擬記憶體區域被加入到進程虛擬記憶體空間中時,open 函數會被調用
-
當虛擬記憶體區域 VMA 從進程虛擬記憶體空間中被刪除時,close 函數會被調用
-
當進程訪問虛擬記憶體時,訪問的頁面不在物理記憶體中,可能是未分配物理記憶體也可能是被置換到磁碟中,這時就會產生缺頁異常,fault 函數就會被調用。
-
當一個只讀的頁面將要變為可寫時,page_mkwrite 函數會被調用。
struct vm_operations_struct 結構中定義的都是對虛擬記憶體區域 VMA 的相關操作函數指針。
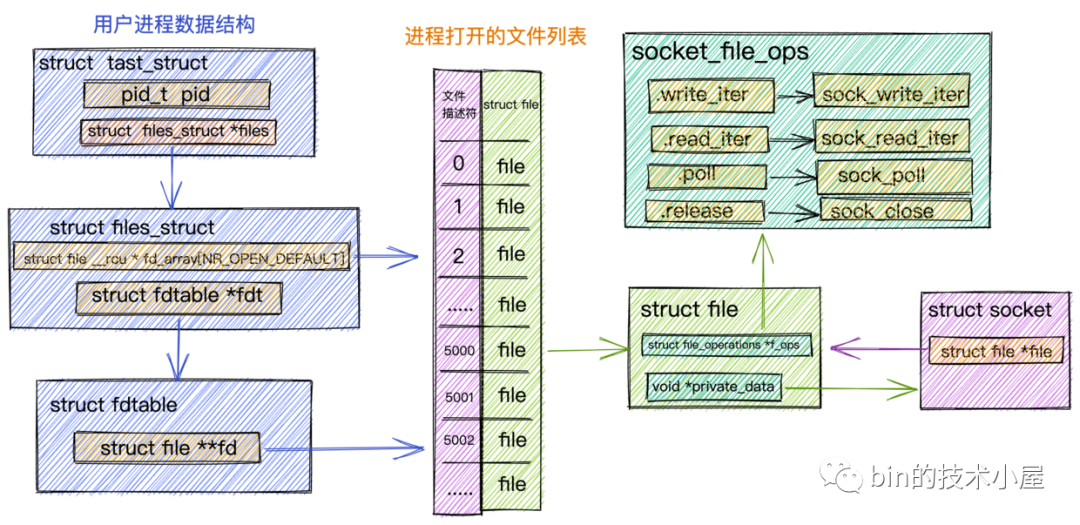
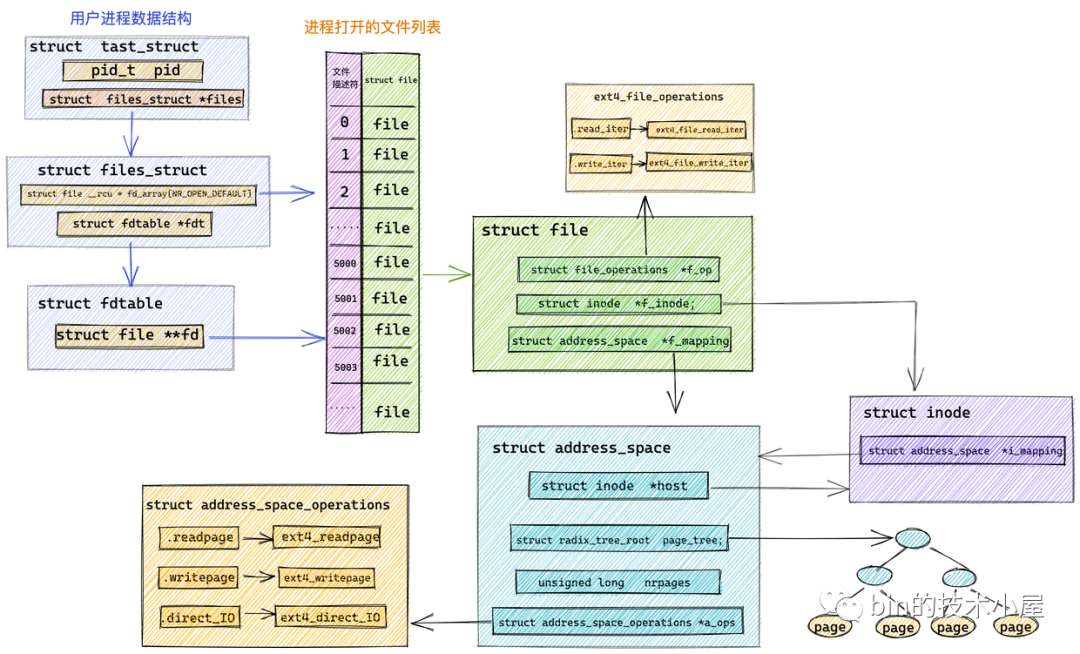
內核中這種類似的用法其實有很多,在內核中每個特定領域的描述符都會定義相關的操作。比如在前邊的文章 《從 Linux 內核角度探秘 JDK NIO 文件讀寫本質》 中我們介紹到內核中的文件描述符 struct file 中定義的 struct file_operations *f_op。裡面定義了內核針對文件操作的函數指針,具體的實現根據不同的文件類型有所不同。
針對 Socket 文件類型,這裡的 file_operations 指向的是 socket_file_ops。
在 ext4 文件系統中管理的文件對應的 file_operations 指向 ext4_file_operations,專門用於操作 ext4 文件系統中的文件。還有針對 page cache 頁高速快取相關操作定義的 address_space_operations 。
還有我們在 《從 Linux 內核角度看 IO 模型的演變》一文中介紹到,socket 相關的操作介面定義在 inet_stream_ops 函數集合中,負責對上給用戶提供介面。而 socket 與內核協議棧之間的操作介面定義在 struct sock 中的 sk_prot 指針上,這裡指向 tcp_prot 協議操作函數集合。
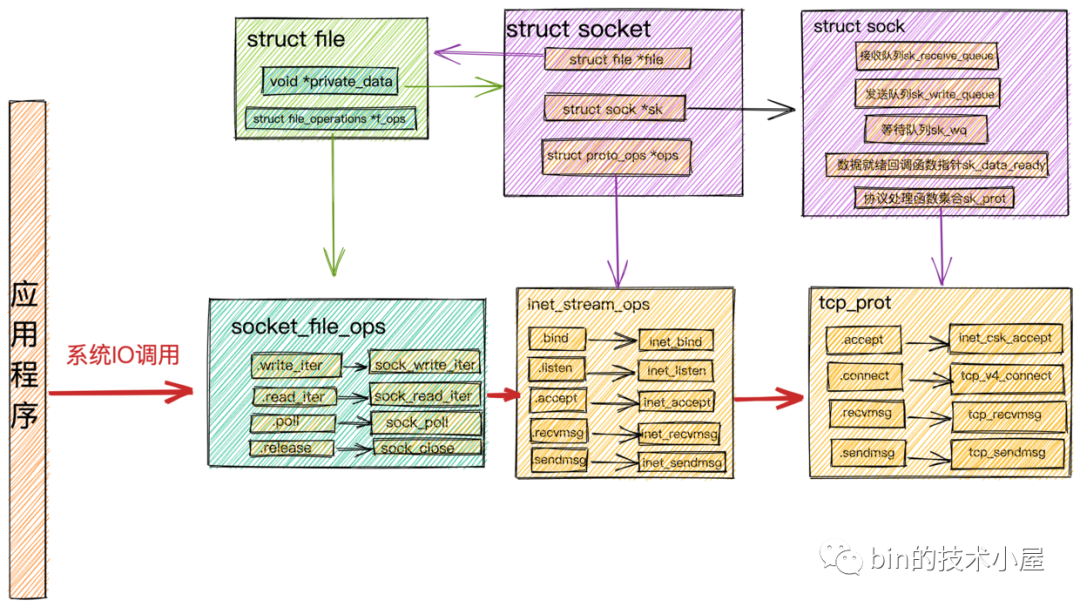
對 socket 發起的系統 IO 調用時,在內核中首先會調用 socket 的文件結構 struct file 中的 file_operations 文件操作集合,然後調用 struct socket 中的 ops 指向的 inet_stream_opssocket 操作函數,最終調用到 struct sock 中 sk_prot 指針指向的 tcp_prot 內核協議棧操作函數介面集合。
5.7 虛擬記憶體區域在內核中是如何被組織的
在上一小節中,我們介紹了內核中用來表示虛擬記憶體區域 VMA 的結構體 struct vm_area_struct ,並詳細為大家剖析了 struct vm_area_struct 中的一些重要的關鍵屬性。
現在我們已經熟悉了這些虛擬記憶體區域,那麼接下來的問題就是在內核中這些虛擬記憶體區域是如何被組織的呢?
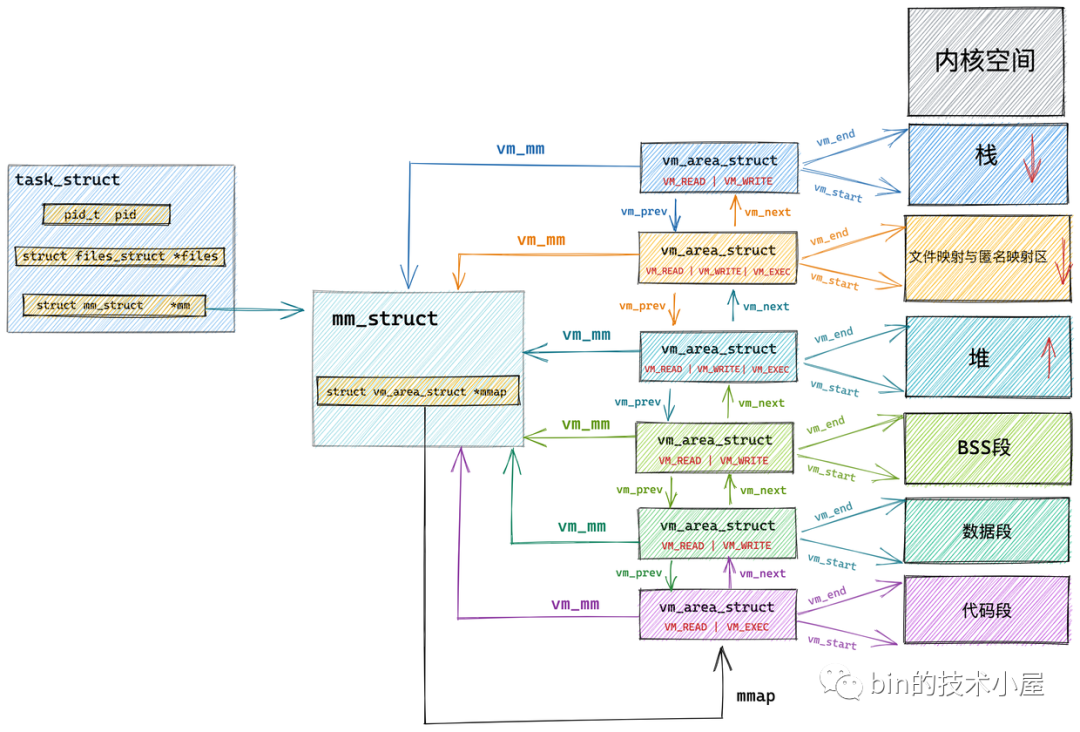
我們繼續來到 struct vm_area_struct 結構中,來看一下與組織結構相關的一些屬性:
struct vm_area_struct {

	struct vm_area_struct *vm_next, *vm_prev;
	struct rb_node vm_rb;
    struct list_head anon_vma_chain;
	struct mm_struct *vm_mm;	/* The address space we belong to. */

    unsigned long vm_start;     /* Our start address within vm_mm. */
    unsigned long vm_end;       /* The first byte after our end address
                       within vm_mm. */
    /*
     * Access permissions of this VMA.
     */
    pgprot_t vm_page_prot;
    unsigned long vm_flags;

    struct anon_vma *anon_vma;  /* Serialized by page_table_lock */
    struct file * vm_file;      /* File we map to (can be NULL). */
    unsigned long vm_pgoff;     /* Offset (within vm_file) in PAGE_SIZE
                       units */
    void * vm_private_data;     /* was vm_pte (shared mem) */
    /* Function pointers to deal with this struct. */
    const struct vm_operations_struct *vm_ops;
}
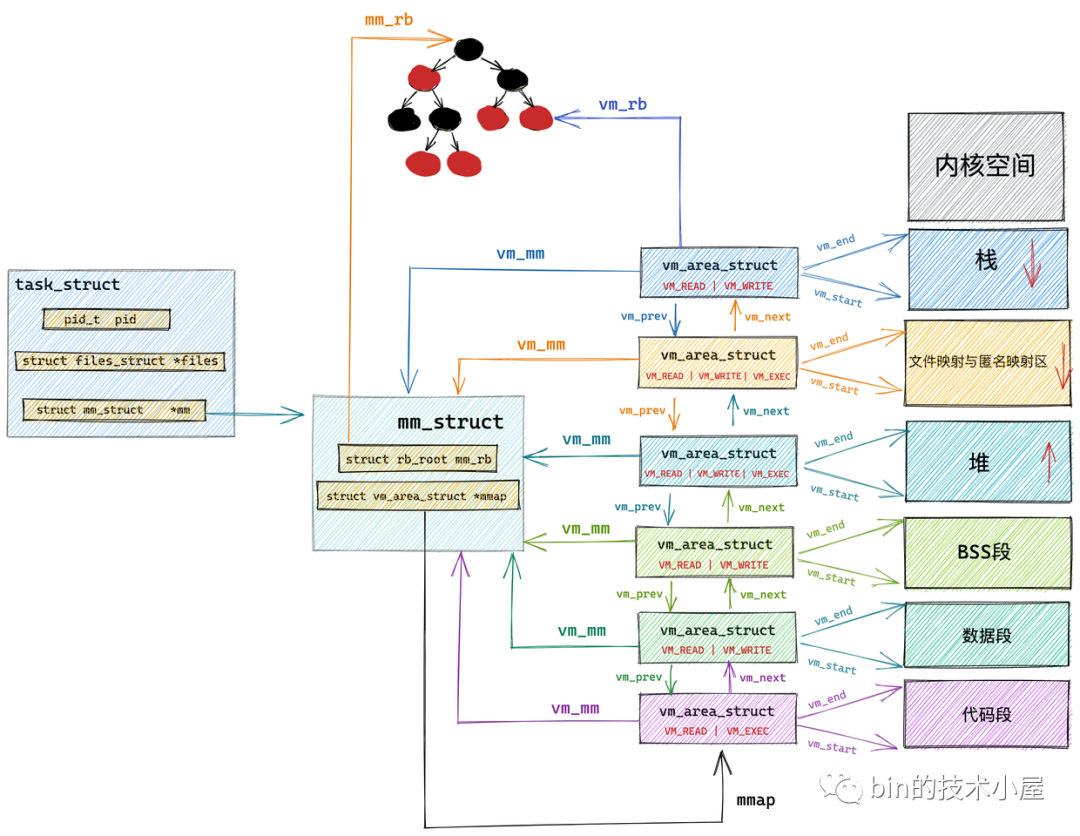
在內核中其實是通過一個 struct vm_area_struct 結構的雙向鏈表將虛擬記憶體空間中的這些虛擬記憶體區域 VMA 串聯起來的。
vm_area_struct 結構中的 vm_next ,vm_prev 指針分別指向 VMA 節點所在雙向鏈表中的後繼節點和前驅節點,內核中的這個 VMA 雙向鏈表是有順序的,所有 VMA 節點按照低地址到高地址的增長方向排序。
雙向鏈表中的最後一個 VMA 節點的 vm_next 指針指向 NULL,雙向鏈表的頭指針存儲在記憶體描述符 struct mm_struct 結構中的 mmap 中,正是這個 mmap 串聯起了整個虛擬記憶體空間中的虛擬記憶體區域。
struct mm_struct {
    struct vm_area_struct *mmap;		/* list of VMAs */
}
在每個虛擬記憶體區域 VMA 中又通過 struct vm_area_struct 中的 vm_mm 指針指向了所屬的虛擬記憶體空間 mm_struct。
我們可以通過 cat /proc/pid/maps 或者 pmap pid 查看進程的虛擬記憶體空間布局以及其中包含的所有記憶體區域。這兩個命令背後的實現原理就是通過遍歷內核中的這個 vm_area_struct 雙向鏈表獲取的。
內核中關於這些虛擬記憶體區域的操作除了遍歷之外還有許多需要根據特定虛擬記憶體地址在虛擬記憶體空間中查找特定的虛擬記憶體區域。
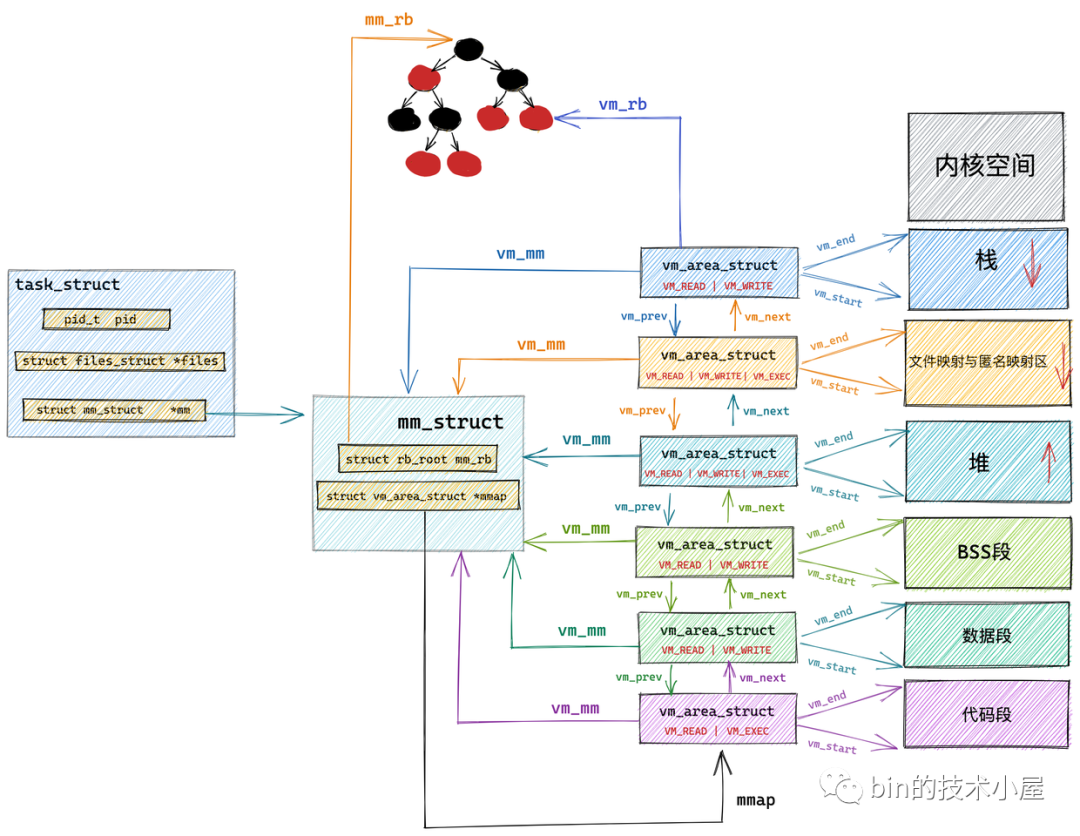
尤其在進程虛擬記憶體空間中包含的記憶體區域 VMA 比較多的情況下,使用紅黑樹查找特定虛擬記憶體區域的時間複雜度是 O( logN ) ,可以顯著減少查找所需的時間。
所以在內核中,同樣的記憶體區域 vm_area_struct 會有兩種組織形式,一種是雙向鏈表用於高效的遍歷,另一種就是紅黑樹用於高效的查找。
每個 VMA 區域都是紅黑樹中的一個節點,通過 struct vm_area_struct 結構中的 vm_rb 將自己連接到紅黑樹中。
而紅黑樹中的根節點存儲在記憶體描述符 struct mm_struct 中的 mm_rb 中:
struct mm_struct {
     struct rb_root mm_rb;
}
6. 程式編譯後的二進位文件如何映射到虛擬記憶體空間中
經過前邊這麼多小節的內容介紹,現在我們已經熟悉了進程虛擬記憶體空間的布局,以及內核如何管理這些虛擬記憶體區域,並對進程的虛擬記憶體空間有了一個完整全面的認識。
現在我們再來回到最初的起點,進程的虛擬記憶體空間 mm_struct 以及這些虛擬記憶體區域 vm_area_struct 是如何被創建並初始化的呢?

在 《3. 進程虛擬記憶體空間》小節中,我們介紹進程的虛擬記憶體空間時提到,我們寫的程式程式碼編譯之後會生成一個 ELF 格式的二進位文件,這個二進位文件中包含了程式運行時所需要的元資訊,比如程式的機器碼,程式中的全局變數以及靜態變數等。
這個 ELF 格式的二進位文件中的布局和我們前邊講的虛擬記憶體空間中的布局類似,也是一段一段的,每一段包含了不同的元數據。
磁碟文件中的段我們叫做 Section,記憶體中的段我們叫做 Segment,也就是記憶體區域。
磁碟文件中的這些 Section 會在進程運行之前載入到記憶體中並映射到記憶體中的 Segment。通常是多個 Section 映射到一個 Segment。
比如磁碟文件中的 .text,.rodata 等一些只讀的 Section,會被映射到記憶體的一個只讀可執行的 Segment 里(程式碼段)。而 .data,.bss 等一些可讀寫的 Section,則會被映射到記憶體的一個具有讀寫許可權的 Segment 里(數據段,BSS 段)。
那麼這些 ELF 格式的二進位文件中的 Section 是如何載入並映射進虛擬記憶體空間的呢?
內核中完成這個映射過程的函數是 load_elf_binary ,這個函數的作用很大,載入內核的是它,啟動第一個用戶態進程 init 的是它,fork 完了以後,調用 exec 運行一個二進位程式的也是它。當 exec 運行一個二進位程式的時候,除了解析 ELF 的格式之外,另外一個重要的事情就是建立上述提到的記憶體映射。
static int load_elf_binary(struct linux_binprm *bprm)
{
      ...... 省略 ........
  // 設置虛擬記憶體空間中的記憶體映射區域起始地址 mmap_base
  setup_new_exec(bprm);

     ...... 省略 ........
  // 創建並初始化棧對應的 vm_area_struct 結構。
  // 設置 mm->start_stack 就是棧的起始地址也就是棧底,並將 mm->arg_start 是指向棧底的。
  retval = setup_arg_pages(bprm, randomize_stack_top(STACK_TOP),
         executable_stack);

     ...... 省略 ........
  // 將二進位文件中的程式碼部分映射到虛擬記憶體空間中
  error = elf_map(bprm->file, load_bias + vaddr, elf_ppnt,
        elf_prot, elf_flags, total_size);

     ...... 省略 ........
 // 創建並初始化堆對應的的 vm_area_struct 結構
 // 設置 current->mm->start_brk = current->mm->brk,設置堆的起始地址 start_brk,結束地址 brk。 起初兩者相等表示堆是空的
  retval = set_brk(elf_bss, elf_brk, bss_prot);

     ...... 省略 ........
  // 將進程依賴的動態鏈接庫 .so 文件映射到虛擬記憶體空間中的記憶體映射區域
  elf_entry = load_elf_interp(&loc->interp_elf_ex,
              interpreter,
              &interp_map_addr,
              load_bias, interp_elf_phdata);

     ...... 省略 ........
  // 初始化記憶體描述符 mm_struct
  current->mm->end_code = end_code;
  current->mm->start_code = start_code;
  current->mm->start_data = start_data;
  current->mm->end_data = end_data;
  current->mm->start_stack = bprm->p;

     ...... 省略 ........
}
-
setup_new_exec 設置虛擬記憶體空間中的記憶體映射區域起始地址 mmap_base
-
setup_arg_pages 創建並初始化棧對應的 vm_area_struct 結構。置 mm->start_stack 就是棧的起始地址也就是棧底,並將 mm->arg_start 是指向棧底的。
-
elf_map 將 ELF 格式的二進位文件中.text ,.data,.bss 部分映射到虛擬記憶體空間中的程式碼段,數據段,BSS 段中。
-
set_brk 創建並初始化堆對應的的 vm_area_struct 結構,設置
current->mm->start_brk = current->mm->brk,設置堆的起始地址 start_brk,結束地址 brk。 起初兩者相等表示堆是空的。 -
load_elf_interp 將進程依賴的動態鏈接庫 .so 文件映射到虛擬記憶體空間中的記憶體映射區域
-
初始化記憶體描述符 mm_struct
7. 內核虛擬記憶體空間
現在我們已經知道了進程虛擬記憶體空間在內核中的布局以及管理,那麼內核態的虛擬記憶體空間又是什麼樣子的呢?本小節筆者就帶大家來一層一層地拆開這個黑盒子。
之前在介紹進程虛擬記憶體空間的時候,筆者提到不同進程之間的虛擬記憶體空間是相互隔離的,彼此之間相互獨立,相互感知不到其他進程的存在。使得進程以為自己擁有所有的記憶體資源。
而內核態虛擬記憶體空間是所有進程共享的,不同進程進入內核態之後看到的虛擬記憶體空間全部是一樣的。
什麼意思呢?比如上圖中的進程 a,進程 b,進程 c 分別在各自的用戶態虛擬記憶體空間中訪問虛擬地址 x 。由於進程之間的用戶態虛擬記憶體空間是相互隔離相互獨立的,雖然在進程a,進程b,進程c 訪問的都是虛擬地址 x 但是看到的內容卻是不一樣的(背後可能映射到不同的物理記憶體中)。
但是當進程 a,進程 b,進程 c 進入到內核態之後情況就不一樣了,由於內核虛擬記憶體空間是各個進程共享的,所以它們在內核空間中看到的內容全部是一樣的,比如進程 a,進程 b,進程 c 在內核態都去訪問虛擬地址 y。這時它們看到的內容就是一樣的了。
這裡筆者和大家澄清一個經常被誤解的概念:由於內核會涉及到物理記憶體的管理,所以很多人會想當然地認為只要進入了內核態就開始使用物理地址了,這就大錯特錯了,千萬不要這樣理解,進程進入內核態之後使用的仍然是虛擬記憶體地址,只不過在內核中使用的虛擬記憶體地址被限制在了內核態虛擬記憶體空間範圍中,這也是本小節筆者要為大家介紹的主題。
在清楚了這個基本概念之後,下面筆者分別從 32 位體系 和 64 位體系下為大家介紹內核態虛擬記憶體空間的布局。
7.1 32 位體系內核虛擬記憶體空間布局
在前邊《5.1 內核如何劃分用戶態和內核態虛擬記憶體空間》小節中我們提到,內核在 /arch/x86/include/asm/page_32_types.h 文件中通過 TASK_SIZE 將進程虛擬記憶體空間和內核虛擬記憶體空間分割開來。
/*
 * User space process size: 3GB (default).
 */
#define TASK_SIZE       __PAGE_OFFSET
__PAGE_OFFSET 的值在 32 位系統下為 0xC000 000
在 32 位體系結構下進程用戶態虛擬記憶體空間為 3 GB,虛擬記憶體地址範圍為:0x0000 0000 - 0xC000 000 。內核態虛擬記憶體空間為 1 GB,虛擬記憶體地址範圍為:0xC000 000 - 0xFFFF FFFF。
本小節我們主要關注 0xC000 000 - 0xFFFF FFFF 這段虛擬記憶體地址區域也就是內核虛擬記憶體空間的布局情況。
7.1.1 直接映射區
在總共大小 1G 的內核虛擬記憶體空間中,位於最前邊有一塊 896M 大小的區域,我們稱之為直接映射區或者線性映射區,地址範圍為 3G -- 3G + 896m 。
之所以這塊 896M 大小的區域稱為直接映射區或者線性映射區,是因為這塊連續的虛擬記憶體地址會映射到 0 - 896M 這塊連續的物理記憶體上。
也就是說 3G -- 3G + 896m 這塊 896M 大小的虛擬記憶體會直接映射到 0 - 896M 這塊 896M 大小的物理記憶體上,這塊區域中的虛擬記憶體地址直接減去 0xC000 0000 (3G) 就得到了物理記憶體地址。所以我們稱這塊區域為直接映射區。
為了方便為大家解釋,我們假設現在機器上的物理記憶體為 4G 大小
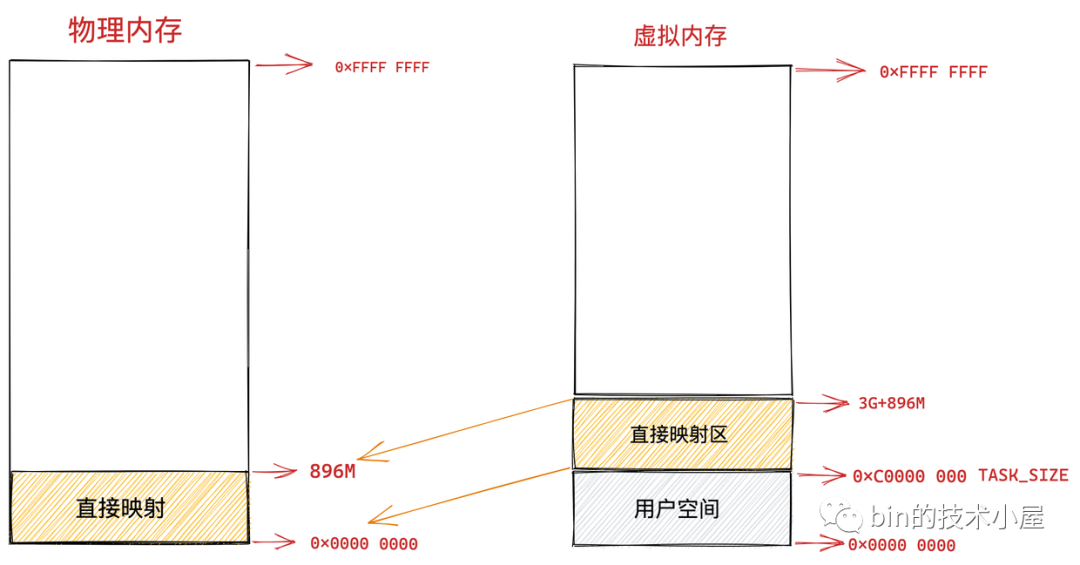
雖然這塊區域中的虛擬地址是直接映射到物理地址上,但是內核在訪問這段區域的時候還是走的虛擬記憶體地址,內核也會為這塊空間建立映射頁表。關於頁表的概念筆者後續會為大家詳細講解,這裡大家只需要簡單理解為頁表保存了虛擬地址到物理地址的映射關係即可。
大家這裡只需要記得內核態虛擬記憶體空間的前 896M 區域是直接映射到物理記憶體中的前 896M 區域中的,直接映射區中的映射關係是一比一映射。映射關係是固定的不會改變。
明白了這個關係之後,我們接下來就看一下這塊直接映射區域在物理記憶體中究竟存的是什麼內容~~~
在這段 896M 大小的物理記憶體中,前 1M 已經在系統啟動的時候被系統佔用,1M 之後的物理記憶體存放的是內核程式碼段,數據段,BSS 段(這些資訊起初存放在 ELF格式的二進位文件中,在系統啟動的時候被載入進記憶體)。
我們可以通過
cat /proc/iomem命令查看具體物理記憶體布局情況。
當我們使用 fork 系統調用創建進程的時候,內核會創建一系列進程相關的描述符,比如之前提到的進程的核心數據結構 task_struct,進程的記憶體空間描述符 mm_struct,以及虛擬記憶體區域描述符 vm_area_struct 等。
這些進程相關的數據結構也會存放在物理記憶體前 896M 的這段區域中,當然也會被直接映射至內核態虛擬記憶體空間中的 3G -- 3G + 896m 這段直接映射區域中。
當進程被創建完畢之後,在內核運行的過程中,會涉及內核棧的分配,內核會為每個進程分配一個固定大小的內核棧(一般是兩個頁大小,依賴具體的體系結構),每個進程的整個調用鏈必須放在自己的內核棧中,內核棧也是分配在直接映射區。
與進程用戶空間中的棧不同的是,內核棧容量小而且是固定的,用戶空間中的棧容量大而且可以動態擴展。內核棧的溢出危害非常巨大,它會直接悄無聲息的覆蓋相鄰記憶體區域中的數據,破壞數據。
通過以上內容的介紹我們了解到內核虛擬記憶體空間最前邊的這段 896M 大小的直接映射區如何與物理記憶體進行映射關聯,並且清楚了直接映射區主要用來存放哪些內容。
寫到這裡,筆者覺得還是有必要再次從功能劃分的角度為大家介紹下這塊直接映射區域。
我們都知道內核對物理記憶體的管理都是以頁為最小單位來管理的,每頁默認 4K 大小,理想狀況下任何種類的數據頁都可以存放在任何頁框中,沒有什麼限制。比如:存放內核數據,用戶數據,緩衝磁碟數據等。
但是實際的電腦體系結構受到硬體方面的限制制約,間接導致限制了頁框的使用方式。
比如在 X86 體系結構下,ISA 匯流排的 DMA (直接記憶體存取)控制器,只能對記憶體的前16M 進行定址,這就導致了 ISA 設備不能在整個 32 位地址空間中執行 DMA,只能使用物理記憶體的前 16M 進行 DMA 操作。
因此直接映射區的前 16M 專門讓內核用來為 DMA 分配記憶體,這塊 16M 大小的記憶體區域我們稱之為 ZONE_DMA。
用於 DMA 的記憶體必須從 ZONE_DMA 區域中分配。
而直接映射區中剩下的部分也就是從 16M 到 896M(不包含 896M)這段區域,我們稱之為 ZONE_NORMAL。從字面意義上我們可以了解到,這塊區域包含的就是正常的頁框(使用沒有任何限制)。
ZONE_NORMAL 由於也是屬於直接映射區的一部分,對應的物理記憶體 16M 到 896M 這段區域也是被直接映射至內核態虛擬記憶體空間中的 3G + 16M 到 3G + 896M 這段虛擬記憶體上。
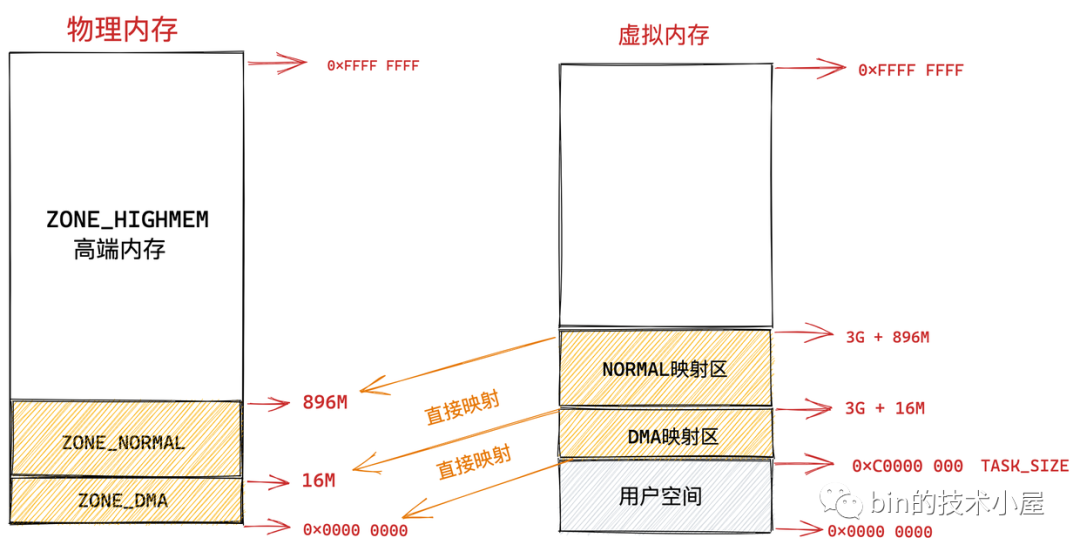
注意這裡的 ZONE_DMA 和 ZONE_NORMAL 是內核針對物理記憶體區域的劃分。
現在物理記憶體中的前 896M 的區域也就是前邊介紹的 ZONE_DMA 和 ZONE_NORMAL 區域到內核虛擬記憶體空間的映射筆者就為大家介紹完了,它們都是採用直接映射的方式,一比一就行映射。
7.1.2 ZONE_HIGHMEM 高端記憶體
而物理記憶體 896M 以上的區域被內核劃分為 ZONE_HIGHMEM 區域,我們稱之為高端記憶體。
本例中我們的物理記憶體假設為 4G,高端記憶體區域為 4G - 896M = 3200M,那麼這塊 3200M 大小的 ZONE_HIGHMEM 區域該如何映射到內核虛擬記憶體空間中呢?
由於內核虛擬記憶體空間中的前 896M 虛擬記憶體已經被直接映射區所佔用,而在 32 體系結構下內核虛擬記憶體空間總共也就 1G 的大小,這樣一來內核剩餘可用的虛擬記憶體空間就變為了 1G - 896M = 128M。
顯然物理記憶體中 3200M 大小的 ZONE_HIGHMEM 區域無法繼續通過直接映射的方式映射到這 128M 大小的虛擬記憶體空間中。
這樣一來物理記憶體中的 ZONE_HIGHMEM 區域就只能採用動態映射的方式映射到 128M 大小的內核虛擬記憶體空間中,也就是說只能動態的一部分一部分的分批映射,先映射正在使用的這部分,使用完畢解除映射,接著映射其他部分。
知道了 ZONE_HIGHMEM 區域的映射原理,我們接著往下看這 128M 大小的內核虛擬記憶體空間究竟是如何布局的?
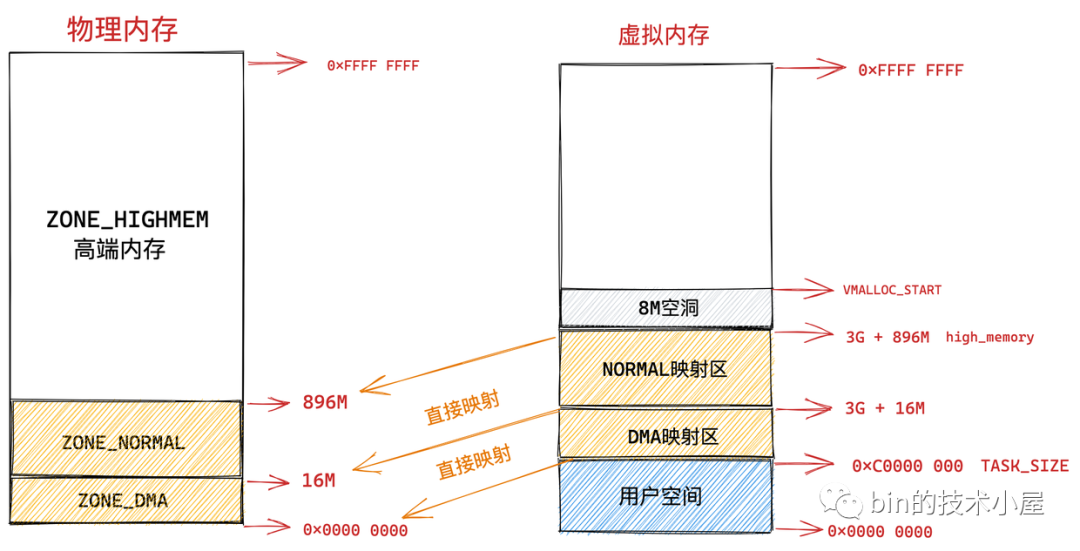
內核虛擬記憶體空間中的 3G + 896M 這塊地址在內核中定義為 high_memory,high_memory 往上有一段 8M 大小的記憶體空洞。空洞範圍為:high_memory 到 VMALLOC_START 。
VMALLOC_START 定義在內核源碼 /arch/x86/include/asm/pgtable_32_areas.h 文件中:
#define VMALLOC_OFFSET	(8 * 1024 * 1024)

#define VMALLOC_START	((unsigned long)high_memory + VMALLOC_OFFSET)
7.1.3 vmalloc 動態映射區
接下來 VMALLOC_START 到 VMALLOC_END 之間的這塊區域成為動態映射區。採用動態映射的方式映射物理記憶體中的高端記憶體。
#ifdef CONFIG_HIGHMEM
# define VMALLOC_END	(PKMAP_BASE - 2 * PAGE_SIZE)
#else
# define VMALLOC_END	(LDT_BASE_ADDR - 2 * PAGE_SIZE)
#endif
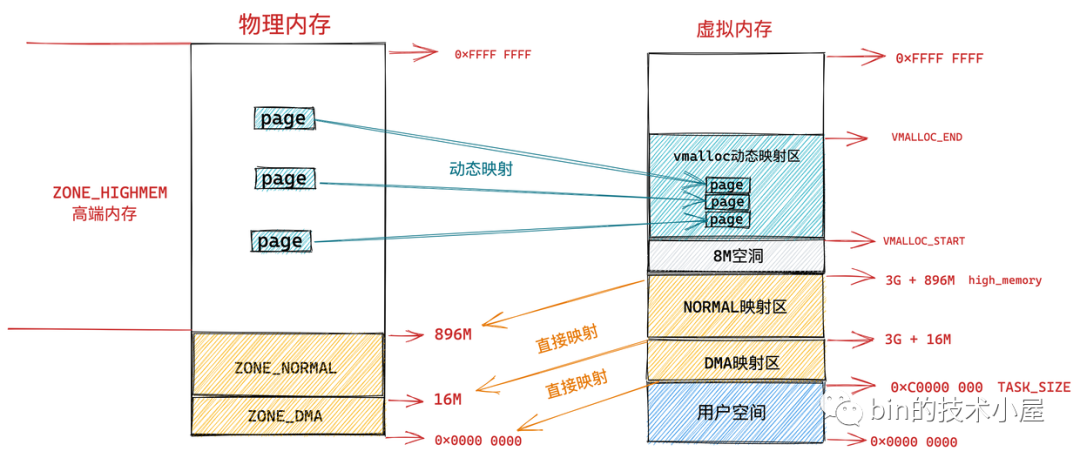
和用戶態進程使用 malloc 申請記憶體一樣,在這塊動態映射區內核是使用 vmalloc 進行記憶體分配。由於之前介紹的動態映射的原因,vmalloc 分配的記憶體在虛擬記憶體上是連續的,但是物理記憶體是不連續的。通過頁表來建立物理記憶體與虛擬記憶體之間的映射關係,從而可以將不連續的物理記憶體映射到連續的虛擬記憶體上。
由於 vmalloc 獲得的物理記憶體頁是不連續的,因此它只能將這些物理記憶體頁一個一個地進行映射,在性能開銷上會比直接映射大得多。
關於 vmalloc 分配記憶體的相關實現原理,筆者會在後面的文章中為大家講解,這裡大家只需要明白它在哪塊虛擬記憶體區域中活動即可。
7.1.4 永久映射區
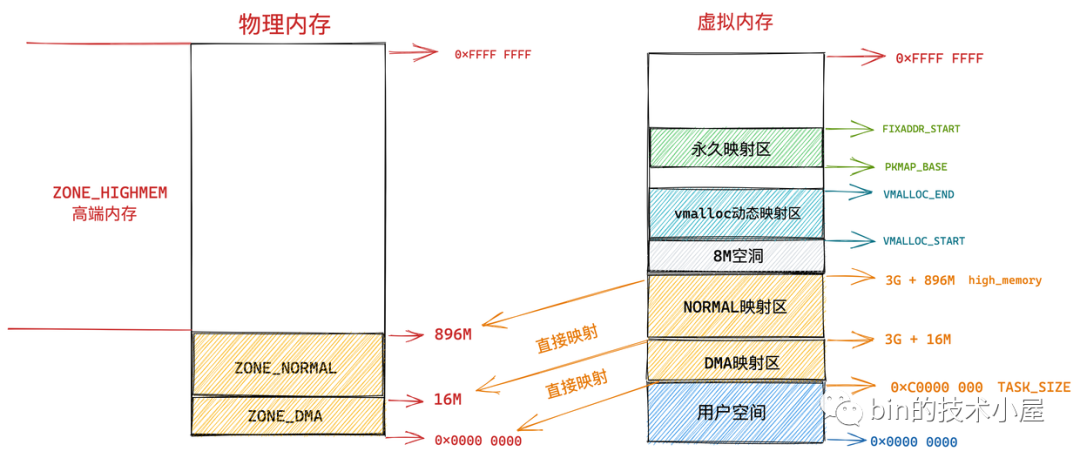
而在 PKMAP_BASE 到 FIXADDR_START 之間的這段空間稱為永久映射區。在內核的這段虛擬地址空間中允許建立與物理高端記憶體的長期映射關係。比如內核通過 alloc_pages() 函數在物理記憶體的高端記憶體中申請獲取到的物理記憶體頁,這些物理記憶體頁可以通過調用 kmap 映射到永久映射區中。
LAST_PKMAP 表示永久映射區可以映射的頁數限制。
#define PKMAP_BASE		\
	((LDT_BASE_ADDR - PAGE_SIZE) & PMD_MASK)

#define LAST_PKMAP 1024
8.1.5 固定映射區
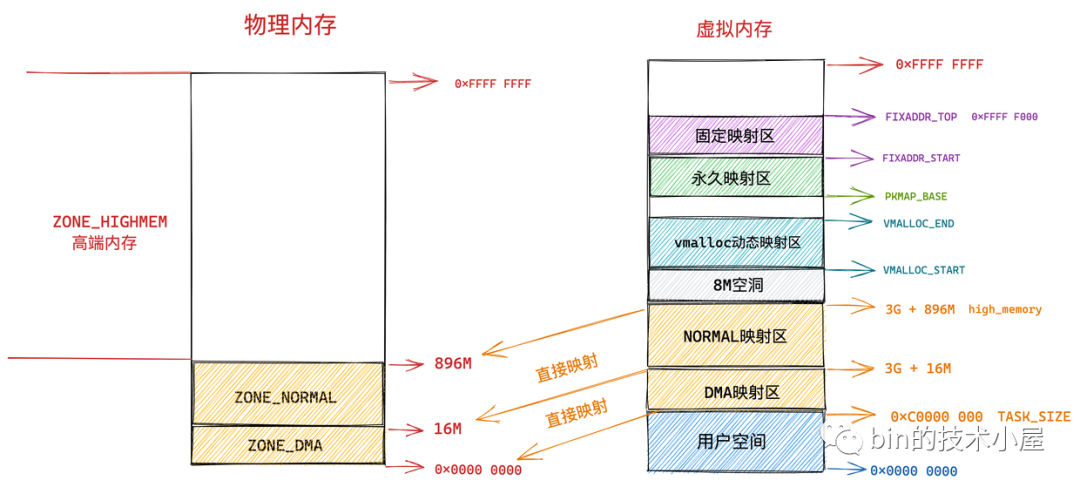
內核虛擬記憶體空間中的下一個區域為固定映射區,區域範圍為:FIXADDR_START 到 FIXADDR_TOP。
FIXADDR_START 和 FIXADDR_TOP 定義在內核源碼 /arch/x86/include/asm/fixmap.h 文件中:
#define FIXADDR_START		(FIXADDR_TOP - FIXADDR_SIZE)

extern unsigned long __FIXADDR_TOP; // 0xFFFF F000
#define FIXADDR_TOP	((unsigned long)__FIXADDR_TOP)
在內核虛擬記憶體空間的直接映射區中,直接映射區中的虛擬記憶體地址與物理記憶體前 896M 的空間的映射關係都是預設好的,一比一映射。
在固定映射區中的虛擬記憶體地址可以自由映射到物理記憶體的高端地址上,但是與動態映射區以及永久映射區不同的是,在固定映射區中虛擬地址是固定的,而被映射的物理地址是可以改變的。也就是說,有些虛擬地址在編譯的時候就固定下來了,是在內核啟動過程中被確定的,而這些虛擬地址對應的物理地址不是固定的。採用固定虛擬地址的好處是它相當於一個指針常量(常量的值在編譯時確定),指向物理地址,如果虛擬地址不固定,則相當於一個指針變數。
那為什麼會有固定映射這個概念呢 ? 比如:在內核的啟動過程中,有些模組需要使用虛擬記憶體並映射到指定的物理地址上,而且這些模組也沒有辦法等待完整的記憶體管理模組初始化之後再進行地址映射。因此,內核固定分配了一些虛擬地址,這些地址有固定的用途,使用該地址的模組在初始化的時候,將這些固定分配的虛擬地址映射到指定的物理地址上去。
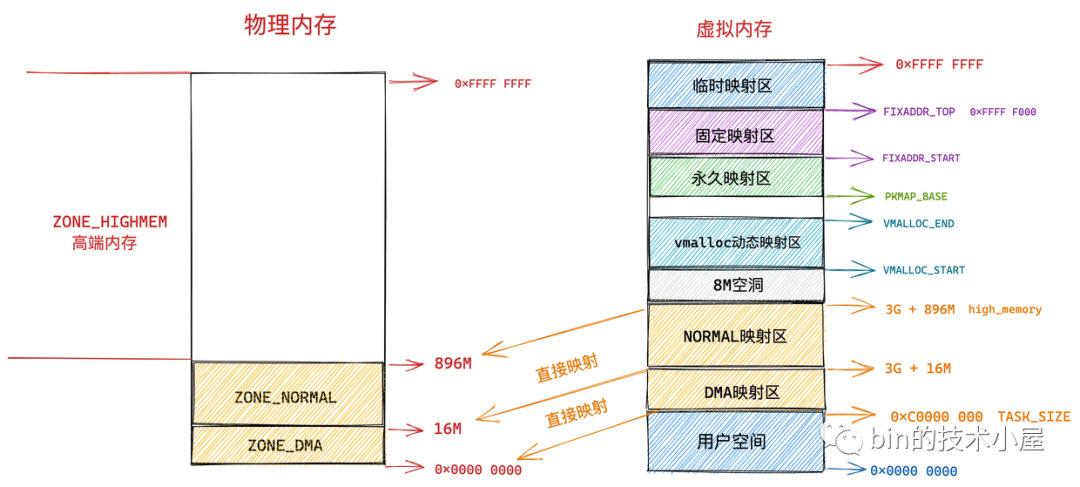
7.1.6 臨時映射區
在內核虛擬記憶體空間中的最後一塊區域為臨時映射區,那麼這塊臨時映射區是用來幹什麼的呢?
筆者在之前文章 《從 Linux 內核角度探秘 JDK NIO 文件讀寫本質》 的 「 12.3 iov_iter_copy_from_user_atomic 」 小節中介紹在 Buffered IO 模式下進行文件寫入的時候,在下圖中的第四步,內核會調用 iov_iter_copy_from_user_atomic 函數將用戶空間緩衝區 DirectByteBuffer 中的待寫入數據拷貝到 page cache 中。
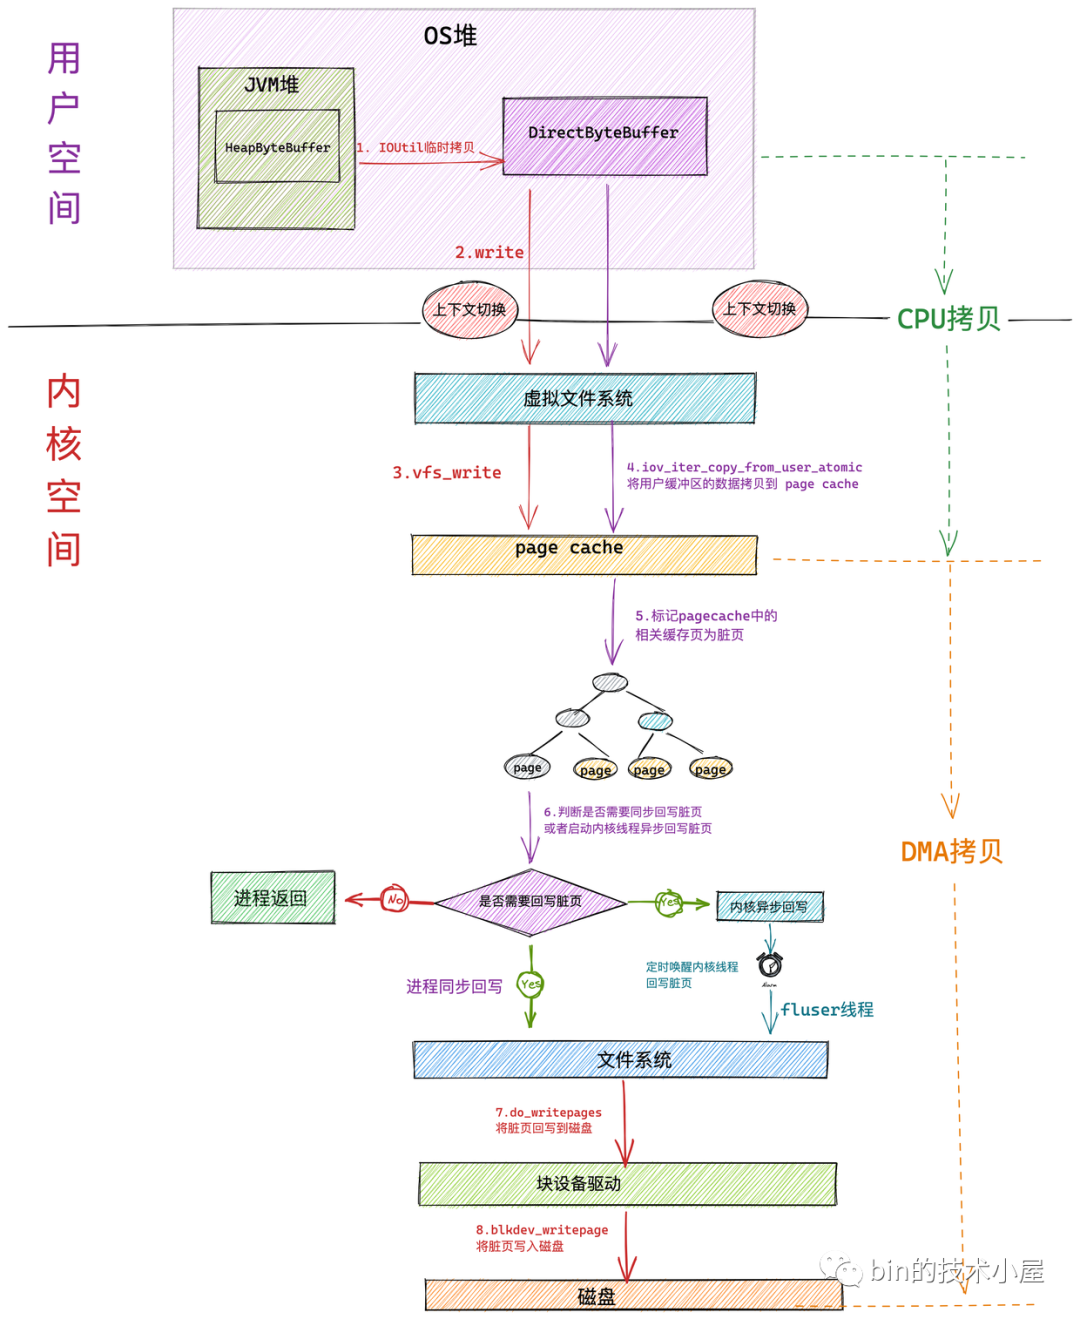
但是內核又不能直接進行拷貝,因為此時從 page cache 中取出的快取頁 page 是物理地址,而在內核中是不能夠直接操作物理地址的,只能操作虛擬地址。
那怎麼辦呢?所以就需要使用 kmap_atomic 將快取頁臨時映射到內核空間的一段虛擬地址上,這段虛擬地址就位於內核虛擬記憶體空間中的臨時映射區上,然後將用戶空間快取區 DirectByteBuffer 中的待寫入數據通過這段映射的虛擬地址拷貝到 page cache 中的相應快取頁中。這時文件的寫入操作就已經完成了。
由於是臨時映射,所以在拷貝完成之後,調用 kunmap_atomic 將這段映射再解除掉。
size_t iov_iter_copy_from_user_atomic(struct page *page,
    struct iov_iter *i, unsigned long offset, size_t bytes)
{
  // 將快取頁臨時映射到內核虛擬地址空間的臨時映射區中
  char *kaddr = kmap_atomic(page),
  *p = kaddr + offset;
  // 將用戶快取區 DirectByteBuffer 中的待寫入數據拷貝到文件快取頁中
  iterate_all_kinds(i, bytes, v,
    copyin((p += v.iov_len) - v.iov_len, v.iov_base, v.iov_len),
    memcpy_from_page((p += v.bv_len) - v.bv_len, v.bv_page,
         v.bv_offset, v.bv_len),
    memcpy((p += v.iov_len) - v.iov_len, v.iov_base, v.iov_len)
  )
  // 解除內核虛擬地址空間與快取頁之間的臨時映射,這裡映射只是為了臨時拷貝數據用
  kunmap_atomic(kaddr);
  return bytes;
}
7.1.7 32位體系結構下 Linux 虛擬記憶體空間整體布局
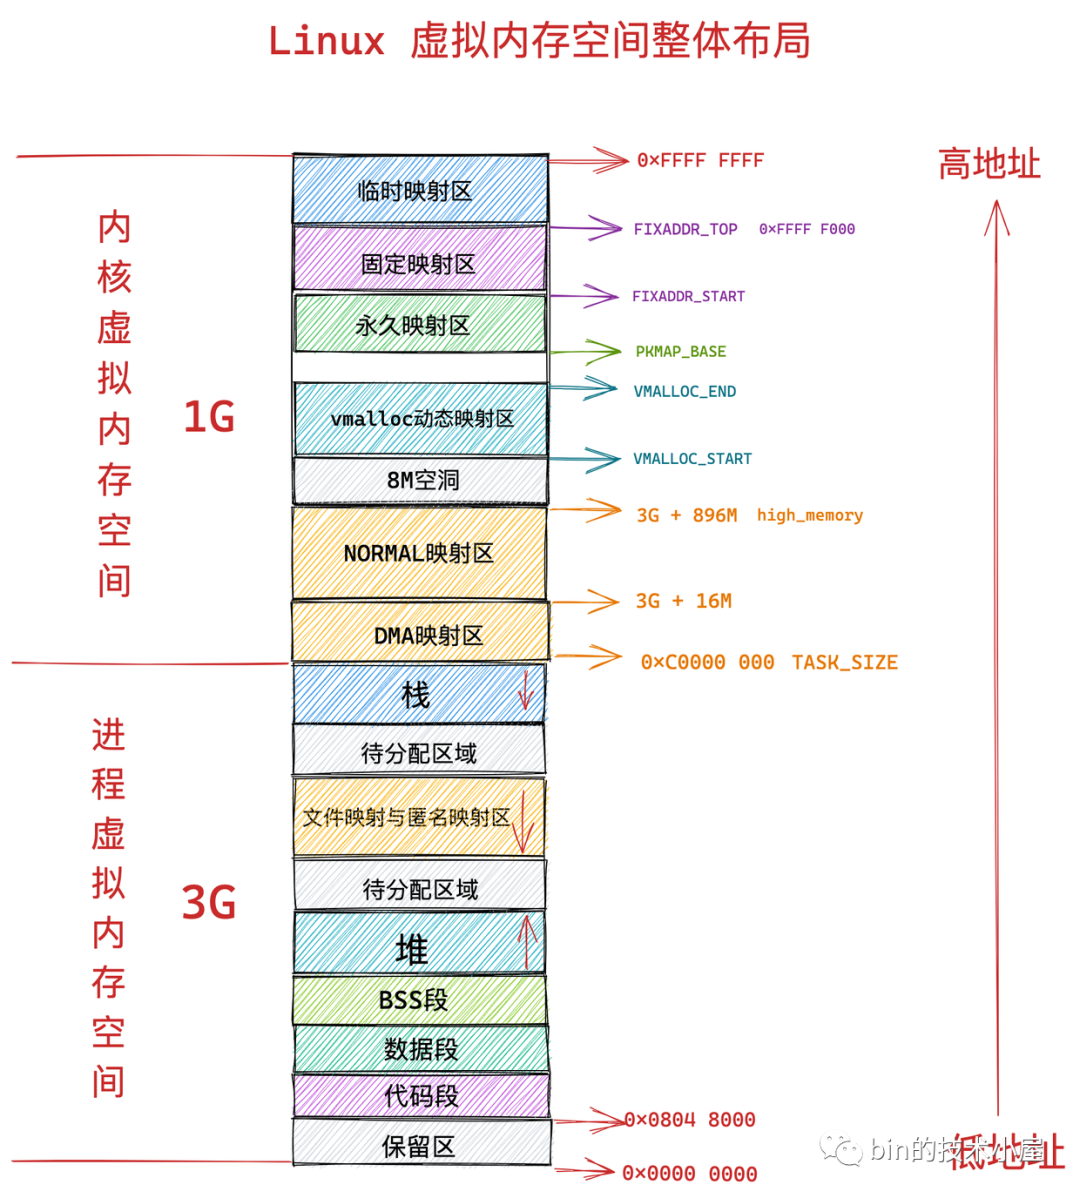
到現在為止,整個內核虛擬記憶體空間在 32 位體系下的布局,筆者就為大家詳細介紹完畢了,我們再次結合前邊《4.1 32 位機器上進程虛擬記憶體空間分布》小節中介紹的進程虛擬記憶體空間和本小節介紹的內核虛擬記憶體空間來整體回顧下 32 位體系結構 Linux 的整個虛擬記憶體空間的布局:
7.2 64 位體系內核虛擬記憶體空間布局
內核虛擬記憶體空間在 32 位體系下只有 1G 大小,實在太小了,因此需要精細化的管理,於是按照功能分類劃分除了很多內核虛擬記憶體區域,這樣就顯得非常複雜。
到了 64 位體系下,內核虛擬記憶體空間的布局和管理就變得容易多了,因為進程虛擬記憶體空間和內核虛擬記憶體空間各自佔用 128T 的虛擬記憶體,實在是太大了,我們可以在這裡邊隨意翱翔,隨意揮霍。
因此在 64 位體系下的內核虛擬記憶體空間與物理記憶體的映射就變得非常簡單,由於虛擬記憶體空間足夠的大,即便是內核要訪問全部的物理記憶體,直接映射就可以了,不在需要用到《7.1.2 ZONE_HIGHMEM 高端記憶體》小節中介紹的高端記憶體那種動態映射方式。
在前邊《5.1 內核如何劃分用戶態和內核態虛擬記憶體空間》小節中我們提到,內核在 /arch/x86/include/asm/page_64_types.h 文件中通過 TASK_SIZE 將進程虛擬記憶體空間和內核虛擬記憶體空間分割開來。
#define TASK_SIZE		(test_thread_flag(TIF_ADDR32) ? \
					IA32_PAGE_OFFSET : TASK_SIZE_MAX)

#define TASK_SIZE_MAX		task_size_max()

#define task_size_max()		((_AC(1,UL) << __VIRTUAL_MASK_SHIFT) - PAGE_SIZE)

#define __VIRTUAL_MASK_SHIFT	47
64 位系統中的 TASK_SIZE 為 0x00007FFFFFFFF000
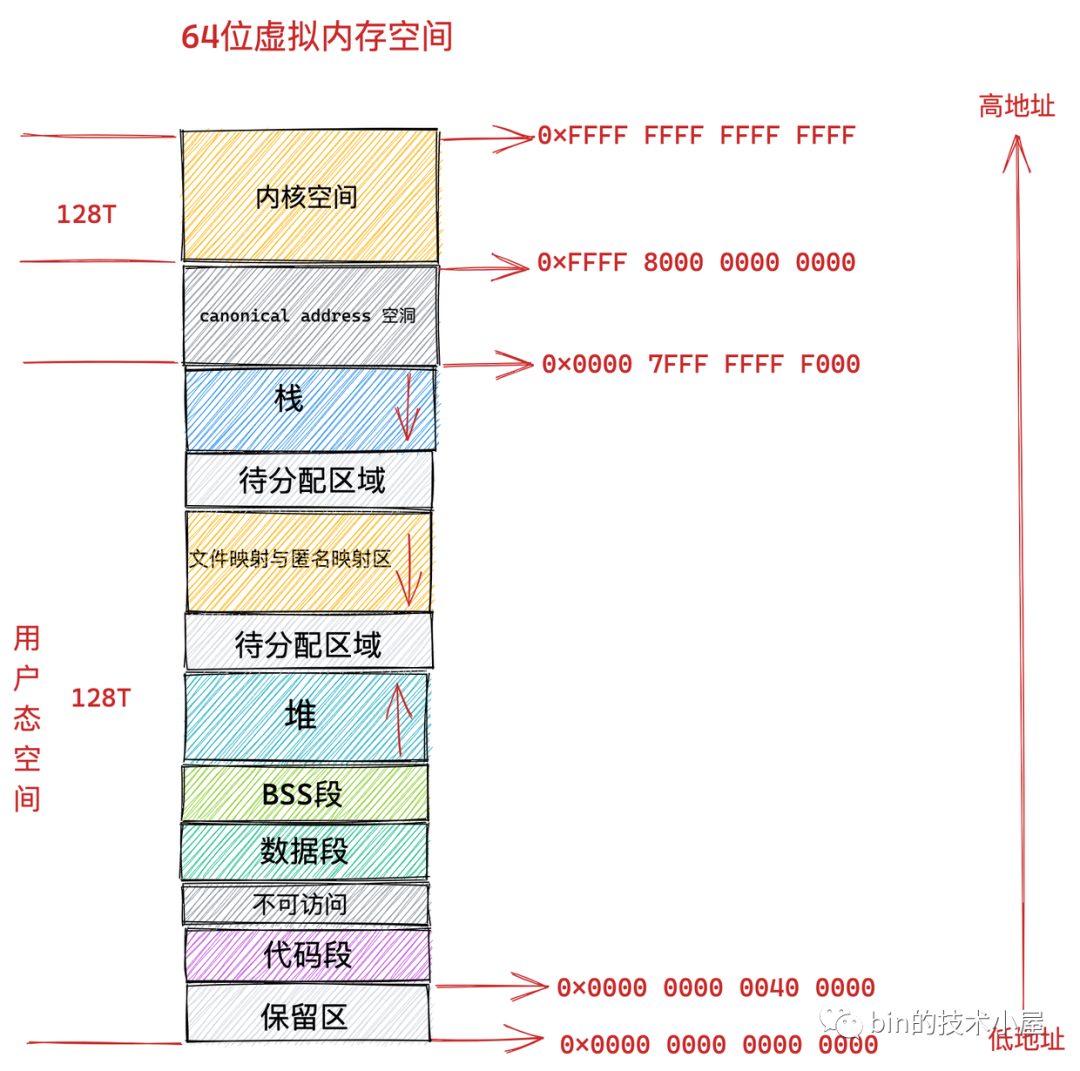
在 64 位系統中,只使用了其中的低 48 位來表示虛擬記憶體地址。其中用戶態虛擬記憶體空間為低 128 T,虛擬記憶體地址範圍為:0x0000 0000 0000 0000 - 0x0000 7FFF FFFF F000 。
內核態虛擬記憶體空間為高 128 T,虛擬記憶體地址範圍為:0xFFFF 8000 0000 0000 - 0xFFFF FFFF FFFF FFFF 。
本小節我們主要關注 0xFFFF 8000 0000 0000 - 0xFFFF FFFF FFFF FFFF 這段內核虛擬記憶體空間的布局情況。
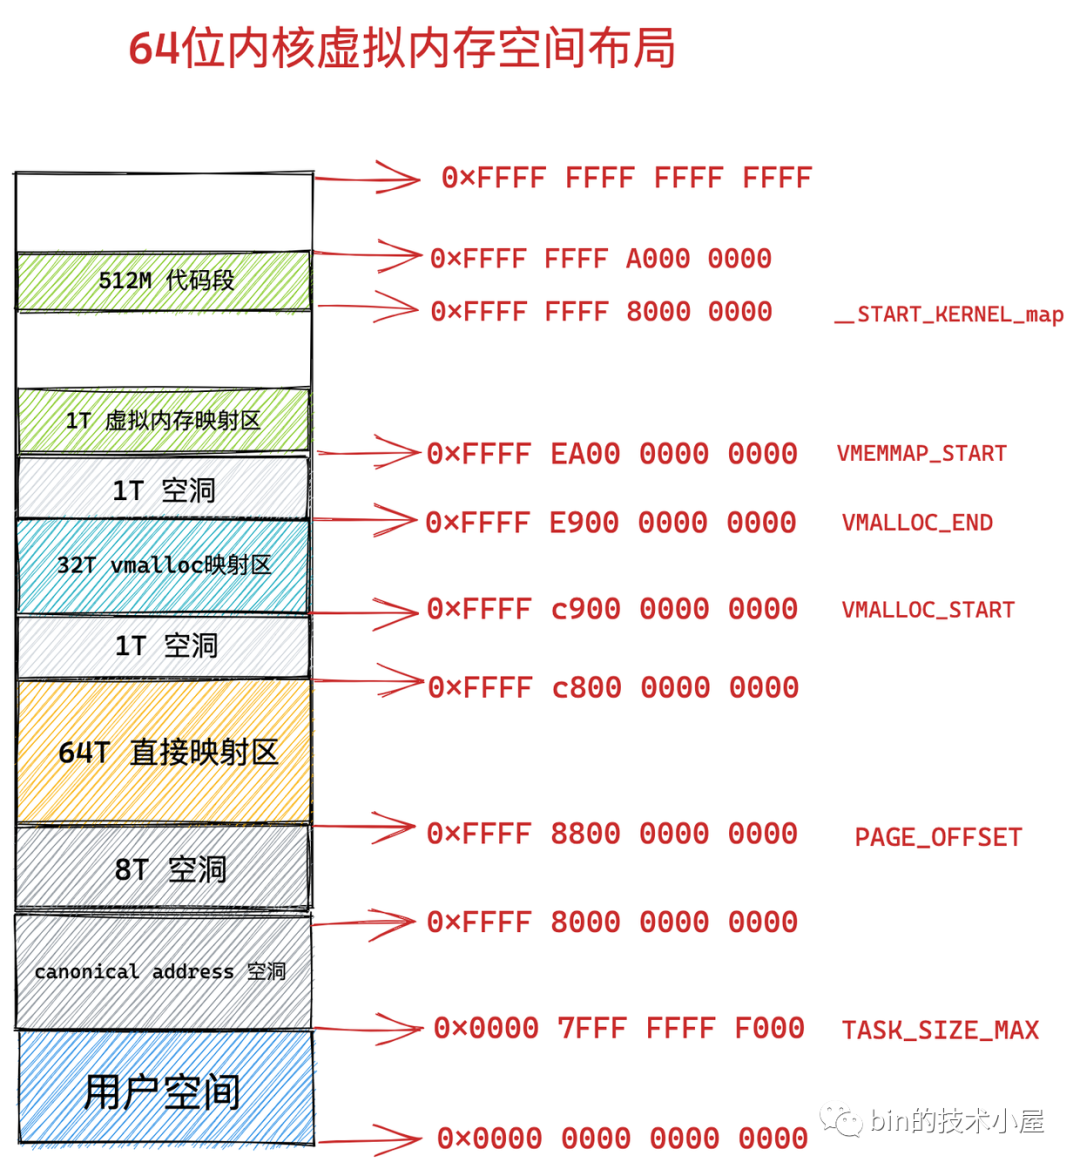
64 位內核虛擬記憶體空間從 0xFFFF 8000 0000 0000 開始到 0xFFFF 8800 0000 0000 這段地址空間是一個 8T 大小的記憶體空洞區域。
緊著著 8T 大小的記憶體空洞下一個區域就是 64T 大小的直接映射區。這個區域中的虛擬記憶體地址減去 PAGE_OFFSET 就直接得到了物理記憶體地址。
PAGE_OFFSET 變數定義在 /arch/x86/include/asm/page_64_types.h 文件中:
#define __PAGE_OFFSET_BASE      _AC(0xffff880000000000, UL)
#define __PAGE_OFFSET           __PAGE_OFFSET_BASE
從圖中 VMALLOC_START 到 VMALLOC_END 的這段區域是 32T 大小的 vmalloc 映射區,這裡類似用戶空間中的堆,內核在這裡使用 vmalloc 系統調用申請記憶體。
VMALLOC_START 和 VMALLOC_END 變數定義在 /arch/x86/include/asm/pgtable_64_types.h 文件中:
#define __VMALLOC_BASE_L4	0xffffc90000000000UL

#define VMEMMAP_START		__VMEMMAP_BASE_L4

#define VMALLOC_END		(VMALLOC_START + (VMALLOC_SIZE_TB << 40) - 1)
從 VMEMMAP_START 開始是 1T 大小的虛擬記憶體映射區,用於存放物理頁面的描述符 struct page 結構用來表示物理記憶體頁。
VMEMMAP_START 變數定義在 /arch/x86/include/asm/pgtable_64_types.h 文件中:
#define __VMEMMAP_BASE_L4	0xffffea0000000000UL

# define VMEMMAP_START		__VMEMMAP_BASE_L4
從 __START_KERNEL_map 開始是大小為 512M 的區域用於存放內核程式碼段、全局變數、BSS 等。這裡對應到物理記憶體開始的位置,減去 __START_KERNEL_map 就能得到物理記憶體的地址。這裡和直接映射區有點像,但是不矛盾,因為直接映射區之前有 8T 的空洞區域,早就過了內核程式碼在物理記憶體中載入的位置。
__START_KERNEL_map 變數定義在 /arch/x86/include/asm/page_64_types.h 文件中:
#define __START_KERNEL_map _AC(0xffffffff80000000, UL)
7.2.1 64位體系結構下 Linux 虛擬記憶體空間整體布局
到現在為止,整個內核虛擬記憶體空間在 64 位體系下的布局筆者就為大家詳細介紹完畢了,我們再次結合前邊《4.2 64 位機器上進程虛擬記憶體空間分布》小節介紹的進程虛擬記憶體空間和本小節介紹的內核虛擬記憶體空間來整體回顧下 64 位體系結構 Linux 的整個虛擬記憶體空間的布局:
8. 到底什麼是物理記憶體地址
聊完了虛擬記憶體,我們接著聊一下物理記憶體,我們平時所稱的記憶體也叫隨機訪問存儲器( random-access memory )也叫 RAM 。而 RAM 分為兩類:
- 一類是靜態 RAM(
SRAM),這類 SRAM 用於 CPU 高速快取 L1Cache,L2Cache,L3Cache。其特點是訪問速度快,訪問速度為 1 - 30 個時鐘周期,但是容量小,造價高。
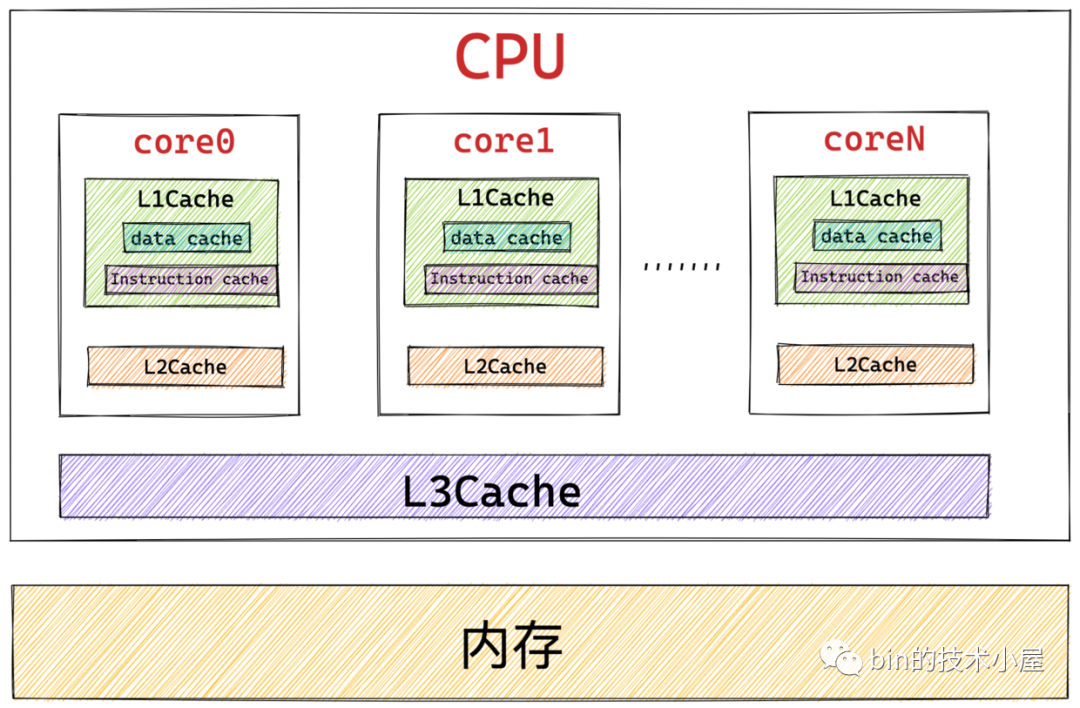
- 另一類則是動態 RAM (
DRAM),這類 DRAM 用於我們常說的主存上,其特點的是訪問速度慢(相對高速快取),訪問速度為 50 - 200 個時鐘周期,但是容量大,造價便宜些(相對高速快取)。
記憶體由一個一個的存儲器模組(memory module)組成,它們插在主板的擴展槽上。常見的存儲器模組通常以 64 位為單位( 8 個位元組)傳輸數據到存儲控制器上或者從存儲控制器傳出數據。
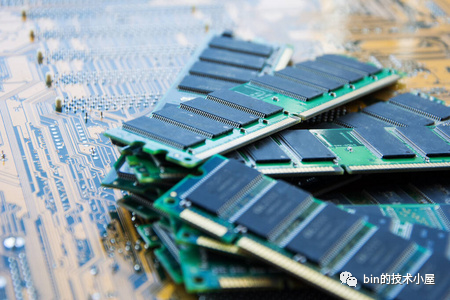
如圖所示記憶體條上黑色的元器件就是存儲器模組(memory module)。多個存儲器模組連接到存儲控制器上,就聚合成了主存。
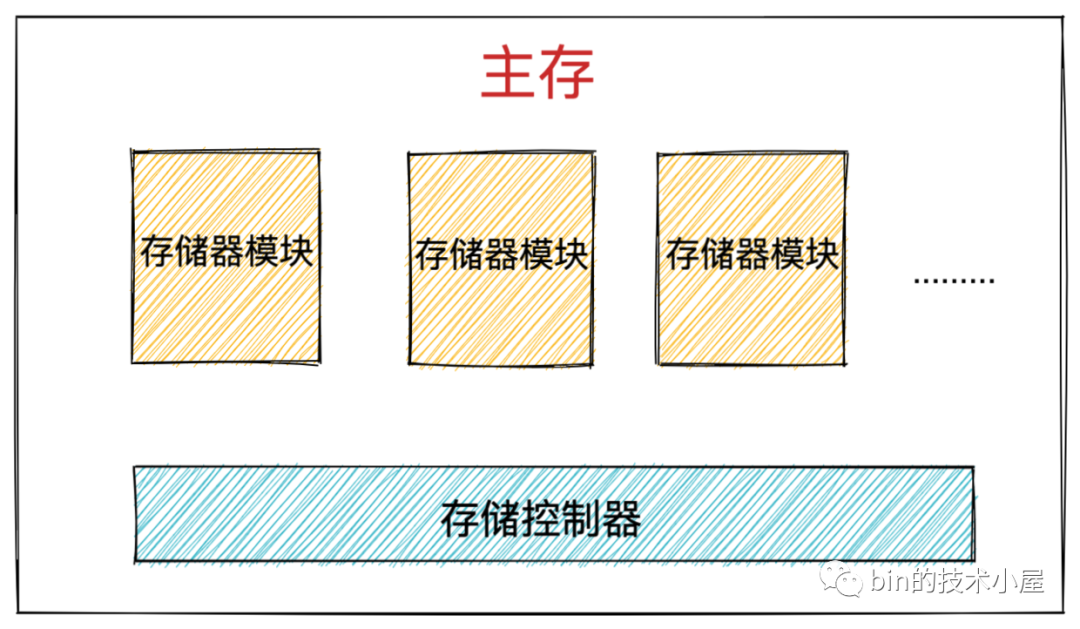
而 DRAM 晶片就包裝在存儲器模組中,每個存儲器模組中包含 8 個 DRAM 晶片,依次編號為 0 - 7 。
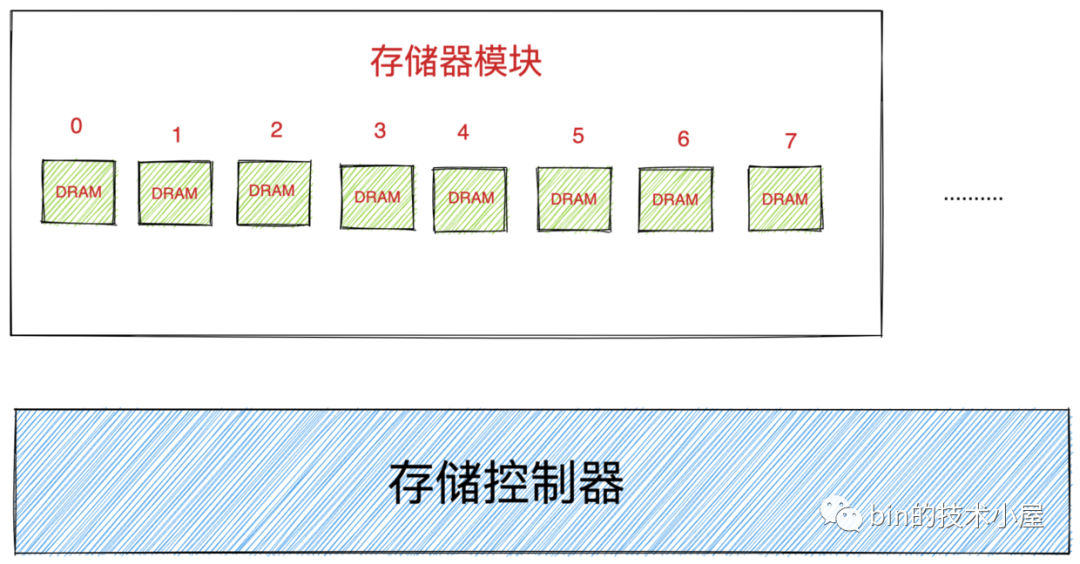
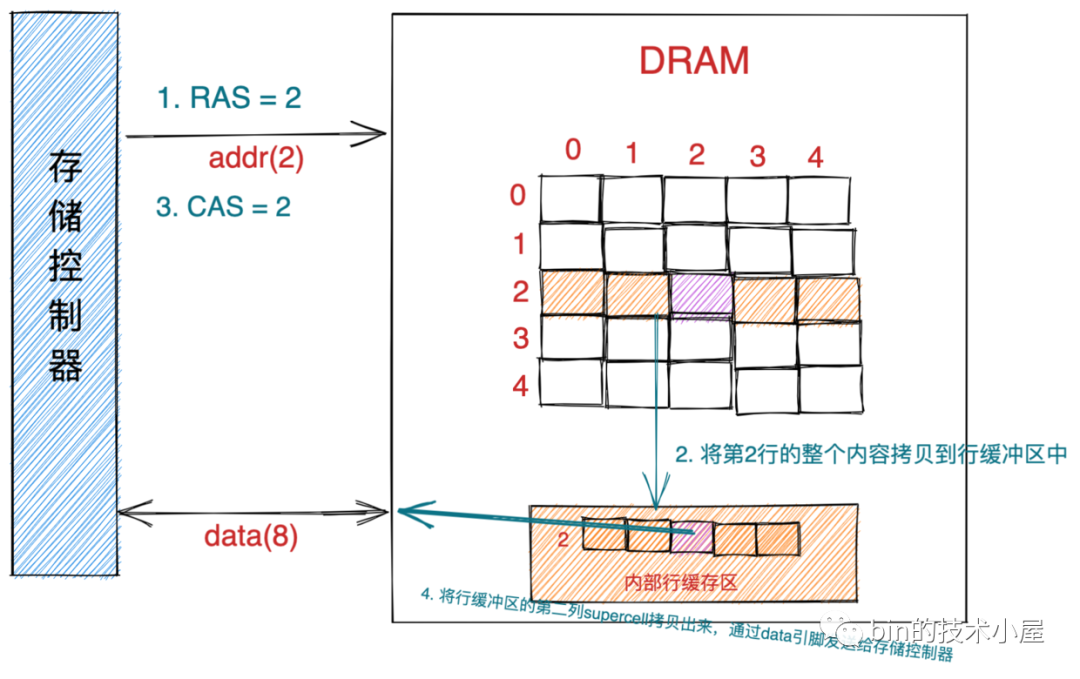
而每一個 DRAM 晶片的存儲結構是一個二維矩陣,二維矩陣中存儲的元素我們稱為超單元(supercell),每個 supercell 大小為一個位元組(8 bit)。每個 supercell 都由一個坐標地址(i,j)。
i 表示二維矩陣中的行地址,在電腦中行地址稱為 RAS (row access strobe,行訪問選通脈衝)。
j 表示二維矩陣中的列地址,在電腦中列地址稱為 CAS (column access strobe,列訪問選通脈衝)。
下圖中的 supercell 的 RAS = 2,CAS = 2。
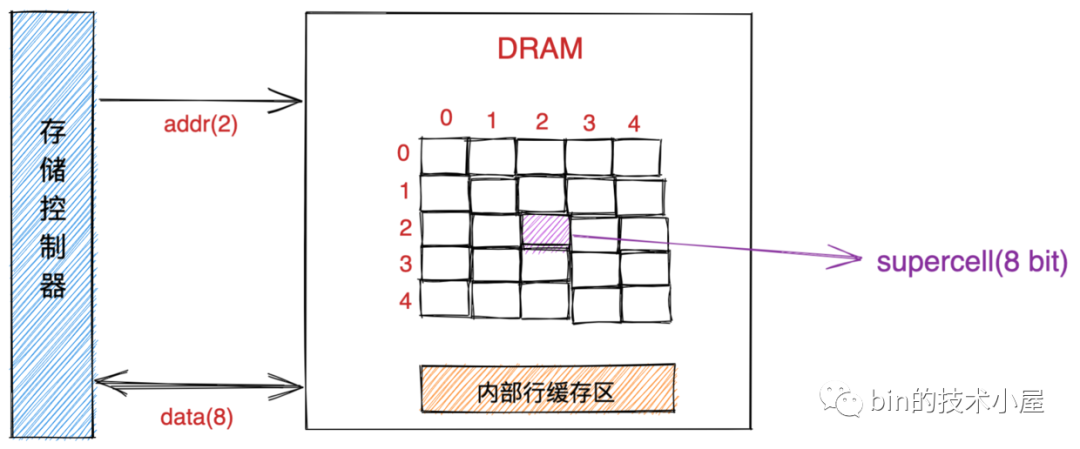
DRAM 晶片中的資訊通過引腳流入流出 DRAM 晶片。每個引腳攜帶 1 bit的訊號。
圖中 DRAM 晶片包含了兩個地址引腳( addr ),因為我們要通過 RAS,CAS 來定位要獲取的 supercell 。還有 8 個數據引腳(data),因為 DRAM 晶片的 IO 單位為一個位元組(8 bit),所以需要 8 個 data 引腳從 DRAM 晶片傳入傳出數據。
注意這裡只是為了解釋地址引腳和數據引腳的概念,實際硬體中的引腳數量是不一定的。
8.1 DRAM 晶片的訪問
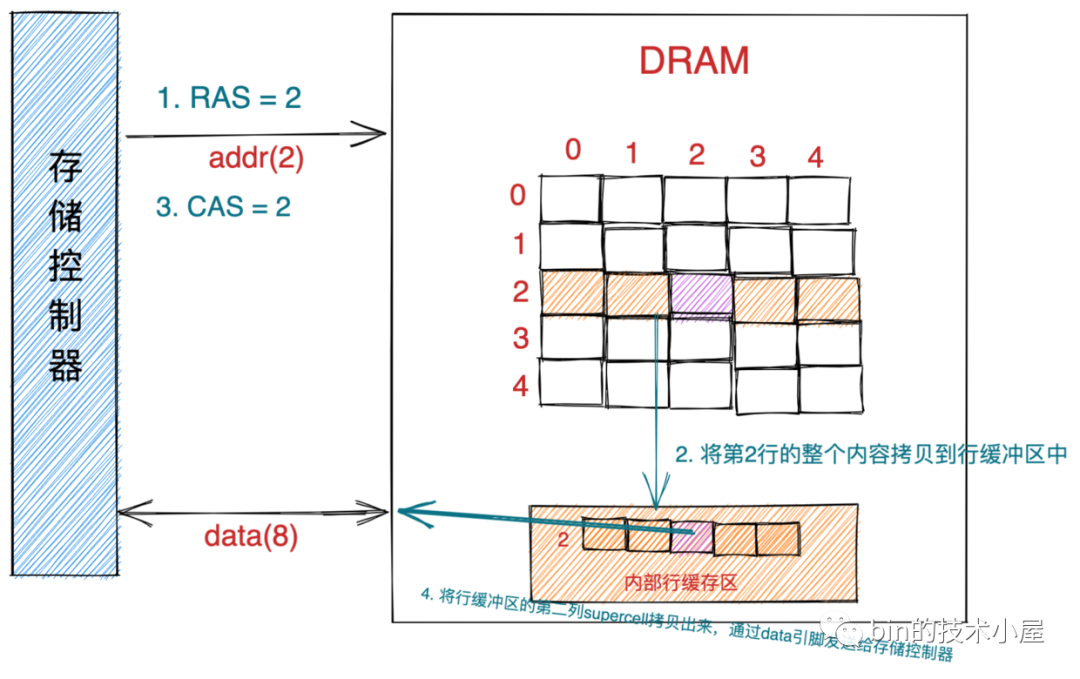
我們現在就以讀取上圖中坐標地址為(2,2)的 supercell 為例,來說明訪問 DRAM 晶片的過程。
-
首先存儲控制器將行地址 RAS = 2 通過地址引腳發送給 DRAM 晶片。
-
DRAM 晶片根據 RAS = 2 將二維矩陣中的第二行的全部內容拷貝到內部行緩衝區中。
-
接下來存儲控制器會通過地址引腳發送 CAS = 2 到 DRAM 晶片中。
-
DRAM晶片從內部行緩衝區中根據 CAS = 2 拷貝出第二列的 supercell 並通過數據引腳發送給存儲控制器。
DRAM 晶片的 IO 單位為一個 supercell ,也就是一個位元組(8 bit)。
8.2 CPU 如何讀寫主存
前邊我們介紹了記憶體的物理結構,以及如何訪問記憶體中的 DRAM 晶片獲取 supercell 中存儲的數據(一個位元組)。本小節我們來介紹下 CPU 是如何訪問記憶體的:
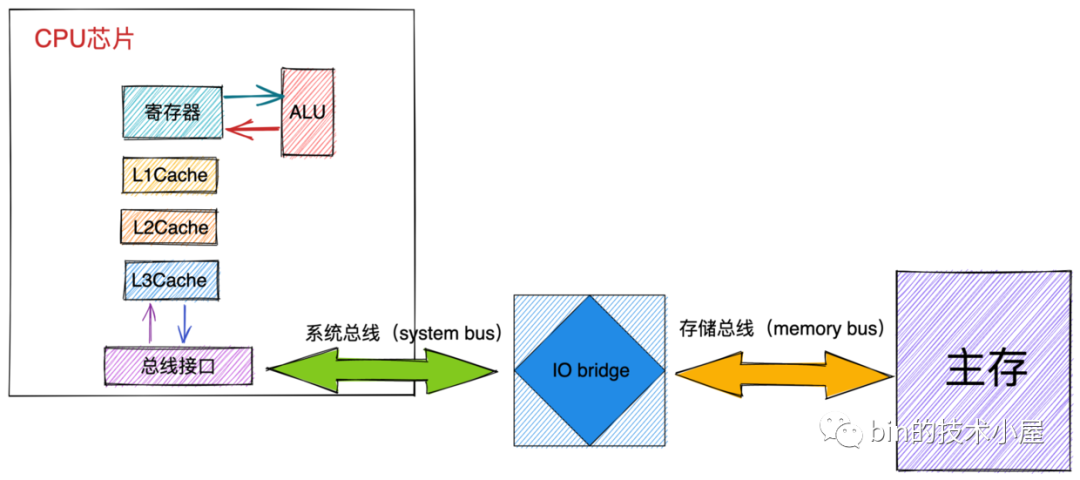
CPU 與記憶體之間的數據交互是通過匯流排(bus)完成的,而數據在匯流排上的傳送是通過一系列的步驟完成的,這些步驟稱為匯流排事務(bus transaction)。
其中數據從記憶體傳送到 CPU 稱之為讀事務(read transaction),數據從 CPU 傳送到記憶體稱之為寫事務(write transaction)。
匯流排上傳輸的訊號包括:地址訊號,數據訊號,控制訊號。其中控制匯流排上傳輸的控制訊號可以同步事務,並能夠標識出當前正在被執行的事務資訊:
- 當前這個事務是到記憶體的?還是到磁碟的?或者是到其他 IO 設備的?
- 這個事務是讀還是寫?
- 匯流排上傳輸的地址訊號(物理記憶體地址),還是數據訊號(數據)?。
這裡大家需要注意匯流排上傳輸的地址均為物理記憶體地址。比如:在 MESI 快取一致性協議中當 CPU core0 修改欄位 a 的值時,其他 CPU 核心會在匯流排上嗅探欄位 a 的物理記憶體地址,如果嗅探到匯流排上出現欄位 a 的物理記憶體地址,說明有人在修改欄位 a,這樣其他 CPU 核心就會失效欄位 a 所在的 cache line 。
如上圖所示,其中系統匯流排是連接 CPU 與 IO bridge 的,存儲匯流排是來連接 IO bridge 和主存的。
IO bridge 負責將系統匯流排上的電子訊號轉換成存儲匯流排上的電子訊號。IO bridge 也會將系統匯流排和存儲匯流排連接到IO匯流排(磁碟等IO設備)上。這裡我們看到 IO bridge 其實起的作用就是轉換不同匯流排上的電子訊號。
8.3 CPU 從記憶體讀取數據過程
假設 CPU 現在需要將物理記憶體地址為 A 的內容載入到暫存器中進行運算。
大家需要注意的是 CPU 只會訪問虛擬記憶體,在操作匯流排之前,需要把虛擬記憶體地址轉換為物理記憶體地址,匯流排上傳輸的都是物理記憶體地址,這裡省略了虛擬記憶體地址到物理記憶體地址的轉換過程,這部分內容筆者會在後續文章的相關章節詳細為大家講解,這裡我們聚焦如果通過物理記憶體地址讀取記憶體數據。
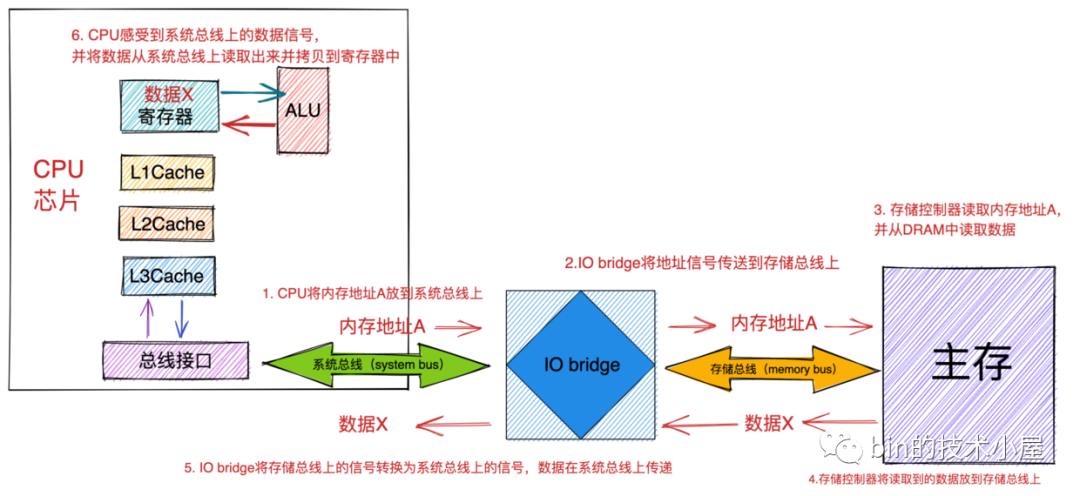
首先 CPU 晶片中的匯流排介面會在匯流排上發起讀事務(read transaction)。 該讀事務分為以下步驟進行:
-
CPU 將物理記憶體地址 A 放到系統匯流排上。隨後 IO bridge 將訊號傳遞到存儲匯流排上。
-
主存感受到存儲匯流排上的地址訊號並通過存儲控制器將存儲匯流排上的物理記憶體地址 A 讀取出來。
-
存儲控制器通過物理記憶體地址 A 定位到具體的存儲器模組,從 DRAM 晶片中取出物理記憶體地址 A 對應的數據 X。
-
存儲控制器將讀取到的數據 X 放到存儲匯流排上,隨後 IO bridge 將存儲匯流排上的數據訊號轉換為系統匯流排上的數據訊號,然後繼續沿著系統匯流排傳遞。
-
CPU 晶片感受到系統匯流排上的數據訊號,將數據從系統匯流排上讀取出來並拷貝到暫存器中。
以上就是 CPU 讀取記憶體數據到暫存器中的完整過程。
但是其中還涉及到一個重要的過程,這裡我們還是需要攤開來介紹一下,那就是存儲控制器如何通過物理記憶體地址 A 從主存中讀取出對應的數據 X 的?
接下來我們結合前邊介紹的記憶體結構以及從 DRAM 晶片讀取數據的過程,來總體介紹下如何從主存中讀取數據。
8.4 如何根據物理記憶體地址從主存中讀取數據
前邊介紹到,當主存中的存儲控制器感受到了存儲匯流排上的地址訊號時,會將記憶體地址從存儲匯流排上讀取出來。
隨後會通過記憶體地址定位到具體的存儲器模組。還記得記憶體結構中的存儲器模組嗎 ?
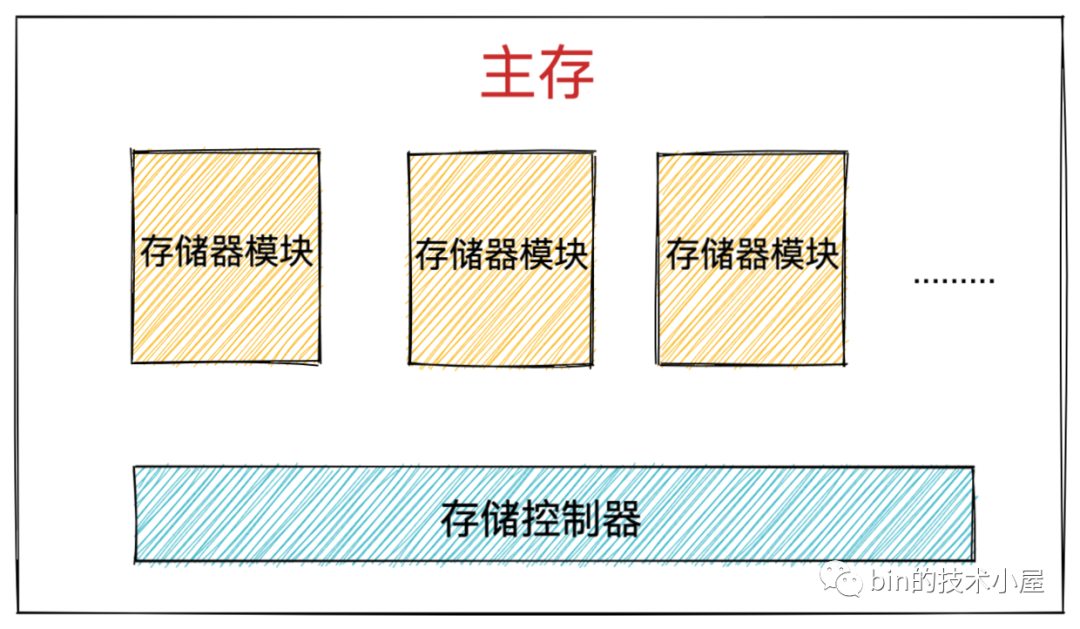
而每個存儲器模組中包含了 8 個 DRAM 晶片,編號從 0 - 7 。
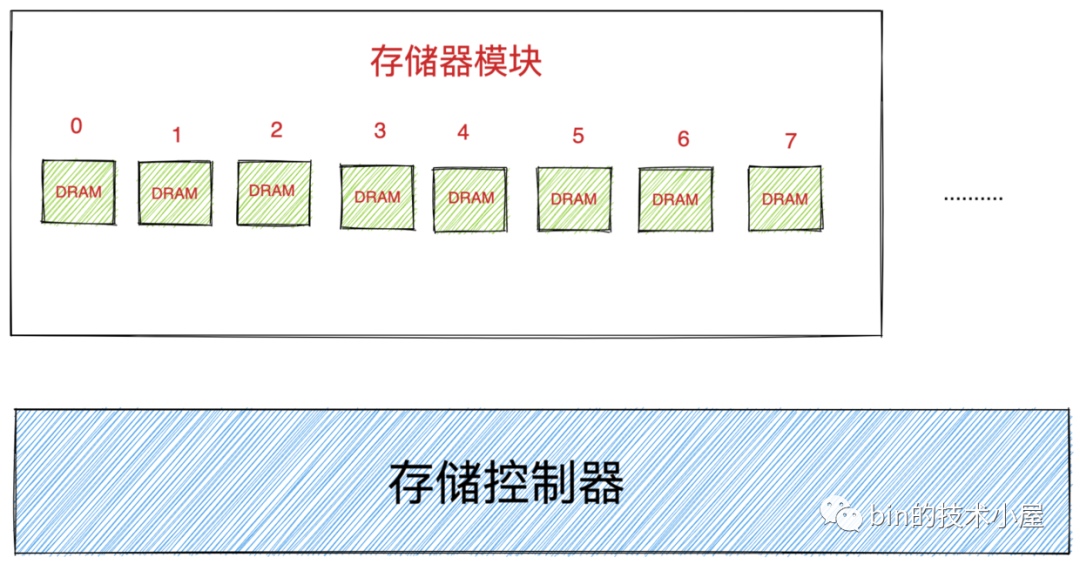
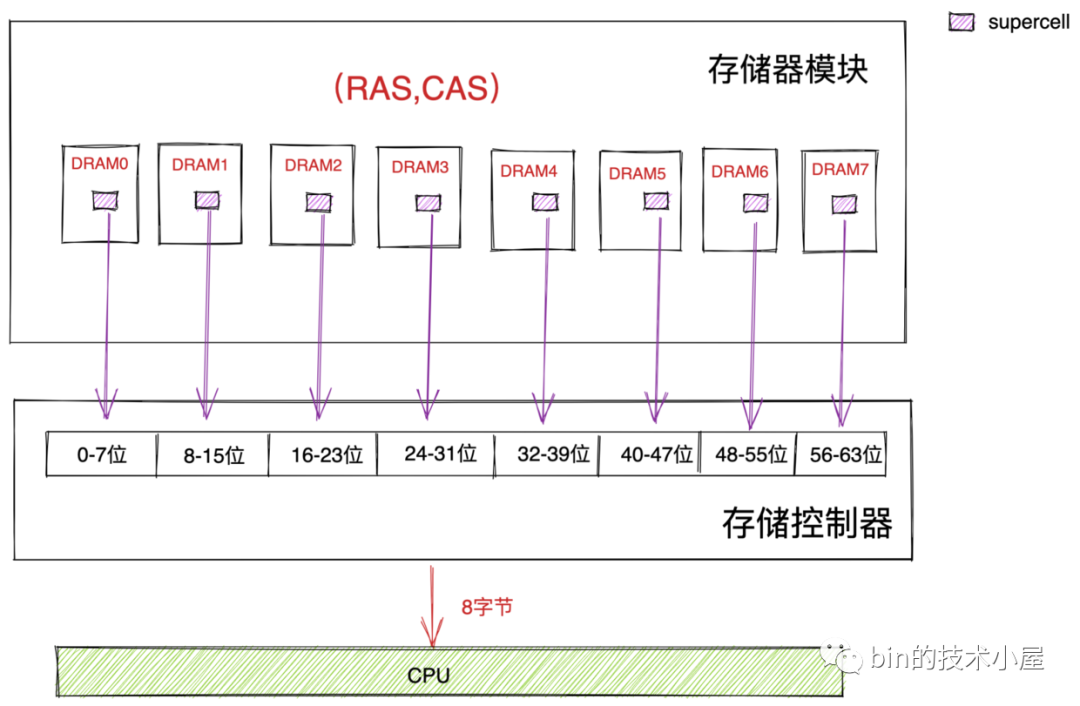
存儲控制器會將物理記憶體地址轉換為 DRAM 晶片中 supercell 在二維矩陣中的坐標地址(RAS,CAS)。並將這個坐標地址發送給對應的存儲器模組。隨後存儲器模組會將 RAS 和 CAS 廣播到存儲器模組中的所有 DRAM 晶片。依次通過 (RAS,CAS) 從 DRAM0 到 DRAM7 讀取到相應的 supercell 。
我們知道一個 supercell 存儲了一個位元組( 8 bit ) 數據,這裡我們從 DRAM0 到 DRAM7 依次讀取到了 8 個 supercell 也就是 8 個位元組,然後將這 8 個位元組返回給存儲控制器,由存儲控制器將數據放到存儲匯流排上。
CPU 總是以 word size 為單位從記憶體中讀取數據,在 64 位處理器中的 word size 為 8 個位元組。64 位的記憶體每次只能吞吐 8 個位元組。
CPU 每次會向記憶體讀寫一個 cache line 大小的數據( 64 個位元組),但是記憶體一次只能吞吐 8 個位元組。
所以在物理記憶體地址對應的存儲器模組中,DRAM0 晶片存儲第一個低位位元組( supercell ),DRAM1 晶片存儲第二個位元組,......依次類推 DRAM7 晶片存儲最後一個高位位元組。
由於存儲器模組中這種由 8 個 DRAM 晶片組成的物理存儲結構的限制,記憶體讀取數據只能是按照物理記憶體地址,8 個位元組 8 個位元組地順序讀取數據。所以說記憶體一次讀取和寫入的單位是 8 個位元組。
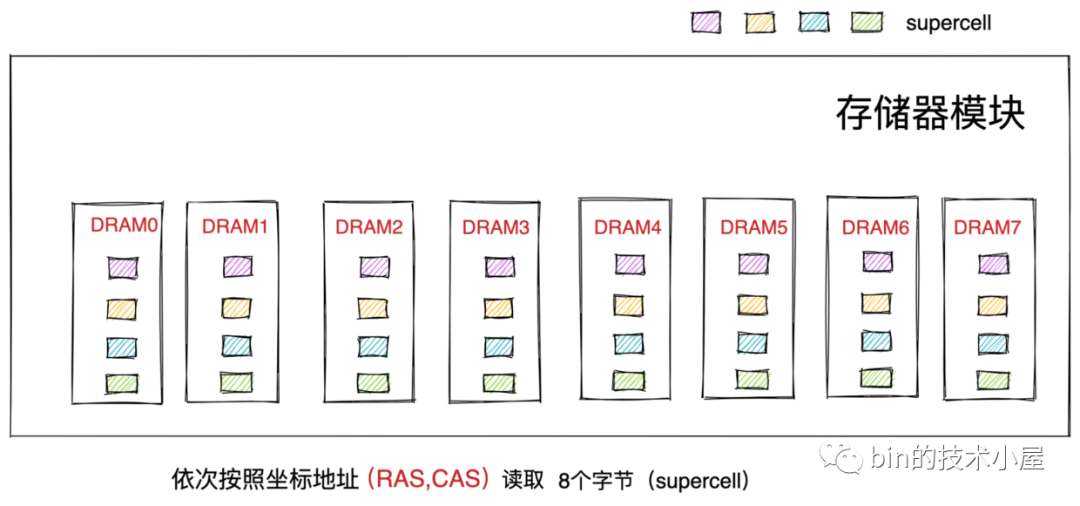
而且在程式設計師眼裡連續的物理記憶體地址實際上在物理上是不連續的。因為這連續的 8 個位元組其實是存儲於不同的 DRAM 晶片上的。每個 DRAM 晶片存儲一個位元組(supercell)
8.5 CPU 向記憶體寫入數據過程
我們現在假設 CPU 要將暫存器中的數據 X 寫到物理記憶體地址 A 中。同樣的道理,CPU 晶片中的匯流排介面會向匯流排發起寫事務(write transaction)。寫事務步驟如下:
-
CPU 將要寫入的物理記憶體地址 A 放入系統匯流排上。
-
通過 IO bridge 的訊號轉換,將物理記憶體地址 A 傳遞到存儲匯流排上。
-
存儲控制器感受到存儲匯流排上的地址訊號,將物理記憶體地址 A 從存儲匯流排上讀取出來,並等待數據的到達。
-
CPU 將暫存器中的數據拷貝到系統匯流排上,通過 IO bridge 的訊號轉換,將數據傳遞到存儲匯流排上。
-
存儲控制器感受到存儲匯流排上的數據訊號,將數據從存儲匯流排上讀取出來。
-
存儲控制器通過記憶體地址 A 定位到具體的存儲器模組,最後將數據寫入存儲器模組中的 8 個 DRAM 晶片中。
總結
本文我們從虛擬記憶體地址開始聊起,一直到物理記憶體地址結束,包含的資訊量還是比較大的。首先筆者通過一個進程的運行實例為大家引出了內核引入虛擬記憶體空間的目的及其需要解決的問題。
在我們有了虛擬記憶體空間的概念之後,筆者又近一步為大家介紹了內核如何劃分用戶態虛擬記憶體空間和內核態虛擬記憶體空間,並在次基礎之上分別從 32 位體系結構和 64 位體系結構的角度詳細闡述了 Linux 虛擬記憶體空間的整體布局分布。
-
我們可以通過
cat /proc/pid/maps或者pmap pid命令來查看進程用戶態虛擬記憶體空間的實際分布。 -
還可以通過
cat /proc/iomem命令來查看進程內核態虛擬記憶體空間的的實際分布。
在我們清楚了 Linux 虛擬記憶體空間的整體布局分布之後,筆者又介紹了 Linux 內核如何對分布在虛擬記憶體空間中的各個虛擬記憶體區域進行管理,以及每個虛擬記憶體區域的作用。在這個過程中還介紹了相關的內核數據結構,近一步從內核源碼實現角度加深大家對虛擬記憶體空間的理解。
最後筆者介紹了物理記憶體的結構,以及 CPU 如何通過物理記憶體地址來讀寫記憶體中的數據。這裡筆者需要特地再次強調的是 CPU 只會訪問虛擬記憶體地址,只不過在操作匯流排之前,通過一個地址轉換硬體將虛擬記憶體地址轉換為物理記憶體地址,然後將物理記憶體地址作為地址訊號放在匯流排上傳輸,由於地址轉換的內容和本文主旨無關,考慮到文章的篇幅以及複雜性,筆者就沒有過多的介紹。
好了,本文的全部內容到這裡就結束了,感謝大家的收看,我們下篇文章見~~~