憑藉SpringBoot整合Neo4j,我理清了《雷神》中錯綜複雜的人物關係
原創:微信公眾號
碼農參上,歡迎分享,轉載請保留出處。
哈嘍大家好啊,我是Hydra。
雖然距離中秋放假還要熬過漫長的兩天,不過也有個好消息,今天是《雷神4》上線Disney+流媒體的日子(也就是說我們稍後就可以網盤見了)~
了解北歐神話的小夥伴們應該知道,它的神話體系可以用一個字來形容,那就是『亂』!就像是雷神3中下面這張錯綜複雜的關係網,也只能算是其中的一支半節。
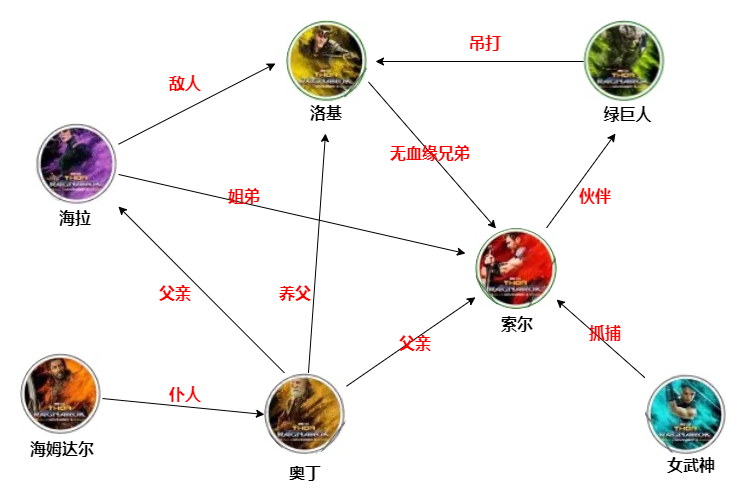
而我們在上一篇文章中,介紹了關於知識圖譜的一些基本理論知識,俗話說的好,光說不練假把式,今天我們就來看看,如何在springboot項目中,實現並呈現這張雷神中複雜的人物關係圖譜。
本文將通過下面幾個主要模組,構建自然界中實體間的聯繫,實現知識圖譜描述:
- 圖資料庫neo4j安裝
- 簡單CQL入門
- springboot整合neo4j
- 文本SPO抽取
- 動態構建知識圖譜
Neo4j安裝
知識圖譜的底層依賴於關鍵的圖資料庫,在這裡我們選擇Neo4j,它是一款高性能的 nosql 圖形資料庫,能夠將結構化的數據存儲在圖而不是表中。
首先進行安裝,打開官網下載Neo4j的安裝包,下載免費的community社區版就可以,地址放在下面:
需要注意的是,neo4j 4.x以上的版本都需要依賴 jdk11環境,所以如果運行環境是jdk8的話,那麼還是老老實實下載3.x版本就行,下載解壓完成後,在bin目錄下通過命令啟動:
neo4j console
啟動後在瀏覽器訪問安裝伺服器的7474埠,就可以打開neo4j的控制台頁面:
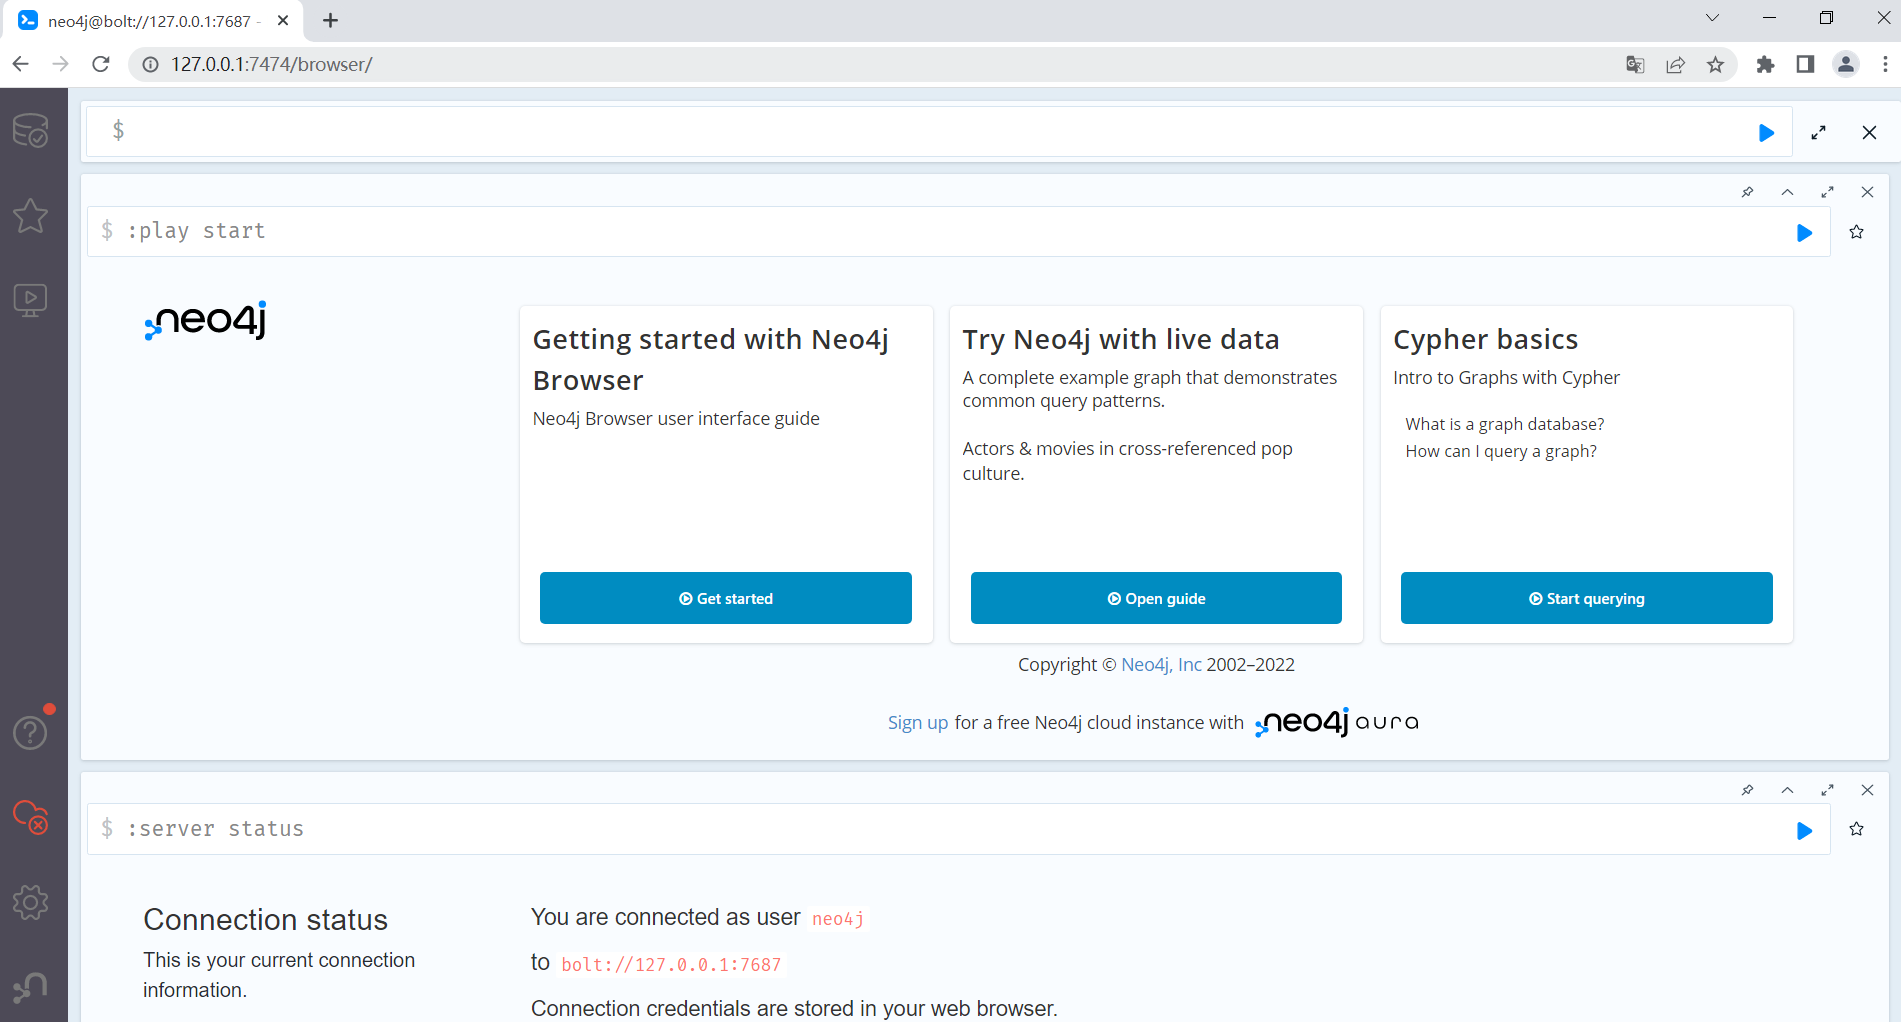
通過左側的導航欄,我們依次可以查看存儲的數據、一些基礎查詢的示例以及一些幫助說明。
而頂部帶有$符號的輸入框,可以用來輸入neo4j特有的CQL查詢語句並執行,具體的語法我們放在下面介紹。
簡單CQL入門
就像我們平常使用關係型資料庫中的SQL語句一樣,neo4j中可以使用Cypher查詢語言(CQL)進行圖形資料庫的查詢,我們簡單來看一下增刪改查的用法。
添加節點
在CQL中,可以通過CREATE命令去創建一個節點,創建不含有屬性節點的語法如下:
CREATE (<node-name>:<label-name>)
在CREATE語句中,包含兩個基礎元素,節點名稱node-name和標籤名稱lable-name。標籤名稱相當於關係型資料庫中的表名,而節點名稱則代指這一條數據。
以下面的CREATE語句為例,就相當於在Person這張表中創建一條沒有屬性的空數據。
CREATE (索爾:Person)
而創建包含屬性的節點時,可以在標籤名稱後面追加一個描繪屬性的json字元串:
CREATE (
   <node-name>:<label-name>
   {
      <key1>:<value1>,
      …
      <keyN>:<valueN>
   }
)
用下面的語句創建一個包含屬性的節點:
CREATE (洛基:Person {name:"洛基",title:"詭計之神"})
查詢節點
在創建完節點後,我們就可以使用MATCH匹配命令查詢已存在的節點及屬性的數據,命令的格式如下:
MATCH (<node-name>:<label-name>)
通常,MATCH命令在後面配合RETURN、DELETE等命令使用,執行具體的返回或刪除等操作。
執行下面的命令:
MATCH (p:Person) RETURN p
查看可視化的顯示結果:
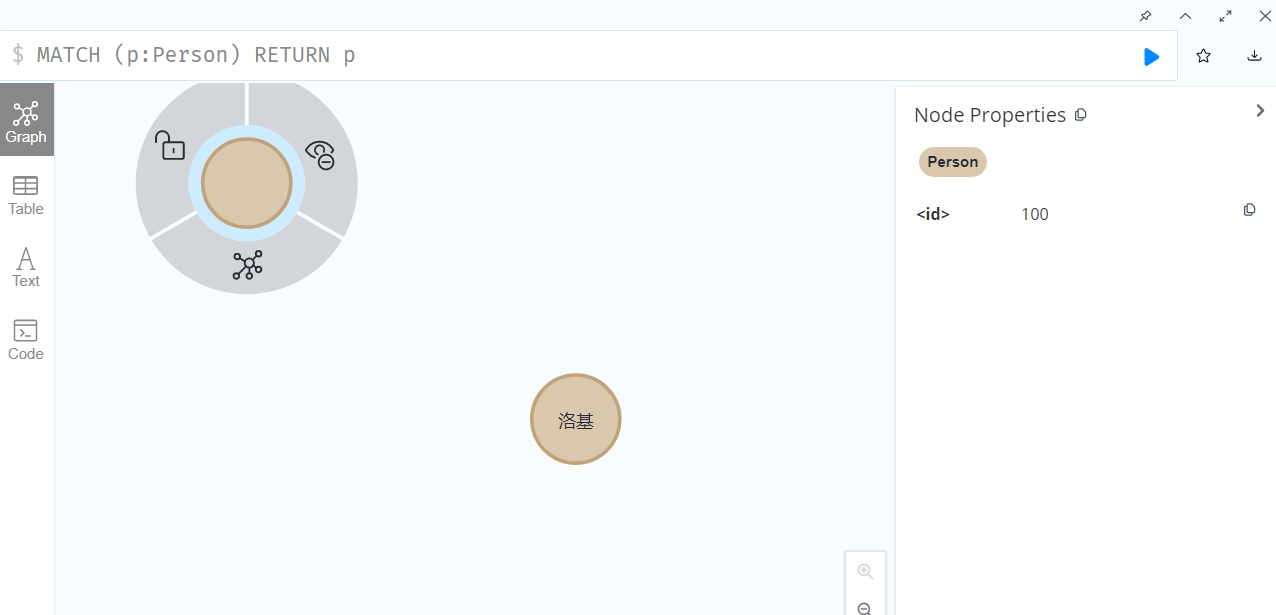
可以看到上面添加的兩個節點,分別是不包含屬性的空節點和包含屬性的節點,並且所有節點會有一個默認生成的id作為唯一標識。
刪除節點
接下來,我們刪除之前創建的不包含屬性的無用節點,上面提到過,需要使用MATCH配合DELETE進行刪除。
MATCH (p:Person) WHERE id(p)=100
DELETE p
在這條刪除語句中,額外使用了WHERE過濾條件,它與SQL中的WHERE非常相似,命令中通過節點的id進行了過濾。
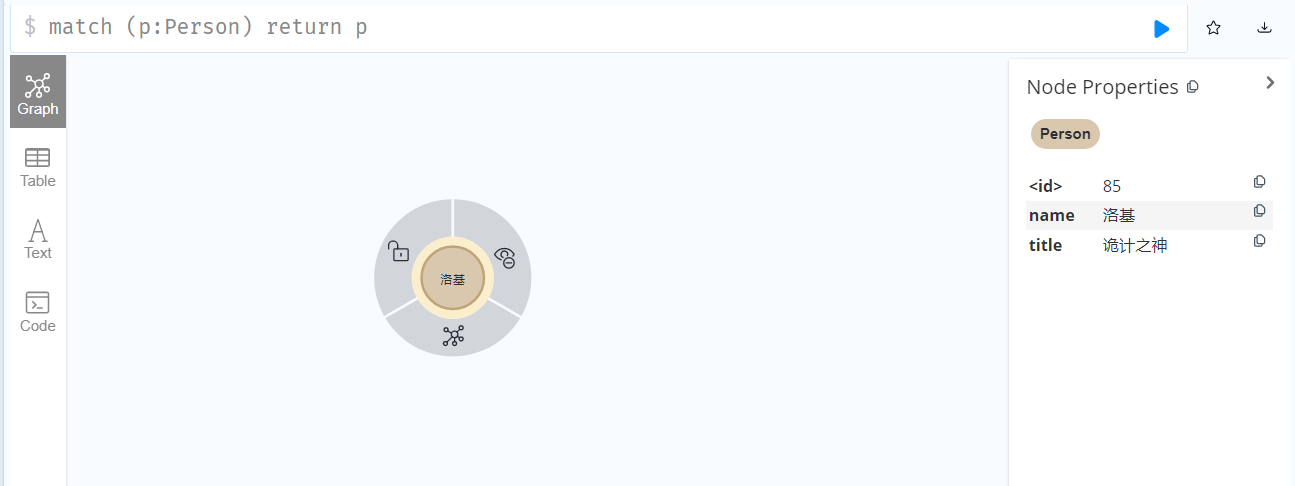
刪除完成後,再次執行查詢操作,可以看到只保留了洛基這一個節點:
添加關聯
在neo4j圖資料庫中,遵循屬性圖模型來存儲和管理數據,也就是說我們可以維護節點之間的關係。
在上面,我們創建過一個節點,所以還需要再創建一個節點作為關係的兩端:
CREATE (p:Person {name:"索爾",title:"雷神"})
創建關係的基本語法如下:
CREATE (<node-name1>:<label-name1>)
- [<relation-name>:<relation-label-name>]
-> (<node-name2>:<label-name2>)
當然,也可以利用已經存在的節點創建關係,下面我們藉助MATCH先進行查詢,再將結果進行關聯,創建兩個節點之間的關聯關係:
MATCH (m:Person),(n:Person)
WHERE m.name='索爾' and n.name='洛基'
CREATE (m)-[r:BROTHER {relation:"無血緣兄弟"}]->(n)
RETURN r
添加完成後,可以通過關係查詢符合條件的節點及關係:
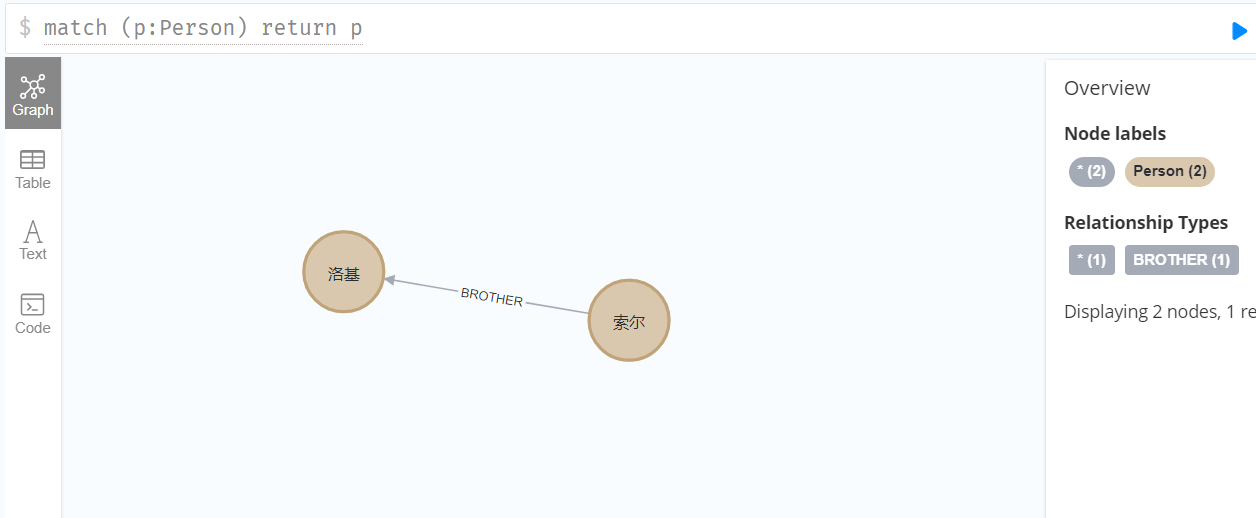
MATCH (m:Person)-[re:BROTHER]->(n:Person)
RETURN m,re,n
可以看到兩者之間已經添加了關聯:
需要注意的是,如果節點被添加了關聯關係後,單純刪除節點的話會報錯,:
Neo.ClientError.Schema.ConstraintValidationFailed
Cannot delete node<85>, because it still has relationships. To delete this node, you must first delete its relationships.
這時,需要在刪除節點時同時刪除關聯關係:
MATCH (m:Person)-[r:BROTHER]->(n:Person)
DELETE m,r
執行上面的語句,就會在刪除節點的同時,刪除它所包含的關聯關係了。
那麼,簡單的cql語句入門到此為止,它已經基本能夠滿足我們的簡單業務場景了,下面我們開始在springboot中整合neo4j。
SpringBoot整合Neo4j
創建一個springboot項目,這裡使用的是2.3.4版本,引入neo4j的依賴坐標:
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-data-neo4j</artifactId>
</dependency>
在application.yml中配置neo4j連接資訊:
spring:
  data:
    neo4j:
      uri: bolt://127.0.0.1:7687
      username: neo4j
      password: 123456
大家如果對jpa的應用非常熟練的話,那麼接下來的過程可以說是輕車熟路,因為它們基本上是一個模式,同樣是構建model層、repository層,然後在此基礎上操作自定義或模板方法就可以了。
節點實體
我們可以使用基於註解的實體映射來描述圖中的節點,通過在實體類上添加@NodeEntity表明它是圖中的一個節點實體,在屬性上添加@Property代表它是節點中的具體屬性。
@Data
@NodeEntity(label = "Person")
public class Node {
    @Id
    @GeneratedValue
    private Long id;

    @Property(name = "name")
    private String name;

    @Property(name = "title")
    private String title;
}
這樣一個實體類,就代表它創建的實例節點的<label-name>為Person,並且每個節點擁有name和title兩個屬性。
Repository持久層
對上面的實體構建持久層介面,繼承Neo4jRepository介面,並在介面上添加@Repository註解即可。
@Repository
public interface NodeRepository extends Neo4jRepository<Node,Long> {
    @Query("MATCH p=(n:Person) RETURN p")
    List<Node> selectAll();

    @Query("MATCH(p:Person{name:{name}}) return p")
    Node findByName(String name);
}
在介面中添加了個兩個方法,供後面測試使用,selectAll()用於返回全部數據,findByName()用於根據name查詢特定的節點。
接下來,在service層中調用repository層的模板方法:
@Service
@AllArgsConstructor
public class NodeServiceImpl implements NodeService {
    private final NodeRepository nodeRepository;

    @Override
    public Node save(Node node) {
        Node save = nodeRepository.save(node);
        return save;
    }
}
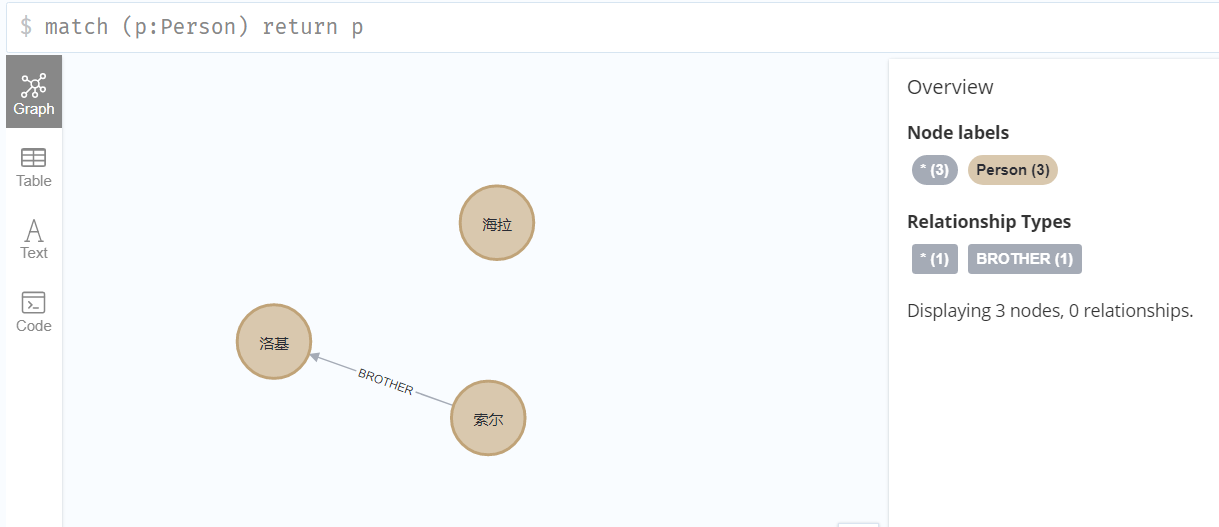
前端調用save()介面,添加一個節點後,再到控制台用查詢語句進行查詢,可以看到新的節點已經通過介面方式被添加到了圖中:
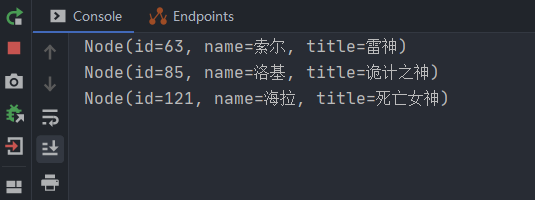
在service中再添加一個方法,用於查詢全部節點,直接調用我們在NodeRepository中定義的selectAll()方法:
@Override
public List<Node> getAll() {
    List<Node> nodes = nodeRepository.selectAll();
    nodes.forEach(System.out::println);
    return nodes;
}
在控制台列印了查詢結果:
對節點的操作我們就介紹到這裡,接下來開始構建節點間的關聯關係。
關聯關係
在neo4j中,關聯關係其實也可以看做一種特殊的實體,所以可以用實體類來對其進行描述。與節點不同,需要在類上添加@RelationshipEntity註解,並通過@StartNode和@EndNode指定關聯關係的開始和結束節點。
@Data
@RelationshipEntity(type = "Relation")
public class Relation {
    @Id
    @GeneratedValue
    private Long id;

    @StartNode
    private Node startNode;

    @EndNode
    private Node endNode;

    @Property
    private String relation;
}
同樣,接下來也為它創建一個持久層的介面:
@Repository
public interface RelationRepository extends Neo4jRepository<Relation,Long> {
    @Query("MATCH p=(n:Person)-[r:Relation]->(m:Person) " +
            "WHERE id(n)={startNode} and id(m)={endNode} and r.relation={relation}" +
            "RETURN p")
    List<Relation> findRelation(@Param("startNode") Node startNode,
                                @Param("endNode") Node endNode,
                                @Param("relation") String relation);
}
在介面中自定義了一個根據起始節點、結束節點以及關聯內容查詢關聯關係的方法,我們會在後面用到。
創建關聯
在service層中,創建提供一個根據節點名稱構建關聯關係的方法:
@Override
public void bind(String name1, String name2, String relationName) {
    Node start = nodeRepository.findByName(name1);
    Node end = nodeRepository.findByName(name2);

    Relation relation =new Relation();
    relation.setStartNode(start);
    relation.setEndNode(end);
    relation.setRelation(relationName);

    relationRepository.save(relation);
}
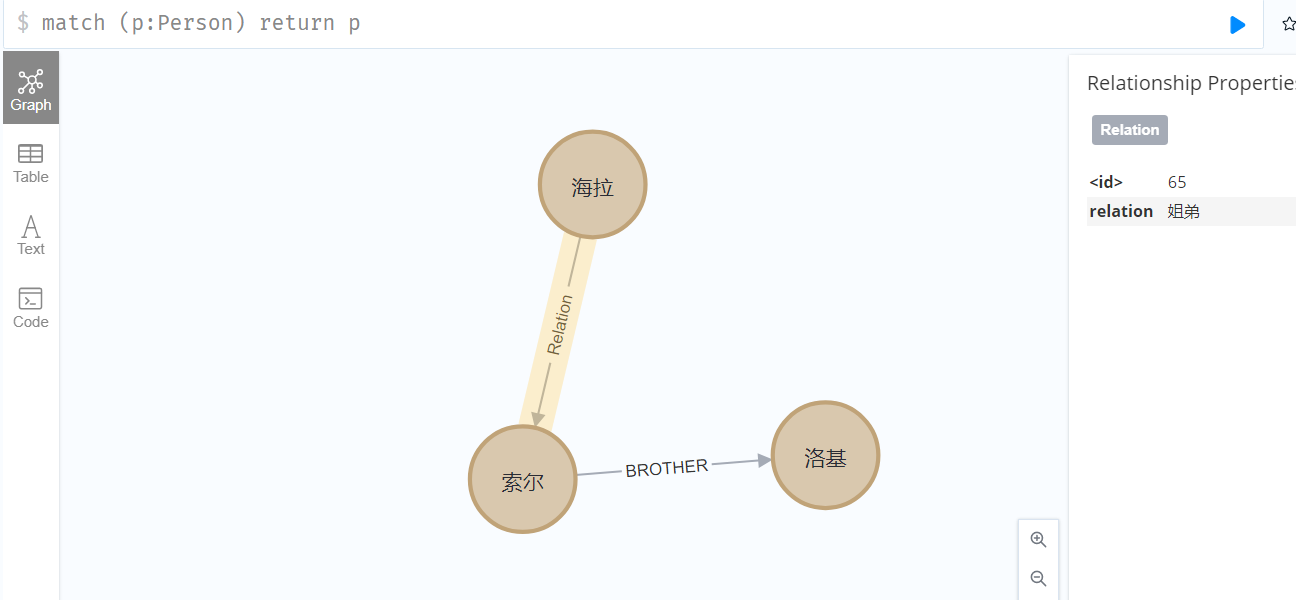
通過介面調用這個方法,綁定海拉和索爾之間的關係後,查詢結果:
文本SPO抽取
在項目中構建知識圖譜時,很大一部分場景是基於非結構化的數據,而不是由我們手動輸入確定圖譜中的節點或關係。因此,我們需要基於文本進行知識抽取的能力,簡單來說就是要在一段文本中抽取出SPO主謂賓三元組,來構成圖譜中的點和邊。
這裡我們藉助Git上一個現成的工具類,來進行文本的語義分析和SPO三元組的抽取工作,項目地址:
這個項目雖然比較簡單一共就兩個類兩個資源文件,但其中的工具類卻能夠有效幫助我們完成句子中的主謂賓的提取,使用它前需要先引入依賴的坐標:
<dependency>
    <groupId>com.hankcs</groupId>
    <artifactId>hanlp</artifactId>
    <version>portable-1.2.4</version>
</dependency>
<dependency>
    <groupId>edu.stanford.nlp</groupId>
    <artifactId>stanford-parser</artifactId>
    <version>3.3.1</version>
</dependency>
然後把這個項目中com.hankcs.nlp.lex包下的兩個類拷到我們的項目中,把resources下的models目錄拷貝到我們的resources下。
完成上面的步驟後,調用MainPartExtractor工具類中的方法,進行一下簡單的文本SPO抽取測試:
public void mpTest(){
    String[] testCaseArray = {
            "我一直很喜歡你",
            "你被我喜歡",
            "美麗又善良的你被卑微的我深深的喜歡著……",
            "小米公司主要生產智慧手機",
            "他送給了我一份禮物",
            "這類演算法在有限的一段時間內終止",
            "如果大海能夠帶走我的哀愁",
            "天青色等煙雨,而我在等你",
            "我昨天看見了一個非常可愛的小孩"
    };
    for (String testCase : testCaseArray) {
        MainPart mp = MainPartExtractor.getMainPart(testCase);
        System.out.printf("%s   %s   %s \n",
                GraphUtil.getNodeValue(mp.getSubject()),
                GraphUtil.getNodeValue(mp.getPredicate()),
                GraphUtil.getNodeValue(mp.getObject()));
    }
}
在處理結果MainPart中,比較重要的是其中的subject、predicate和object三個屬性,它們的類型是TreeGraphNode,封裝了句子的主謂賓語成分。下面我們看一下測試結果:
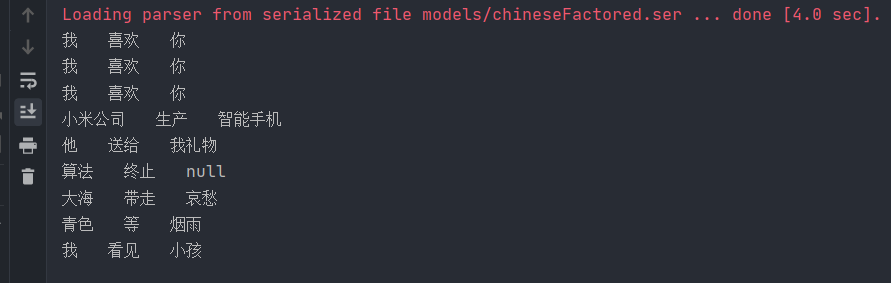
可以看到,如果句子中有明確的主謂賓語,那麼則會進行抽取。如果某一項為空,則該項為null,其餘句子結構也能夠正常抽取。
動態構建知識圖譜
在上面的基礎上,我們就可以在項目中動態構建知識圖譜了,新建一個TextAnalysisServiceImpl,其中實現兩個關鍵方法。
首先是根據句子中抽取的主語或賓語在neo4j中創建節點的方法,這裡根據節點的name判斷是否為已存在的節點,如果存在則直接返回,不存在則添加:
private Node addNode(TreeGraphNode treeGraphNode){
    String nodeName = GraphUtil.getNodeValue(treeGraphNode);

    Node existNode = nodeRepository.findByName(nodeName);
    if (Objects.nonNull(existNode))
        return existNode;

    Node node =new Node();
    node.setName(nodeName);
    return nodeRepository.save(node);
}
然後是核心方法,說白了也很簡單,參數傳進來一個句子作為文本先進行spo的抽取,對實體進行Node的保存,再查看是否已經存在同名的關係,如果不存在則創建關聯關係,存在的話則不重複創建。下面是關鍵程式碼:
@Override
public List<Relation> parseAndBind(String sentence) {
    MainPart mp = MainPartExtractor.getMainPart(sentence);

    TreeGraphNode subject = mp.getSubject();    //主語
    TreeGraphNode predicate = mp.getPredicate();//謂語
    TreeGraphNode object = mp.getObject();      //賓語

    if (Objects.isNull(subject) || Objects.isNull(object))
        return null;

    Node startNode = addNode(subject);
    Node endNode = addNode(object);
    String relationName = GraphUtil.getNodeValue(predicate);//關係詞

    List<Relation> oldRelation = relationRepository
            .findRelation(startNode, endNode,relationName);
    if (!oldRelation.isEmpty())
        return oldRelation;

    Relation botRelation=new Relation();
    botRelation.setStartNode(startNode);
    botRelation.setEndNode(endNode);
    botRelation.setRelation(relationName);
    Relation relation = relationRepository.save(botRelation);

    return Arrays.asList(relation);
}
創建一個簡單的controller介面,用於接收文本:
@GetMapping("parse")
public List<Relation> parse(String sentence) {
    return textAnalysisService.parseAndBind(sentence);
}
接下來,我們從前端傳入下面幾個句子文本進行測試:
海拉又被稱為死亡女神
死亡女神捏碎了雷神之錘
雷神之錘屬於索爾
調用完成後,我們再來看看neo4j中的圖形關係,可以看到海拉、死亡女神、索爾、錘這些實體被關聯在了一起:
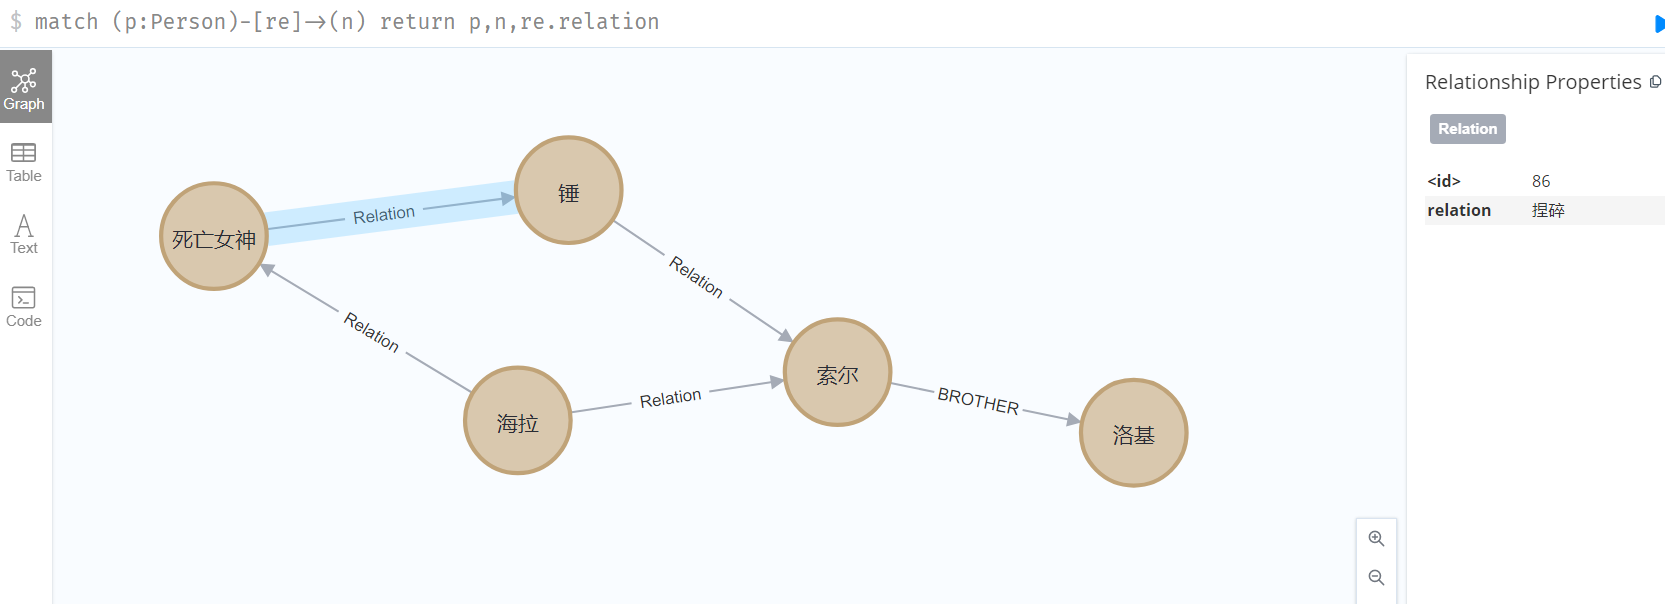
到這裡,一個簡單的文本處理和圖譜創建的流程就被完整的串了起來,但是這個流程還是比較粗糙,之後還需要在下面幾個方面繼續優化:
- 當前使用的還是單一類型的節點和關聯關係,後續可以在程式碼中豐富更多類型的節點和關聯關係實體類
- 文中使用的文本spo抽取效果一般,如果應用於企業項目,那麼建議基於更精確的nlp演算法去做語義分析
- 當前抽取的節點只包含了實體的名稱,不包含具體的屬性,後續需要繼續完善補充實體的屬性
- 完善知識融合,主要是添加實體的指代消解以及屬性的融合功能
總之,需要完善的部分還有不少,項目程式碼我也傳到git上了,大家如果有興趣可以看看,後續如果有時間的話我也會基於這個版本繼續改進,公眾號後台回復『neo』獲取項目地址。
那麼,這次的分享就到這裡,我是Hydra,我們下篇再見。
作者簡介,
碼農參上,一個熱愛分享的公眾號,有趣、深入、直接,與你聊聊技術。歡迎添加好友,進一步交流。

