大規模數據分析統一引擎Spark最新版本3.3.0入門實戰
@
概述
定義
Spark 官網最新文檔文檔 //spark.apache.org/docs/latest/
Spark GitHub源碼地址 //github.com/search?q=spark
Apache Spark™是一個開源的、分散式、多語言引擎,用於在單節點機器或集群上執行數據工程、數據科學和機器學習,用於大規模數據分析的統一引擎。目前最新版本為3.3.0
- Spark是用於大規模數據處理的統一分析引擎,也可以說是目前用於可伸縮計算的最廣泛的引擎,成千上萬的公司包括財富500強中的80%都在使用。
- Spark生態系統集成了豐富的數據科學、機器學習、SQL分析和BI、存儲和基礎設施等框架,並將這個生態使用可以擴展到數千台機器大規模數據使用。
- Spark提供了Java、Scala、Python和R的高級api,以及支援通用執行圖的優化引擎。
- Spark支援一系列豐富的高級工具,包括用於SQL和結構化數據處理的Spark SQL,用於pandas工作負載的Spark上的pandas API,用於機器學習的MLlib,用於圖形處理的GraphX,以及用於增量計算和流處理的Structured Streaming。
Hadoop與Spark的關係與區別
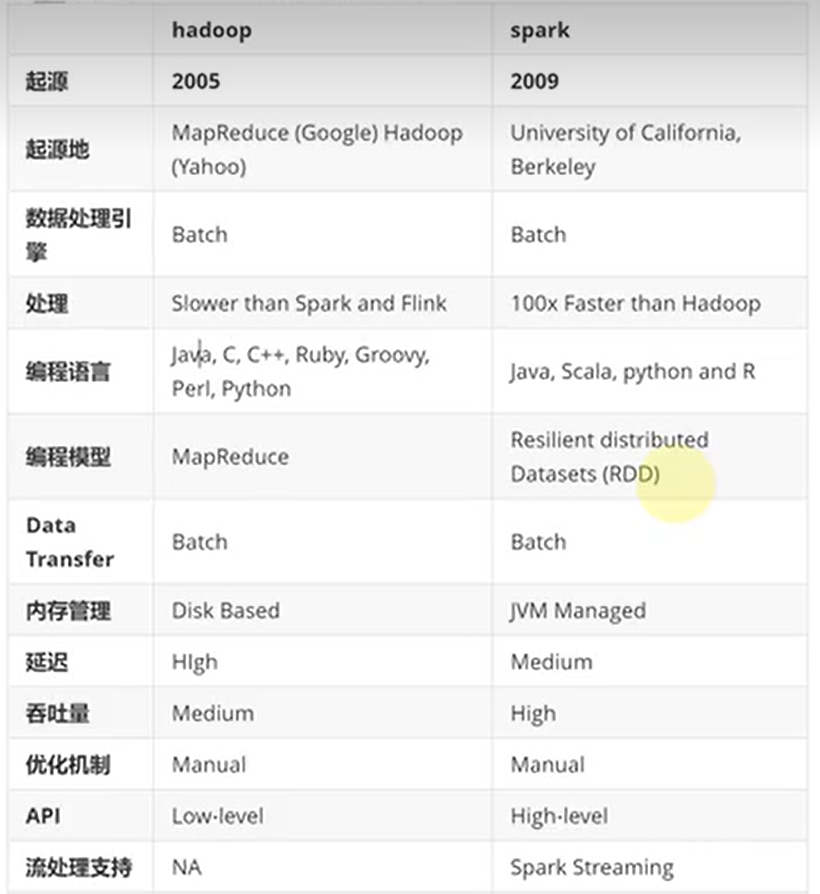
- 框架比較
- 處理流程比較
-
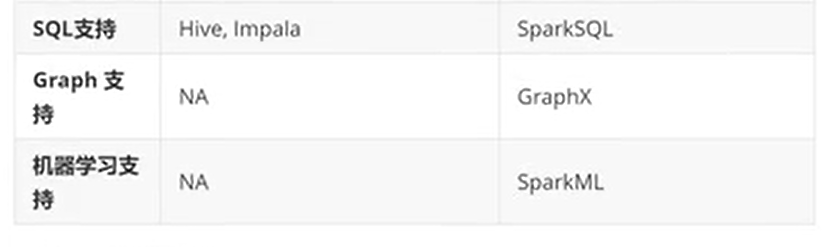
spark是借鑒了Mapreduce,並在其基礎上發展起來的,繼承了其分散式計算的優點並進行了改進,spark生態更為豐富,功能更為強大,性能更加適用範圍廣,mapreduce更簡單,穩定性好。主要區別:
- spark把運算的中間數據(shuffle階段產生的數據)存放在記憶體,迭代計算效率更高,mapreduce的中間結果需要落地,保存到磁碟;
- Spark容錯性高,它通過彈性分散式數據集RDD來實現高效容錯,RDD是一組分散式的存儲在節點記憶體中的只讀性的數據集,這些集合石彈性的,某一部分丟失或者出錯,可以通過整個數據集的計算流程的血緣關係來實現重建,mapreduce的容錯只能重新計算;
- Spark更通用,提供了transformation和action這兩大類的多功能api,另外還有流式處理sparkstreaming模組、圖計算等等,mapreduce只提供了map和reduce兩種操作,流計算及其他的模組支援比較缺乏;
- Spark框架和生態更為複雜,有RDD,血緣lineage、執行時的有向無環圖DAG,stage劃分等,很多時候spark作業都需要根據不同業務場景的需要進行調優以達到性能要求,mapreduce框架及其生態相對較為簡單,對性能的要求也相對較弱,運行較為穩定,適合長期後台運行;
- Spark計算框架對記憶體的利用和運行的並行度比mapreduce高,Spark運行容器為executor,內部ThreadPool中執行緒運行一個Task,mapreduce在執行緒內部運行container,container容器分類為MapTask和ReduceTask。Spark程式運行並行度高;
- Spark對於executor的優化,在JVM虛擬機的基礎上對記憶體彈性利用:storage memory與Execution memory的彈性擴容,使得記憶體利用效率更高;
-
特點與關鍵特性
Spark官網對其特點高度概括的四個單詞分為為:Simple-簡單、Fast-快、Scalable-可擴展、Unified-統一。
- 運行速度快。Spark使用先進的DAG(Directed Acyclic Graph,有向無環圖)執行引擎,以支援循環數據流與記憶體計算,基於記憶體的執行速度可比Hadoop MapReduce快上百倍,基於磁碟的執行速度也能快十倍。
- 簡單易使用。Spark支援使用Scala、Java、Python和R語言進行編程,簡潔的API設計有助於用戶輕鬆構建並行程式,並且可以通過Spark Shell進行互動式編程。
- 統一通用性。Spark提供了完整而強大的技術棧,包括SQL查詢、流式計算、機器學習和圖演算法組件,這些組件可以無縫整合在同一個應用中,足以應對複雜的計算。
- 運行模式多樣。Spark可運行於獨立的集群模式中,或者運行於Hadoop中,也可運行於Amazon EC2等雲環境中,並且可以訪問HDFS、Cassandra、HBase、Hive等多種數據源。
Spark關鍵特性包括:
- 批/流媒體數據:使用多種語言:Python、SQL、Scala、Java或R來統一批量和實時流處理數據。
- SQL分析:為儀錶板和特別報告執行快速的分散式ANSI SQL查詢。運行速度比大多數數據倉庫都快。
- 大規模數據科學:對pb級數據進行探索性數據分析(EDA),而不需要進行降取樣。
- 機器學習:在筆記型電腦電腦上訓練機器學習演算法,並使用相同的程式碼來擴展到由數千台機器組成的容錯集群。
組件
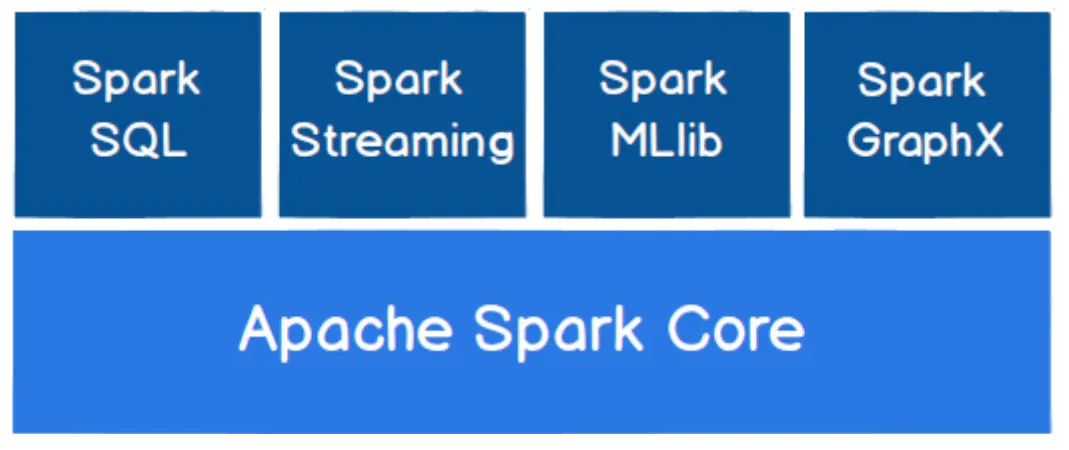
- Spark Core:為Spark的核心組件,實現了Spark的基本功能,包含任務調度、記憶體管理、錯誤恢復、與存儲系統交互等模組。Spark Core中還包含了對彈性分散式數據集(Resilient Distributed Datasets,RDD)的API定義,RDD是只讀的分區記錄的集合,只能基於在穩定物理存儲中的數據集和其他已有的RDD上執行確定性操作來創建;為其他 Spark 功能模組提供了核心層的支撐,可類比 Spring 框架中的 Spring Core。
- Spark SQL:用來操作結構化數據的核心組件,通過Spark SQL可以直接查詢Hive、 HBase等多種外部數據源中的數據。Spark SQL的重要特點是能夠統一處理關係表和RDD在處理結構化數據時,開發人員無須編寫 MapReduce程式,直接使用SQL命令就能完成更加複雜的數據查詢操作。Spark SQL 適用於結構化表和非結構化數據的查詢,並且可以在運行時自適配執行計劃,支援 ANSI SQL(即標準的結構化查詢語言)。
- Spark Streaming:Spark提供的流式計算框架,支援高吞吐量、可容錯處理的實時流式數據處理,其核心原理是將流數據分解成一系列短小的批處理作業,每個短小的批處理作業都可以使用 Spark Core進行快速處理。Spark Streaming支援多種數據源,如 Kafka以及TCP套接字等。最為使用DStreams處理數據流的老的API。
- Structured Streaming:使用關係查詢處理結構化數據流(使用數據集和DataFrames,比DStreams更新的API);是從 spark2.0 開始引入了一套新的流式計算模型,基於 Spark SQl 引擎具有彈性和容錯的流式處理引擎. 使用 Structure Streaming 處理流式計算的方式和使用批處理計算靜態數據(表中的數據)的方式是一樣的。
- MLlib:Spark提供的關於機器學習功能的演算法程式庫,包括分類、回歸、聚類、協同過濾演算法等,還提供了模型評估、數據導入等額外的功能,開發人員只需了解一定的機器學習演算法知識就能進行機器學習方面的開發,降低了學習成本。
- GraphX: Spark提供的分散式圖處理框架,擁有圖計算和圖挖掘演算法的API介面以及豐富的功能和運算符,極大地方便了對分散式圖的處理需求,能在海量數據上運行複雜的圖演算法。
集群概述
Spark應用程式在集群中作為獨立的進程集運行,由主程式(稱為驅動程式)中的SparkContext對象協調。
- 運行在一個集群上,SparkContext可以連接到幾種類型的集群管理器(Spark自己獨立的集群管理器,Mesos, YARN或Kubernetes),這些管理器在應用程式之間分配資源。
- 一旦連接上,Spark將獲得集群中節點上的executor,這些executor是為應用程式運行計算和存儲數據的進程。
- 接下來將應用程式程式碼(由傳遞給SparkContext的JAR或Python文件定義)發送給執行器。
- 最後,SparkContext將任務發送給執行器運行。
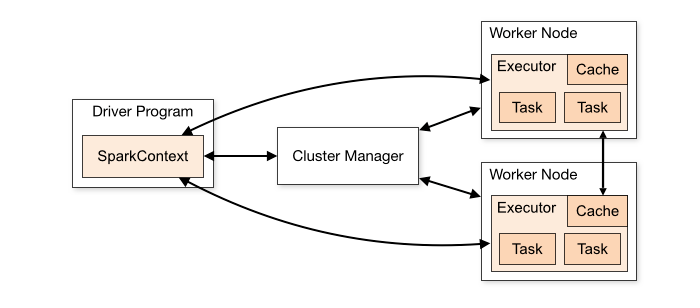
- 提交應用程式:可以使用spark-submit腳本將應用程式提交到任何類型的集群。
- 監控:Driver程式都有一個web UI,通常在4040埠上,顯示關於正在運行的任務、執行器和存儲使用的資訊。只需在web瀏覽器中訪問//
:4040就可以訪問這個WEB UI。 - 作業調度:Spark提供了跨應用程式(在集群管理器級別)和應用程式內部(如果多個計算髮生在同一個SparkContext上)的資源分配控制。
集群術語
-
Application 基於Spark構建的用戶程式。由集群上的驅動程式和執行程式組成。 Application jar 用戶的Spark應用程式Jar,包含他們的應用程式及其依賴項。用戶的jar包不應該包含Hadoop或Spark庫(這些庫會在運行時添加)。 Driver program 運行應用程式main()函數並創建SparkContext的進程 Cluster manager 獲取集群資源的外部服務(例如standalone manager, Mesos, YARN, Kubernetes) Deploy mode 區分驅動進程運行的位置。在「集群」模式下,框架在集群內部啟動驅動程式。在「客戶端」模式下,提交者在集群外啟動驅動程式。 Worker node 可以在集群中運行應用程式程式碼的任何節點 Executor 在工作節點上為應用程式啟動的進程,它運行任務並跨任務將數據保存在記憶體或磁碟存儲中。每個應用程式都有自己的執行器。 Task 將被發送到一個執行程式的工作單元 Job 由多個任務組成的並行計算,這些任務響應Spark操作(例如 save,collect)Stage 每個任務被分成更小的任務集,稱為相互依賴的階段(類似於MapReduce中的map和reduce階段);
部署
概述
Spark作為一個數據處理框架和計算引擎,被設計在所有常見的集群環境中運行, 在中國工作中主流的環境為Yarn,不過逐漸容器式環境也慢慢流行起來。
容器式環境:發現集群規模不足夠,會自動化生成所需要的環境,不需要多餘集群機器時,也會自動刪除。
Spark運行環境 = Java環境(JVM) + 集群環境(Yarn) + Spark環境(lib)
[外鏈圖片轉存失敗,源站可能有防盜鏈機制,建議將圖片保存下來直接上傳(img-WJRyiUk1-1662907653703)(//www.itxiaoshen.com:3001/assets/1662907244159WcYf6J10.png)]
Spark既可以單獨運行,也可以通過多個現有的集群管理器運行。目前它提供了幾種部署選項
- Local模式:多用於本地測試,如在Idea中編寫程式運行測試,本機提供資源 Spark提供計算。
- Standalone:Spark中自帶的一個簡單的資源調度框架,支援完全分散式。
- Apache Mesos:一個通用的資源管理和調度框架,也可以運行Hadoop MapReduce和服務應用程式。(棄用)
- Hadoop YARN:Hadoop 2和Hadoop 3中的資源管理器。Spark On Yarn是目前生產系統使用最多的部署方式
- Kubernetes:一個用於自動化部署、擴展和管理容器化應用程式的開源系統。Spark On K8s是未來的趨勢
環境準備
由於前面的文章已經搭建過Hadoop,環境預準備條件是類似,比如至少3台機器的互通互聯、免密登錄、時間同步、JDK如1.8版本安裝,這裡就不再說明了。
Local模式
所謂的Local模式,就是不需要其他任何節點資源就可以在本地執行Spark程式碼的環境
# 下載最新版本3.3.0
wget --no-check-certificate //dlcdn.apache.org/spark/spark-3.3.0/spark-3.3.0-bin-hadoop3.tgz
# 解壓
tar -xvf spark-3.3.0-bin-hadoop3.tgz
# 拷貝一個部署spark-local目錄
spark-3.3.0-bin-hadoop3 spark-local
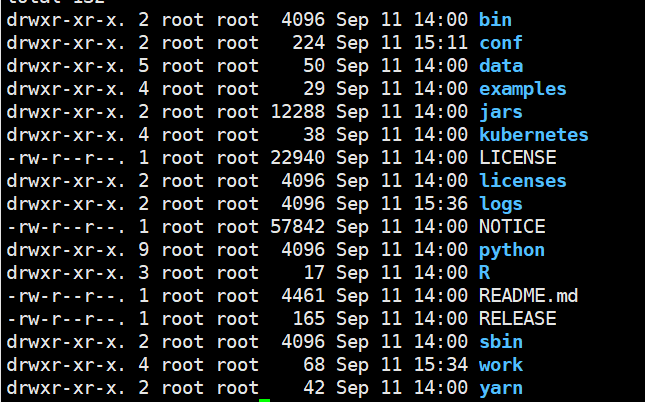
spark文件目錄說明
- bin:可執行的二進位命令文件,腳本文件
- conf:配置文件,其中以.template後綴結尾的文件不會起作用,稱為模板文件
- data:官方提供的教學數據
- examples:官方案例
- jars:官方案例的jar包
- src:官方案例的源碼
- jars:當前spark的lib,類庫
- kubernetes:容器式部署環境
- sbin:啟動關閉的腳本命令
- python,R,yarn
# 提交應用
bin/spark-submit \
--class org.apache.spark.examples.SparkPi \
--master local[2] \
./examples/jars/spark-examples_2.12-3.3.0.jar \
10
參數說明:
- –class表示要執行程式的主類,此處可以更換為自己寫的應用程式。
- –master local[2] 部署模式,默認為本地模式,數字表示分配的虛擬CPU核數量。
- spark-examples_2.12-3.0.0.jar 運行的應用類所在的jar包,實際使用時,可以設定為自己打的jar包。
- 數字10表示程式的入口參數,用於設定當前應用的任務數量
Standalone部署
Standalone模式
Spark自身節點運行的集群模式,也就是我們所謂的獨立部署(Standalone)模式,Spark的Standalone模式體現了經典的master-slave模式。
# 拷貝一個部署spark-standalone目錄
cp -r spark-3.3.0-bin-hadoop3 spark-standalone
# 進入目錄
cd spark-standalone/
cd conf
# 準備workers配置文件
mv workers.template workers
# 修改workers內容為
vi workers
hadoop1
hadoop2
hadoop3
# 準備spark-env.sh配置文件
mv spark-env.sh.template spark-env.sh
# spark-env.sh添加如下內容
vi spark-env.s
export JAVA_HOME=/home/commons/jdk8
SPARK_MASTER_HOST=hadoop1
SPARK_MASTER_PORT=7077
# 分發到其他兩台上
scp -r /home/commons/spark-standalone hadoop2:/home/commons/
scp -r /home/commons/spark-standalone hadoop3:/home/commons/
# 進入根目錄下sbin執行目錄和啟動
cd sbin/
./start-all.sh
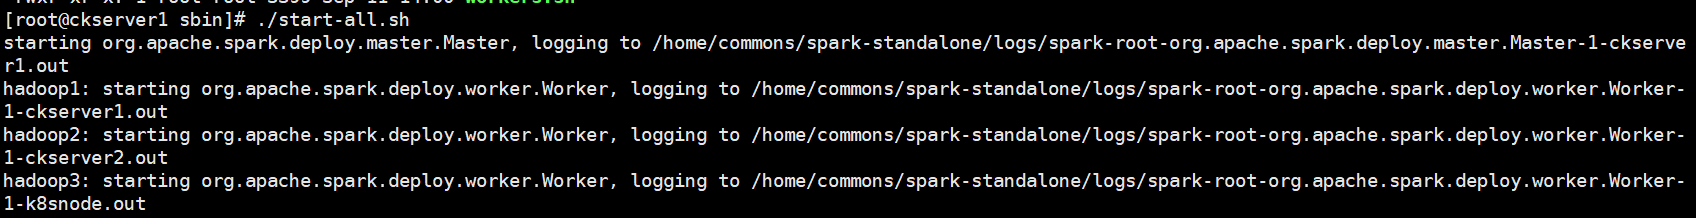
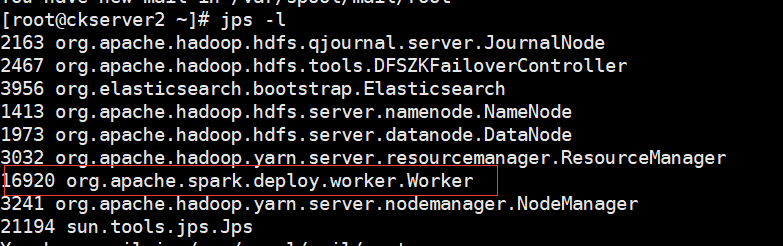
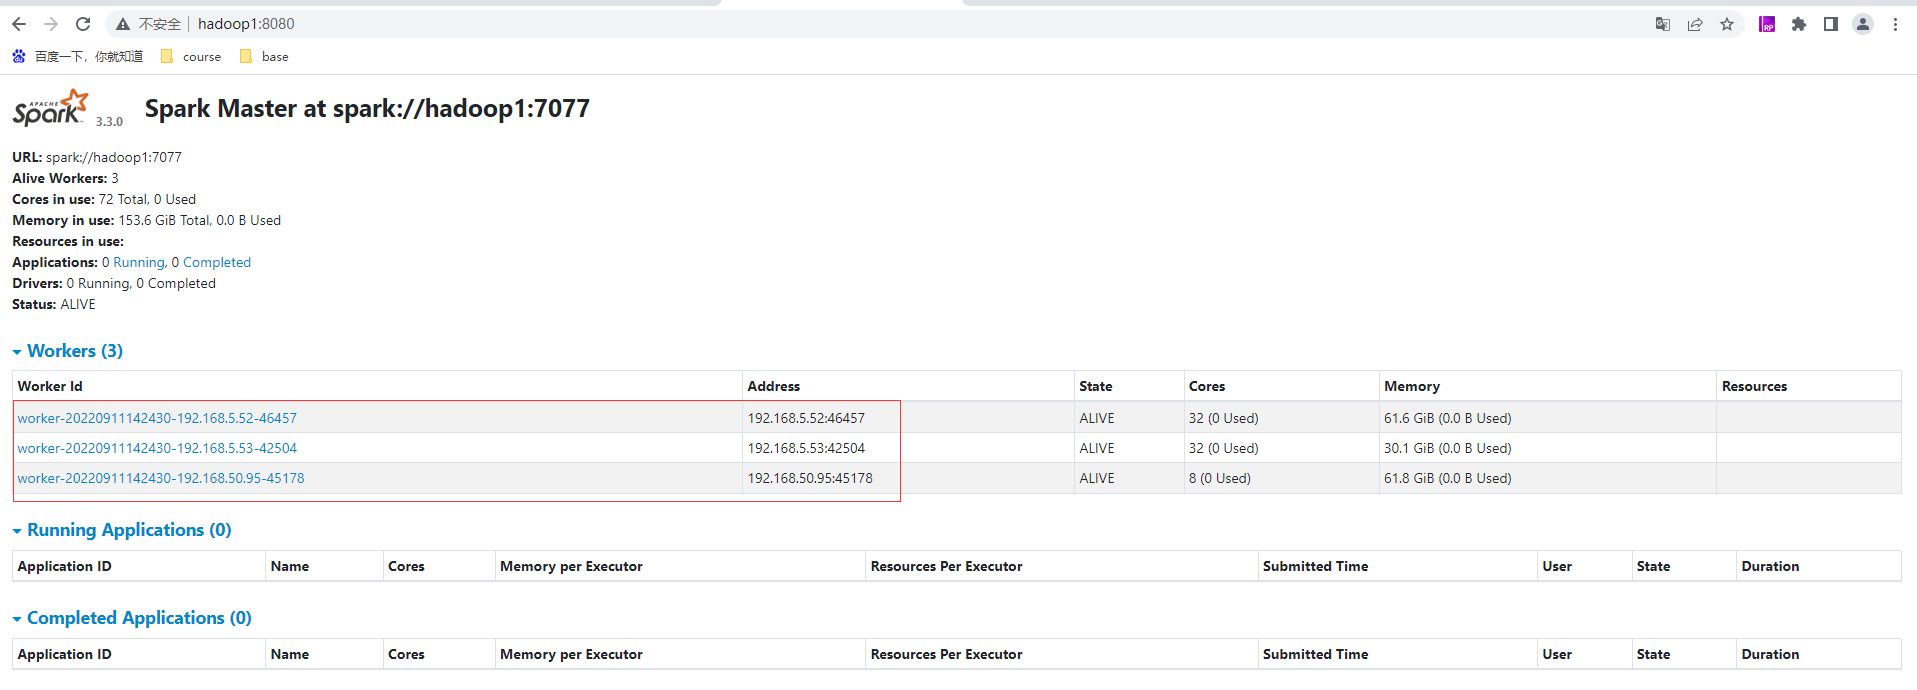
當前機器有Master和Worker進程,而另外其他兩台上有worker進程
訪問WebUi頁面://hadoop1:8080/ ,如果8080埠有其他服務使用,可以訪問8081埠也能正常訪問到當前這個Master的頁面(默認8081是Worker的)
配置歷史服務
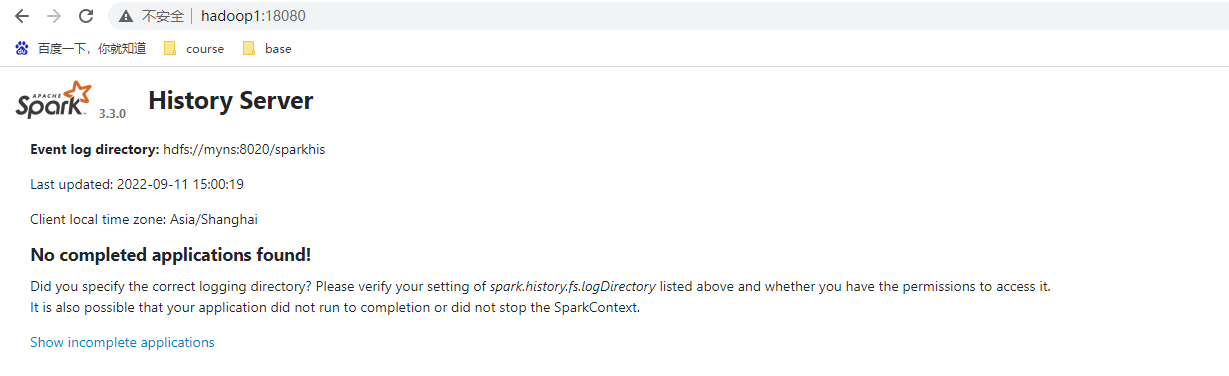
由於spark-shell 停止掉後,集群監控頁面就看不到歷史任務的運行情況,所以開發時都配置歷史伺服器記錄任務運行情況。
# 先停止前面啟動的集群
./stop-all.sh
# 準備spark-defaults.conf
cd ../conf
mv spark-defaults.conf.template spark-defaults.conf
# 修改spark-defaults.conf
vim spark-defaults.conf
spark.eventLog.enabled          true
spark.eventLog.dir              hdfs://myns:8020/sparkhis
# 需要啟動Hadoop集群,HDFS上的目錄需要提前存在
hadoop fs -mkdir /sparkhis
# 修改spark-env.sh文件,添加如下配置:
vi spark-env.sh
export SPARK_HISTORY_OPTS="
-Dspark.history.ui.port=18080
-Dspark.history.fs.logDirectory=hdfs://myns:8020/sparkhis
-Dspark.history.retainedApplications=30"
# 參數1含義:WEBUI訪問的埠號為18080
# 參數2含義:指定歷史伺服器日誌存儲路徑(讀)
# 參數3含義:指定保存Application歷史記錄的個數,如果超過這個值,舊的應用程式資訊將被刪除,這個是記憶體中的應用數,而不是頁面上顯示的應用數。
由於hadoop是HA模式因此配置為hdfs-site.xml下的dfs.nameservices的value值
    <property>
        <name>dfs.nameservices</name>
        <value>myns</value> <!--core-site.xml的fs.defaultFS使用該屬性值-->
    </property>
# 分發配置到另外兩台上
scp spark-defaults.conf spark-env.sh hadoop2:/home/commons/spark-standalone/conf/
scp spark-defaults.conf spark-env.sh hadoop3:/home/commons/spark-standalone/conf/
# 啟動集群
./start-all.sh
# 啟動歷史服務
./start-history-server.sh
訪問歷史服務的WebUI地址,//hadoop1:18080/
高可用(HA)
所謂的高可用是因為當前集群中的 Master 節點只有一個,所以會存在單點故障問題。所以為了解決單點故障問題,需要在集群中配置多個 Master 節點,一旦處於活動狀態的 Master發生故障時,由備用 Master 提供服務,保證作業可以繼續執行。這裡的高可用一般採用Zookeeper 設置。這裡使用前面搭建Zookeeper 。
# 停止集群
./stop-all.sh
# 停止歷史服務
./stop-history-server.sh
# 修改Spark中的 spark-env.sh 文件,修改如下配置
# 注釋如下內容
#SPARK_MASTER_HOST=hadoop1
#SPARK_MASTER_PORT=7077
# 添加如下內容
export SPARK_DAEMON_JAVA_OPTS="
-Dspark.deploy.recoveryMode=ZOOKEEPER
-Dspark.deploy.zookeeper.url=zk1,zk2,zk3
-Dspark.deploy.zookeeper.dir=/spark"
# 分發配置到另外兩台上
scp spark-env.sh hadoop2:/home/commons/spark-standalone/conf/
scp spark-env.sh hadoop3:/home/commons/spark-standalone/conf/
# 啟動集群
./start-all.sh
# 在另外伺服器如hadoop2上啟動master
./start-master.sh
hadoop1的master為ALIVE狀態
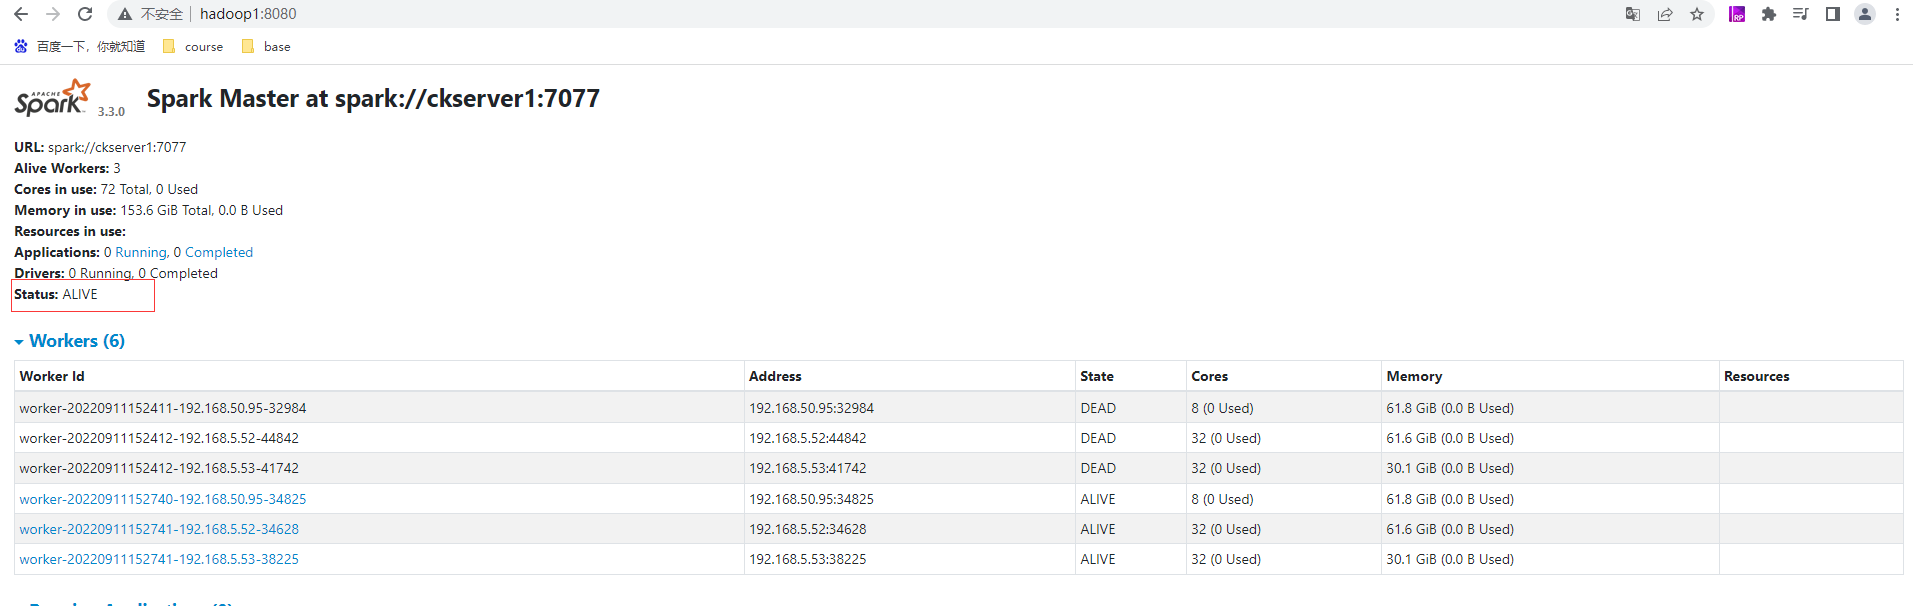
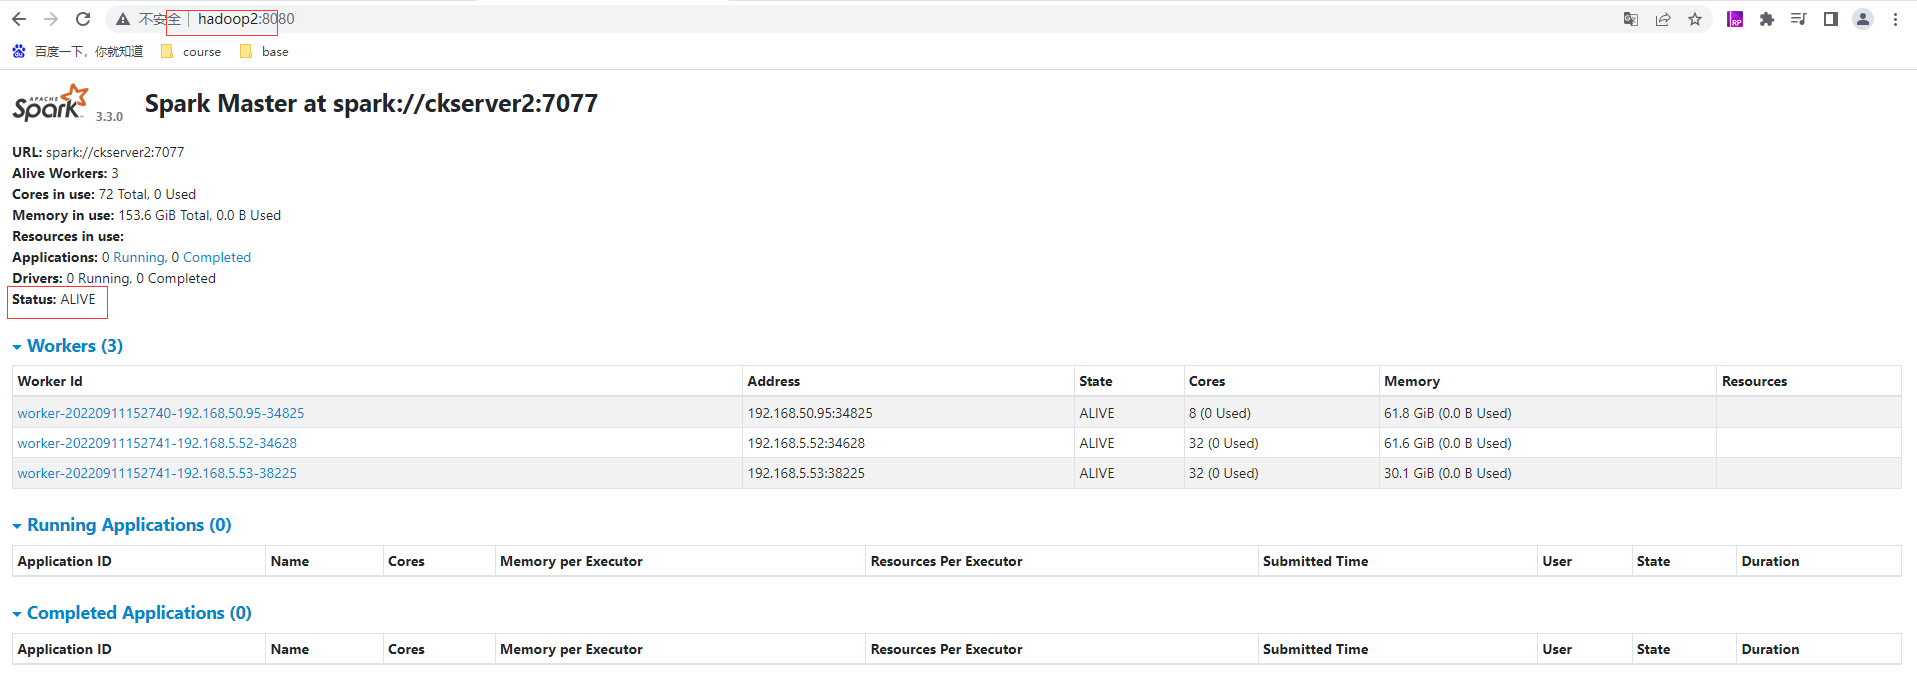
hadoop2的master為STANDBY狀態
[外鏈圖片轉存失敗,源站可能有防盜鏈機制,建議將圖片保存下來直接上傳(img-NVmFWDEw-1662907653726)(//www.itxiaoshen.com:3001/assets/1662907298952BdHwc0Bh.png)]
提交應用到高可用集群,注意提交master要填寫多個master地址
bin/spark-submit \
--class org.apache.spark.examples.SparkPi \
--master spark://hadoop1:7077,hadoop2:7077 \
./examples/jars/spark-examples_2.12-3.3.0.jar \
10
# 停止mALIVE狀態hadoop1的master
./stop-master.sh
hadoop2的master由原來的STANDBY狀態轉變為ALIVE狀態,實現高可用的切換
提交流程
作業提交原理
[外鏈圖片轉存失敗,源站可能有防盜鏈機制,建議將圖片保存下來直接上傳(img-GqM7w3Qz-1662907653730)(//www.itxiaoshen.com:3001/assets/1662907304666dPiztcT6.png)]
Standalone-client 提交任務方式
# --deploy-mode client 可以省略,默認為client
bin/spark-submit \
--class org.apache.spark.examples.SparkPi \
--master spark://hadoop1:7077,hadoop2:7077 \
--deploy-mode client \
./examples/jars/spark-examples_2.12-3.3.0.jar \
10

# 其他參數提交應用
bin/spark-submit \
--master spark://hadoop1:7077 \
--class org.apache.spark.examples.SparkPi \
--driver-memory 500m \
--driver-cores 1 \
--executor-memory 800m \
--executor-cores 1 \
./examples/jars/spark-examples_2.12-3.3.0.jar \
10
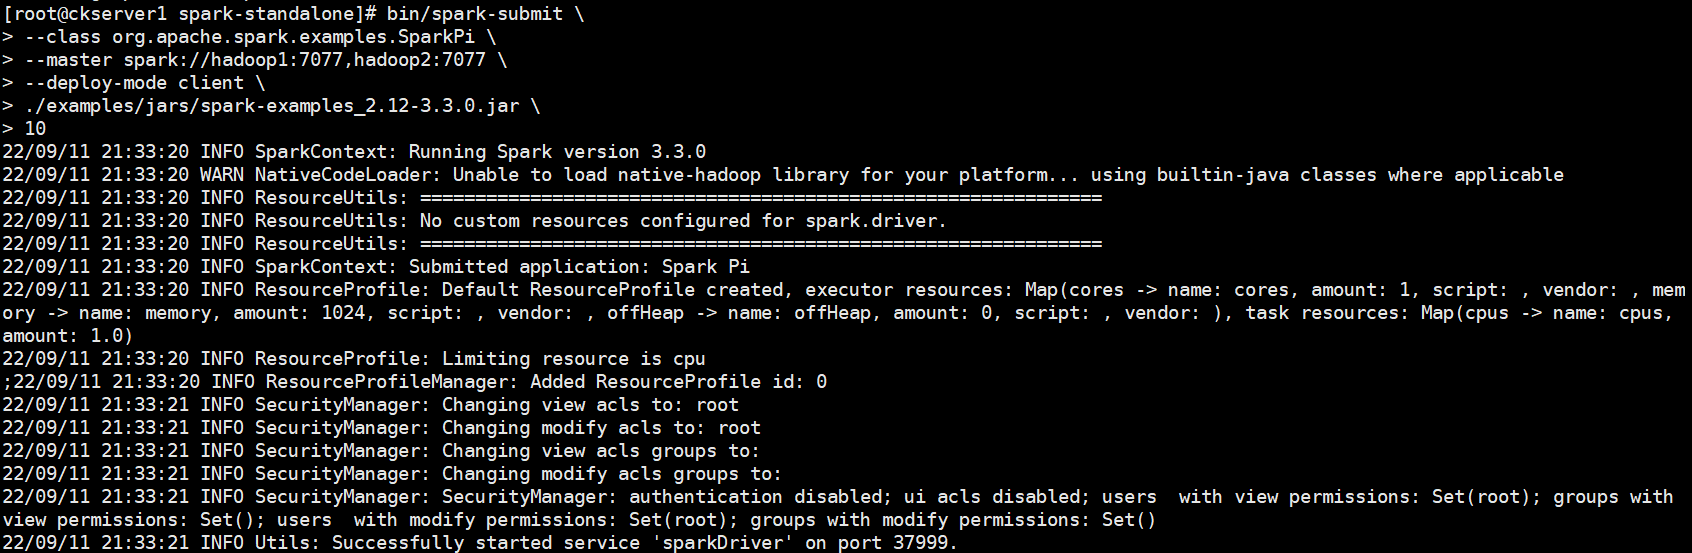
參數說明:
- --class:表示要執行程式的主類,Spark程式中包含主函數的類
- --master:Spark程式運行的模式(環境) 模式:local[*]、spark://hadoop101:7077、 Yarn,spark://hadoop101:7077 獨立部署模式,連接到Spark集群,Mater的地址和埠號。
- --executor-memory 1G 指定每個executor可用記憶體為1G 符合集群記憶體配置即可,具體情況具體分析。
- --total-executor-cores 2 指定所有executor使用的cpu核數為2個。
- --executor-cores 指定每個executor使用的cpu核數。
- application-jar:打包好的應用jar,包含依賴。這個URL在集群中全局可見。 比如hdfs:// 共享存儲系統,如果是file:// path,那麼所有的節點的path都包含同樣的jar,spark-examples_2.12-3.0.0.jar 運行類所在的jar包
- application-arguments:數字10表示程式的入口參數,用於設定當前應用的任務數量
查看WebUI後可以看到剛剛提交的任務app-20220911213322-0000資訊
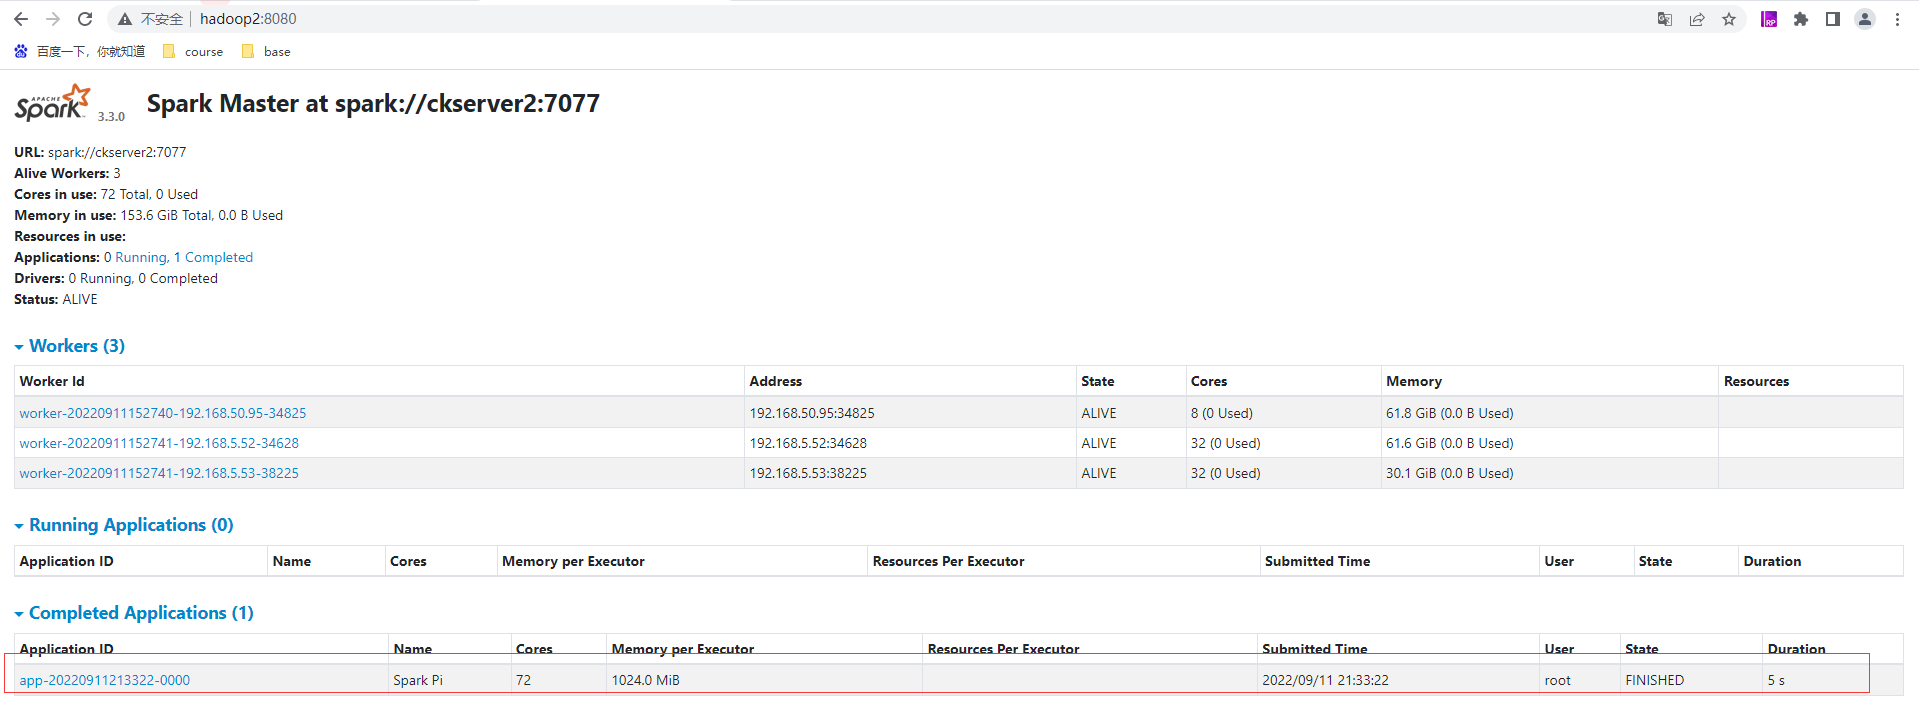
執行任務時,會產生多個Java進程(用於計算)執行完成就會釋放掉。其中Master和Worker是資源,默認採用伺服器集群節點的總核數,每個節點記憶體1024M。
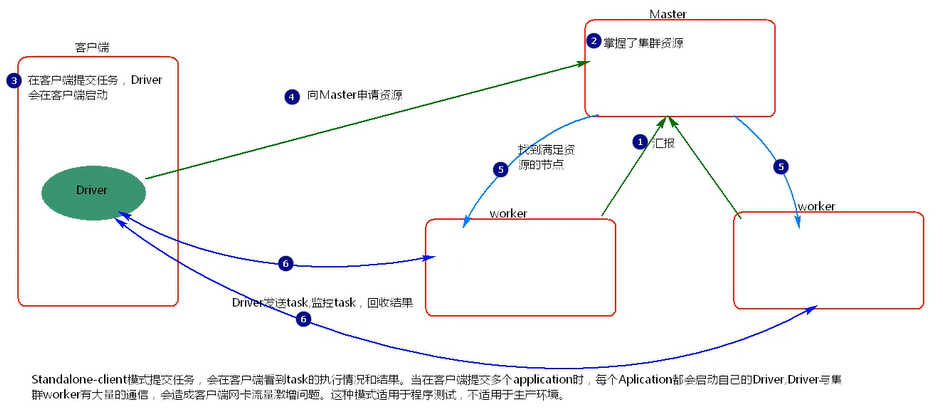
- client 模式提交任務後,會在客戶端啟動 Driver 進程。
- Driver 會向 Master 申請啟動 Application 啟動的資源。
- Master 收到請求之後會在對應的 Worker 節點上啟動 Executor
- Executor 啟動之後,會註冊給 Driver 端,Driver 掌握一批計算 資源。
- Driver 端將 task 發送到 worker 端執行。worker 將 task 執行結 果返回到 Driver 端。
當在客戶端提交多個Spark application時,每個application都會啟動一個Driver。lient 模式適用於測試調試程式。Driver 進程是在客戶端啟動的,這裡的客 戶端就是指提交應用程式的當前節點。在 Driver 端可以看到 task 執行的情 況。生產環境下不能使用 client 模式,是因為:假設要提交 100 個,application 到集群運行,Driver 每次都會在 client 端啟動,那麼就會導致 客戶端 100 次網卡流量暴增的問題。client 模式適用於程式測試,不適用 於生產環境,在客戶端可以看到 task 的執行和結果
Standalone-cluster 提交任務方式
bin/spark-submit \
--class org.apache.spark.examples.SparkPi \
--master spark://hadoop1:7077,hadoop2:7077 \
--deploy-mode cluster \
./examples/jars/spark-examples_2.12-3.3.0.jar \
10
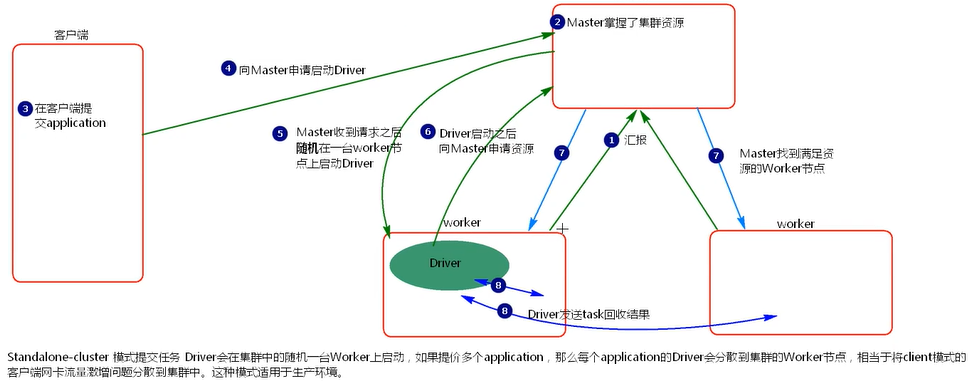
- cluster 模式提交應用程式後,會向 Master 請求啟動 Driver
- Master 接受請求,隨機在集群一台節點啟動 Driver 進程。
- Driver 啟動後為當前的應用程式申請資源。
- Driver 端發送 task 到 worker 節點上執行。
- worker 將執行情況和執行結果返回給 Driver 端。
Driver 進程是在集群某一台 Worker 上啟動的,在客戶端是無法查看 task 的執行情況的。假設要提交 100 個 application 到集群運行,每次 Driver 會 隨機在集群中某一台 Worker 上啟動,那麼這 100 次網卡流量暴增的問題 就散布在集群上。
Yarn部署
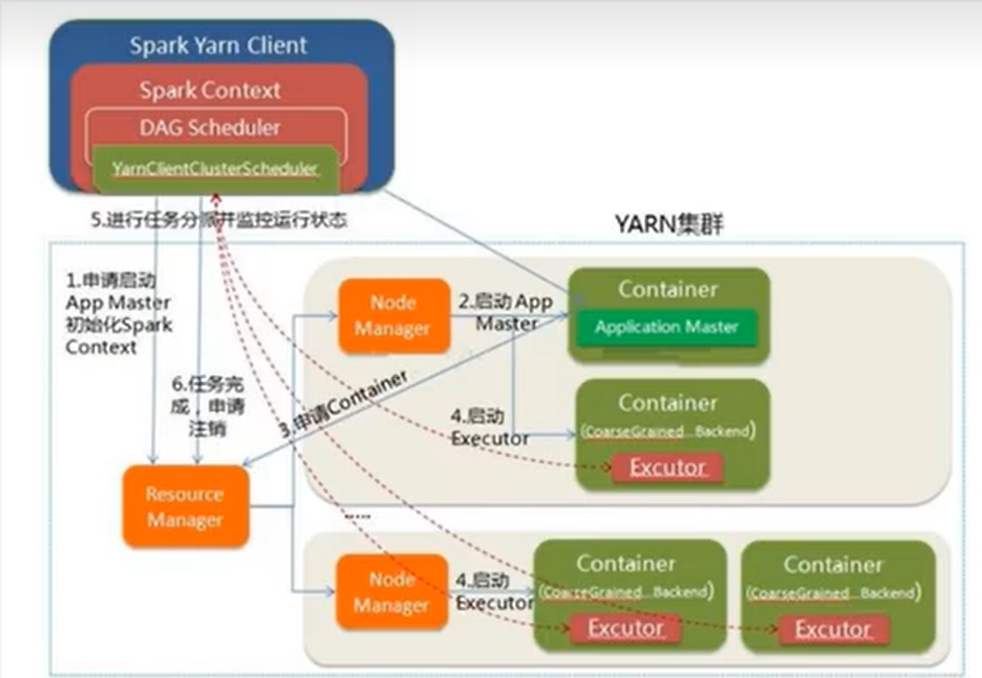
獨立部署(Standalone)模式由Spark自身提供計算資源,無需其他框架提供資源。這種方式降低了和其他第三方資源框架的耦合性,獨立性非常強。但是也要記住,Spark主要是計算框架,而不是資源調度框架,所以本身提供的資源調度並不是它的強項,所以還是和其他專業的資源調度框架集成會更靠譜一些。所以接下來需要學習在強大的Yarn環境下Spark是如何工作的(其實是因為在中國工作中,Yarn使用的非常多)。
Yarn Client模式
# 重新拷貝一個目錄
cp -r spark-3.3.0-bin-hadoop3 spark-yarn
# 修改hadoop配置文件/home/commons/hadoop/etc/hadoop/yarn-site.xml,
<!--是否啟動一個執行緒檢查每個任務正使用的物理記憶體量,如果任務超出分配值,則直接將其殺掉,默認是true -->
<property>
     <name>yarn.nodemanager.pmem-check-enabled</name>
     <value>false</value>
</property>

<!--是否啟動一個執行緒檢查每個任務正使用的虛擬記憶體量,如果任務超出分配值,則直接將其殺掉,默認是true -->
<property>
     <name>yarn.nodemanager.vmem-check-enabled</name>
     <value>false</value>
</property>

#  yarn-site.xml並分發到其他兩台機器
scp /home/commons/hadoop/etc/hadoop/yarn-site.xml hadoop2:/home/commons/hadoop/etc/hadoop/
scp /home/commons/hadoop/etc/hadoop/yarn-site.xml hadoop3:/home/commons/hadoop/etc/hadoop/

# 重啟Hadoop
cd /home/commons/hadoop/sbin
./stop-all.sh
./start-all.sh
# 修改conf目錄三個配置文件,跟前面的類似稍微修改
mv workers.template workers
# 修改workers內容為
vi workers
hadoop1
hadoop2
hadoop3
# 準備spark-env.sh配置文件
mv spark-env.sh.template spark-env.sh
# 增加下面配置
vi spark-env.sh
export JAVA_HOME=/home/commons/jdk8
HADOOP_CONF_DIR=/home/commons/hadoop/etc/hadoop
YARN_CONF_DIR=/home/commons/hadoop/etc/hadoop
export SPARK_HISTORY_OPTS="
-Dspark.history.ui.port=18080
-Dspark.history.fs.logDirectory=hdfs://myns:8020/sparkhis
-Dspark.history.retainedApplications=30"
# 修改spark-defaults.conf.template文件名為spark-defaults.conf
mv spark-defaults.conf.template spark-defaults.conf
# 修改spark-default.conf文件,配置日誌存儲路徑
spark.eventLog.enabled  true
spark.eventLog.dir  hdfs://myns:8020/sparkhis
spark.yarn.historyServer.address=hadoop1:18080
spark.history.ui.port=18080
# 啟動歷史服務
sbin/start-history-server.sh
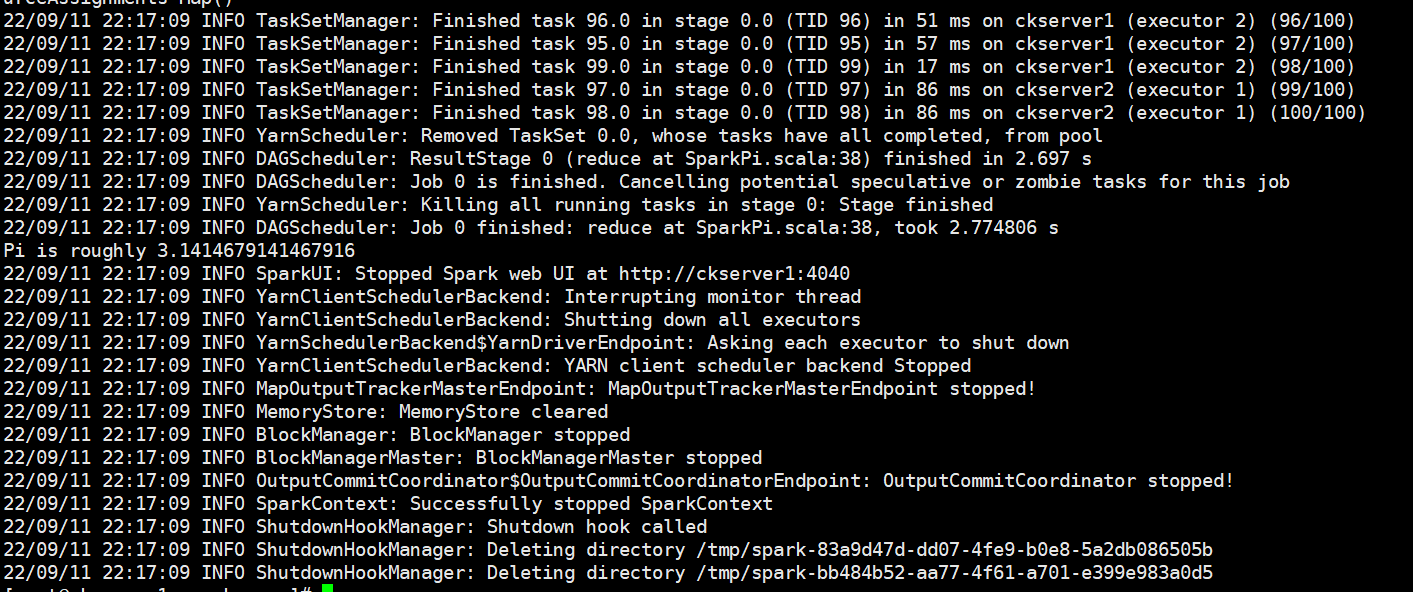
提交yarn client任務
bin/spark-submit \
--master yarn \
--deploy-mode client \
--class org.apache.spark.examples.SparkPi \
--driver-memory 600m \
--driver-cores 1 \
--executor-memory 800m \
--executor-cores 2 \
./examples/jars/spark-examples_2.12-3.3.0.jar \
100
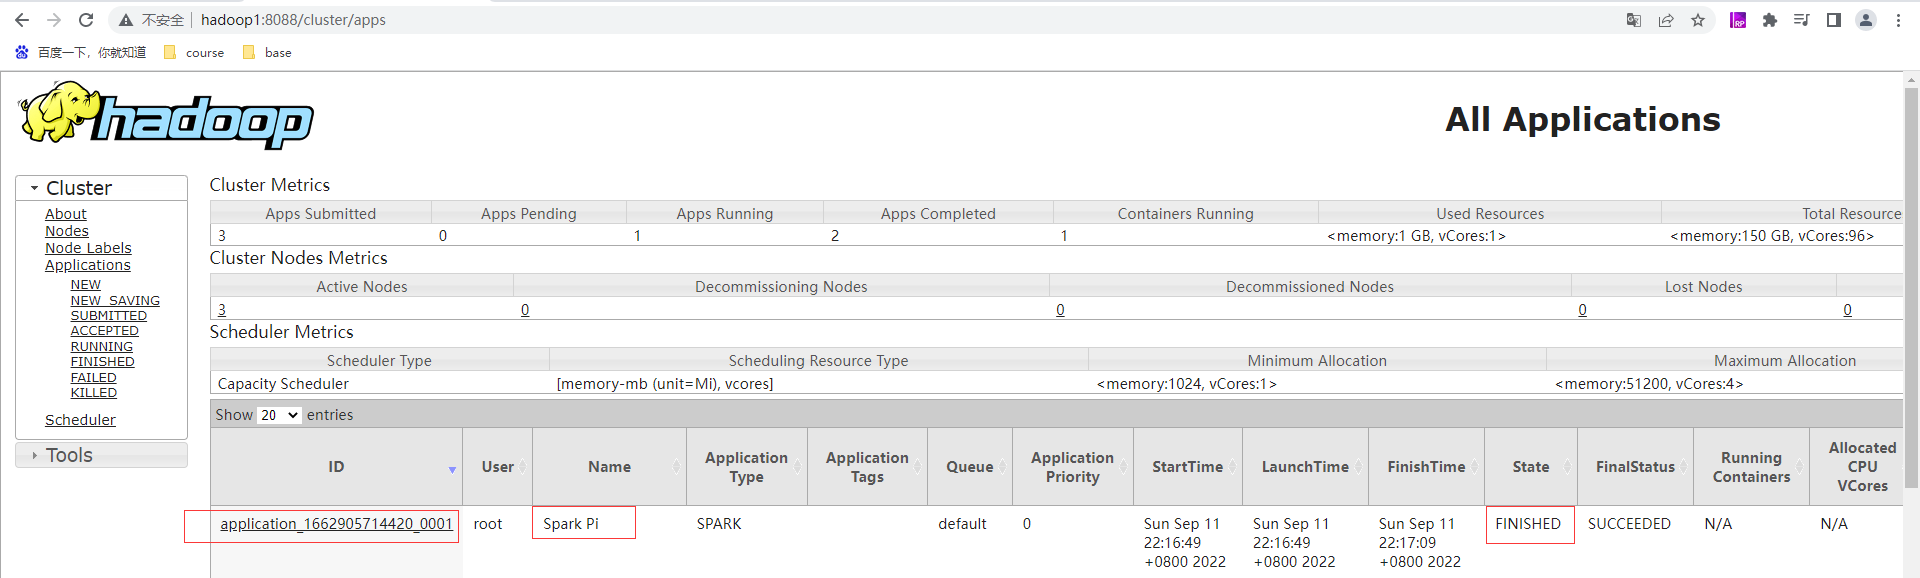
查看yarn的頁面://hadoop1:8088/cluster 有剛才提交的應用application_1662905714420_0001為狀態成功且已完成
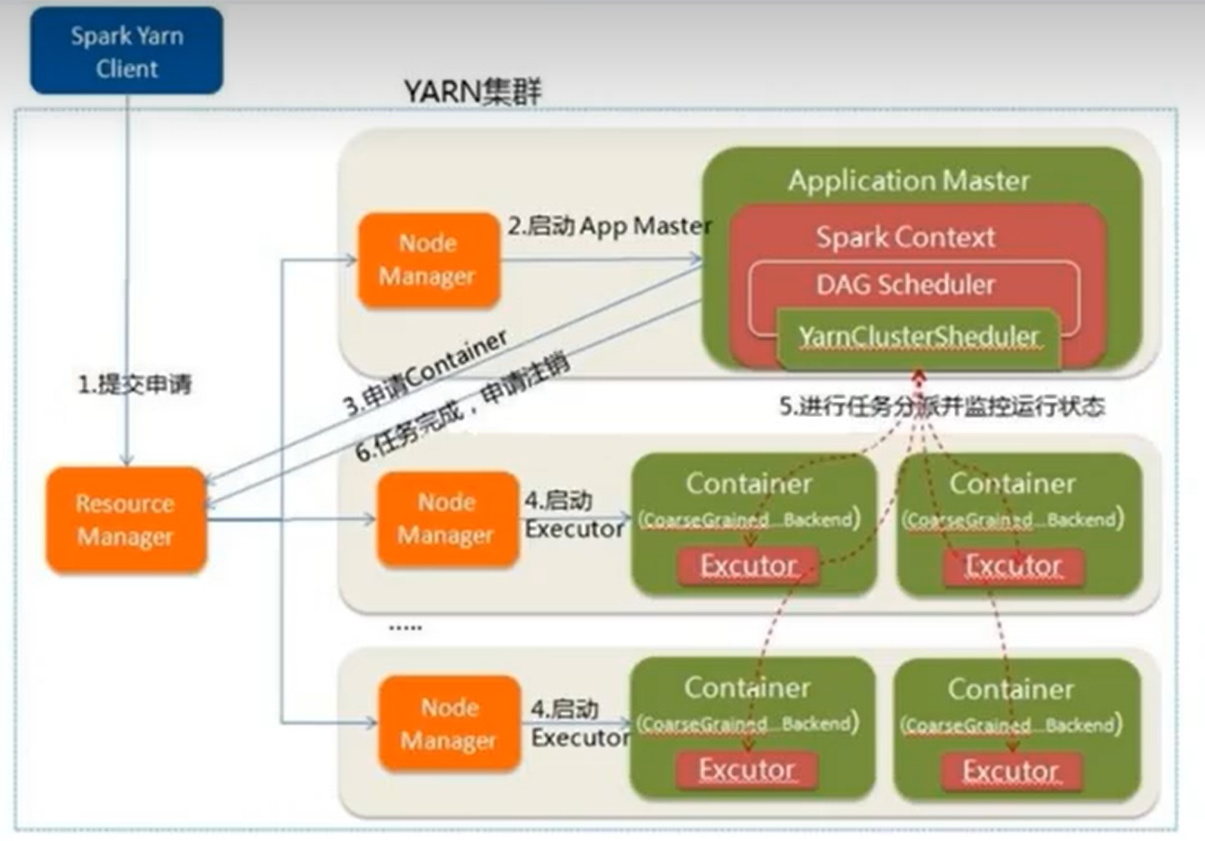
Yarn Cluster模式
bin/spark-submit \
--master yarn \
--deploy-mode cluster \
--class org.apache.spark.examples.SparkPi \
--driver-memory 600m \
--driver-cores 1 \
--executor-memory 800m \
--executor-cores 2 \
./examples/jars/spark-examples_2.12-3.3.0.jar \
100
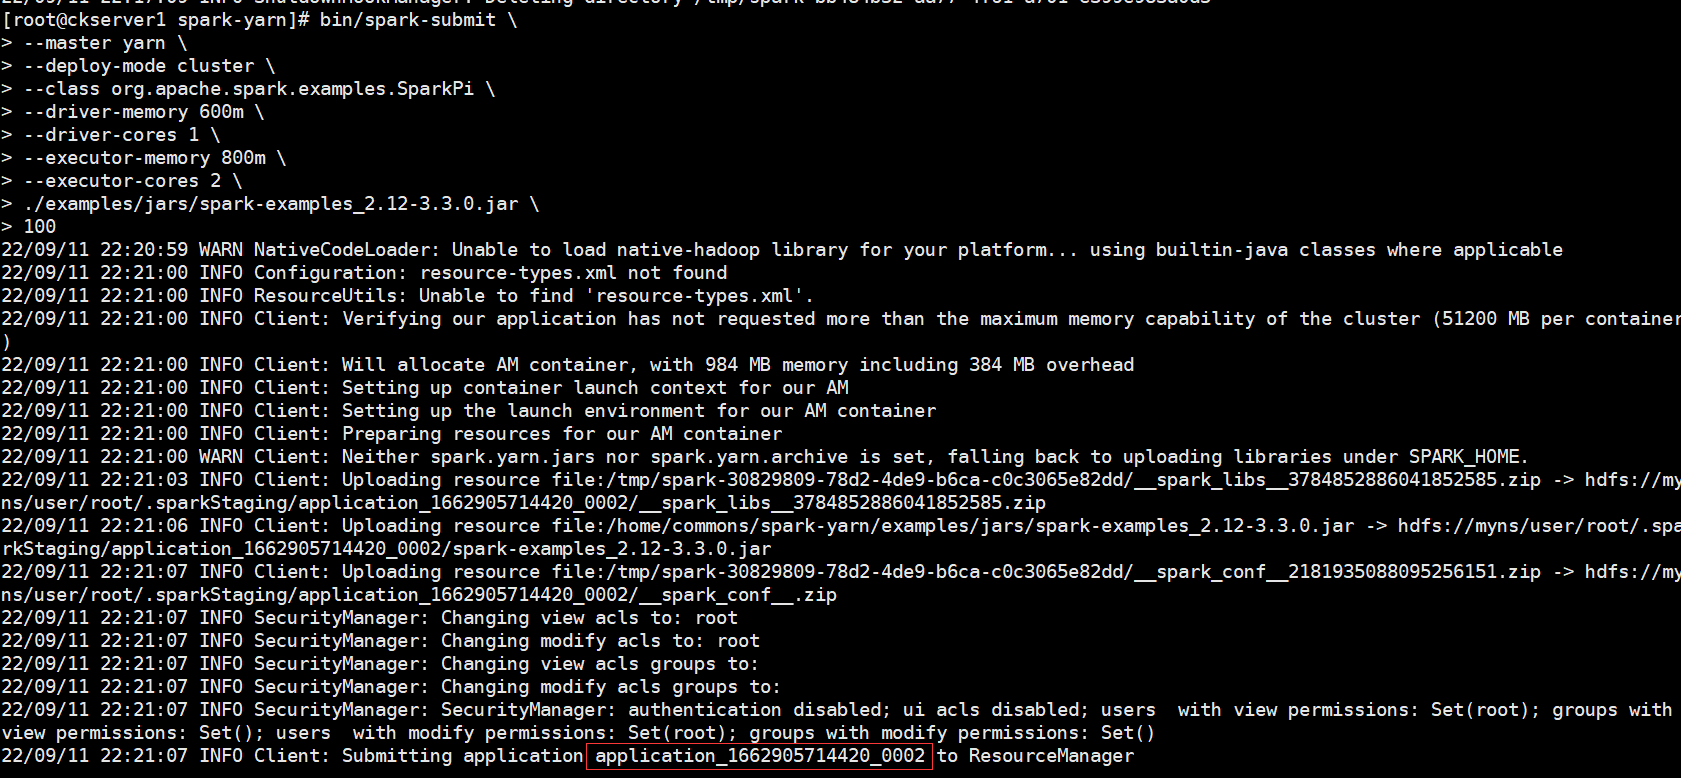
查看yarn的頁面://hadoop1:8088/cluster 有剛才提交的應用application_1662905714420_0002為狀態成功且已完成
Spark-Shell
在Spark Shell中,已經在名為sc的變數中為您創建了一個特殊的SparkContext,如果您自己創建SparkContext會不生效。您可以使用--master參數設置SparkContext連接到哪個主節點,並且可以通過--jars參數來設置添加到CLASSPATH的JAR包,多個JAR包時使用逗號(,)分隔。更多參數資訊,您可以通過命令./bin/spark-shell --help獲取。
- local模式
bin/spark-shell
# 啟動成功後,可以輸入網址進行Web UI監控頁面訪問
# //虛擬機地址:4040
# 在解壓縮文件夾下的data目錄中,添加word.txt文件。在命令行工具中執行如下程式碼指令(和IDEA中程式碼簡化版一致)
sc.textFile("data/word.txt").flatMap(_.split(" ")).map((_,1)).reduceByKey(_+_).collect
# 退出本地模式,盡量用命令退出
:quit
- Standalone模式
bin/spark-shell \
--master spark://hadoop1:7077
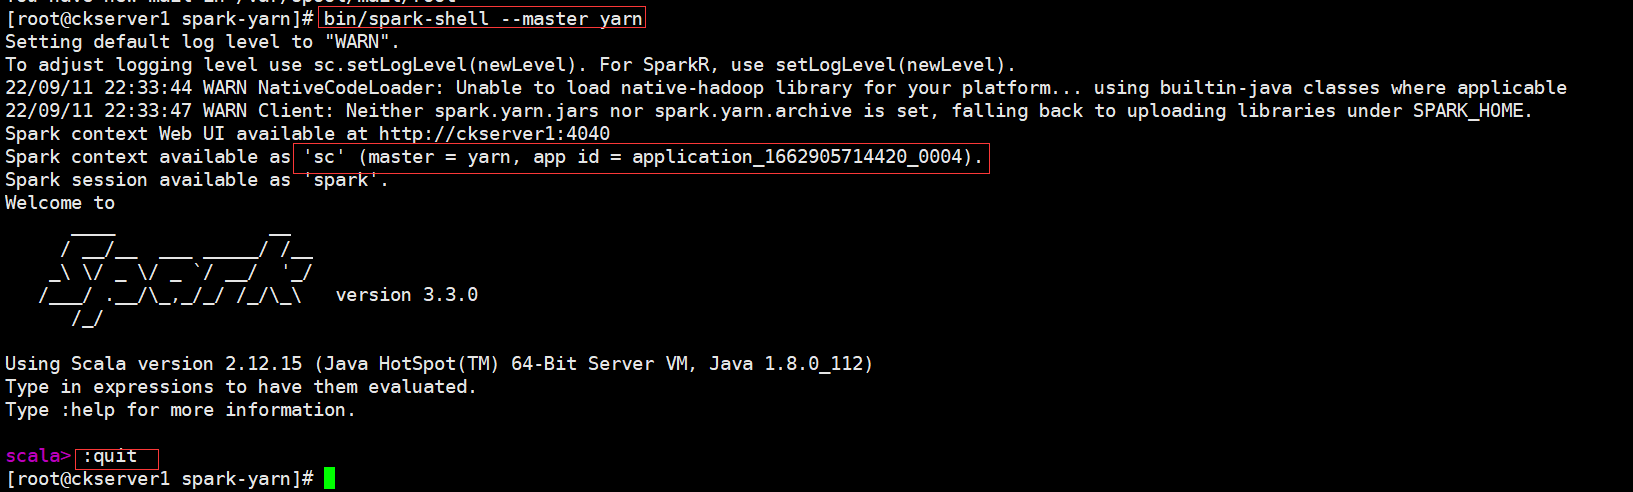
- Yarn Client模式,由於shell屬於互動式方式,因此只有Yarn Client模式,沒有Yarn Cluster模式
bin/spark-shell \
--master yarn
**本人部落格網站 **IT小神 www.itxiaoshen.com
