django路由匹配、反向解析、無名有名反向解析、路由分發、名稱空間
目錄
django請求生命周期流程圖
1.Django請求的生命周期的含義
Django請求的生命周期是指:當用戶在瀏覽器上輸入URL到用戶看到網頁的這個時間段內,Django後台所發生的事情。
2.Django請求的生命周期圖解及流程
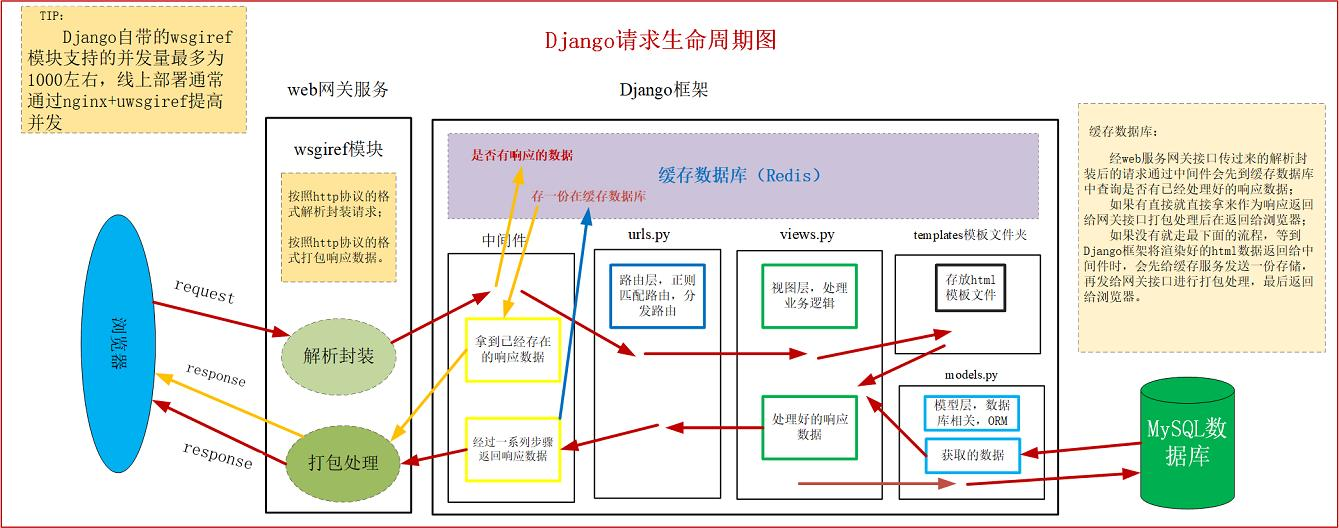
1.瀏覽器默認市=是基於HTTP協議發送請求的
2.發送請求進入一個web服務網關介面,其實就是wsgiref(幫我們分裝了socket程式碼,幫我們把請求過來的數進行數據處理,變成了一個大字典)它是Django默認的,但是它的並發能力特別低非常差,所以在Django上線之後都會切換為uwsgi,該服務並發能力強,並發量大
3.wsgiref與uwsgi都是屬於WSG協議,它們倆個是實現這個協議的模組
4.請求進來的時候拆建數據,響應走的時候封裝數據

------->進入了Django後端

1.首先會經過一個Django中間件,請求會經過它的層層篩選,才會進入urls.py
2.urls.py(路由層),進來之後完成一個地址的匹配,查看功能是否開設好了,如果開設好了就會進入views.py(視圖層),執行核心邏輯,如果需要模板進入模板層
3.templates文件夾(模板層),models.py(模型層),模板層可能會需要用到模板語法,然後進入模型層拿取數據,用orm進入資料庫操作數據,返回一個數據,然後orm會操作封裝成對象,回到views.py層,然後會做一個模板渲染,最後依次返回
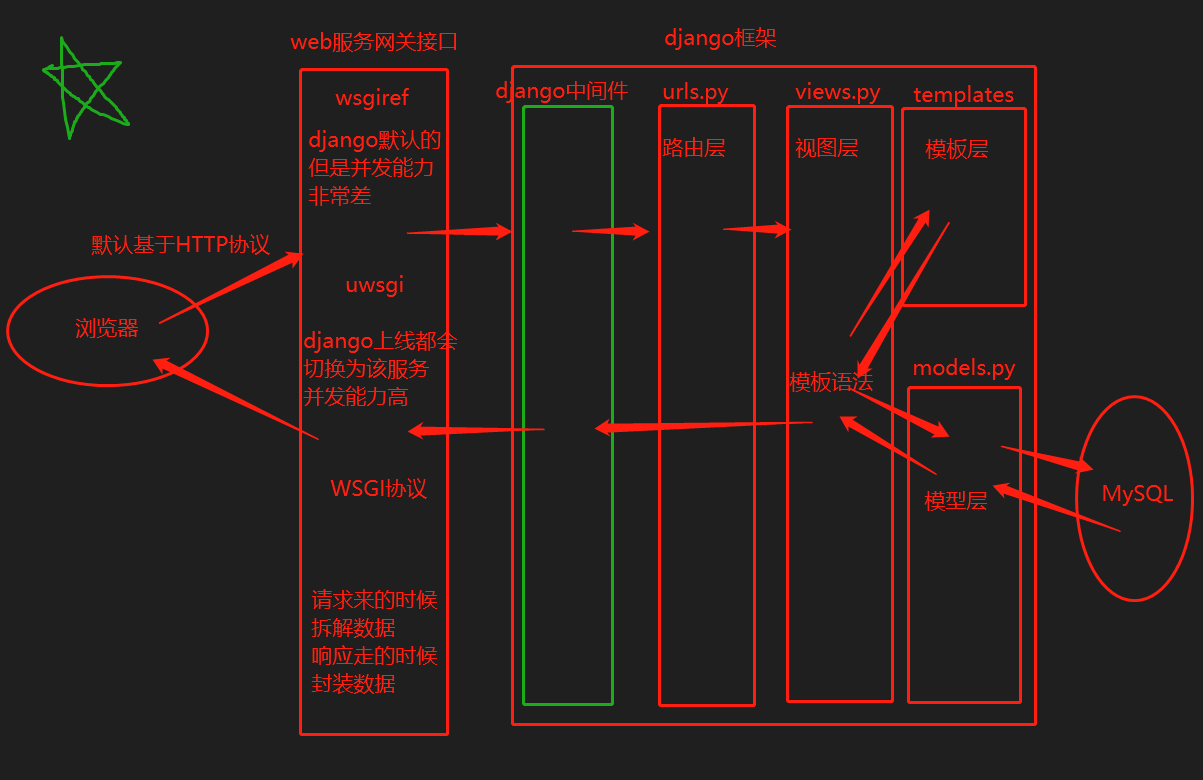
3.Django的請求生命周期(分布解析)
瀏覽器
	發送請求(HTTP協議)

web服務網關介面
	1.請求來的時候解析封裝
		響應走的時候打包處理

	2.django默認的wsgiref模組不能承受高並發 最大只有1000左右
		上線之後會替換成uwsgi來增加並發量

	3.WSGI跟wsgiref和uwsgi是什麼關係
		WSGI是協議
		wsgiref和uwsgi是實現該協議的功能模組

django後端
	1.django中間件(暫時不考慮 後面講)
		類似於django的保安 門戶

	2.urls.py  路由層
		識別路由匹配對應的視圖函數

	3.views.py	視圖層
		網站整體的業務邏輯

	4.templates文件夾		模版層
		網站所有的html文件

	5.models.py			   模型層
		ORM
額外擴展:快取資料庫的作用
路由層
1.路由匹配
path('網址後綴',函數名)
    一旦網址後綴匹配上了就會自動執行後面的函數
    並結束整個路由的匹配
ps:ip和埠號後面必須要家斜杠的
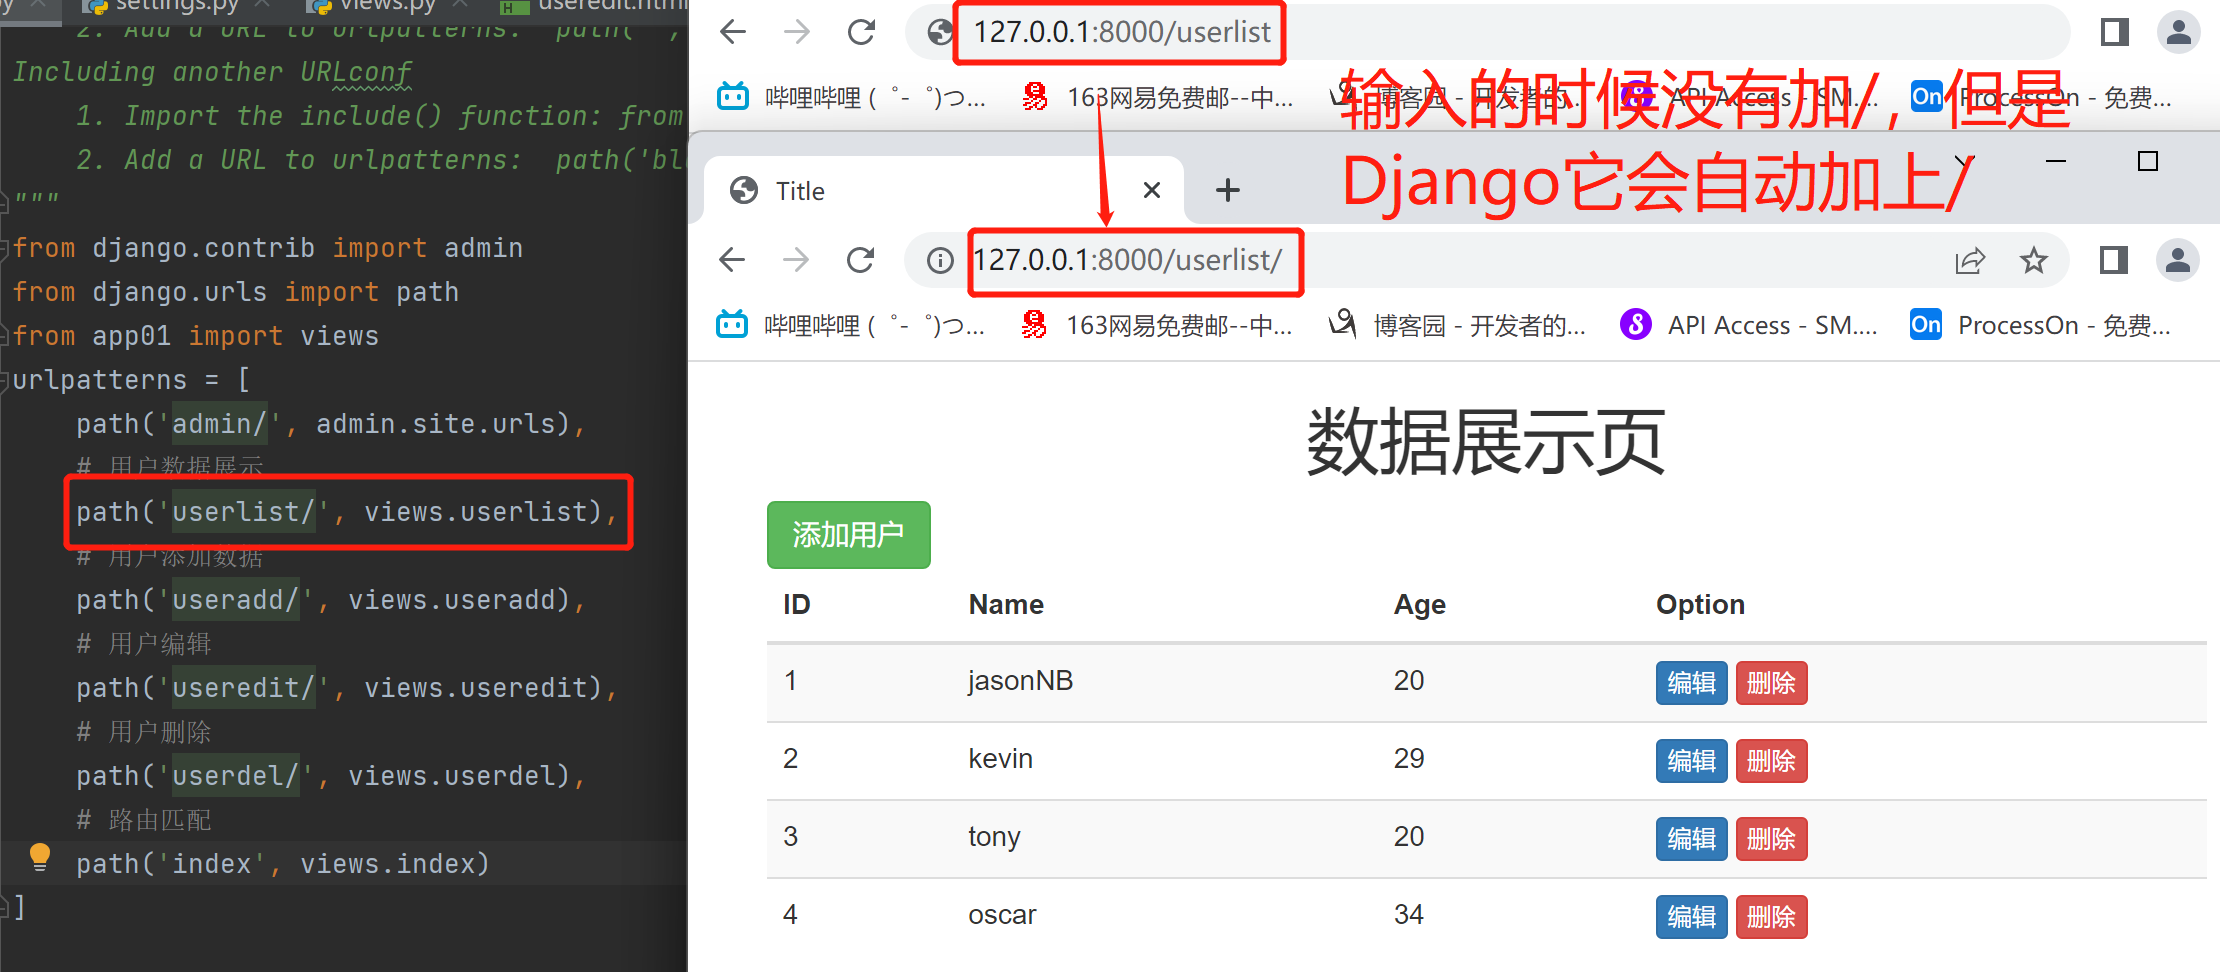
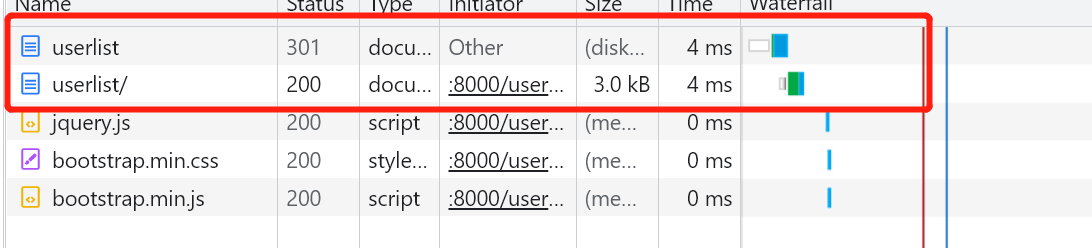
不加/去請求訪問的時候原理
首先它會去查看一遍有沒有這個地址,然後發現沒有,301是重定向的狀態碼,那麼此時它會考慮給加一個/去重新執行一次,所有就有了倆次
路由結尾的斜杠
默認情況下不寫斜杠 django會做二次處理
    第一次匹配不上 會讓瀏覽器加斜杠再次請求
django配置文件中可以指定是否自動添加斜杠
    APPEND_SLASH = False(默認是True,改成false的時候,不加的話就不能訪問到了)
2.path轉換器
轉換器只有在django2以上才會有
當網址後綴不固定的時候 可以使用轉換器來匹配
'int': IntConverter(),
'path': PathConverter(),
'slug': SlugConverter(),
'str': StringConverter(),
'uuid': UUIDConverter(),
以後不知道固定的視圖函數後面寫什麼就這麼寫:
    path('func/<int:year>/<str:info>/', views.func)
轉換器匹配到的內容會當做視圖函數的關鍵字參數傳入
    轉換器有幾個叫什麼名字 那麼視圖函數的形參必須對應
    def func(request,year,info):
        pass
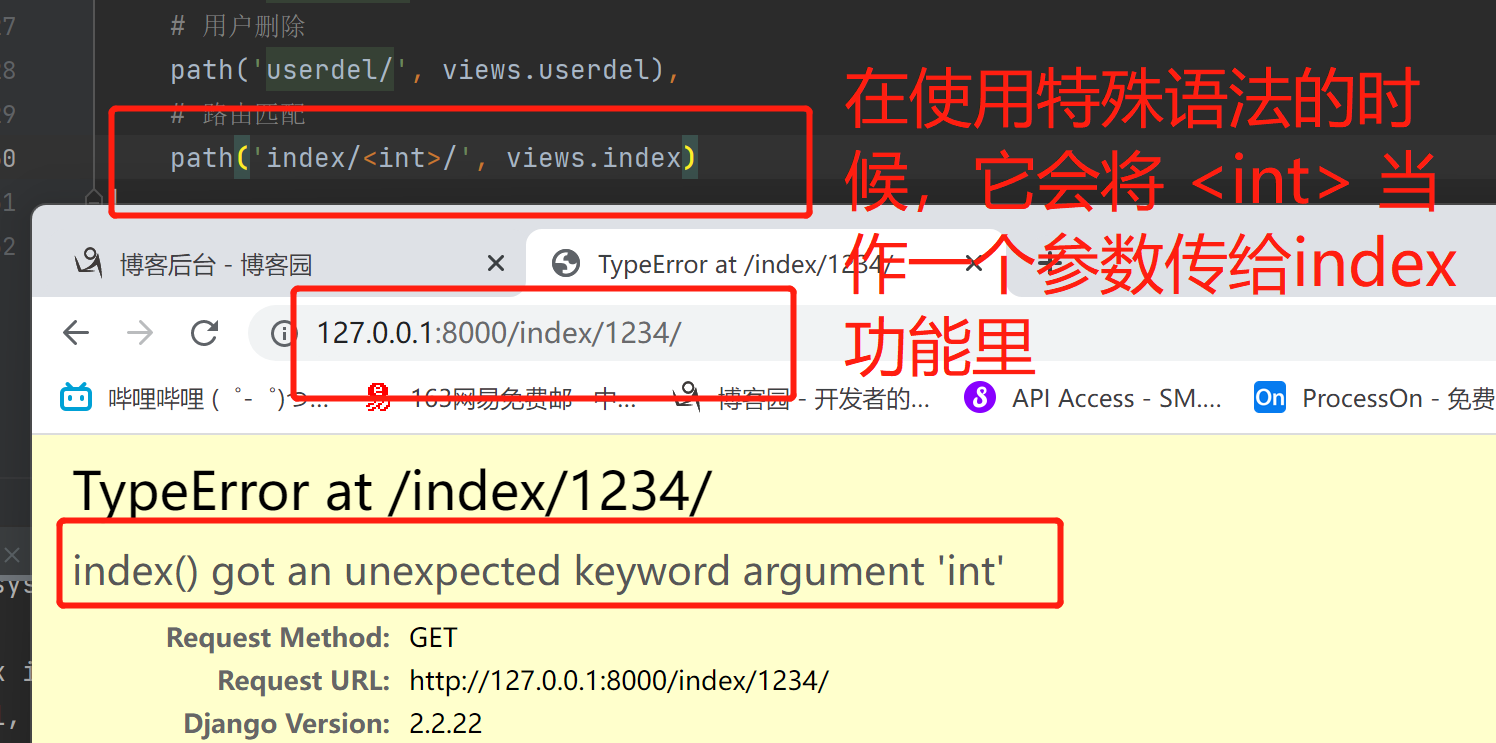
在固定的路由後面添加些不確定的數
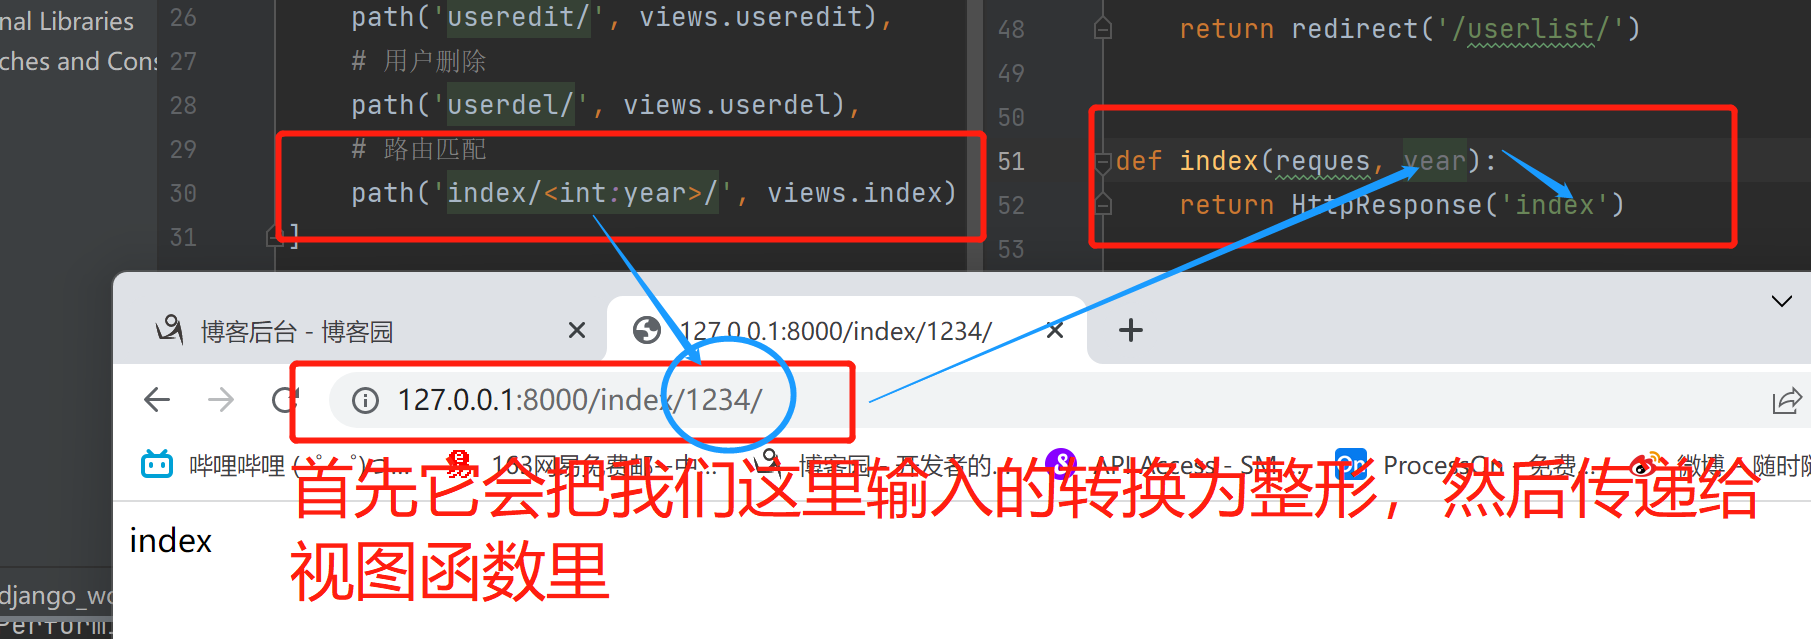
3.re_path正則匹配
re_path('test', views.test),
re_path('testadd', views.testadd),

輸入網址://127.0.0.1:8000/testadd的時候,返回的是test的內容,re_path的特點是在我們輸入的網址的後綴,它會去匹配,只要能匹配到這個後綴的,就算匹配上了

1.怎麼去區分開呢??
    re_path('test/', views.test),
    re_path('testadd/', views.testadd),
    加上/後它完整的是test/,所以它只能匹配到它自己的

2.但是還存在問題
    //127.0.0.1:8000/wfdrfffg/test/egddddddd/6ygg
    這個樣子還能匹配到,不太精準

那麼如果想要使用正則去做匹配的話,在前面加上^,後面加上$
    re_path('^test/$', views.test)

3.re_path(正則表達式,函數名)
    一旦網址後綴的正則能夠匹配到內容就會自動執行後面的函數
    並結束整個路由的匹配
    當網址後綴不固定的時候 可以使用轉換器來匹配
4.正則匹配之無名分組
re_path('^test/(\d+)/', views.test)
   正則表達式匹配到的內容會當做視圖函數的位置參數傳遞給視圖函數
5.正則匹配之有名分組
re_path('^test/(?P<year>\d+)/(?P<others>.*?)/', views.test)
   正則表達式匹配到的內容會當做視圖函數的關鍵字參數傳遞給視圖函數
6.django版本區別
在django1.11中 只支援正則匹配 並且方法是 url()
django2,3,4中  path()  re_path() 等價於 url()
反向解析
1.什麼是反向解析
當路由頻繁變化的時候,html介面與後端上的連接地址如何做到動態解析?
根據自己設置的一個別名,動態解析出一個結果,該結構可以直接訪問對應的url
2.反向解析概念
通過一些方法得到一個結果 該結果可以直接訪問對應的url觸發視圖函數
實現url路由頻繁變化,html介面與後端動態解析連接地址操作步驟:
3.反向解析路由配置
1.先給路由與視圖函數起一個別名
url(r'^func_kkk/',views.func,name='ooo')  # name='ooo' 起別名
4.前後端反向解析
# 後端視圖函數反向解析
1.導入模組reverse
from django.shortcuts import render,HttpResponse,redirect,reverse

2.反向解析  關鍵字 reverse('ooo')

def home(request):
    print(reverse('ooo'))
    return render(request,'home.html')

# 前端反向解析

3.前端模板文件反向解析
<a href="{% url 'ooo' %}">111</a>
5.無名有名反向解析
1.當路由出現無名有名分組反向解析需要傳遞額外的參數
2.無名有名分組反向解析,目的就是需要給一個參數,如果有多個就是需要手動的給多個,這多個參數一般情況都是當前操作數據的主鍵值。

path('reg/<str:info>/', views.reg, name='reg_view')
當路由中有不確定的匹配因素 反向解析的時候需要人為給出一個具體的值

後端:
reverse('reg_view', args=('jason',))

前端:
{% url 'reg_view' 'jason' %}

ps:反向解析的操作三個方法都一樣path() re_path() url()
路由分發
1.django是專註於開發應用的,當一個django項目特別龐大的時候,所有的路由與視圖函數映射關係全部寫在項目名下urls.py(總路由層),很明顯太冗餘也不便於管理,這個時候也可以利用路由分發來減輕總路由的壓力。

2.django的每一個應用(app)都可以有自己獨立的urls.py路由器,static文件夾,templates文件夾。

3.基於上述特點,使用django做分組開發非常的簡便。每個人只需要寫自己的應用即可,互不干擾。最後由組長統一匯總到一個空的django項目中然後使用路由分發將多個應用關聯在一起,即可完成大項目的拼接。
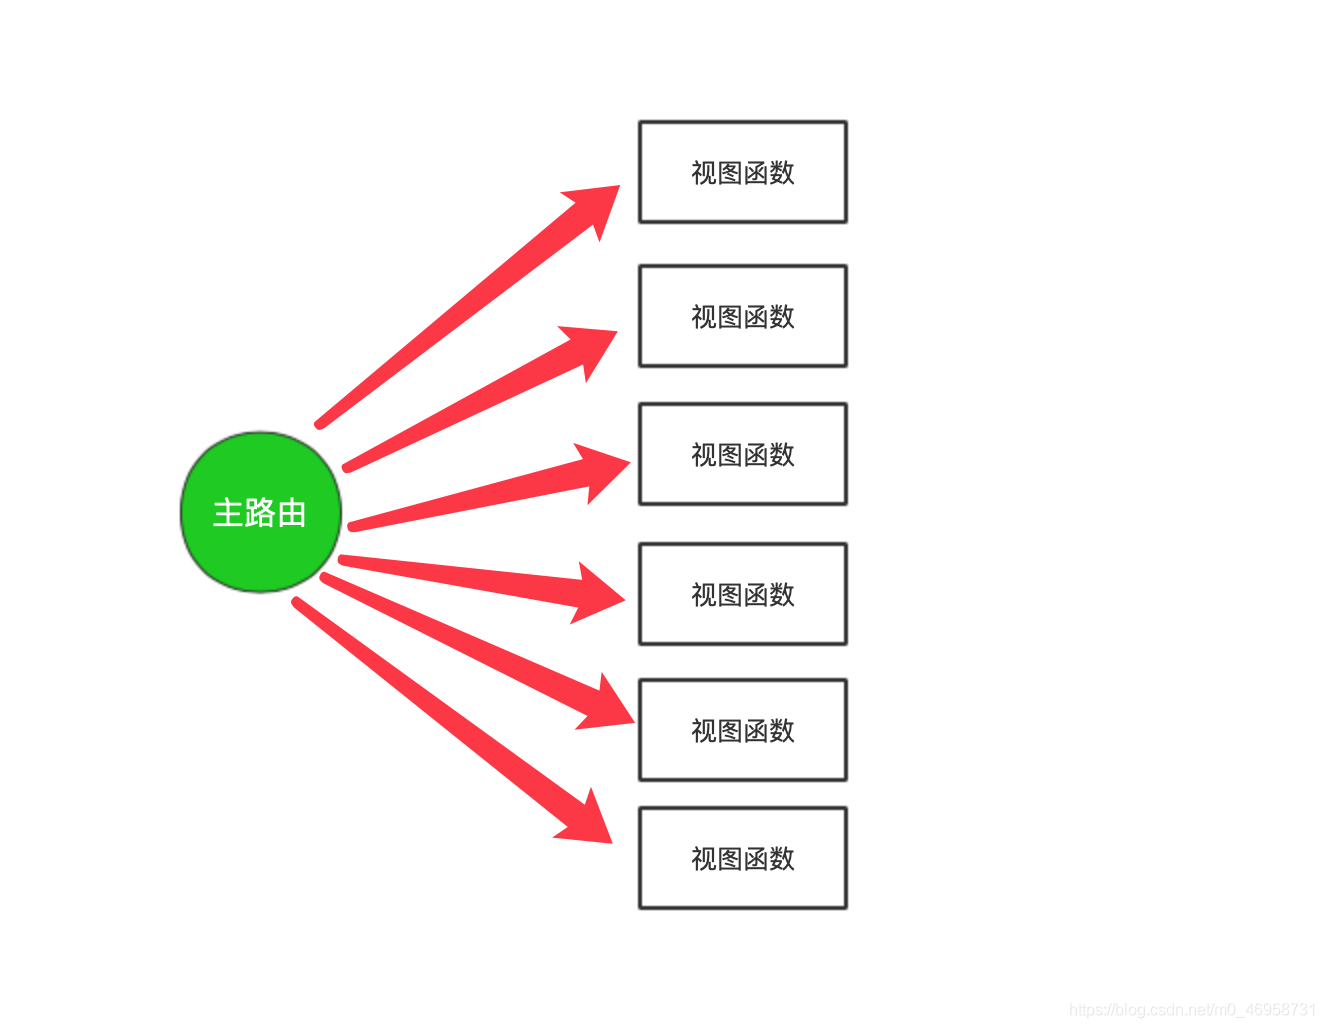
路由分發解決的就是項目的總路由匹配關係過多的情況

利用路由分發之後 總路由不再幹路由與視圖函數的直接對應關係

總路由而是做一個分發處理(識別當前url是屬於那個應用下的 直接分發對應的應用去處理)

請求來了之後 總路由不做對應關係 只詢問你要訪問哪個app的功能 然後將請求轉發給對應的app去處理

提前創建好 應用app01 應用app02 然後記得註冊
1.總路由配置
# 1.需要導入一個include路由分發模組
from django.conf.urls import url,include

# 2.導入子路由的uls(重名問題 起別名)
from app01 import urls as app01_urls
from app02 import urls as app02_urls
urlpatterns = [
    path('admin/', admin.site.urls),
    # 1.路由分發
    path('app01/',include(app01_urls)),  # 只要url前綴是app01開頭 全部交給app01下的urls處理
    path('app02/',include(app02_urls))   # 只要url前綴是app02開頭 全部交給app02下的urls處理
]
名稱空間
當多個應用出現了相同的別名 我們研究反向解析會不會自動識別應用前綴

反向解析:正常情況下的反向解析是沒有辦法自動識別前綴的
解決 方式一:名稱空間
# 總路由增加一個名稱空間
path('app01/', include(('app01.urls', 'app01'), namespace='app01')), # 創建名稱空間app01
path('app01/', include(('app01.urls', 'app02'), namespace='app02')),  # 創建名稱空間app02
# 子路由app01
urlpatterns = [
    path('after/',views.after, name='after_view')
]
# 後端
def reg(request):
    print(reverse('app01:after_view'))
    return HttpResponse('下午好 from app01')

# 前端
{% url 'app01:after_view' %}
解決 方式二:起別名
# 子路由app01
urlpatterns = [
    path('after/',views.after, name='app01_after_view')
]
# 後端
def reg(request):
    print(reverse('app01_after_view'))
    return HttpResponse('下午好 from app01')

# 前端
{% url 'app01:after_view' %}
1.其實只要保證名字不衝突 就沒有必要使用名稱空間

2.解決方法
一般情況下 有多個app的時候我們在起別名的時候會加上app的前綴
這樣的話就能夠確保多個app之間名字不衝突的問題