分庫分表之ShardingSphere
- 2022 年 8 月 22 日
- 筆記
分庫分表誕生的前景
隨著系統用戶運行時間還有用戶數量越來越多,整個資料庫某些表的體積急劇上升,導致CRUD的時候性能嚴重下降,還容易造成系統假死
這時候系統都會做一些基本的優化,比如加索引、快取、讀寫分離/主從複製,增刪改都走主庫,查詢走從庫。但是這樣沒法提升主庫寫的能力,因為主庫只有一個。這時候就要考慮分庫分表了,一般資料庫在設計的時候就會提前考慮到是否有分庫分表場景需要,避免後期帶來遷移的問題,而且最好對錶的查詢足夠簡單,盡量避免跨表跨庫查詢。
阿里的開發規範中建議預估三年內單表數據量上500W,或者大小上2G,就要考慮分庫分表
分庫分表的方式(垂直拆分,水平複製)
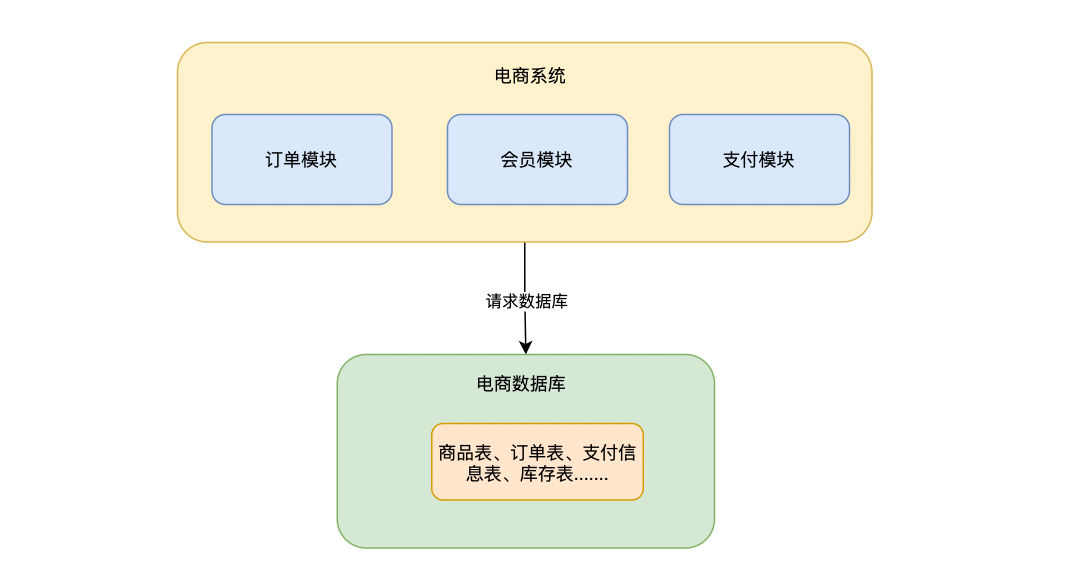
一般系統模組都是訪問同一個資料庫資源,所有的表都存放在一個庫裡面
1.垂直拆分
1.1 垂直分庫
把單一的資料庫進行業務劃分,專庫專表
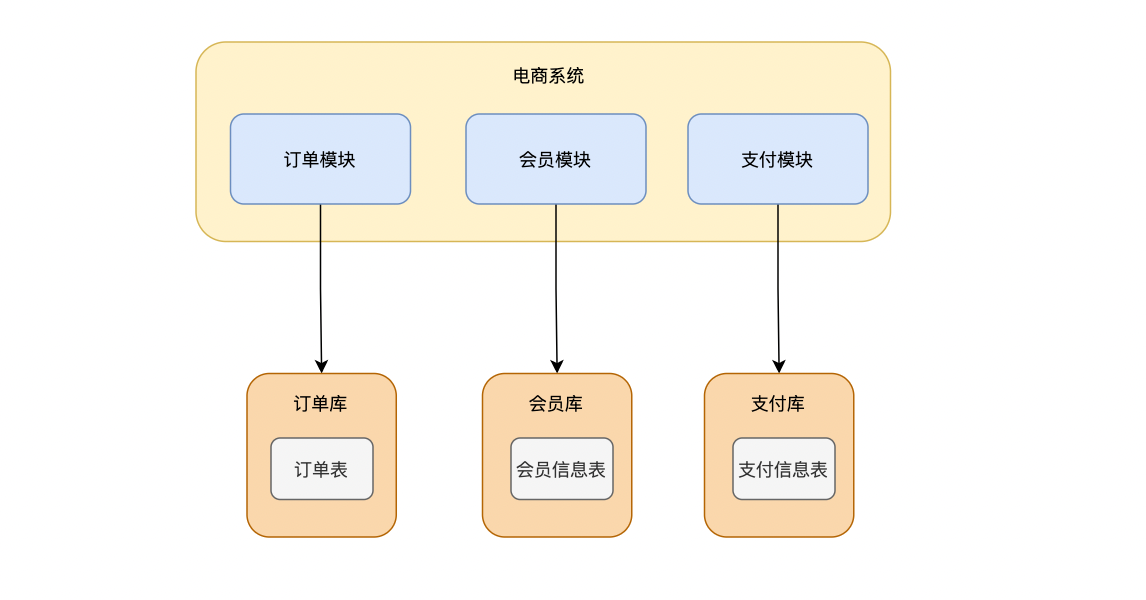
經過垂直拆分之後,每個模組都使用各自獨立的資料庫,減輕了資料庫的壓力,業務也更加清晰,拓展也更容易了,但是會增加連表查詢以及事務處理的複雜度,無法解決單表數據量太大的問題
1.2 垂直分表
垂直拆分表主要解決一張表太多欄位某個欄位存儲值為大文本會對io查詢有損耗所以把本來屬於同一個對象描述的屬性拆分多個表,分散式微服務分庫分表盡量不要嚴苛遵守資料庫的3大範式,可參考不可嚴格遵循
相當於把一個大表根據欄位拆分成多個小表 ,一個10w數據的表,變成兩個10w數據的表
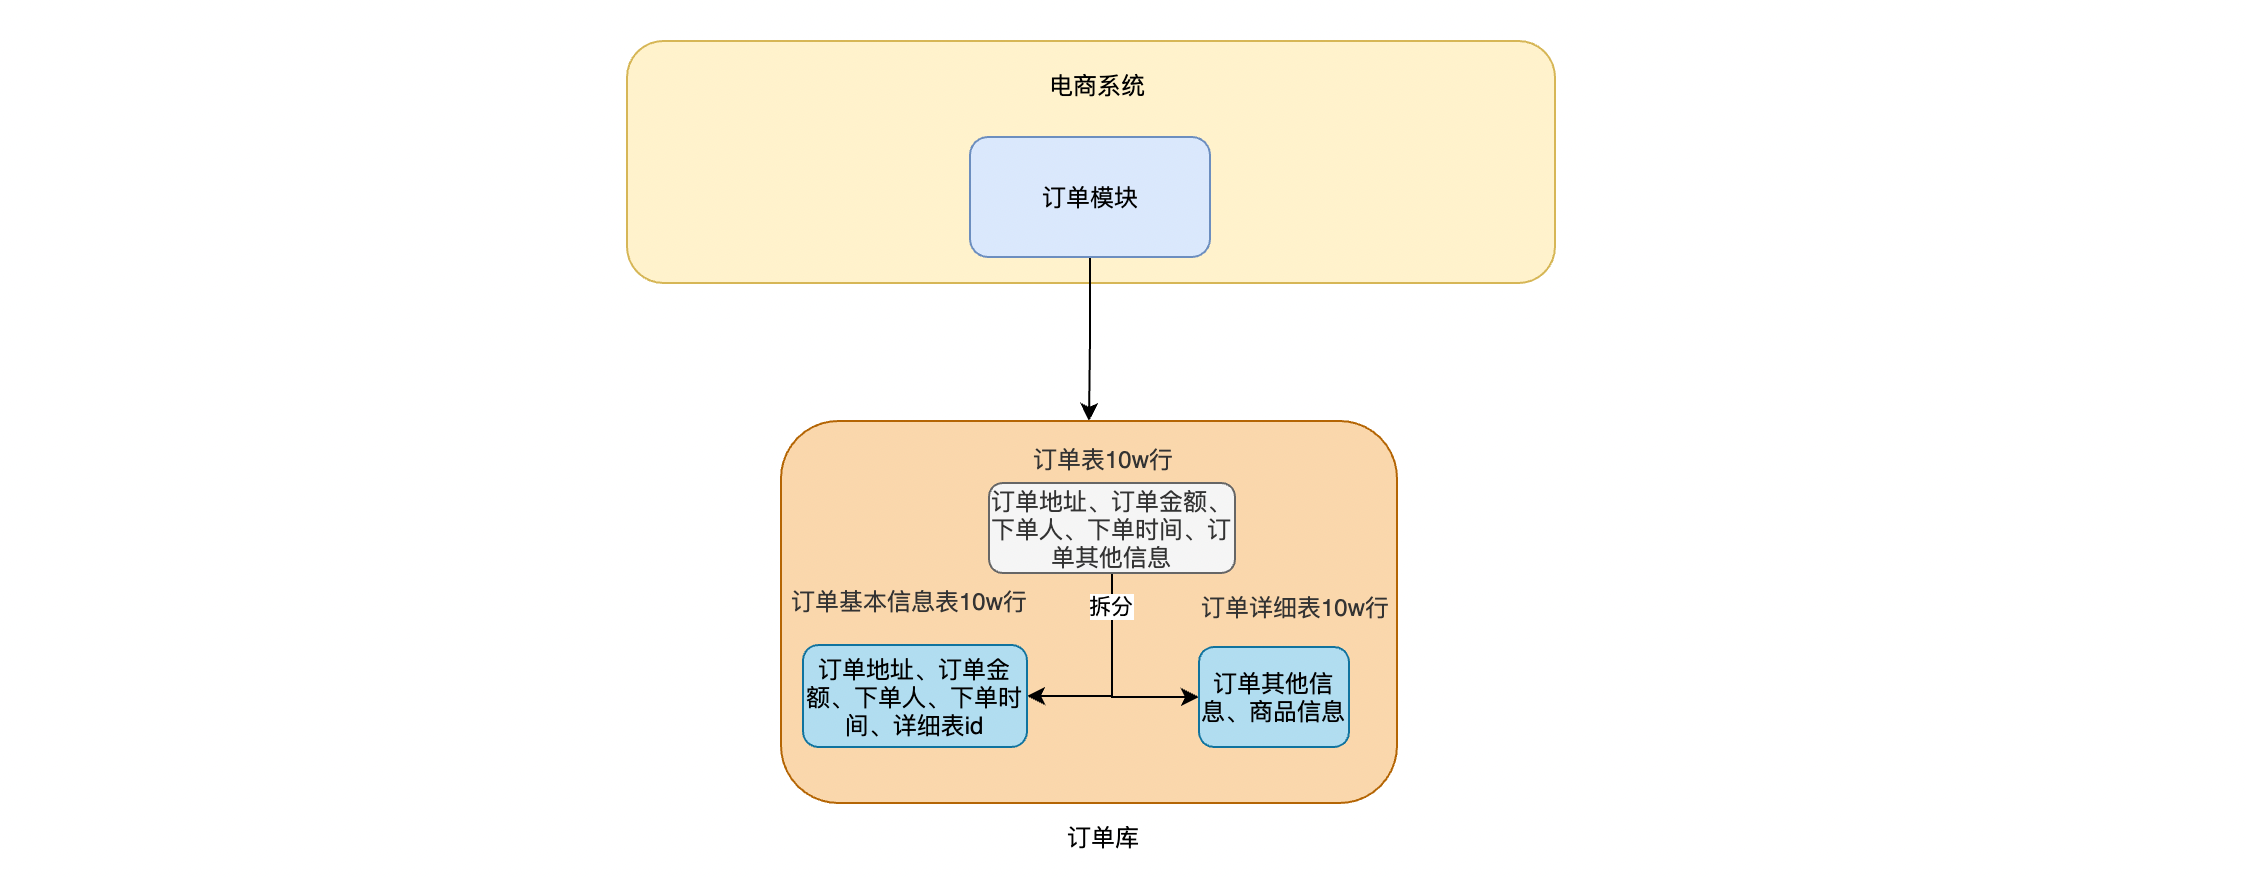
這樣拆分的好處就是,假如只顯示列表,不需要顯示詳細資訊就很方便,例如一個訂單是包含很多資訊的,但是在後台通常不需要去獲取訂單的詳情資訊用作展示,一般只需要展示概要資訊:下單用戶、下單時間、金額等等重要資訊。於是可以把一個訂單表垂直拆分為兩個表來處理
2.水平拆分
2.1 水平分庫
把一個資料庫分散成多個結構相同的資料庫,本質就是複製操作
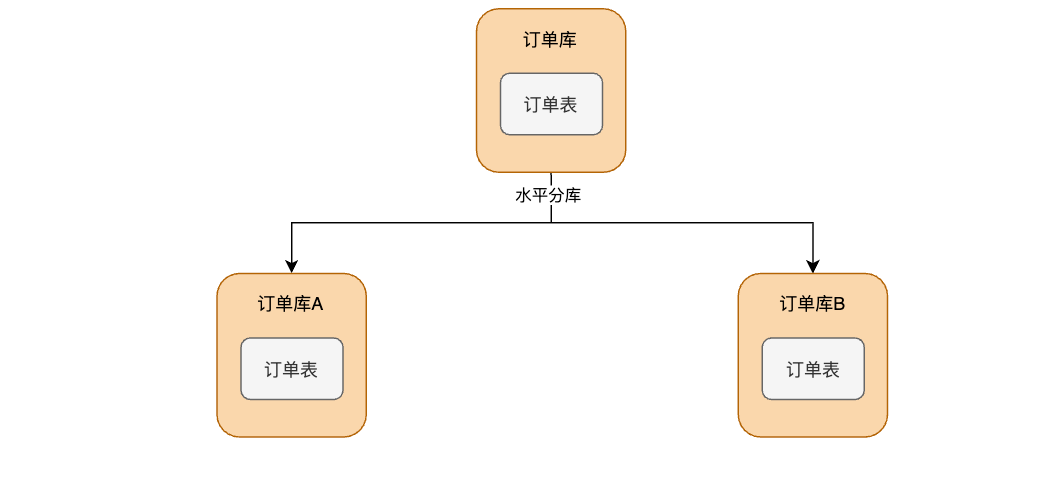
2.2 水平分表
一個表數據量太大,將一個表按不同的條件分散多個表中,把1000w的表拆分為兩個500w的表
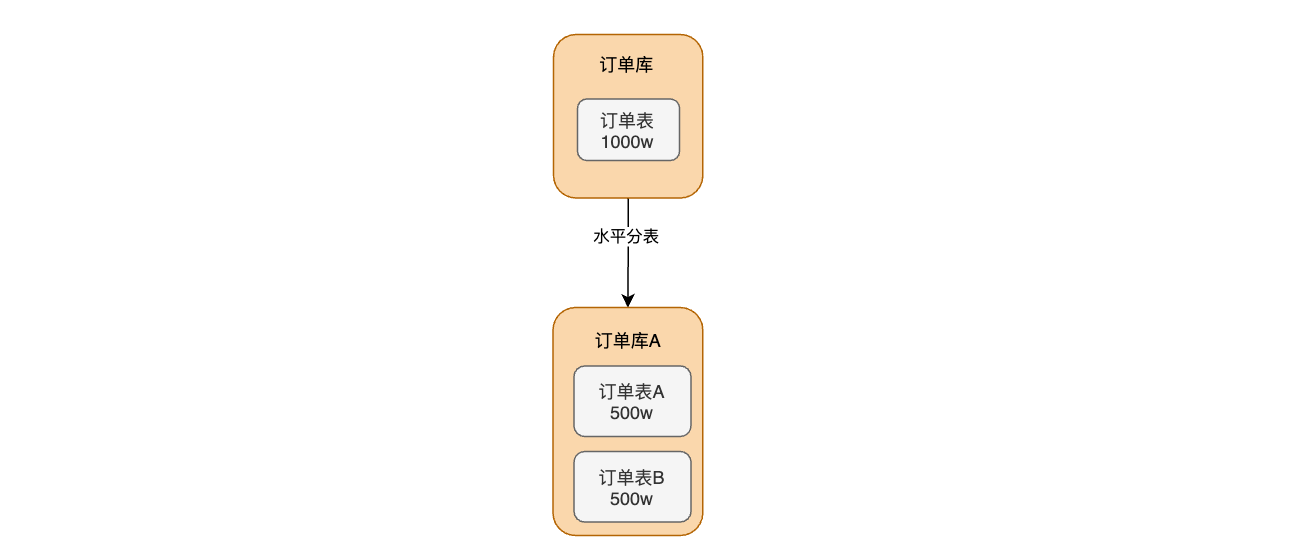
分表的規則有很多種:
-
取範圍
根據時間範圍或者id範圍分布到不同的庫中,例如把2020年前的數據放到一個表中,之後的數據放到一個表中。把用戶ID 0~100000放到一個表中,100000~200000的數據放到一個表中。
優點:使用分片欄位範圍查詢比較方便
缺點:某段範圍內熱點數據可能被頻繁讀寫,其他數據很少被查詢
-
數值hash取模運算
根據某個欄位進行運算均勻的分配到不同的表中
優點:分散比較均勻,不容易存在熱點數據
缺點:數據太分散,導致範圍查詢比較麻煩,需要查詢分庫之後再合併
水平拆分的時候會導致多庫多表的聯合查詢難度變大,以及多數據源管理的問題
分庫分庫中間件
ShardingSphere
官網://shardingsphere.apache.org/
ShardingSphere是一個關係型資料庫中間件,它由Sharding-JDBC、Sharding-Proxy和Sharding-Sidecar(計劃中)這3款相互獨立的產品組成,主要提供資料庫分片以及分散式事務
Sharding-JDBC
Sharding-JDBC簡化分庫分表之後數據相關操作,它一個輕量級的Java框架,是增強版的JDBC驅動,以jar包的形式提供引入非常簡單,適用於很多ORM框架以及資料庫連接池,Sharding-JDBC不做分庫分表,主要做兩個功能:數據分片和讀寫分離,簡化分庫分表後對數據的操作
實現水平分表
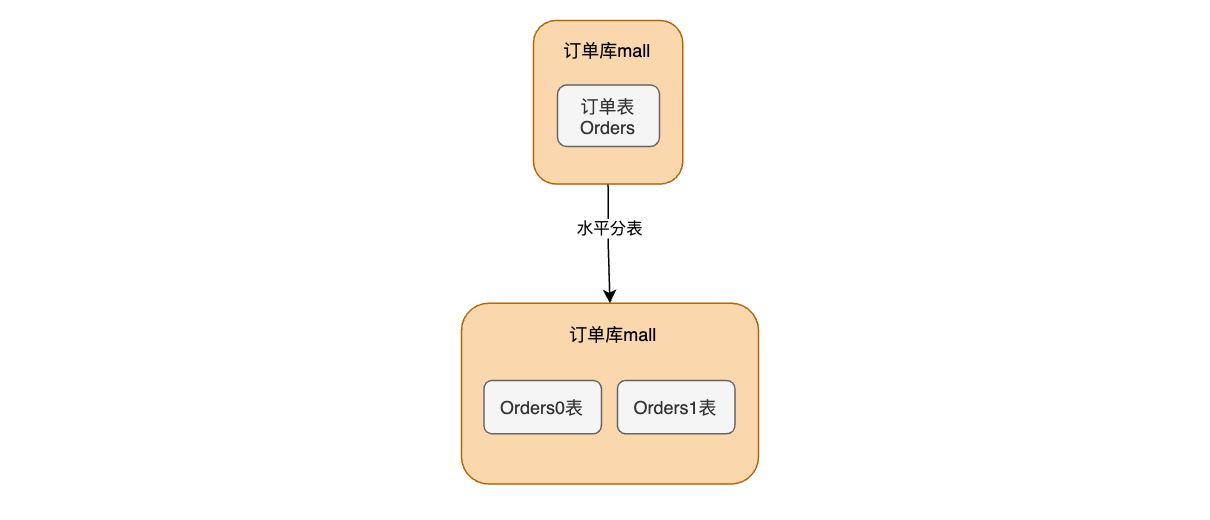
環境搭建:SpringBoot+mybatisPlus
1、首先創建一個springboot項目,引入相關依賴jar包
   <!-- Sharding-JDBC -->
        <dependency>
            <groupId>org.apache.shardingsphere</groupId>
            <artifactId>sharding-jdbc-spring-boot-starter</artifactId>
            <version>4.0.0-RC1</version>
        </dependency>
        <!-- Mysql驅動依賴 -->
        <dependency>
            <groupId>mysql</groupId>
            <artifactId>mysql-connector-java</artifactId>
            <version>8.0.29</version>
        </dependency>
        <!-- Druid連接池 -->
        <dependency>
            <groupId>com.alibaba</groupId>
            <artifactId>druid</artifactId>
            <version>1.2.8</version>
        </dependency>
        <!--mybatisPlus-->
        <dependency>
            <groupId>com.baomidou</groupId>
            <artifactId>mybatis-plus-boot-starter</artifactId>
            <version>3.5.1</version>
        </dependency>

        <dependency>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-starter</artifactId>
        </dependency>
        <dependency>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-starter-web</artifactId>
        </dependency>
        <dependency>
            <groupId>org.projectlombok</groupId>
            <artifactId>lombok</artifactId>
            <optional>true</optional>
        </dependency>
        <dependency>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-starter-test</artifactId>
            <scope>test</scope>
        </dependency>
2、創建資料庫表結構
創建一個mall資料庫,然后里面創建兩張表分別為:order0、order1
CREATE DATABASE `mall`

CREATE TABLE `orders0` (
  `id` bigint NOT NULL AUTO_INCREMENT,
  `order_number` varchar(50) NOT NULL,
  `create_time` date NOT NULL,
  `creater` varchar(20) NOT NULL,
  `money` decimal(10,0) NOT NULL,
  PRIMARY KEY (`id`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_0900_ai_ci;

CREATE TABLE `orders1` (
  `id` bigint NOT NULL AUTO_INCREMENT,
  `order_number` varchar(50) NOT NULL,
  `create_time` date NOT NULL,
  `creater` varchar(20) NOT NULL,
  `money` decimal(10,0) NOT NULL,
  PRIMARY KEY (`id`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_0900_ai_ci;
3、約定分片規則
如果訂單號order_number為奇數添加到orders0,否則添加到orders1
4、建立相關實體類、DAO
/**
 * @author yanglingcong
 */
@Data
public class Orders implements Serializable {

    private Long id;

    private String orderNumber;

    private Timestamp createTime;

    private String creater;

    private double money;

}
OrderDao
/**
 * @author yanglingcong
 */
@Mapper
public interface OrderDao extends BaseMapper<Orders> {

}
5、配置分片策略以及數據源
application.properties
server.port=8099

spring.application.name=sharding-jdbc-demo

spring.profiles.active=dev


#指定資料庫連接資訊
spring.shardingsphere.datasource.names=db0
spring.shardingsphere.datasource.db0.type=com.alibaba.druid.pool.DruidDataSource
spring.shardingsphere.datasource.db0.driver-class-name=com.mysql.cj.jdbc.Driver
spring.shardingsphere.datasource.db0.url=jdbc:mysql://xxx:3306/mall?serverTimezone=GMT%2B8
spring.shardingsphere.datasource.db0.username=root
spring.shardingsphere.datasource.db0.password=xxx

# 一個實體類對應兩張表,覆蓋
spring.main.allow-bean-definition-overriding=true

#指定主鍵id列的生成策略 SNOWFLAKE表示雪花
spring.shardingsphere.sharding.tables.orders.key-generator.column=id
spring.shardingsphere.sharding.tables.orders.key-generator.type=SNOWFLAKE

#指定表的分布  order資料庫的order1和order2表
spring.shardingsphere.sharding.tables.orders.actual-data-nodes=db0.orders$->{0..1}

#指定分片策略  約定根據訂單號order_number分片 奇數添加到`order1`,否則添加到`order2`  表索引從1開始的,所以加上1
spring.shardingsphere.sharding.tables.orders.table-strategy.inline.sharding-column=id
spring.shardingsphere.sharding.tables.orders.table-strategy.inline.algorithm-expression=orders$->{id % 2}

#sql輸出日誌
spring.shardingsphere.props.sql.show=true
6、測試生成
@RunWith(SpringRunner.class)
@SpringBootTest
public class ShardingJdbcDemoApplicationTests {
    @Autowired
    OrderDao orderDao;

    @Test
    void insertTest() {
        for (int i = 0; i < 1; i++) {
            Orders order=new Orders();
            order.setCreater("ylc");
            order.setOrderNumber("6");
            order.setCreateTime(new Timestamp(System.currentTimeMillis()));
            order.setMoney(30.01);
            orderDao.insert(order);
        }
    }

    @Test
    void  selectTest(){
        QueryWrapper<Orders> queryWrapper=new QueryWrapper<>();
        queryWrapper.eq("id",1553218859002007553L);
        Orders orders = orderDao.selectOne(queryWrapper);
        System.out.println(orders);
    }
}
最後根據生成的雪花id插入到了資料庫中
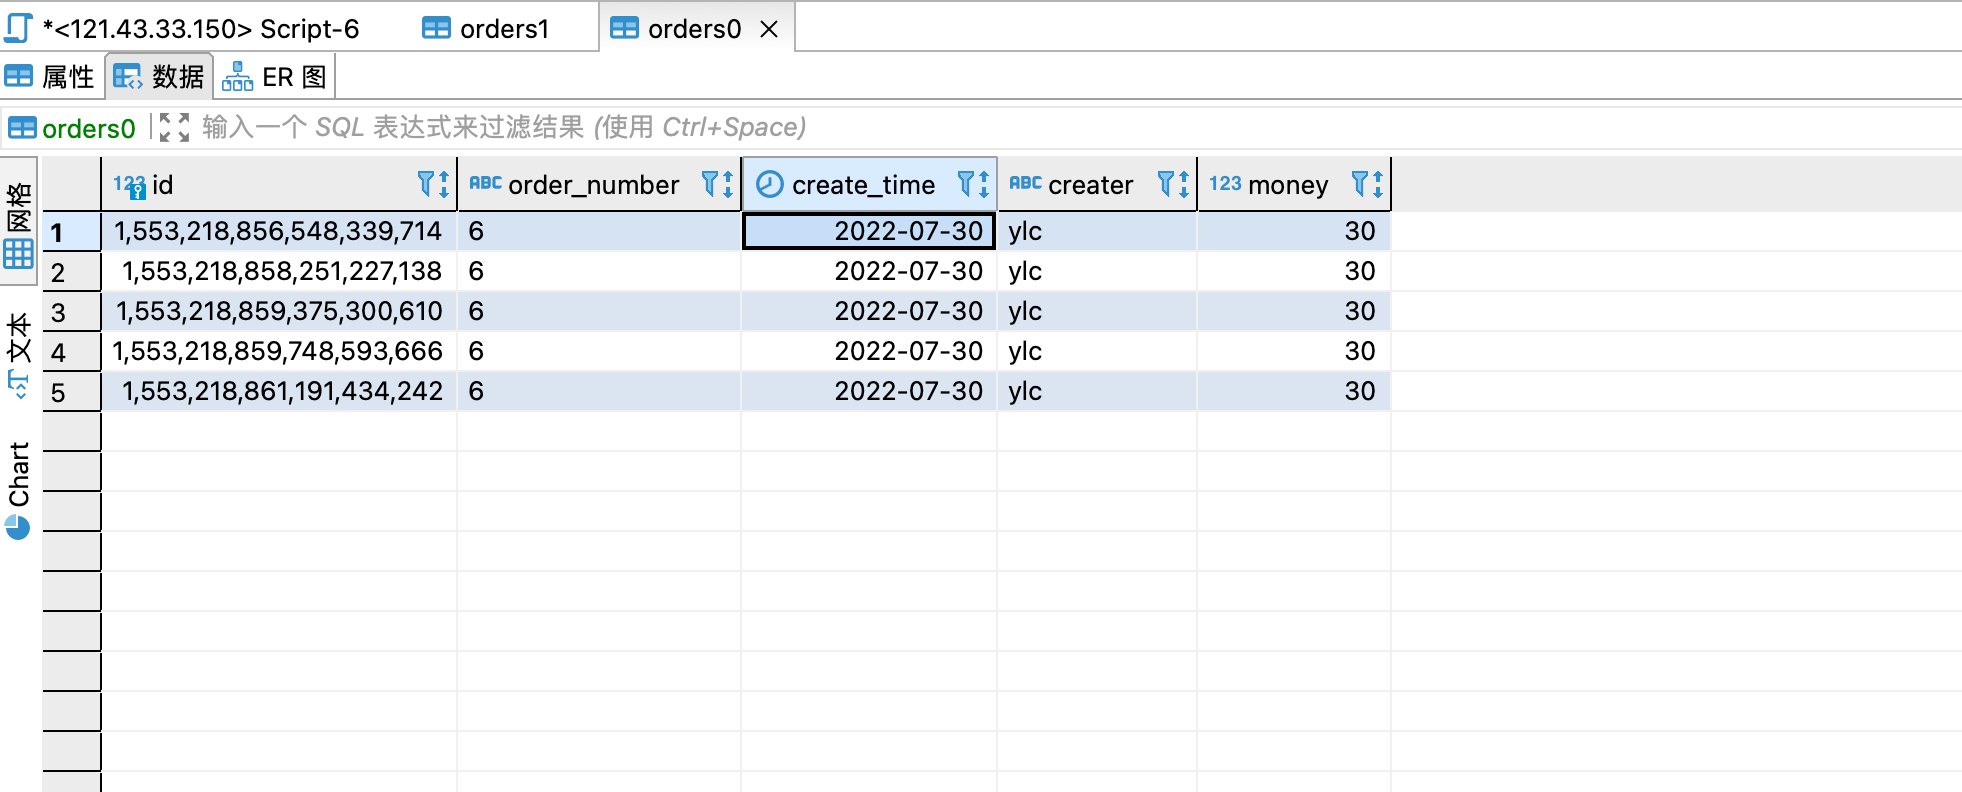
查詢也會根據雪花id找到對應的表
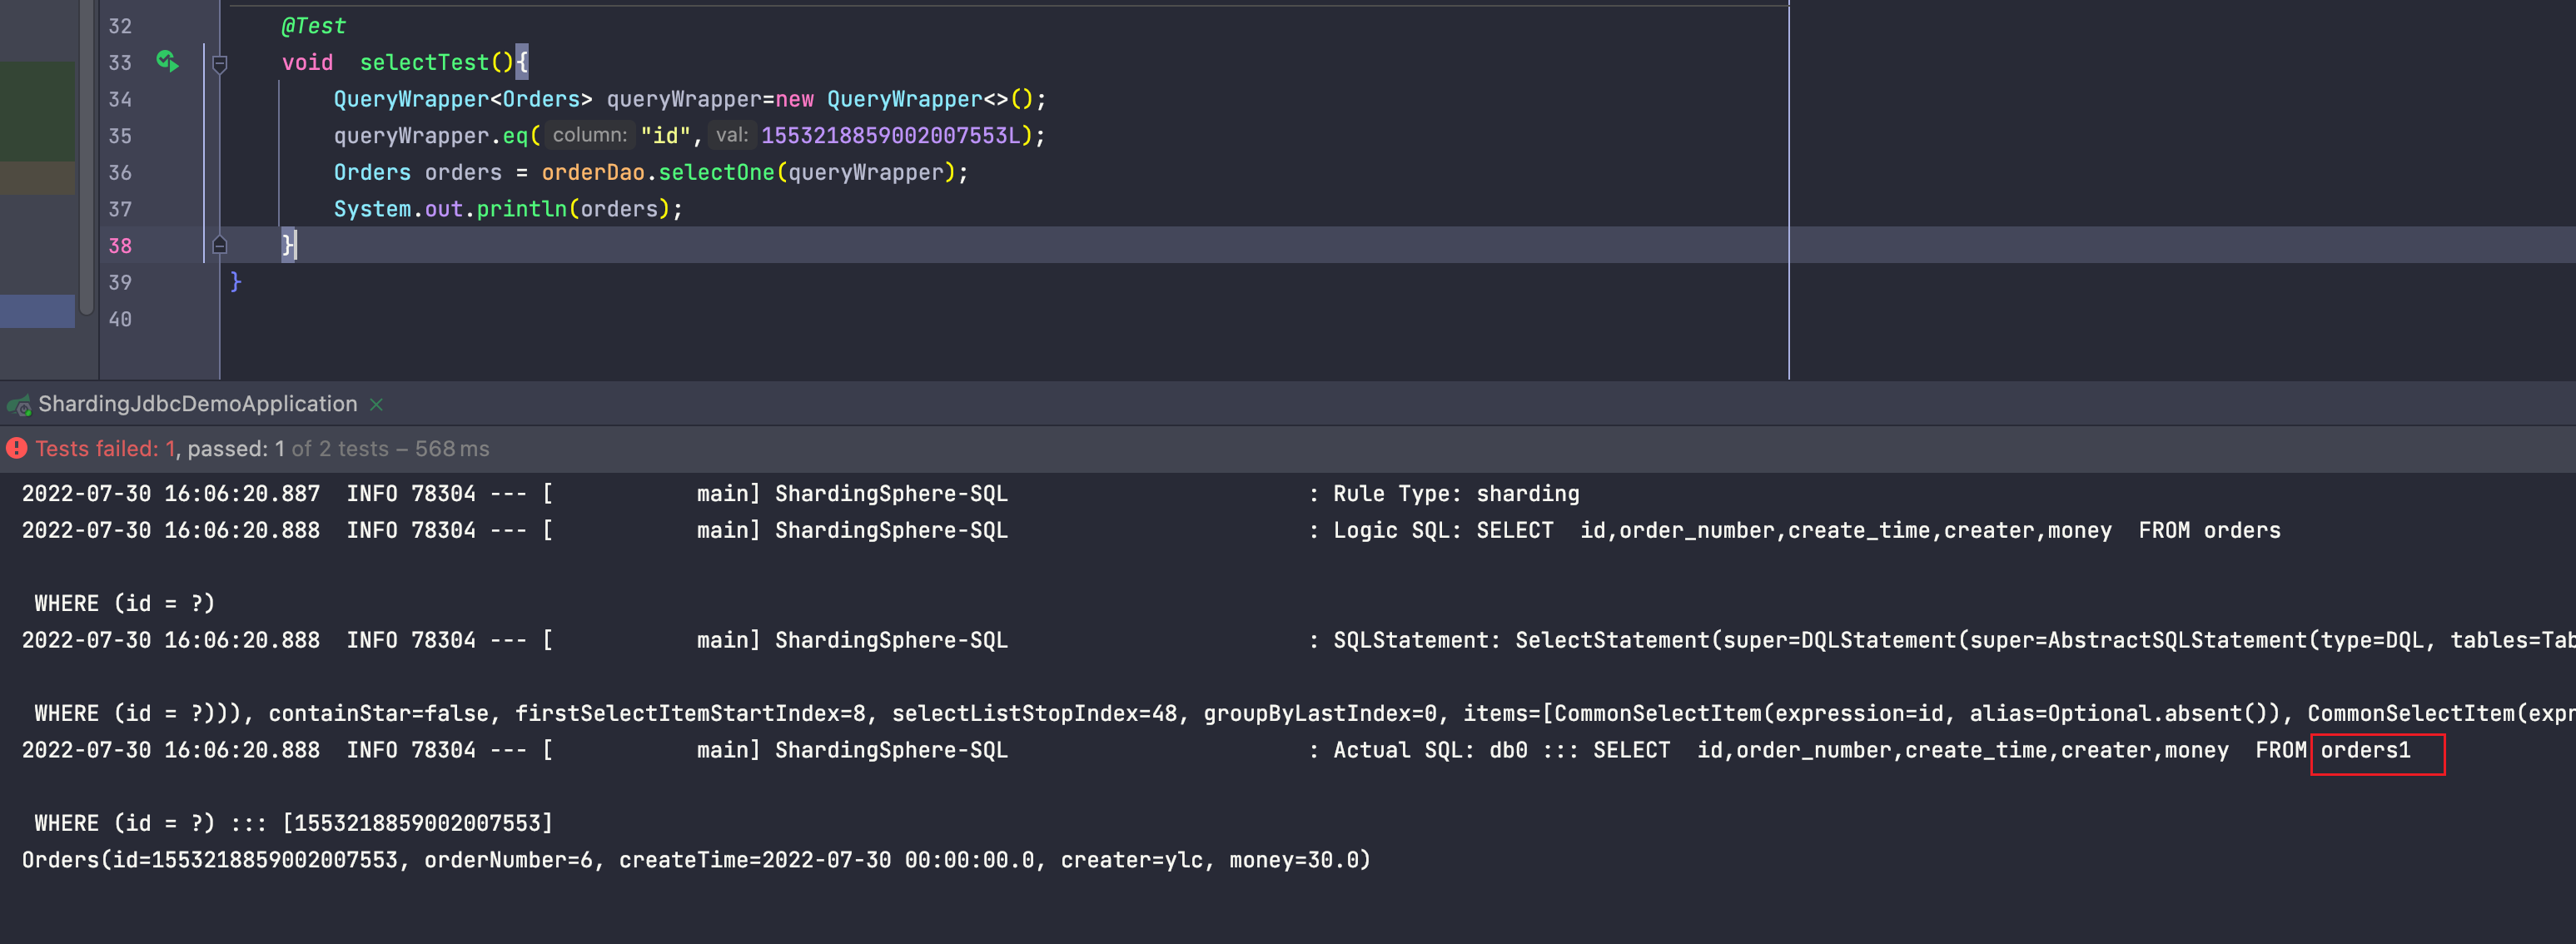
sharding-jdbc水平分表就是提前做好分表,然後配置分表規則,就可以讓數據插入在不同的表中了,這裡只是指定了一個數據源,還可以指定多個數據源
實現水平分庫
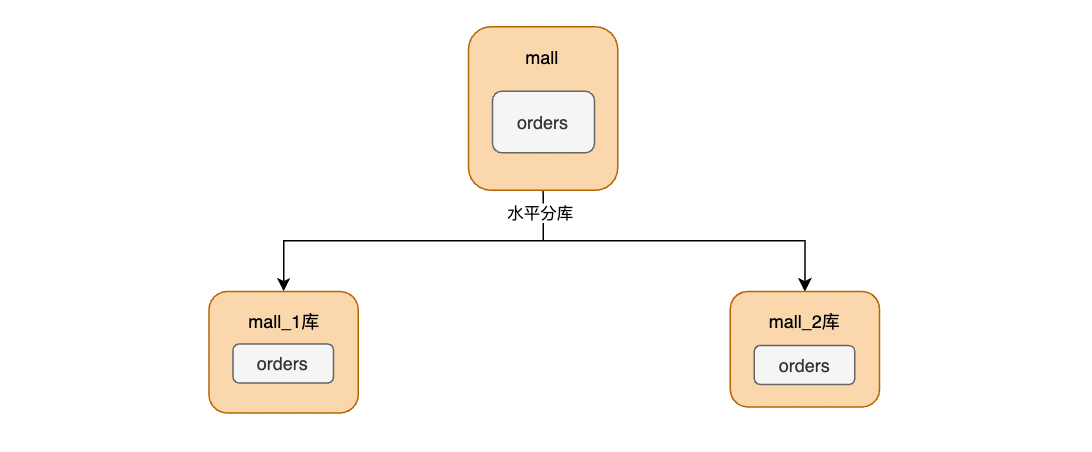
水平分庫規則為:根據表裡面的訂單號欄位orderNumber,奇數就路由到mall_1庫,偶數路由到mall_2庫
1、更改配置文件
server.port=8099

spring.application.name=sharding-jdbc-demo

spring.profiles.active=dev


spring.shardingsphere.sharding.default-data-source-name=db1
#指定資料庫連接資訊
spring.shardingsphere.datasource.names=db1,db2
spring.shardingsphere.datasource.db1.type=com.alibaba.druid.pool.DruidDataSource
spring.shardingsphere.datasource.db1.driver-class-name=com.mysql.cj.jdbc.Driver
spring.shardingsphere.datasource.db1.url=jdbc:mysql://xxx:3306/mall_1?serverTimezone=GMT%2B8
spring.shardingsphere.datasource.db1.username=root
spring.shardingsphere.datasource.db1.password=xxx

spring.shardingsphere.datasource.db2.type=com.alibaba.druid.pool.DruidDataSource
spring.shardingsphere.datasource.db2.driver-class-name=com.mysql.cj.jdbc.Driver
spring.shardingsphere.datasource.db2.url=jdbc:mysql://xxx:3306/mall_2?serverTimezone=GMT%2B8
spring.shardingsphere.datasource.db2.username=root
spring.shardingsphere.datasource.db2.password=xxx

# 一個實體類對應兩張表,覆蓋
spring.main.allow-bean-definition-overriding=true

#指定主鍵id列的生成策略 SNOWFLAKE表示雪花
spring.shardingsphere.sharding.tables.orders.key-generator.column=id
spring.shardingsphere.sharding.tables.orders.key-generator.type=SNOWFLAKE

#指定庫的分布
spring.shardingsphere.sharding.tables.orders.actual-data-nodes=db$->{1..2}.orders0


#指定資料庫分表策略  根據order_number奇數就路由到mall_1庫,偶數路由到mall_2庫
spring.shardingsphere.sharding.tables.orders.database-strategy.inline.sharding-column=order_number
spring.shardingsphere.sharding.tables.orders.database-strategy.inline.algorithm-expression=db$->{order_number % 2+1}

#sql輸出日誌
spring.shardingsphere.props.sql.show=true
2、更改實體
/**
 * @author yanglingcong
 */
@Data
public class Orders implements Serializable {

    private Long id;

    private long orderNumber;

    private Timestamp createTime;

    private String creater;

    private double money;

}
3、sql腳本
CREATE DATABASE `mall_0`

CREATE TABLE `orders0` (
  `id` bigint NOT NULL AUTO_INCREMENT,
  `order_number` bigint NOT NULL,
  `create_time` date NOT NULL,
  `creater` varchar(20) NOT NULL,
  `money` decimal(10,0) NOT NULL,
  PRIMARY KEY (`id`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_0900_ai_ci;

CREATE DATABASE `mall_1`

CREATE TABLE `orders0` (
  `id` bigint NOT NULL AUTO_INCREMENT,
  `order_number` bigint NOT NULL,
  `create_time` date NOT NULL,
  `creater` varchar(20) NOT NULL,
  `money` decimal(10,0) NOT NULL,
  PRIMARY KEY (`id`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_0900_ai_ci;
4、插入數據
    @Test
    void insertTest() {
        for (int i = 0; i < 3; i++) {
            Orders order=new Orders();
            order.setCreater("ylc");
            order.setOrderNumber(i);
            order.setCreateTime(new Timestamp(System.currentTimeMillis()));
            order.setMoney(30.01);
            orderDao.insert(order);
        }
    }

    @Test
    void  selectTest(){
        QueryWrapper<Orders> queryWrapper=new QueryWrapper<>();
        queryWrapper.eq("order_number",1553314824824299522L);
        Orders orders = orderDao.selectOne(queryWrapper);
        System.out.println(orders);
    }
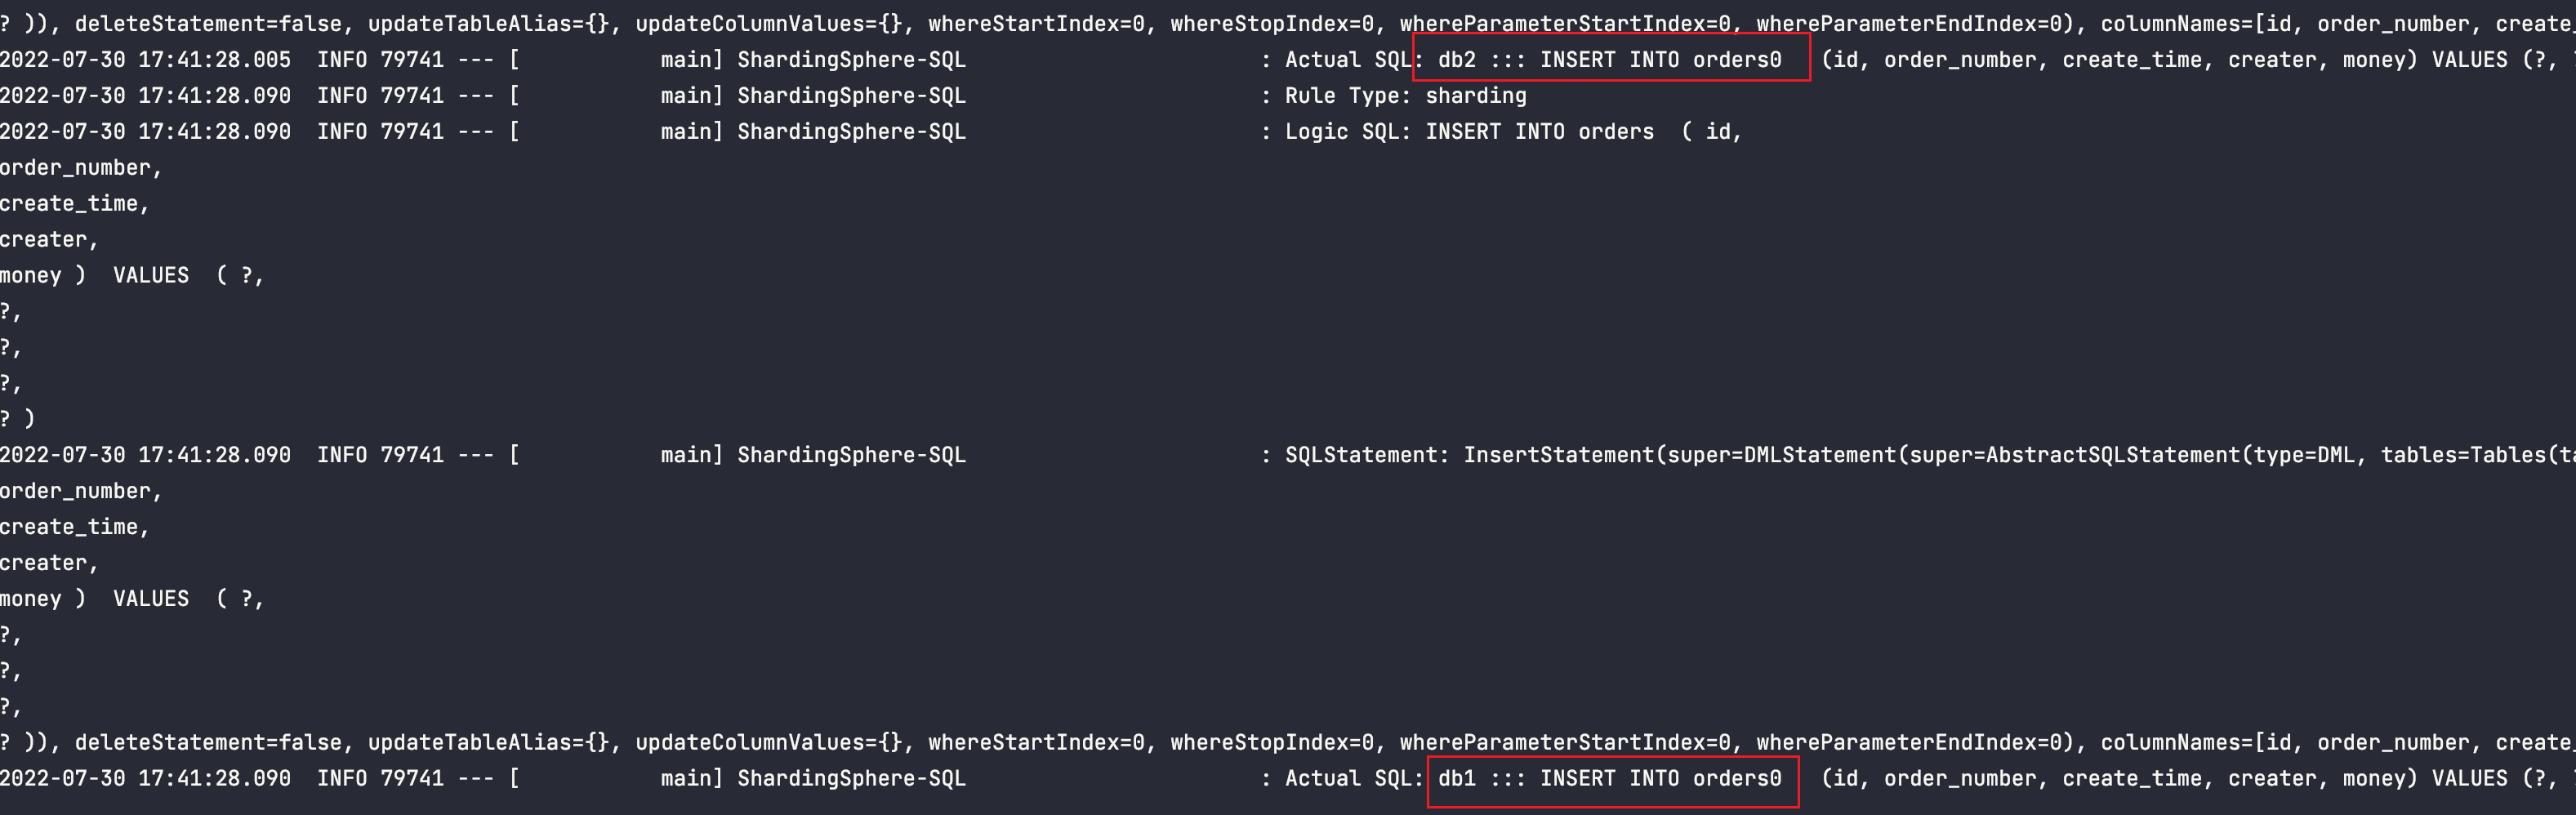
很簡單就實現了分庫功能,分庫分表就是把這兩種方式結合到了一起
分庫分表查詢,分庫分表欄位為必傳欄位,否則不知道去哪個資料庫哪張表去查詢數據,所以根據非主鍵查詢的不支援。
實現垂直分庫
垂直分庫相當於專庫專表,可以使用多數據源來處理,也可以通過sharding-Jdbc
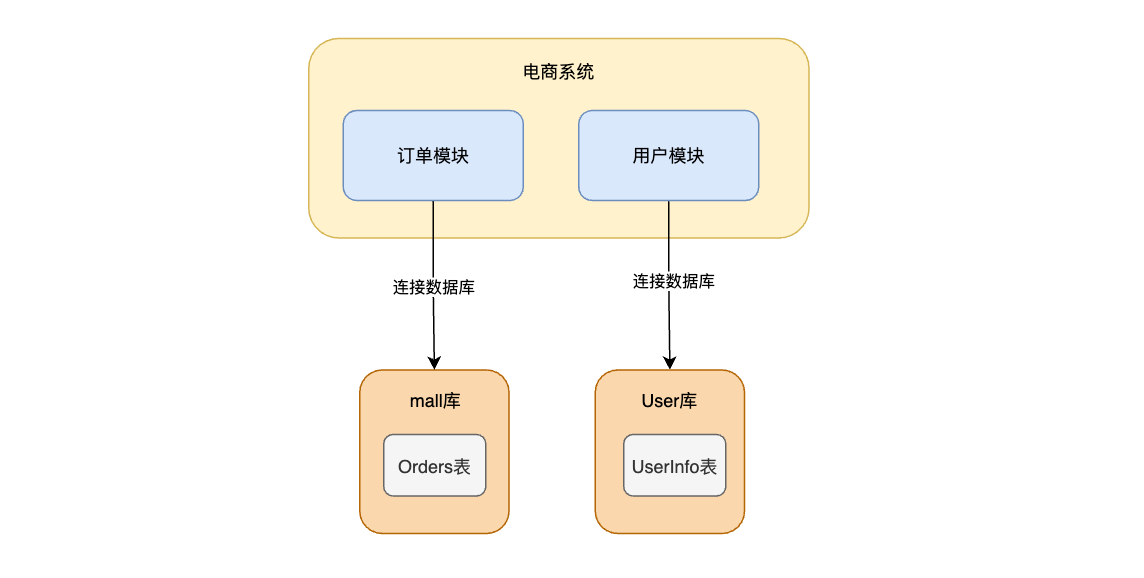
垂直分庫的規則為:往訂單表orders插入數據,會自動找到訂單表所在的庫mall進行操作。往用戶表插入數據,會自動找到所在庫User進行操作
1、資料庫腳本
CREATE DATABASE `user`

CREATE TABLE `user`.userInfo (
	id BIGINT auto_increment NOT NULL,
	user_name varchar(20) NOT NULL,
	password varchar(50) NOT NULL,
	CONSTRAINT userinfo_PK PRIMARY KEY (id)
)
ENGINE=InnoDB
DEFAULT CHARSET=utf8mb4
COLLATE=utf8mb4_0900_ai_ci
AUTO_INCREMENT=1;

CREATE DATABASE `user`


CREATE DATABASE `mall`

CREATE TABLE `orders` (
  `id` bigint NOT NULL AUTO_INCREMENT,
  `order_number` bigint NOT NULL,
  `create_time` date NOT NULL,
  `creater` varchar(20) NOT NULL,
  `money` decimal(10,0) NOT NULL,
  PRIMARY KEY (`id`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_0900_ai_ci;
2、創建相關實體類
UserInfo
@Data
public class UserInfo {
    private Long id;

    private String userName;

    private String password;
}
Orders
@Data
public class Orders implements Serializable {

    private Long id;

    private long orderNumber;

    private Timestamp createTime;

    private String creater;

    private double money;
}
3、Dao類
@Mapper
public interface UserInfoDao extends BaseMapper<UserInfo> {
}
4、配置垂直分庫策略
server.port=8099

spring.application.name=sharding-jdbc-demo

spring.profiles.active=dev


spring.shardingsphere.sharding.default-data-source-name=db1
#指定資料庫連接資訊
spring.shardingsphere.datasource.names=db1,db2
spring.shardingsphere.datasource.db1.type=com.alibaba.druid.pool.DruidDataSource
spring.shardingsphere.datasource.db1.driver-class-name=com.mysql.cj.jdbc.Driver
spring.shardingsphere.datasource.db1.url=jdbc:mysql://xxx:3306/mall?serverTimezone=GMT%2B8
spring.shardingsphere.datasource.db1.username=root
spring.shardingsphere.datasource.db1.password=xxx

spring.shardingsphere.datasource.db2.type=com.alibaba.druid.pool.DruidDataSource
spring.shardingsphere.datasource.db2.driver-class-name=com.mysql.cj.jdbc.Driver
spring.shardingsphere.datasource.db2.url=jdbc:mysql://xxx:3306/user?serverTimezone=GMT%2B8
spring.shardingsphere.datasource.db2.username=root
spring.shardingsphere.datasource.db2.password=xxx

# 一個實體類對應兩張表,覆蓋
spring.main.allow-bean-definition-overriding=true

#指定主鍵id列的生成策略 SNOWFLAKE表示雪花
spring.shardingsphere.sharding.tables.orders.key-generator.column=id
spring.shardingsphere.sharding.tables.orders.key-generator.type=SNOWFLAKE

spring.shardingsphere.sharding.tables.userInfo.key-generator.column=id
spring.shardingsphere.sharding.tables.userInfo.key-generator.type=SNOWFLAKE

#指定orders表所在的庫 userInfo表所在的庫
spring.shardingsphere.sharding.tables.orders.actual-data-nodes=db1.orders
spring.shardingsphere.sharding.tables.userInfo.actual-data-nodes=db2.userInfo


#指定orders表分片策略
spring.shardingsphere.sharding.tables.orders.table-strategy.inline.sharding-column=id
spring.shardingsphere.sharding.tables.orders.table-strategy.inline.algorithm-expression=orders


#指定數userInfo分片策略
spring.shardingsphere.sharding.tables.userInfo.table-strategy.inline.sharding-column=id
spring.shardingsphere.sharding.tables.userInfo.table-strategy.inline.algorithm-expression=userInfo

#sql輸出日誌
spring.shardingsphere.props.sql.show=true
5、插入數據
Orders表在mall庫
    @Test
    void insertOrdersTest() {
            Orders order=new Orders();
            order.setCreater("ylc");
            order.setOrderNumber(1);
            order.setCreateTime(new Timestamp(System.currentTimeMillis()));
            order.setMoney(30.01);
            orderDao.insert(order);
    }
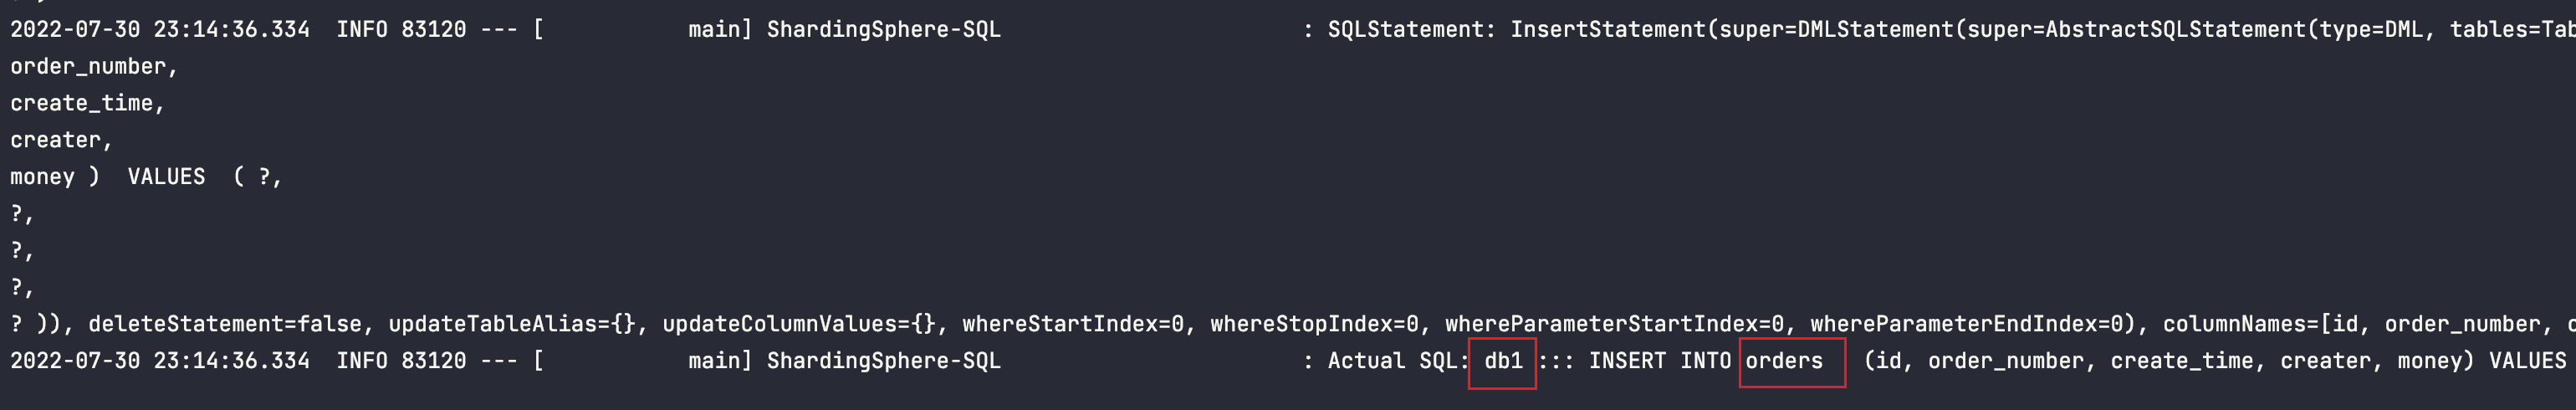
UserInfo表在user庫
    @Test
    void insertUserTest() {
        UserInfo userInfo=new UserInfo();
        userInfo.setUserName("ylc");
        userInfo.setPassword("123456");
        userInfoDao.insert(userInfo);
    }
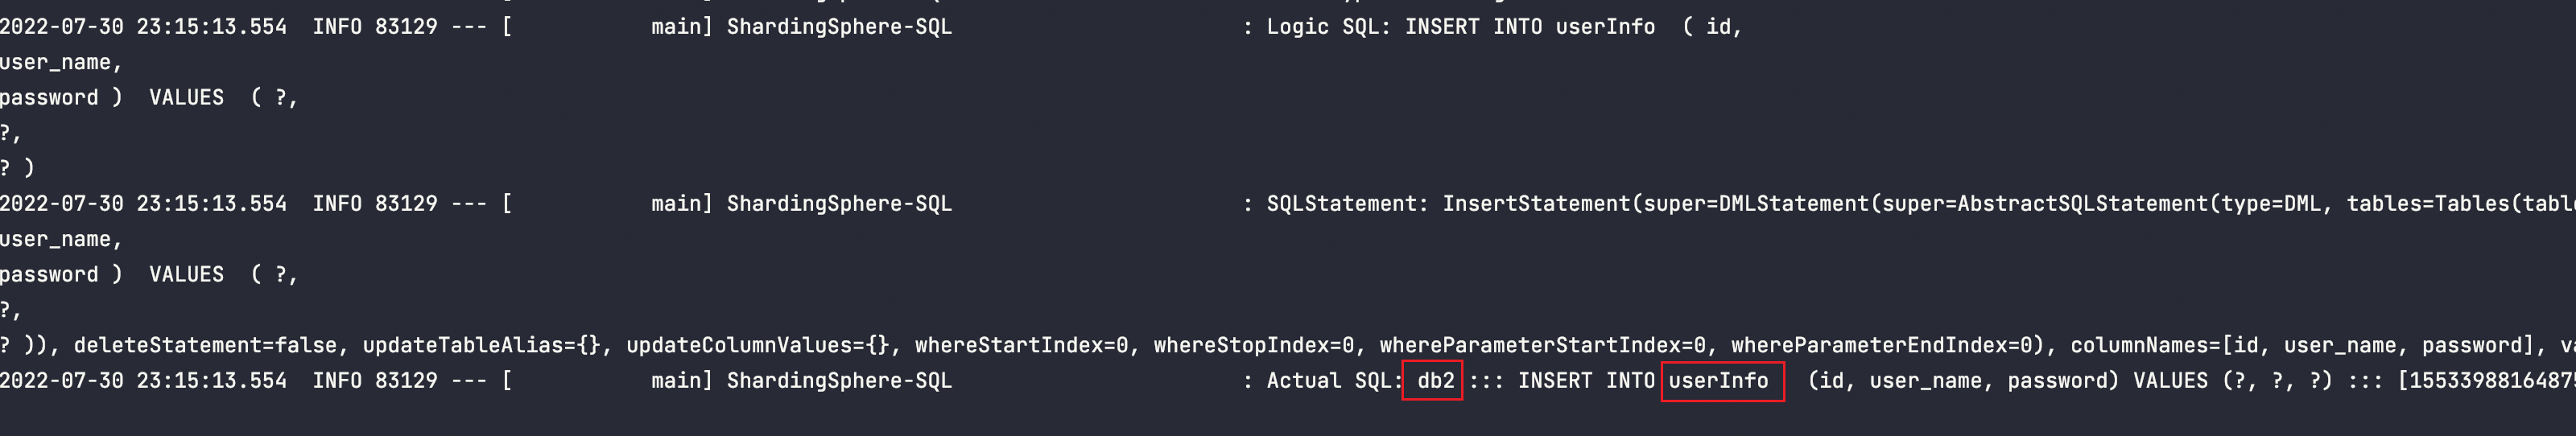
這樣就實現了不同的表插入了不同的資料庫,不過使用多數據源方式會更方便
實現讀寫分離
環境配置:使用mall庫為主庫,mall_01、mall_02為從庫,前提是MySQL資料庫需要提前做好讀寫分離相關配置
1、讀寫分離配置
server.port=8099

spring.application.name=sharding-jdbc-demo

spring.profiles.active=dev


#指定資料庫連接資訊 一主兩從
spring.shardingsphere.datasource.names=master,slave0,slave1
spring.shardingsphere.datasource.master.type=com.alibaba.druid.pool.DruidDataSource
spring.shardingsphere.datasource.master.driver-class-name=com.mysql.cj.jdbc.Driver
spring.shardingsphere.datasource.master.url=jdbc:mysql://xxx:3306/mall?serverTimezone=GMT%2B8
spring.shardingsphere.datasource.master.username=root
spring.shardingsphere.datasource.master.password=xxx

spring.shardingsphere.datasource.slave0.type=com.alibaba.druid.pool.DruidDataSource
spring.shardingsphere.datasource.slave0.driver-class-name=com.mysql.cj.jdbc.Driver
spring.shardingsphere.datasource.slave0.url=jdbc:mysql://xxx:3306/mall_1?serverTimezone=GMT%2B8
spring.shardingsphere.datasource.slave0.username=root
spring.shardingsphere.datasource.slave0.password=xxx

spring.shardingsphere.datasource.slave1.type=com.alibaba.druid.pool.DruidDataSource
spring.shardingsphere.datasource.slave1.driver-class-name=com.mysql.cj.jdbc.Driver
spring.shardingsphere.datasource.slave1.url=jdbc:mysql://xxx:3306/mall_2?serverTimezone=GMT%2B8
spring.shardingsphere.datasource.slave1.username=root
spring.shardingsphere.datasource.slave1.password=xxx

# 配置從節點負載均衡策略,採用輪詢機制
spring.shardingsphere.masterslave.load-balance-algorithm-type=round_robin
# 配置主從名稱
spring.shardingsphere.masterslave.name=ms
# 配置數據源的讀寫分離
spring.shardingsphere.sharding.master-slave-rules.ds0.master-data-source-name=master
spring.shardingsphere.sharding.master-slave-rules.ds0.slave-data-source-names=slave0,slave1

#sql輸出日誌
spring.shardingsphere.props.sql.show=true

# 一個實體類對應兩張表,覆蓋
spring.main.allow-bean-definition-overriding=true
2、測試讀
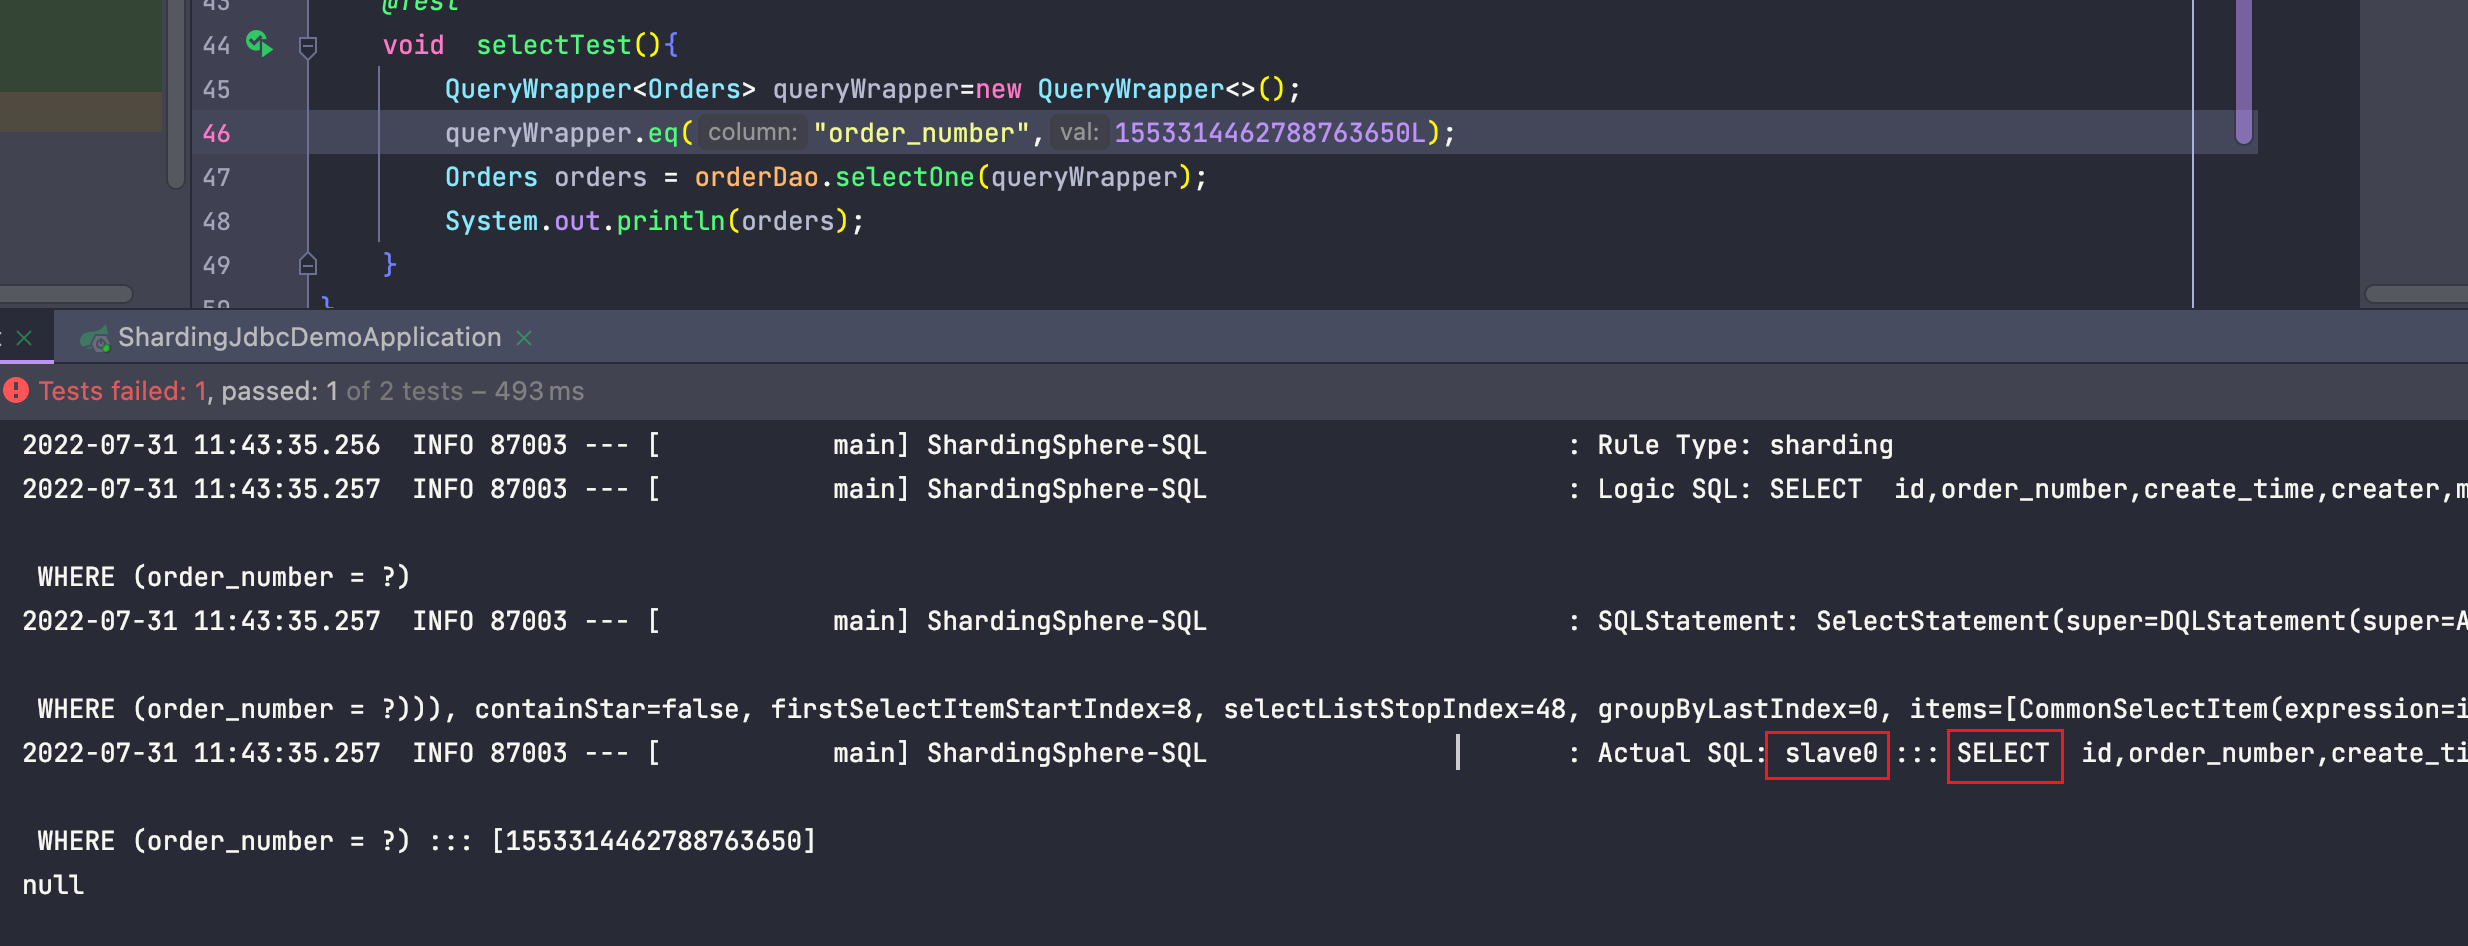
查找成功
3、測試寫
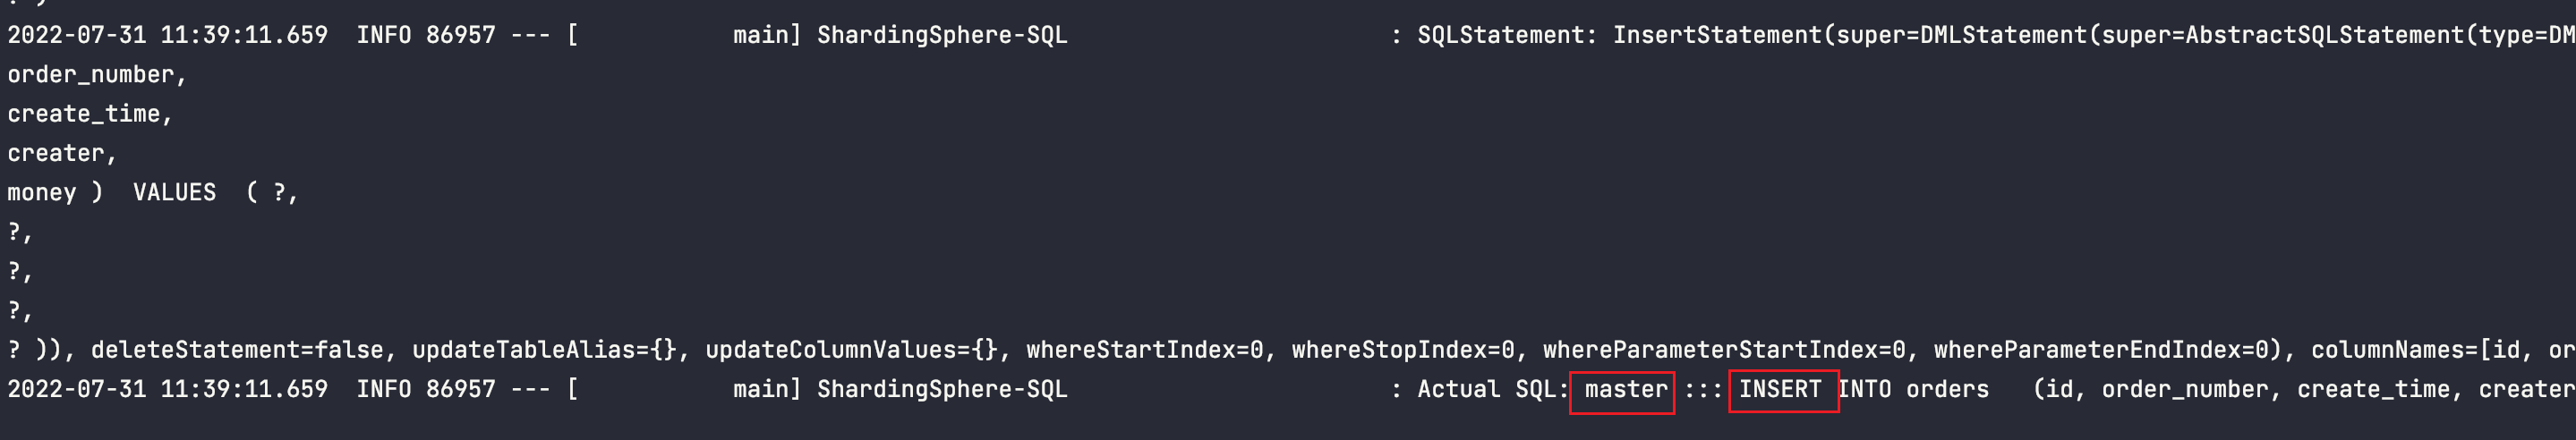
寫入主庫成功,會自動同步到兩個從庫,然後查詢的時候通過負載均衡輪詢到一個子庫進行查詢
Sharding-Proxy
它是一個資料庫的代理端,代理資料庫我們只用訪問它就行了,通過訪問代理資料庫來簡化分庫分表的操作
環境配置
1、安裝包下載解壓
//archive.apache.org/dist/shardingsphere/4.1.0/apache-shardingsphere-4.1.0-sharding-proxy-bin.tar.gz
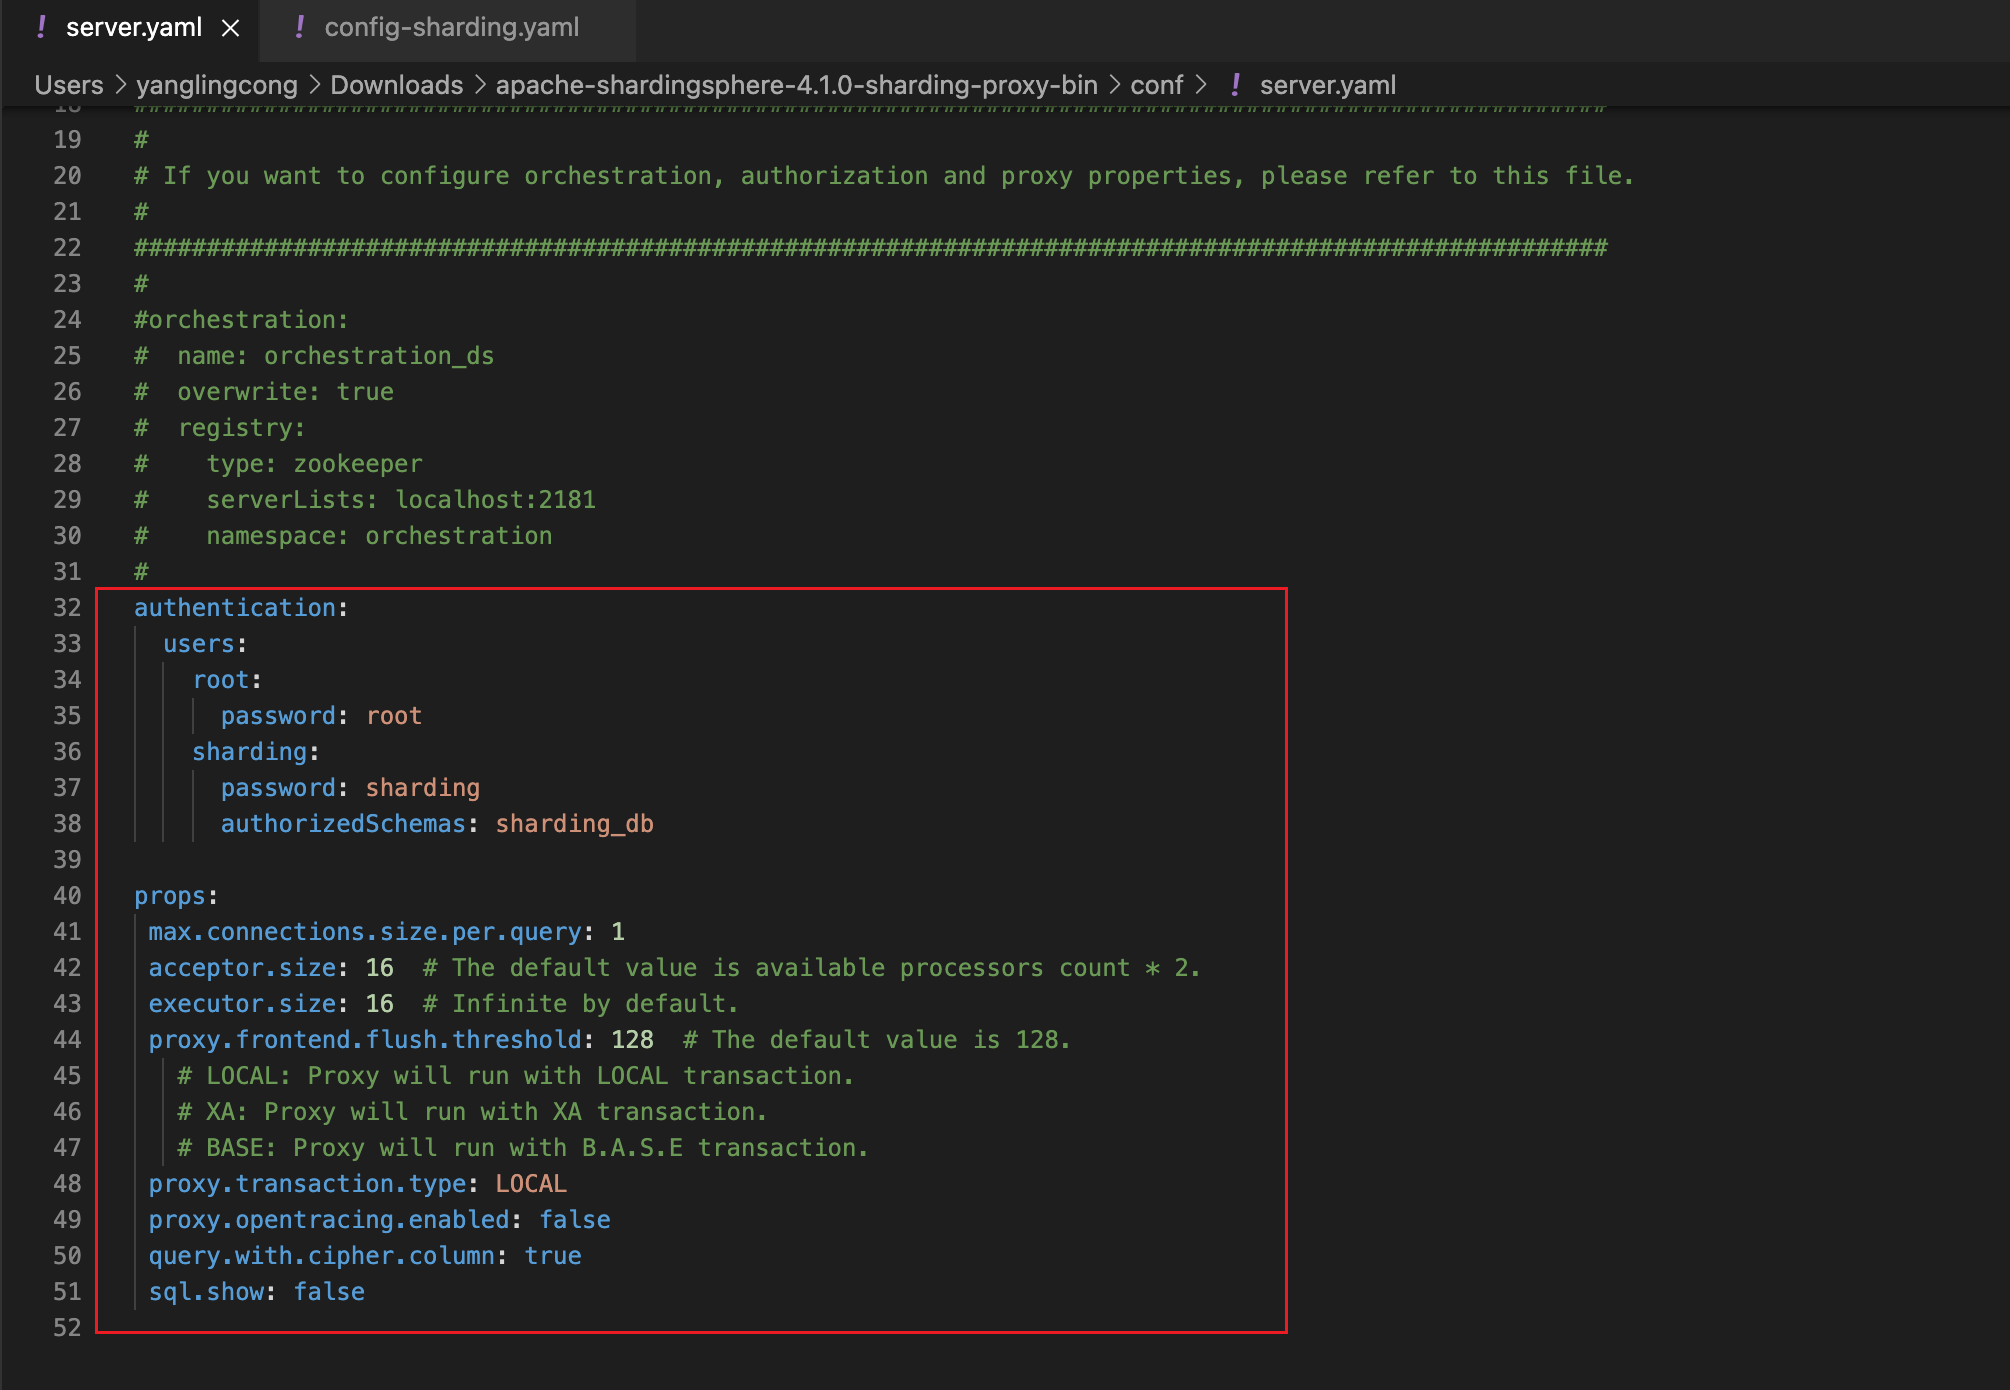
2、在conf目錄下,修改server.yaml文件,去掉這一部分的注釋
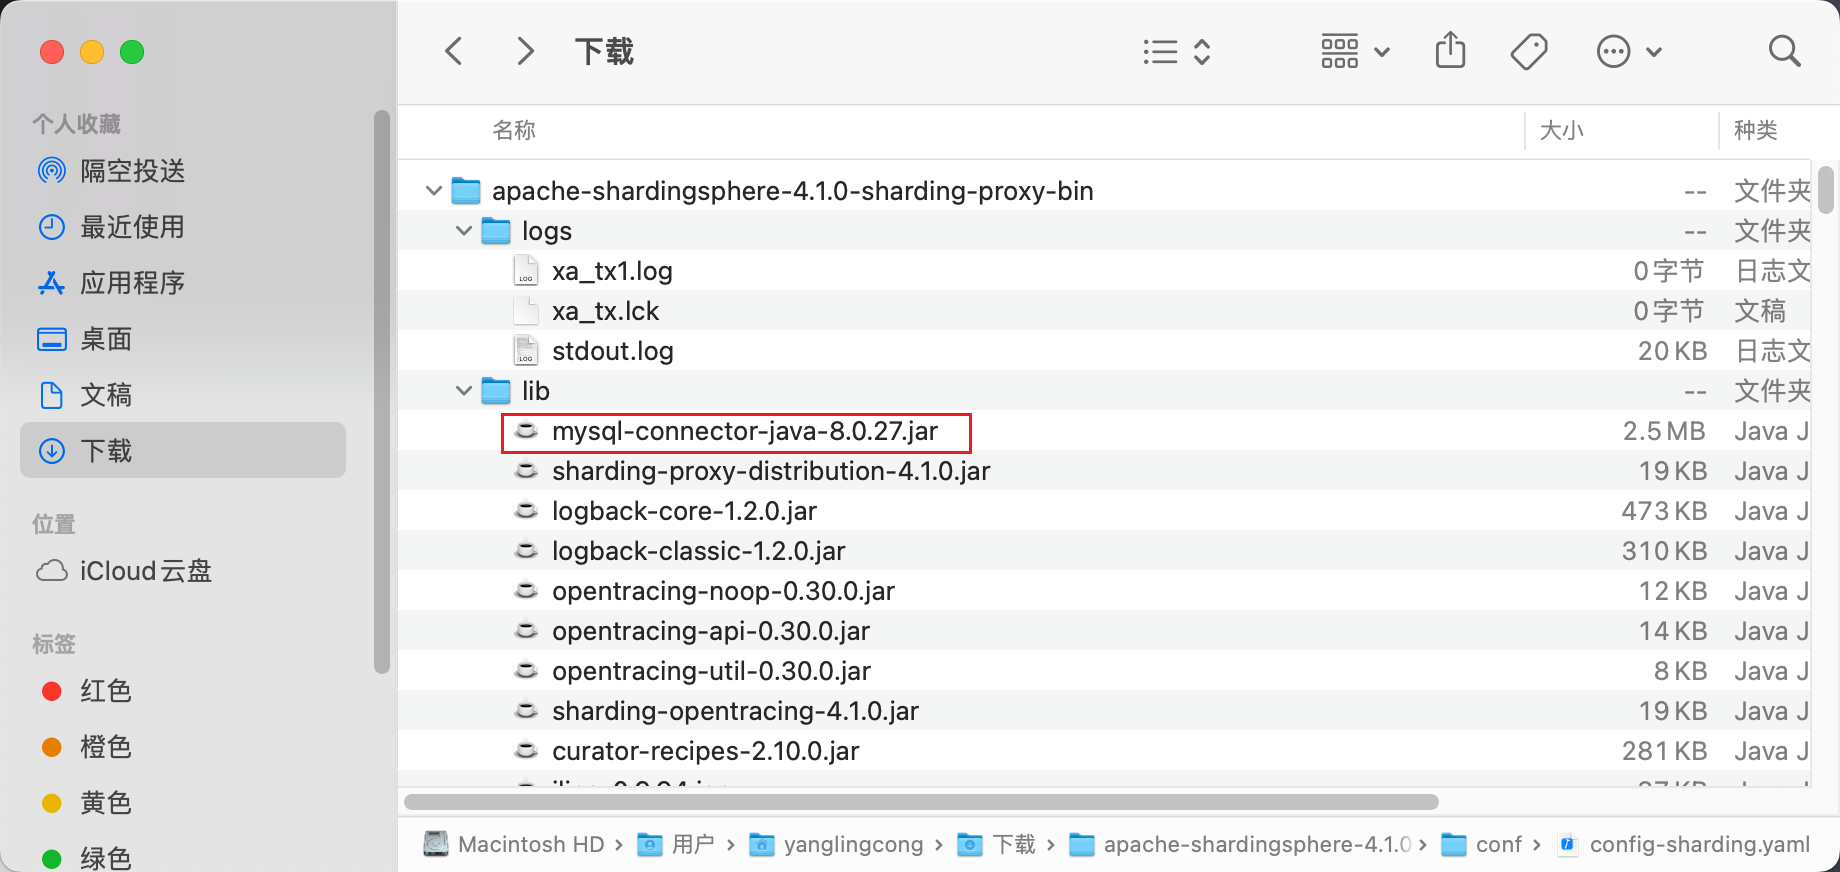
3、需要手動的把mysql驅動的jar包放到lib目錄下否則程式無法運行
4、配置分庫分表
修改config-sharding.yaml文件
schemaName: sharding_db

dataSources:
 ds_0:
   url: jdbc:mysql://121.43.33.150:3306/mall_1?serverTimezone=UTC&useSSL=false
   username: root
   password: xxx
   connectionTimeoutMilliseconds: 30000
   idleTimeoutMilliseconds: 60000
   maxLifetimeMilliseconds: 1800000
   maxPoolSize: 50
 ds_1:
   url: jdbc:mysql://121.43.33.150:3306/mall_2?serverTimezone=UTC&useSSL=false
   username: root
   password: xxx
   connectionTimeoutMilliseconds: 30000
   idleTimeoutMilliseconds: 60000
   maxLifetimeMilliseconds: 1800000
   maxPoolSize: 50

shardingRule:
 tables:
 #t_order表規則 可配置多個表
   t_order:
     actualDataNodes: ds_${0..1}.t_order_${0..1}
     tableStrategy:
       inline:
         shardingColumn: order_id
         algorithmExpression: t_order_${order_id % 2}
     keyGenerator:
       type: SNOWFLAKE
       column: order_id
 bindingTables:
   - t_order
 defaultDatabaseStrategy:
   inline:
     shardingColumn: order_number
     algorithmExpression: ds_${order_number % 2}
 defaultTableStrategy:
   none:
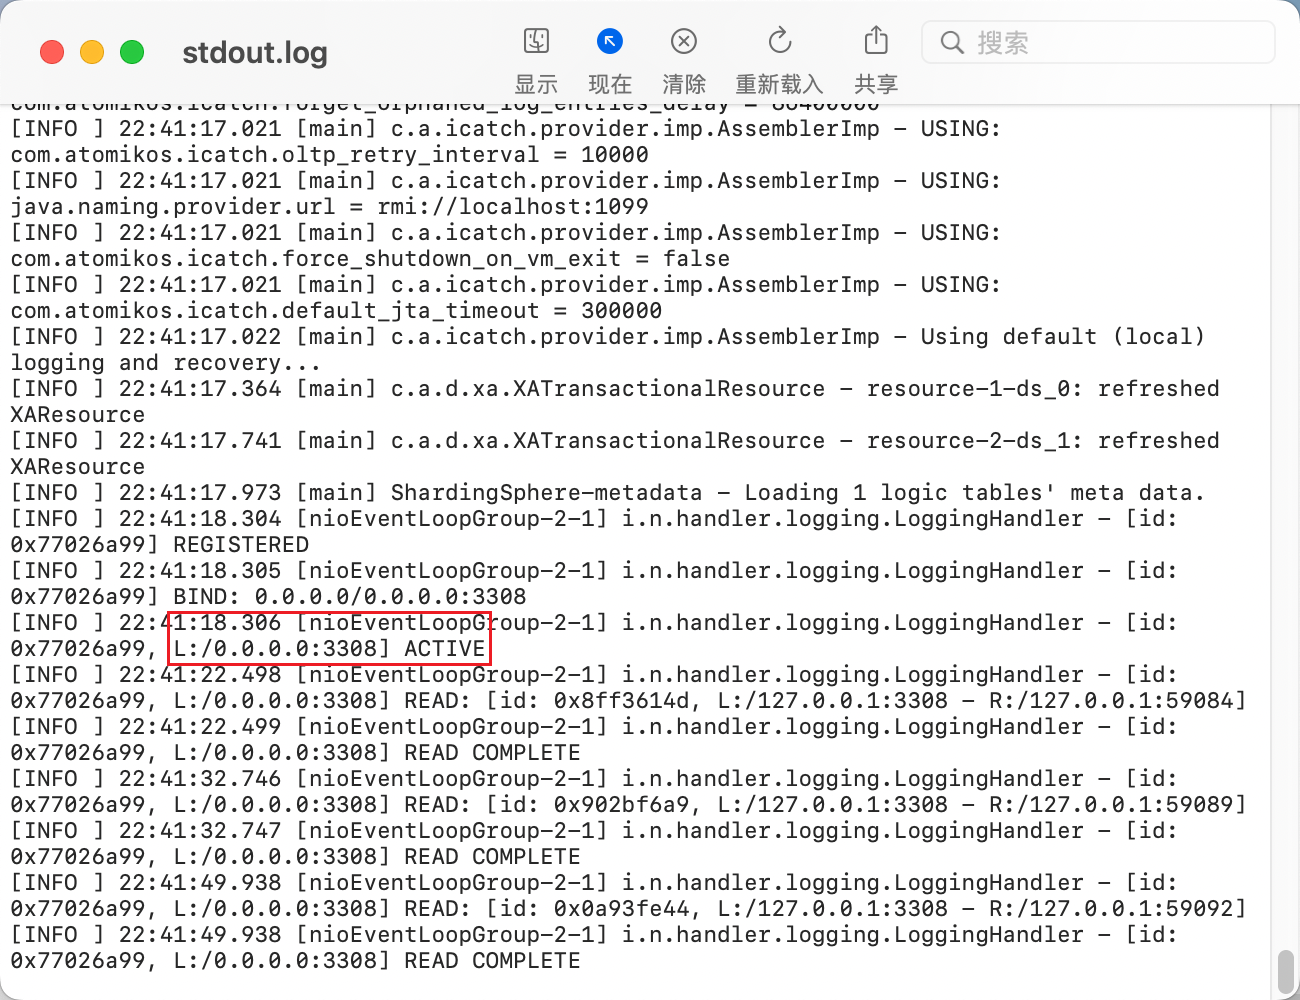
5、啟動Sharding-Proxy
執行bin目錄下的start.sh文件
./start.sh 3308
顯示Active表示成功了
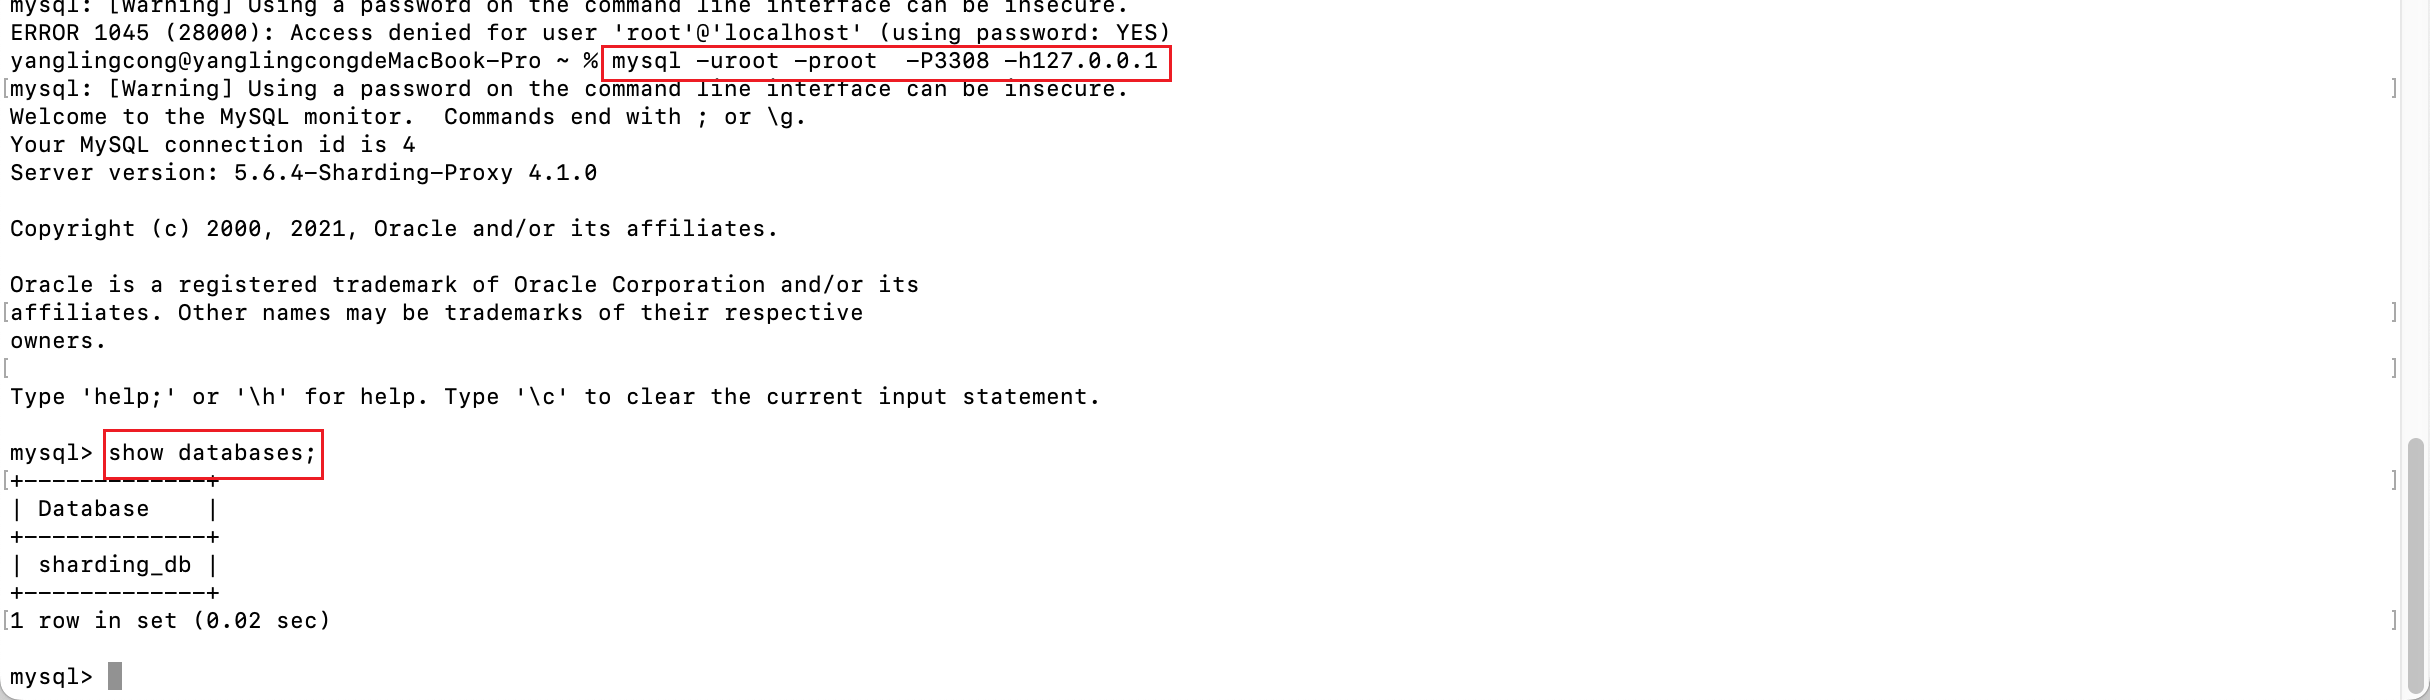
6、mysql登陸
mysql -uroot -proot -P3308 -h127.0.0.1
分庫分表
配置規則
schemaName: sharding_db

dataSources:
 ds_0:
   url: jdbc:mysql://127.0.0.1:3306/lottery_01?serverTimezone=Asia/Shanghai&useSSL=false
   username: root
   password: 123456
   connectionTimeoutMilliseconds: 30000
   idleTimeoutMilliseconds: 60000
   maxLifetimeMilliseconds: 1800000
   maxPoolSize: 50
 ds_1:
   url: jdbc:mysql://127.0.0.1:3306/lottery_02?serverTimezone=Asia/Shanghai&useSSL=false
   username: root
   password: 123456
   connectionTimeoutMilliseconds: 30000
   idleTimeoutMilliseconds: 60000
   maxLifetimeMilliseconds: 1800000
   maxPoolSize: 50

shardingRule:
 tables:
 #t_order表規則 可配置多個表
   t_order:
     actualDataNodes: ds_${0..1}.t_order_${0..1}
     tableStrategy:
       inline:
         shardingColumn: order_id
         algorithmExpression: t_order_${order_id % 2}
     keyGenerator:
       type: SNOWFLAKE
       column: order_id
 bindingTables:
   - t_order
 defaultDatabaseStrategy:
   inline:
     shardingColumn: user_id
     algorithmExpression: ds_${user_id % 2}
 defaultTableStrategy:
   none:
執行語句
use sharding_db;

create table if not exists ds_0.t_order(`order_id` bigint primary key,`user_id` int not null,`status` varchar(50));

insert into t_order(`order_id`,`user_id`,`status`)values(11,1,'jack');
根據插入的id進行運算,11為奇數分配到了t_order_1
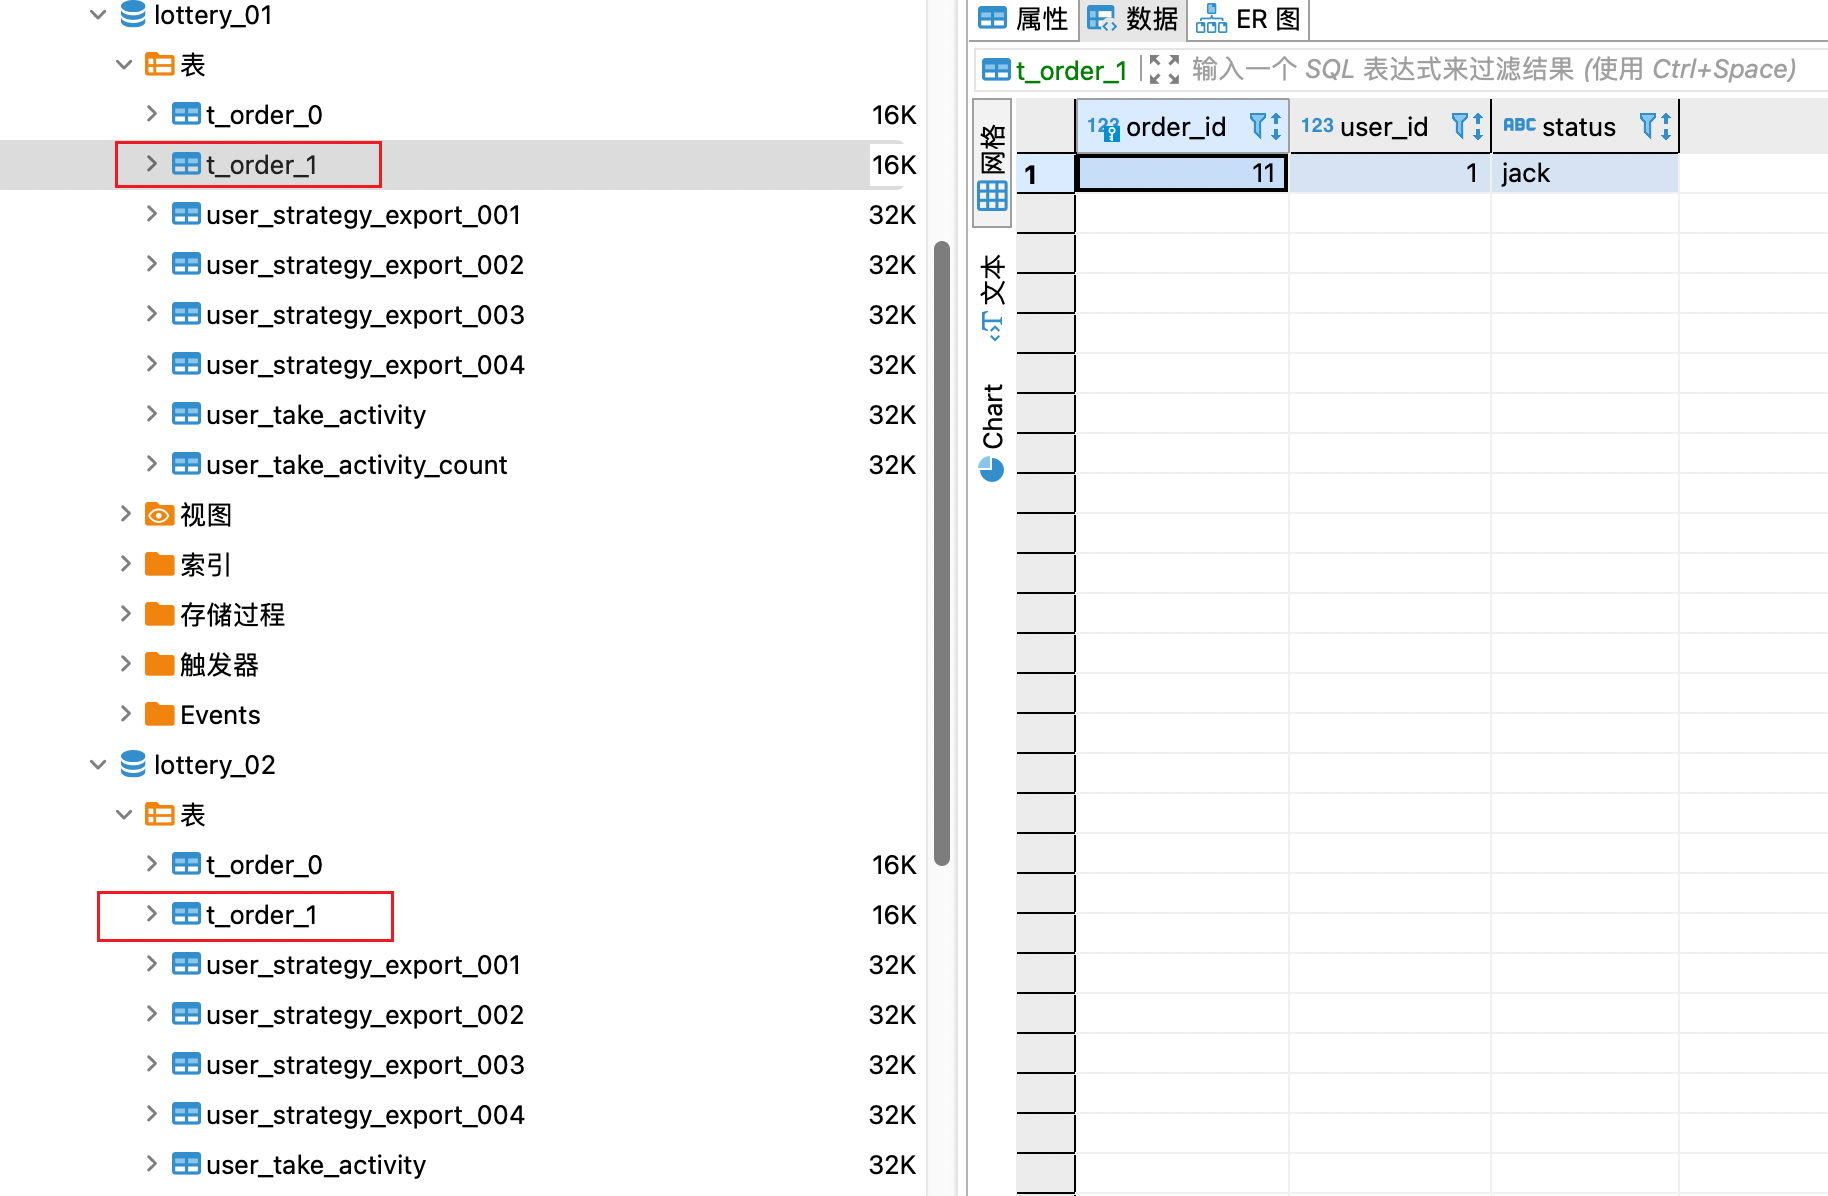
讀寫分離
需要先在Mysql上面配置主從複製,讀寫分離比較簡單,讀從庫lottery_02,寫入主庫同步到從庫
1、配置規則
schemaName: sharding_db

dataSources:
 master:
   url: jdbc:mysql://127.0.0.1:3306/lottery_01?serverTimezone=Asia/Shanghai&useSSL=false
   username: root
   password: 123456
   connectionTimeoutMilliseconds: 30000
   idleTimeoutMilliseconds: 60000
   maxLifetimeMilliseconds: 1800000
   maxPoolSize: 50
 save:
   url: jdbc:mysql://127.0.0.1:3306/lottery_02?serverTimezone=Asia/Shanghai&useSSL=false
   username: root
   password: 123456
   connectionTimeoutMilliseconds: 30000
   idleTimeoutMilliseconds: 60000
   maxLifetimeMilliseconds: 1800000
   maxPoolSize: 50

masterSlaveRule:
  name: ms_ds
  masterDataSourceName: master
  slaveDataSourceNames:
    - save
2、重新啟動
然後查詢表t_order_1,這個表同時存在於主從庫,最後查到了從庫所在的記錄行
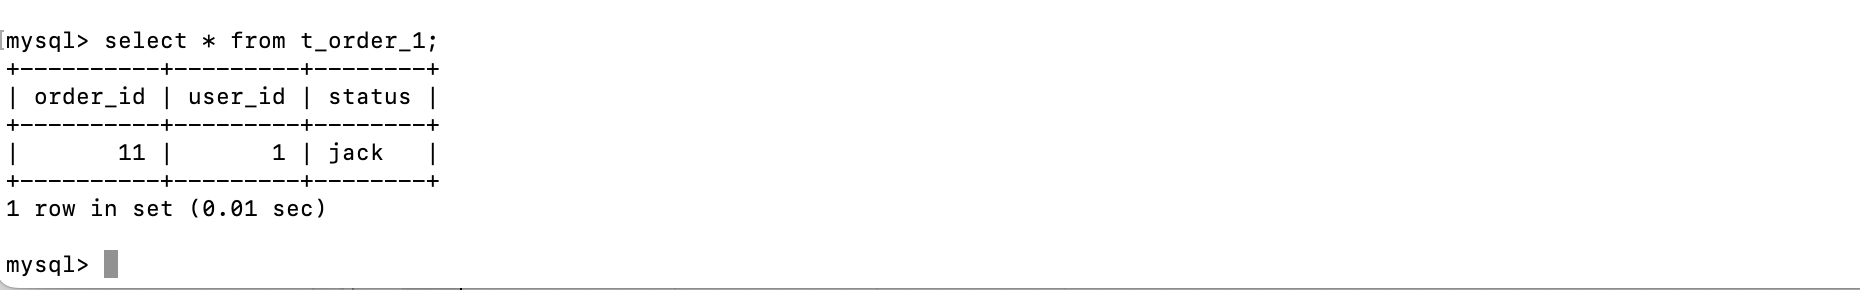
兩者區別
sharding-jdbc是在JDBC層擴展分庫分表的,可以理解為增強版的JDBC驅動,支援JDBC協議的資料庫的資料庫,但目前僅支援Java語言,支援數據分片、讀寫分離,以 jar 包的形式提供輕量級服務,無proxy代理層,無需額外部署,無其他依賴,適用於Java開發的高性能的輕量級OLTP應用,中小團隊
sharding-proxy是屏蔽了底層的分庫分表像操作一個資料庫一樣來進行分庫分表,代理了真實資料庫,相當於在原有資料庫和應用中增加了一層,sharding-proxy是基於 MySQL的,偽裝成了MySQL資料庫,可以通過DDL/DML等操作來變更數據,對DBA更加友好,適用於OLAP應用以及對分片資料庫進行管理和運維的場景
實現原理
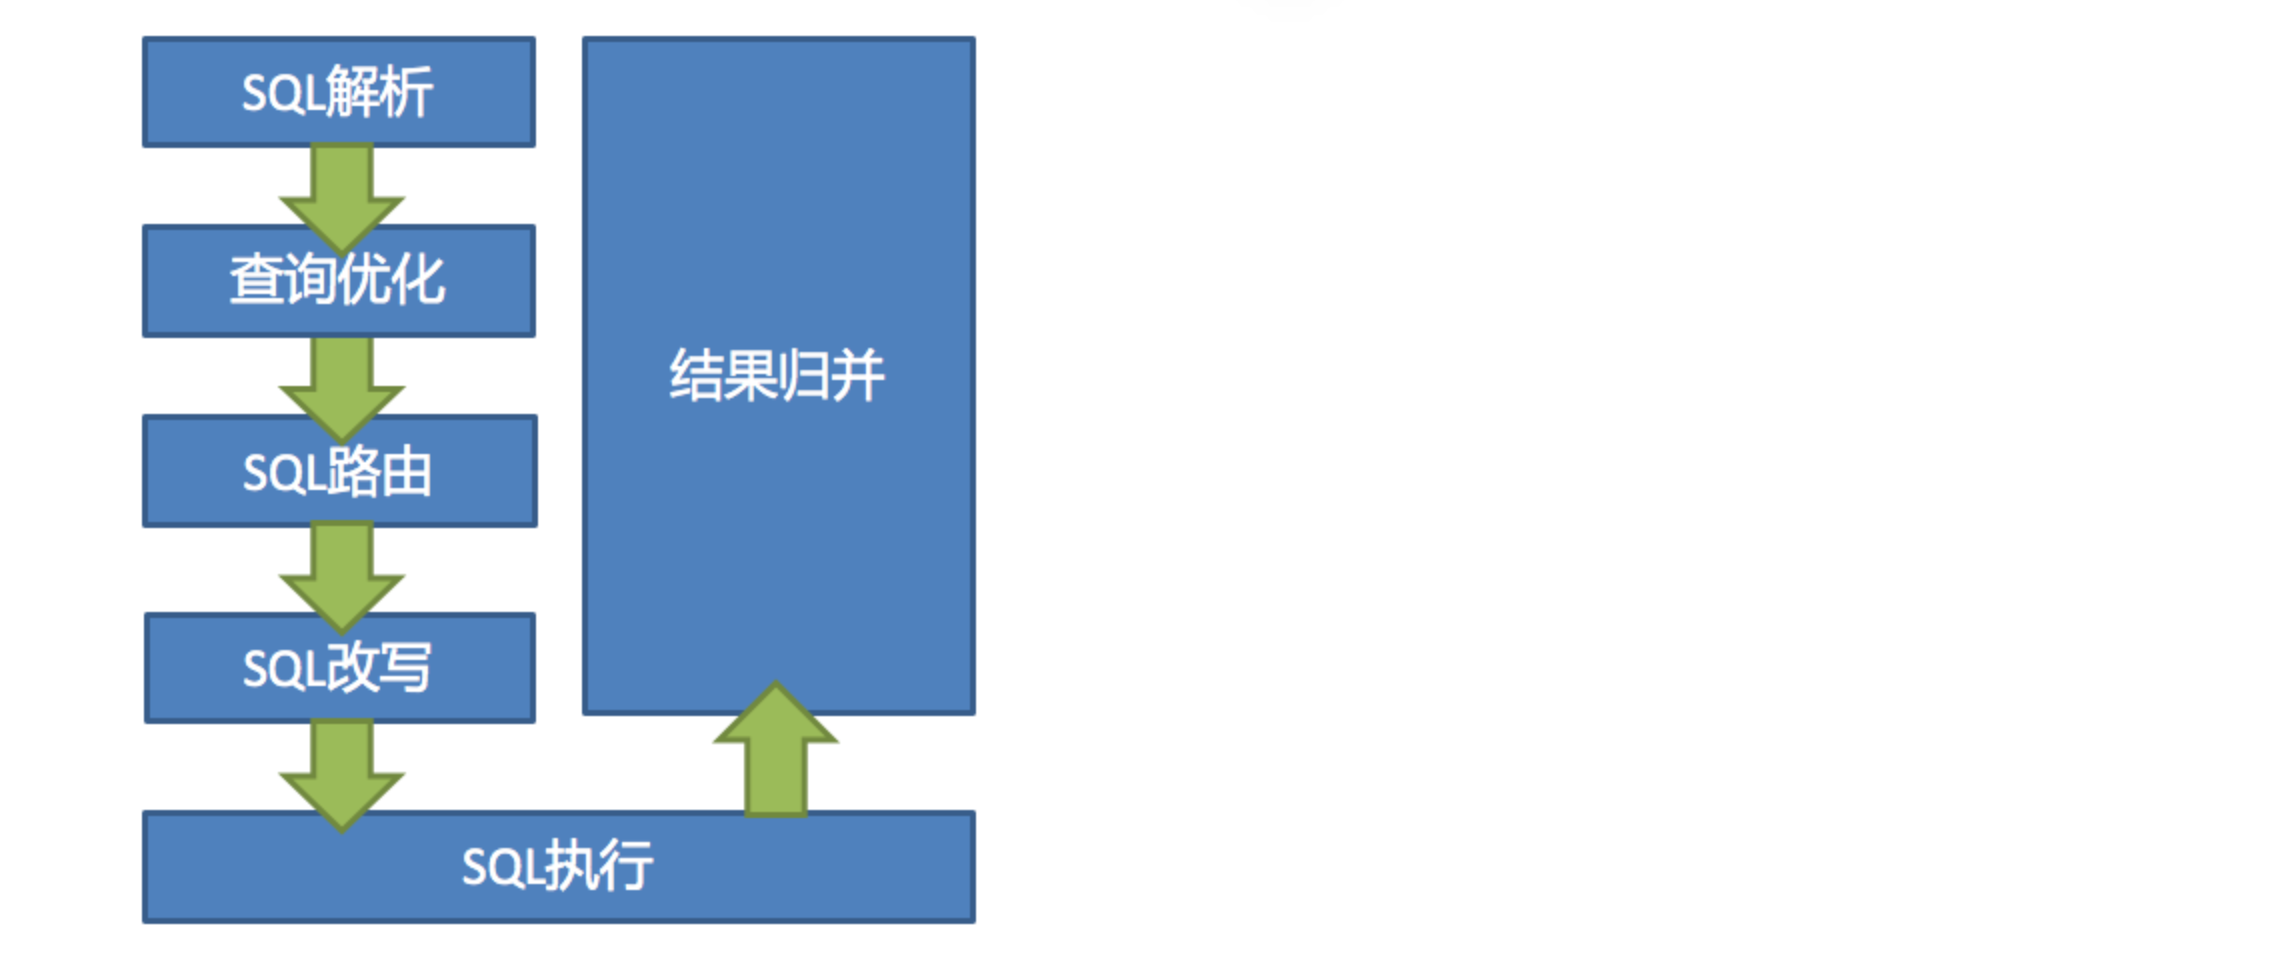
ShardingSphere的3個產品的數據分片主要流程是完全一致的
-
首先連接到Proxy埠執行一條SQL,通過解析引擎SQL會被解析為抽象語語法樹,將裡面的每一個單詞拆分出來,然後標記可能會改寫的位置。
SELECT id, name FROM t_user WHERE status = 'ACTIVE' AND age > 18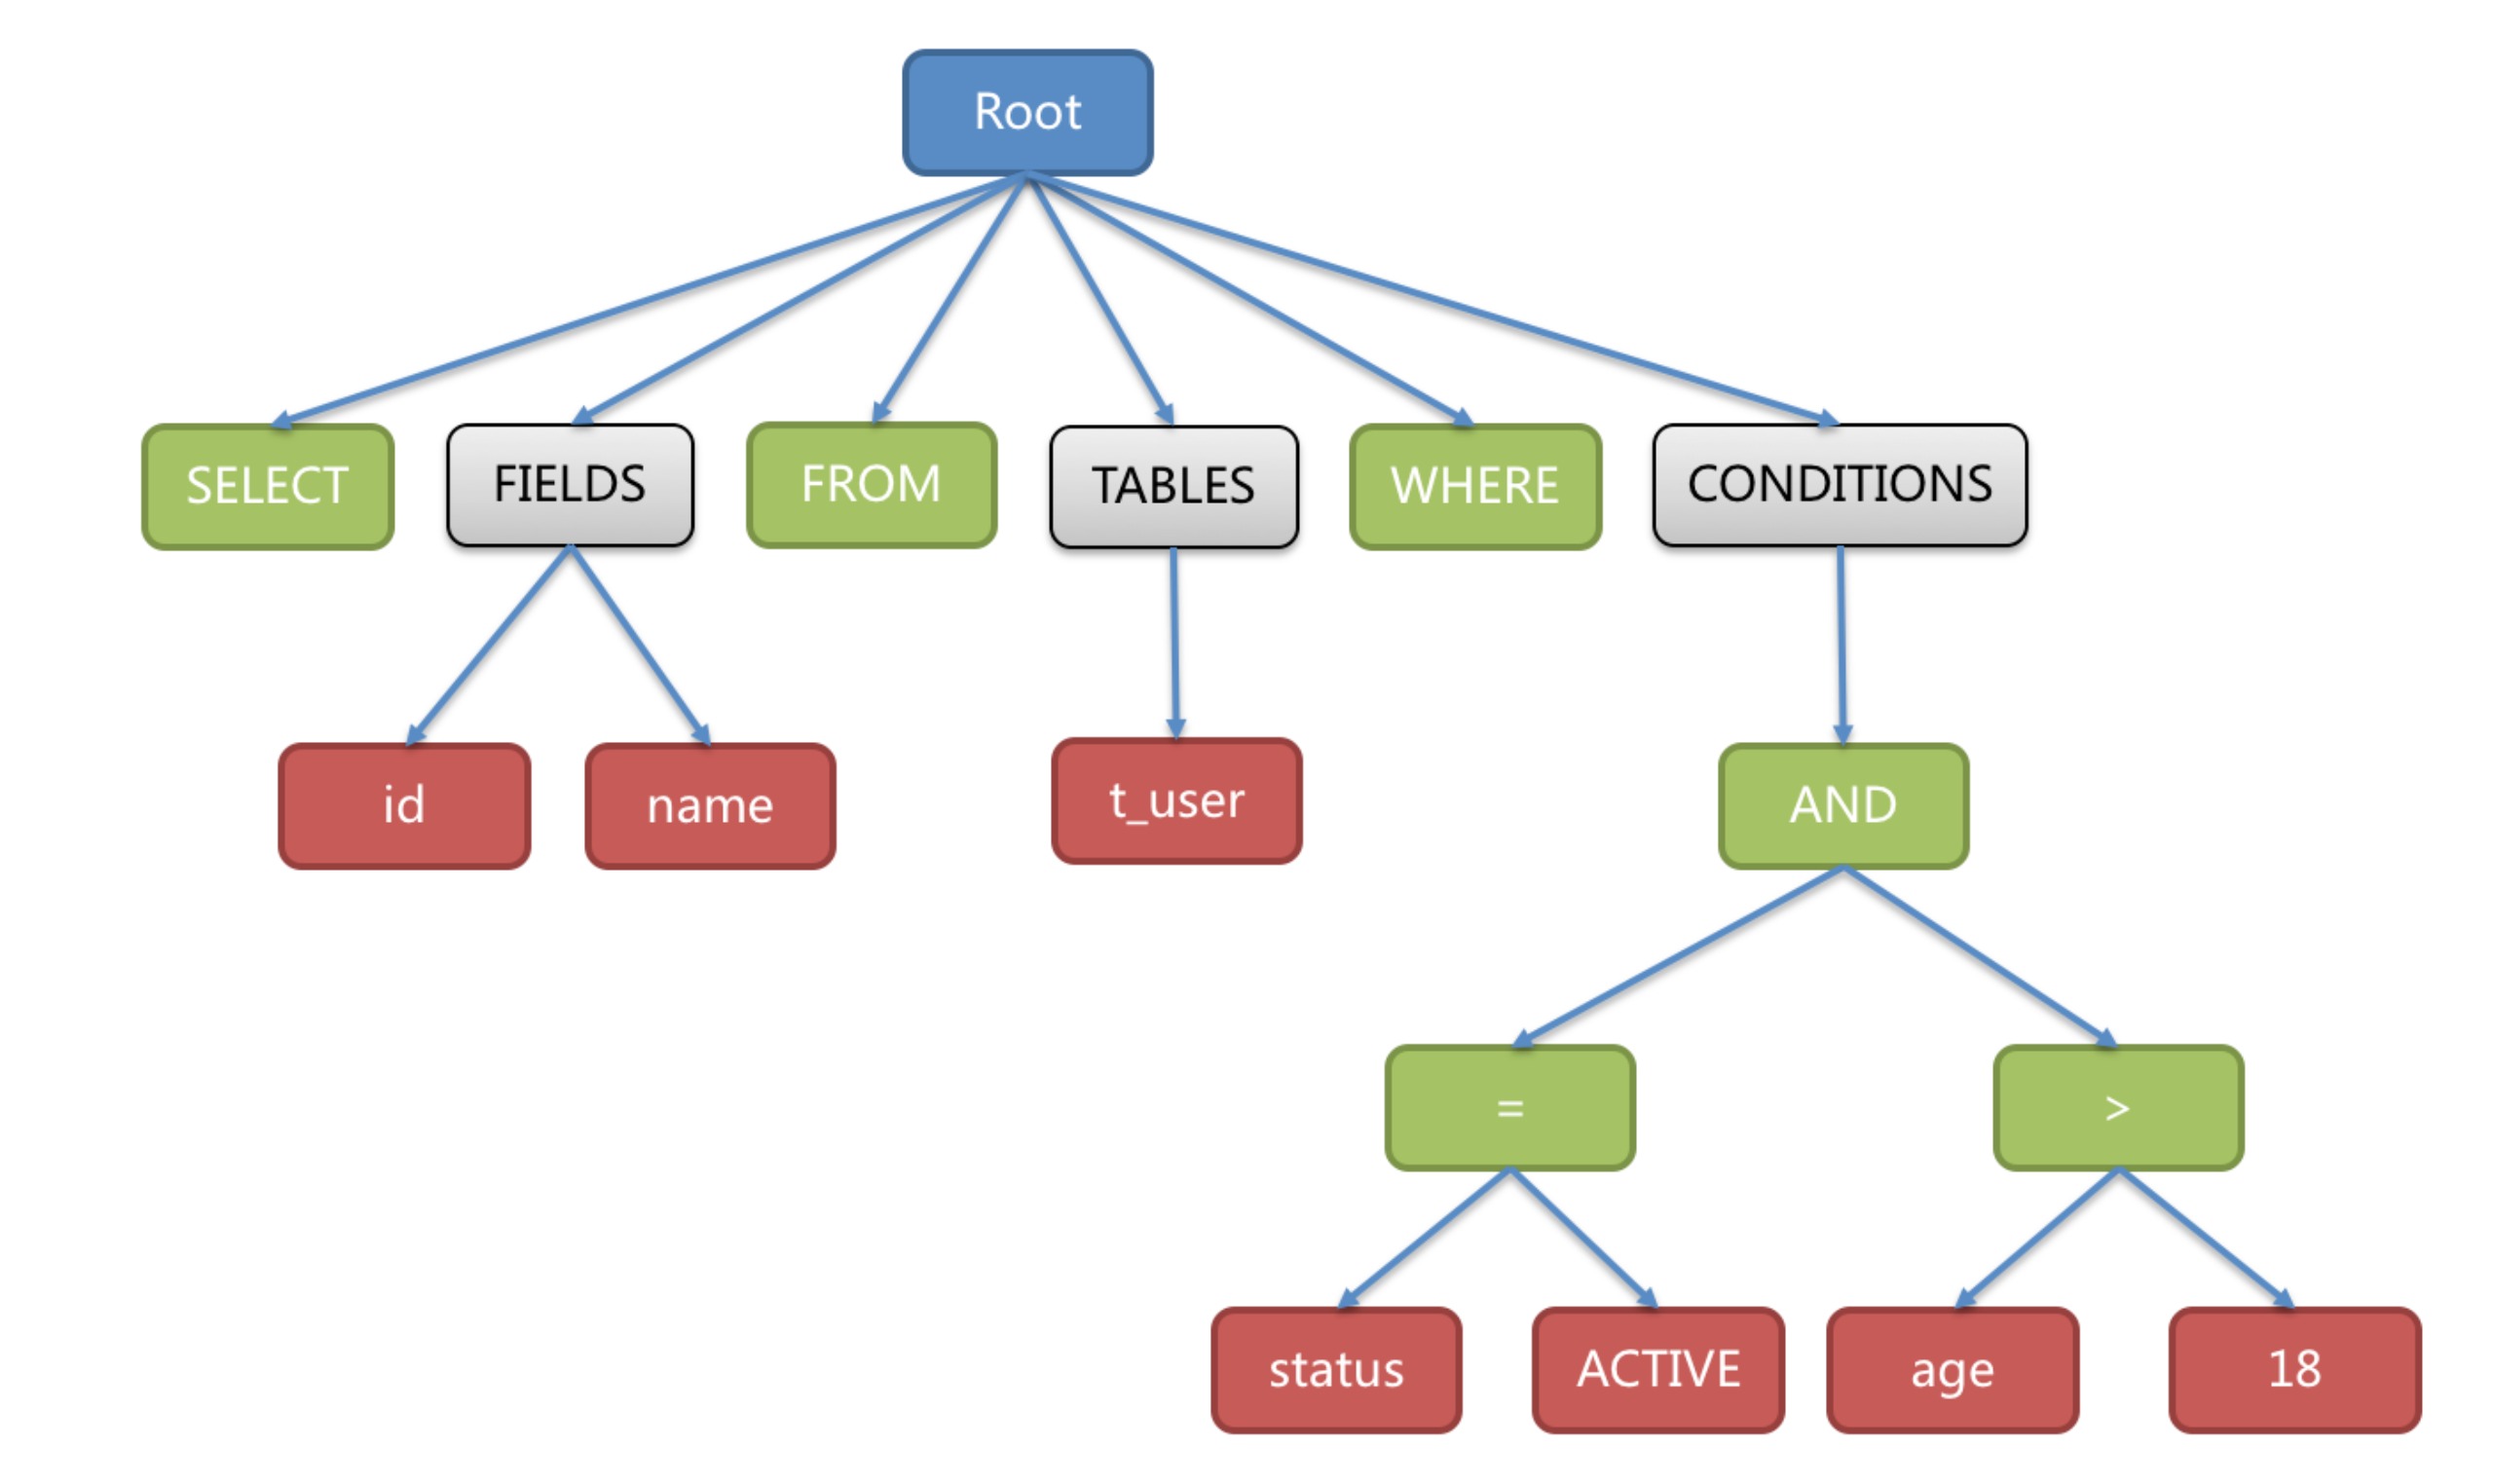
抽象語法樹中的關鍵字的Token用綠色表示,變數的Token用紅色表示,灰色表示需要進一步拆分
從3.0.x版本開始使用Druid ANTLR作為解析引擎,為了提高效率增加了快取機制,因此建議採用PreparedStatement預編譯的SQL
-
路由引擎通過分片規則(取模、哈希、範圍、標籤、時間等等)路由到真實的庫表
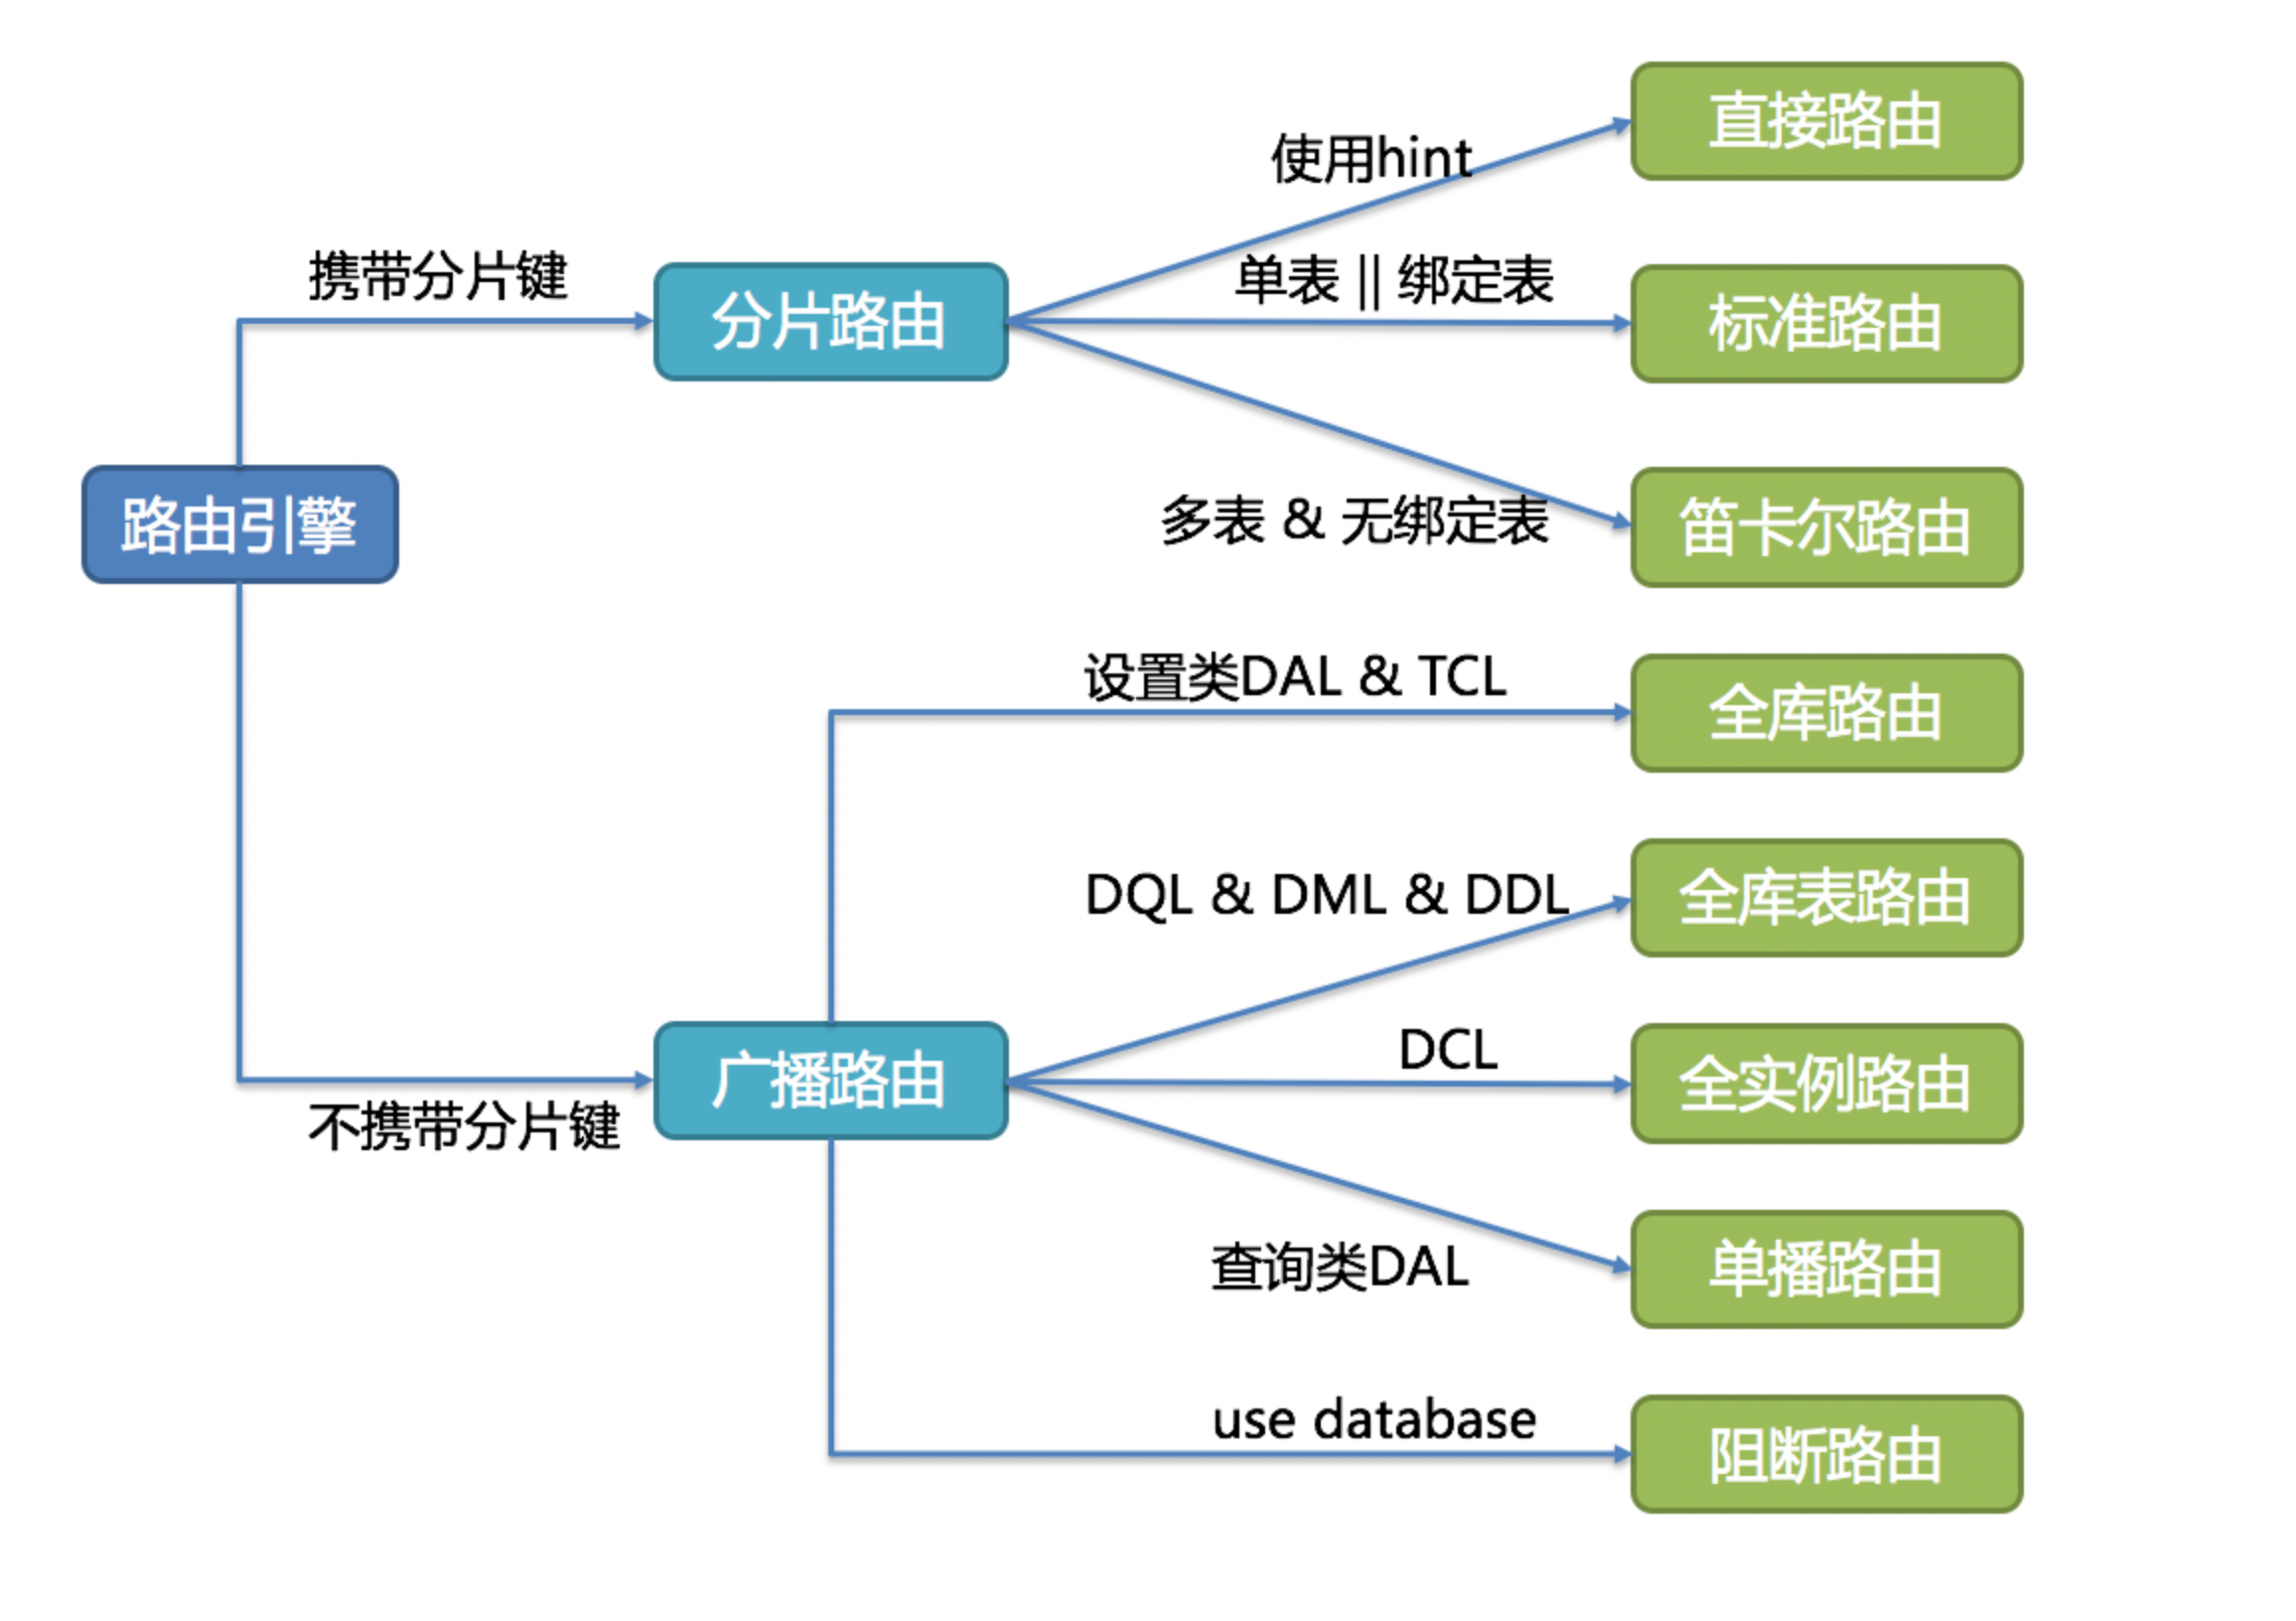
分片路由
- 直接路由:不管SQL是什麼樣,就要按照規則進行路由,直接指定路由至庫表方式分片
- 標準路由:當查詢是等於、in、between時就是標準路由,路由結果不一定落入唯一的庫,一條SQL可能被拆分為多條用於執行的SQL
- 笛卡爾積路由:無法根據分片規則計算出SQL應該在哪個資料庫、哪個表上執行,那麼結果就是把所有分庫分表中關聯使用到的表交叉查詢
廣播路由
- 全庫表路由:對於不帶分片鍵的DQL和DML,以及DDL等會便利所有庫表,一一執行,例如select * from user
- 全庫路由:對資料庫插座都會遍歷真實庫,例如SET autocommit=0;這種TCL事務控制語句
- 全實例路由:對於DCL操作,會在每個資料庫實例中執行一遍
- 單播路由:僅需要從任意庫中的任意真實表中獲取數據即可 DESCRIBE t_order;
- 阻斷路由:用於屏蔽SQL對資料庫的操作 USE order_db;,這個命令在真實庫中執行
-
改寫引擎改寫SQL語句,把庫名表名替換為配置的資訊
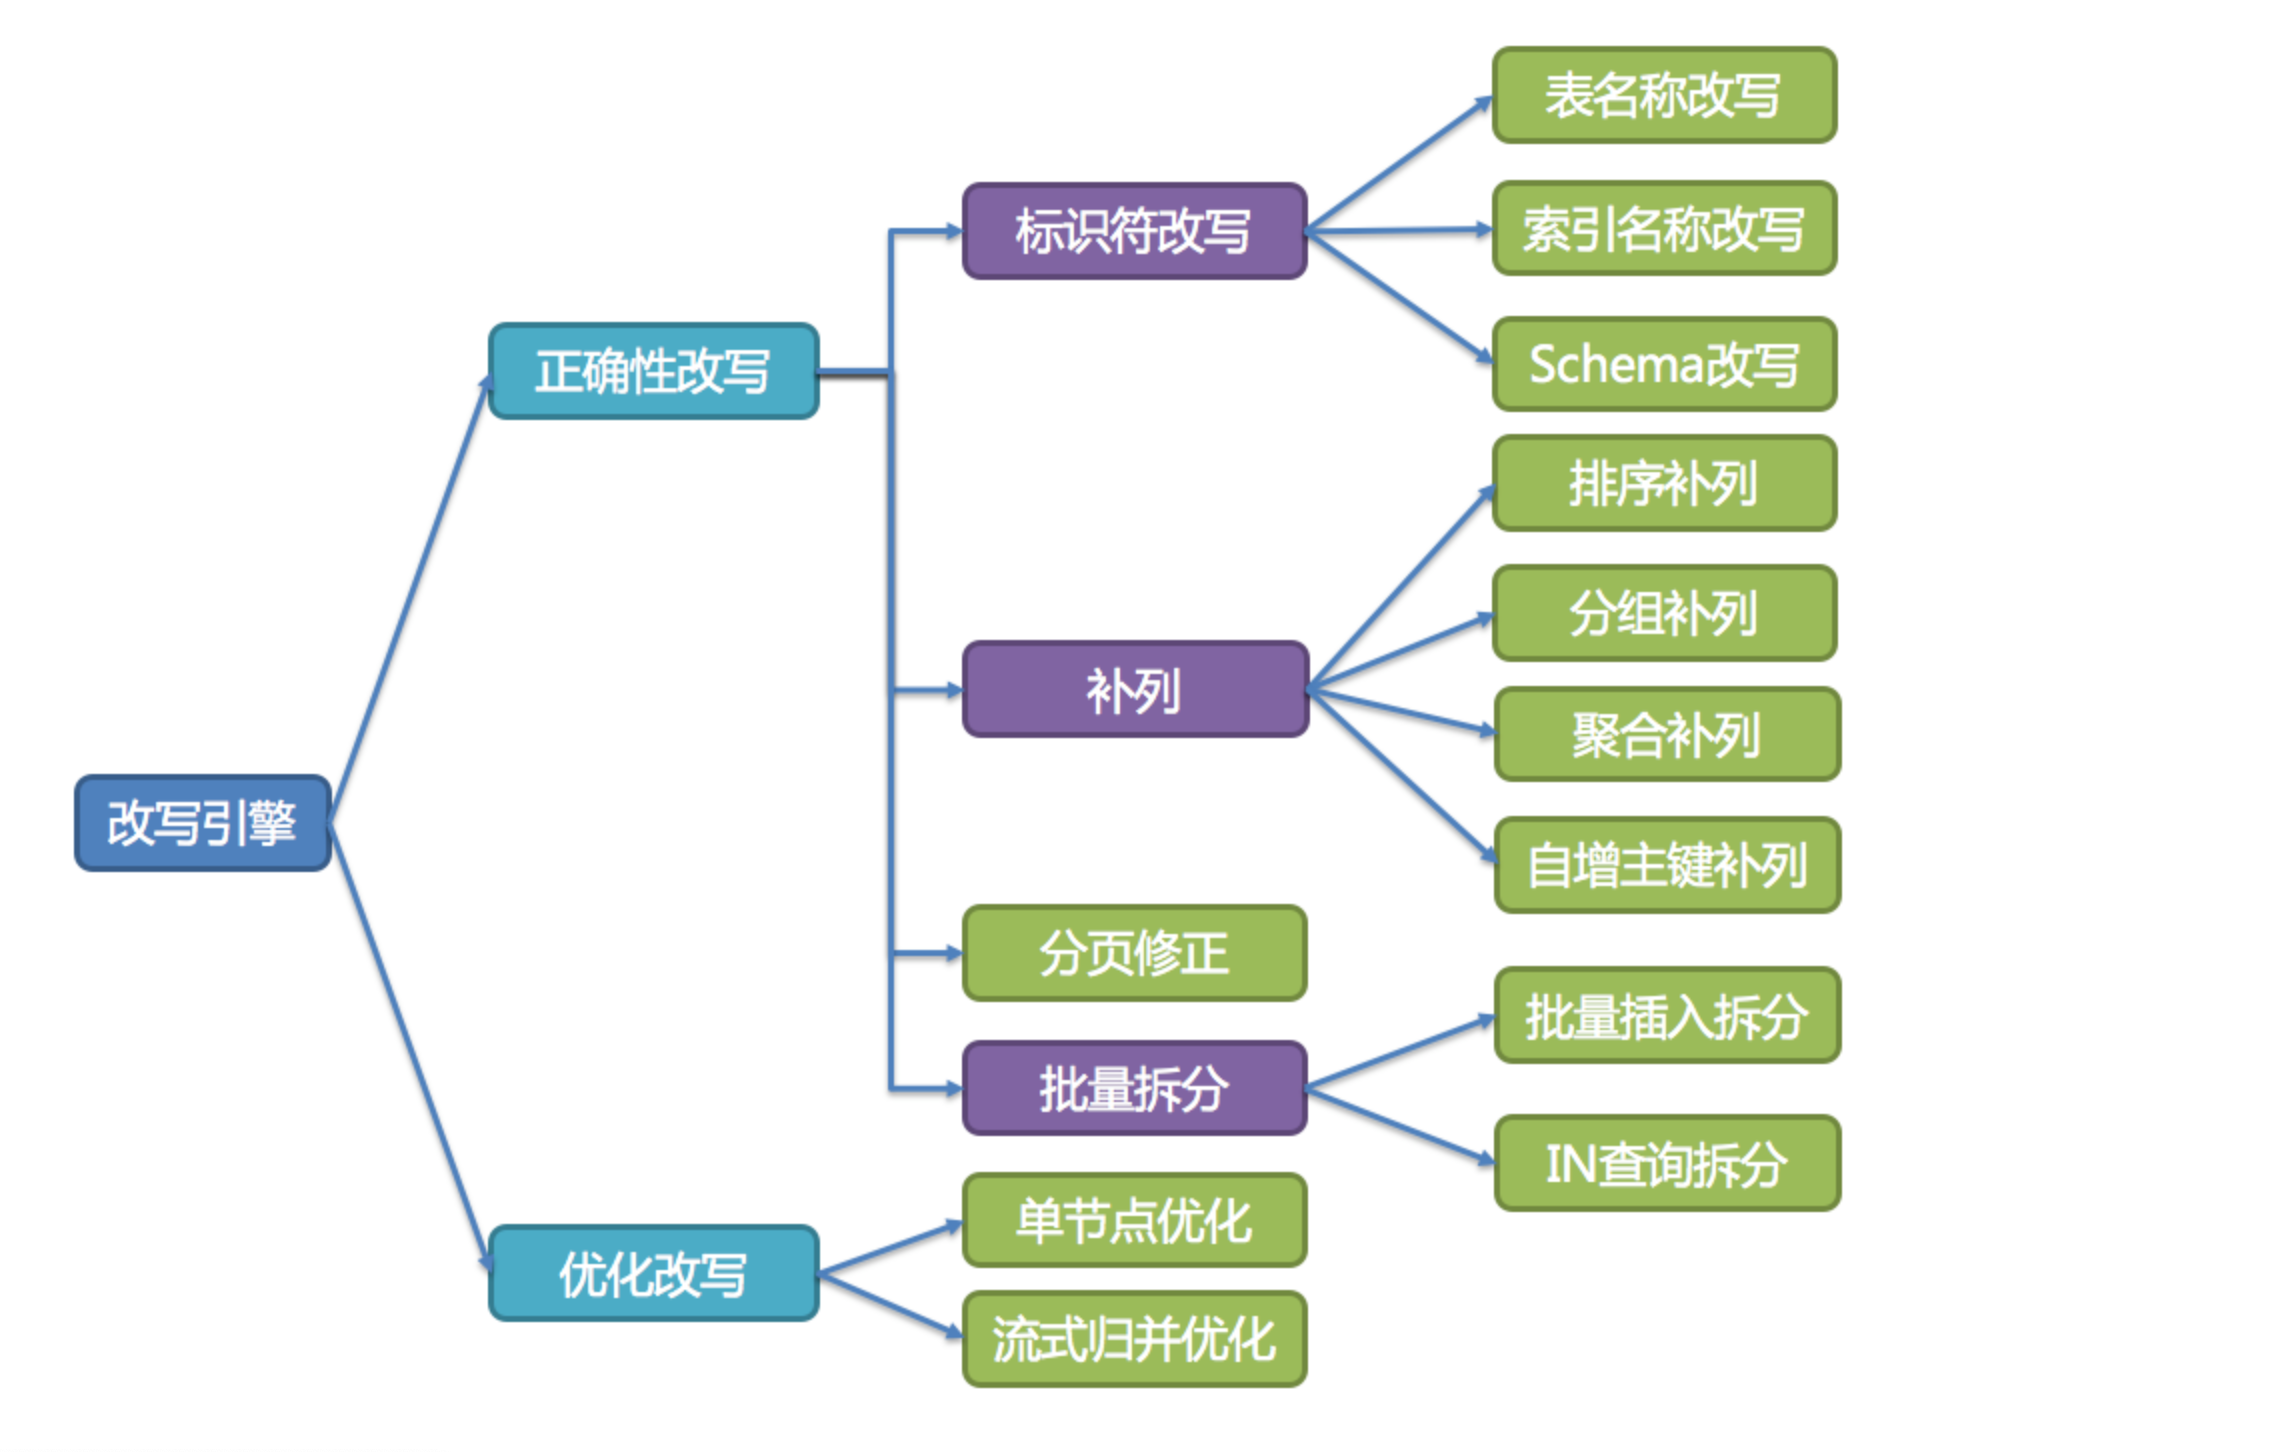
-
執行引擎執行SQL把結果流發送給MySQL伺服器,經過MySQL執行後從存儲引擎裡面把結果集返回出來到Proxy
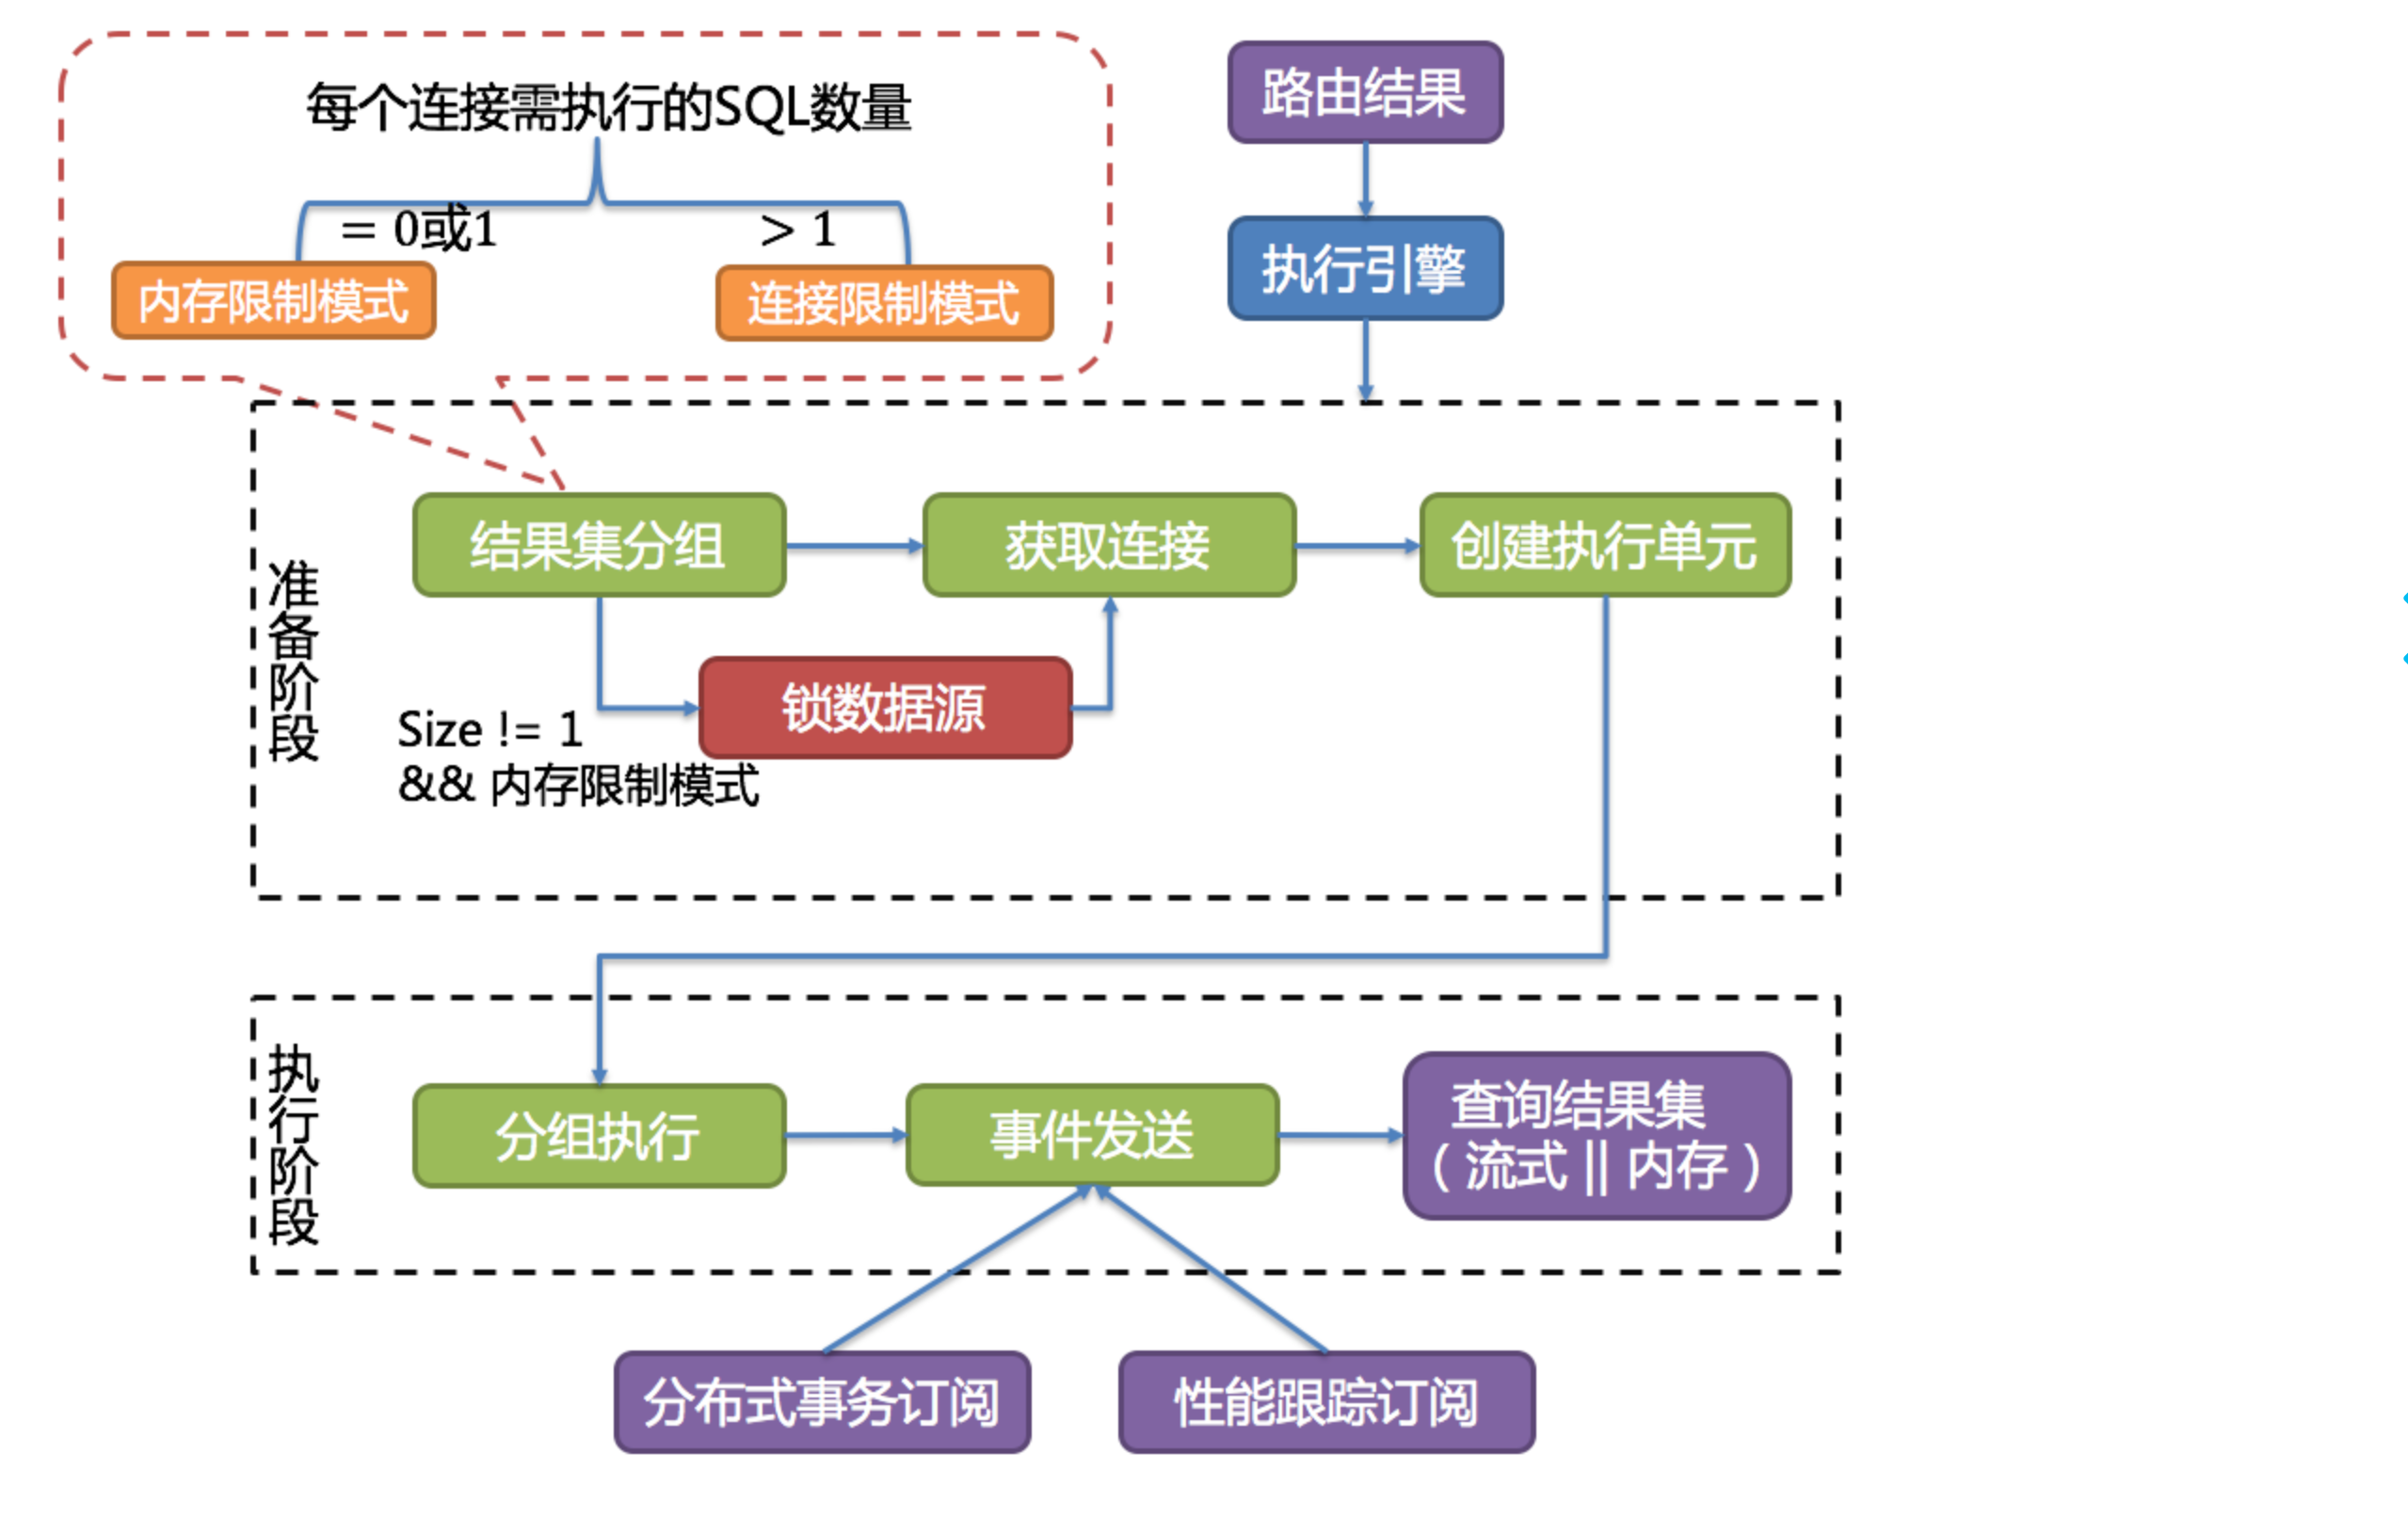
-
歸併引擎把接收到的數據歸併匯總,然後把結果發送給MySQL客戶端
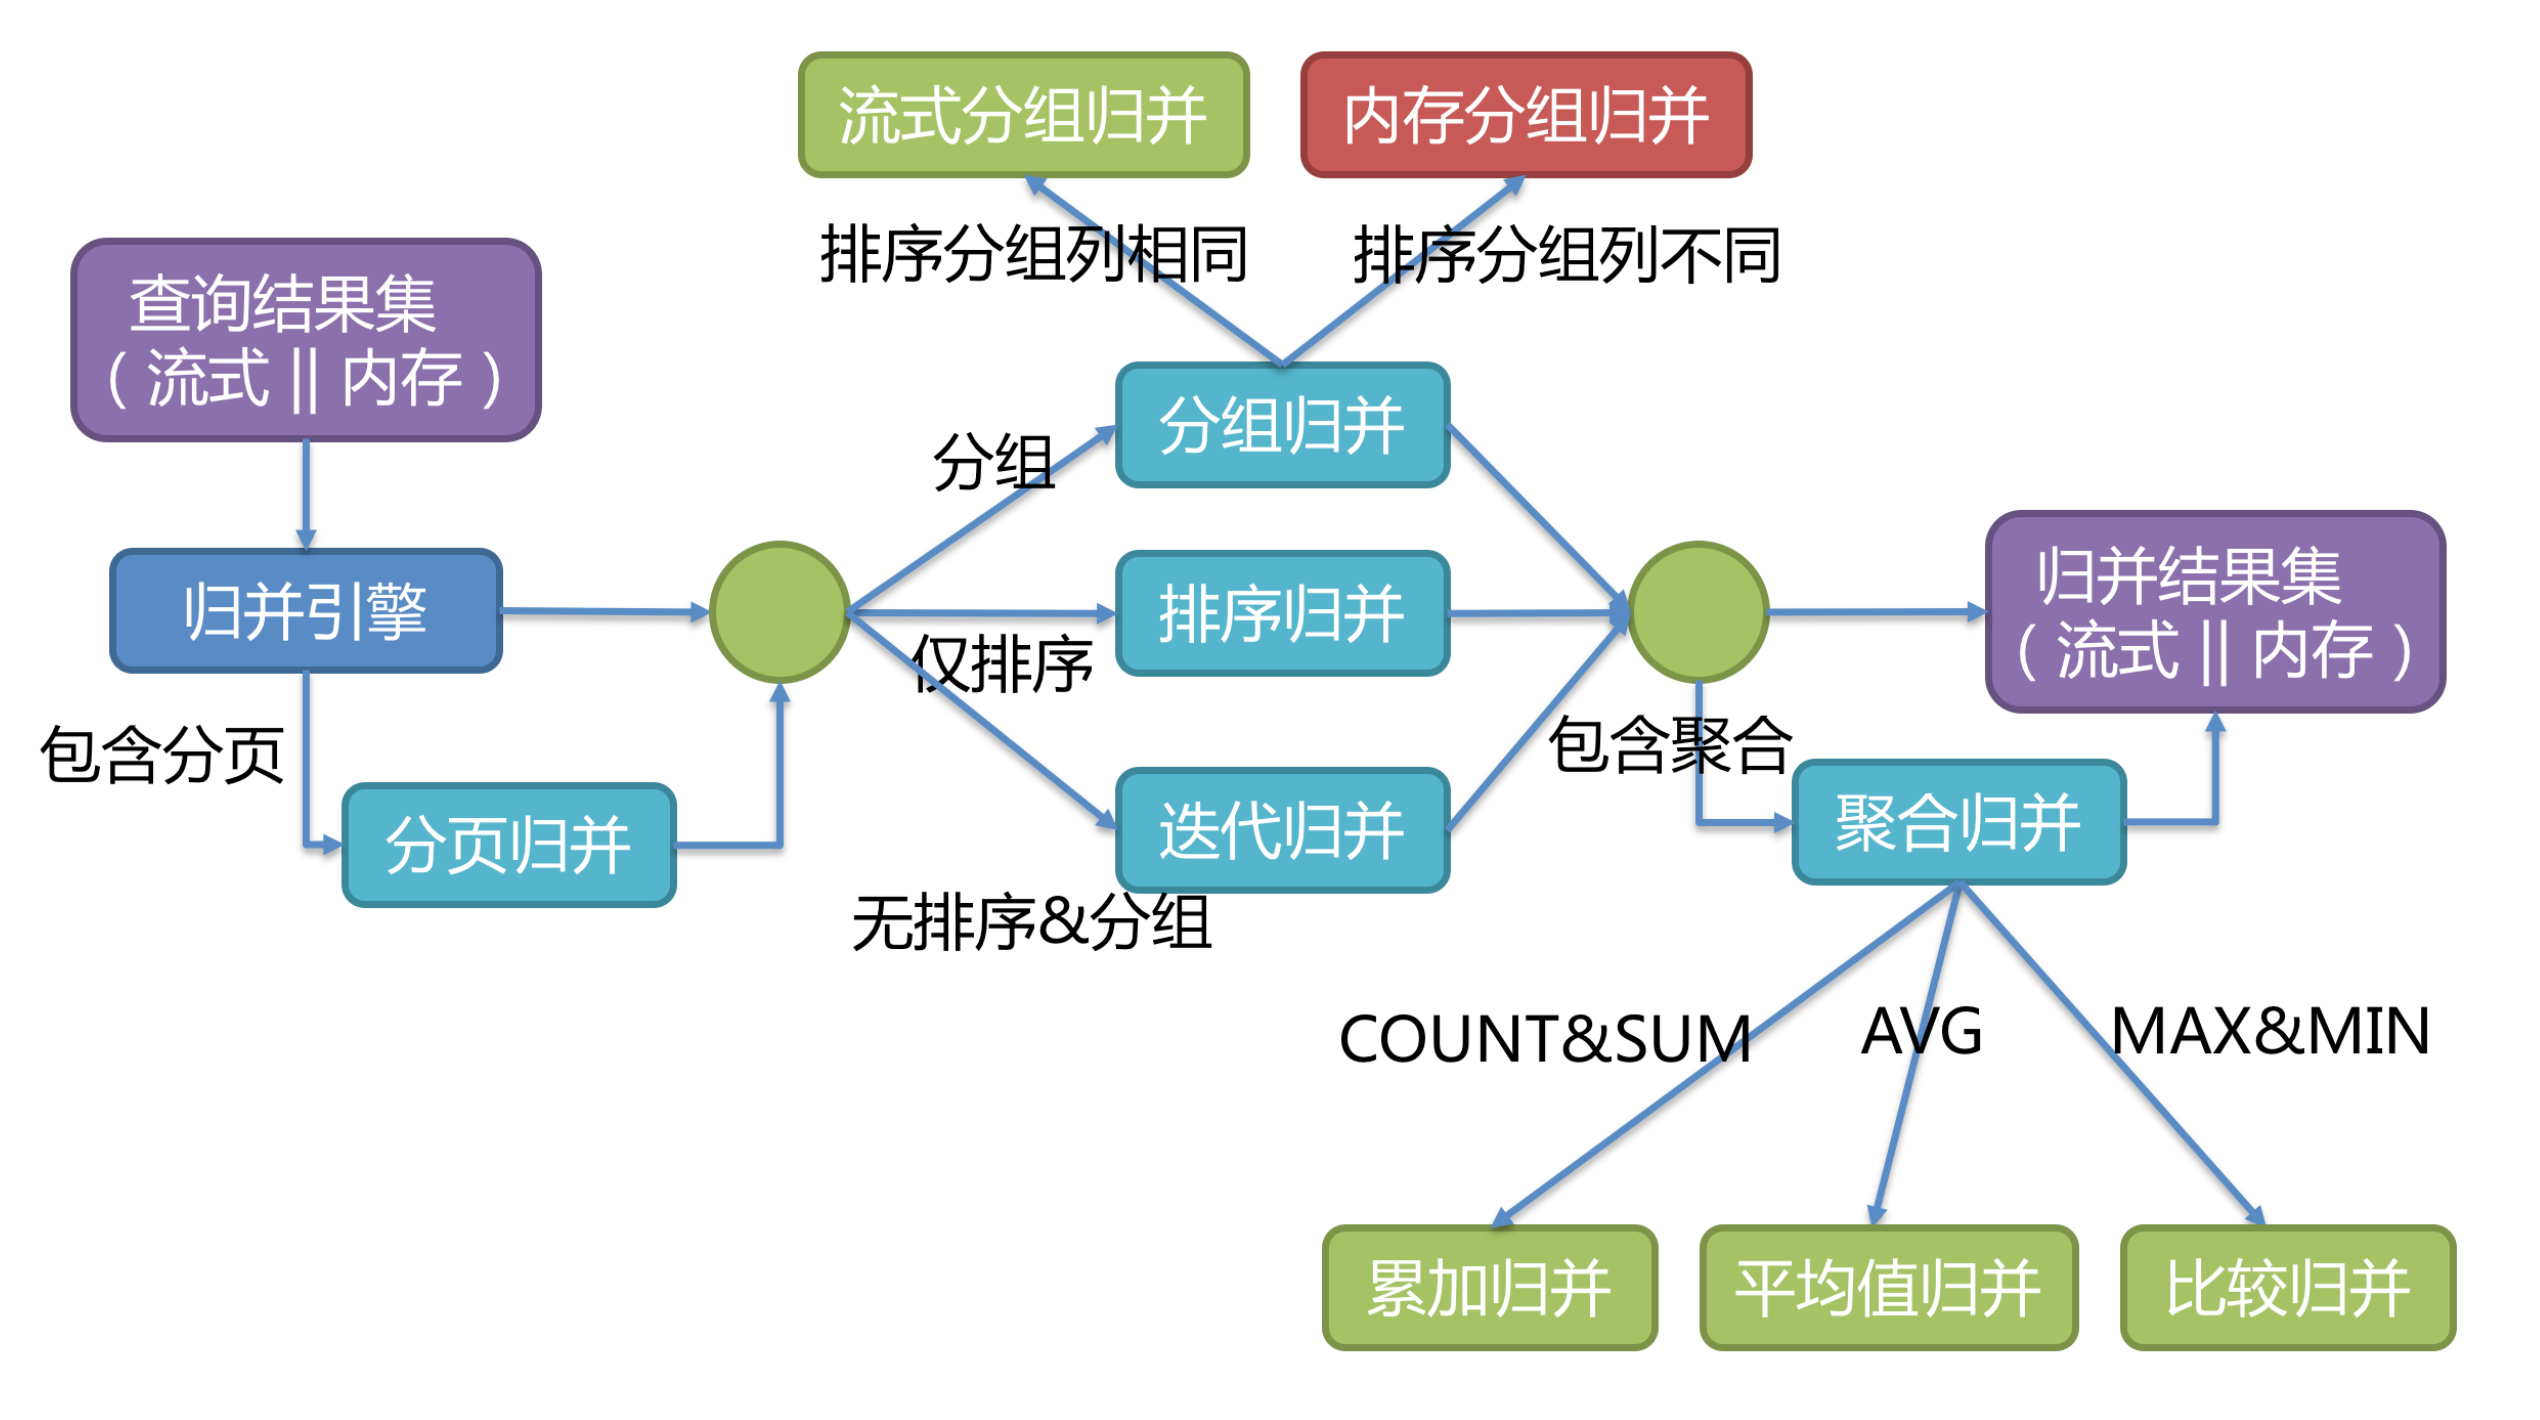
Sharding-jdbc 3.0不支援的sql
- 不支援CASE WHEN、HAVING、UNION (ALL),可以拆分查詢自己再拼接
- 子查詢不能出現相同的表
- 包含聚合函數的子查詢
- 同時使用distinct和聚合函數
ShardingSphere擴展點
ShardingAlgorithm擴展點就列出了ShardingSphere默認提供的多種分片策略:
- InlineShardingAlgorithm:基於⾏表達式的分⽚演算法
- ModShardingAlgorithm:基於取模的分⽚演算法
- HashModShardingAlgorithm:基於哈希取模的分⽚演算法
- FixedIntervalShardingAlgorithm:基於固定時間範圍的分⽚演算法
- MutableIntervalShardingAlgorithm:基於可變時間範圍的分⽚演算法
- VolumeBasedRangeShardingAlgorithm:基於分⽚容量的範圍分⽚演算法
- BoundaryBasedRangeShardingAlgorithm:基於分⽚邊界的範圍分⽚演算法
還有其他分散式主鍵、分散式ID等等擴展點
分庫分表中間件對比
-
Cobar
阿里 b2b 團隊開發和開源的,屬於 proxy 層方案,就是介於應用伺服器和資料庫伺服器之間。應用程式通過 JDBC 驅動訪問 Cobar 集群,Cobar 根據 SQL 和分庫規則對 SQL 做分解,然後分發到 MySQL 集群不同的資料庫實例上執行。早些年還可以用,但是最近幾年都沒更新了,基本沒啥人用,差不多算是被拋棄的狀態吧。而且不支援讀寫分離、存儲過程、跨庫 join 和分頁等操作。由於Cobar發起人的離職,Cobar停止維護
-
TDDL
淘寶團隊開發的,屬於 client 層方案。支援基本的 crud 語法和讀寫分離,但不支援 join、多表查詢等語法。目前使用的也不多,因為還依賴淘寶的 diamond 配置管理系統。
-
Atlas
是360團隊基於mysql proxy改寫,功能還需完善,高並發下不穩定
-
Sharding-jdbc
噹噹開源的,屬於 client 層方案,目前已經更名為 ShardingSphere(後文所提到的 Sharding-jdbc,等同於 ShardingSphere)。確實之前用的還比較多一些,因為 SQL 語法支援也比較多,沒有太多限制,而且截至 2019.4,已經推出到了 4.0.0-RC1 版本,支援分庫分表、讀寫分離、分散式 id 生成、柔性事務(最大努力送達型事務、TCC 事務)。而且確實之前使用的公司會比較多一些(這個在官網有登記使用的公司,可以看到從 2017 年一直到現在,是有不少公司在用的),目前社區也還一直在開發和維護,還算是比較活躍,個人認為算是一個現在也可以選擇的方案。
-
Mycat
基於 Cobar 改造的,解決了cobar存在的問題,並且加入了許多新的功能在其中。青出於藍而勝於藍,屬於 proxy 層方案,支援的功能非常完善,而且目前應該是非常火的而且不斷流行的資料庫中間件,社區很活躍,也有一些公司開始在用了。但是確實相比於 Sharding jdbc 來說,年輕一些,經歷的錘鍊少一些。
Sharing-jdbc不用部署,直接使用jar包,相對維護起來比較簡單,運維成本低
Mycat屬於代理Proxy,需要部署運維,它是一個中間件
建議中小型公司選用 Sharding-jdbc,client 層方案輕便,而且維護成本低,不需要額外增派人手,而且中小型公司系統複雜度會低一些,項目也沒那麼多;但是中大型公司最好還是選用 Mycat 這類 proxy 層方案,因為可能大公司系統和項目非常多,團隊很大,人員充足,那麼最好是專門弄個人來研究和維護 Mycat,然後大量項目直接透明使用即可
分布分表應用和問題
1、在資料庫設計的時候就考慮垂直分庫和分表
2、資料庫數據越來越多不要考慮水平切分,先考慮讀寫分離,使用索引等等。如果解決不了在使用水平分表
帶來的問題:
- 跨分片的事務一致性難以保證
- 跨庫的join關聯查詢性能較差
- 數據多次擴展難度和維護量極大
- 查詢問題表分布在不同的庫裡面
- 分頁查詢不方便
解決方案:
-
跨分片的事務一致性難以保證
- 拆分成多個小事務,來進行總控制
- 使用分散式事務,性能代價高(推薦)
-
join操作
- 數據分布在不同的表:分兩次查詢再合併,先查關聯id再根據關聯id去另一個表查數據(推薦)
- 全局數據:這樣的數據比較少修改,很多模組都會依賴這個表,這樣可以在每個資料庫保存一份,避免跨庫查詢
- 欄位冗餘:可能需要的數據欄位在詳細表中,可以將欄位放過來,避免join查詢
- Mycat支援跨庫join
-
count操作
先在不同庫中把數據取出來,最後再統計
-
分頁操作
1、數據拼裝:先在不同庫中把數據取出來,最後再合併分頁,如果數據量太大很消耗系統資源,性能也很差
2、禁止跳頁:降低技術方案
3、資料庫均衡:如果數據差不多均衡的話,各個庫各取一半數據,優點是不需要再進行記憶體排序,但是精度可能會丟失一些
-
數據多次擴展難度和維護量極大
-
查詢問題
- 直接查詢:每個資料庫執行一遍語句,性能差
- 模糊查詢:數據拼裝
- 使用關聯表/關聯欄位:具體表分布在哪個庫
- MyCat多執行緒查詢:類似第一種方式
- 異構索引:額外建立一個索引表記錄分片鍵和非分片欄位的對應關係,例如通過xx欄位找到訂單id,然後根據訂單id找到對應的庫(方法可以,但沒法通用範圍,狀態等等不好查)
- 實時數倉:通過中間件監聽資料庫binlog日誌,實時收集數據
-
分表後使用非分片欄位查詢問題(根據任意一個欄位查詢數據,如何找到所在表)
根據訂單ID進行分庫,如果需要刪除前一天的訂單記錄,那麼需要在每個庫中執行一遍sql,沒法確定哪個庫執行哪個庫不執行
解決辦法:冗餘欄位:因為是根據訂單id進行路由的,那麼幾個路由的鍵都是固定的,比如路由到3個庫,那麼0、1、2分別代表這三個庫的索引,在表裡面記錄下這個欄位,就可以直接找到這個庫進行刪除。
-
主鍵ID問題(為什麼不使用自增或者UUID)
-
使用自增可能會出現ID重複的問題
-
使用UUID 缺點:太長不方便排序
-
雪花演算法:(0+41位時間戳+10位工作機器id+12位序列號)傳給前端的時候用String,使用Long的話前端js會溢出。缺點:時間戳依賴於機器時鐘。如果機器時間回調,還是可能會有衝突
-
使用redis生成分散式主鍵
-
-
數據擴縮容
-
擴容的話:一般是因為數據量太多磁碟快滿了,原有兩台機器,每台機器2個庫,每個庫4個表,總共個16表,增加伺服器2個伺服器,每台伺服器增加兩個庫,調整為每個伺服器的一個庫,每個庫裡面還是固定的2張表
分片id 取模 8/=庫
分片id /8 ,再取模8 = 表
-
-
數據遷移(如何在舊數據上做分庫分表)
- 半夜系統停機,停止寫入數據然後使用中間件寫入(廢人)
- 系統不停機,使用雙寫方案,數據同時寫入新庫新表和舊錶,等於兩份數據。再用工具去去讀老庫的數據到新庫中,可以根據主鍵id或者修改時間區分數據。可能會造成程式碼入侵,可以監聽binlog日誌,最後再校驗數據是否準確,先校驗數量,再使用隨機取樣法抽取幾十條數據合併,比較是否相等通過Base64加密對比
相關部落格
Sharding-JDBC 實戰(史上最全) - 瘋狂創客圈 - 部落格園 (cnblogs.com)
從一個簡單的SQL查詢搞懂Sharding-Proxy核心原理 - 掘金 (juejin.cn)