從HashMap的執行流程開始 揭開HashMap底層實現
- 2022 年 8 月 21 日
- 筆記
- 從HashMap的執行流程開始 揭開HashMap底層實現
☺ 心得:如何學習源碼:
從某個執行過程入手,建議先從整體入手,了解底層的數據結構是怎麼一步一步優化的。最後,在了解完底層的數據結構優化過程後,從重要的核心方法入手,從它的執行流程入手,先去網上搜索了解它的執行流程過程(推薦看流程圖),再去看源碼。
(1)
從某個執行過程入手,建議先從整體入手,了解底層的數據結構是怎麼一步一步優化的:比如雖然我們知道HashMap 底層數據結構是:數組+鏈表+紅黑樹,但是一開始研究的是增刪改查某個流程的執行,
它的整體思路是只用到
數組作為哈希表存儲數據,即key 根據 哈希函數,換算得到 索引,然後根據索引定位操作對應的 數組元素。但是存儲過程發生了哈希衝突,在解決哈希衝突使用-鏈地址法,於是
HashMap的底層結構才加入單鏈表。但是為提升效率,使用效率高的數據結構-紅黑樹,在鏈表的結點大於8且數組容量大於64,單鏈錶轉成紅黑樹,於是
HashMap的底層結構才加入紅黑樹。(2)
最後,在知道了底層的數據結構優化過程後,從重要核心方法的執行流程入手,先去了解到它的執行流程 (推薦看流程圖),再去看源碼:
比如先了解整明白put方法執行流程圖:
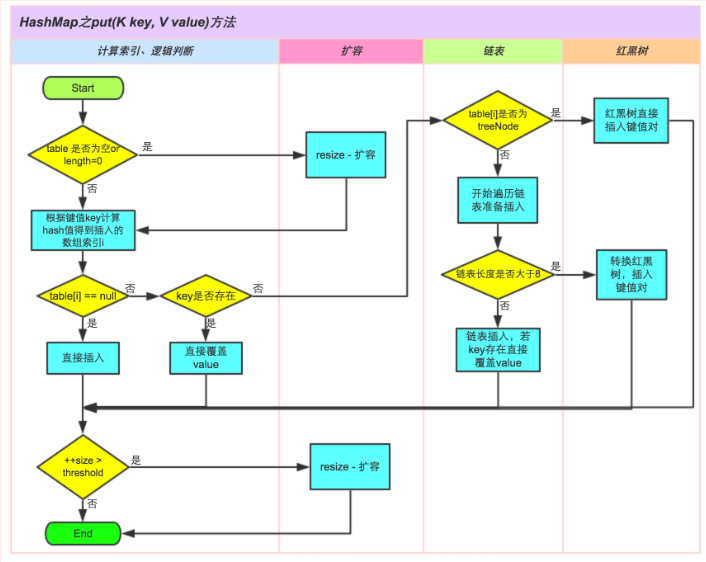
然後再使用idea 點擊進入HashMap的put方法,自己去看源碼:
一、HashMap 哈希表
1、 哈希表簡單介紹:是【空間換時間】的典型應用
- 哈希函數,也叫做散列函數
- 哈希表內部的數組元素,很多地方也叫 Bucket(桶),整個數組叫 Buckets 或者 BucketArray
★ 2、(增刪改查) 執行流程:
- 比如增加流程:
▪ 增刪改查的流程都是類似的:
① 利用哈希函數生成key 對應的索引 index 【O(1)】
② 根據 index 操作定位到的數組 元素 【O(1)】
put("Jack", 666);
put("Rose", 777);
put("Kate", 888);
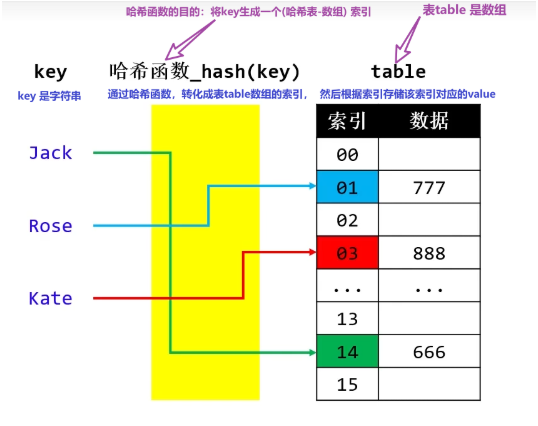
- 比如Key 是Object 類型,可以存儲各種類型
★ 3、哈希衝突(哈希碰撞)
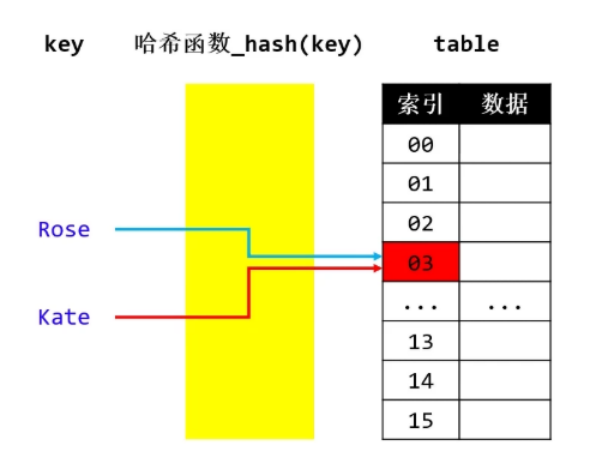
(1) 定義:2 個不同的 key,經過哈希函數計算出相同的結果(索引相同)
(2) 解決哈希衝突方法:
- 開放定址法:
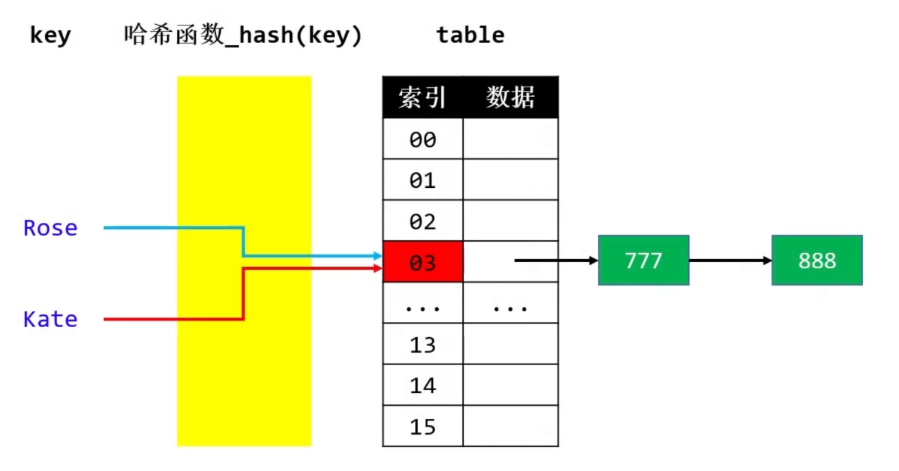
例如上圖,key="Rose" 經過哈希函數換算得到索引是03,然後將key對應的value放到索引為03的數組元素位置上;
此時,key="Kate" 經過哈希函數換算得到索引也是03,而03的元素位置已經被key="Rose"對應的value 佔據了,那麼 從索引03的下一個位置 開始往下找一個新的"坑",往下一個一個地找(線性探測),直到找到哈希表的元素(桶),桶是空的,然後放上key="Kate"對應的value
▪ 當然往下繼續找空桶,可以按平方找 12、22、32、42 等等 (平方探測)
- 再哈希法:設計了多個哈希函數
上圖,按先來的先佔坑,03索引的元素(桶)的"坑位" 已經被 key="Rose" 佔據了,後來者key="Kate",換算得到的索引也是 03,而"坑位"已經被佔據了,那麼key="Kate",選擇使用另外一個哈希函數,換算得到一個新的索引,直到可以成功佔到"坑位"。
-
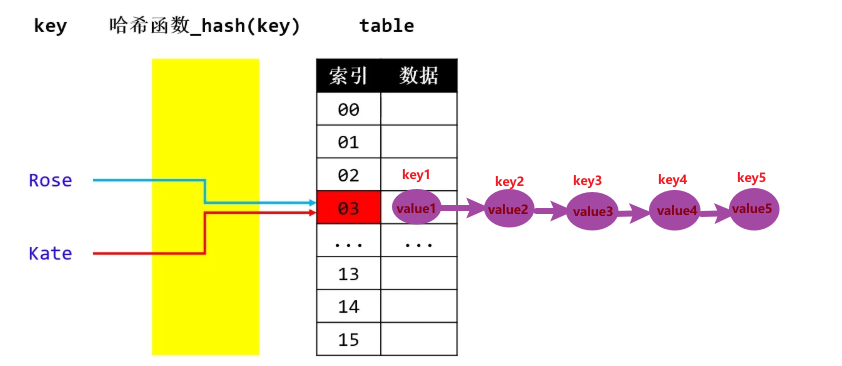
鏈地址法: 比如通過鏈表將同一index的元素串起來put("Jack", 666); put("Rose", 777); put("Kate", 888);
★ 4、JDK1.8的哈希衝突解決方法:鏈地址法(數據結構:單鏈表+紅黑樹)
◼ 默認使用單向鏈表將元素串起來
◼ 在添加元素的過程,可能會由單向鏈錶轉為紅黑樹來存儲元素
比如當哈希表容量 ≥ 64 且 單向鏈表的節點數量大於 8 時
◼ 當紅黑樹節點數量少到一定程度時,會由紅黑樹轉為單向鏈表
◼ JDK1.8中的哈希表是使用鏈表+紅黑樹解決哈希衝突
☺ 為什麼使用 單向鏈表,不使用雙向鏈表呢?
為了節省記憶體空間,單向鏈表比雙向鏈表少一個指針;而且每次都需要從頭開始遍歷,使用單向鏈表完全滿足
至此,咱就已經知道HashMap的底層數據結構為什麼是數組+鏈表+紅黑樹,
接下來,咱需要了解具體實現HashMap的細節:比如哈希函數的具體實現過程,哈希值怎麼計算,增刪改查的具體實現細節、哈希表的擴容等等
5、哈希函數(散列函數)的作用:將各種類型的key 換算成哈希表(數組) 的索引
(1) 哈希函數的具體實現過程:
① 首先根據 key,生成 哈希值(必須是整數-int 類型)
② 然後再根據 key 的哈希值和 數組的大小 進行相關運算,生成一個 索引值
    static final int hash(Object key) {
        //return key.hashCode() % table.length;
        // 為了提升運算效率,使用 & 位運算取代 % 運算(前提:數組長度設計為2的冪)
        return key.hashCode() & (table.length - 1);
    }
(2) 補充一下 與運算 &:
不管一個數 x 多大,x & 100, 最終的範圍就是[0, 100]
- 使用 & 位運算取代 % 運算(前提:數組長度設計為2的冪):是為了保證被與數全是1
- 比如 2^1 是 10,2^1-1 是 00
- 比如 2^2 是 100,2^2-1 是 11
- 比如 2^3 是 1000,2^3-1 是 111
- 比如 2^4 是 10000,2^4-1 是 1111
(3) 良好的哈希函數(哈希函數作用):
- 讓哈希值更加均勻分布 → 減少哈希衝突次數 → 提升哈希表的性能
6、哈希值計算
- 我們知道哈希函數第一步是根據key獲取到哈希值,而且哈希值必須是整型;而key的類型是各種各樣的,那麼各種各樣的key是如何獲取到哈希值的呢?
▪ 不同種類的 key,哈希值的生成方式不一樣,但目標是一致的
♢ 盡量讓每個 key 的哈希值是唯一的
♢ 盡量讓 key 的所有資訊參與運算
◼ 在Java中,
HashMap 的 key 必須實現 hashCode、equals 方法,也允許 key 為 null
(1) 數值類型-哈希計算:包括整型、Long類型、浮點型Float、Double類型
① 整型-哈希值計算
-
整型的哈希值,已經滿足哈希值是整數的特點了,所以整型的哈希值是它本身。
public static int hashCode(int value){
	rerurn value;
}
② 浮點型-哈希值計算
-
將浮點數對應的二進位數轉成整數
- float 類型,直接調用:Float對象的floatToIntBits方法,直接將float類型的數據對應的二進位數轉成整數
  public static int hashCode(int value){
  	rerurn Float.floatToIntBits(value);
  }
- double 類型,直接調用:Double 對象的doubleToIntBits方法,直接將double類型的數據對應的二進位數轉成整數
細節:java 要求哈希值必須是int 類型,是32位的,對於 long(64位)、double(64位) 類型超過32位的都需要進行處理:
- 將64位分成兩部分,讓 高32bit 和 低32bit 混合計算出 32bit 的哈希值,充分利用所有資訊計算出哈希值。
// double 類型
public static int hashCode(int value){
    long bits = Double.DoubleToIntBits(value);
	rerurn (int)(bits ^ (bits >>> 32));
}

//long 類型
public static int hashCode(int value){
	rerurn (int)(value^(value >>> 32));
}

♢ 無符號的位運算>>> 和 異或運算^ 作用?
將64位分成兩部分,讓 高32bit 和 低32bit 混合計算出 32bit 的哈希值,充分利用所有資訊計算出哈希值。
■ 補充一個細節:hash 函數,對哈希值進行右移16位後取異或
對哈希值的進一步處理:擾動計算,是哈希值分布更加均勻。
    static final int hash(Object key) {
	   int h = key.hashCode();
        return (h ^ (h >>> 16)) & (table.length - 1);//將哈希值低16位與高16 位進行混合,企圖讓哈希值分布更加均勻
    }
(3) 字元串-哈希值計算
- 利用字元串的字元本質是整數
例如:整數 5487 計算過程: 5 * 10^3 + 4 * 10^2 + 8 * 10^1 + 7 * 10^0
同理:字元串"kate",是由'k'、'a'、't'、'e' 組成:可以表示為 k * n^3 + a * n^2 + t * n^1 + e * n^0
合併,減少計算次數,等價於 [(k * n + a) * n + t] * n + e
java中 n=31,則[(k * n + a) * n + t] + e = [(k * 31 + a) * 31 + t] * 31 + e
發現規律:當前字元a或t或e的哈希值:是先算出前面的字元*31 + 當前的字元
    public int hashCode() {
        int h = hash;
        if (h == 0 && value.length > 0) {
            char val[] = value;

            for (int i = 0; i < value.length; i++) {
                h = 31 * h + val[i];
            }
            hash = h;
        }
        return h;
    }
(4) 自定義對象-哈希值計算
- 對自定義對象的屬性根據key類型計算得出哈希值後,進行相加
7、為什麼需要重寫 equals
需要判斷 key 是否相同,相同的話,直接用key 對應的value 覆蓋掉原先的value
■ 為什麼有hashCode 方法,比較 key 是否相同還需要 重寫equals方法?
-
因為hashCode 方法的作用是 生成key的哈希值,而
對於不同的key,比如key類型是不同,最後算出的哈希值卻是相同,所以hashCode 方法並不能判斷兩個key是否相同,需要重寫equals方法,進一步比較兩個key是否相同。
■ 總結:hashCode 方法 和 equals 方法 作用是不同的?
- hashCode 方法:生成key的哈希值
- equals 方法:比較key是否相同
8、HashMap源碼分析
(1) 了解重要的幾個常量
Node<K,V>[] table;//哈希桶數組,明顯它是一個Node的數組
// Node是HashMap的一個內部類,實現了Map.Entry介面,本質是就是一個映射(鍵值對)。
-
HashMap就是使用哈希表來存儲的。哈希表為解決衝突,可以採用開放地址法和鏈地址法等來解決問題,Java中HashMap採用了鏈地址法。鏈地址法,簡單來說,就是數組加鏈表的結合。在每個數組元素上都一個鏈表結構,當數據被Hash後,得到數組下標,把數據放在對應下標元素的鏈表上。
-
減少哈希衝突,依靠:好的Hash演算法和擴容機制
int DEFAULT_INITIAL_CAPACITY = 1 << 4; // 默認的哈希桶的長度 16,要求哈希桶的長度必須是2的n次方

/* 構造函數就是對下面幾個欄位進行初始化 */
int threshold;             // 可以容納最大的Node個數(最大元素數目)
final float loadFactor;    // 負載因子,默認值是0.75
int modCount;  			  // 記錄HashMap內部結構發生變化的次數
int size;				  // 節點的數量
// threshold = length * loadFactor 能容納的最大節點個數=哈希桶容量*負載因子
- threshold就是在此loadFactor和length(數組長度)對應下允許的最大元素數目,超過這個數目就重新resize(擴容),擴容後的HashMap容量是之前容量的兩倍。
■ 要求哈希桶的長度必須是2的n次方?
HashMap採用這種非 常規設計(常規是設計成素數),主要是為了在取模和擴容時做優化,同時為了減少衝突,HashMap定位哈希桶索引位置時,也加入了高位 參與運算的過程。
int TREEIFY_THRESHOLD = 8;		// 樹化閥值
int MIN_TREEIFY_CAPACITY = 64;	// 樹化哈希桶最小容量
int UNTREEIFY_THRESHOLD = 6;	// 樹降級為鏈表的閥值
- 添加元素時,
當哈希表容量 ≥ 64 且 單向鏈表的節點數量大於 8 時,單向鏈錶轉為紅黑樹來存儲元素
(2) 了解幾個重要的方法
■ 確定哈希桶數組索引位置
方法一:
static final int hash(Object key) {   //jdk1.8 & jdk1.7
     int h;
     // h = key.hashCode() 為第一步 取hashCode值
     // h ^ (h >>> 16)  為第二步 高位參與運算
     return (key == null) ? 0 : (h = key.hashCode()) ^ (h >>> 16);
}
方法二:
static int indexFor(int h, int length) {  //jdk1.7的源碼,jdk1.8沒有這個方法,但是實現原理一樣的(在put方法中,有與運算來定位到索引位置)
     return h & (length-1);  //第三步 取模運算
}
總結:哈希函數將key換算成哈希桶數組的索引具體實現過程:
① 生成key的哈希值 ② 高位參與運算 ③ 取模運算
- 高位參與運算:將哈希值低16位與高16 位進行混合,企圖讓哈希值分布更加均勻
- 取模運算:定位到數組的索引位置
■ put 增加元素方法
    final V putVal(int hash, K key, V value, boolean onlyIfAbsent,
                   boolean evict) {
        Node<K,V>[] tab; Node<K,V> p; int n, i;
        if ((tab = table) == null || (n = tab.length) == 0)//判斷哈希桶數組是否為空/是否存在,不存在-擴容
            n = (tab = resize()).length;
        if ((p = tab[i = (n - 1) & hash]) == null)//判斷定位到的哈希桶數組的索引對應的元素是否為空/是否存在,不存在,直接創建插入該元素
            tab[i] = newNode(hash, key, value, null);
        else {//哈希桶數組的元素存在,那麼判斷key是否存在
            Node<K,V> e; K k;
            if (p.hash == hash &&
                ((k = p.key) == key || (key != null && key.equals(k))))
                e = p;//key存在,直接覆蓋元素的值
            else if (p instanceof TreeNode)//key不存在,判斷是否是一顆樹節點
                e = ((TreeNode<K,V>)p).putTreeVal(this, tab, hash, key, value);//是樹節點,紅黑樹插入
            else {
                for (int binCount = 0; ; ++binCount) {//不是樹節點,鏈表從頭遍歷插入該節點
                    if ((e = p.next) == null) {
                        p.next = newNode(hash, key, value, null);
                        if (binCount >= TREEIFY_THRESHOLD - 1) //插入後節點大於8,開始樹化成紅黑樹
                            treeifyBin(tab, hash);
                        break;
                    }
                    if (e.hash == hash &&
                        ((k = e.key) == key || (key != null && key.equals(k))))//key存在,直接覆蓋元素的值
                        break;
                    p = e;
                }
            }
            if (e != null) { // existing mapping for key
                V oldValue = e.value;
                if (!onlyIfAbsent || oldValue == null)
                    e.value = value;
                afterNodeAccess(e);
                return oldValue;
            }
        }
        ++modCount;
        if (++size > threshold)//插入元素後判斷是否大於 threshold(可以容納的最大元素數目/節點數) --大於,則需要擴容
            resize();
        afterNodeInsertion(evict);
        return null;
    }
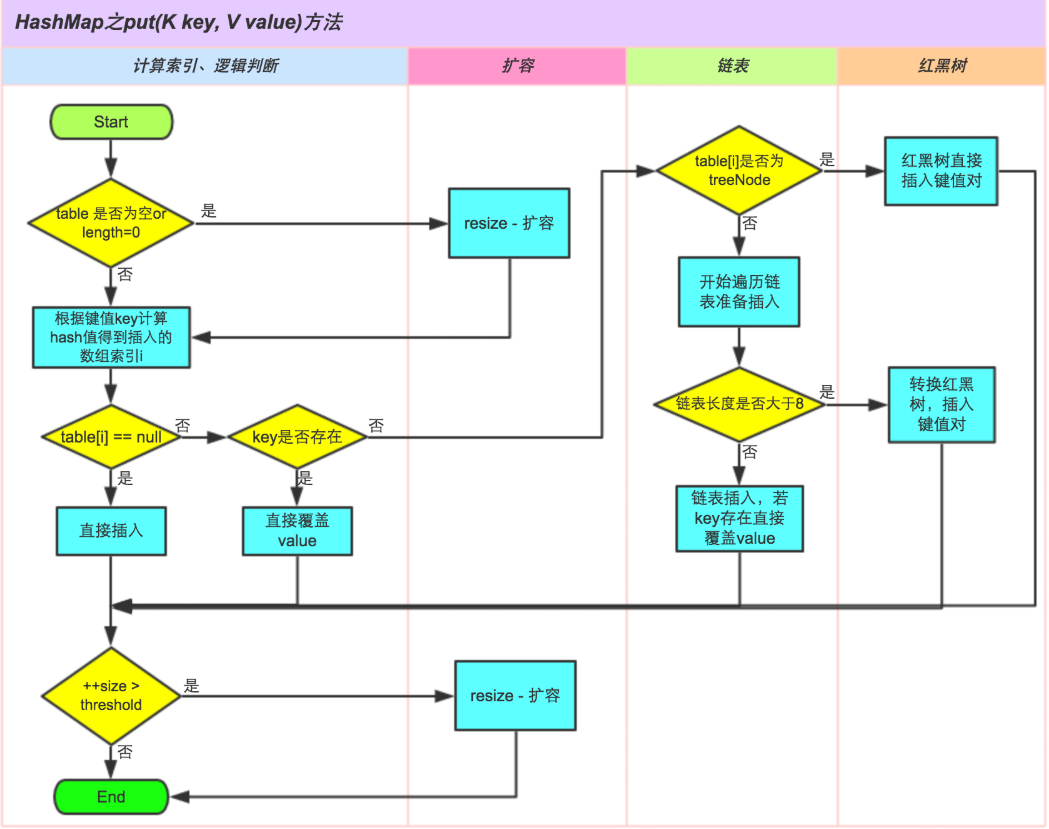
總結put時的思考點:
1、哈希表是否為空判斷---空(需要擴容)
2、定位哈希表索引對應的元素是否為空判斷---空(直接插入)
3、元素非空,判斷key是否存在,存在直接覆蓋
不存在,判斷該節點是否是一顆樹節點,是樹節點->紅黑樹插入
不是樹節點->鏈表插入,插入後判斷節點數量是否大於8,大於8樹化成紅黑樹
4、插入元素後判斷是否大於 threshold(可以容納的最大元素數目/節點數) --大於(需要擴容)
參考文章:美團技術團隊 《Java 8系列之重新認識HashMap》
如果本文對你有幫助的話記得給一樂點個贊哦,感謝!