Bert不完全手冊7. 為Bert注入知識的力量 Baidu-ERNIE & THU-ERNIE & KBert
借著ACL2022一篇知識增強Tutorial的東風,我們來聊聊如何在預訓練模型中融入知識。Tutorial分別針對NLU和NLG方向對一些經典方案進行了分類匯總,感興趣的可以去細看下。這一章我們只針對NLU領域3個基於實體鏈接的知識增強方案Baidu-ERNIE,THU-ERNIE和K-Bert來聊下具體實現~
知識增強
Knowledge is any external information absent from the input but helpful for generating the output
Tutorial里一句話點題,知識就是不直接包含在當前文本表達中的,但是對文本理解起到幫助作用的補充資訊,大體可以分成
- 通用領域:例如中國的首都是北京
- 特殊領域:例如醫療,金融,工業等場景中的領域知識,
- 常識:例如狗有4條腿,雞不會飛,豬不能上樹
常規預訓練預語料也是包含部分知識的,不過受限於知識出現的頻率,以及非結構化的知識表徵,預訓練任務的設計等等因素,知識資訊往往等不到充分的訓練,因此BERT不可避免會給出一些不符合知識但是符合語言表達的預測結果,於是有了嘗試在預訓練階段融入結構化知識資訊的各種嘗試
LM中融入知識的一般分成3個步驟:定位知識(knowledge grounding),知識表徵(knowledge representation),融入知識(knowledge fusion),這麼說就像把大象放進冰箱一樣easy,不過實現起來細節問題頗多,例如定位知識時的消歧問題,知識表徵和文本表徵的不一致問題,知識融入時如何不干擾原始的上下文語義等等,下面我們來看下3種不同的增強方案
Baidu-ERNIE
- paper: ERNIE: Enhanced Representation through Knowledge Integratiion
- Github: //github.com/PaddlePaddle/ERNIE
- Take Away: 通過knowledge masking學到隱含的實體以及短語內部一致資訊
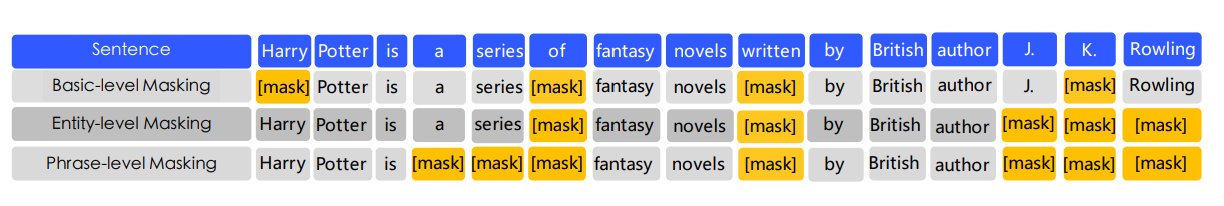
ERNIE的主要創新是在預訓練階段引入了knowledge masking,這裡的knowledge包括短語和實體兩種。所以ERINE定位知識的方式是通過分詞定位短語,以及通過實體匹配定位到實體。對比BERT對獨立token進行掩碼,ERNIE分階段採用token,phrase和entity這三種不同粒度的span進行掩碼。實體和短語內部的字元,因為被同時掩碼,所以會被相同的上下文資訊進行梯度更新,使得token之間學到內部關聯資訊,以及更清晰的實體邊界資訊,在NER等局部資訊抽取任務上更有優勢。不過模型本身並沒有引入更豐富的實體關聯等知識資訊~
THU-ERNIE
- paper:ERNIE: Enhanced Language Representation with Informative Entities
- github: //github.com/thunlp/ERNIE
- Take Away: 引入KG預訓練Embedding,通過FusionLayer進行知識融入
論起名的重要性,這兩篇ERNIE其實是完全不同的方向。THU-ERNIE更完整的給出了在預訓練中融入知識的方案。THU-ERNIE由T-Encoder和K-Encoder構成,其中T-Encoder就是常規的Transformer Block用來學習基於上下文的文本表徵,而K-Encoder負責知識表徵和融入,同時ERNIE設計了新的預訓練目標dAE來輔助知識資訊融入。以』Bob Dylan wrote Blowin in the Wind in 1962『為例,分別看下THU-ERNIE如何定位,表徵和融入知識
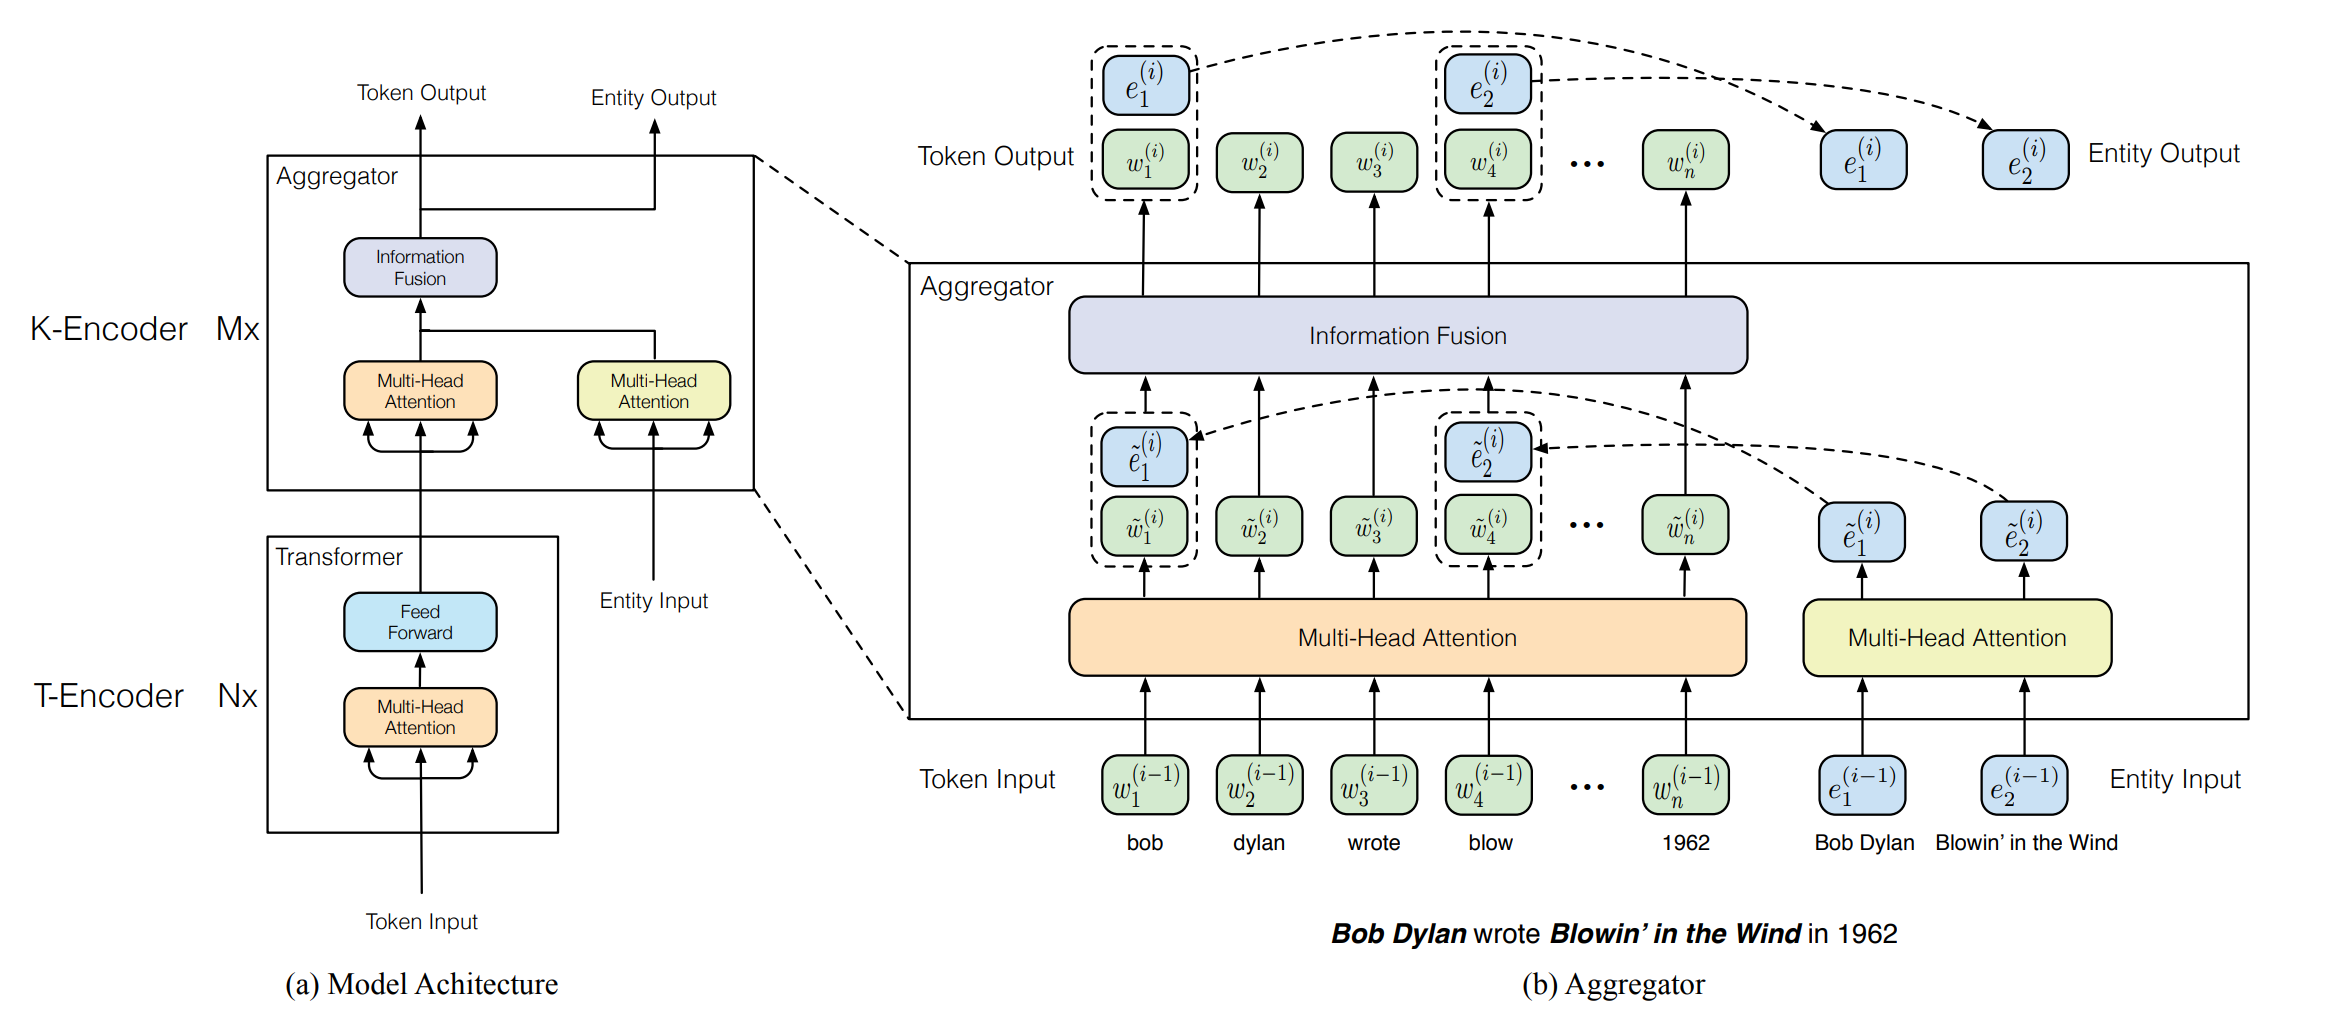
knowledge Encoder
ERNIE通過TAGME從句子中定位到實體知{e1, ...en},並使用TransE預訓練的實體embedding作為知識表徵。在知識融入上,首先原始文本輸入會過T-Encoder得到考慮上下文的文本表徵,然後會通過K-Encoder中的多個Aggregator層進行知識融合,這裡的知識融合包括知識表徵和文本表徵的對齊以及雙方的資訊交互。每個Aggregator層由兩部分構成
- 多頭注意:文本表徵W和實體表徵E分別各自做多頭注意力,文本表徵是上下文交互,實體表徵是學習實體關聯
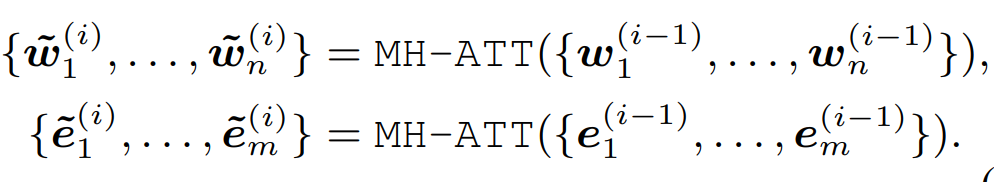
- Fusion:多頭輸出的文本表徵和實體表徵進行拼接[w,e],過feed forward來進行資訊融合,這裡的激活函數選用了gelu。對於非實體的文本因為沒有相關聯的實體所以等同於拼接了全0向量。融合表徵h分別做兩次非線性映射得到文本和實體的表徵,作為下一層aggregator的輸入。
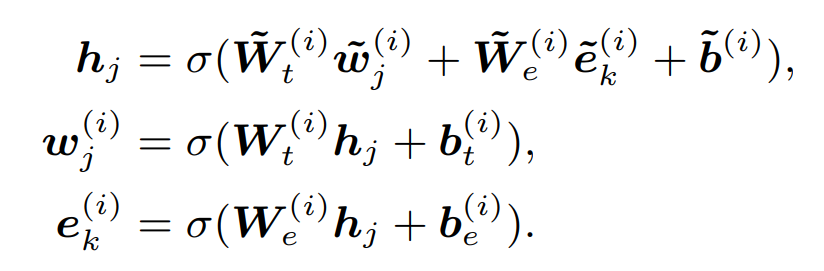
預訓練任務dAE

作者在MLM和NSP的預訓練任務的基礎上,加入了實體還原dAE任務,來幫助模型融合知識相關資訊。同樣是AutoEncoder任務,實體還原和MLM任務主要有兩個差異
- 掩碼差異:dAE採用5%隨機實體掩碼,15%同時對token和實體掩碼,85%保持不變的掩碼策略
- 還原差異:和token還原相比,實體還原採用了負取樣的邏輯,沒有從全部KG實體中進行預測,而是只從當前句子的所有實體中去選擇MASK位置的實體。
整體上dAE的任務設計偏簡單,首先是掩碼部分和BERT只保留10%的原始token相比,dAE85%的概率都保留原始token;同時還原任務只使用當前句子的實體作為候選,候選集較小。至於為什麼把任務調整的更加簡單,作者只簡單說是因為token-entity對齊會存在一定error,不過我對這部分的任務設計還是有些疑惑~有了解的同學求解答
ERNIE的預訓練過程使用了google BERT的參數來初始化T-Encoder,TransE的實體Embedding在訓練過程中是Freeze的,K-Encoder的參數會隨機初始化。效果上在Entity Typing和Relation Classification上都有較明顯的效果提升
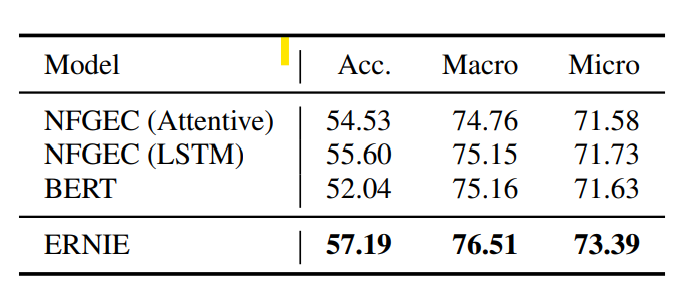
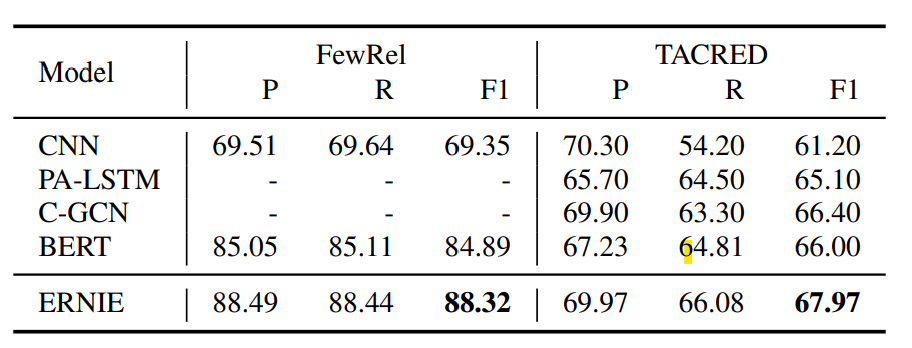
在常規的GLUE Benchmark上,針對樣本量較大的任務ERNIE和BERT持平,但是對樣本較小的任務上存在波動有好有壞,不過波動本身並不小。。。所以感覺不太能說明實體資訊引入完全沒有影響到原始上下文資訊
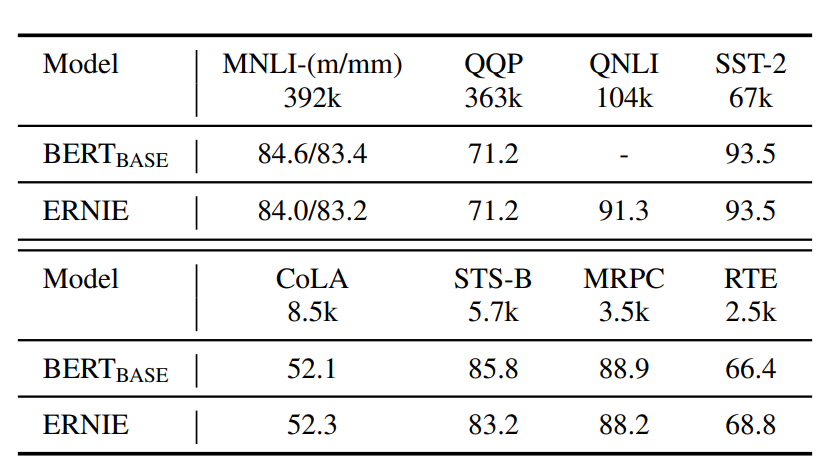
整體上ERNIE的效果提升還是顯著的,幾個能想到的討論方向有
- 預訓練任務的優化
- 特殊處理引入實體資訊後可能對上下文語義產生的影響
- 模型本身因為額外的K-Encoder的加入,模型複雜度較高,想要落地難度較大
K-BERT
- paper: ERNIE: Enhanced Language Representation with Informative Entities
- gitub: //github.com/autoliuweijie/K-BERT
- Take Away: 通過soft MASK和soft PE在引入知識表徵的同時不影響原有文本語義
K_BERT通過soft-Mask和soft-position,在不影響原始語義的情況下,把知識圖譜的3元組資訊直接融入文本表徵。以』CLS Tim Cook is visiting Beijing Now『 為例,分別看下K-bert如何定位,表徵和融入知識
knowledge Layer
K-bert在輸入層之前加入知識層,負責知識的定位和表徵。K-Bert通過字元匹配的方式先定位到句子中的實體,然後去圖譜中請求實體相關的全部3元組。句子中的Tim Cook和Beijing實體,分別能請求到如下三元組:[Tim Cook, CEO, Apple], [Beijing, capital, China],[Beijing, is_a , City]。這裡請求深度為1,也就是Beijing請求得到的China後,不會用China去進一步檢索。所有請求到的三元組會構建如下的句子樹
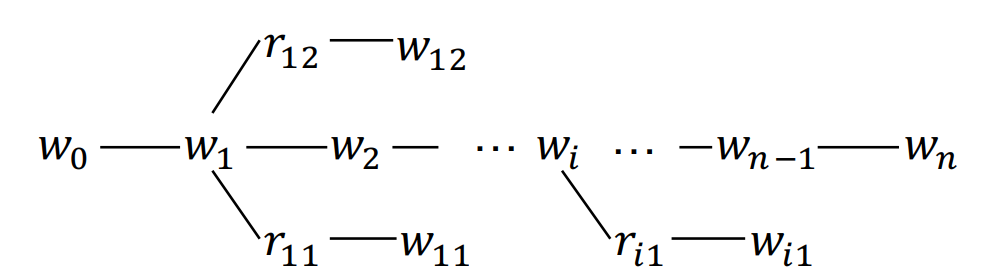
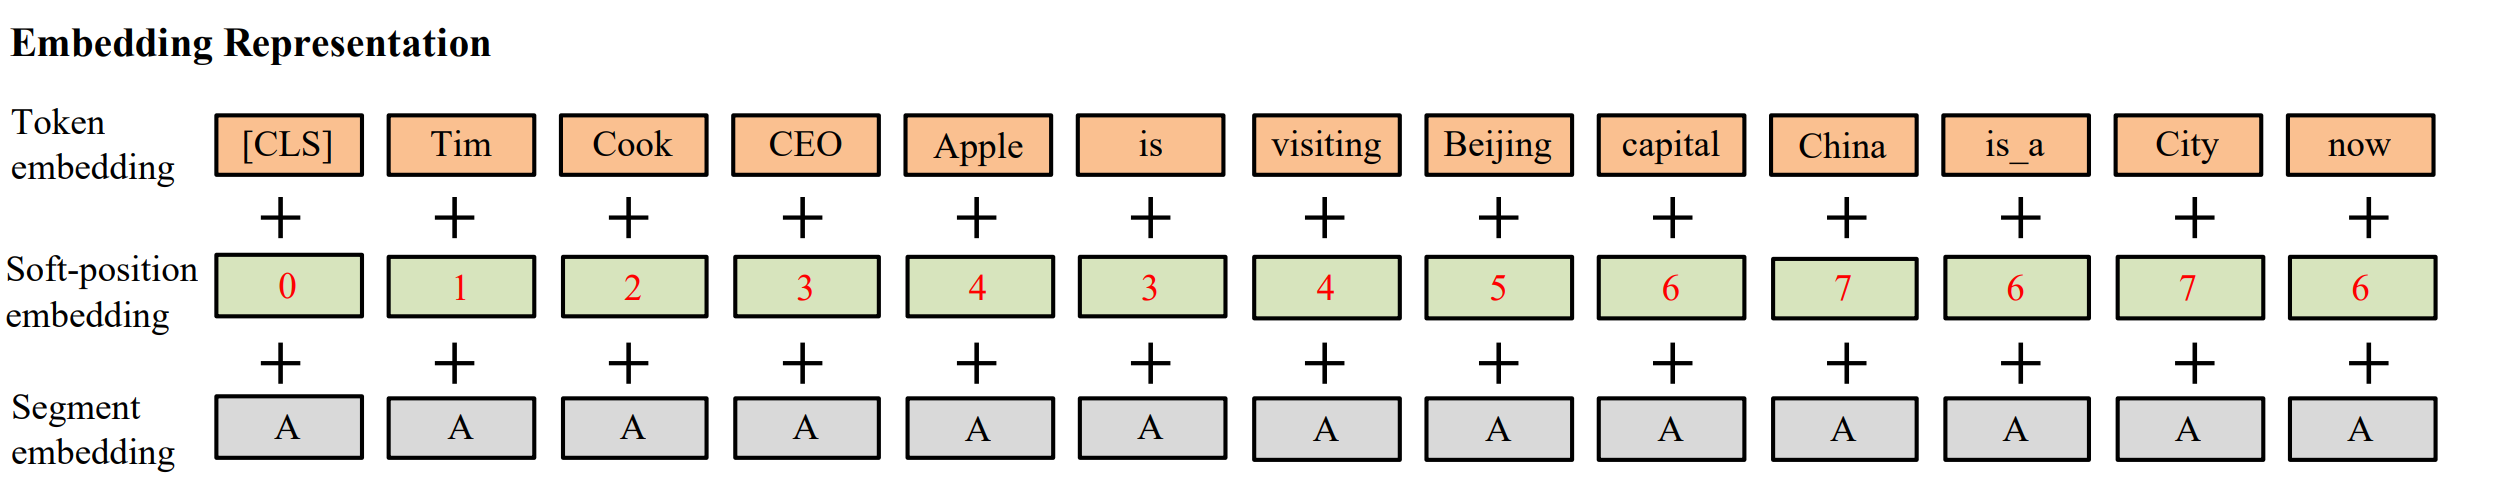
定位到知識後,在知識表徵上K-Bert沒有引入圖譜相關的預訓練知識表徵,而是選擇把三元組資訊和原始token一同輸入模型,使用相同的token embedding來進行語義表徵。所以需要對以上的句子樹進行展開,展開的順序是按照原始句子遍歷,如果碰到分支就把分支的token加入,然後繼續遍歷原始句子,展開後的句子如下。輸入和BERT相同是token+position+segment embedding
Seeing Layer & position Encoding
不過以上的知識表徵方式存在一個問題,就是對句子樹進行展開時,人為引入了噪音,主要包括3個方面
- 因為知識的插入,人為改變了原始句子中token間的距離
- 插入知識後的句子並不符合常規的文本表達
- 引入的知識和其他知識以及其他與文本交互時會引入噪音,例如Apple和China不應該存在顯示的交互
針對這些問題,作者提出了Soft—PE和Soft-MASK的實現。核心就是讓原始token的PE保持不變,原始token之間的交互不變,每個token只和自己的知識進行交互。
Soft-PE就是保持原始句子的位置編碼不變,對於插入的知識會從實體的位置開始向後順延,於是會存在重複的PE,例如is在原始句子中的位置id是3,CEO對應的實體是TimCook位置是2,順延後位置id也是3,他們的位置編碼就是相同的,這樣就解決了以上的問題1
Soft-Mask就是通過掩碼對知識部分進行隔離,CEO Apple只和Tim Cook進行交互,不和其他token進行交互,保證知識的引入只是為當前實體提供補充資訊,不會干擾整體上下文語義,也不會和其他token交互引入噪音,這樣就解決了以上的問題2和3
作者也通過消融實驗證明了,如果不使用Soft-MASK和Soft-PE, k-bert的效果會顯著低於原始BERT。

訓練
K-Bert只在下游任務微調中使用了KG,核心問題在於如果在預訓練中加入KG,因為知識表徵中使用了和原始文本相同的詞向量,所以會導致實體三元組中兩個實體的文本表徵變得變得高度相似,導致語義資訊損失。所以K-Bert只在微調中引入了實體三元組資訊。
效果上,醫療領域KG對醫療NER的效果提升最明顯,通用知識KG對與金融和法律的NER有部分提升,對推理類任務有微小提升,情感分類任務因為和知識關係不大所以效果有限~
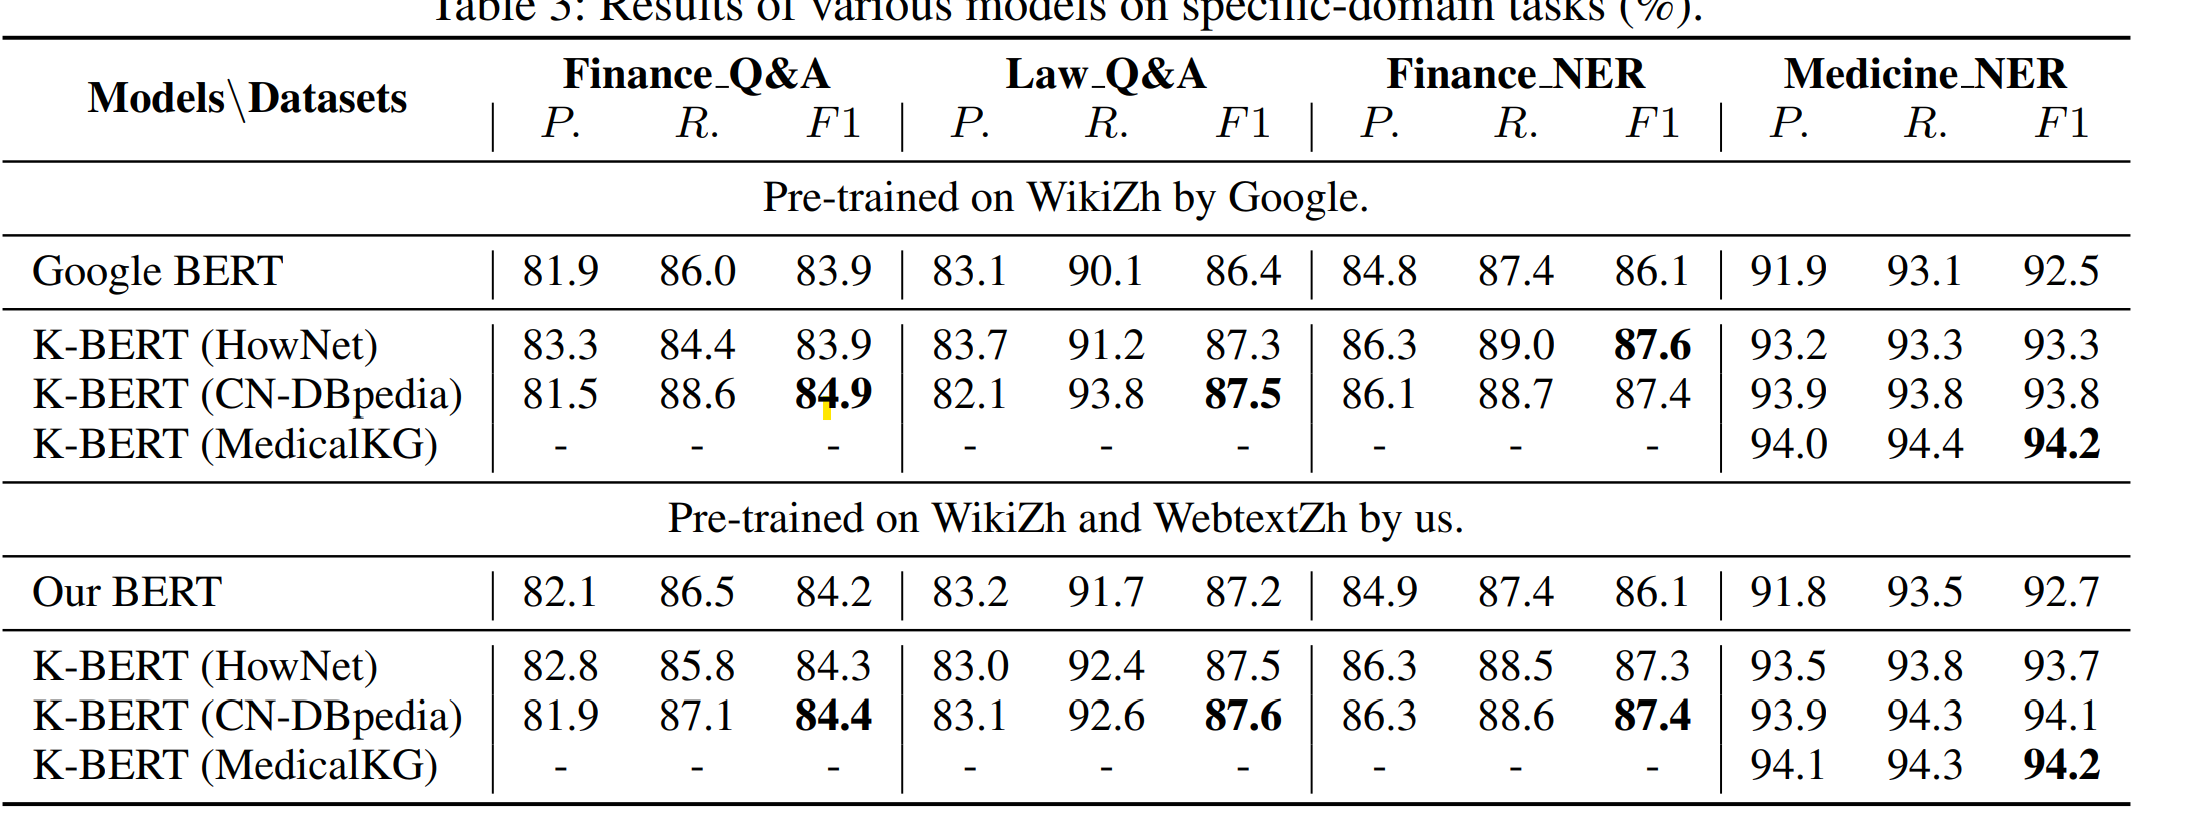
K-BERT只在微調中引入KG的好處是遷移到不同領域的成本較低,幾個能想到的討論點有
- 微調中引入知識,微調的樣本量和擬合目標一定程度限制了KG的融合效果
- Soft-MASK矩陣的構造成本較高,batch中的每個句子都需要獨立構造掩碼矩陣
- 復用文本token來表徵知識資訊,雖然解決了知識表徵和文本表徵不一致的問題,但是只引入實體三元組資訊,會丟失掉KG中更豐富的關聯資訊
Reference
