架構與思維:互聯網高性能Web架構
- 2022 年 8 月 17 日
- 筆記
- 高性能, 高可用, 系統架構設計, 架構與思維, 設計模式相關, High Concurrency, High Availability
1 什麼是高性能Web架構
在互聯網業務中,我們經常會面臨流量巨大的複雜的分散式場景。這就要求我們在設計系統的時候保證系統具有承載高並發(High Concurrency)的能力,同時能夠保證系統的高可用性(High Availability)。
所以,具備高性能Web架構通常是指,通過穩健的系統設計能力,來保證系統能夠同時處理複雜的業務場景,並保證性能、穩定性、可用性的架構體系。。
高性能Web常用的一些衡量指標有響應時間(Response Time),吞吐量(Throughput),每秒請求數QPS(Query Per Second),並發用戶數等。
響應時間(RT) 響應時間是指系統對請求作出響應的時間,如一個請求從發送request到response的時間是500ms,這就是請求的響應時間。
吞吐量(Throughput) 吞吐量是指系統在單位時間內處理請求的數量。
並發用戶數 並發數是指系統同時能處理的請求數量,這個也是反映了系統的負載能力。
與吞吐量相比,並發用戶數是一個更直觀但也更籠統的性能指標。實際上,並發用戶數是一個非常不準確的指標,因為用戶不同的使用模式會導致不同用戶在單位時間發出不同數量的請求。
QPS每秒查詢率(Query Per Second) 每秒查詢率QPS是對一個特定的查詢伺服器在規定時間內所處理流量多少的衡量標準
TPS每秒事務數(Transactions Per Second) 是吞吐量的常用量化指標
2 如何提升系統的性能指標
在互聯網分散式架構設計,我們常常用兩種方式來提高系統的性能,一種是橫向擴展(Scale Out),一種是縱向擴展(Scale Up)。對於橫向縱向擴張我們在 微服務系列、MySQL系列、Redis系列 中已經多次 討論過了。
縱向擴展主要提高單機的性能,讓其算力不斷提升。橫向擴展就是典型的分治思維,單機的記憶體、CPU、連接數、吞吐量始終是有限的,多實例化的集群支撐才是解決大型分散式場景的保障。
2.1 縱向擴展(Scale Up): 提升單機算力
1、單機硬體水平提升,如 CPU(多執行緒計算服務消耗大)、記憶體(快取等)、GPU(音影片、直播類)、SSD磁碟(數據存儲等),升級到更高的配置;
2、提升單機架構性能,很多時候不是伺服器硬體水平低,而是架構的不合理。如:
- 服務模組化分層不合理,導致調用互相影響,請求鏈路過長。
- 未合理地使用快取,導致系統計算時間過長,IO操作頻率過高。
- 存儲服務,如資料庫可優化空間大,如 索引使用不當,單表容量過大,單表欄位過多,查詢未優化等。
這些都是在架構設計的時候需要謹慎對待的。
但是正如上面說的,不論是單機硬體性能,還是單機架構性能,優化都有一個極限,互聯網分散式架構設計高並發終極解決方案還是橫向擴展。
2.2 橫向擴展(Scale Out):
典型的分治思維,單機的記憶體、SSD、CPU、GPU、連接、吞吐量始終是有限的,總不能無限制的擴展。所以我們需要追求橫向擴展,在架構的各個層面做水平擴容,增加實例數量,比如Services Cluster、Redis Cluster、MySQL Cluster,並在長期的業務實踐中不斷優化。
相對於Scale Up,他有哪些優勢:
- 理論上的性能無限擴充,單機的擴容總是有限制的,但是集群是可以持續擴張。bat大廠核心服務的成千上萬的服務集群就是很好的業內範例。
- 提高可用性,水平擴容最終會把計算能力和數據能力分攤在不同的實例、甚至不同的服務、甚至不同機房。某個分區出問題不會導致整個系統崩塌,這個單體系統是不能保障的,哪怕他硬體再牛。
3 業內常見的系統分層架構如下:

- Client: 包括Web瀏覽器、App應用、還有第三方請求。
- Reverse Proxy:流量的入口,提供 反向代理、負載均衡 等能力的支援
- Web Services: Web服務層,處理業務邏輯,直接面向用戶視覺,返回HTML頁面、文檔、Json資訊等
- Computing Services:提供計算能力,所有繁瑣的業務計算、數據存取、快取存取。
- Cache:快取層,主要消耗記憶體,提供高效率數據存取。
- Data:數據層,將數據持久化到硬碟。
如果要保證整個系統的高性能,那不是單純對快取層或數據層進行擴容的事情,就要求各層都可以水平擴展,下面我們一一來拆解下。
4 分層水平擴展架構實踐
4.1 Reverse Proxy 的Scale Out
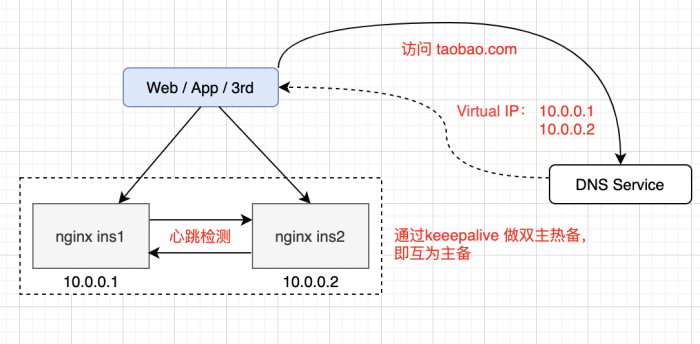
一般情況下,我們使用 Nginx 來實現 Load Balance(Random、Round Robin、Hash等),但是單台Nginx照樣存在宕機的風險。這時候我們就使用DNS 輪詢
在 Nginx 上層做反向代理,一般會在一個域名上配置多個IP解析。當我們訪問 DNS服務的時候,他會輪詢的返回IP。而我們增加Nginx實例的時候,同時也在DNS 服務上增配解析IP,這樣就達到理論上的無限擴容了。
如圖中,當我們有多個Nginx實例的時候,我們還可以配置keepalive做探活,以保證可用性。
4.2 Web Services 的 Scale Out
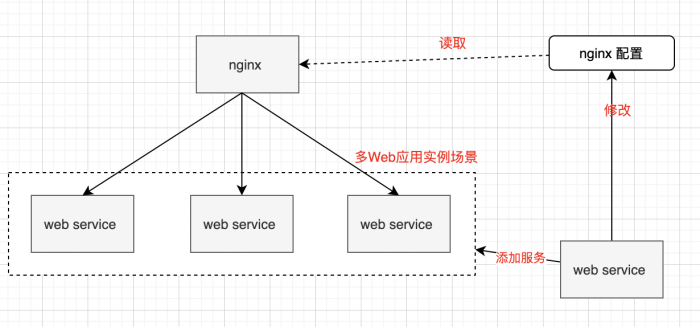
Web Services的上層是Nginx,他本身就是出色的負載均衡利器。當我們有多個服務實例的時候,只要在Nginx上conf文件上進行配置,就可以實現強大而穩定的負載了。而且對服務實例的新增和縮減,可以達到高效配置和快速擴縮的能力。Nginx可以調度足夠多的Web Services實例,實現互聯網系統高並發運行。
4.3 Computing Services 的 Scale Out
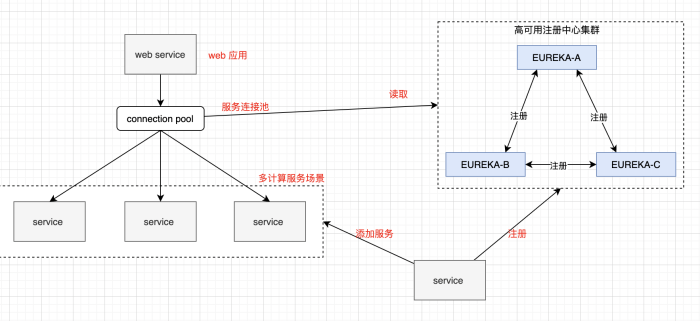
計算服務這一層的橫向擴展,可以使用 命名服務(Name Server)模式進行處理。比如我們建立一個高可用的服務註冊與發現中心。
Alive的計算服務實例都註冊到服務中心去,Web服務層則訂閱服務中心,獲取可用的計算服務,並執行調用。無論是使用Rest API調用,還是使用RPC調用,當你明顯發現計算服務無法支撐逐漸上升的流量的時候(比如用戶量暴漲、請求暴增),可以部署新的計算服務實例,並自動地註冊到服務中心。實現平滑的動態的計算服務擴容相當優雅。
另外,目前的服務間調用一般是去中心化的,會把訂閱到的註冊服務實例資訊保存在本地(比如 Web 服務 把 計算服務地址 列表保存在本地),哪怕服務中心掛了,短時間內,也不影響請求的正常運轉。
4.4 數據層 的 Scale Out
這個算老生長談了,我們在 MySQL系列 和 Redis系列 中中已經不厭其煩的討論過 快取層 和 資料庫層水平擴容的方式了。
在互聯網高速發展的今天,巨量的數據已經覆蓋我們生活的每個角落,我們的衣食住行都是海量的數據進行支撐和管理。當我們的數據過於龐大的時候,一般會通過分庫分表,來將資料庫拆分到不同的實例,甚至伺服器上,來達到存儲層系統性能擴展的目的。
《MySQL分庫分表》中我們有詳細說拆分的原理和方式,以MySQL為例,
這邊我們再做一下整理。一般有以下三種拆分方式:
4.4.1 按照Range水平拆分

上面的示例,使用了範圍RANGE函數對崗位編號進行分區,共分為3個分區,
崗位編號為1 ~ 25w 的對應在分區P0中,25w+1 ~ 50w 編號在分區P1中,依次類推即可,類別編號大於 50w的數據統一存放在分區P3中即可。
這種模式的優勢是:
- 判斷簡單,只要對值進行判斷一下,就能找到對應的存儲分區;
- 區間自定義的情況下,可以比較均勻的分布數據。
- 擴展簡單,當超過50w的數據比較多的時候,可以再加一個 id(50w,75w) 的分區。
- 可能存在的問題就是,各Range之間的請求壓力可能不均衡,比如訪問頻率最高的用戶數據可能都落在第2區間。
4.4.2 按照HASH水平拆分
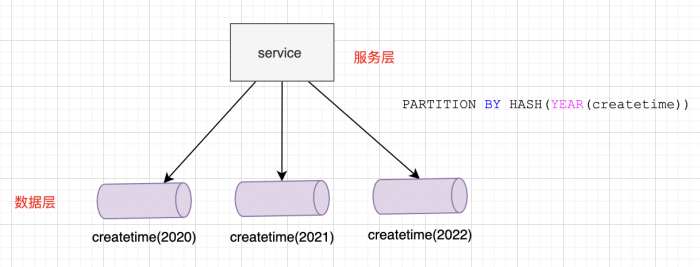
上面的例子,使用HASH函數對createtime日期進行HASH運算,並根據這個日期來分區數據,這裡按照 年 為單位共分為3個分區。
建表語句上添加一個「PARTITION BY HASH (expr)」子句,其中「expr」是一個返回整數的表達式,它可以是欄位類型為MySQL 整型的一列的名字,也可以是返回非負數的表達式。
這種模式的優勢是:
- 同樣的,判斷簡單,只要對相應欄位進行hash計算一下就可以了。
- 大部分情況下,數據分布也比較均勻,請求分布都可以比較均勻。比如你使用日期、性別等來hash,得到的結果一般是比較均衡的。
- 缺點是:擴展性不佳,擴增一個數據實例,或者hash屬性對應改變的時候,意味著你的數據所屬區要重新劃定,數據遷移是個不可缺少的成本。
4.4.3 按照LIST(預定義列表)拆分
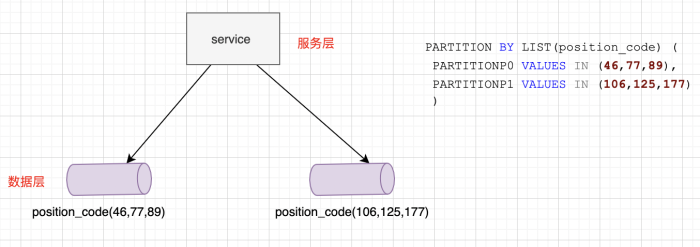
上面的例子,使用了列表匹配LIST函數對位置編號進行分區,共分為2個分區,編號為46,77,89的對應在分區P0中,106,125,177類別在分區P1中。
不同於RANGE的是,LIST分區的數據必須匹配列表中的崗位編號才能進行分區,所以這種方式只是適合比較區間值確定並少量的情況。
不管是哪種模式,我們通過水平擴展,將數據分攤到不同的實例甚至伺服器上,以此提升了資料庫單實例的性能和穩定性。
5 總結
在大型互聯網分散式系統的架構設計中,High Concurrency (高性能)、High Availability(高可用) 是構成的關鍵因素,我們通過精妙的設計,來保證系統能夠同時並行處理足夠多的請求、能夠提高穩定持久服務的時間(n個9)、能夠大幅降低事務處理時間。
提高系統並發能力的方式,方法論上主要有兩種:垂直擴展(Scale Up)與水平擴展(Scale Out)。
Scale Up 是指單機硬體水平提升,如 CPU(多執行緒計算服務消耗大)、記憶體(快取等)、GPU(音影片、直播類)、SSD磁碟(數據存儲等),升級到更高的配置,來提高並發性和可用性,但單機性能終歸是有限的,不可能無限擴展。
在我們上面的討論中,我們通過對各層逐層的水平擴容來實踐互聯網系統保持高性能高可用性的可能性。
- Reverse Proxy 通過 DNS輪詢 的方式實現IP解析的增配,以保證快速的擴容。
- nginx 通過配置conf 實現對上游 Web Services 的擴容和負載均衡。
- Computing Services 通過服務註冊中心實現新增服務實例的自動發現,保證水平擴容的高效和穩定。
- 數據層可以使用 資料庫分區 來實現水平擴展。