【python基礎】第19回 多層,有參裝飾器 遞歸 二分法
- 2022 年 7 月 6 日
- 筆記
本章內容概要
1. 多層裝飾器
2. 有參裝飾器
3. 遞歸函數
4. 演算法(二分法)
本章內容詳解
1. 多層裝飾器
1.1 什麼是多層裝飾器
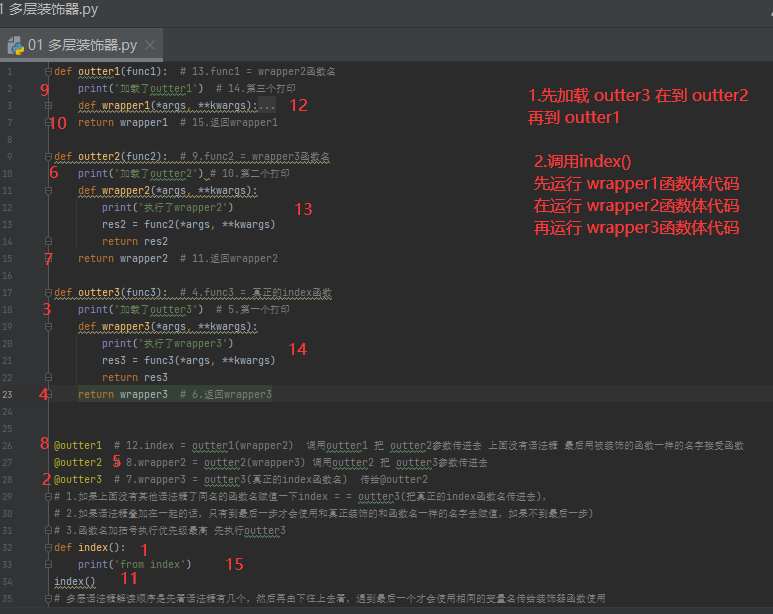
多層裝飾器是從下往上依次執行,需要注意的是,被裝飾的函數名所指代的函數是一直被裝飾器中的內層函數所取代。
1.2 語法糖的功能
會自動將下面緊挨著的函數名當做參數傳遞給@符號2後面的函數名(加括弧調用)
1.3 程式碼講解
def outter1(func1):  # 13.func1 = wrapper2函數名
    print('載入了outter1')  # 14.第三個列印
    def wrapper1(*args, **kwargs):
        print('執行了wrapper1')
        res1 = func1(*args, **kwargs)
        return res1
    return wrapper1  # 15.返回wrapper1

def outter2(func2):  # 9.func2 = wrapper3函數名
    print('載入了outter2') # 10.第二個列印
    def wrapper2(*args, **kwargs):
        print('執行了wrapper2')
        res2 = func2(*args, **kwargs)
        return res2
    return wrapper2  # 11.返回wrapper2

def outter3(func3):  # 4.func3 = 真正的index函數
    print('載入了outter3')  # 5.第一個列印
    def wrapper3(*args, **kwargs):
        print('執行了wrapper3')
        res3 = func3(*args, **kwargs)
        return res3
    return wrapper3  # 6.返回wrapper3


@outter1  # 12.index = outter1(wrapper2)  調用outter1 把 outter2參數傳進去 上面沒有語法糖 最後用被裝飾的函數一樣的名字接受函數
@outter2  # 8.wrapper2 = outter2(wrapper3) 調用outter2 把 outter3參數傳進去
@outter3  # 7.wrapper3 = outter3(真正的index函數名)  傳給@outter2
# 1.如果上面沒有其他語法糖了同名的函數名賦值一下index = = outter3(把真正的index函數名傳進去),
# 2.如果語法糖疊加在一起的話,只有到最後一步才會使用和真正裝飾的和函數名一樣的名字去賦值,如果不到最後一步)
# 3.函數名加括弧執行優先順序最高 先執行outter3
def index():
    print('from index')
index()
# 多層語法糖解讀順序是先看語法糖有幾個,然後再由下往上去看,遇到最後一個才會使用相同的變數名傳給裝飾器函數使用
# 語法糖三:wrapper3 = outter3(index),載入了outter3
# 語法糖二:wrapper2 = outter2(wrapper3),載入了outter2
# 語法糖一;index = outter1(wrapper2),載入了outter1
# 執行順序就是:wrapper1>>>>>wrapper2>>>>>wrapper3
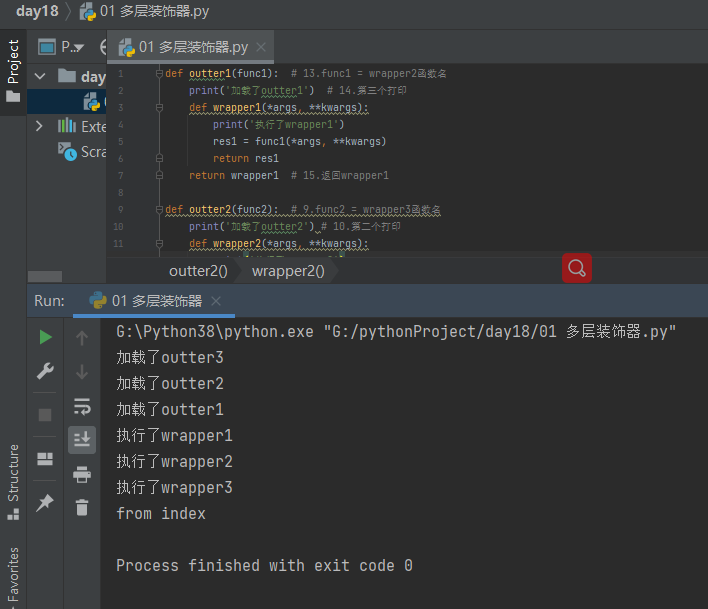
# 載入outer3>>>載入outer2>>>載入outer1>>>index()>>>運行wrapper1函數體程式碼>>>然後再執行outer2函數體程式碼>>>然後再執行wrapper3的函數體程式碼
2. 有參裝飾器
2.1 什麼是有參裝飾器
是為裝飾器提供多樣功能選擇的實現提供的,實現原理是三層閉包
2.2 程式碼講解
初始程式碼
def login_auth(func_name):
    def inner(*args, **kwargs):
        username = input('username>>>:').strip()
        password = input('password>>>:').strip()
        if username == 'jason' and password == '123':
            res = func_name(*args, **kwargs)
            return res
        else:
            print('用戶許可權不夠 無法調用函數')
    return inner
實現:在裝飾器內部可以切換多種數據來源 ,如 列表 ,字典 ,文檔
def outer(condition,type_user):
    def login_auth(func_name):  # 這裡不能再填寫其他形參
        def inner(*args, **kwargs):  # 這裡不能再填寫非被裝飾對象所需的參數
            username = input('username>>>:').strip()
            password = input('password>>>:').strip()
            # 應該根據用戶的需求執行不同的程式碼
            if type_user =='jason':print('VIP')
            if condition == '列表':
                print('使用列表作為數據來源 比對用戶數據')
            elif condition == '字典':
                print('使用字典作為數據來源 比對用戶數據')
            elif condition == '文件':
                print('使用文件作為數據來源 比對用戶數據')
            else:
                print('去你妹的 我目前只有上面幾種方式')
        return inner
    return login_auth
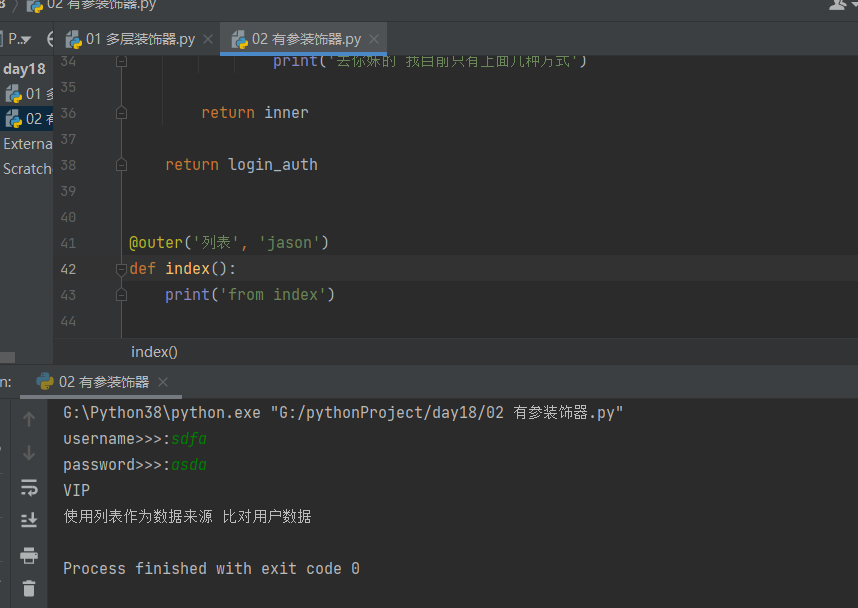
@outer('列表','jason')
def index():
    print('from index')
index()
3. 遞歸函數
3.1 什麼是遞歸函數
程式語言中,函數直接或間接調用函數本身,則該函數稱為遞歸函數。
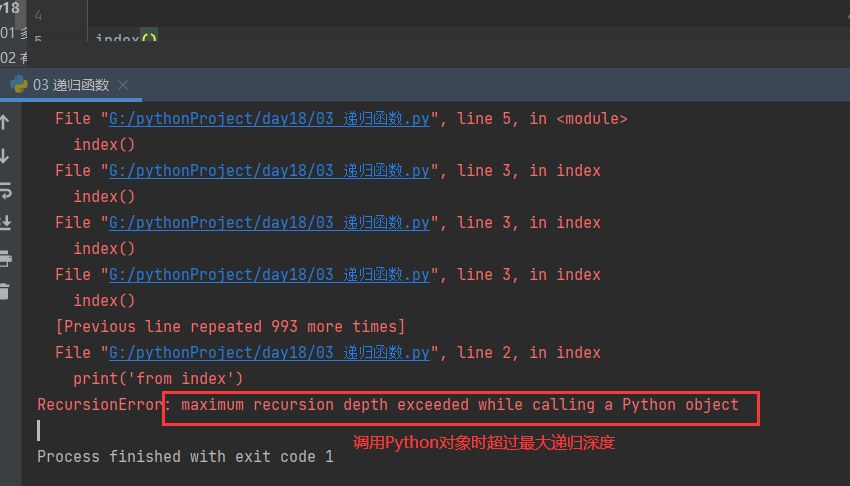
3.2 程式碼講解 遞歸調用:直接調用
def index():
    print('from index')
    index()

index()
有返回值
也會報錯,調用Python對象時超過最大遞歸深度
3.3 程式碼講解 遞歸調用:間接調用
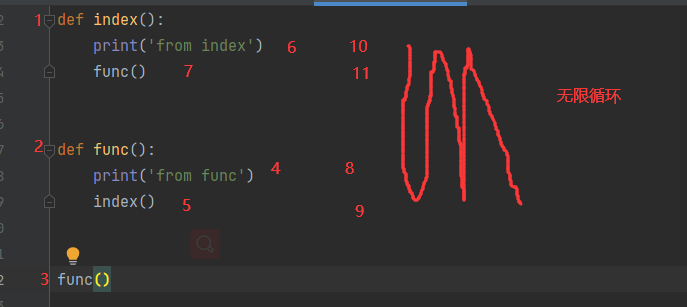
# 遞歸調用:間接調用
def index():
    print('from index')
    func()

def func():
    print('from func')
    index()

func()
有返回值
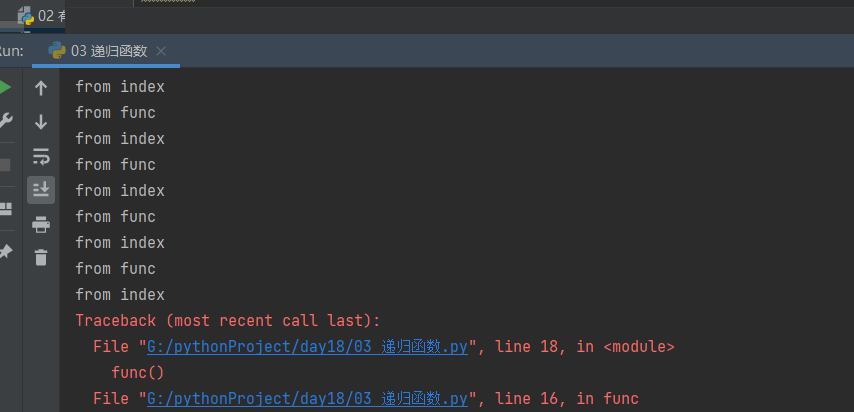
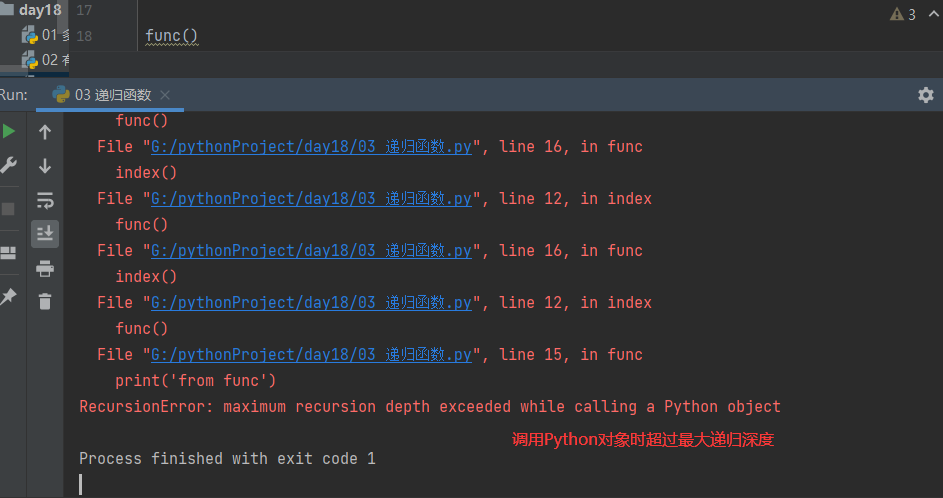
也會報錯,調用Python對象時超過最大遞歸深度
3.4 python 中允許函數最大遞歸調用的次數
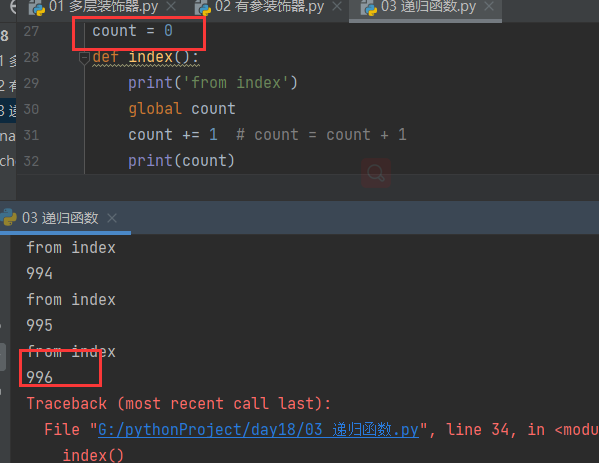
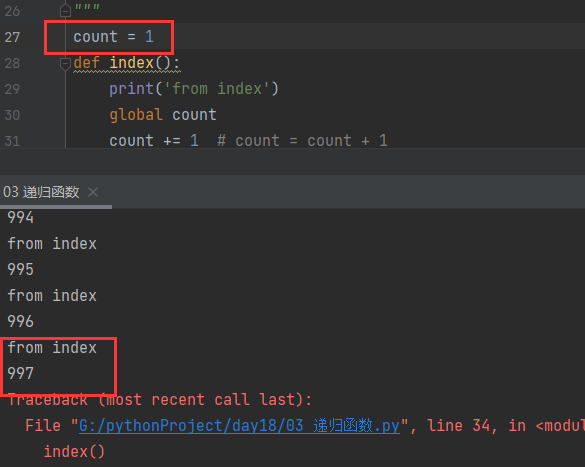
1. 官方給出的限制是1000 用程式碼去驗證可能會有些許偏差(997 998...)
count = 0  # count = 1
def index():
    print('from index')
    global count
    count += 1  # count = count + 1
    print(count)
    index()
index()
2. python 解釋器獲取遞歸最大次數
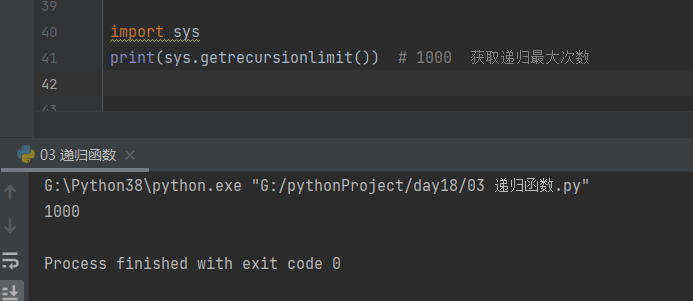
import sys
print(sys.getrecursionlimit())  # 1000  獲取遞歸最大次數
3. 自定義遞歸遞歸最大次數
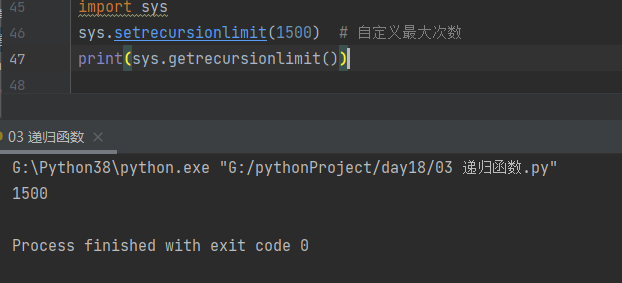
import sys
sys.setrecursionlimit(1500)  # 自定義最大次數
print(sys.getrecursionlimit())
3.4 遞歸函數真正的應用場景
1. 遞歸函數真正的應用場景
遞推:一層層往下尋找答案
回溯:根據已知條件推導最終結果
2. 遞歸函數
1.每次調用的時候都必須要比上一次簡單!
2.並且遞歸函數最終都必須要有一個明確的結束條件!
3. 講解 **空列表自動結束
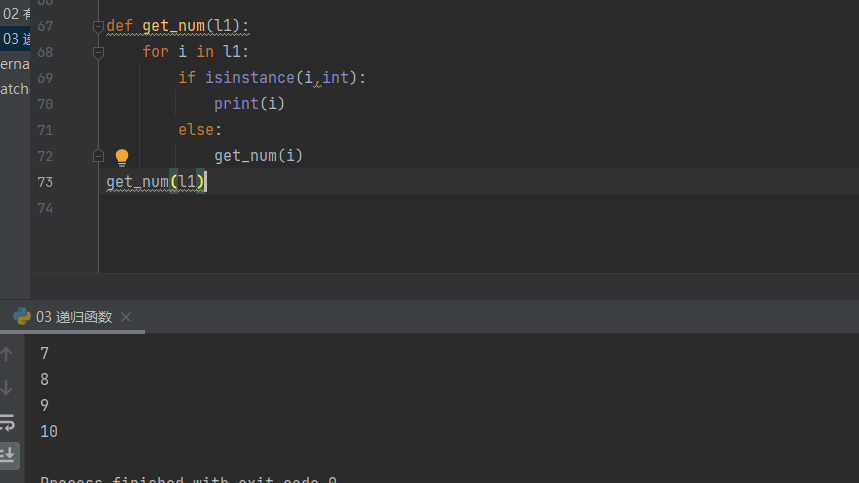
l1 = [1, [2, [3, [4, [5, [6, [7, [8, [9, [10, ]]]]]]]]]]
# 循環列印出列表中所有的數字
# 1.for循環l1裡面所有的數據值
# 2.判斷當前數據值是否是數字 如果是則列印
# 3.如果不是則繼續for循環裡面所有數據值
# 4.判斷當前數據值是否是數字 如果是則列印
# 5.如果不是則繼續for循環裡面所有數據值
# 6.判斷當前數據值是否是數字 如果是則列印

def get_num(l1):
    for i in l1:
        if isinstance(i,int):
            print(i)
        else:
            get_num(i)
get_num(l1)
4. 演算法(二分法)
4.1 什麼是演算法 演算法就是解決問題的方法
演算法(Algorithm)是指解題方案的準確而完整的描述,是一系列解決問題的清晰指令,演算法代表著用系統的方法描述解決問題的策略機制。也就是說,能夠對一定規範的輸入,在有限時間內獲得所要求的輸出。如果一個演算法有缺陷,或不適合於某個問題,執行這個演算法將不會解決這個問題。不同的演算法可能用不同的時間,空間或效率來完成同樣的任務。一個演算法的優劣可以用空間複雜度與時間複雜度來衡量。
二分法 快拍 插入 堆排 鏈表 雙向鏈表 約瑟夫問題
4.2 什麼是二分法
二分法是所有演算法裡面最簡單的演算法,是一種非常高效的演算法,它常常用於電腦的查找過程中
4.3 二分法場景應用程式碼講解
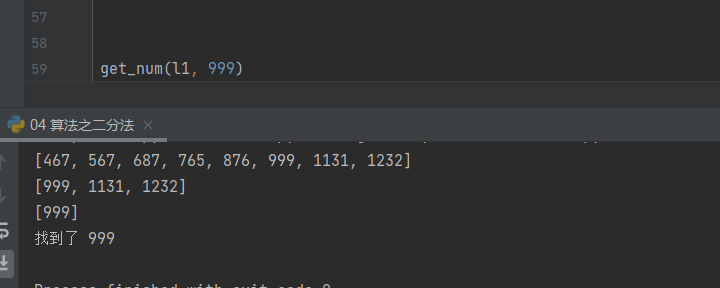
在列表l1中,找到999,該列表無限長,簡潔的取少部分
l1 = [11, 23, 32, 45, 65, 78, 90, 123, 432, 467, 567, 687, 765, 876, 999, 1131, 1232]


def get_num(l1, target_num):
    # 添加遞歸函數的結束條件
    if len(l1) == 0:
        print('不好意思 找不到')
        return
    # 1.先獲取數據集中間那個數
    middle_index = len(l1) // 2
    middle_value = l1[middle_index]
    # 2.判斷中間的數據值與目標數據值孰大孰小
    if target_num > middle_value:
        # 3.說明要查找的數在數據集右半邊  如何截取右半邊
        right_l1 = l1[middle_index + 1:]
        # 3.1.獲取右半邊中間那個數
        # 3.2.與目標數據值對比
        # 3.3.根據大小切割數據集
        # 經過分析得知 應該使用遞歸函數
        print(right_l1)
        get_num(right_l1, target_num)
    elif target_num < middle_value:
        # 4.說明要查找的數在數據集左半邊  如何截取左半邊
        left_l1 = l1[:middle_index]
        # 4.1.獲取左半邊中間那個數
        # 4.2.與目標數據值對比
        # 4.3.根據大小切割數據集
        # 經過分析得知 應該使用遞歸函數
        print(left_l1)
        get_num(left_l1, target_num)
    else:
        print('找到了', target_num)


get_num(l1, 999)
4.4 二分法的缺陷
1. 數據集必須是有序的
2. 查找的數如果在開頭或者結尾 那麼二分法效率更低(for 循環)
作業
1.嘗試編寫有參函數將多種用戶驗證方式整合到其中
直接獲取用戶數據比對
數據來源於列表 數據來源於文件
2.嘗試編寫遞歸函數
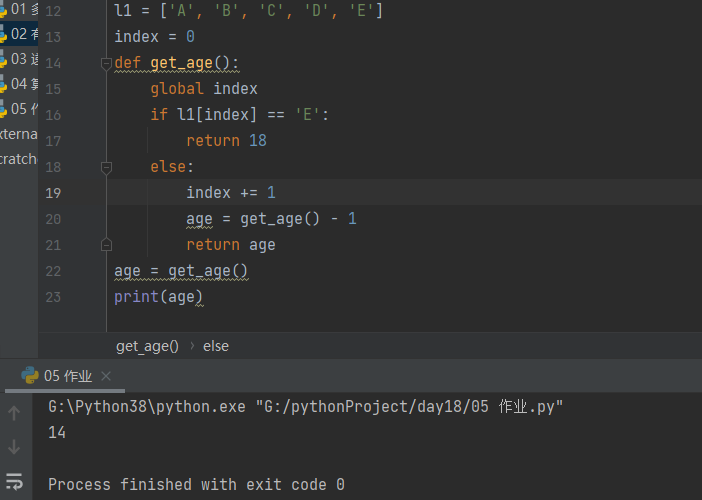
推導指定某個人的正確年齡
eg: A B C D E 已知E是18 求A是多少
l1 = ['A', 'B', 'C', 'D', 'E']
index = 0
def get_age():
    global index
    if l1[index] == 'E':
        return 18
    else:
        index += 1
        age = get_age() - 1
        return age
age = get_age()
print(age)
3.自行查閱資料 提前收集常見演算法快排 插入 冒泡等
3.1 快排
快排 全名 快速排序演算法
快速排序(QuickSort)是對冒泡排序的一種改進。快速排序由C. A. R. Hoare在1962年提出。
它的基本思想是:
1. 從要排序的數據中取一個數為「基準數」。
2. 通過一趟排序將要排序的數據分割成獨立的兩部分,其中左邊的數據都比「基準數」小,右邊的數據都比「基準數」大。
3. 然後再按步驟2對這兩部分數據分別進行快速排序,整個排序過程可以遞歸進行,以此達到整個數據變成有序序列。
該思想可以概括為:挖坑填數 + 分治法。分治法(分而治之)
3.2 插入
插入演算法是一種排序演算法
在運用插入演算法時一般將數據分為兩組,有序組和無序組,並且將數據的第一個元素默認為有序組,將無序組的元素一個一個按照某種排列方式插入到有序組中。
3.3 冒泡
冒泡演算法是一種經典的排序演算法,冒泡,顧名思義就是輕(小)的往上冒,重(大)的往下沉,也稱雞尾酒演算法
解析首先我們需要確立兩層嵌套for循環,第一層for循環主要控制總體循環的趟數,第二層for循環主要是比對相鄰的兩個數,運用CAS(比較並替換)的思路將每一趟的第二層for循環執行完成
