從Hadder看蛋白質分子中的加氫演算法
技術背景
PDB(Protein Data Bank)是一種最常用於存儲蛋白質結構的文件。而我們在研究蛋白質構象時,往往更多的是考慮其骨架,因此在很多pdb文件中直接去掉了氫原子。但是在我們構建蛋白質力場時,又需要用到這些氫原子。因此這個流程就變成了,在預測蛋白質構象時,不考慮氫原子,然後在力場構建的步驟去添加氫原子。由於氫原子的位置相對其連接的重原子來說,是相對比較固定的,而且最低能量位置也比較容易找到。因此常見的策略是,先在大致合理的位置補充上氫原子,再通過能量優化演算法去優化氫原子的位置,使其處於一個更加合理的最終位置。而我們得到了這個氫原子的最終位置和重原子的位置之後,就可以對該蛋白質進行分子動力學的演化。本文主要介紹上述提到的,為蛋白質分子在大致合理的位置添加氫原子的演算法。
效果預覽
這裡我們先看下加氫前後的效果,使用的工具是開源的輕量級加氫軟體Hadder和分子動力學模擬常用的可視化軟體VMD。在加氫之前,蛋白質的結構如下圖所示:
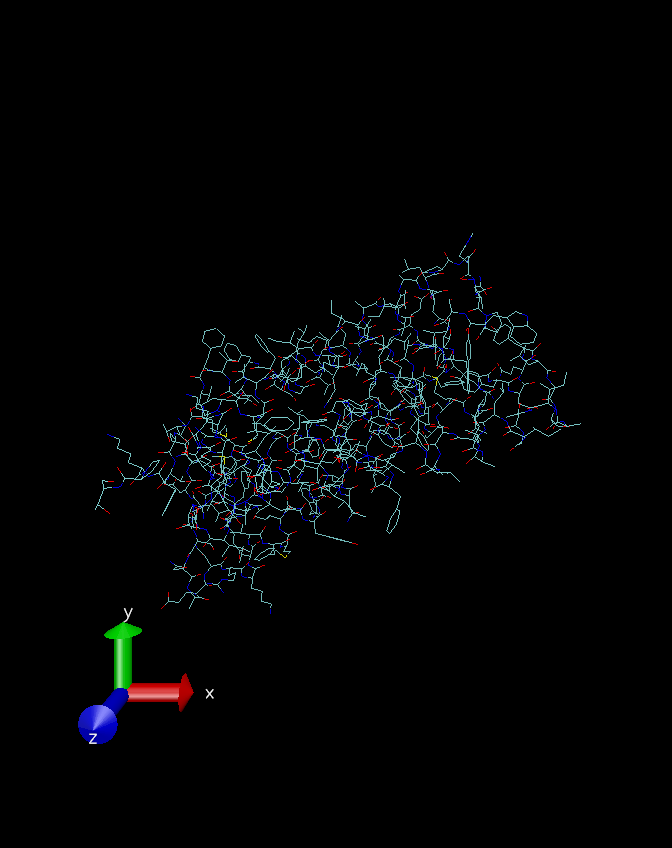
這是線條模型展示的結構,一般氫鍵用白色的線條來表示,可以看到上圖中並沒有白色的線條出現。其中有很多六邊形的結構,其實就是苯環。再看一下加完氫原子之後的線條模型:
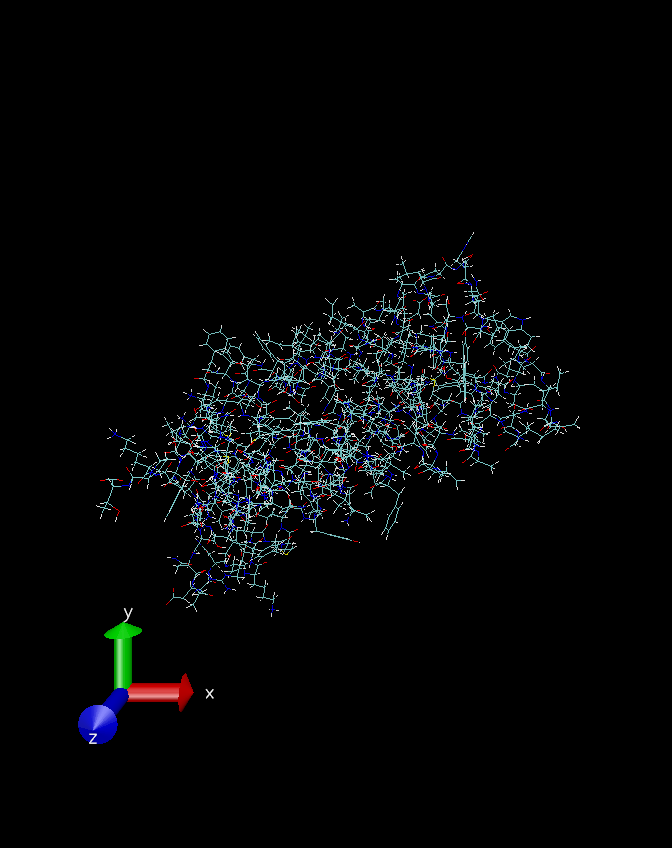
可以看到圖中多出來了很多白色的線條,也就是補完氫原子之後生成的氫鍵了。關於氫原子所加的位置是否合理,可以參考其中苯環上加的氫原子和常見的甲基上添加的氫原子。
加氫演算法
我們首先看一下GROMACS中所使用的加氫演算法,大體上來說就是,將20種氨基酸中的氫原子所連接的重原子的拓撲結構枚舉出來,然後針對這每一種的拓撲結構去執行不同的加氫方案。
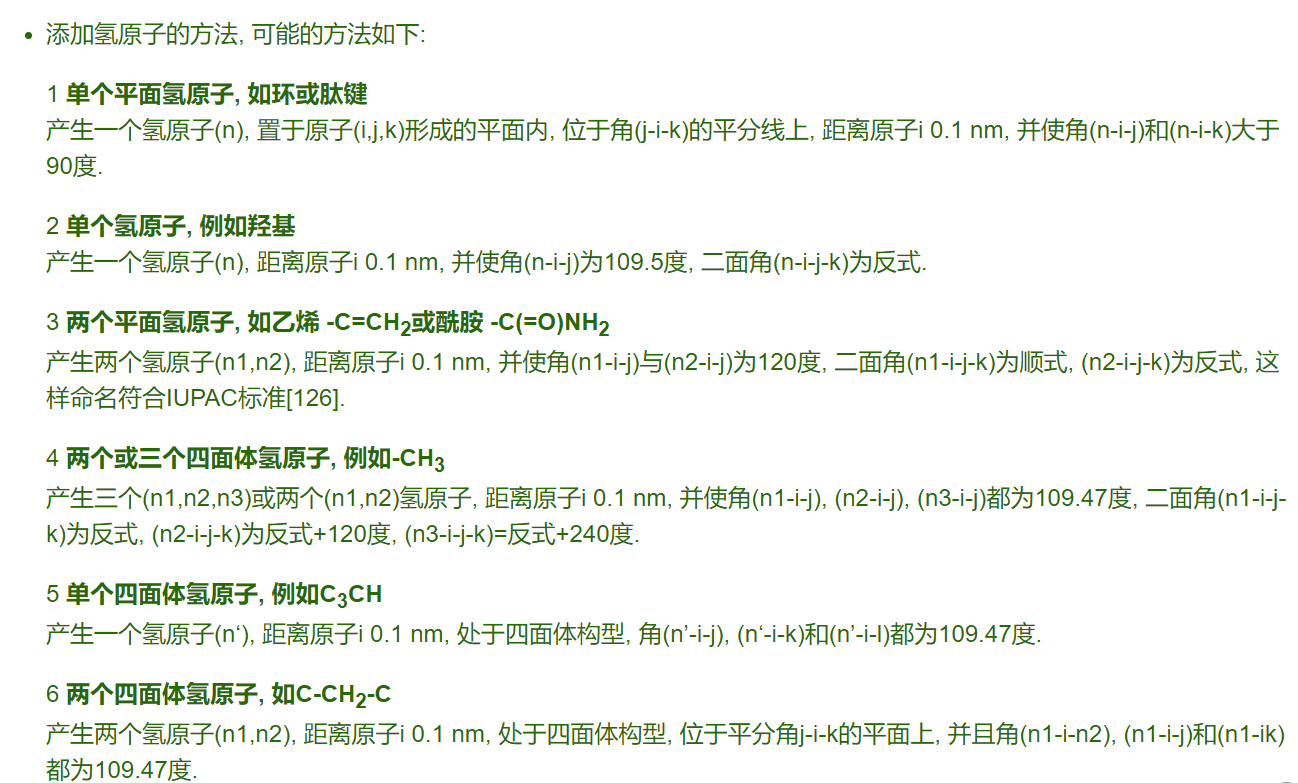
那麼,基於GROMACS的這個方案,我們對其進行了稍微的調整,也分成了以下6個不同的加氫方案來實施。需要說明的是,以下幾個加氫方案的前綴命名是筆者隨便取的,並不是什麼規範性的要求,在Hadder中就是用了以下幾種命名來作為演算法索引。
1. c6--環結構補氫
不論是五元環還是六元環,其加氫的方式就是在最近鄰三個點構成的平面的角平分線上,並且保障所加的氫原子與其所連接的重原子的距離為0.1nm。
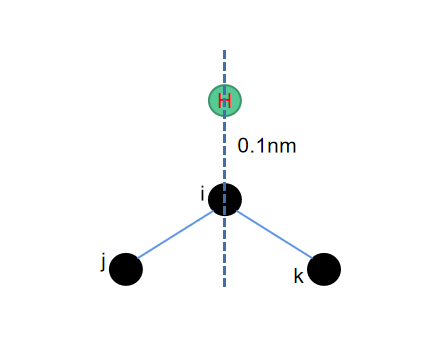
而這裡尋找角平分線的演算法也並不難,在python中只需要把\(\vec{ij}\)和\(\vec{ik}\)這兩個矢量歸一化之後,相加再取一個相反反向,再歸一化一次,就可以得到需要添加氫原子的位置了。需要注意的是,這裡長度單位使用的是埃而不是納米,因此找到長度為1埃的氫鍵即可。
if type == 'c6':
    left_arrow = crd[j] - crd[i]
    left_arrow /= np.linalg.norm(left_arrow)
    right_arrow = crd[k] - crd[i]
    right_arrow /= np.linalg.norm(right_arrow)
    h_arrow = -1 * (left_arrow + right_arrow)
    h_arrow /= np.linalg.norm(h_arrow)
2. dihedral--二面角補氫
在上一個環結構中氫原子所連接的重原子,同時與其他另外兩個原子相連接,而本章節中二面角形式的氫原子所連接的重原子,只與一個另外的重原子相連。同樣的我們需要保障補充的氫原子跟這三個重原子處在同一個平面內。然後保障二面角的中心旋轉對稱性,就可以找到需要添加氫原子的位置。
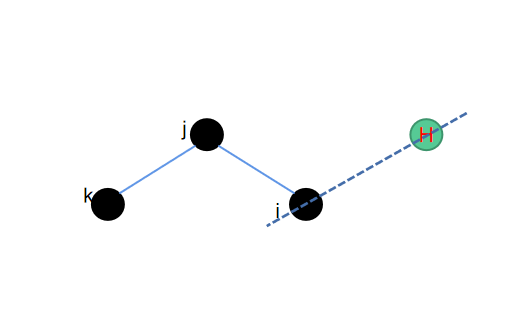
因為依然是在同一個平面內進行處理,因此也有比較簡單的操作可以實現,相應的python程式碼如下:
if type == 'dihedral':
    h_arrow = crd[j] - crd[k]
    h_arrow /= np.linalg.norm(h_arrow)
這裡使用的方法就是把向量\(\vec{jk}\)平移了一下,保持一樣的角度即可。跟GROMACS中的方法略有點不同的是,在這裡我們不追求一定達到109度的角度,更多的是使用系統本身自帶的向量來進行操作。當然,這樣實現的前提是,我們所得到的蛋白質的重原子結構,已經是一個相對比較合理的構象,否則按照本演算法實施也會出現一些問題。
3. c2h4--乙烯結構補氫
同樣的還是一個平面內的操作,類似於乙烯的結構,我們在得到i、j、k、l這4個位置的原子坐標之後就可以通過平移來得到需要補充的兩個氫原子的位置。
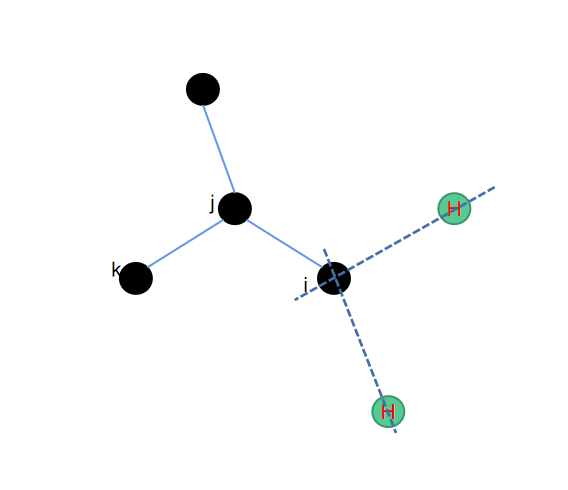
這裡為了跟其他幾種補氫的演算法保持輸入維度的一致,我們並沒有直接將4個重原子的位置作為輸入,而是取了其中的3個原子,再通過這3個原子的位置去推導氫原子的位置,相應python程式碼如下:
if type == 'c2h4':
    h_arrow_1 = crd[j] - crd[k]
    h1 = (h_arrow_1/np.linalg.norm(h_arrow_1) + crd[i])
    middle_arrow = (crd[i] - crd[j])
    middle_arrow /= np.linalg.norm(middle_arrow)
    middle_arrow *= np.linalg.norm(h_arrow_1)
    h_arrow_2 = -h_arrow_1 + middle_arrow
    h2 = (h_arrow_2/np.linalg.norm(h_arrow_2) + crd[i])
在具體演算法中,第一個氫的位置可以用跟上一個章節中二面角一樣的演算法推導出來,而第二個氫的位置,我們是假設這個乙烯結構中每一條邊的長度都大致相等,這樣根據等邊三角形的矢量閉環關係,可以推導出來第二個氫原子的位置。
4. ch3--正四面體補三氫
一個sp3雜化的碳原子可以連接其他的4個原子,而甲基\(-CH3\)是很常見的一種基團,我們需要在這個碳上面補3個氫原子。那麼此時除了碳原子的位置,和碳原子直接相連的一個原子的位置之外,我們還需要一個額外的原子,就是碳原子的次近鄰原子,這樣我們就有了三個原子可以去構造一個平面。
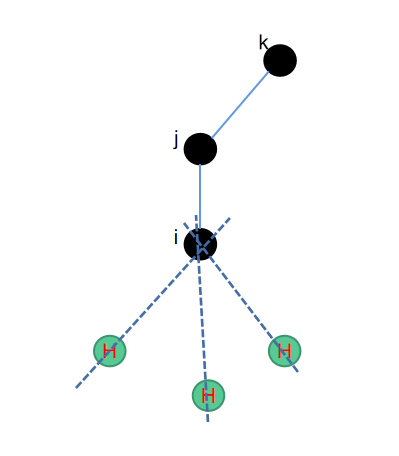
因為需要補氫的數量有3個,因此整體上演算法會相對複雜一些。首先,補第一個氫原子位置時,可以參考二面角的補法,直接補上一個氫原子。補第二個和第三個氫原子時,需要用到一個平移旋轉矩陣,其中又分為三個步驟:平移\(\vec{ij}\)到Z軸上->分別旋轉第一個補的氫120度和240度->平移回原始的位置。相關python程式碼如下所示:
if type == 'ch3':
    upper_arrow = crd[k] - crd[j]
    upper_arrow /= np.linalg.norm(upper_arrow)
    h1 = -upper_arrow + crd[i]
    axes = crd[j] - crd[i]
    rotate_matrix = rotate_by_axis(axes, 2 * np.pi / 3)
    h2 = np.dot(rotate_matrix, h1-crd[i])
    h2 /= np.linalg.norm(h2)
    h2 += crd[i]
    rotate_matrix = rotate_by_axis(axes, 4 * np.pi / 3)
    h3 = np.dot(rotate_matrix, h1-crd[i])
    h3 /= np.linalg.norm(h3)
    h3 += crd[i]
這裡還用到了一個旋轉矩陣,其形式為:
相應的python程式碼實現為:
def rotate_by_axis(axis, theta):
    """Rotate an atom by a given axis with angle theta.
    Args:
        axis: The rotate axis.
        theta: The rotate angle.
    Returns:
        The rotate matrix.
    """
    vx, vy, vz = axis[0], axis[1], axis[2]
    return np.array([[vx*vx*(1-np.cos(theta))+np.cos(theta),
                      vx*vy*(1-np.cos(theta))-vz*np.sin(theta),
                      vx*vz*(1-np.cos(theta))+vy*np.sin(theta)],
                     [vx*vy*(1-np.cos(theta))+vz*np.sin(theta),
                      vy*vy*(1-np.cos(theta))+np.cos(theta),
                      vy*vz*(1-np.cos(theta))-vx*np.sin(theta)],
                     [vx*vz*(1-np.cos(theta))-vy*np.sin(theta),
                      vy*vz*(1-np.cos(theta))+vx*np.sin(theta),
                      vz*vz*(1-np.cos(theta))+np.cos(theta)]])
類似的,這種演算法對於初始構象有要求,如果是一個無序混亂的原子系統,則是沒有辦法通過這種演算法來加氫的。
cc3--正四面體補一氫
還是sp3雜化的碳原子,但是此時該碳原子已經跟其他三個重原子成鍵,因此有一個多餘的鍵可以跟氫原子結合生成氫鍵。由於sp3雜化的特殊性,形成的結構會是一個接近於正四面體的形狀。此時同樣為了保持介面一致,我們選取包含sp3碳原子在內的一共3個原子,來定位氫原子的位置。
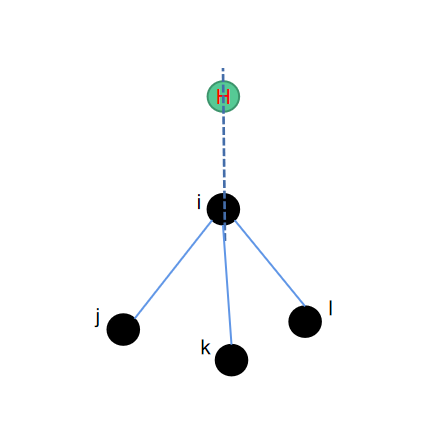
因為是一個正四面體,因此我們將\(\vec{ik}\)繞\(\vec{ij}\)逆時針旋轉120度,即可得到氫原子的位置。其中用到的旋轉矩陣可以參考上一個章節,對應的python程式碼實現如下:
if type == 'cc3':
    h1 = crd[k]
    upper_arrow = crd[j] - crd[i]
    rotate_matrix = rotate_by_axis(upper_arrow, 2 * np.pi / 3)
    h2 = np.dot(rotate_matrix, h1-crd[i])
    h2 /= np.linalg.norm(h2)
c2h2--正四面體補二氫
從正四面體補三氫和補一氫的演算法來看,我們還缺少一個補二氫的演算法。跟補一氫的原理一樣,也是找到三個重原子,然後對其中的一個鍵進行旋轉。一次旋轉120度,一次旋轉240度,就可以得到待補的兩個氫原子的位置。
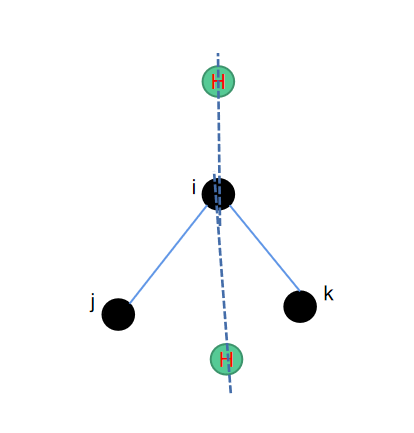
相應的python程式碼如下所示:
if type == 'c2h2':
    right_arrow = crd[k] - crd[i]
    rotate_matrix = rotate_by_axis(right_arrow, 2 * np.pi / 3)
    h1 = np.dot(rotate_matrix, crd[j]-crd[i])
    h2 = np.dot(rotate_matrix, h1)
    h1 /= np.linalg.norm(h1)
    h2 /= np.linalg.norm(h2)
當然,在實現的過程中,為了避免出現兩個不同的旋轉矩陣,這裡只定義了一個旋轉矩陣。旋轉一次120度之後,對生成的新的氫鍵再繞相同的軸旋轉120度,就可以得到第二個氫原子的位置。
Hadder的安裝與使用
上述的這些補氫的演算法,都已經實現在開源程式碼倉Hadder中,該程式碼都是基於python編寫,開源依賴只有一個numpy。採用了開放式的開源協議Apache License 2.0。目前已經支援了pip的安裝與管理,用戶可以使用如下安裝指令直接安裝獲取最新版本的hadder。
$ python3 -m pip install hadder --upgrade
因為只是為了給pdb補氫,因此軟體中實現了pdb讀取和寫入的方法,而對外開放的API也較為簡單,主要就是這樣的一個補氫介面:
from hadder import AddHydrogen
AddHydrogen('input.pdb', 'output.pdb')
這樣在python中定義好輸入和輸出的pdb文件路徑(建議使用絕對路徑),就可以獲得補完氫原子的結果。如果運行成功,軟體會有如下提示:
1 H-Adding task complete.
軟體運行的效果在前面的章節中已經展示過了,這裡再重複放兩張圖片:
分別對應的是加氫前與加氫後的結果。一個好的加氫位置,是至關重要的。如果一開始加氫的位置偏離較大,有可能導致體系能量異常的巨大,在計算梯度時會發生梯度爆炸的現象,也就無法正常的執行下一步的優化任務。
總結概要
本文主要介紹了開源加氫軟體Hadder中用到的一些常規的補氫演算法。在存儲和優化蛋白質結構的過程中,人們更多的關注於蛋白質本身的骨架的變化,而單個原子的細微變化,對整體產生的性質是微乎其微的。但是我們在建立力場以及做能量最小化的過程中,需要用到氫原子。而氫原子的初始位置是至關重要的,如果加的位置太差,有可能導致體系能量過大,從而出現梯度爆炸的問題。
版權聲明
本文首發鏈接為://www.cnblogs.com/dechinphy/p/hadder.html
作者ID:DechinPhy
更多原著文章請參考://www.cnblogs.com/dechinphy/
打賞專用鏈接://www.cnblogs.com/dechinphy/gallery/image/379634.html
騰訊雲專欄同步://cloud.tencent.com/developer/column/91958
CSDN同步鏈接://blog.csdn.net/baidu_37157624?spm=1008.2028.3001.5343
51CTO同步鏈接://blog.51cto.com/u_15561675
參考鏈接
- //jerkwin.github.io/GMX/GMXman-5/#564-氫資料庫
- //gitee.com/dechin/hadder/tree/master
- //www.cnblogs.com/singlex/p/3DPointRotate.html

