剖析 SPI 在 Spring 中的應用
vivo 互聯網伺服器團隊 - Ma Jian
一、概述
SPI(Service Provider Interface),是Java內置的一種服務提供發現機制,可以用來提高框架的擴展性,主要用於框架的開發中,比如Dubbo,不同框架中實現略有差異,但核心機制相同,而Java的SPI機制可以為介面尋找服務實現。SPI機制將服務的具體實現轉移到了程式外,為框架的擴展和解耦提供了極大的便利。
得益於SPI優秀的能力,為模組功能的動態擴展提供了很好的支撐。
本文會先簡單介紹Java內置的SPI和Dubbo中的SPI應用,重點介紹分析Spring中的SPI機制,對比Spring SPI和Java內置的SPI以及與 Dubbo SPI的異同。
二、Java SPI
Java內置的SPI通過java.util.ServiceLoader類解析classPath和jar包的META-INF/services/目錄 下的以介面全限定名命名的文件,並載入該文件中指定的介面實現類,以此完成調用。
2.1 Java SPI
先通過程式碼來了解下Java SPI的實現
① 創建服務提供介面
package jdk.spi;
// 介面
public interface DataBaseSPI {
    public void dataBaseOperation();
}
② 創建服務提供介面的實現類
- MysqlDataBaseSPIImpl
實現類1
package jdk.spi.impl;

import jdk.spi.DataBaseSPI;

public class MysqlDataBaseSPIImpl implements DataBaseSPI {

    @Override
    public void dataBaseOperation() {
        System.out.println("Operate Mysql database!!!");
    }
}
- OracleDataBaseSPIImpl
實現類2
package jdk.spi.impl;

import jdk.spi.DataBaseSPI;

public class OracleDataBaseSPIImpl implements DataBaseSPI {

    @Override
    public void dataBaseOperation() {
        System.out.println("Operate Oracle database!!!");
    }
}
③ 在項目META-INF/services/目錄下創建jdk.spi.DataBaseSPI文件
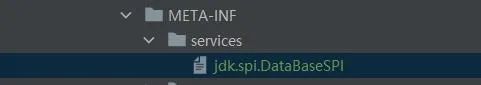
jdk.spi.DataBaseSPI
jdk.spi.impl.MysqlDataBaseSPIImpl
jdk.spi.impl.OracleDataBaseSPIImpl
④ 運行程式碼:
JdkSpiTest#main()
package jdk.spi;

import java.util.ServiceLoader;

public class JdkSpiTest {

    public static void main(String args[]){
        // 載入jdk.spi.DataBaseSPI文件中DataBaseSPI的實現類(懶載入)
        ServiceLoader<DataBaseSPI> dataBaseSpis = ServiceLoader.load(DataBaseSPI.class);
        // ServiceLoader實現了Iterable,故此處可以使用for循環遍歷載入到的實現類
        for(DataBaseSPI spi : dataBaseSpis){
            spi.dataBaseOperation();
        }
    }
}
⑤ 運行結果:
Operate Mysql database!!!
Operate Oracle database!!!
2.2 源碼分析
上述實現即為使用Java內置SPI實現的簡單示例,ServiceLoader是Java內置的用於查找服務提供介面的工具類,通過調用load()方法實現對服務提供介面的查找(嚴格意義上此步並未真正的開始查找,只做初始化),最後遍歷來逐個訪問服務提供介面的實現類。
上述訪問服務實現類的方式很不方便,如:無法直接使用某個服務,需要通過遍歷來訪問服務提供介面的各個實現,到此很多同學會有疑問:
- Java內置的訪問方式只能通過遍歷實現嗎?
- 服務提供介面必須放到META-INF/services/目錄下?是否可以放到其他目錄下?
在分析源碼之前先給出答案:兩個都是的;Java內置的SPI機制只能通過遍歷的方式訪問服務提供介面的實現類,而且服務提供介面的配置文件也只能放在META-INF/services/目錄下。
ServiceLoader部分源碼
public final class ServiceLoader<S> implements Iterable<S>{
    // 服務提供介面對應文件放置目錄
    private static final String PREFIX = "META-INF/services/";

    // The class or interface representing the service being loaded
    private final Class<S> service;

    // 類載入器
    private final ClassLoader loader;

    // The access control context taken when the ServiceLoader is created
    private final AccessControlContext acc;

    // 按照初始化順序快取服務提供介面實例
    private LinkedHashMap<String,S> providers = new LinkedHashMap<>();

    // 內部類,實現了Iterator介面
    private LazyIterator lookupIterator;
}
從源碼中可以發現:
- ServiceLoader類本身實現了Iterable介面並實現了其中的iterator方法,iterator方法的實現中調用了LazyIterator這個內部類中的方法,解析完服務提供介面文件後最終結果放在了Iterator中返回,並不支援服務提供介面實現類的直接訪問。
- 所有服務提供介面的對應文件都是放置在META-INF/services/目錄下,final類型決定了PREFIX目錄不可變更。
所以Java內置的SPI機制思想是非常好的,但其內置實現上的不足也很明顯。
三、Dubbo SPI
Dubbo SPI沿用了Java SPI的設計思想,但在實現上有了很大的改進,不僅可以直接訪問擴展類,而且在訪問的靈活性和擴展的便捷性都做了很大的提升。
3.1 基本概念
① 擴展點
一個Java介面,等同於服務提供介面,需用@SPI註解修飾。
② 擴展
擴展點的實現類。
③ 擴展類載入器:ExtensionLoader
類似於Java SPI的ServiceLoader,主要用來載入並實例化擴展類。一個擴展點對應一個擴展載入器。
④ Dubbo擴展文件載入路徑
Dubbo框架支援從以下三個路徑來載入擴展類:
- META-INF/dubbo/internal
- META-INF/dubbo
- META-INF/services
Dubbo框架針對三個不同路徑下的擴展配置文件對應三個策略類:
- DubboInternalLoadingStrategy
- DubboLoadingStrategy
- ServicesLoadingStrategy
三個路徑下的擴展配置文件並沒有特殊之處,一般情況下:
- META-INF/dubbo對開發者開放
- META-INF/dubbo/internal 用來載入Dubbo內部的擴展點
- META-INF/services 兼容Java SPI
⑤ 擴展配置文件
和Java SPI不同,Dubbo的擴展配置文件中擴展類都有一個名稱,便於在應用中引用它們。
如:Dubbo SPI擴展配置文件
#擴展實例名稱=擴展點實現類
adaptive=org.apache.dubbo.common.compiler.support.AdaptiveCompiler
jdk=org.apache.dubbo.common.compiler.support.JdkCompiler
javassist=org.apache.dubbo.common.compiler.support.JavassistCompiler
3.2 Dubbo SPI
先通過程式碼來演示下 Dubbo SPI 的實現。
① 創建擴展點(即服務提供介面)
擴展點
package dubbo.spi;

import org.apache.dubbo.common.extension.SPI;

@SPI  // 註解標記當前介面為擴展點
public interface DataBaseSPI {
    public void dataBaseOperation();
}
② 創建擴展點實現類
- MysqlDataBaseSPIImpl
擴展類1
package dubbo.spi.impl;

import dubbo.spi.DataBaseSPI;

public class MysqlDataBaseSPIImpl implements DataBaseSPI {

    @Override
    public void dataBaseOperation() {
        System.out.println("Dubbo SPI Operate Mysql database!!!");
    }
}
- OracleDataBaseSPIImpl
擴展類2
package dubbo.spi.impl;

import dubbo.spi.DataBaseSPI;

public class OracleDataBaseSPIImpl implements DataBaseSPI {

    @Override
    public void dataBaseOperation() {
        System.out.println("Dubbo SPI Operate Oracle database!!!");
    }
}
③在項目META-INF/dubbo/目錄下創建dubbo.spi.DataBaseSPI文件:
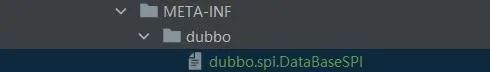
dubbo.spi.DataBaseSPI
#擴展實例名稱=擴展點實現類
mysql = dubbo.spi.impl.MysqlDataBaseSPIImpl
oracle = dubbo.spi.impl.OracleDataBaseSPIImpl
PS:文件內容中,等號左邊為該擴展類對應的擴展實例名稱,右邊為擴展類(內容格式為一行一個擴展類,多個擴展類分為多行)
④ 運行程式碼:
DubboSpiTest#main()
package dubbo.spi;

import org.apache.dubbo.common.extension.ExtensionLoader;

public class DubboSpiTest {

    public static void main(String args[]){
        // 使用擴展類載入器載入指定擴展的實現
        ExtensionLoader<DataBaseSPI> dataBaseSpis = ExtensionLoader.getExtensionLoader(DataBaseSPI.class);
        // 根據指定的名稱載入擴展實例(與dubbo.spi.DataBaseSPI中一致)
        DataBaseSPI spi = dataBaseSpis.getExtension("mysql");
        spi.dataBaseOperation();

        DataBaseSPI spi2 = dataBaseSpis.getExtension("oracle");
        spi2.dataBaseOperation();
    }
}
⑤ 運行結果:
Dubbo SPI Operate Mysql database!!!
Dubbo SPI Operate Oracle database!!!
從上面的程式碼實現直觀來看,Dubbo SPI在使用上和Java SPI比較類似,但也有差異。
相同:
- 擴展點即服務提供介面、擴展即服務提供介面實現類、擴展配置文件即services目錄下的配置文件 三者相同。
- 都是先創建載入器然後訪問具體的服務實現類,包括深層次的在初始化載入器時都未實時解析擴展配置文件來獲取擴展點實現,而是在使用時才正式解析並獲取擴展點實現(即懶載入)。
不同:
- 擴展點必須使用@SPI註解修飾(源碼中解析會對此做校驗)。
- Dubbo中擴展配置文件每個擴展(服務提供介面實現類)都指定了一個名稱。
- Dubbo SPI在獲取擴展類實例時直接通過擴展配置文件中指定的名稱獲取,而非Java SPI的循環遍歷,在使用上更靈活。
3.3 源碼分析
以上述的程式碼實現作為源碼分析入口,了解下Dubbo SPI是如何實現的。
ExtensionLoader
① 通過ExtensionLoader.getExtensionLoader(Classtype)創建對應擴展類型的擴展載入器。
ExtensionLoader#getExtensionLoader()
public static <T> ExtensionLoader<T> getExtensionLoader(Class<T> type) {
    if (type == null) {
        throw new IllegalArgumentException("Extension type == null");
    }
    // 校驗當前類型是否為介面
    if (!type.isInterface()) {
        throw new IllegalArgumentException("Extension type (" + type + ") is not an interface!");
    }
    // 介面上是否使用了@SPI註解
    if (!withExtensionAnnotation(type)) {
        throw new IllegalArgumentException("Extension type (" + type +
                ") is not an extension, because it is NOT annotated with @" + SPI.class.getSimpleName() + "!");
    }
    // 從記憶體中讀取該擴展點的擴展類載入器
    ExtensionLoader<T> loader = (ExtensionLoader<T>) EXTENSION_LOADERS.get(type);
    // 記憶體中不存在則直接new一個擴展
    if (loader == null) {
        EXTENSION_LOADERS.putIfAbsent(type, new ExtensionLoader<T>(type));
        loader = (ExtensionLoader<T>) EXTENSION_LOADERS.get(type);
    }
    return loader;
}
getExtensionLoader()方法中有三點比較重要的邏輯:
- 判斷當前type類型是否為介面類型。
- 當前擴展點是否使用了@SPI註解修飾。
- EXTENSION_LOADERS為ConcurrentMap類型的記憶體快取,記憶體中存在該類型的擴展載入器則直接使用,不存在就new一個並放入記憶體快取中。
再看下new ExtensionLoader(type)源碼
ExtensionLoader#ExtensionLoader()
// 私有構造器
private ExtensionLoader(Class<?> type) {
     this.type = type;
     // 創建ExtensionFactory自適應擴展
     objectFactory = (type == ExtensionFactory.class ? null : ExtensionLoader.getExtensionLoader(ExtensionFactory.class).getAdaptiveExtension());
 }
重點:構造方法為私有類型,即外部無法直接使用構造方法創建ExtensionLoader實例。
每次初始化ExtensionLoader實例都會初始化type和objectFactory ,type為擴展點類型;objectFactory 為ExtensionFactory類型。
② 使用getExtension()獲取指定名稱的擴展類實例getExtension為重載方法,分別為getExtension(String name)和getExtension(String name, boolean wrap),getExtension(String name)方法最終調用的還是getExtension(String name, boolean wrap)方法。
ExtensionLoader#getExtension()
public T getExtension(String name) {
     // 調用兩個參數的getExtension方法,默認true表示需要對擴展實例做包裝
     return getExtension(name, true);
 }

 public T getExtension(String name, boolean wrap) {
    if (StringUtils.isEmpty(name)) {
        throw new IllegalArgumentException("Extension name == null");
    }
    if ("true".equals(name)) {
        return getDefaultExtension();
    }
    // 獲取Holder實例,先從ConcurrentMap類型的記憶體快取中取,沒值會new一個並存放到記憶體快取中
    // Holder用來存放一個類型的值,這裡用於存放擴展實例
    final Holder<Object> holder = getOrCreateHolder(name);
    // 從Holder讀取該name對應的實例
    Object instance = holder.get();
    if (instance == null) {
       // 同步控制
       synchronized (holder) {
          instance = holder.get();
          // double check
          if (instance == null) {
             // 不存在擴展實例則解析擴展配置文件,實時創建
             instance = createExtension(name, wrap);
             holder.set(instance);
          }
        }
     }
     return (T) instance;
}
Holder類:這裡用來存放指定擴展實例
③ 使用createExtension()創建擴展實例
ExtensionLoader#createExtension()
// 部分createExtension程式碼
private T createExtension(String name, boolean wrap) {
   // 先調用getExtensionClasses()解析擴展配置文件,並生成記憶體快取,
   // 然後根據擴展實例名稱獲取對應的擴展類
   Class<?> clazz = getExtensionClasses().get(name);
   if (clazz == null) {
       throw findException(name);
   }
   try {
       // 根據擴展類生成實例並對實例做包裝(主要是進行依賴注入和初始化)
       // 優先從記憶體中獲取該class類型的實例
       T instance = (T) EXTENSION_INSTANCES.get(clazz);
       if (instance == null) {
           // 記憶體中不存在則直接初始化然後放到記憶體中
           EXTENSION_INSTANCES.putIfAbsent(clazz, clazz.newInstance());
           instance = (T) EXTENSION_INSTANCES.get(clazz);
       }
       // 主要是注入instance中的依賴
       injectExtension(instance);
       ......
}
createExtension()方法:創建擴展實例,方法中EXTENSION_INSTANCES為ConcurrentMap類型的記憶體快取,先從記憶體中取,記憶體中不存在重新創建;其中一個核心方法是getExtensionClasses():
ExtensionLoader#getExtensionClasses()
private Map<String, Class<?>> getExtensionClasses() {
   // 優先從記憶體快取中讀
    Map<String, Class<?>> classes = cachedClasses.get();
    if (classes == null) {
        // 採用同步手段解析配置文件
        synchronized (cachedClasses) {
            // double check
            classes = cachedClasses.get();
            if (classes == null) {
                // 正式開始解析配置文件
                classes = loadExtensionClasses();
                cachedClasses.set(classes);
            }
        }
    }
    return classes;
}
cachedClasses為Holder<map<string, class>>類型的記憶體快取,getExtensionClasses中會優先讀記憶體快取,記憶體中不存在則採用同步的方式解析配置文件,最終在loadExtensionClasses方法中解析配置文件,完成從擴展配置文件中讀出擴展類:
ExtensionLoader#loadExtensionClasses()
// 在getExtensionClasses方法中是以同步的方式調用,是執行緒安全
private Map<String, Class<?>> loadExtensionClasses() {
   // 快取默認擴展名稱
   cacheDefaultExtensionName();
   Map<String, Class<?>> extensionClasses = new HashMap<>();
   // strategies策略類集合,分別對應dubbo的三個配置文件目錄
   for (LoadingStrategy strategy : strategies) {
      loadDirectory(extensionClasses, strategy.directory(), type.getName(), strategy.preferExtensionClassLoader(), strategy.overridden(), strategy.excludedPackages());
      loadDirectory(extensionClasses, strategy.directory(), type.getName().replace("org.apache", "com.alibaba"), strategy.preferExtensionClassLoader(), strategy.overridden(),
           strategy.excludedPackages());
   }

   return extensionClasses;
}
源碼中的strategies即static volatile LoadingStrategy[] strategies數組,通過Java SPI從META-INF/services/目錄下載入配置文件完成初始化,默認包含三個類:
- DubboInternalLoadingStrategy
- DubboLoadingStrategy
- ServicesLoadingStrategy
分別對應dubbo的三個目錄:
- META-INF/dubbo/internal
- META-INF/dubbo
- META-INF/services
上述的源碼分析只是對Dubbo SPI做了簡要的介紹,Dubbo中對SPI的應用很廣泛,如:序列化組件、負載均衡等都應用了SPI技術,還有很多SPI功能未做分析,比如:自適應擴展、Activate活性擴展等 等,感興趣的同學可以更深入的研究。
四、Spring SPI
Spring SPI沿用了Java SPI的設計思想,但在實現上和Java SPI及Dubbo SPI也存在差異,Spring通過spring.handlers和spring.factories兩種方式實現SPI機制,可以在不修改Spring源碼的前提下,做到對Spring框架的擴展開發。
4.1 基本概念
- DefaultNamespaceHandlerResolver
類似於Java SPI的ServiceLoader,負責解析spring.handlers配置文件,生成namespaceUri和NamespaceHandler名稱的映射,並實例化NamespaceHandler。
- spring.handlers
自定義標籤配置文件;Spring在2.0時便引入了spring.handlers,通過配置spring.handlers文件實現自定義標籤並使用自定義標籤解析類進行解析實現動態擴,內容配置如:
http\://www.springframework.org/schema/c=org.springframework.beans.factory.xml.SimpleConstructorNamespaceHandler
http\://www.springframework.org/schema/p=org.springframework.beans.factory.xml.SimplePropertyNamespaceHandler
http\://www.springframework.org/schema/util=org.springframework.beans.factory.xml.UtilNamespaceHandler

spring.handlers實現的SPI是以namespaceUri作為key,NamespaceHandler作為value,建立映射關係,在解析標籤時通過namespaceUri獲取相應的NamespaceHandler來解析
- SpringFactoriesLoader
類似於Java SPI的ServiceLoader,負責解析spring.factories,並將指定介面的所有實現類實例化後返回。
- spring.factories
Spring在3.2時引入spring.factories,加強版的SPI配置文件,為Spring的SPI機制的實現提供支撐,內容配置如:
# PropertySource Loaders
org.springframework.boot.env.PropertySourceLoader=\
org.springframework.boot.env.PropertiesPropertySourceLoader,\
org.springframework.boot.env.YamlPropertySourceLoader

# Run Listeners
org.springframework.boot.SpringApplicationRunListener=\org.springframework.boot.context.event.EventPublishingRunListener

spring.factories實現的SPI是以介面的全限定名作為key,介面實現類作為value,多個實現類用逗號隔開,最終返回的結果是該介面所有實現類的實例集合
- 載入路徑
Java SPI從/META-INF/services目錄載入服務提供介面配置,而Spring默認從META-INF/spring.handlers和META-INF/spring.factories目錄載入配置,其中META-INF/spring.handlers的路徑可以通過創建實例時重新指定,而META-INF/spring.factories固定不可變。
4.2 spring.handlers
首先通過程式碼初步介紹下spring.handlers實現。
4.2.1 spring.handlers SPI
① 創建NameSpaceHandler
MysqlDataBaseHandler
package spring.spi.handlers;

import org.springframework.beans.factory.config.BeanDefinition;
import org.springframework.beans.factory.xml.NamespaceHandlerSupport;
import org.springframework.beans.factory.xml.ParserContext;
import org.w3c.dom.Element;

// 繼承抽象類
public class MysqlDataBaseHandler extends NamespaceHandlerSupport {

    @Override
    public void init() {
    }

    @Override
    public BeanDefinition parse(Element element, ParserContext parserContext) {
        System.out.println("MysqlDataBaseHandler!!!");
        return null;
    }
}
OracleDataBaseHandler
package spring.spi.handlers;

import org.springframework.beans.factory.config.BeanDefinition;
import org.springframework.beans.factory.xml.NamespaceHandlerSupport;
import org.springframework.beans.factory.xml.ParserContext;
import org.w3c.dom.Element;

public class OracleDataBaseHandler extends NamespaceHandlerSupport {

    @Override
    public void init() {
    }

    @Override
    public BeanDefinition parse(Element element, ParserContext parserContext) {
        System.out.println("OracleDataBaseHandler!!!");
        return null;
    }
}
② 在項目META-INF/目錄下創建spring.handlers文件:
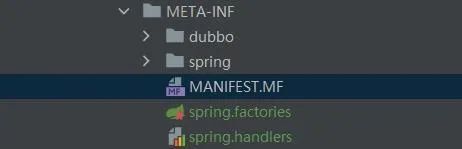
文件內容:
spring.handlers
#一個namespaceUri對應一個handler
http\://www.mysql.org/schema/mysql=spring.spi.handlers.MysqlDataBaseHandler
http\://www.oracle.org/schema/oracle=spring.spi.handlers.OracleDataBaseHandler
③ 運行程式碼:
SpringSpiTest#main()
package spring.spi;

import org.springframework.beans.factory.xml.DefaultNamespaceHandlerResolver;
import org.springframework.beans.factory.xml.NamespaceHandler;

public class SpringSpiTest {

    public static void main(String args[]){
        // spring中提供的默認namespace URI解析器
        DefaultNamespaceHandlerResolver resolver = new DefaultNamespaceHandlerResolver();
        // 此處假設nameSpaceUri已從xml文件中解析出來,正常流程是在項目啟動的時候會解析xml文件,獲取到對應的自定義標籤
        // 然後根據自定義標籤取得對應的nameSpaceUri
        String mysqlNameSpaceUri = "//www.mysql.org/schema/mysql";
        NamespaceHandler  handler = resolver.resolve(mysqlNameSpaceUri);
        // 驗證自定義NamespaceHandler,這裡參數傳null,實際使用中傳具體的Element
        handler.parse(null, null);

        String oracleNameSpaceUri = "//www.oracle.org/schema/oracle";
        handler = resolver.resolve(oracleNameSpaceUri);
        handler.parse(null, null);
    }
}
④ 運行結果:
MysqlDataBaseHandler!!!
OracleDataBaseHandler!!!
上述程式碼通過解析spring.handlers實現對自定義標籤的動態解析,以NameSpaceURI作為key獲取具體的NameSpaceHandler實現類,這裡有別於Java SPI,其中:
DefaultNamespaceHandlerResolver是NamespaceHandlerResolver介面的默認實現類,用於解析自定義標籤。
- DefaultNamespaceHandlerResolver.resolve(String namespaceUri)方法以namespaceUri作為參數,默認載入各jar包中的META-INF/spring.handlers配置文件,通過解析spring.handlers文件建立NameSpaceURI和NameSpaceHandler的映射。
- 載入配置文件的默認路徑是META-INF/spring.handlers,但可以使用DefaultNamespaceHandlerResolver(ClassLoader, String)構造方法修改,DefaultNamespaceHandlerResolver有多個重載方法。
- DefaultNamespaceHandlerResolver.resolve(String namespaceUri)方法主要被BeanDefinitionParserDelegate的parseCustomElement()和decorateIfRequired()方法中調用,所以spring.handlers SPI機制主要用在bean的掃描和解析過程中。
4.2.2 源碼分析
下面從上述程式碼開始深入源碼了解spring handlers方式實現的SPI是如何工作的。
- DefaultNamespaceHandlerResolver
① DefaultNamespaceHandlerResolver.resolve()方法本身是根據namespaceUri獲取對應的namespaceHandler對標籤進行解析,核心源碼:
DefaultNamespaceHandlerResolver#resolve()
public NamespaceHandler resolve(String namespaceUri) {
    // 1、核心邏輯之一:獲取namespaceUri和namespaceHandler映射關係
    Map<String, Object> handlerMappings = getHandlerMappings();
    // 根據namespaceUri參數取對應的namespaceHandler全限定類名or NamespaceHandler實例
    Object handlerOrClassName = handlerMappings.get(namespaceUri);
    if (handlerOrClassName == null) {
        return null;
    }
    // 2、handlerOrClassName是已初始化過的實例則直接返回
    else if (handlerOrClassName instanceof NamespaceHandler) {
        return (NamespaceHandler) handlerOrClassName;
    }else {
        String className = (String) handlerOrClassName;
        try {
            ///3、使用反射根據namespaceHandler全限定類名載入實現類
            Class<?> handlerClass = ClassUtils.forName(className, this.classLoader);
            if (!NamespaceHandler.class.isAssignableFrom(handlerClass)) {
                throw new FatalBeanException("Class [" + className + "] for namespace [" + namespaceUri +
                        "] does not implement the [" + NamespaceHandler.class.getName() + "] interface");
            }
            // 3.1、初始化namespaceHandler實例
            NamespaceHandler namespaceHandler = (NamespaceHandler) BeanUtils.instantiateClass(handlerClass);
            // 3.2、 初始化,不同的namespaceHandler實現類初始化方法邏輯有差異
            namespaceHandler.init();
            // 4、將初始化好的實例放入記憶體快取中,下次解析到相同namespaceUri標籤時直接返回,避免再次初始化
            handlerMappings.put(namespaceUri, namespaceHandler);
            return namespaceHandler;
        }catch (ClassNotFoundException ex) {
            throw new FatalBeanException("NamespaceHandler class [" + className + "] for namespace [" +
                    namespaceUri + "] not found", ex);
        }catch (LinkageError err) {
            throw new FatalBeanException("Invalid NamespaceHandler class [" + className + "] for namespace [" +
                    namespaceUri + "]: problem with handler class file or dependent class", err);
        }
    }
}
第1步:源碼中getHandlerMappings()是比較核心的一個方法,通過懶載入的方式解析spring.handlers並返回namespaceUri和NamespaceHandler的映射關係。
第2步:根據namespaceUri返回對應的NamespaceHandler全限定名或者具體的實例(是名稱還是實例取決於是否被初始化過,若是初始化過的實例會直接返回)
第3步:是NamespaceHandler實現類的全限定名,通過上述源碼中的第3步,使用反射進行初始化。
第4步:將初始化後的實例放到handlerMappings記憶體快取中,這也是第2步為什麼可能是NamespaceHandler類型的原因。
看完resolve方法的源碼,再看下resolve方法在Spring中調用場景,大致可以了解spring.handlers的使用場景:
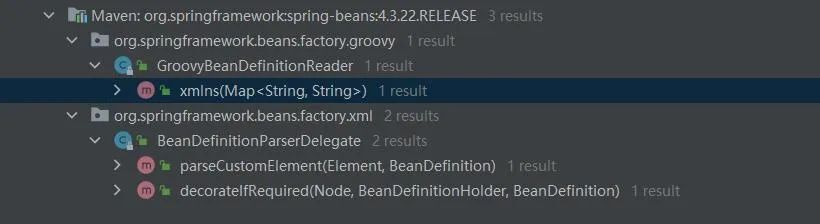
可以看到resolve()主要用在標籤解析過程中,主要被在BeanDefinitionParserDelegate的parseCustomElement和decorateIfRequired方法中調用。
② resolve()源碼中核心邏輯之一便是調用的getHandlerMappings(),在getHandlerMappings()中實現對各個jar包中的META-INF/spring.handlers文件的解析,如:
DefaultNamespaceHandlerResolver#getHandlerMappings()
private Map<String, Object> getHandlerMappings() {
    Map<String, Object> handlerMappings = this.handlerMappings;
    // 使用執行緒安全的解析邏輯,避免在並發場景下重複的解析,沒必要重複解析
    // 這裡在同步程式碼塊的內外對handlerMappings == null作兩次判斷很有必要,採用懶漢式初始化
    if (handlerMappings == null) {
        synchronized (this) {
            handlerMappings = this.handlerMappings;
            // duble check
            if (handlerMappings == null) {
                if (logger.isDebugEnabled()) {
                    logger.debug("Loading NamespaceHandler mappings from [" + this.handlerMappingsLocation + "]");
                }
                try {
                    // 載入handlerMappingsLocation目錄文件,handlerMappingsLocation路徑值可變,默認是META-INF/spring.handlers
                    Properties mappings =
                            PropertiesLoaderUtils.loadAllProperties(this.handlerMappingsLocation, this.classLoader);
                    if (logger.isDebugEnabled()) {
                        logger.debug("Loaded NamespaceHandler mappings: " + mappings);
                    }
                    // 初始化記憶體快取
                    handlerMappings = new ConcurrentHashMap<String, Object>(mappings.size());
                    // 將載入到的屬性合併到handlerMappings中
                    CollectionUtils.mergePropertiesIntoMap(mappings, handlerMappings);
                    // 賦值記憶體快取
                    this.handlerMappings = handlerMappings;
                }catch (IOException ex) {
                    throw new IllegalStateException(
                            "Unable to load NamespaceHandler mappings from location [" + this.handlerMappingsLocation + "]", ex);
                }
            }
        }
    }
    return handlerMappings;
}
源碼中this.handlerMappings是一個Map類型的記憶體快取,存放解析到的namespaceUri以及NameSpaceHandler實例。
getHandlerMappings()方法體中的實現使用了執行緒安全方式,增加了同步邏輯。
通過閱讀源碼可以了解到Spring基於spring.handlers實現SPI邏輯相對比較簡單,但應用卻比較靈活,對自定義標籤的支援很方便,在不修改Spring源碼的前提下輕鬆實現接入,如Dubbo中定義的各種Dubbo標籤便是很好的利用了spring.handlers。
Spring提供如此靈活的功能,那是如何應用的呢?下面簡單了解下parseCustomElement()。
- BeanDefinitionParserDelegate.parseCustomElement()
resolve作為工具類型的方法,被使用的地方比較多,這裡僅簡單介紹在BeanDefinitionParserDelegate.parseCustomElement()中的應用。
BeanDefinitionParserDelegate#parseCustomElement()
public BeanDefinition parseCustomElement(Element ele, BeanDefinition containingBd) {
     // 獲取標籤的namespaceUri
     String namespaceUri = getNamespaceURI(ele);
     // 首先獲得DefaultNamespaceHandlerResolver實例在再以namespaceUri作為參數調用resolve方法解析取得NamespaceHandler
     NamespaceHandler handler = this.readerContext.getNamespaceHandlerResolver().resolve(namespaceUri);
     if (handler == null) {
         error("Unable to locate Spring NamespaceHandler for XML schema namespace [" + namespaceUri + "]", ele);
         return null;
     }
     // 調用NamespaceHandler中的parse方法開始解析標籤
     return handler.parse(ele, new ParserContext(this.readerContext, this, containingBd));
 }
parseCustomElement作為解析標籤的中間方法,再看下parseCustomElement的調用情況:

在parseBeanDefinitions()中被調用,再看下parseBeanDefinitions的源碼
DefaultBeanDefinitionDocumentReader#parseBeanDefinitions()
protected void parseBeanDefinitions(Element root, BeanDefinitionParserDelegate delegate) {
    // spring內部定義的標籤為默認標籤,即非spring內部定義的標籤都不是默認的namespace
    if (delegate.isDefaultNamespace(root)) {
        NodeList nl = root.getChildNodes();
        for (int i = 0; i < nl.getLength(); i++) {
            Node node = nl.item(i);
            if (node instanceof Element) {
                Element ele = (Element) node;
                // root子標籤也做此判斷
                if (delegate.isDefaultNamespace(ele)) {
                    parseDefaultElement(ele, delegate);
                }else{
                    // 子標籤非spring默認標籤(即自定義標籤)也走parseCustomElement來解析
                    delegate.parseCustomElement(ele);
                }
            }
        }
    }else {
        // 非spring的默認標籤(即自定義的標籤)走parseCustomElement來解析
        delegate.parseCustomElement(root);
    }
}
到此就很清晰了,調用前判斷是否為Spring默認標籤,不是默認標籤調用parseCustomElement來解析,最後調用resolve方法。
4.2.3 小節
Spring自2.0引入spring.handlers以後,為Spring的動態擴展提供更多的入口和手段,為自定義標籤的實現提供了強力支撐。
很多文章在介紹Spring SPI時都重點介紹spring.factories實現,很少提及很早就引入的spring.handlers,但通過個人的分析及與Java SPI的對比,spring.handlers也是一種SPI的實現,只是基於xml實現。
相比於Java SPI,基於spring.handlers實現的SPI更加的靈活,無需遍歷,直接映射,更類似於Dubbo SPI的實現思想,每個類指定一個名稱(只是spring.handlers中是以namespaceUri作為key,Dubbo配置中是指定的名稱作為key)。
4.3 spring.factories
同樣先以測試程式碼來介紹spring.factories實現SPI的邏輯。
4.3.1 spring.factories SPI
① 創建DataBaseSPI介面
介面
package spring.spi.factories;

public interface DataBaseSPI {
    public void dataBaseOperation();
}
② 創建DataBaseSPI介面的實現類
MysqlDataBaseImpl
#實現類1
package spring.spi.factories.impl;

import spring.spi.factories.DataBaseSPI;

public class MysqlDataBaseImpl implements DataBaseSPI {

    @Override
    public void dataBaseOperation() {
        System.out.println("Mysql database test!!!!");
    }
}
MysqlDataBaseImpl
#實現類2
package spring.spi.factories.impl;

import spring.spi.factories.DataBaseSPI;

public class OracleDataBaseImpl implements DataBaseSPI {

    @Override
    public void dataBaseOperation() {
        System.out.println("Oracle database test!!!!");
    }
}
③ 在項目META-INF/目錄下創建spring.factories文件:
文件內容
spring.factories
#key是介面的全限定名,value是介面的實現類
spring.spi.factories.DataBaseSPI = spring.spi.factories.impl.MysqlDataBaseImpl,spring.spi.factories.impl.OracleDataBaseImpl
④ 運行程式碼
SpringSpiTest#main()
package spring.spi.factories;

import java.util.List;

import org.springframework.core.io.support.SpringFactoriesLoader;

public class SpringSpiTest {

    public static void main(String args[]){

        // 調用SpringFactoriesLoader.loadFactories方法載入DataBaseSPI介面所有實現類的實例
        List<DataBaseSPI> spis= SpringFactoriesLoader.loadFactories(DataBaseSPI.class, Thread.currentThread().getContextClassLoader());

        // 遍歷DataBaseSPI介面實現類實例
        for(DataBaseSPI spi : spis){
            spi.dataBaseOperation();
        }
    }
}
⑤ 運行結果
Mysql database test!!!!
Oracle database test!!!!
從上述的示例程式碼中可以看出spring.facotries方式實現的SPI和Java SPI很相似,都是先獲取指定介面類型的實現類,然後遍歷訪問所有的實現。但也存在一定的差異:
(1)配置上:
Java SPI是一個服務提供介面對應一個配置文件,配置文件中存放當前介面的所有實現類,多個服務提供介面對應多個配置文件,所有配置都在services目錄下;
Spring factories SPI是一個spring.factories配置文件存放多個介面及對應的實現類,以介面全限定名作為key,實現類作為value來配置,多個實現類用逗號隔開,僅spring.factories一個配置文件。
(2)實現上
Java SPI使用了懶載入模式,即在調用ServiceLoader.load()時僅是返回了ServiceLoader實例,尚未解析介面對應的配置文件,在使用時即循環遍歷時才正式解析返回服務提供介面的實現類實例;
Spring factories SPI在調用SpringFactoriesLoader.loadFactories()時便已解析spring.facotries文件返回介面實現類的實例(實現細節在源碼分析中詳解)。
4.3.2 源碼分析
我們還是從測試程式碼開始,了解下spring.factories的SPI實現源碼,細品spring.factories的實現方式。
- SpringFactoriesLoader測試程式碼入口直接調用SpringFactoriesLoader.loadFactories()靜態方法開始解析spring.factories文件,並返回方法參數中指定的介面類型,如測試程式碼里的DataBaseSPI介面的實現類實例。
SpringFactoriesLoader#loadFactories()
public static <T> List<T> loadFactories(Class<T> factoryClass, ClassLoader classLoader) {
    Assert.notNull(factoryClass, "'factoryClass' must not be null");
    ClassLoader classLoaderToUse = classLoader;
    // 1.確定類載入器
    if (classLoaderToUse == null) {
        classLoaderToUse = SpringFactoriesLoader.class.getClassLoader();
    }
    // 2.核心邏輯之一:解析各jar包中META-INF/spring.factories文件中factoryClass的實現類全限定名
    List<String> factoryNames = loadFactoryNames(factoryClass, classLoaderToUse);
    if (logger.isTraceEnabled()) {
        logger.trace("Loaded [" + factoryClass.getName() + "] names: " + factoryNames);
    }
    List<T> result = new ArrayList<T>(factoryNames.size());
    // 3.遍歷實現類的全限定名並進行實例化
    for (String factoryName : factoryNames) {
        result.add(instantiateFactory(factoryName, factoryClass, classLoaderToUse));
    }
    // 排序
    AnnotationAwareOrderComparator.sort(result);
    // 4.返回實例化後的結果集
    return result;
}
源碼中loadFactoryNames() 是另外一個比較核心的方法,解析spring.factories文件中指定介面的實現類的全限定名,實現邏輯見後續的源碼。
經過源碼中第2步解析得到實現類的全限定名後,在第3步通過instantiateFactory()方法逐個實例化實現類。
再看loadFactoryNames()源碼是如何解析得到實現類全限定名的:
SpringFactoriesLoader#loadFactoryNames()
public static List<String> loadFactoryNames(Class<?> factoryClass, ClassLoader classLoader) {
    // 1.介面全限定名
    String factoryClassName = factoryClass.getName();
    try {
        // 2.載入META-INF/spring.factories文件路徑(分布在各個不同jar包里,所以這裡會是多個文件路徑,枚舉返回)
        Enumeration<URL> urls = (classLoader != null ? classLoader.getResources(FACTORIES_RESOURCE_LOCATION) :
                ClassLoader.getSystemResources(FACTORIES_RESOURCE_LOCATION));
        List<String> result = new ArrayList<String>();
        // 3.遍歷枚舉集合,逐個解析spring.factories文件
        while (urls.hasMoreElements()) {
            URL url = urls.nextElement();
            Properties properties = PropertiesLoaderUtils.loadProperties(new UrlResource(url));
            String propertyValue = properties.getProperty(factoryClassName);
            // 4.spring.factories文件中一個介面的實現類有多個時會用逗號隔開,這裡拆開獲取實現類全限定名
            for (String factoryName : StringUtils.commaDelimitedListToStringArray(propertyValue)) {
                result.add(factoryName.trim());
            }
        }
        return result;
    }catch (IOException ex) {
        throw new IllegalArgumentException("Unable to load factories from location [" +
                FACTORIES_RESOURCE_LOCATION + "]", ex);
    }
}
源碼中第2步獲取所有jar包中META-INF/spring.factories文件路徑,以枚舉值返回。
源碼中第3步開始遍歷spring.factories文件路徑,逐個載入解析,整合factoryClass類型的實現類名稱。
獲取到實現類的全限定名集合後,便根據實現類的名稱逐個實例化,繼續看下instantiateFactory()方法的源碼:
SpringFactoriesLoader#instantiateFactory()
private static <T> T instantiateFactory(String instanceClassName, Class<T> factoryClass, ClassLoader classLoader) {
    try {
        // 1.使用classLoader類載入器載入instanceClassName類
        Class<?> instanceClass = ClassUtils.forName(instanceClassName, classLoader);
        if (!factoryClass.isAssignableFrom(instanceClass)) {
            throw new IllegalArgumentException(
                    "Class [" + instanceClassName + "] is not assignable to [" + factoryClass.getName() + "]");
        }
        // 2.instanceClassName類中的構造方法
        Constructor<?> constructor = instanceClass.getDeclaredConstructor();
        ReflectionUtils.makeAccessible(constructor);
        // 3.實例化
        return (T) constructor.newInstance();
    }
    catch (Throwable ex) {
        throw new IllegalArgumentException("Unable to instantiate factory class: " + factoryClass.getName(), ex);
    }
}
實例化方法是私有型(private)靜態方法,這個有別於loadFactories和loadFactoryNames。
實例化邏輯整體使用了反射實現,比較通用的實現方式。
通過對源碼的分析,Spring factories方式實現的SPI邏輯不是很複雜,整體上的實現容易理解。
Spring在3.2便已引入spring.factories,那spring.factories在Spring框架中又是如何使用的呢?先看下loadFactories方法的調用情況:
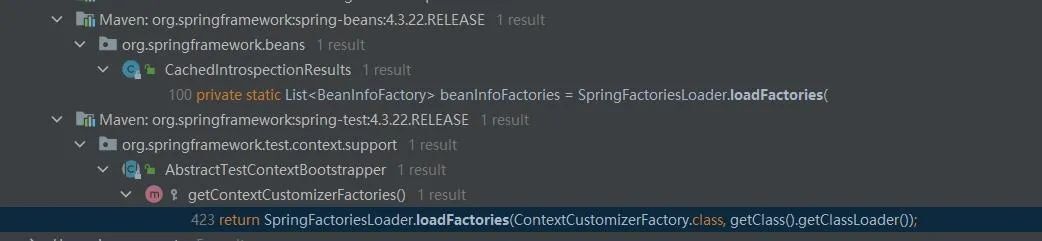
從調用情況看Spring自3.2引入spring.factories SPI後並沒有真正的利用起來,使用的地方比較少,然而真正把spring.factories發揚光大的,是在Spring Boot中, 簡單了解下SpringBoot中的調用。
- getSpringFactoriesInstances()getSpringFactoriesInstances()並不是Spring框架中的方法,而是SpringBoot中SpringApplication類里定義的私有型(private)方法,很多地方都有調用,源碼如下:
SpringApplication#getSpringFactoriesInstance()
// 單個參數getSpringFactoriesInstances方法
private <T> Collection<T> getSpringFactoriesInstances(Class<T> type) {
    // 默認調用多參的重載方法
    return getSpringFactoriesInstances(type, new Class<?>[] {});
}
// 多個參數的getSpringFactoriesInstances方法
private <T> Collection<T> getSpringFactoriesInstances(Class<T> type,
        Class<?>[] parameterTypes, Object... args) {
    ClassLoader classLoader = getClassLoader();
    // 調用SpringFactoriesLoader中的loadFactoryNames方法載入介面實現類的全限定名
    Set<String> names = new LinkedHashSet<>(
            SpringFactoriesLoader.loadFactoryNames(type, classLoader));
    // 實例化
    List<T> instances = createSpringFactoriesInstances(type, parameterTypes,
            classLoader, args, names);
    AnnotationAwareOrderComparator.sort(instances);
    return instances;
}
在getSpringFactoriesInstances()中調用了SpringFactoriesLoader.loadFactoryNames()來載入介面實現類的全限定名集合,然後進行初始化。
SpringBoot中除了getSpringFactoriesInstances()方法有調用,在其他邏輯中也廣泛運用著SpringFactoriesLoader中的方法來實現動態擴展,這裡就不在一一列舉了,有興趣的同學可以自己去發掘。
4.3.3 小節
Spring框架在3.2引入spring.factories後並沒有有效的利用起來,但給框架的使用者提供了又一個動態擴展的能力和入口,為開發人員提供了很大的自由發揮的空間,尤其是在SpringBoot中廣泛運用就足以證明spring.factories的地位。spring.factories引入在 提升Spring框架能力的同時也暴露出其中的不足:
首先,spring.factories的實現類似Java SPI,在載入到服務提供介面的實現類後需要循環遍歷才能訪問,不是很方便。
其次,Spring在5.0.x版本以前SpringFactoriesLoader類定義為抽象類,但在5.1.0版本之後Sping官方將SpringFactoriesLoader改為final類,類型變化對前後版本的兼容不友好。
五、應用實踐
介紹完Spring中SPI機制相關的核心源碼,再來看看項目中自己開發的輕量版的分庫分表SDK是如何利用Spring的SPI機制實現分庫分表策略動態擴展的。
基於項目的特殊性並沒有使用目前行業中成熟的分庫分表組件,而是基於Mybatis的插件原理自己開發的一套輕量版分庫分表組件。為滿足不同場景分庫分表要求,將其中分庫分表的相關邏輯以策略模式進行抽取分離,每種分庫分表的實現對應一條策略,支援使用方對分庫分表策略的動態擴展,而這裡的動態擴展就利用了spring.factories。
首先給出輕量版分庫分表組件流程圖,然後我們針對流程圖中使用到Spring SPI的地方進行詳細分析。
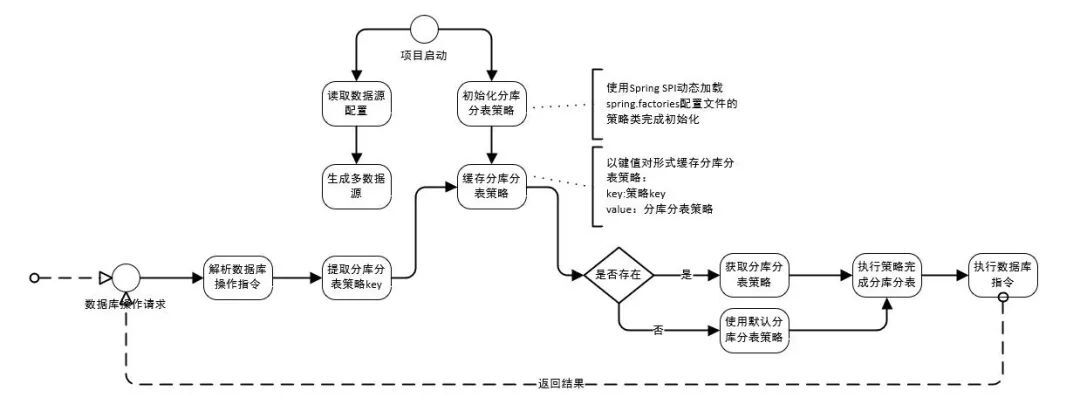
說明:
- 上述流程圖中項目啟動過程中生成數據源和分庫分表策略的初始化,策略初始化完成後快取到記憶體中。
- 發起資料庫操作指令時,解析是否需要分庫分表(流程中只給出了需要分庫分表的流程),需要則通過提取到的策略key獲取對應的分庫分表策略並進行分庫分表,完成資料庫操作。
通過上述的流程圖可以看到,分庫分表SDK通過spring.factories支援動態載入分庫分表策略以兼容不同項目的不同使用場景。
其中分庫分表部分的策略類圖:
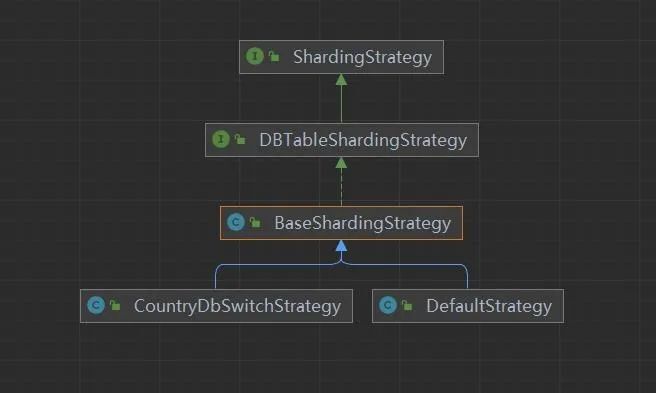
其中:ShardingStrategy和DBTableShardingStrategy為介面;BaseShardingStrategy為默認實現類;DefaultStrategy和CountryDbSwitchStrategy為SDK中基於不同場景默認實現的分庫分表策略。
在項目實際使用時,動態擴展的分庫分表策略只需要繼承BaseShardingStrategy即可,SDK中初始化分庫分表策略時通過SpringFactoriesLoader.loadFactories()實現動態載入。
六、總結
SPI技術將服務介面與服務實現分離以達到解耦,極大的提升程式的可擴展性。
本文重點介紹了Java內置SPI和Dubbo SPI以及Spring SPI三者的原理和相關源碼;首先演示了三種SPI技術的實現,然後通過演示程式碼深入閱讀了三種SPI的實現源碼;其中重點介紹了Spring SPI的兩種實現方式:spring.handlers和spring.factories,以及使用spring.factories實現的分庫分表策略載入。希望通過閱讀本文可以讓讀者對SPI有更深入的了解。
