透過Redis源碼探究字元串的實現
轉載請聲明出處哦~,本篇文章發佈於luozhiyun的部落格://www.luozhiyun.com
本文使用的Redis 5.0源碼
概述
最近在通過 Redis 學 C 語言,不得不說,Redis的程式碼寫的真的工整。這篇文章會比較全面的深入的講解了Redis數據結構字元串的源碼實現,希望大家能夠從中學到點東西。
Redis 的字元串源碼主要都放在了 sds.c 和 sds.h 這兩個文件中。具體實現已經被剝離出來變成單獨的庫://github.com/antirez/sds。
Redis 的動態字元串結構如下圖所示:
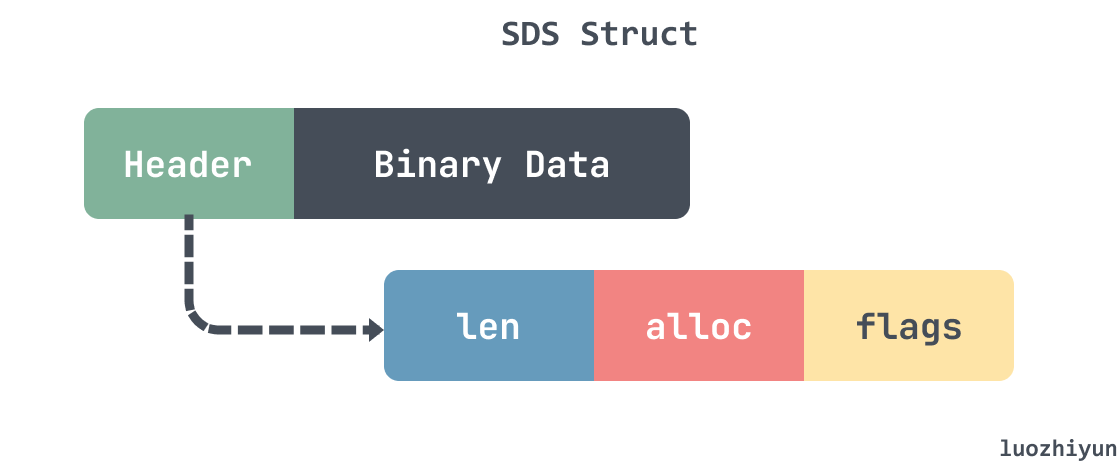
SDS 大致由兩部分構成:header以及 數據段,其中 header 還包含3個欄位 len、alloc、flags。len 表示數據長度,alloc 表示分配的記憶體長度,flags 表示了 sds 的數據類型。
在以前的版本中,sds 的header其實佔用記憶體是固定8位元組大小的,所以如果在redis中存放的都是小字元串,那麼 sds 的 header 將會佔用很多的記憶體空間。
但是隨著 sds 的版本變遷,其實在記憶體佔用方面還是做了一些優化:
- 在 sds 2.0 之前 header 的大小是固定的 int 類型,2.0 版本之後會根據傳入的字元大小調整 header 的 len 和 alloc 的類型以便節省記憶體佔用。
- header 的結構體使用
__attribute__修飾,這裡主要是防止編譯器自動進行記憶體對齊,這樣可以減少編譯器因為記憶體對齊而引起的 padding 的數量所佔用的記憶體。
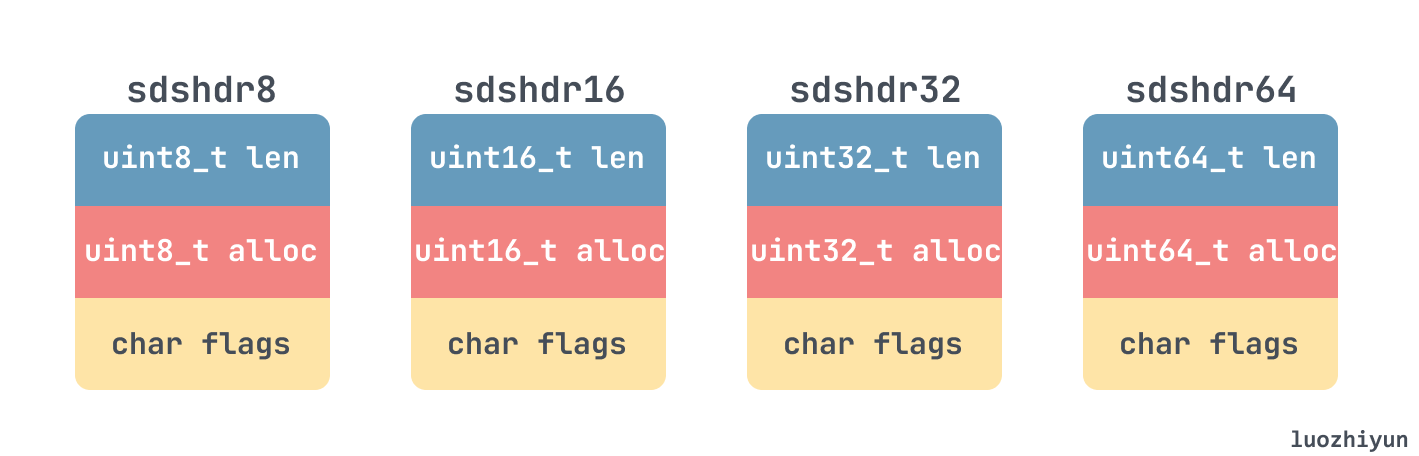
目前的版本中共定義了五種類型的 sds header,其中 sdshdr5 是沒用的,所以沒畫:
源碼分析
sds 的創建
sds 的創建主要有如下幾個函數:
sds sdsnewlen(const void *init, size_t initlen);
sds sdsnew(const char *init);
sds sdsempty(void);
sds sdsdup(const sds s);
-
sdsnewlen 傳入一個 C 的字元串進去,創建一個 sds 字元串,並且需要傳入大小;
-
sdsnew 傳入一個 C 的字元串進去,創建一個 sds 字元串,它裡面實際上會調用
strlen(init)計算好長度之後調用 sdsnewlen; -
sdsempty 會創建一個空字元串 「」;
-
sdsdup 調用 sdsnewlen,複製一個已存在的字元串;
所以通過上面的創建可以知道,最終都會調用 sdsnewlen 來創建字元串,所以我們看看這個函數具體怎麼實現。
sdsnewlen
其實對於一個字元串對象的創建來說,其實就做了三件事:申請記憶體、構造結構體、字元串拷貝到字元串記憶體區域中。下面我們看一下 Redis 的具體實現。
申請記憶體
sds sdsnewlen(const void *init, size_t initlen) {
    void *sh; //指向SDS結構體的指針
    sds s; //sds類型變數,即char*字元數組
    char type = sdsReqType(initlen); //根據數據大小獲取sds header 類型
    if (type == SDS_TYPE_5 && initlen == 0) type = SDS_TYPE_8;
    int hdrlen = sdsHdrSize(type); // 根據類型獲取sds header大小
    unsigned char *fp; /* flags pointer. */

    assert(hdrlen+initlen+1 > initlen); /* Catch size_t overflow */
    sh = s_malloc(hdrlen+initlen+1); //新建SDS結構,並分配記憶體空間,這裡加1是因為需要在最後加上\0
    ...
    return s;
}
在記憶體申請之前,需要做的事情有以下幾件:
- 因為 sds 會根據傳入的大小來設計 header 的類型,所以需要調用 sdsReqType 函數根據 initlen 獲取 header 類型;
- 然後調用 sdsHdrSize 根據 header 類型獲取 header 佔用的位元組數;
- 最後調用 s_malloc 根據 header 長度和字元串長度分配記憶體,這裡需要加1是因為在 c 裡面字元串是以
\0結尾的,為了兼容 c 的字元串格式。
既然說到了 header 類型,那麼我們先來看看 header 的類型定義:
struct __attribute__ ((__packed__)) sdshdr8 { // 佔用 3 byte
    uint8_t len; /* used */
    uint8_t alloc; /* excluding the header and null terminator */
    unsigned char flags; /* 3 lsb of type, 5 unused bits */
    char buf[];
};
struct __attribute__ ((__packed__)) sdshdr16 { // 佔用 5 byte
    uint16_t len; /* used */
    uint16_t alloc; /* excluding the header and null terminator */
    unsigned char flags; /* 3 lsb of type, 5 unused bits */
    char buf[];
};
struct __attribute__ ((__packed__)) sdshdr32 { // 佔用 9 byte
    uint32_t len; /* used */
    uint32_t alloc; /* excluding the header and null terminator */
    unsigned char flags; /* 3 lsb of type, 5 unused bits */
    char buf[];
};
struct __attribute__ ((__packed__)) sdshdr64 { // 佔用 17 byte
    uint64_t len; /* used */
    uint64_t alloc; /* excluding the header and null terminator */
    unsigned char flags; /* 3 lsb of type, 5 unused bits */
    char buf[];
};
在這裡 __attribute__ 是用來防止記憶體對齊用的,否則也會浪費一些存儲空間。關於記憶體對齊相關的知識,我在 《Go中由WaitGroup引發對記憶體對齊思考》 這篇文章裡面也講解過了,知識點是通用的,感興趣的可以回過去看看。
看了上面的定義之後,我們自然而然的就可以想到,Redis 會根據傳入的大小判斷生成的 sds header 頭類型:
static inline char sdsReqType(size_t string_size) {
    if (string_size < 1<<5) // 小於 32
        return SDS_TYPE_5;
    if (string_size < 1<<8) // 小於 256
        return SDS_TYPE_8;
    if (string_size < 1<<16) // 小於 65,536
        return SDS_TYPE_16;
#if (LONG_MAX == LLONG_MAX)
    if (string_size < 1ll<<32)
        return SDS_TYPE_32;
    return SDS_TYPE_64;
#else
    return SDS_TYPE_32;
#endif
}
可以看到 sdsReqType 是根據傳入的字元串長度來判斷字元類型。
構造結構體
對於Redis來說,如果沒用過C語言的同學,會覺得它這裡構造結構體的方式比較 hack。首先它是直接根據需要的記憶體大小申請一塊記憶體,然後初始化頭結構的指針指向的位置,最後為頭結構的指針設值。
#define SDS_HDR_VAR(T,s) struct sdshdr##T *sh = (void*)((s)-(sizeof(struct sdshdr##T)));

sds sdsnewlen(const void *init, size_t initlen) {
	...
    sh = s_malloc(hdrlen+initlen+1); // 1.申請記憶體,這裡長度加1是為了在最後面存放一個 \0
    if (sh == NULL) return NULL;
    if (init==SDS_NOINIT)
        init = NULL;
    else if (!init)
        memset(sh, 0, hdrlen+initlen+1);// 2.將記憶體的值都設置為0
    s = (char*)sh+hdrlen; 				//3.將s指針指向數據起始位置
    fp = ((unsigned char*)s)-1; 		//4.將fp指針指向sds header的flags欄位
    switch(type) {
        case SDS_TYPE_5: {
            *fp = type | (initlen << SDS_TYPE_BITS);
            break;
        }
        case SDS_TYPE_8: {
            SDS_HDR_VAR(8,s); //5.構造sds結構體header
            sh->len = initlen; // 初始化 header len欄位
            sh->alloc = initlen; // 初始化 header alloc欄位
            *fp = type; // 初始化 header flag欄位
            break;
        }
        ...
    }
    ...
    return s;
}
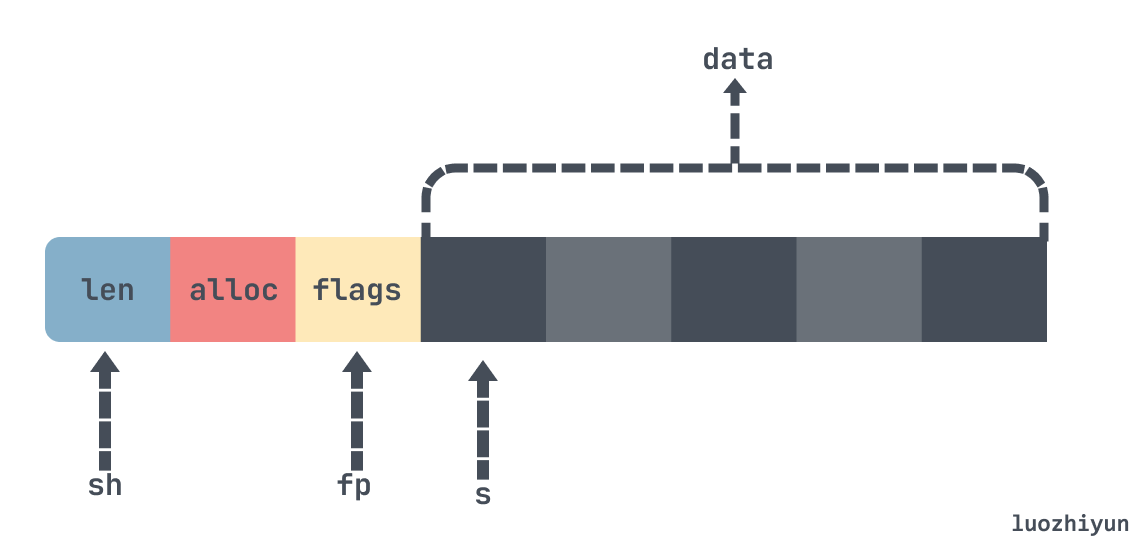
上面的過程我已經標註清楚了,可能直接看程式碼比較難理解這裡的頭結構體構造的過程,我下面用一張圖表示一下指針指向的位置:
字元串拷貝
sds sdsnewlen(const void *init, size_t initlen) {
    ...
    if (initlen && init)
        memcpy(s, init, initlen); //將要傳入的字元串拷貝給sds變數s
    s[initlen] = '\0'; //變數s末尾增加\0,表示字元串結束
    return s;
}
memcpy 函數會逐個位元組的將字元串拷貝到 s 對應的記憶體區域中。
sdscatlen 字元串追加
sds sdscatlen(sds s, const void *t, size_t len) {
    size_t curlen = sdslen(s); // 獲取字元串 len 大小
    //根據要追加的長度len和目標字元串s的現有長度,判斷是否要增加新的空間
    //返回的還是字元串起始記憶體地址
    s = sdsMakeRoomFor(s,len);
    if (s == NULL) return NULL;
    // 將新追加的字元串拷貝到末尾
    memcpy(s+curlen, t, len);
    // 重新設置字元串長度
    sdssetlen(s, curlen+len);
    s[curlen+len] = '\0';
    return s;
}
在這個字元串追加的方法里,其實把空間檢查和擴容封裝在了 sdsMakeRoomFor 函數中,它裡面所要做的就是:
- 有沒有剩餘空間,有的話直接返回;
- 沒有剩餘空間,那麼需要擴容,擴容多少?
- 字元串是否可以在原來的位置追加空間,還是需要重新申請一塊記憶體區域。
那麼下面我把 sdsMakeRoomFor 函數分為兩部分來看:擴容、記憶體申請。
擴容
sds sdsMakeRoomFor(sds s, size_t addlen) {
    void *sh, *newsh;
    size_t avail = sdsavail(s); //這裡是用 alloc-len,表示可用資源
    size_t len, newlen;
    char type, oldtype = s[-1] & SDS_TYPE_MASK;
    int hdrlen;

    if (avail >= addlen) return s; // 如果有空間剩餘,那麼直接返回

    len = sdslen(s); // 獲取字元串 len 長度
    sh = (char*)s-sdsHdrSize(oldtype); //獲取到header的指針
    newlen = (len+addlen); // 新的記憶體空間
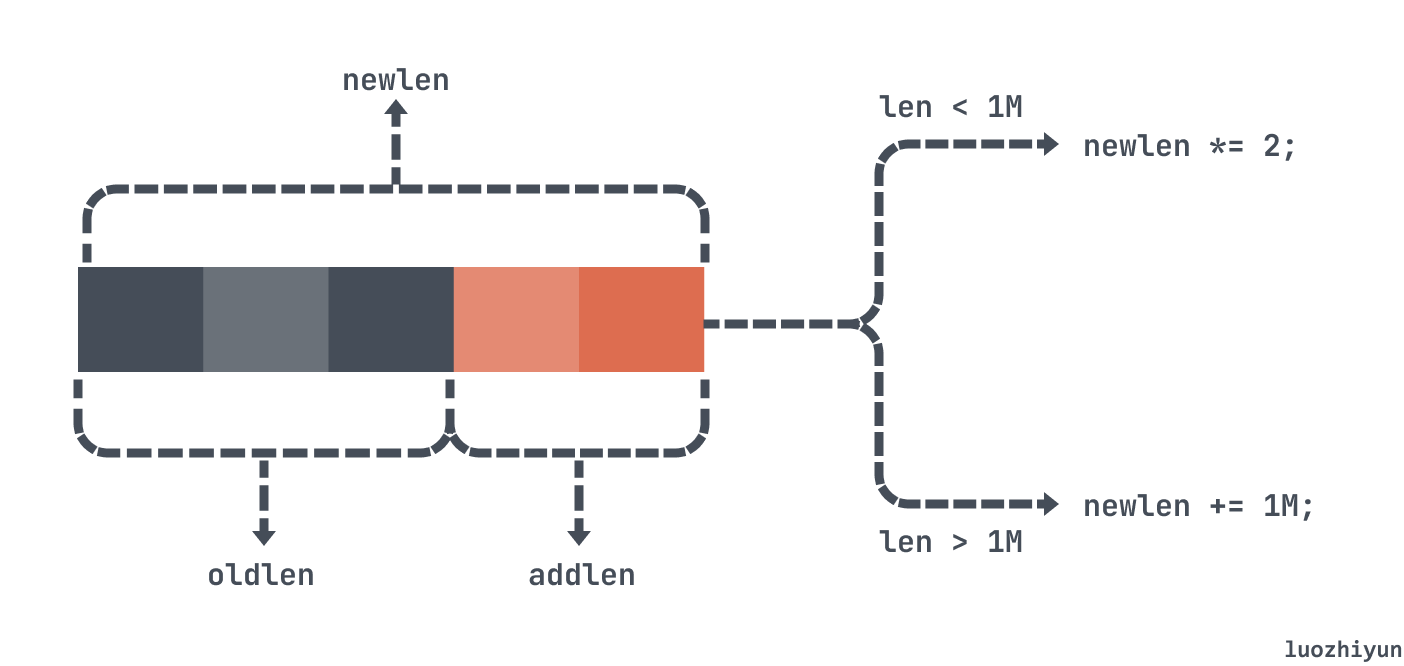
    if (newlen < SDS_MAX_PREALLOC) //如果小於 1m, 那麼存儲空間直接翻倍
        newlen *= 2;
    else
        newlen += SDS_MAX_PREALLOC; //超過了1m,那麼只會多增加1m空間
    ...
    return s;
}
對於擴容來說,首先會看一下空間是否足夠,也就是根據 alloc-len 判斷, 有剩餘空間直接返回。
然後 Redis 會根據 sds 的大小不同來進行擴容,如果 len+addlen空間小於 1m,那麼新的空間直接翻倍;如果 len+addlen空間大於 1m ,那麼新空間只會增加 1m。
記憶體申請
sds sdsMakeRoomFor(sds s, size_t addlen) {
    ...

    type = sdsReqType(newlen); // 根據新的空間佔用計算 sds 類型

    hdrlen = sdsHdrSize(type); // header 長度
    if (oldtype==type) { // 和原來header一樣,那麼可以復用原來的空間
        newsh = s_realloc(sh, hdrlen+newlen+1); // 申請一塊記憶體,並追加大小
        if (newsh == NULL) return NULL;
        s = (char*)newsh+hdrlen;
    } else {
        //如果header 類型變了,表示記憶體頭變了,那麼需要重新申請記憶體
        //因為如果使用s_realloc只會向後追加記憶體
        newsh = s_malloc(hdrlen+newlen+1);
        if (newsh == NULL) return NULL;
        memcpy((char*)newsh+hdrlen, s, len+1);
        s_free(sh); // 釋放掉原記憶體
        s = (char*)newsh+hdrlen;
        s[-1] = type;
        sdssetlen(s, len);
    }
    sdssetalloc(s, newlen);//重新設置alloc欄位
    return s;
}
在記憶體申請上,Redis 分為兩種情況,一種是 sds header 類型沒變,那麼可以直接調用 realloc在原有記憶體後面追加新的記憶體區域即可;
另一種是 sds header 類型發生了變化,這裡一般是 header 佔用的空間變大了,因為 realloc 無法向前追加記憶體區域,所以只能調用 malloc 重新申請一塊記憶體區域,然後通過 memcpy 將字元串拷貝到新的地址中去。
總結
通過這篇文章,我們深入學習到 Redis 的字元串是怎麼實現,得知它通過版本的更迭做了哪些改變,大家可以自己拿 sds 和自己熟悉的語言的字元串實現做個對比,看看實現上有啥差異,哪個更好。
Reference
//redis.io/docs/reference/internals/internals-sds/