Redis初啟(一)
1、資料庫存存儲性能優化
在mysql的文章專題中我寫過了關於傳統關係型資料庫的一些優化思路,整體來說,通過優化之後能夠提升程式訪問資料庫的計算性能。但是還是有一些情況,即便是優化之後,使用傳統關係型資料庫無法解決的,比如。
- 當數據量達到TB級別時,傳統關係型資料庫基本做了分庫分表,單表數據量也是非常大的。
- 對於一些不適合用關係型資料庫存儲的數據,傳統資料庫無法做到,所以資料庫本身的特性限制了多樣性數據的管理。
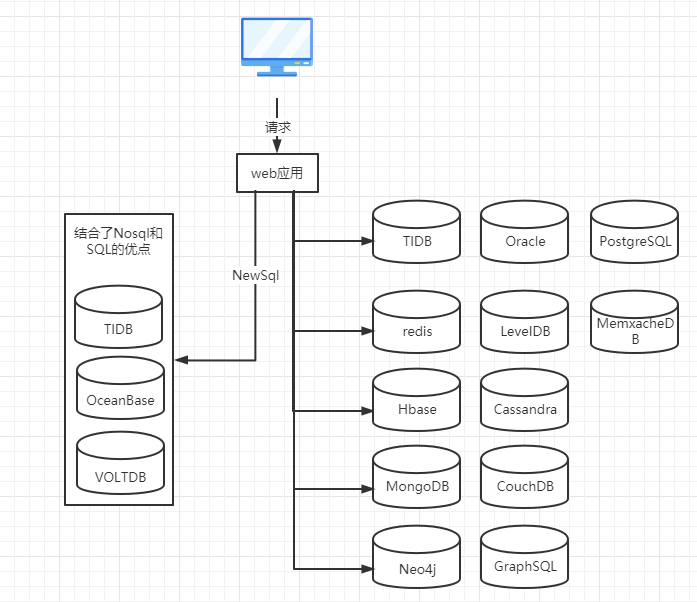
1.1、K-V資料庫
key-value分散式存儲系統查詢速快、存放數據量大、支援高並發,非常適合通過主鍵進行查詢,但不能進行複雜的條件查詢。
如果輔以實時搜索引擎進行複雜條件檢索、全文檢索,就可以替代並發性能較低的MySQL等關係型資料庫,達到高並發、高性能,節省幾十倍伺服器數 量的目的。以MemcacheDB、Tokyo Tyrant為代表的key-value分散式存儲,在上萬並發連接下,輕鬆地完成高速查詢。
1.2、列式數據
1.2.1、列式資料庫介紹
列式資料庫是以列相關存儲架構進行數據存儲的資料庫,主要適合與批量數據處理和即席查詢。相對應的是行式資料庫,數據以行相關的存儲體系架構進行空間分配,主要適合與小批量的數據處理,常用於聯機事務型數據處理。列式資料庫以行、列的二維表的形式存儲數據,但是卻以一維字元串的方式存儲,例如以下的一個表:
|
EmpId |
Lastname |
Firstname |
Salary |
|---|---|---|---|
| 1 | Smith | Joe | 40000 |
| 2 | Jones | Mary | 50000 |
| 3 | Johnson | Cathy | 44000 |
這個簡單的表包括員工程式碼(EmpId), 姓名欄位(Lastname and Firstname)及工資(Salary).
這個表存儲在電腦的記憶體(RAM)和存儲(硬碟)中。雖然記憶體和硬碟在機制上不同,電腦的作業系統是以同樣的方式存儲的。資料庫必須把這個二維表存儲在一系列一維的「位元組」中,又作業系統寫到記憶體或硬碟中。
行式資料庫把一行中的數據值串在一起存儲起來,然後再存儲下一行的數據,以此類推。
1,Smith,Joe,40000;2,Jones,Mary,50000;3,Johnson,Cathy,44000;
列式資料庫把一列中的數據值串在一起存儲起來,然後再存儲下一列的數據,以此類推。
1,2,3;Smith,Jones,Johnson;Joe,Mary,Cathy;40000,50000,44000;
這是一個簡化的說法。
列式資料庫的代表包括:Sybase IQ,ParAccel, Sand/DNA Analytics和 Vertica。
1.2.2、列式資料庫與行式資料庫
傳統的行式資料庫,是按照行存儲的,維護大量的索引和物化視圖無論是在時間(處理)還是空間(存儲)方面成本都很高。而列式資料庫恰恰相反,列式資料庫的數據是按照列存儲,每一列單獨存放,數據即是索引。只訪問查詢涉及的列,大大降低了系統I/O,每一列由一個線來處理,而且由於數據類型一致,數據特徵相似,極大方便壓縮。
最後盧東明很務實的指出,沒有萬能的資料庫,Sybase IQ也並非萬能,只不過給DBA們的工具箱里提供更多的選擇,DBA需根據自己的應用場景自行選擇。
在數據倉庫領域,列式資料庫和傳統的行式資料庫有何差別呢?列式資料庫和行式資料庫的擁護者均認為結合這兩種技術的混合資料庫是個不錯的想法。
行式資料庫擅長隨機讀操作,列式資料庫則更擅長大批量數據量查詢,而混合資料庫則試圖同時包含這兩種技術的優點,在災難恢復環境中,數據要麼按列式存儲,要麼按行式存儲。
未來將是列式資料庫的天下,行資料庫和混合型資料庫都將漸漸消亡,原因如下:數據增長速度很快,對存儲設備(主記憶體和SSD)的需求也將不斷上升,隨著主記憶體和SSD中壓縮列所佔百分比的提高,列式資料庫隨機讀的弱點反而變成了優點,這樣列式資料庫不管是應付聯機事務處理,還是大批量更新或大型報表需要執行的複雜查詢都能應付自如。對於更新操作而言,列式資料庫和行式資料庫在這方面已經沒有多大差距了,因為大部分更新操作只會影響到一行中的一到三列(欄位),同時,大部分更新操作影響的是最近的數據,因此主記憶體/SSD快取中數據會越來越多。對於插入和刪除操作而言,先在記憶體中快速更新索引,然後再寫入磁碟,這意味著在I/O密集型情況下也不會有明顯的性能下降。對在線備份而言,按列存儲方法壓縮數據後備份時間窗口將會更短。
對今天的數據倉庫而言,列式資料庫的性能和傳統行資料庫相比,根本不在一個數量級上,列式資料庫已經得到了廣泛的認可和使用(Sybase IQ已經有十年歷史,也出現了一些新興列式資料庫公司,如Vertica),資料庫巨人Oracle也按捺不住,在其Exadata資料庫機中也加入了按列存儲選擇,IBM則提供了一個列式專用設備,它可以確定什麼數據該按列存儲,什麼數據該按行存儲,然後將事務分流到相應的設備。
1.2.3、列式資料庫優缺點
列式資料庫從一開始就是面向大數據環境下數據倉庫的數據分析而產生,它跟行式資料庫相比當然也有一些前提條件和優缺點.
列式資料庫優點:
- 極高的裝載速度 (最高可以等於所有硬碟IO 的總和,基本是極限了)
- 適合大量的數據而不是小數據
- 實時載入數據僅限於增加(刪除和更新需要解壓縮Block 然後計算然後重新壓縮儲存)
- 高效的壓縮率,不僅節省儲存空間也節省計算記憶體和CPU.
- 非常適合做聚合操作.
缺點:
- 不適合掃描小量數據
- 不適合隨機的更新
- 批量更新情況各異,有的優化的比較好的列式資料庫(比如Vertica)表現比較好,有些沒有針對更新的資料庫表現比較差.
- 不適合做含有刪除和更新的實時操作.
1.2.4、常見誤區
一個常見的誤區認為如果每次掃描較多行或者全列全表掃描的時候,行式資料庫比列式資料庫更有優勢. 事實上這只是行式資料庫認識上的一個誤區,即認為列式資料庫的主要優勢在於其列分開儲存,而忽略了列式資料庫上面提到的其他幾大特徵,這個才是列式資料庫高性能的核心.
1.3、文檔型資料庫
MongoDB是一個介於關係資料庫和非關係資料庫之間的產品,是非關係資料庫當中功能最豐富,最像關係資料庫的。他支援的數據結構非常鬆散,是類似json的bjson格式,因此可以存儲比較複雜的數據類型。Mongo最大的特點是他支援的查詢語言非常強大,其語法有點類似於面向對象的查詢語言,幾乎可以實現類似關係資料庫單表查詢的絕大部分功能,而且還支援對數據建立索引。
整體架構:
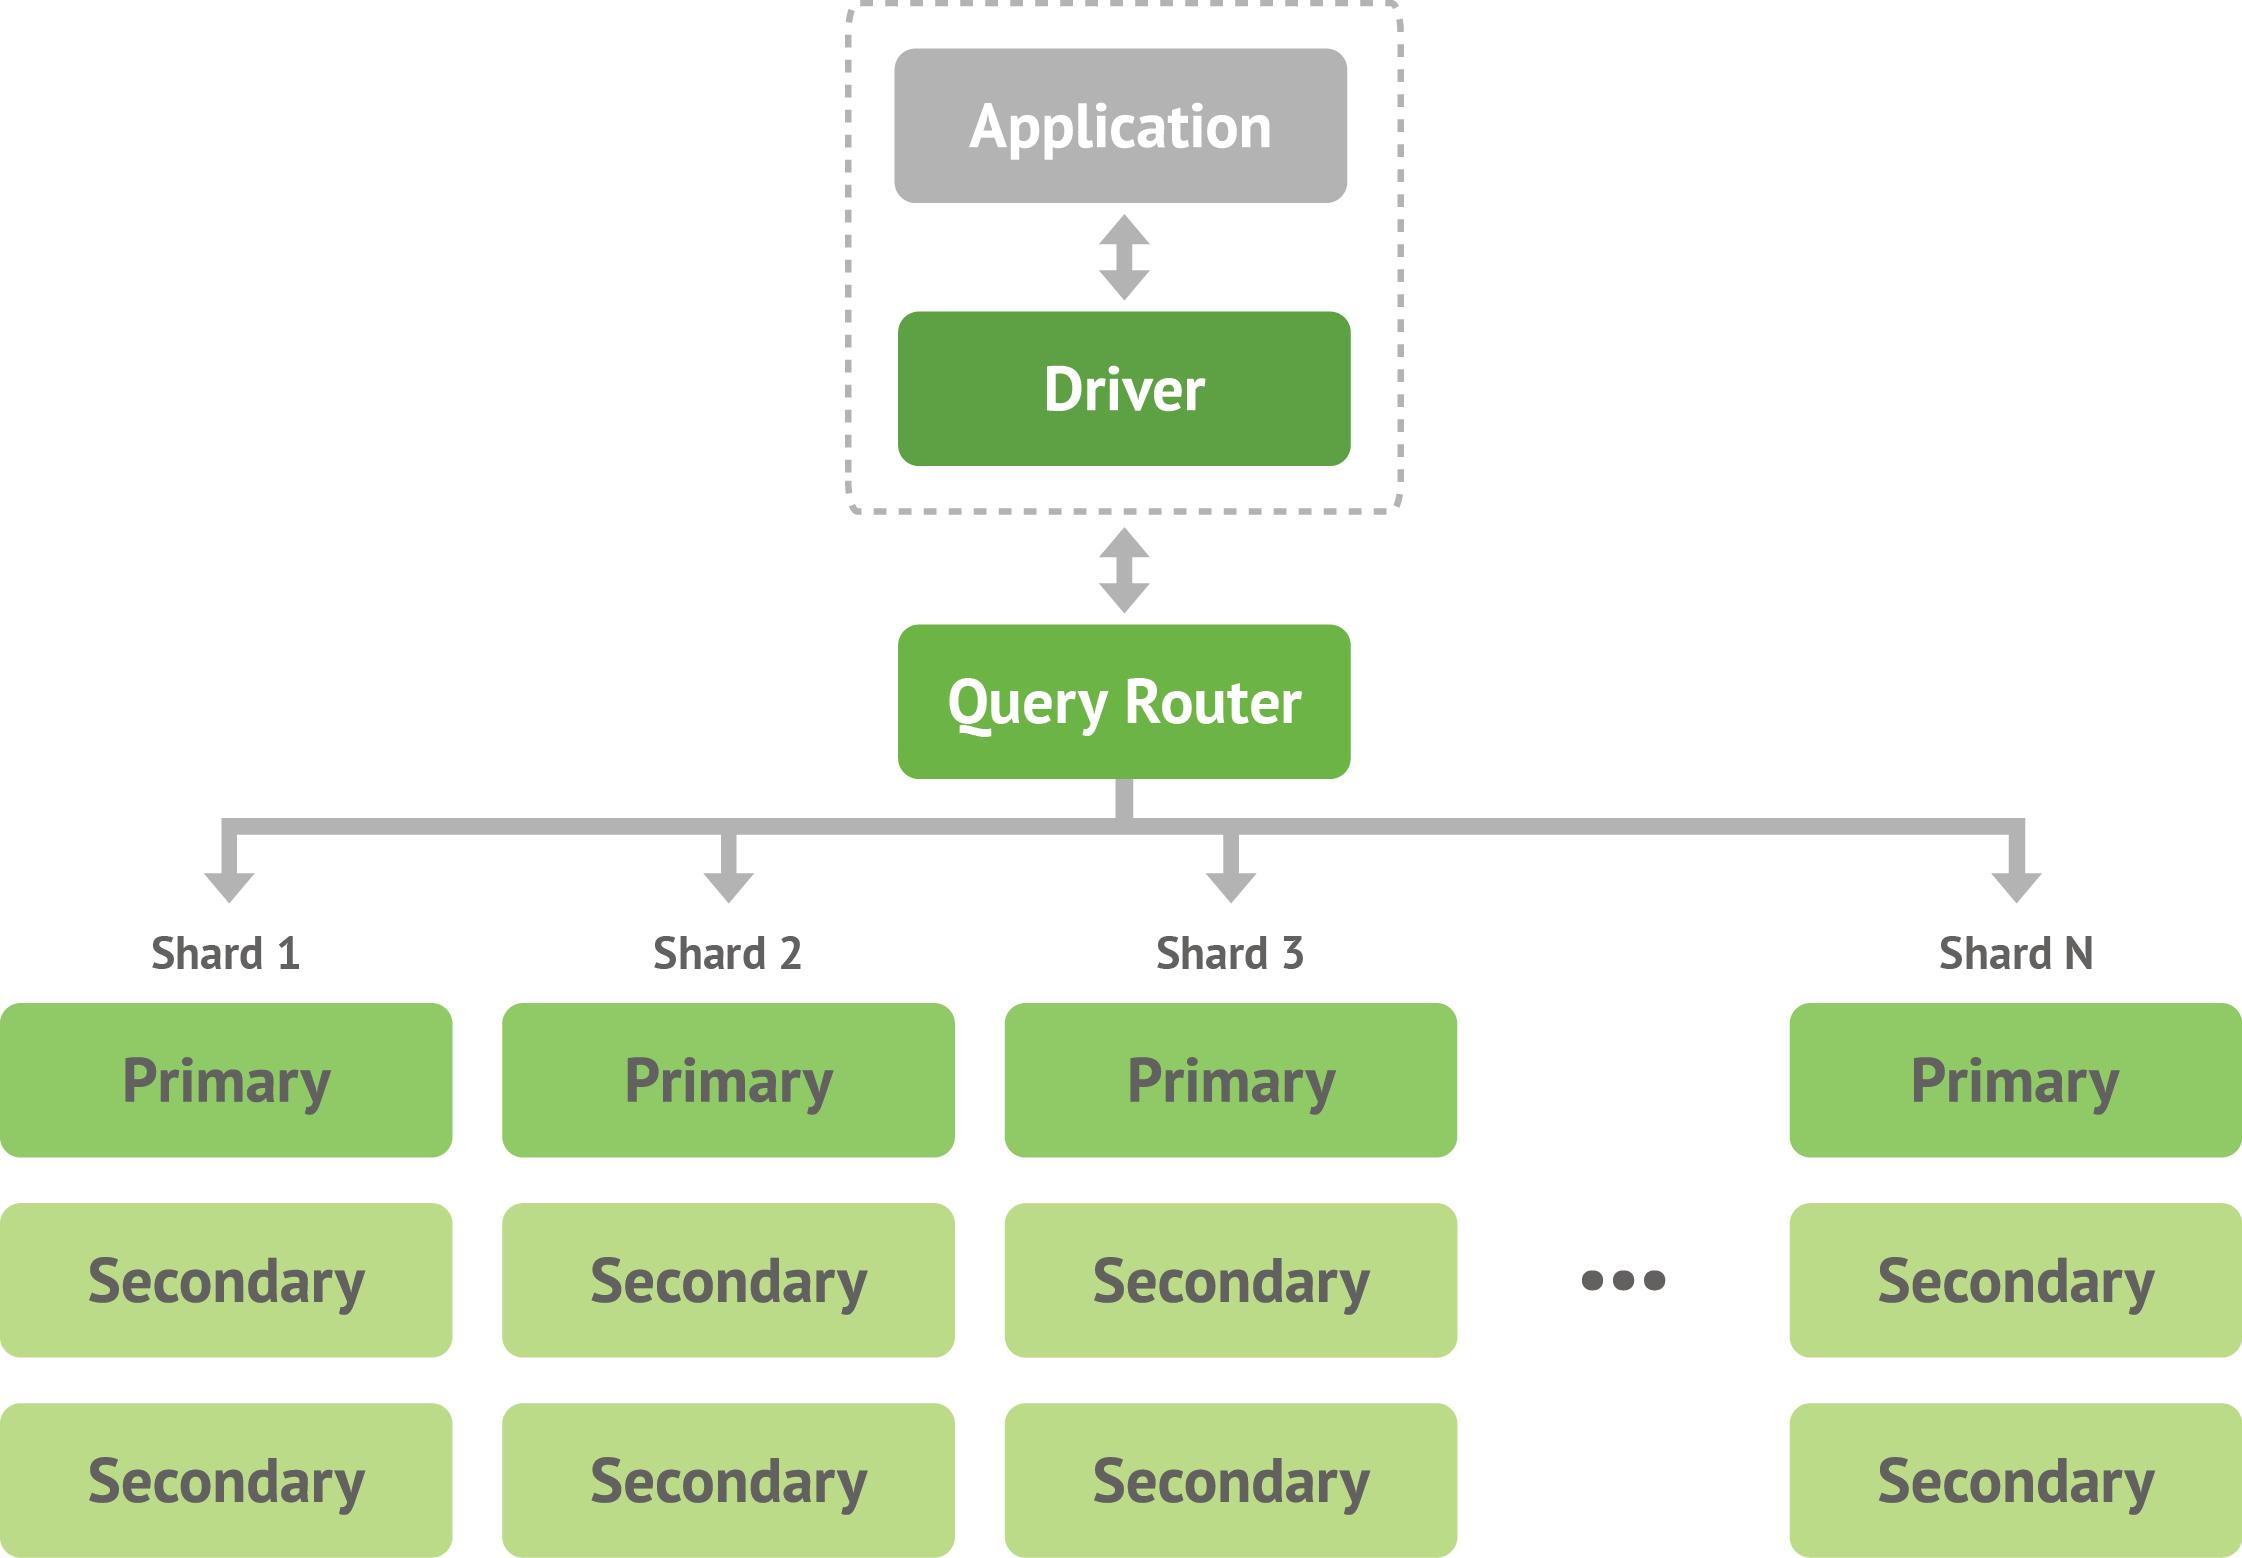
內部架構:

它的特點是高性能、易部署、易使用,存儲數據非常方便。主要功能特性有:
-
面向集合存儲,易存儲對象類型的數據。
-
模式自由。
-
支援動態查詢。
-
支援完全索引,包含內部對象。
-
支援查詢。
-
支援複製和故障恢復。
-
使用高效的二進位數據存儲,包括大型對象(如影片等)。
-
自動處理碎片,以支援雲計算層次的擴展性
-
支援RUBY,PYTHON,JAVA,C++,PHP等多種語言。
-
文件存儲格式為BSON(一種JSON的擴展)
-
可通過網路訪問
所謂「面向集合」(Collenction-Orented),意思是數據被分組存儲在數據集中,被稱為一個集合(Collenction)。每個 集合在資料庫中都有一個唯一的標識名,並且可以包含無限數目的文檔。集合的概念類似關係型資料庫(RDBMS)里的表(table),不同的是它不需要定 義任何模式(schema)。
模式自由(schema-free),意味著對於存儲在mongodb資料庫中的文件,我們不需要知道它的任何結構定義。如果需要的話,你完全可以把不同結構的文件存儲在同一個資料庫里。
存儲在集合中的文檔,被存儲為鍵-值對的形式。鍵用於唯一標識一個文檔,為字元串類型,而值則可以是各中複雜的文件類型。我們稱這種存儲形式為BSON(Binary Serialized dOcument Format)。
MongoDB服務端可運行在Linux、Windows或OS X平台,支援32位和64位應用,默認埠為27017。推薦運行在64位平台,因為MongoDB
在32位模式運行時支援的最大文件尺寸為2GB。
MongoDB把數據存儲在文件中(默認路徑為:/data/db),為提高效率使用記憶體映射文件進行管理。
1.4、NewSql
很多企業都需要處理來自多個數據源的複雜數據,因此需要利用資料庫管理系統來存儲和管理數據。現在,有很多不同類型的資料庫系統,而找到一個正確的資料庫不是一件容易的事。這需要考慮業務需求,以便選擇正確的資料庫管理系統。
企業使用關係資料庫管理系統(RDBMS)來存儲和管理他們的數據。然而,這些系統無法處理海量的複雜數據,無法滿足當今資料庫用戶的需求。因此,很多企業都在尋找能夠在保持傳統資料庫系統重要特性的同時,也能提供可伸縮性、可用性和高性能的資料庫系統。資料庫軟體供應商也已經確定了這一需求,並開發了NewSQL資料庫來彌補傳統資料庫系統的缺陷。
NewSQL資料庫在不放棄傳統資料庫優勢的前提下解決了問題。NewSQL關係資料庫管理系統為OLTP提供了與NoSQL系統相同的可伸縮性能,在保證傳統資料庫系統的ACID的同時,也能處理在線事務的讀寫工作負載。NoSQL資料庫使用的數據結構與關係資料庫中使用的數據結構不同,這使得NoSQL資料庫中的某些操作更快。
1.4.1、什麼是 NewSQL 資料庫
NewSQL資料庫是現代SQL資料庫,它解決了與傳統聯機事務處理(OLTP)RDBMS相關的一些主要問題。它們在保持傳統資料庫管理系統優點的同時,力求實現NoSQL資料庫的可伸縮性和高性能。換句話說,NewSQL資料庫是一種特殊的關係資料庫系統,它結合了傳統資料庫OLTP 和NoSQL的高性能和可伸縮性。它們保持了傳統DBMS的ACID(原子性、一致性、隔離性和持久性)。ACID事務特性確保了完整的業務流程、並發事務、系統故障或錯誤時的數據完整性,以及事務前後的一致性。
NewSQL資料庫在內部設計方面有所不同,但它們都是運行在SQL上的rdbms。它們使用SQL來接收新資訊,同時執行許多事務,並修改資料庫的內容。NewSQL系統的主要包括新的技術架構、透明的數據分片中間件、SQL引擎和資料庫即服務(DBaaS)。
分區/分片:幾乎所有的NewSQL資料庫管理系統都是通過將資料庫劃分為不同的子集(稱為分區或分片)來擴展的。資料庫中的表被水平地分割成幾個分片,這些分片的邊界基於列值來劃分,來自不同表的相關片段被連接以創建分區。
副本: 此功能允許資料庫用戶創建和維護資料庫以及副本。資料庫的副本存儲在與主站相連接的遠程站點或距離很遠的站點。用戶可以同時更新副本,也可以更新一個節點並將結果狀態轉移到其他副本
輔助索引(二級索引): 輔助索引允許資料庫用戶通過使用主鍵以外的其他值有效地訪問資料庫記錄。
並發控制: 此功能可解決多用戶系統中當多個用戶同時訪問或修改數據時可能出現的問題。NewSQL系統使用此功能來確保同步事務,同時保持數據完整性。
故障恢復:NewSQL資料庫有一種故障恢復的機制,使它們能夠在系統崩潰時恢複數據到一致的狀態。
其中一些好處包括:
- 資料庫分區減少了系統的通訊開銷,從而可以輕鬆地訪問數據。
- 即使出現系統故障或錯誤,ACID事務也可以確保數據的完整性。
- NewSQL資料庫可以處理複雜的數據。
- NewSQL系統具有高度可伸縮性。
1.4.2、常用的NewSql
Vitess(開源)
Vitess 是一個分散式 MySQL 工具集,它可以自動分片存儲 MySQL 數據表,將單個 SQL 查詢改寫為分散式發送到多個 MySQL Server 上,支援行快取(比 MySQL 本身快取效率高)與複製容錯等。Vitess 4.0 中有許多改進,可以使新用戶更容易使用,可以很容易的在k8s上部署Vitess,從單一的 MySQL 或 MariaDB 遷移到Vitess 成為可能,而應用對此有所感知。
CockroachDB(免費)
CockroachDB (蟑螂資料庫)是一個可伸縮的、支援地理位置處理、支援事務處理的數據存儲系統。CockroachDB 提供兩種不同的的事務特性,包括快照隔離(snapshot isolation,簡稱SI)和順序的快照隔離(SSI)語義,後者是默認的隔離級別。
蟑螂是一個分散式的K/V數據倉庫,支援ACID事務,多版本值存儲是其首要特性。主要的設計目標是全球一致性和可靠性,從蟑螂的命名上是就能看出這點。蟑螂資料庫能處理磁碟、物理機器、機架甚至數據中心失效情況下最小延遲的服務中斷;整個失效過程無需人工干預。蟑螂的節點是均衡的,其設計目標是同質部署(只有一個二進位包)且最小配置。CockroachDB 無需重新配置,也無需進行大規模的架構大修 就可以水平擴展,只需在集群中添加一個新節點就可以了,CockroachDB就會處理底層的複雜性。
- 只需向集群添加新節點即可進行擴展
- 自動平衡和分配分段的範圍,不是分片
- 在所有節點上均勻地優化,以提升伺服器利用率
TiDB (企業版收費)
TiDB 是一款定位於在線事務處理/在線分析處理( HTAP: Hybrid Transactional/Analytical Processing)的融合型資料庫產品,實現了一鍵水平伸縮,強一致性的多副本數據安全,分散式事務,實時 OLAP 等重要特性。同時兼容 MySQL 協議和生態,遷移便捷,運維成本極低。但是從使用情況來看,它對硬體要求較高。目前也分社區版和企業版。
ClustrixDB(收費)
MariaDB 2018年收購了ClustrixDB,它目前是一個類MYSQL的關係資料庫, 可以很容易的從MySQL遷移 到ClustrixDB。ClustrixDB與MySQL客戶機兼容,但與mazon Aurora不同,它是分散式的,可以擴展寫操作,並且不會產生單獨的IO和存儲費用,它從底層就支援web、移動和物聯網(IoT)等具有最極端的可擴展性要求的應用程式,並且是在不損害關鍵特性的情況下做到這一點,資料庫需要為帶有關鍵型任務應用程式提供對可靠數據訪問服務:事務和SQL。
MemSQL(收費)
MemSQL最大的賣點就是性能,同時兼容兼容MySQL。MemSQL,2012年12月14日發布,是世界上最快的關係資料庫,能實現每秒150萬次事務。MemSQL是一個分散式的、高度可伸縮的SQL資料庫,可以在任何地方運行。我們使用熟悉的關係模型為事務性和分析性工作負載提供最高性能.MemSQL是一個可擴展的SQL資料庫,它不斷地吸收數據,為您的業務一線執行操作分析。使用ACID事務每秒接收數百萬個事件,同時以關係SQL、JSON、地理空間和全文搜索格式分析數十億行數據。
NuoDB(商用需要授權)
NuoDB 是世界上首個也是唯一一個具有專利的、彈性可伸縮的SQL關係資料庫,主要用於去集中化的計算資源。我們完全從頭開始設計這麼一個全新的資料庫,100% ACID 保證以及兼容 SQL 標準規範。支援複雜資料庫管理任務如分區、快取集群和性能調優等等。
Altibase(商用收費)
ALTIBASE 資料庫完美結合了,並提出了一個新概念---Hybrid DBMS。ALTIBASE 提供高性能、容錯能力和事務管理的方便性,特別是在通訊、網上銀行、證券交易、實時應用和嵌入式系統領域。
VoltDB(商用收費)
VoltDB是一個記憶體中的開源OLTP SQL資料庫,能夠保證事務的完整性(ACID)。它是Postgres和Ingres聯合創始人Mike Stonebraker領導開發的下一代開源資料庫管理系統。它能在現有的廉價伺服器集群上實現每秒數百萬次數據處理。VoltDB大幅降低了伺服器資源 開銷,單節點每秒數據處理遠遠高於其它資料庫管理系統。不同於NoSQL的key-value儲存,VoltDB能使用SQL存取,支援傳統資料庫的 ACID模型。VoltDB程式碼採用GPLv3授權,支援訂閱費用從15,000美元起步。
Citus(商用收費)
Citus面向高速簡單的事務,高吞吐量批量載入以及高速亞秒級分析查詢。它還集成了cstore/hll等很多插件。一個限制是在某些情況下它不支援所有SQL查詢或複雜事務。CitusDB採用PostgreSQL的插件形式(not a fork),即享受PostgreSQL的強大支援,又同時擁有分散式資料庫能力。Citus的企業版是要收費的。
2、K-V資料庫之Redis
在寫這個中間件前想了很多,因為現在一畢業的人你一問他快取,他都知道用Redis,從09年出現Redis到現在,這玩意已經很成熟和大眾化了,所以在規劃中間件文章時想了很久要怎麼寫才能寫出一些新的識知的東西,思考很久後我想了想,正是因為會很的人都會把東西直接放Redis中,如果不明白什麼東西應該放Redis中什麼不該放,如果不明白怎麼合理使用Redis中提供的不同的數據類型及規劃Redis的使用,那麼這種盲目的使用其實對系統來說並不見得是對性能的提升反而是一場災難。
2.1、Redis概述
什麼是Nosql:Nosql叫做非關係型資料庫,為了解決高並發、高可用、高可擴展,大數據存儲等一系列問題而產生的資料庫解決方案。
Redis是使用ANSI C語言開發的一個高性能Key-Value資料庫,是當今速度最快的記憶體型非關係型(NoSQL)資料庫,可以存儲鍵和五種不同類型的值之間的映射。鍵的類型只能為字元串,值支援五種數據類型:字元串、列表、集合、散列表、有序集合。
Redis 支援很多特性,例如將記憶體中的數據持久化到硬碟中,使用複製來擴展讀性能,使用分片來擴展寫性能。
2.2、Redis數據類型說明
2.2.1、String類型
- get:獲取key對應的vlaue
- set:為一個key設置value,可配合ex/px參數設置key的有效期
- getset:為一個Key設置value,並返回該key的原value
- mget:獲取多個key對應的value
- mset:為多個key設置value
- incr/incrby:將key對應的value自增1(或者指定的整型數值),並返回自增後的值。
- decr/decrby:同上,自減
- del:刪除指定key
- setex:設置指定key的過期時間,單位為秒
- setnx:將key的值設置為value,如果key存在,返回0不做任何處理,否則返回1
應用場景:String是最常用的一種數據類型,普通的key/value存儲都可以化為此類,即可以完全實現目前Memcached的功能,並且效率更高。還具有Redis的持久化,操作日誌以及Replication等功能。除了和Memcached一樣有get set incr decr等操作外,Redis還具有如下操作:
- 獲取字元串長度
- 對字元串append內容
- 設置和獲取字元串的某一段內容
- 設置和獲取字元串的某一位bit
- 批量設置一系列字元串的內容
使用場景:常規key-value快取應用。常規計數:微博數、粉絲數。
實現方式:String在redis內部存儲默認就是一個字元串,被redisObject所引用,當遇到incr ,decr等操作時會轉成數值型進行計算,此時redisObject的encoding欄位為int
2.2.2、Hash 散列類型
key-value ,單點登錄時採用這種數據結構存儲用戶資訊,key為cookieId,value存放結構化對象。常用命令:
- hset:將Key對應的hash中的field設置為value。如果該hash不存在,會自動創建一個。
- hget:返回指定hash中field欄位的值。
- hmset/hmget:同hset和hget,可以批量操作同一個key下的多個field。
- hgetall:謹慎使用,為完整遍歷,耗時!—以數組形式返回哈希表中,所有的欄位和值。緊跟每個欄位名(field name)之後是欄位的值 (value),所以返 回值的長度是哈希表大小的兩倍。
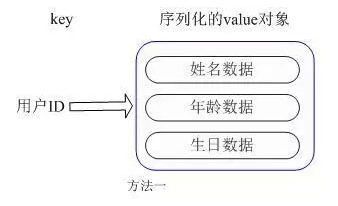
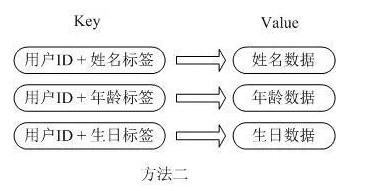
用戶ID為查找的key,存儲的value用戶對象包含姓名、年齡、生日等資訊,如果用普通的key/value結構來存儲,主要有兩種方式:
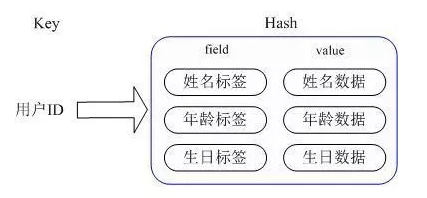
使用場景:存儲部分變更數據,如用戶資訊。
實現方式:Redis的Hash數據類型對應的Value內部實際就是一個HashMap,有兩種不同實現: 當hash成員比較少時,Redis為了節省記憶體會採用類似一維數組的方式來緊湊存儲,而不會採用真正的HashMap結構,此時對應的value redisObject的encoding為zipmap。 當成員數量增大時,會自動轉成真正的HashMap,此時的encoding為ht。
2.2.3、List類型
常用命令:
- LPOP key :移出並獲取列表的第一個元素
- RPOP key :移除列表的最後一個元素,返回值為移除的元素。
- LPUSH key value1 [value2] :將一個或多個值插入到列表頭部
- RPUSH key value1 [value2] :在列表中添加一個或多個值
- LRANGE key start stop: 獲取列表指定範圍內的元素
應用場景:Redis list的應用場景非常多,也是redis最重要的數據結構之一,比如twitter的關注列表,粉絲列表等都可以用redis的list結構來實現。
List就是鏈表,使用List結構,我們可以實現最新消息排行等功能。List的另一個應用就是消息隊列。
可以利用List的PUSH操作,將任務存在List中,然後工作執行緒再用POP操作將任務取出來進行執行。Redis還提供了操作List中某一段的api,可以直接查詢,刪除List中某一段的元素。
實現方式:Redis List的實現為一個雙向鏈表,即可以支援反向查找和遍歷,更方便操作,不過會帶來額外記憶體開銷,Redis內部的很多實現,包括發送緩衝隊等也是採用這個數據結構。
Redis的list是每個子元素都是String類型的雙向鏈表,可以通過push和pop操作從列表的頭部或者尾部添加或者刪除元素,這樣list既可以作為棧又可以作為隊列。
使用場景:消息隊列
使用list可以構建消息隊列系統。 比如將Redis 用作日誌收集器,實際上還是一個隊列,多個端點將日誌資訊寫入Redis,然後一個worker統一將所有日誌寫到磁碟。取出最新的N個數據的操作。記錄前N個最新登陸的用戶ID列表,超出範圍的可以從資料庫取出。
2.2.4、Set類型
Redis 的 Set 是 String 類型的無序集合。集合成員是唯一的,這就意味著集合中不能出現重複的數據。 Redis 中集合是通過哈希表實現的,所以添加,刪除,查找的複雜度都是 O(1)。 集合中最大的成員數為 232 - 1 (4294967295, 每個集合可存儲40多億個成員)。
為什麼不用JVM自帶的Set進行去重: 一般我們的系統都是集群部署,那麼使用JVM自帶的set比較麻煩,需要再起一個公共服務。
常見命令:
sadd
spop
smembers
sunion
應用場景:set對外提供的功能和list類似,但是set具有自動排重功能。並且set提供了判斷某個成員是否在一個set集合內的重要介面,這要是list所不能提供的。
案例:在微博應用中,可以將一個用戶所有的關注人存在一個集合中,將其所有粉絲存在一個集合。Redis還為集合提供了求交集、並集、差集等操作,可以非常方便的實現如共同關注、共同喜好、二度好友等功能,對上面的所有集合操作,你還可以使用不同的命令選擇將結果返回給客戶端還是存到一個新的集合中。Set是集合,是String類型的無序集合,set是通過hashtable實現的,概念和數學中個的集合基本類似,可以交集,並集,差集等等,set中的元素是沒有順序的。
實現方式:set 的內部實現是一個 value永遠為null的HashMap,實際就是通過計算hash的方式來快速排重的,這也是set能提供判斷一個成員是否在集合內的原因。
2.2.5、ZSet類型
zadd:向有序集合zset中增加一個元素。例如:zadd zset 1 Hello
zrange:輸出zset中指定範圍內的的所有元素,按照score從小到大的順序。例如:zrange zset 0 -1 withscores,表示輸出有序集合zset中所有的元素,並且輸出順序號。
zrem:刪除名稱為key的zset集合中的元素member。例如:zrem set1 Hello。
zincrby:把有序集合zset中的指定元素的序列號加上指定的值。例如:zincrby zset 4 Hello
zrank:返回名稱為key的zset集合中元素的排名,按照下標從小到大的排名。例如:zrank zset Hello。
zrevrank:返回名稱為key的zset集合中元素的排名,按照下表從大到小的排名。例如:zrevrank zset Hello。
zrevrange:按照score從大到小的順序輸出集合中所有元素。例如:zrevrange zset 0 -1 withscores。
zrangebyscore:返回集合中給定區間的元素。例如:zrangebyscore zset 2 3 withscores
zcount:返回集合中score在給定區間的數量。zcount zset 2 3
zcard:返回集合中元素的個數。
zremrangebyrank:按照索引來刪除給定區間的元素。例如:zremrangebyrank zset 1 2
zremrangebyscore:刪除score在指定範圍內的元素。例如:zremrangebyscore zset 1 2
2.2.6、Geospatial
2.2.7、HyperLogLog
- pfadd ,Redis Pfadd 命令將所有元素參數添加到 HyperLogLog 數據結構中。
- pfcount,Redis Pfcount 命令返回給定 HyperLogLog 的基數估算值。
- pgmerge,Redis Pgmerge 命令將多個 HyperLogLog 合併為一個 HyperLogLog ,合併後的HyperLogLog 的基數估算值是通過對所有 給定 HyperLogLog 進行並集計算得出的。
2.2.8、Bit

常見命令:
getbit 指令:獲取到 key 對應的 value 在 offset 處的 bit 值。
setbit 指令:修改 key 對應的 value 在 offset 處的 bit 值
bitcount 指令:統計二進位數據中 1 的個數

