架構師必備:多維度查詢的最佳實踐
- 2022 年 5 月 22 日
- 筆記
- 架構, MySQL, elasticsearch, 多維度查詢
背景
有2種常見的多維度查詢場景,分別是:
- 帶多個篩選條件的列表查詢
- 不含分庫分表列的其他維度查詢
普通的資料庫查詢,很難實現上述需求場景,更不用提模糊查詢、全文檢索了。
下面結合樓主的經驗和知識,介紹初級方案、進階方案(上ElasticSearch),大部分情況下推薦使用ElasticSearch來實現多維度查詢,趕時間的讀者可以直接跳到「進階方案:將ElasticSearch添加到現有系統中」。
初級方案
1、根據常見查詢場景,增加相應欄位的組合索引
這個是為了實現帶多個篩選條件的列表查詢的。
優點
- 非常簡單
- 讀寫不一致時間較短:取決於資料庫主從同步延時,一般為毫秒級別
缺點
- 非常局限:除非篩選條件比較固定,否則難以應付後續新增或修改篩選條件
- 如果每次來新的篩選查詢欄位的需求,就新增索引,最終導致索引過於龐大,影響性能
於是就出現了經典的一幕:產品提需求說要支援某個新欄位的篩選查詢,開發回饋說做不了、或者成本很高,於是不了了之 :)
2、異構出多份數據
更加優雅的方式,是異構出多份數據。
例如,C端按用戶維度查詢,B端按店鋪維度查詢,如果還有供應商,按供應商維度查詢。一個資料庫只能按一種維度來分庫。
(1)程式寫入多個數據源
優點是:非常簡單。
缺點
- 跨庫寫存在一致性問題(除非不同維度的表使用公共的分庫,事務寫入),性能低
- 不能靈活支援更多其他維度的查詢
(2)藉助Canal實現數據的自動同步
通過Canal同步數據,異構出多個維度的數據源。詳見之前寫的這篇文章:架構師必備:巧用Canal實現非同步、解耦的架構

優點是:更加優雅,無需改動程式主流程。
缺點
- 仍然無法解決不斷變化的需求,不可能為了支援新維度就異構出一份新數據
進階方案:將ElasticSearch添加到現有系統中
應用架構
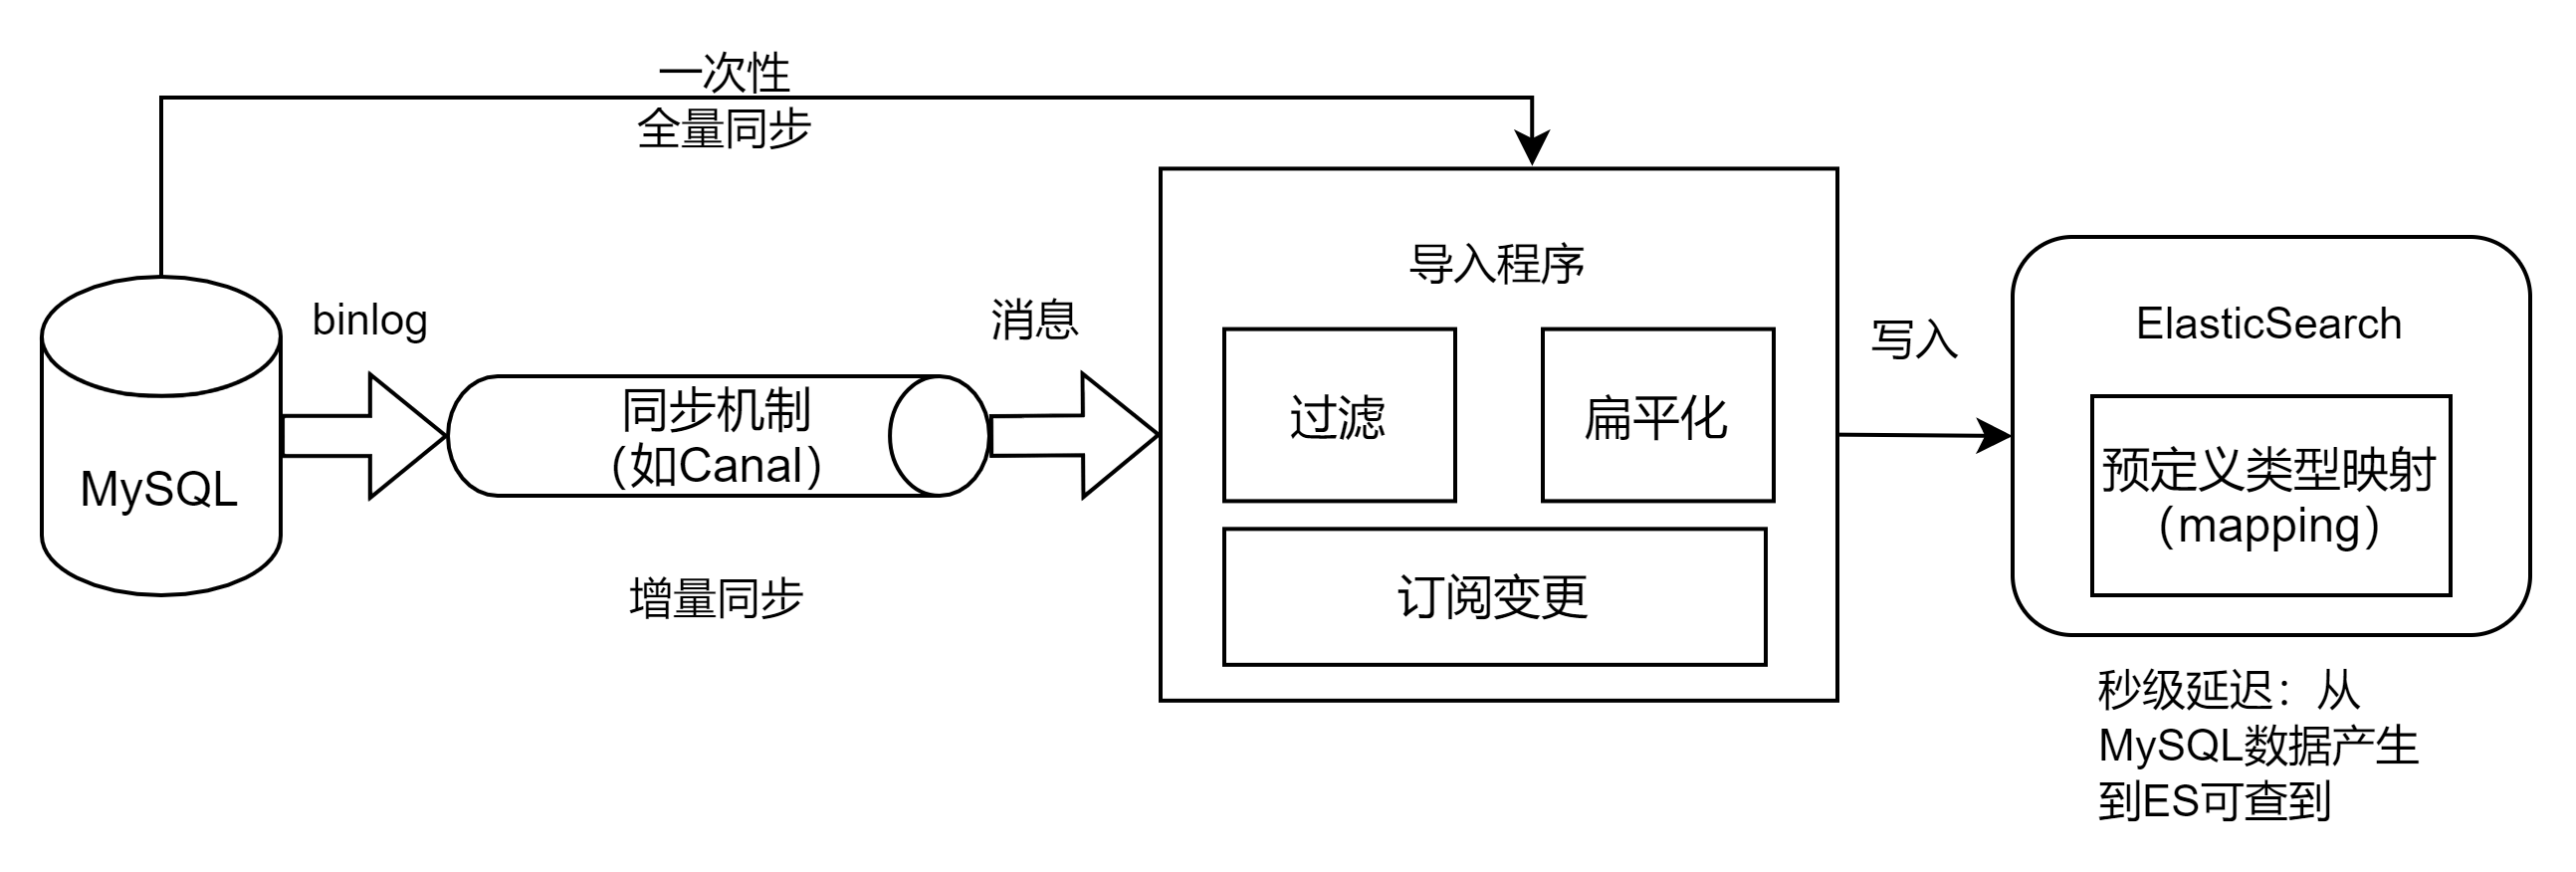
現有系統一般都會用到MySQL資料庫,需要引入ES,為系統增強多維度查詢的功能。
MySQL繼續承擔業務的實時讀寫請求、事務操作,ES承擔近實時的多維度查詢請求,ES可支撐十萬級別qps(取決於節點數、分片數、副本數)。
需要注意的是:同步數據至ES是秒級延遲(主要耗費在索引refresh),而查詢已進入索引的文檔,是在數毫秒到數百毫秒級別。

導入數據
需要同步機制,來把MySQL中的數據導入到ES中,主要流程如下:
- 預先定義ES索引的mapping配置,而不依賴ES自動生成mapping
- 初始全量導入,後續增量導入:Canal+MQ數據管道同步,不需要或僅需少量程式碼工作
- 數據過濾:不導入無需檢索的欄位,減小索引大學,提高性能
- 數據扁平化處理:如果資料庫中有json欄位列,需要從中提取業務欄位,避免嵌套類型的欄位,提高性能
查詢數據
-
從ES 8.x版本開始,建議使用Java api client,並且要Java 8及以上環境,因為可使用各種lambda函數,來提高程式碼可讀性
- 優點是新客戶端與server程式碼完全耦合(相比於原Java transport client,在8.x版本已廢棄),並且API風格與http rest api很接近(相比於原Java rest client,在8.x版本已廢棄),只要熟練掌握http json請求體寫法,即可快速上手。
- 底層使用的還是原來的low level rest client,實現了http長連接、訪問ES各節點的負載均衡、故障轉移,最底層依賴的是apache http async client。
-
ES 7.x版本及以下,或使用Java 7及以下,建議升級,否則就只能繼續用high level rest client。
程式碼示例如下(含詳細注釋):
public class EsClientDemo {

    // demo演示:創建client,然後搜索
    public void createClientAndSearch() throws Exception {
        // 創建底層的low level rest client,連接ES節點的9200埠
        RestClient restClient = RestClient.builder(
            new HttpHost("localhost", 9200)).build();

        // 創建transport類,傳入底層的low level rest client,和json解析器
        ElasticsearchTransport transport = new RestClientTransport(
            restClient, new JacksonJsonpMapper());

        // 創建核心client類,後續操作都圍繞此對象
        ElasticsearchClient esClient = new ElasticsearchClient(transport);


        // 多條件搜索
        // fluent API風格,並且使用lambda函數提高程式碼可讀性,可以看出Java api client的語法,同http json請求體非常相似
        String searchText = "bike";
        String brand = "brandNew";
        double maxPrice = 1000;

        // 根據商品名稱,做match全文檢索查詢
        Query byName = MatchQuery.of(m -> m
            .field("name")
            .query(searchText)
        )._toQuery();

        // 根據品牌,做term精確查詢
        Query byBrand = new Query.Builder()
            .term(t -> t
                .field("brand")
                .value(v -> v.stringValue(brand))
            ).build();

        // 根據價格,做range範圍查詢
        Query byMaxPrice = RangeQuery.of(r -> r
            .field("price")
            .lte(JsonData.of(maxPrice))
        )._toQuery();

        // 調用核心client,做查詢
        SearchResponse<Product> response = esClient.search(s -> s
            .index("products")  // 指定ES索引
            .query(q -> q       // 指定查詢DSL
                .bool(b -> b    // 多條件must組合,必須同時滿足
                    .must(byName)
                    .must(byBrand)
                    .must(byMaxPrice)
                )
            ),
            Product.class
        );

        // 遍曆命中結果
        List<Hit<Product>> hits = response.hits().hits();
        for (Hit<Product> hit: hits) {
            Product product = hit.source();  // 通過source獲取結果
            logger.info("Found product " + product.getName() + ", score " + hit.score());
        }
    }

}
可參閱://www.elastic.co/guide/en/elasticsearch/client/index.html
數據模型轉換
因為既有MySQL,又有ES,所以有2種異構的數據模型。需要在程式碼中定義2種數據模型,並且實現類型互相轉換的工具類。
- MySQL數據VO
- ES數據VO
- MySQL數據VO、ES數據VO互相轉換工具
- 業務層BO
- 介面DTO
原理概要
ES之所以比MySQL,能勝任多維度查詢、全文檢索,是因為底層數據結構不同:
- ES倒排索引
- 如果是全文檢索欄位:會先分詞,然後生成 term -> document 的倒排索引,查詢時也會把query分詞,然後檢索出相關的文檔。相關度演算法如TF-IDF(term frequency–inverse document frequency),取決於:詞在該文檔中出現的頻率(TF,term frequency),越高代表越相關;以及詞在所有文檔中出現的頻率(IDF,inverse document frequency),越高代表越不相關,相當於是一個通用的詞,對相關性影響較小。
- 如果是精確值欄位:則無需分詞,直接把query作為一個整體的term,查詢對應文檔。
- 因為文檔中的所有欄位,都生成了倒排索引,所以能處理多維度組合查詢
- MySQL B+樹
- B+樹的非葉子節點記錄了孩子節點值的範圍,而葉子節點記錄了真正的一組值,並且在同一層,形成了一個有序鏈表
- 組合索引需要顯式創建:選擇需索引的欄位、並且順序是重要的,所以如果待查詢的欄位不在索引中,就無法高效查詢,可能演變為全表掃描(對聚簇索引的葉子節點做一次遍歷)
另外簡要回顧一下ES的架構要點:
- 節點分為主節點、數據節點,一個節點上可以有多個分片,分片分為主分片、副本分片,1對多,主分片與副本分片分布在不同的節點,來實現高可用
- 主分片數在創建時,就需要指定,在創建後不能隨意更改(如果變化,路由就會出錯);而副本分片可以增加,來提高ES集群的查詢QPS
- 路由演算法:id % 主分片數,如果創建文檔時不指定id,則ES會自動生成;一般會傳自定義業務id
優點、缺點
優點
- 支援各欄位的多維度組合查詢,無懼未來新增欄位(主要成本在於新增欄位後、重建索引)
- 與現有系統完全解耦,適合架構演進
- 在數據量級上遠勝Mysql,最大支援PB級數據的存儲和查詢
缺點
- 讀寫不一致時間在秒級:因為有2個耗時階段,一是同步階段將數據從MySQL資料庫寫入ES,二是ES索引refresh階段,數據從buffer寫入索引後才可查到
- 因此一個trick就是,在寫入操作後,前端延遲調用後端的列表查詢介面,比如延遲1秒後再展示
- 超高並發下存在瓶頸,存在穩定性問題:目前原生版本支援大約 3-5 萬分片,性能已經到達極限,創建索引基本到達 30 秒+ 甚至分鐘級。節點數只能到 500 左右基本是極限了。但依然能滿足絕大部分場景。數據來源://elasticsearch.cn/slides/259#page=30
ES最佳實踐
- 只把需要搜索的數據導入ES,避免索引過大
- 數據扁平化,不用嵌套結構,提高性能
- 合理設置欄位類型,預先定義mapping配置,而不依賴ES自動生成mapping
- 精確值的類型指定為keyword(mapping配置),並且使用term查詢
- 精確值是指無需進行range範圍查詢的欄位,既可以是字元串,比如書的作者名字,也可以是數值,比如商品id、訂單id、圖書ISBN編號、枚舉值。在使用中,大部分場景是以id類作為精確值
- 避免無路由查詢:無路由查詢會並發在多個索引上查詢、歸併排序結果,會使得集群cpu飆升,影響穩定性
- 避免深度分頁查詢:如有大量數據查詢,推薦用scroll滾動查詢
- 設置合理的文件系統快取(filesytem cache)大小,提高性能:因為ES查詢的熱數據在文件系統快取中
- ES分片數在創建後不能隨意改動,但是副本數可以隨時增加,來提高最大QPS。如果單個分片壓力過大,需要擴容。
更進一步
前面提到ES超高並發下存在瓶頸,極端情況下可能遇到OOM,因此超高並發下需要C++實現的專用搜索引擎
例如:
- 百度:通用搜索引擎,根據文字、圖片搜索資訊
- 電商垂類:電商專用搜索引擎,比如根據關鍵詞查找商品,或根據品牌、價格篩選商品,可總結為商品的搜索、廣告、推薦