詳解CVE-2022-0847 DirtyPipe漏洞
摘要:本文詳細介紹了CVE-2022-0847漏洞形成根因,相應修補程式修復方法,通過本文讓讀者對CVE-2022-0847漏洞有更清晰的了解。
本文分享自華為雲社區《CVE-2022-0847 DirtyPipe》,作者:安全技術猿。
簡介
CVE-2022-0847不需要調用特權syscall就能完成對任意只讀文件的修改(有點類似之前的臟牛,但底層原理其實不一樣),且由於利用過程中不涉及記憶體損壞,因此不需要ROP等利用方法,也自然不需要知道內核基址等資訊,故不需要對內核版本進行適配(因此可以被廣泛利用,危害巨大)。
本質上,這個漏洞是由記憶體未初始化造成的,且從2016年就存在了,但在當時並不能發生有趣的利用,直到2020年由於對pipe內部實現進行了一些修改,才讓這個「BUG」變成了能夠利用的「漏洞」。
漏洞分析
這個漏洞主要涉及到兩個syscall:
- pipe://man7.org/linux/man-pages/man2/pipe.2.html
- splice://man7.org/linux/man-pages/man2/splice.2.html
syscall pipe
pipe,我想使用linux的都不陌生它的作用,因此直接從底層實現開始說。
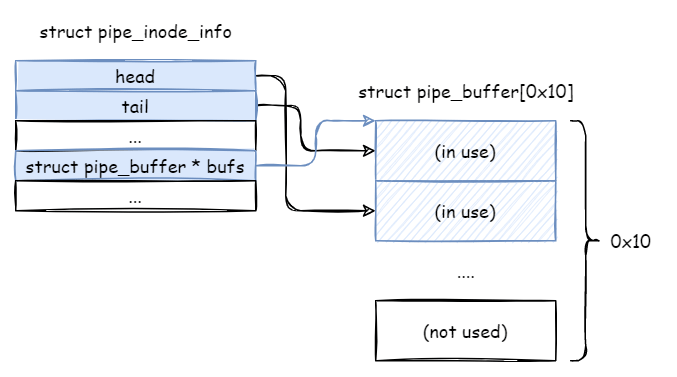
pipe在內核中使用struct pipe_inode_info進行管理,注釋中為比較重要的幾個欄位。
/**
 *    struct pipe_inode_info - a linux kernel pipe
 *    @head: The point of buffer production
 *    @tail: The point of buffer consumption
 *    @max_usage: The maximum number of slots that may be used in the ring
 *    @ring_size: total number of buffers (should be a power of 2)
 *    @tmp_page: cached released page
 *    @bufs: the circular array of pipe buffers
 **/
struct pipe_inode_info {
...
    unsigned int head;
    unsigned int tail;
    unsigned int max_usage;
    unsigned int ring_size;
...
    struct page *tmp_page;
...
    struct pipe_buffer *bufs;
...
};
pipe在內核中使用了環狀buffer(bufs欄位),而默認的數量為16個(PIPE_DEF_BUFFERS),每一個struct pipe_buffer管理一個buffer,而一個buffer為一頁的大小(默認0x1000)。pipe為FIFO的結構體,這可以從head和tail兩個欄位體現出來,head指向最新生產的buffer,而tail指向開始消費的buffer。
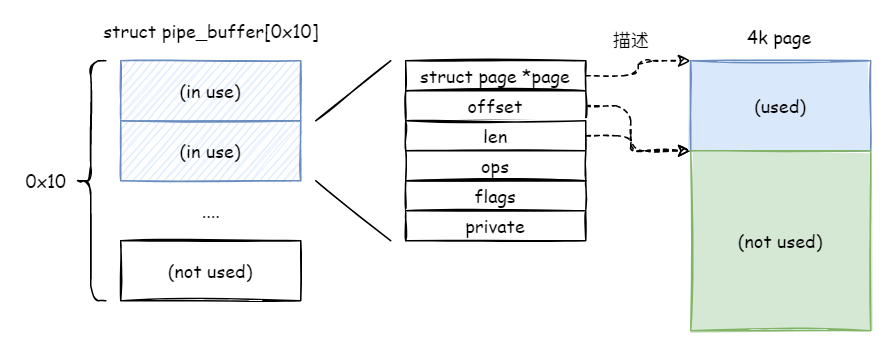
pipe_buffer為如下的結構體,其中這裡的page並不直接指向目標頁,而是一個物理頁的頁框(實際使用過程中通過kmap_atomic()獲取對應的虛擬地址)。畢竟pipe需要考慮到跨進程,這裡在結構體中使用物理頁是明知智選。
// >>> include/linux/pipe_fs_i.h:17
/**
 *    struct pipe_buffer - a linux kernel pipe buffer
 *    @page: the page containing the data for the pipe buffer
 *    @offset: offset of data inside the @page
 *    @len: length of data inside the @page
 *    @ops: operations associated with this buffer. See @pipe_buf_operations.
 *    @flags: pipe buffer flags. See above.
 *    @private: private data owned by the ops.
 **/
struct pipe_buffer {
    struct page *page;
    unsigned int offset, len;
    const struct pipe_buf_operations *ops;
    unsigned int flags;
    unsigned long private;
};
接著我們分析下pipe的使用。假設用戶向分配的pipe中寫入數據,在內核層就會進入函數pipe_write:
// >>> fs/pipe.c:415
/* 415 */ static ssize_t
/* 416 */ pipe_write(struct kiocb *iocb, struct iov_iter *from)
/* 417 */ {
/* 418 */     struct file *filp = iocb->ki_filp;
            // 拿到pipe結構體
/* 419 */     struct pipe_inode_info *pipe = filp->private_data;
/* 420 */     unsigned int head;
/* 421 */     ssize_t ret = 0;
            // total_len為此次寫入的長度
/* 422 */     size_t total_len = iov_iter_count(from);
/* 423 */     ssize_t chars;
/* 424 */     bool was_empty = false;
/* 425 */     bool wake_next_writer = false;
------
/* 457 */     head = pipe->head;
/* 458 */     was_empty = true;
            // 考慮使用merge
/* 459 */     chars = total_len & (PAGE_SIZE-1);
            // 如果len&0xFFF !=0 且當前使用的頁
/* 460 */     if (chars && !pipe_empty(head, pipe->tail)) {
/* 461 */         unsigned int mask = pipe->ring_size - 1;
/* 462 */         struct pipe_buffer *buf = &pipe->bufs[(head - 1) & mask];
/* 463 */         int offset = buf->offset + buf->len;
/* 464 */
/* 465 */         if ((buf->flags & PIPE_BUF_FLAG_CAN_MERGE) && // 可以merge
/* 466 */             offset + chars <= PAGE_SIZE) { // 小於一頁
/* 467 */             ret = pipe_buf_confirm(pipe, buf);
------
                    // 拷貝內容
/* 471 */             ret = copy_page_from_iter(buf->page, offset, chars, from);
------
/* 480 */         }
/* 481 */     }
/* 482 */
            // merge失敗,或者merge不完全,接著處理剩下的內容
/* 483 */     for (;;) {
------
/* 491 */         head = pipe->head;
                // 如果pipe沒滿
/* 492 */         if (!pipe_full(head, pipe->tail, pipe->max_usage)) {
/* 493 */             unsigned int mask = pipe->ring_size - 1;
                    // 取當前的pipe buffer
/* 494 */             struct pipe_buffer *buf = &pipe->bufs[head & mask];
/* 495 */             struct page *page = pipe->tmp_page;
/* 496 */             int copied;
/* 497 */             // 如果當前page是空的,就創建新的page
/* 498 */             if (!page) {
/* 499 */                 page = alloc_page(GFP_HIGHUSER | __GFP_ACCOUNT);
------
/* 504 */                 pipe->tmp_page = page;
/* 505 */             }
------
/* 519 */             // head++
/* 520 */             pipe->head = head + 1;
/* 521 */             spin_unlock_irq(&pipe->rd_wait.lock);
/* 522 */
/* 523 */             // 開始初始化 pipe buffer 的各個欄位
/* 524 */             buf = &pipe->bufs[head & mask];
/* 525 */             buf->page = page;
/* 526 */             buf->ops = &anon_pipe_buf_ops;
/* 527 */             buf->offset = 0;
/* 528 */             buf->len = 0;
/* 529 */             if (is_packetized(filp)) // 一般不走
/* 530 */                 buf->flags = PIPE_BUF_FLAG_PACKET;
/* 531 */             else
                        // 設置flag PIPE_BUF_FLAG_CAN_MERGE
/* 532 */                 buf->flags = PIPE_BUF_FLAG_CAN_MERGE;
/* 533 */             pipe->tmp_page = NULL;
/* 534 */
                    // 複製內容
/* 535 */             copied = copy_page_from_iter(page, 0, PAGE_SIZE, from);
------
/* 541 */             ret += copied;
/* 542 */             buf->offset = 0;
/* 543 */             buf->len = copied;
可以看到,在pipe_write中使用了merge的思想,如果我們分16次向pipe中寫入1位元組,這16位元組不會並不會分別佔用16個pipe_buffer,而是連續佔用第一個pipe_buffer。這很好理解,不然pipe就堵死了,那利用率就太低了。而負責管理merge的是struct pipe_buffer中的flags欄位PIPE_BUF_FLAG_CAN_MERGE。
相對應的,pipe_read也是通過pipe_inode_info拿到pipe_buffer進行讀取,這裡就不在分析。需要注意的是,pipe_buffer在read過程中只會被修改其offset和len欄位,並不會被釋放或是修改其flags欄位,也就是說PIPE_BUF_FLAG_CAN_MERGE一但設置,則在read/write的過程中就不會再被清除掉。
syscall splice
接著來分析一下splice這個syscall。
splice是在Linux 2.6.16中被引入的(5274f052e7b3dbd81935772eb551dfd0325dfa9d),本質上是為了解決文件對拷的效率問題,它實現了「零拷貝」。
這裡稍微展開說說零拷貝。可以思考下在Linux上你會如何實現文件對拷?
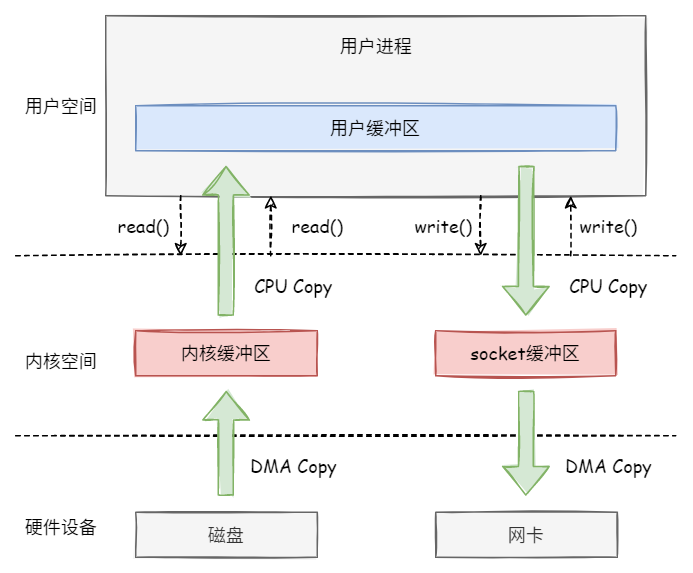
最簡單的,就是open()兩個文件,然後申請一個buffer,然後使用read()/write()來進行拷貝。但這樣效率太低,原因是一對read()和write()涉及到4次上下文切換,2次CPU拷貝,2次DMA拷貝。
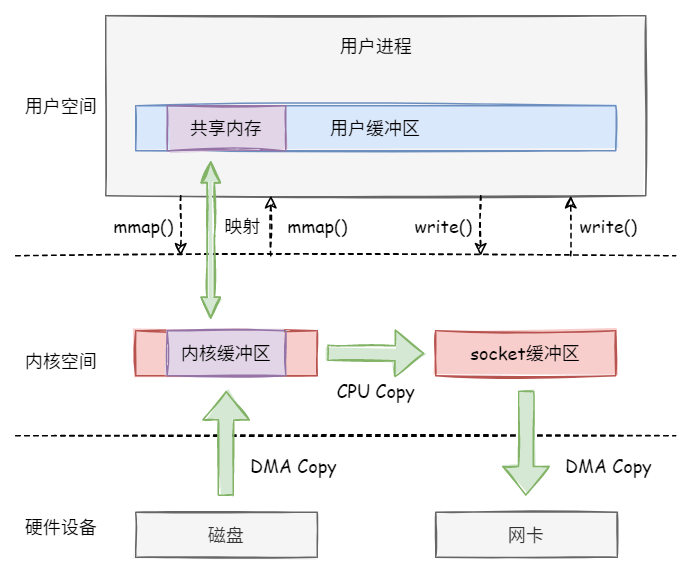
因此稍微聰明點的人,會使用mmap()+write()的組合,這樣涉及4次上下⽂切換,1次 CPU 拷⻉,2次DMA 拷⻉。
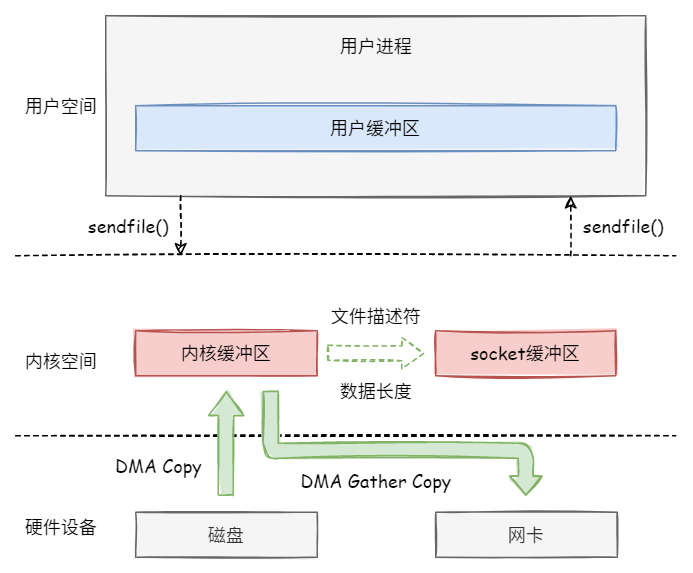
更近一步的,會使用sendfile(),調用sendfile()只需提供兩個互拷的fd,以及拷貝的長度即可。與 mmap 記憶體映射⽅式不同的是, sendfile 調⽤中 I/O 數據對⽤戶空間是完全不可⻅的。因此它只涉及2次上下⽂切換,2次DMA 拷⻉。
splice()類似,不過使用了pipe機制,從而不需要硬體的支援就能實現兩個fd間的零拷貝。它也只涉及2 次上下⽂切換,2次DMA 拷⻉。
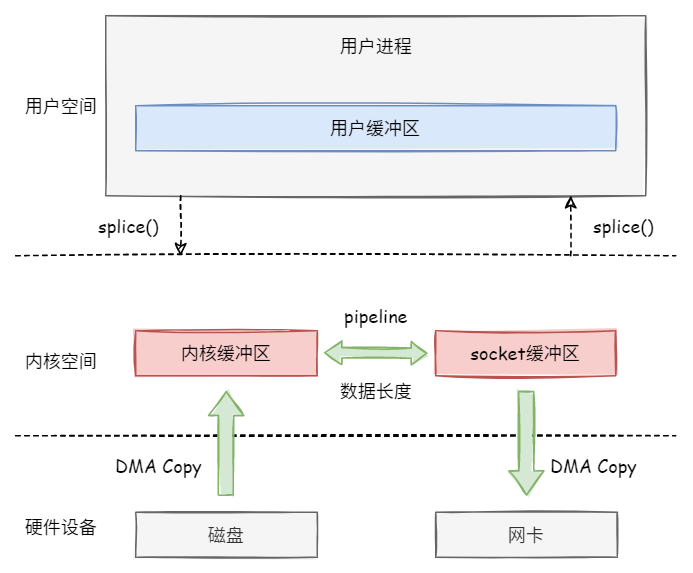
一般我們用下面的模式使用splice實現文件對拷:
int in_fd = open(file_to_read);
int out_fd = open(file_to_write);
int anon_pipes[2];
pipe(anon_pipes);

while has_content_to_copy:
    splice(in_fd,&in_off,anon_pipes[1],NULL,size);
    splice(anon_pipes[0],NULL,out_fd,&out_off,size);

close(in_fd);
close(out_fd);
可以看到,splice底層用到了pipe。splice支援對接多種設備,例如普通文件,socket等。下面我們啃一下splice的源碼,以上面的splice(in_fd,&in_off,anon_pipes[1],NULL,size);為例:
// >>> fs/splice.c:1325
/* 1325 */ SYSCALL_DEFINE6(splice, int, fd_in, loff_t __user *, off_in,
/* 1326 */         int, fd_out, loff_t __user *, off_out,
/* 1327 */         size_t, len, unsigned int, flags)
/* 1328 */ {
------
                    // splice是對__do_splice的簡單包裝
/* 1343 */             error = __do_splice(in.file, off_in, out.file, off_out,
/* 1344 */                         len, flags);
------
/* 1350 */ }
// __do_splice 是對 do_splice 的簡單包裝
// >>> fs/splice.c:1008
/* 1008 */ long do_splice(struct file *in, loff_t *off_in, struct file *out,
/* 1009 */            loff_t *off_out, size_t len, unsigned int flags)
/* 1010 */ {
------
/* 1011 */     struct pipe_inode_info *ipipe;
/* 1012 */     struct pipe_inode_info *opipe;
------
            // 從 in/out 中嘗試取得 pipe_inode_info
/* 1020 */     ipipe = get_pipe_info(in, true);
/* 1021 */     opipe = get_pipe_info(out, true);
------
            // 上面例子中in是普通文件,out是pipe,因此不進這裡
/* 1037 */     if (ipipe) {
------
/* 1068 */     }
------
            // 進這裡
/* 1070 */     if (opipe) {
------
                    // 調用 do_splice_to
/* 1093 */             ret = do_splice_to(in, &offset, opipe, len, flags);
------
/* 1104 */     }
------
/* 1107 */ }
// >>> fs/splice.c:770
/* 770 */ static long do_splice_to(struct file *in, loff_t *ppos,
/* 771 */              struct pipe_inode_info *pipe, size_t len,
/* 772 */              unsigned int flags)
/* 773 */ {
------
            // 這裡根據in的f_op->splice_read選擇對應的函數
            // 由於是普通文件,所以:
            //
            // >>> fs/read_write.c:28
            // /* 28 */ const struct file_operations generic_ro_fops = {
            // ------
            // /* 32 */     .splice_read    = generic_file_splice_read,
            // /* 33 */ };
/* 788 */     return in->f_op->splice_read(in, ppos, pipe, len, flags);
/* 789 */ }
// >>> fs/splice.c:298
/* 298 */ ssize_t generic_file_splice_read(struct file *in, loff_t *ppos,
/* 299 */                  struct pipe_inode_info *pipe, size_t len,
/* 300 */                  unsigned int flags)
/* 301 */ {
/* 302 */     struct iov_iter to;
/* 303 */     struct kiocb kiocb;
/* 304 */     unsigned int i_head;
/* 305 */     int ret;
/* 306 */
            // 從pipe中取數據,得到 to
/* 307 */     iov_iter_pipe(&to, READ, pipe, len);
/* 308 */     i_head = to.head;
/* 309 */     init_sync_kiocb(&kiocb, in);
/* 310 */     kiocb.ki_pos = *ppos;
            // 進入這裡,其實是調用in->f_op->read_iter(&kiocb,&to);
            // 即 generic_file_read_iter()
/* 311 */     ret = call_read_iter(in, &kiocb, &to);
------
/* 328 */ }
// 之後:
// generic_file_read_iter()
// -> generic_file_buffered_read()
// -> copy_page_to_iter()
// >>> lib/iov_iter.c:916
/* 916 */ size_t copy_page_to_iter(struct page *page, size_t offset, size_t bytes,
/* 917 */              struct iov_iter *i)
/* 918 */ {
------
/* 921 */     if (i->type & (ITER_BVEC|ITER_KVEC)) {
------
/* 926 */     } else if (unlikely(iov_iter_is_discard(i))) {
------
/* 931 */     } else if (likely(!iov_iter_is_pipe(i)))
/* 932 */         return copy_page_to_iter_iovec(page, offset, bytes, i);
/* 933 */     else
                // 這裡的i其實就是前面generic_file_splice_read中的to,因此是pipe
/* 934 */         return copy_page_to_iter_pipe(page, offset, bytes, i);
/* 935 */ }
// 終於來到了我們今天的主角:copy_page_to_iter_pipe
// >>> lib/iov_iter.c:375
/* 375 */ static size_t copy_page_to_iter_pipe(struct page *page, size_t offset, size_t bytes,
/* 376 */              struct iov_iter *i)
/* 377 */ {
------
/* 378 */     struct pipe_inode_info *pipe = i->pipe;
------
/* 379 */     struct pipe_buffer *buf;
------
/* 394 */     off = i->iov_offset;
------
/* 395 */     buf = &pipe->bufs[i_head & p_mask];
/* 396 */     if (off) {
------
/* 405 */     }
/* 406 */     if (pipe_full(i_head, p_tail, pipe->max_usage))
/* 407 */         return 0;
/* 408 */
            // 劃重點!!! 沒有設置buf->flags
/* 409 */     buf->ops = &page_cache_pipe_buf_ops;
/* 410 */
            // page ref_count ++
/* 411 */     get_page(page);
            // 直接把普通文件的pipe拿來放到pipe中
/* 412 */     buf->page = page;
/* 413 */     buf->offset = offset;
/* 414 */     buf->len = bytes;
/* 415 */
/* 416 */     pipe->head = i_head + 1;
/* 417 */     i->iov_offset = offset + bytes;
/* 418 */     i->head = i_head;
/* 419 */ out:
/* 420 */     i->count -= bytes;
/* 421 */     return bytes;
/* 422 */ }
可以看到,最主要的邏輯就在copy_page_to_iter_pipe中,之所以splice實現了CPU的零拷貝是因為他直接對目標頁的ref count進行了遞增,然後把目標頁的物理頁頁框複製到pipe buffer的page處,但這裡卻忘記設置pipe buffer的flags欄位。
OK,現在梳理完了這兩個syscall的邏輯,也發現在splice中存在對pipe buffer的flags欄位為初始化漏洞,那一種可行的利用思路就出來了。
使用pipe read/write,我們可以讓目標pipe的每個pipe buffer都帶上PIPE_BUF_FLAG_CAN_MERGEflag。之後打開目標文件,並使用splice 寫到之前處理過的pipe中,splice底層會幫助我們把目標文件的page cache 設置到pipe buffer的page欄位,但卻沒有修改flags欄位。之後我們再調用pipe write時由於存在PIPE_BUF_FLAG_CAN_MERGEflag欄位,內容會接著上次被寫入同一個page中,但page其實已經變成了目標文件的page cache,導致直接修改了目標文件page cache。如果之後有其他文件嘗試讀取這個文件,kernel會優先返回cache中的內容,也就是被我們修改後的page cache。但由於這個修改並不會觸發page的dirty屬性,因此若由於記憶體緊張後或系統重啟等原因,就會導致這個cache內kernel丟棄,再次讀取文件內核就會重新從磁碟中取出未被我們修改的內容(這就是和臟牛的不同點)。
雜談
這個bug其實在2016年就產生了,但為什麼在2020年才能被利用呢?這就涉及到linux程式碼的歷史了。
最早的時候,是否能夠merge並不是通過struct pipe_buffer中的flags欄位來管理,而是通過struct pipe_buf_operations中的can_merge欄位來判斷。因此在splice被加入linux時,splice提供了一個新的pipe_buf_operations叫page_cache_pipe_buf_ops,如下:
static struct pipe_buf_operations page_cache_pipe_buf_ops = {
    .can_merge = 0,
    .map = page_cache_pipe_buf_map,
    .unmap = page_cache_pipe_buf_unmap,
    .release = page_cache_pipe_buf_release,
};
其中can_merge欄位默認就是0,這就解釋了為什麼在copy_page_to_iter_pipe中不存在對flags的設置邏輯,因為只需要修改fops到page_cache_pipe_buf_ops就可以了。
之後在2016年的一個commit中 commit 241699cd72a8 「new iov_iter flavour: pipe-backed」 (Linux 4.9, 2016),添加了兩個函數,其中一個就是copy_page_to_iter_pipe,裡面對pipe_buffer的flags沒有進行初始化,但現在還沒出什麼大問題,因為此時can_merge參數還在fops中,且flags中也沒有什麼有趣的選項。
時間來到2019年,Commit 01e7187b4119 「pipe: stop using ->can_merge」 (Linux 5.0, 2019)中開始對can_merge欄位下手了,但這個時候操刀還比較暴力,除了把所有使用所有fops中的can_merge欄位刪除外,還增加了一個函數叫pipe_buf_can_merge,可能是發現除了匿名管道外,所有的管道都不支援merge,所以只要判斷一下fops是不是anon_pipe_buf_ops就行了。到目前為止,merge操作和16年的未初始化bug還沒掛鉤。
static bool pipe_buf_can_merge(struct pipe_buffer *buf)
{
    return buf->ops == &anon_pipe_buf_ops;
}
終於,在2020年,可能還是感覺這種判斷太過於暴力,於是把merge操作的判斷塞進了pipe_buffer的flags中:Commit f6dd975583bd 「pipe: merge anon_pipe_buf*_ops」 (Linux 5.8, 2020) 。16年埋下的bug終於在4年後變成了漏洞。
漏洞修復
內核的修復方法很簡單,把兩處pipe buffer的flags未初始化補上即可。
diff --git a/lib/iov_iter.c b/lib/iov_iter.c
index b0e0acdf96c15..6dd5330f7a995 100644
--- a/lib/iov_iter.c
+++ b/lib/iov_iter.c
@@ -414,6 +414,7 @@ static size_t copy_page_to_iter_pipe(struct page *page, size_t offset, size_t by
         return 0;

     buf->ops = &page_cache_pipe_buf_ops;
+    buf->flags = 0;
     get_page(page);
     buf->page = page;
     buf->offset = offset;
@@ -577,6 +578,7 @@ static size_t push_pipe(struct iov_iter *i, size_t size,
             break;

         buf->ops = &default_pipe_buf_ops;
+        buf->flags = 0;
         buf->page = page;
         buf->offset = 0;
         buf->len = min_t(ssize_t, left, PAGE_SIZE);
閱讀福利:
試試下面的漏掃服務,看看系統是否存在安全風險:>>>漏洞掃描服務
參考
- //github.com/bbaranoff/CVE-2022-0847
- //dirtypipe.cm4all.com/
- //elixir.bootlin.com/linux/v5.10.60/source
- //www.cnblogs.com/liconglong/p/15211413.html

