kafka基礎原理
- 2022 年 5 月 6 日
- 筆記
1、什麼是kafka
Kafka 是一個分散式的基於發布/訂閱模式的消息隊列
消息隊列的兩種模式:
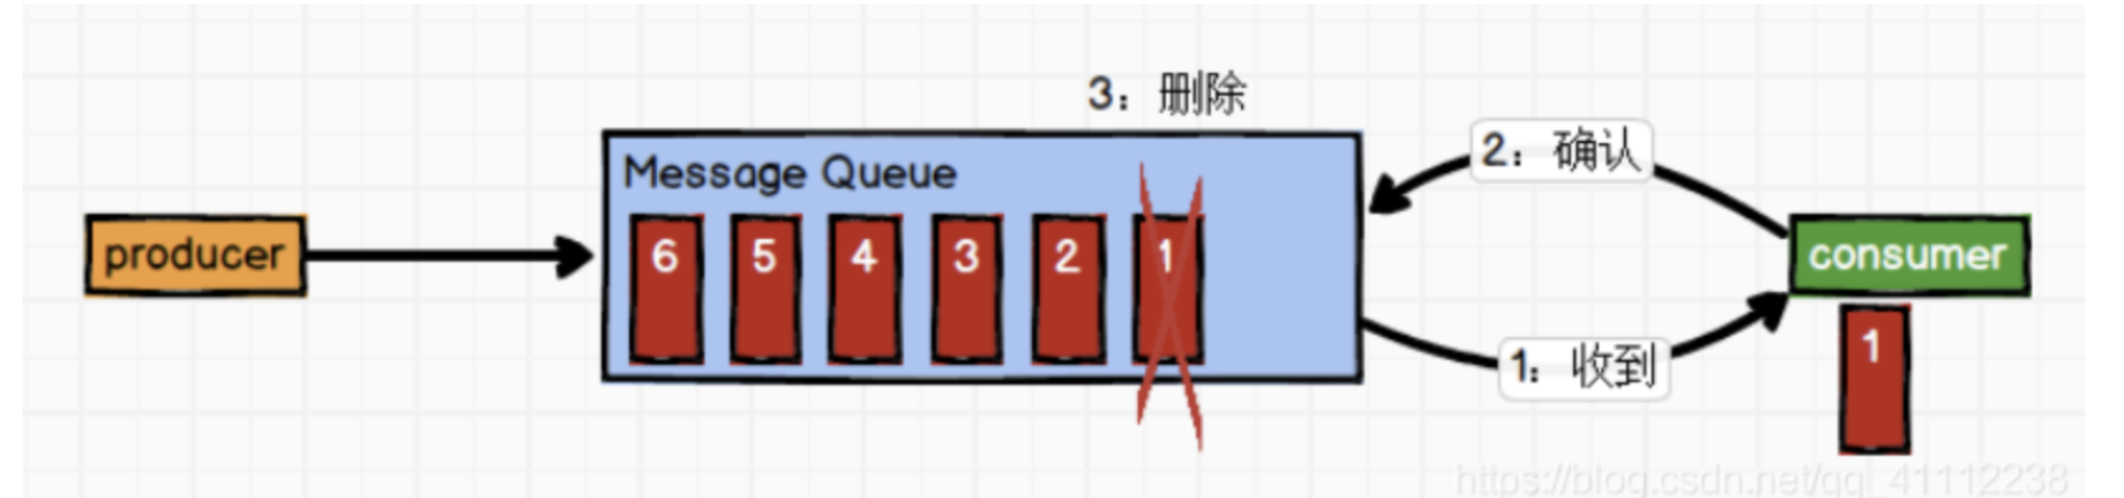
點對點模式(一對一,消費者主動拉取數據,消息收到後消息清除)。特點,一個消息只能被一個消費者消費
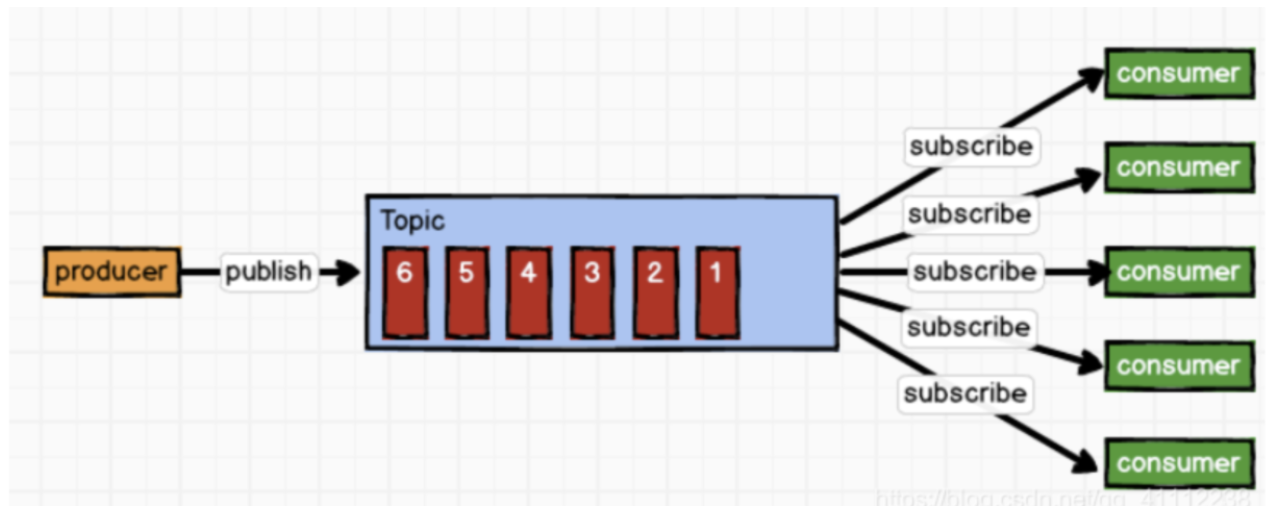
發布/訂閱模式(一對多,消費者消費數據之後不會清除消息)。特點,一個消息可以被多個訂閱的消費者消費
2、消息隊列的優點:
解耦
允許獨立擴展或修改兩邊的處理過程,只要確保它們遵守同樣的介面約束。
可恢復性
系統的一部分組件失效時,不會影響到整個系統。消息隊列降低了進程間的耦合度,所以即使一個處理消息的進程掛掉,加入隊列中的消息仍然可以在系統恢復後被處理。
靈活性 & 峰值處理能力
在訪問量劇增的情況下,應用仍然需要繼續發揮作用,但是這樣的突發流量並不常見。如果為以能處理這類峰值訪問為標準來投入資源隨時待命是很浪費的,使用消息隊列能夠使關鍵組件頂住突發的訪問壓力,而不會因為突發的超負荷請求而崩潰。
非同步通訊
很多時候用戶不想也不需要立即處理消息。消息隊列提供了非同步處理機制,允許用戶把一個消息放入隊列但並不立即處理它。想向隊列中放入多少消息就放多少,然後在需要的時候再去處理它們。例:晨配項目集收創建訂單後推給大網,同時這個單還需要判斷是供應商派送還是順豐派送。派送的判斷需調大網介面,大網處理這個新建的訂單需要一定的時間,所以我們在創建訂單後,通過mq加個了延遲
3、Kafka介紹
Producer:Producer即生產者,消息的產生者,是消息的入口。
Consumer:消費者,即消息的消費方,是消息的出口。
Consumer Group:我們可以將多個消費組組成一個消費者組,在kafka的設計中同一個分區的數據只能被消費者組中的某一個消費者消費。同一個消費者組的消費者可以消費同一個topic的不同分區的數據,這也是為了提高kafka的吞吐量!
kafka cluster(kafka集群):
Broker:Broker是kafka實例,每個伺服器上有一個或多個kafka的實例,我們姑且認為每個broker對應一台伺服器。每個kafka集群內的broker都有一個不重複的編號,如圖中的broker-0、broker-1等……
Topic:消息的主題,可以理解為消息的分類,kafka的數據就保存在topic。在每個broker上都可以創建多個topic。
Partition:Topic的分區,每個topic可以有多個分區,分區的作用是做負載,提高kafka的吞吐量。同一個topic在不同的分區的數據是不重複的,partition的表現形式就是一個一個的文件夾!
Replication:每一個分區都有多個副本,副本的作用是做備胎。當主分區(Leader)故障的時候會選擇一個備胎(Follower)上位,成為Leader。在kafka中默認副本的最大數量是10個,且副本的數量不能大於Broker的數量,follower和leader絕對是在不同的機器,同一機器對同一個分區也只可能存放一個副本(包括自己)。
Message:每一條發送的消息主體。
Zookeeper:Kafka通過Zookeeper管理Kafka集群配置:選舉Kafka 的leader,以及在Consumer Group發生變化時進行rebalance,因為consumer消費kafka topic的partition的offsite資訊是存在Zookeeper的。失敗的消息會記錄在Zookeeper,重啟後Consumer先消費Zookeeper里失敗的消息,再從上次offset開始消費。
消息存儲過程:
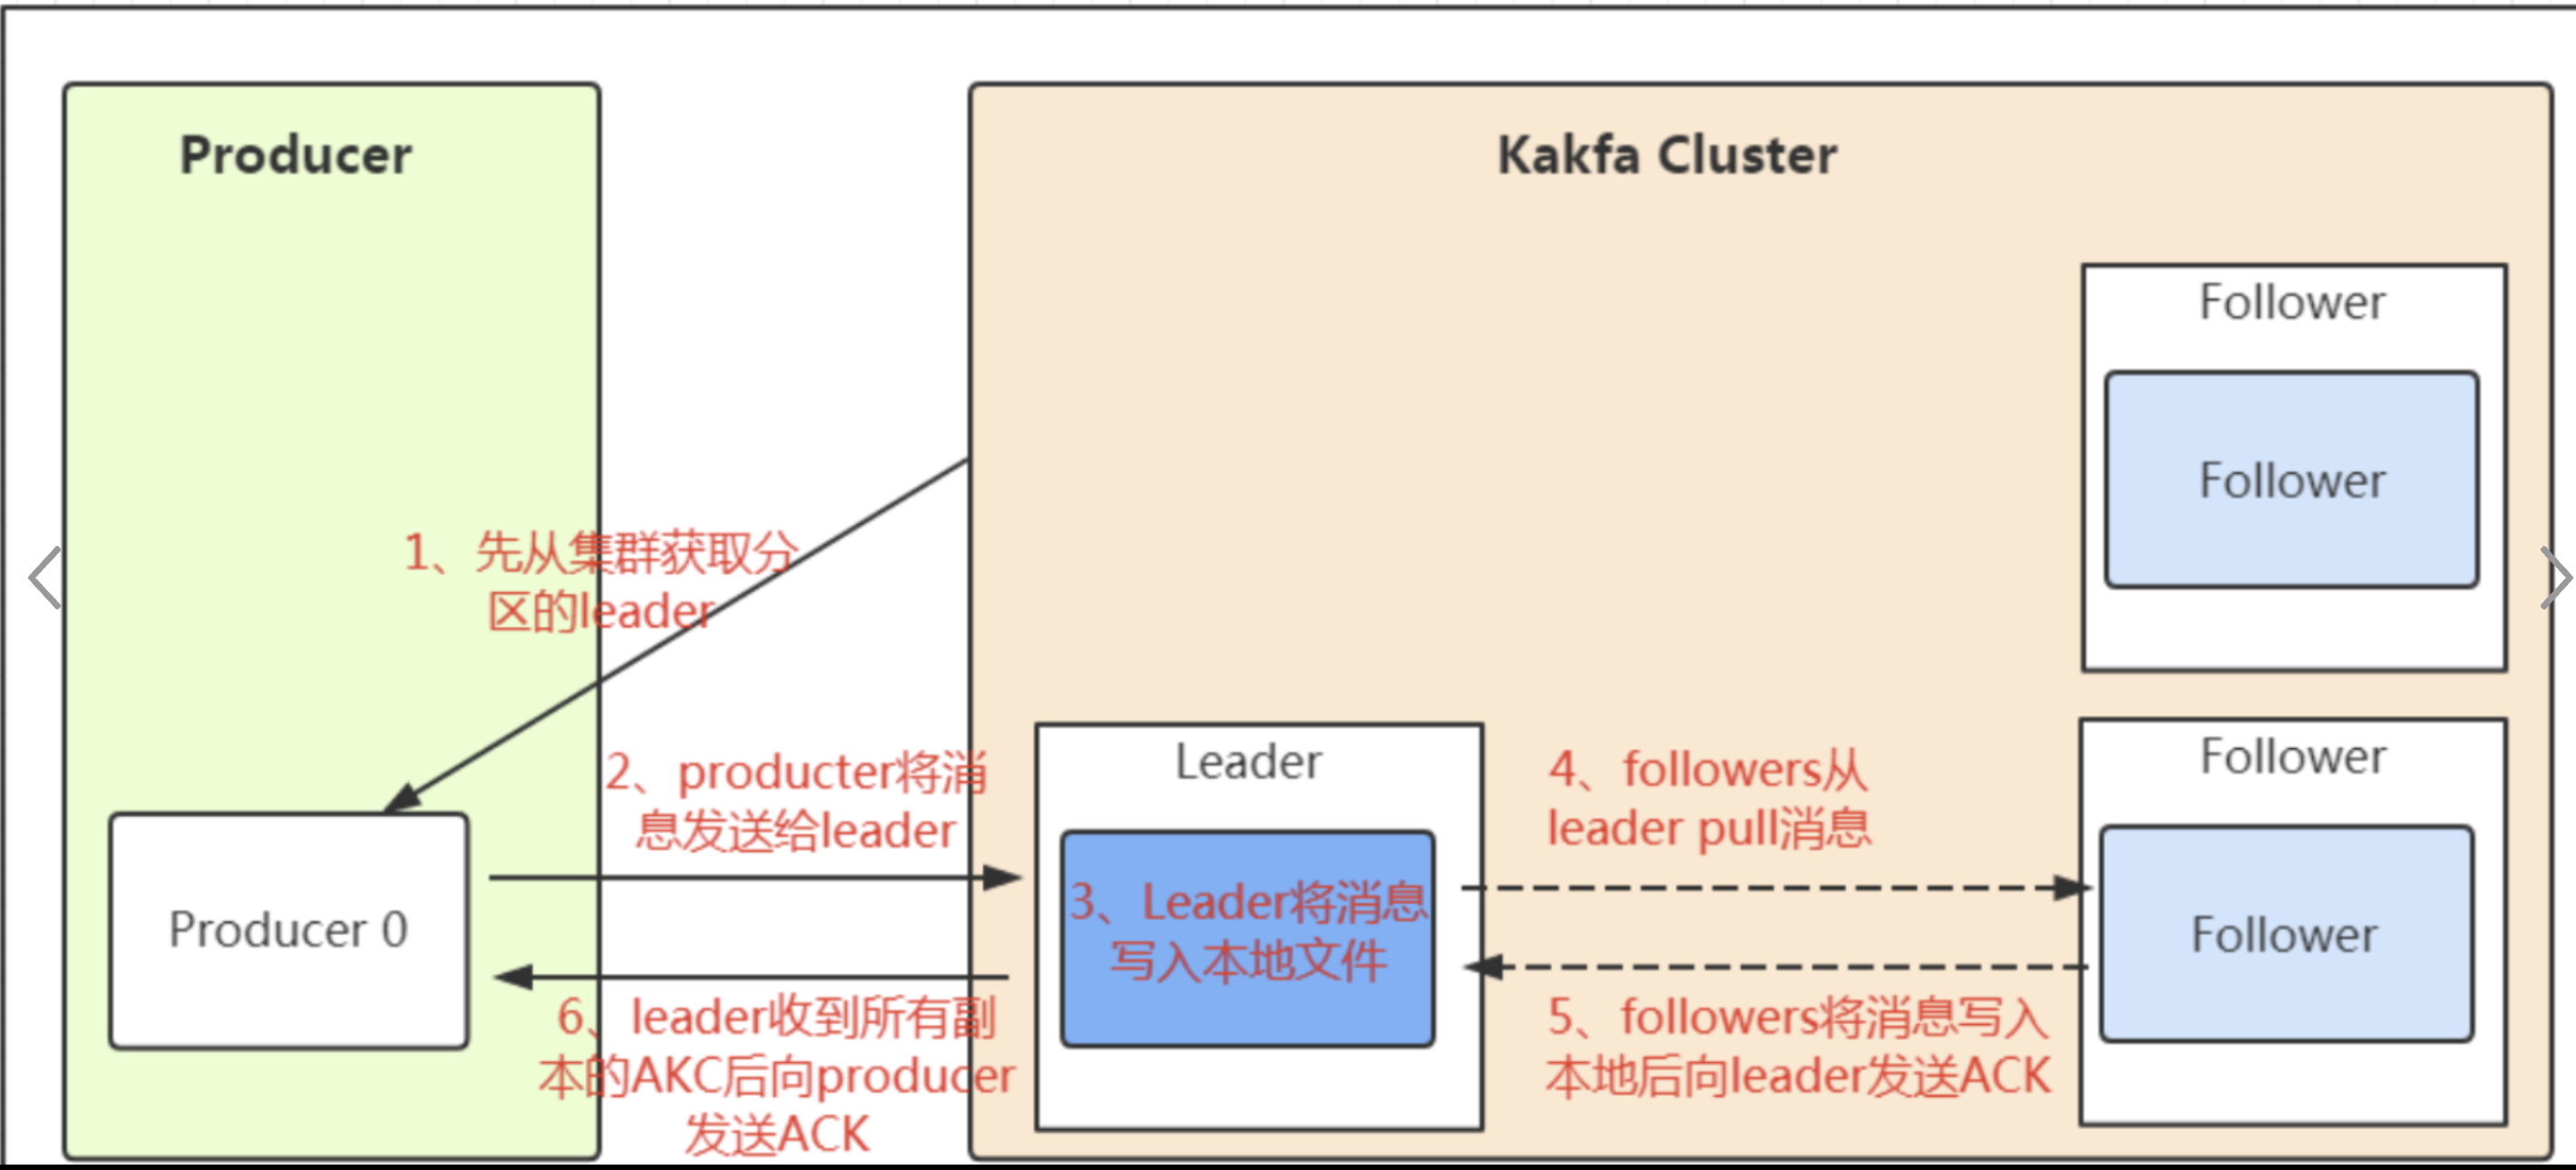
消息寫入leader後,follower是主動的去leader進行同步的!producer採用push模式將數據發布到broker,每條消息追加到分區中,順序寫入磁碟,所以保證同一分區內的數據是有序的
消息消費過程:
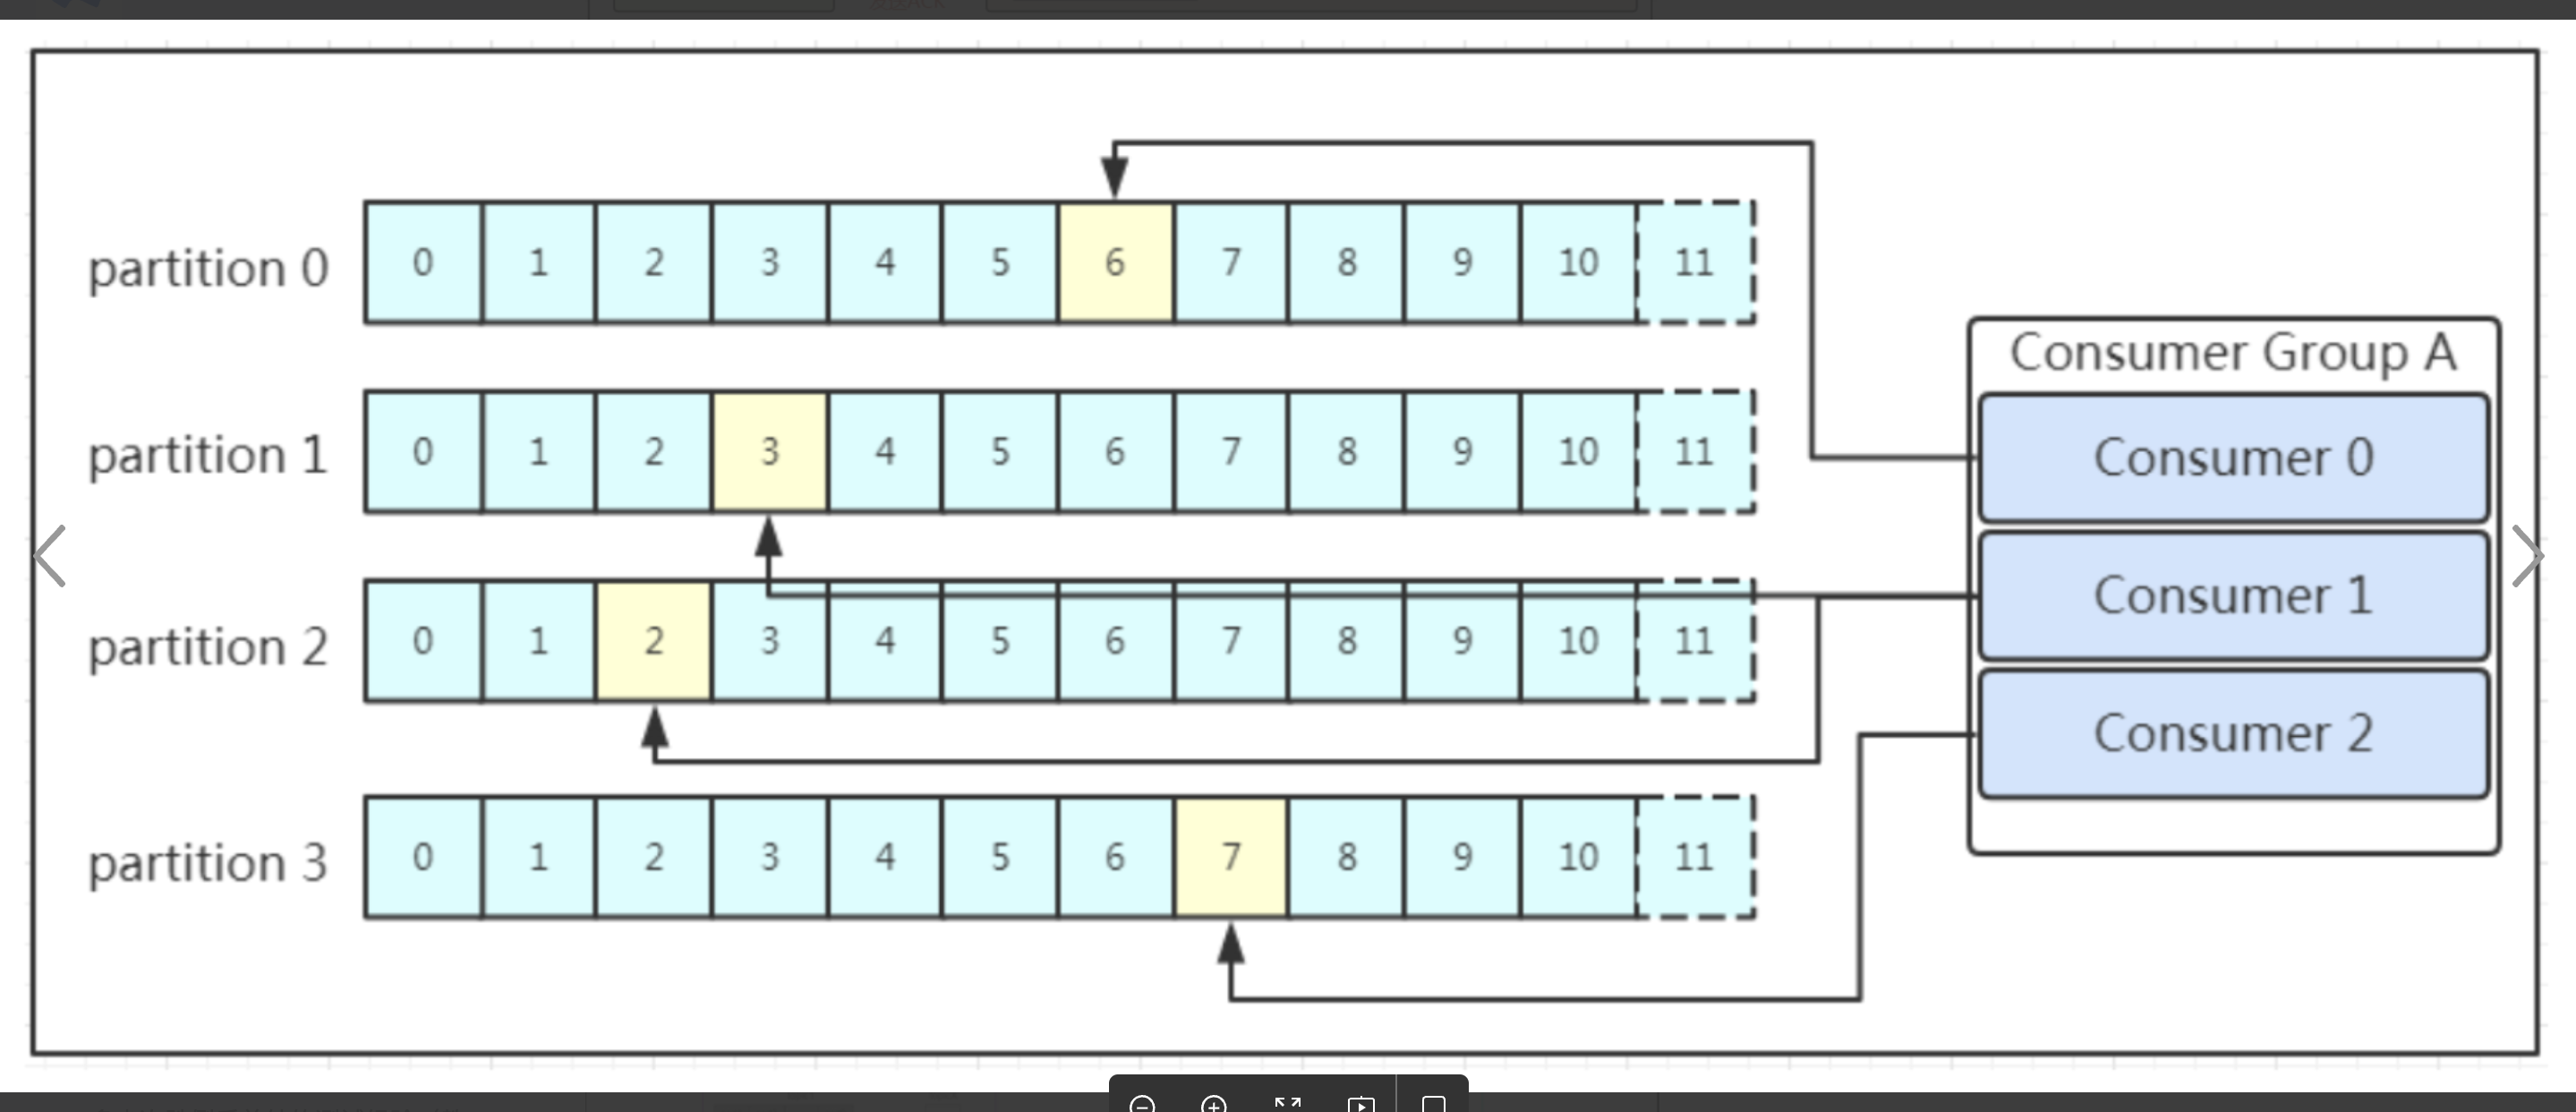
消費者在拉取消息的時候也是找leader去拉取。同一個消費組者的消費者可以消費同一topic下不同分區的數據,但是不會組內多個消費者消費同一分區的數據。
思考:1、怎麼配置partition數量和consumergroup的消費者數量,能達到消費效率最大化?
2、多個consumergroup消費同一個topic,offset 的值有影響嗎:
3、批量發送消息怎麼保證消息的順序?