【論文筆記】A Survey on Federated Learning: The Journey From Centralized to Distributed On-Site Learning and Beyond(綜述)
A Survey on Federated Learning: The Journey From Centralized to Distributed On-Site Learning and Beyond
| Authors | Sawsan AbdulRahman, Hanine Tout, Hakima Ould-Slimane, Azzam Mourad, Chamseddine Talhi, Mohsen Guizani |
|---|---|
| Keywords | AI; DL; distributed intelligence; FL applications; FL; ML; privacy; resource management; security; |
| Abstract | 在隱私問題和深度學習願景的驅動下,過去四年見證了機器學習適用機制的範式轉變,一種稱為聯邦學習(FL)的新興模式正在超越集中式系統和on-site分析。這是一種保護隱私的分散方法,它將原始數據保留在本機並訓練本地模型,減輕了數據通訊的負擔,然後在中心伺服器上執行學習和共享模型的聯合,以在參與者之間聚合和共享構建的知識。本文首先檢查和比較不同的基於ML的部署架構,然後對FL進行深入和廣泛的調查。與該領域現有的評論相比,我們在全面分析主要技術挑戰和當前相關工作的基礎上,對FL課題和研究領域進行了新的分類。在此背景下,我們詳細闡述了文獻中各種具有挑戰性的方面、貢獻和趨勢,包括核心系統模型和設計、應用領域、隱私和安全以及資源管理。此外,我們還討論了一些重要的挑戰和開放性的研究方向,以實現更強大的FL系統。 |
| Year | 2020 |
| Publication | INTERNET OF THINGS JOURNAL |
| DOI | 10.1109/jiot.2020.3030072 |
1 INTRODUCTION
當今人們通過各種互聯設備生產了海量的數據,有了這些數據,AI使我們的生活更高效。隨著深度學習的迅速發展,現有的方法繼續支援雲中心架構,數據被集中儲存和處理。除了不可接受的延遲和高代價,數據隱私和安全也是主要問題。
沒有嚴格的隱私考慮,敏感數據很容易遭受泄露、攻擊和網路風險。21世紀以來記錄在案的最嚴重的違規行為中,各大公司數以億計的用戶受到影響。在這樣的環境下,歐盟出台了GDPR法規( General Data Protection Regulation),它通過設置規則、限制數據共享和儲存來保護個人隱私。
為了按照上述規章制度進一步加強數據保護工作,on-site ML和FL已經發展起來代替集中式系統。
儘管on-site ML將原始數據保留在本地,雲端下發ML任務給設備,但是每個設備建立自己的模型,不從其他設備的數據和經驗中獲益。
因此聯邦學習(FL)被引入克服這些問題,同時仍然保護了隱私,還減輕了數據收集的負擔。它是一種在訓練數據和本地計算處理上分散式的方法。在FL中,原始數據被保留在設備本地,在中心伺服器上,只有來自設備本地計算的更新和分析結果被接收,並聚合成一個加強的全局模型,新模型接著為各客戶機所共享。
與當前工作相關的現有調查文章概覽:

但是文獻仍然缺乏對FL核心建模、應用、技術和部署方面的綜合調查,於是本文根據不同的分類學提出一個新分類和領域內關鍵挑戰,包括核心系統模型和設計、應用領域、隱私和安全、資源管理。本文主要貢獻如下:
- 詳細闡述了基於ML的分析的部署架構的演變,對FL範式在當前研究和行業趨勢中的努力和貢獻進行了分類,並對FL核心系統模型和設計的關鍵技術方面進行了深入回顧和透徹分析。我們進一步討論了為下一代FL解決方案鋪平道路的挑戰和有趣的開放研究方向。研究方向根據FL領域和主題進行分類,即系統模型和設計、應用領域、隱私和安全以及資源管理。
- 建立了一個FL應用領域的分類體系,涵蓋了迄今為止引入FL方法的所有領域。
- 確定並分析了FL範式中解決隱私和安全問題的關鍵貢獻。確定並分析了FL範式中解決隱私和安全問題的關鍵貢獻。
- 我們對為FL設置提出的資源管理機制進行了全面分析,並根據目標函數和考慮的參數對優化方法進行了分類。
2 機器學習架構演變
本部分闡述ML架構的演變,從集中式到分散式on-site到FL。
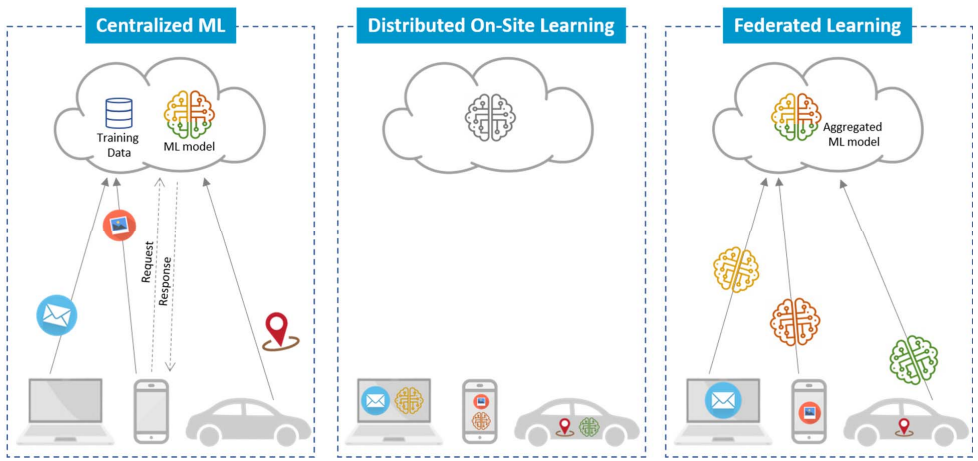
- 集中式ML:數據上傳到雲端,在雲端訓練模型,用戶通過請求API的方式使用模型及服務。
- 分散式on-site學習:每個設備在本地用自己的數據訓練自己的模型,在第一次雲端下發初始模型給設備之後,設備不再需要與雲通訊。
- 聯邦學習:每個設備在本地用自己的數據訓練自己的模型,之後將模型參數發給中心伺服器做聚合。數據保留在本地,知識通過聚合的模型共享給用戶。
2.1 集中式學習
在傳統方法下,設備產生的數據不斷地上傳到雲端進行分析,在高性能伺服器上能夠提取更多的特徵,模型能夠得到更好的訓練。Amazon Web Services、Google Cloud、Microsoft Azure都是可用的ML即服務的提供商,模型可以大規模部署和使用。
但是設備產生的數據可能是非常隱私且多樣的,當這些數據云上共享的時候,用戶隱私很可能為竊聽攻擊所妥協。這種雲集中方式也產生了其他問題:
- 延遲。數據可能需要傳輸幾千英里上雲。
- 數據傳輸代價。將數據移入移出雲都需要代價。
2.2 分散式on-site學習
on-site ML中,伺服器下發預訓練好的或是通用模型給設備,部署好模型後,每個設備在本地用自己的數據訓練自己的模型,然後根據自己的模型做一些預測與推理。
這樣的方法隱私上的優勢很明顯,數據從沒離開過本地。皮膚病檢測、醫療應用、指揮課堂、神經網路輔助服務等已有應用。
但是這種方法下,設備的模型沒有從其他設備的數據中獲益,沒有發揮群體智慧。
2.3 聯邦學習
Google在2016年提出了FL。在on-site ML之上,FL也是將訓練任務放在設備本地上,但同時將本地模型和學習聯合起來。它的主要目標是構建一個面向隱私保護的ML的框架。
3 預備:FL框架及設計
本部分介紹FL流程、產品應用及正式問題聲明。
3.1 產品應用及開源框架
FL首先在Gboard(Google為Android開發的鍵盤)上測試,FL加強了未來建議功能及與用戶的交互,提供了更好的特性(例如下一詞預測、辭彙補全及修正等)。
FL開源框架有:tensorflow federated(TFF),federated AI technology enabler(FATE),PySyft,PaddleFL,Clara訓練框架。
在科研界,圖片分類和語言模型是最先廣泛應用基於FL框架的領域,為了測試它們的表現,針對手寫字元的Modified National Institute of Standards and Technology(MNIST)和針對圖片的the Canadian Institute For Advanced Research(CIFAR)是文獻實驗中最流行的數據集。
3.2 FL生命周期及協議
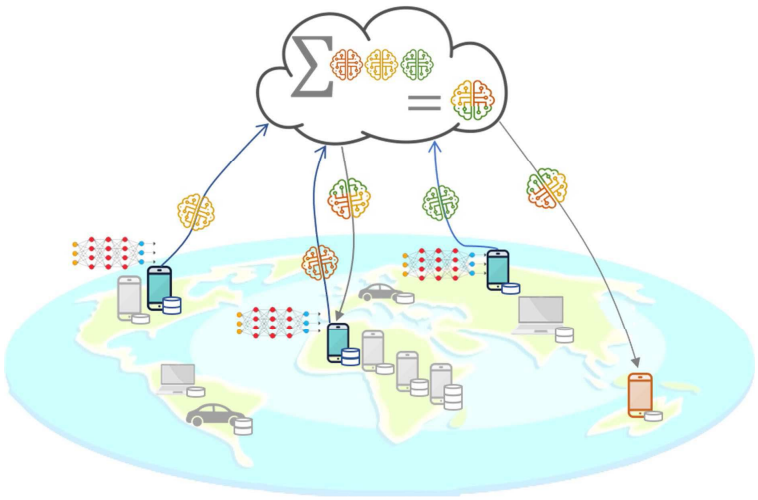
FL生命周期分為許多連續的通訊往來(round),一旦全局模型達到預期準確度則流程完畢。伺服器首先生成一個通用模型,每輪(round)重複以下步驟:
- 伺服器選取部分客戶機。儘管客戶機選擇的典型條件是基於設備充電、空閑和未測量的連接狀態,但是很少有這方面的工作。
- 被選中的客戶機從伺服器下載當前的模型參數並初始化本地模型。
- 被選中的客戶機使用本地數據訓練並優化全局模型。在典型的大多數被使用的技術中,客戶機採用隨機梯度下降演算法(SGD)計算更新。受通訊頻寬限制,每算一個梯度就上傳伺服器頻寬會不夠用,所以在一輪(round)中採用mini-batch在本機上多訓練幾個epoch再上傳伺服器,這樣可以獲得更好的模型更新並減少通訊代價。
- 一旦訓練完成,客戶機將優化後的模型參數發送給伺服器。在這個過程中,一些客戶機可能會由於連接差、受限的計算資源及大量的訓練數據而掉線,因此超出伺服器能掌控的客戶機的宕機率會被報告,處理繼續。如果及時報告的客戶機的數量不夠,當前輪(round)終止。
- 伺服器在根據客戶機的數據集大小對其進行加權後,聚合客戶機更新(即聯邦平均演算法)。新的全局模型誕生,投入下一輪。
3.3 問題公式化
FL關注有監督ML,樣本\(i\)特徵向量為\(x_i\),標籤為\(y_i\),訓練目標是通過最小化損失函數\(f_i(w)\)來找到模型參數向量\(w\)。基於ML模型,問題可以是凸的和非凸的。由於FL建立在非凸神經網路上,它的有限和函數優化演算法描述如下(整個樣本集的平均損失函數值最小):
在FL里客戶機的數據從未被組裝,所以上式需要修改一下。設\(K\)個客戶機參與學習,每個客戶機有\(n_k=|P_k|\)個樣本,\(P_k\)是整個數據集\(P\)分配給客戶機\(k\)的部分,\(P=\cup_{k=1}^{K} P_{k}\)。因此,代表全局損失的新的損失函數是將每個本地損失\(F_k(w)\)加權平均(根據各自樣本數量加權):
4 FL技術挑戰及研究領域:新的分類
本部分討論FL技術挑戰並對主要研究領域進行新分類。
為什麼FL區別於傳統分散式學習環境:
- 非獨立同分布數據(Nonindependent and Nonidentically Distributed,Non-IID):每個客戶機根據自己的使用情況生成自己的數據集,數據是本地的、分散的,其他客戶端看不到,這使得每個設備的數據不具有代表性,在總體中分布不一致。
- 不平衡數據:設備不同使用方式、客戶機本地環境和客戶機之間不交流導致了客戶機之間訓練數據量差異很大。
- 大規模分散式數據:FL的參與者可以達到幾百萬,從移動手機到物聯網設備、組織機構、交通工具等。參與者的數量預計比每個參與者的平均樣本數量還要大得多。
- 不可靠的設備連接:在大多數時候,客戶機處於低速、受限、昂貴和不可用的連接下,這大大降低了可用客戶機數量。此外,由於不同的計算能力,許多可用客戶機無法每輪都參與學習。
- 受限的設備存儲:通常在移動設備,特別是在物聯網設備中,可用的存儲預算通常是受限的。另外,隨著batch size提升,記憶體佔用也會提升。這不僅會導致設備在訓練階段掉線,也會迫使設備採用小batch訓練簡單模型。
- 投毒攻擊:客戶機匿名可能會使一名攻擊者被選中參與FL訓練,因此,攻擊者可以在訓練階段通過提供有毒數據來利用這一優勢,同時使模型產生偏離。
FL問題研究主要分為四類:
- 系統模型及設計
- 應用領域
- 隱私與安全
- 資源管理
5 FL系統模型及設計
FL系統模型及設計的努力與貢獻可以分為五個主要領域:通訊代價、客戶機選擇、優化與聚合演算法、Non-IID、激勵措施。
5.1 通訊代價
- [32]提議研究兩種方法。一種是結構化更新,通過提出兩種類型:低位掩碼和隨機掩碼,為更新施加一個預定義的結構。低秩將模型參數分為兩個矩陣,其中一個是固定的,另外一個發送到雲。另一方面,隨機掩碼可以以只發送非零值而不是整個條目的方式生成矩陣結構;第二種方法是草圖更新,它要求更新完整模型,有損壓縮後發給伺服器。
- [43]致力於減小伺服器與客戶機生成的模型大小。首先,採用federated dropout技術生成一個有較少參數的較小的子模型,然後伺服器對生成模型進行有損壓縮後發送給客戶機。客戶機解壓縮後開始訓練,訓練後有損壓縮後發送給伺服器,伺服器解壓後做聚合。
- [44]採用over-the-air計演算法則提出了更快的聚合模型。
- [45]致力於滿足FL的以下需求:允許上下游壓縮、使模型在小batch及不平衡的非獨立同分布數據下變得魯棒、可以掌控大量參與學習的客戶機。
- [46]提出了一個加強的FL框架,不僅降低了通訊代價(採用非同步策略),也提升了模型準確度(考慮到前幾輪訓練模型成果而非只考慮本輪訓練)。
- [47]採用雙流模型。
- [48]應用在講話場景中的喚醒語檢測(「Hey Siri」),用Adam-based adaptive averaging策略代替標準的FedAvg演算法。
- [49]提出一個通訊減負FL方案(CMFL),解決FL通訊負擔瓶頸。
我們天真地以為只要恪守FL協議就能完整地傳輸模型,然而事實並非如此,通訊負擔成為了FL的一個瓶頸,連通性成為一個大問題,特別是當上行鏈路比下行鏈路網路連通更差的時候。
5.2 客戶機選擇
客戶機選擇的典型條件是基於設備充電、空閑和連接到未測量網路(例如WIFI)。然而,在處理通訊和計算資源方面異構的客戶機時,僅依賴這些標準會帶來許多缺點,例如訓練時間長。
- [41]討論了客戶機的不同特徵,這些特徵會影響整個訓練過程的效率。該提案由一個新的FL協議FEDC組成,確定了能夠在特定期限內完成下載、更新和上傳模型的FL步驟的客戶端子集。
- 在[42]中,除了資源調度演算法之外,這項工作還擴展到了客戶機選擇方面。在前者中,選擇兩組客戶機,一組更新模型,另一組通過提供一些激勵將自己的數據上傳到伺服器。伺服器首先使用基於IID的原始數據更新模型,然後使用聚合模型進行更新。此外,利用一些驗證數據對模型性能進行了測量。
當隨機選取參與FL的客戶機時,模型訓練到部署將會依賴於客戶機的表現。
5.3 優化與聚合演算法
- [3]選取了FedAvg演算法並經過廣泛評估證明該方法可以被實際應用。
- [51]討論了現存FL演算法的不足,不能滿足以下FL需求:大規模分布數據點、Non-IID、不平衡數據。據此提出了聯邦隨機方差減少梯度,僅經過幾輪迭代收斂到最優分類準確度。
- [53]除了集中優化之外,他們對FedAvg、FSVRG、CO-OP三種演算法進行了基準測試,以比較它們的性能,結果表明FedAvg比其他演算法表現更優。至於集中式優化,它在Non-IID劃分中的性能優於FedAvg,但兩者的性能在IID方式下相似。
- [54]表明原生FL在最小化損失的時候完全依賴於數據的均勻分布,然而,這使模型偏向於特定的客戶,使得FL系統不夠完善。因此,作者提出了一個不可知FL框架,當出現任何客戶機分布組合時,該框架會優化聚合模型。作者還提出了一種新的快速隨機優化方法來解決上述問題。
- [55]強調了在FL中,為了提高模型的準確性,需要進行多輪的通訊,這會導致無法忍受的延遲和網路飽和。為了減少所需的通訊輪數,通過部署移動邊緣伺服器作為客戶機和雲端之間的中介,提出了一種分層聯邦平均演算法。提議的解決方案最初在邊緣伺服器上進行多個本地聚合,以便在稍後階段將客戶端模型發送到雲端進行全局聚合。
- [56]中,中央伺服器和客戶端之間的大量通訊輪被替換為一輪,以克服FL中通訊的關鍵瓶頸。
- [57]選擇了一組關於客戶機的標準,作為每個客戶貢獻的基礎。接下來,為這些標準分配優先順序,並對參數聚合使用在線調整。
FL里通訊比計算代價更大,實現可以在不給主幹網路造成負擔的情況下以快速收斂的方式最大限度地減少輪數的優化和聚合演算法至關重要。
5.4 Non-IID數據
非獨立同分布的數據會使模型產生偏差,特別是在使用SGD訓練的時候。
- [58]解決了傾斜Non-IID數據下準確性降低的問題。這意味著每個客戶機設備只能根據自己的行為訓練一個單獨的類。方案旨在通過與所有參與的客戶共享一組包含類(標籤)均勻分布的小數據來提高準確性水平。除了共享數據之外,每個客戶機還使用其本地私有數據來構建ML模型。
- [42]通過提出混合FL解決了FL中的Non-IID問題。後者為客戶提供了一些激勵措施,鼓勵他們將數據上傳到伺服器。
- [59]首先指出,當在分散式的節點上執行FL時,FL面臨兩個挑戰,即統計和系統。當需要從不同節點生成的Non-IID分散式數據中學習模型時,會出現統計挑戰。在系統挑戰方面,由於貢獻的設備在通訊、存儲和計算方面具有不平衡的數據和不同的容量,這導致了一些容錯和掉隊。作者證明了多任務學習可以解決統計問題,還提出了新的優化方法MOCHA應對系統挑戰。
在高傾斜Non-IID數據下使用FedAvg時,CNN準確度大大降低。基本上,在FL中部署DNN依賴於SGD。後者訓練數據應代表整個樣本分布,以免在梯度估計中產生偏差。雖然這種屬性基於IID數據分布,但FL遵循非IID方式,因為獨立客戶機根據自己的行為和使用情況生成數據,因此實現最初的FedAvg演算法並沒有保證性能。
5.5 激勵
雖然現存的方法關注優化FL的方方面面,但是很少在意客戶機不情願參與訓練或者選擇了模型更新品質低的客戶機的情況。
- [61]得出,一些被伺服器選擇的、算力和通訊能力受限的客戶機不願意浪費自己的資源。作者解決該問題通過基於合約理論設計一個激勵機制鼓勵用戶在FL中做貢獻。訓練模型的數據品質越高,準確度越高,模型迭代次數越少。因此,客戶機數據品質越高,得到的獎勵越多。
- [62]提出一種基於榮譽的可靠工作者的選擇方法,為了選出有著高準確度和高效的訓練數據的客戶機,採用一種依靠於客戶機以往的同其他FL服務交互及行為的客觀的邏輯模型去評估「榮譽」。
經典的FL基於被選中的客戶機總是可用的並且隨時可以開始學習的假設,然而現實場景並非如此,相當數量的設備極可能在處理過程中掉線,甚至由於資源代價和限制拒絕參與學習。為了更快收斂全局模型,激勵有著高品質數據的客戶機是非常需要的。
6 FL應用領域
本部分為FL應用領域做一個新的分類。
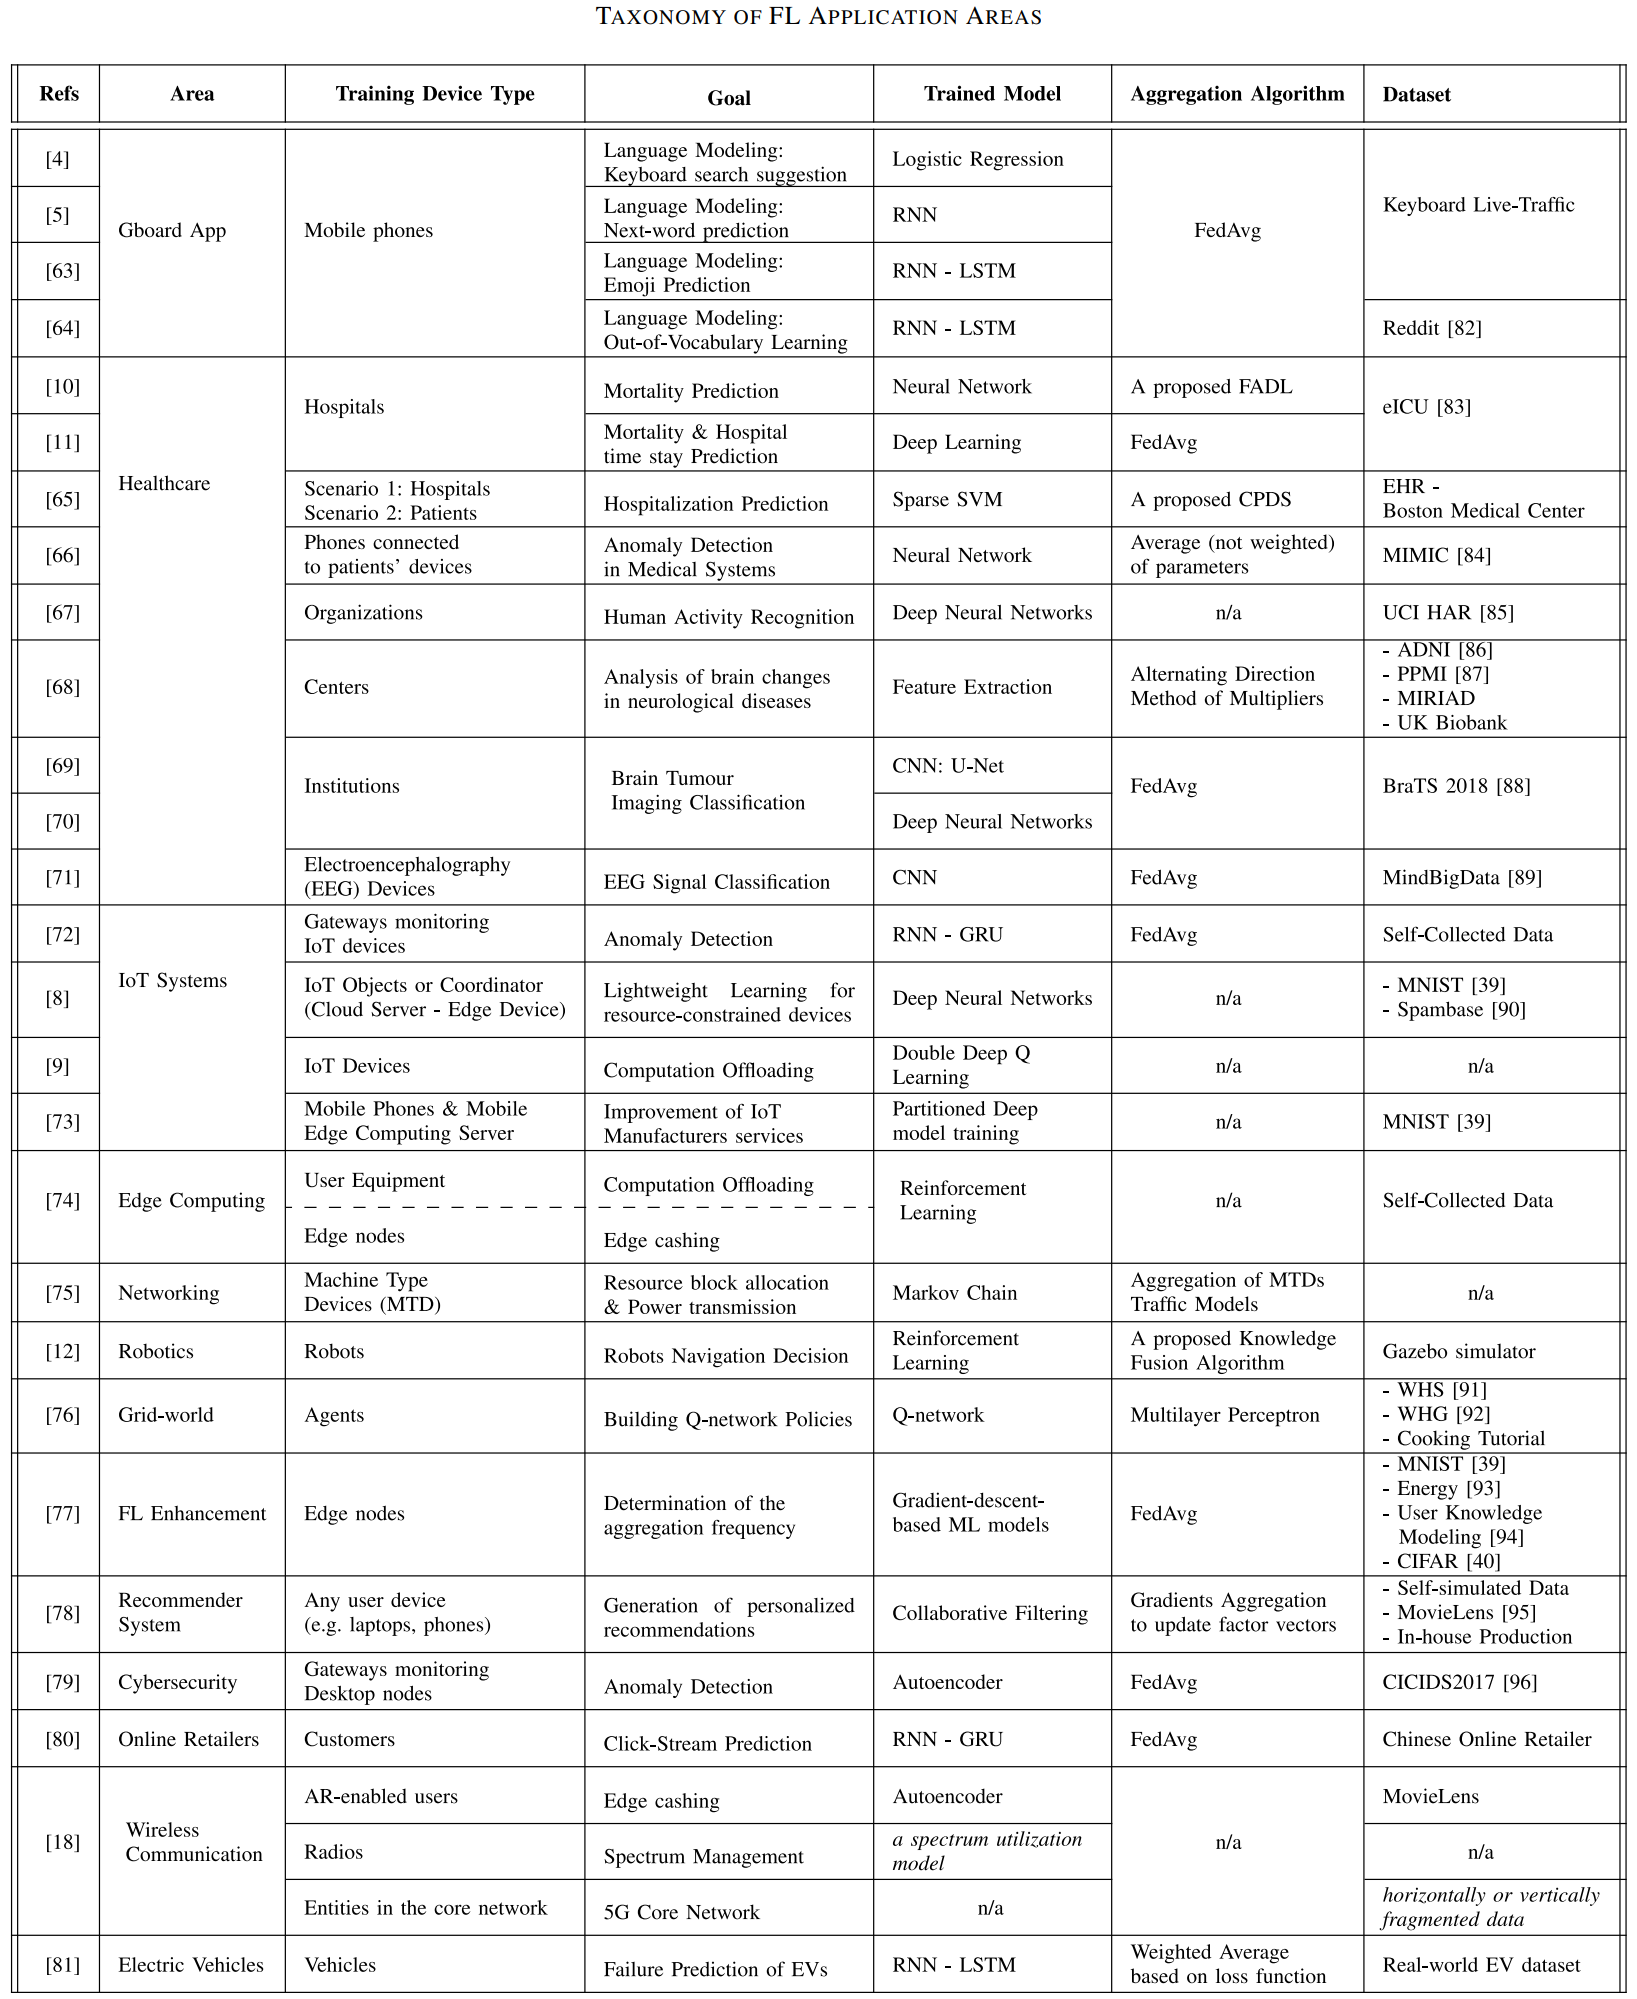
6.1 Gboard應用
FL最初在Gboard(Google虛擬鍵盤)上使用,[4]改善了Gboard的搜索建議。為了驗證參與FL的資格,客戶機需要滿足不同的需求,包括環境需求(設備規格、語言限制)及其他伺服器聲明的限制(參與學習的客戶機的目標數量、每輪學習最小客戶機數量、訓練頻率、等待接收模型更新的時間閾值、為了進行一輪必須報告的客戶機比例)。
評估表明,晚上訓練樣本較多,白天損失較大。對實時部署的觀察進一步顯示,實際的查詢點擊率與預期的查詢點擊率相比有時略有下降。
Gboard也在[5]中使用FL為了訓練一個更複雜的神經網路模型,證明了比在集中式數據上訓練的模型有更好的表現。
- [63]證明了RNN在Gboard上通過FL預測emoji(表情)的能力。
- [64]改編了FL,更精確地聯合基於字元的RNN學習字典之外的辭彙(OOV)。
6.2 健康關懷
- [10]提出了一種策略叫FADL,神經網路第一層使用所有數據以聯邦的方式訓練,其他層用各自數據本地訓練。
- [11]提出了一種基於集群的FL演算法預測死亡與住院時間。基於通常的醫療方面在醫院內部將電子健康記錄聚類成簇(集群),每個集群內部進行學習和共享。
- [65]中,FL也被用來預測心臟病患者的住院情況。考慮了兩種情況,第一種是半集中的場景,其中每個代理/數據源持有多個樣本,而第二種是完全分散的場景,其中每個代理持有一個樣本。
- [66]在醫療網路物理系統領域設計了一個基於FL的入侵檢測系統。為了提供高性能模型,對具有相似特徵的同質患者進行聚類,每個聚類創建其個性化的局部和全局模型。
- [67]提出了可穿戴醫療設備的聯邦遷移學習方法。
- [68]中提出了一個FL框架,用於生物醫學數據的分析。本研究分別使用局部任務的特徵選擇和交替方向乘數法和聚集法,研究神經系統疾病等多種疾病中的亞順序腦改變。
- [69]和[70]在考慮FL的同時,專註於用於腦腫瘤分割的醫學影像預測。他們的解決方案允許多個機構通過共享本地計算模型進行協作。
- [71]中,FL還用於對從各種設備收集的腦電圖(EEG)訊號進行分類。
6.3 物聯網(IoT)系統
為了限制大規模物聯網設備的漏洞,FL被應用在了物聯網系統上。由於設備上密集的計算負載,邊緣計算被設想去支援和卸載從物聯網到邊緣節點之間的任務。
- [72]提出了一種基於物聯網異常檢測的入侵檢測系統。不同的安全網關,每個網關監控一種特定設備類型的流量,在本地訓練封閉的循環單元模型,並將其發送給物聯網安全服務進行聚合。這樣的系統可以在沒有用戶干預的情況下工作,並且能夠檢測到新的攻擊。
- [8]提出了一種針對資源受限設備的輕量級學習模型。首先,提出的解決方案在設備級應用高斯隨機投影,以模糊訓練數據。接下來,對於沒有足夠計算資源進行訓練的參與設備,由協調器接管。
- [9]考慮到邊緣級別的代理數據與存儲在物聯網設備上的數據相關性較小。因此,後者負責訓練模型,而邊緣節點執行更新聚合。
- [73]中考慮了許多方面,以實現物聯網的完全安全FL方法。
6.4 其他應用領域
- 首先,FL已經被應用於邊緣系統,同時在[74]中整合了深度強化學習。
- [75]利用FL動態分配資源塊,並為可能處於常規或報警模式的機器類型設備傳輸功率。
- [12]中應用了機器人中的聯邦強化學習。這項工作使機器人能夠融合和轉移他們的學習經驗,以便快速適應新的環境設置。
- [76]提出了一種基於強化學習的FL方法,旨在通過代理之間共享有限的加密資訊來學習代理的Q網路策略。
- [77]引入了一種自適應方法來確定局部模型更新和全局聚合參數之間的權衡,該方法能夠在客戶端資源約束下最小化學習損失。
- [78]提出了一種針對FL設置的協同過濾方法。這項工作生成了一個推薦系統,根據其他客戶的回饋為用戶個性化推薦。
- [79]將FL用於異常檢測。
- [80]選擇將FL應用於在線零售業務活動。
- [18]在無線通訊中保護了數據的隱私。在介紹了FL及其顯著特徵後,作者討論了該領域的幾種可能應用,同時主要關注邊緣、頻譜管理和5G核心網路中的內容兌現和數據計算。
- [81]分析了駕駛員行為指標,以預測電動汽車在電池和相關附件方面的故障。
6.5 總結
- 在IoT中,第一個挑戰是所有IoT系統級特點,例如1)設備在硬體、連接、功率方面的異構性;2)網路規模及每台設備的限制(影響它們在 FL 過程中活動的能力,使包括掉隊者和容錯在內的障礙比其他環境(如數據中心)更加普遍)。另外,通訊應當高效,因為在這樣的環境中通訊是很昂貴的。
- 雖然基於強化學習的FL方案可以融合學習經驗並在新環境中將其遷移到導航上,使得允許FL的機器人導航可以處理多樣的輸入輸出維度,給機器人系統提供了廣泛的幫助,但這仍然是一個開放性挑戰。
- 雖然FL證明了在推薦系統中保護隱私的能力,但在該領域仍然有許多挑戰。首先,處理在線學習以對系統進行基準測試,換句話說,分析有著來自客戶端的連續非同步更新的現實生活系統。另外,在這樣的系統中,處理分析通訊能力和效率的方法是一個挑戰。保護推薦系統學習模型免受攻擊和威脅的技術也是一個挑戰。
- 對於網路安全而言,在將權重更新存儲在區塊鏈上之前,提出一種聚合演算法來應對所有硬體異構性、不可靠連接和間歇性連接的節點,以緩解投毒攻擊,仍然是一項挑戰。
- 無線通訊中的一個重要挑戰是模型的魯棒性,其中任何通訊頻寬、雜訊、干擾和其他方面都是可能加劇信道瓶頸的因素。此外,收斂時間是另一個相當大的挑戰,它不僅取決於本地節點和集中式聚合器,而且還取決於它們之間的通訊信道的品質,在優化更新交換頻率和聚合頻率時應考慮這一點。最後,聚合器和任何本地學習者之間的無線信道品質會影響訓練過程,這是一個更具挑戰性的問題。
7 隱私和安全
儘管FL的首要問題是通過防止數據共享來實現嚴格的隱私保護,但與隱私和安全相關的新挑戰已經出現。最近所做的努力已經清楚地證明,模型更新的傳輸仍然可以披露有關客戶端的敏感資訊[19],[97],甚至更糟的是,可能會引發安全問題[98]。在本節中,我們將概述解決這些問題的相關方法。
7.1 隱私
現有隱私保護演算法仍然會使用戶隱私遭受風險。如[99]所示,FL中的攻擊者可能會從客戶機的訓練數據中泄露資訊。作者表示,惡意客戶機能夠推斷訓練集中是否存在確切的數據點,例如特定位置。此外,作者還研究了如何從參與的客戶數據中推斷屬性。因此,保護FL模型需要嚴格的隱私保障。由於參與者可以在整個過程中自由加入和退出一輪溝通,FL環境會導致許多角色產生各種威脅模型和漏洞。
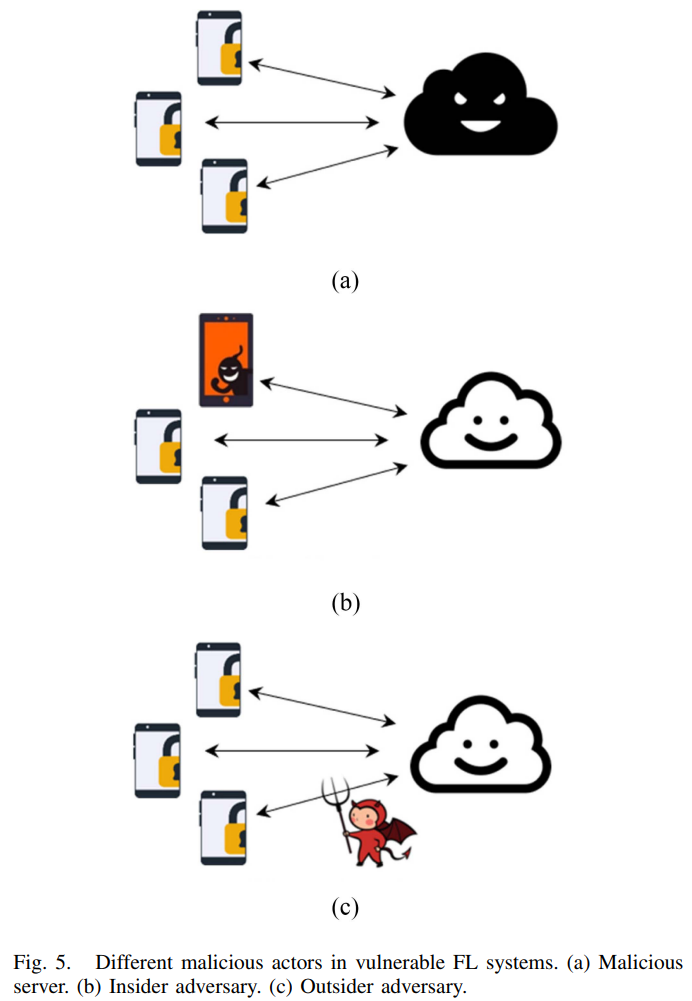
FL系統中不同的惡意角色(如上圖所示):
- 惡意伺服器:潛在的惡意伺服器不僅可以檢查模型更新,還會篡改模型。
- 內部對手:會有惡意的客戶機參與學習。
- 外部對手:在信任的客戶機於伺服器之間通訊更新的時候,信道中會有竊聽者出現。
鑒於這些威脅,最近的提議被推進以防止數據泄露。[98]調查了FL系統中的隱私與安全相關問題,首先,除了在整個FL框架上應用安全性,還討論了在客戶和伺服器側著手的幾種保護方案。接著,隱私與安全問題被分類為收斂、數據中毒、拓展規模和模型聚合,對於每種分類,一些實驗與可能的方案被提出以構建一個隱私保護的FL系統。另一方面,其他研究人員已經使用了不同的隱私技術(如下圖所示),主要屬於加密協議和差分隱私(DP)的範疇下。
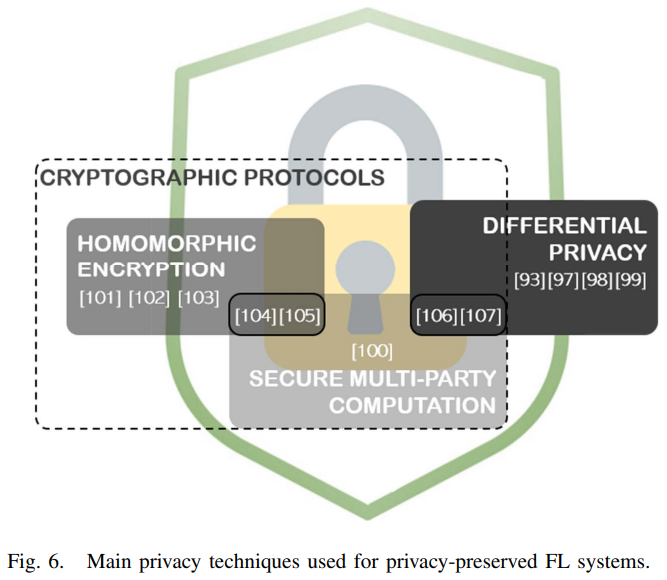
差分隱私(Differential Privacy,DP):通過注入一些雜訊來掩蓋客戶對模型參數的影響[97]。
- [101]介紹了一種演算法,旨在使用DP解決數據泄漏問題。在所提出的演算法中,使用了兩種方法:1)隨機子取樣,其中在每一輪通訊中,伺服器選擇一個隨機的客戶端子集與之共享全局模型;2)應用高斯技術來扭曲聚合的更新,但確保這不會超過一定的限制,因為它將添加影響學習過程準確性的不希望的雜訊。
- [102]中提出了聯邦平均演算法的新版本,其中Moments Accountant用於滿足用戶級隱私。
- [103]將DP機制應用於醫療應用。在真實世界的健康數據集上進行了實驗,結果表明,在沒有DP的情況下,FL的性能接近集中式系統。此外,在應用DP時,儘管增加了隱私級別,但是所研究的醫療保健應用程式產生了重大損失。這將促使研究人員考慮未來基於DP的系統的應用。
安全多方計算(Secure Multiparty Computation,SMC):它是密碼學協議的一個子領域,目的是當多方在其私人輸入上聯合執行任意功能時,只顯示輸出。
- [104]中的一項研究使用SMC構建FL系統。所提出的協議考慮秘密共享,在密鑰共享過程中添加新的回合(round)、保護惡意伺服器的雙掩蔽回合、有效交換秘密的密鑰協議以及最小化信任的伺服器中介密鑰協議。
同態加密(Homomorphic Encription,HE):它是一種通過直接在密文上做計算來保護客戶機數據的加密形式[105]。
- [106]在使用HE時提出SecureBoost(一種用於保護隱私的無損樹增強系統)。本文的創新之處在於多個參與方的協作模型,這些參與方的數據是垂直分區的,而不是水平分區的。
- [107]使用HE為私有FL處理垂直劃分的數據。具體來說,在跨特徵空間中,邏輯回歸使用Paillier加密進行私密聯合。此外,還分析了影響學習過程的實體解析錯誤。
混合協議(Hybrid Protocols):使用組合技術來更好地保護原始數據。
- [108]提出了聯邦遷移學習,以構建隱私保護的FL框架。為了盡量減少對神經網路結構的調整,這種方法使用了HE到多方計算的方法。
- [109]中,隱私保護FL系統是使用跨異構特徵空間的轉移學習構建的。該方法在HE和秘密共享設置下提供,包括以下步驟:1)安全域適配;2) 安全特徵映射;3) 安全FL;4) 安全模型集成;5)局部模型推理。
- [110]中的工作強調了計算多方聚合的需要,在這種情況下,所有參與者都不會透露其更新,不僅是在彼此之間,也不會向聚合器透露。
- [111]提出以混合方法實現DP和SMC。實驗表明,該方法能夠訓練決策樹、SVM和CNN模型。
其他技術:
- [112]構建了一個系統來對抗投毒攻擊。在模型被提取和聚合之後,所提出的方法允許共享黑盒環境下構建的模型的知識。
- [113]旨在檢測誘髮型攻擊(對手餵給分類器惡意活動以干擾最終模型)。
- [114]允許客戶機對神經網路參數編碼和壓縮,伺服器解碼它們以聚合,形成了一個端到端的加密模式。
7.2 安全
除了針對用戶隱私的惡意角色,在其他類型的攻擊和可能的漏洞下,FL系統也是很脆弱的。後者通常是用戶不經意間造成的,例如訓練混亂的數據、嘈雜的標籤等。另一方面,對手會有意傷害模型表現。下圖描繪的是敵對攻擊者可能做的兩種攻擊類型:數據投毒和模型更新投毒。
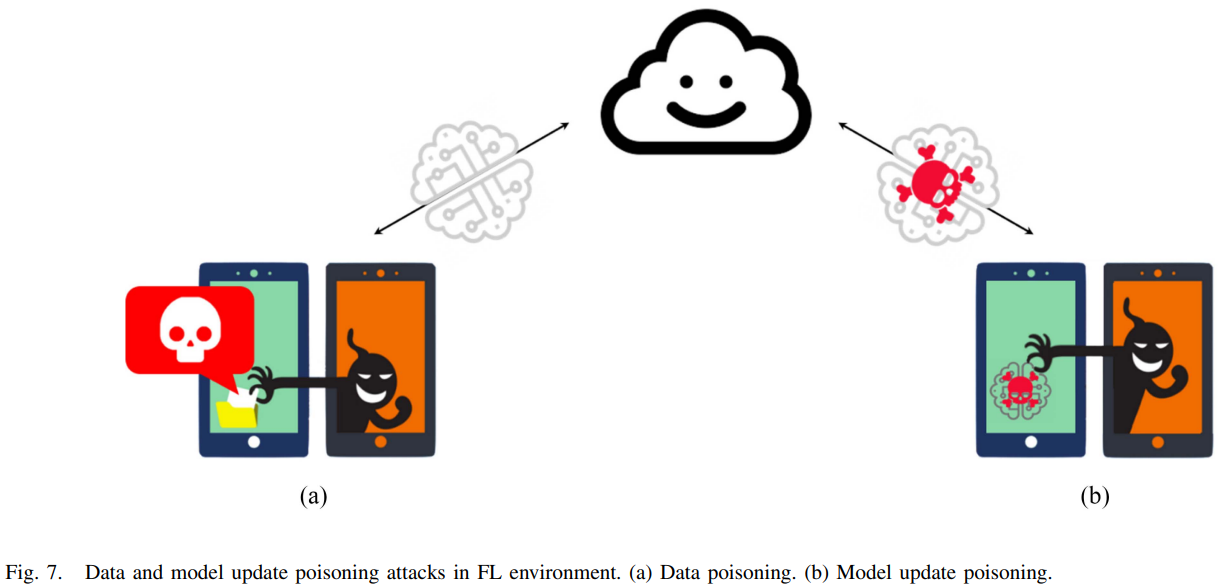
數據投毒(Data Poisoning):在FL學習的過程中,一個或多個客戶機在正確地參與一或多輪學習之後可能惡意作為,給聯合模型投毒。這樣的敵人可以通過clean-label和dirty-label攻擊操縱訓練階段,其中dirty-label攻擊允許用一個不相關命不中的標籤替換原有標籤,而clean-label攻擊看起來無害,因為它注入了有毒數據,導致模型本身在沒有攻擊者對標籤進行任何控制的情況下被干擾。
label-flipping是dirty-label攻擊的一個特例,在[115]中已被證明是FL漏洞之一。根據已進行的實驗,可以清楚地證明,僅僅兩個惡意sybils即可使最終模型受到嚴重影響。作者還表明,ML中現有的防禦不適用於FL環境,尤其是基於sybil的攻擊。因此,他們提出了一種基於客戶機貢獻相似性的新解決方案來防止此類攻擊。使用上述DP技術可以緩解此類攻擊。
模型更新投毒(Model Update Poisoning):與往訓練集中注入惡意數據的方式不同,模型更新投毒攻擊試圖通過欺騙本地模型直接破壞全局模型。與數據投毒攻擊相比,模型更新投毒攻擊看起來不那麼自然,但更有效。
如[116]和[117]所示,入侵者可以單獨行動,也可以與其他共謀參與者一起行動。此外,[116]通過證明參與FL步驟的任何客戶機都可以在共享的全局模型中呈現隱藏的後門(backdoor)功能,將秘密後門引入到全局模型中。它們表明,一個攻擊者的單次攻擊足以在後門任務上實現100%的準確率。在他們對單詞預測任務進行的實驗中,8萬名參與者中有8人被認為是惡意的,與數據中毒攻擊中的400名入侵者相比,他們能夠在後門上實現50%的準確率。
防禦投毒攻擊:為了保護系統免受投毒攻擊,已經提出一些方法。
- [118]中,區塊鏈取代了vanilla FL中中心協調員的支援,本地模型在區塊鏈網路中共享和驗證,同時為客戶提供獎勵。在這項工作中,學習過程的整體延遲被規範化並最小化。
- [119]在物聯網環境中提出了一種安全的數據協作系統。為了保證數據的私密性和安全性,在FL的設置下,利用區塊鏈範式建立了高效的數據訪問控制,保證了大規模分散式數據計算的安全協作。
- [105]考慮了這樣一種情況:一個客戶機有問題要解決,一些客戶機持有適當的數據,而另一些客戶機擁有具有足夠計算資源的設備。針對這種情況,提出了一種加密方案,初始客戶機創建公鑰和私鑰,並對模型參數進行加密。然後,適當的客戶機協作利用提供的資源和私有加密數據,以便成功地訓練模型。區塊鏈技術和數據完整性也被用於提議的方法中,以實現更穩健的FL解決方案。
7.3 總結
FL的主要思想是將ML模型引入數據源,以避免將數據引入模型,從而保證數據隱私。目前關於FL安全和隱私的工作提出了無損方法,並證明了它們的有效性,同時保留了原始的準確性。然而,其中一些技術帶來了巨大的額外通訊成本,而其他方法包含了一系列超參數,這些超參數不僅會影響準確性,還會影響通訊。此外,壓縮技術和DP之間的融合將帶來更大的好處。此外,安全和隱私約束可能會從一個設備轉移到另一個設備,甚至可能跨越單個設備上的數據片段,這是一個挑戰。因此,從這樣的角度來看,可以解決各種特定樣本數據和特定設備邊界的新技術看起來很有希望。
8 資源管理
FL應用於動態環境中,在動態環境中,客戶端擁有受限的資源設備,並通過頻寬受限的網路進行通訊,其中一些設備可以共享相同的鏈路。因此,許多貢獻一直以來關注資源管理以做出有關客戶機選擇、超參數學習、訓練輪的次數與持續時間、聚合策略的最佳決定。在這樣的環境下,假設以下指標(如下圖所示)子集的可用性/可預測性,各種優化問題被定義和解決。
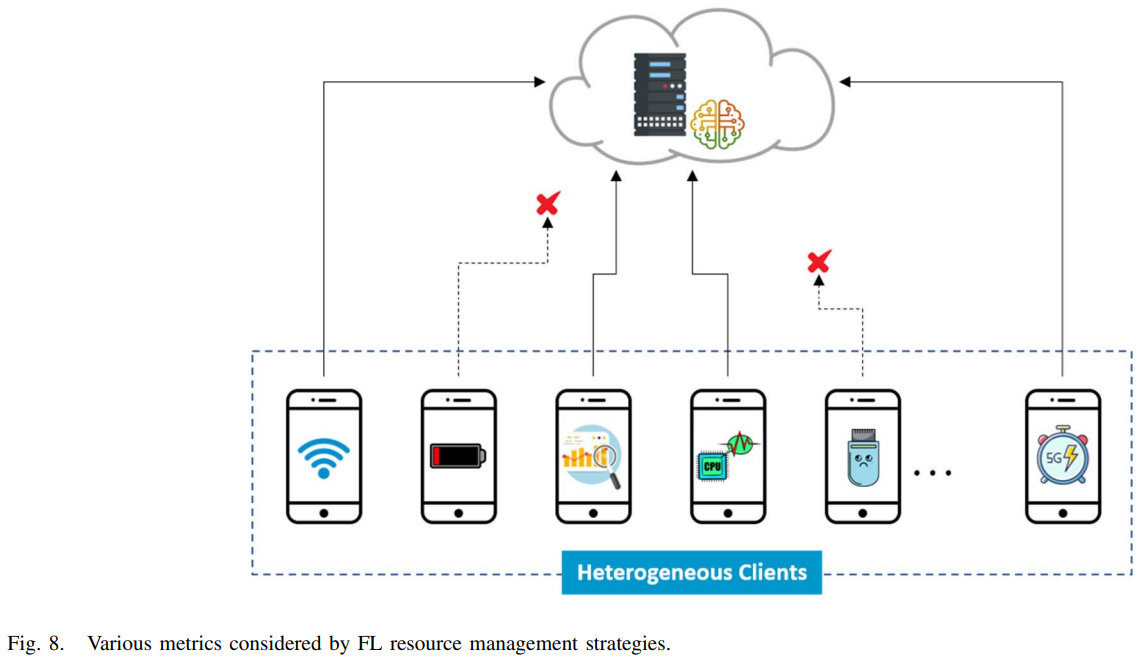
- 客戶機可靠性:資源(CPU,電量),定位追蹤(GPS定位),本地訓練時間,更新參數的品質(準確度,損失)。一些相關工作在每輪學習中假設這些指標「實際」值的可用性,而其他人採用各種方法「預測」這些值。
- 網路連接品質:上行鏈路/下行鏈路頻寬(已經可用的或可能分配的)。
- 中心聚合伺服器:聚合時間,全局模型準確度,損失。
文獻針對各種目標提出了優化方法,包括全局模型(準確度、損失)收斂時間、客戶機消耗資源、無線連接使用。在這方面,我們提供了下表所示的FL資源管理方法的分類。

主要的優化方法:
- [120]通過聯合優化本地訓練batchsize和無線資源分配,解決了加速DNN訓練任務的問題。
- [77]在考慮Non-IID數據分布的情況下,對FL的收斂邊界進行了分析。此外,他們提出了一種控制演算法,在有限的資源預算下,在最小化損失函數的同時,實現局部更新和全局聚合之間的預期權衡。
- [121]將客戶選擇問題描述為一個在線時變非線性整數規劃,該規劃將計算和通訊資源的總累積使用量降至最低,分別取決於伺服器容量以及每個設備和伺服器上本地和聚合模型的長期收斂要求。
無線網路相關方法:
- [122]提出了無線網路上的FL問題,該問題包含以下權衡:1)通過採用Pareto效率模型,權衡學習時間與客戶機能耗;2)通過計算最佳學習精度,權衡計算與通訊學習時間。
- [123]通過制定一個聯合頻寬分配和調度問題來最小化訓練時間,並達到所需的模型精度,從而最大化FL訓練相對於時間的收斂速度。
- [124]將聯合學習、無線資源分配和客戶選擇問題描述為最小化FL損失函數的優化問題。提出了一個封閉形式的表達式來量化無線因素對FL收斂速度的影響。他們使用匈牙利演算法來尋找最佳的用戶選擇和資源分配,以最小化FL損失函數。
- [125]提出了一種通過無線網路實現自組織FL的方法。他們採用啟發式演算法來最小化全局FL時間,同時考慮局部能耗和資源塊。
- [126]提出了一個分析和描述FL性能的模型。考慮到調度方案和小區間干擾的影響,推導了FL收斂速度的可處理表達式。此外,他們還研究了隨機調度、循環調度和比例公平調度策略的有效性(收斂速度)。
從所研究的貢獻中,我們可以看到,在移動和無線網路環境下,FL管理的主要挑戰是在參與的客戶端之間最佳地共享頻寬。至於管理能量完善,其基礎是:1)減少模型參數更新的傳輸,2)優化局部模型訓練。前一種策略是有效的,後一種策略受到無線設備及其其他計算任務的異構性的限制。
覆蓋客戶模型參數的方法:最近,一些研究人員開始研究在FL通訊輪(round)中由模型改進機會指導的調度技術。
- [127]設計了調度策略,用於根據信道條件和本地模型更新的重要性來決定處理每輪傳輸的設備子集。實驗結果表明,與僅基於這兩個指標之一的調度相比,該方法具有更好的長期性能。
- [128]的貢獻為客戶端共享公共無線鏈路的無線網路中的資源分配提供了一個長期的視角。該方法基於實驗觀察,表明在最初的學習輪中選擇較少的客戶,並逐漸增加這個數量,是對學習績效影響最大的策略。作者提出了一個隨機優化問題,用於選擇客戶端和分配頻寬,同時考慮長期客戶端能量限制。這一貢獻的一個關鍵設計元素是利用Lyapunov技術,為每個客戶機構建一個虛擬能量不足隊列。
- [129]提出了一種基於分層的FL(TiFL)系統,該系統根據客戶機的訓練表現將客戶機分為多個層次,同時應用基於分層的自適應客戶機選擇。
- [130]提出了一種調度策略,以利用多用戶信道的多樣性和邊緣設備學習更新重要性的多樣性(通過梯度散度測量)。他們提出了一種新的概率調度框架,以產生無偏的更新聚合。
- [131]提出了一種主動演算法,該演算法基於對移動客戶端未來訓練和報告品質的預測來選擇移動客戶機。所採用的方法包括兩個主要部分:1)預測用戶的移動軌跡模式及其智慧手機的應用程式使用習慣;2)基於深度強化學習的客戶機選擇演算法,處理大都市MEC(邊緣雲)環境中發生的意外動態事件。
雖然考慮到客戶機模型更新的品質對於提高FL管理技術的效率非常有希望,但這些方法面臨著許多挑戰。首先,通訊的模型參數和實際的本地訓練活動之間沒有可追溯性。第二,識別(Non-IID)數據的情況非常困難。最後,不能保證在前幾輪中提供良好參數的客戶在未來幾輪中會提供相同品質的參數。
基於卸載(Offloading-Based)的方法:一個有趣的方向是卸載到邊緣結點與分層組織。
此」卸載「非彼」卸載「,這裡offload是指將任務」卸貨「到某些地方,並非是指將應用程式卸載。
- [132]介紹了一種分層聯邦邊緣學習框架,其中模型聚合部分從雲端卸載到邊緣伺服器。提出並解決了一個聯合計算和通訊資源分配及邊緣關聯問題。在優化收斂時間和資源消耗時,考慮了頻寬、時間和電量約束。
- [133]提出了一種針對異構蜂窩網路的方法。FL由小型基地台在其小區內的移動用戶之間協調,這些基地台定期將模型更新傳達給宏基地台,以獲得全局共識。他們的方法通過聯合稀疏化和周期平均以及最小化端到端延遲的資源分配策略來確保高效通訊。
雖然呼籲FL計算卸載,但這些方法在移動設備(主要是智慧手機)環境中的適用性有限,在移動設備中幾乎不可能組織設備。然而,在無線感測器網路中,這些方法預計會對FL的採用產生重大影響,在無線感測器網路中,大多數感測器設備都有嚴重的資源限制,並且通常圍繞更強大的邊緣設備組織在一個層次中。
總結:現有方法的主要目標是在優化資源消耗的同時達到最好的全局學習效果(最小化損失並/或最大化準確度)。然而,這些方法的效率取決於客戶機在通訊所需的指標(CPU,時間等)時是否誠信,或者取決於預測演算法的可靠性。另外,一個中心伺服器沒有對於用於訓練客戶機本地模型的數據的數量和品質的核查機會,這解釋了為什麼少有方法([127] [129])考慮客戶機模型參數的品質。事實上,中央伺服器無法控制相關客戶端的資源監控工具。無線網路頻寬是唯一動態分配給客戶端並由現有方法管理的資源,前提是調度實體位於網路節點(如基地台)處。
9 研究方向
本部分給出一些挑戰與未來方向。
9.1 核心系統模型及設計
該類別涵蓋FL的不同技術方面,包括使用的ML演算法、優化和聚合機制、模型通訊技術、部署模型和數據分布,以及採用的框架等。在這方面,基準線聚合演算法、聯邦平均演算法都已發展到了只考慮數據集大小去做聚合和加權更新的模型。然而,這種演算法的收斂性取決於應用,更複雜的方法值得研究。新方法可以在減少通訊次數的情況下達到預期的精度,從而降低通訊成本。此外,在FL實現中高度鼓勵使用神經網路以外的演算法。這種模型尺寸較小的演算法也有助於最小化通訊和計算成本。儘管在這方面提出了一些令人鼓舞的方法,但仍有很大的工作空間。更進一步的,FL另一基本方面是客戶機的選擇,通常,從一輪到另一輪(round),不同客戶機集被選擇。當選擇涉及資源有限的一些客戶機時,例如物聯網設備,客戶機不僅需要更長的處理時間,而且可能無法完成訓練任務,從而影響模型的準確性。因此,隨機選擇客戶端會導致客戶端發送的更新數量減少,因此一些FL輪將被丟棄[31]。因此,需要更多的努力來優化FL客戶機選擇,同時考慮網路特性和為訓練模型而選擇的設備的生存能力。
9.2 應用領域
更廣泛的努力和貢獻是針對應用領域的,其中醫療保健和物聯網系統是最廣泛的目標領域。在另一個方向上,在邊緣FL中,以最小的學習開銷證明了良好的性能效率,但在這方面仍需要考慮一些挑戰。首先,為優化學習計算任務而制定訂製技術仍然是一項挑戰。此外,無論是在邊緣節點還是移動設備上,都需要協作人工智慧任務的調度方法。
此外,自主車輛和無人機(UAV)是很有前景的領域,可能有很多有用的應用,例如計程車、食品配送、醫療配送、虛擬現實應用、檢查、公共安全、事故報告、交通監控等。無人機應用分為三類[134]:1)配送系統;2) 實時多媒體流媒體;3)智慧交通系統,每個系統都面臨許多無線和安全挑戰。為了解決後者,[134]在沒有提供完整框架的情況下,為第一類和第三類引入了基於FL的解決方案。因此,研究適用於自動駕駛車輛和無人機系統的FL方法可能是一個有希望的投資方向。
此外,[135]提出了FL環境下智慧家居的一個用例。在他們的解決方案中,共享同一智慧設備的不同用戶可以受益於經過訓練的模型,智慧家居中的不同設備可以受益於其他設備的數據和模型。在這種情況下,當智慧家居設備受到攻擊時,可以實施基於IDS的體系結構,我們可以假設:1)所有連接的設備都有足夠的資源來執行訓練任務;2) 這些設備都沒有所需的資源,監護人可以負責訓練;3)一些設備能夠訓練模型。對於所描述的體系結構,[135]為其實現提供了一個完整的模擬試驗台。智慧家庭環境可能是研究FL部署的一個極好的匹配。
另一方面,大多數現有解決方案考慮FL應用的標記數據。然而,在實際場景中,有標記的數據集,甚至高品質的標記數據集都是一個挑戰。因此,迫切需要新的解決方案來解決這種限制。
9.3 隱私與安全
雖然隱私和安全性是採用FL作為相關解決方案的最初目標之一,但分散式方面提出了其他需要解決的問題,例如泄露用戶的敏感資訊或毒害本地數據和共享模型。儘管最近的努力採用了不同的基於隱私的解決方案,但仍存在一些挑戰。當使用DP時,會注入不同級別的雜訊,這會導致一些缺點。首先,雜訊會損害已建立的模型,導致精度損失。只有少數設備參與,才能保持可接受的精度。此外,這種做法不能保護數據隱私免受惡意伺服器攻擊。另一方面,即使密碼方法被認為是無損的,也會帶來密集的通訊開銷,有些方法甚至沒有強大到可以檢測中毒攻擊的程度。因此,迫切需要設計強大的隱私保護和安全系統,在這種情況下,隱私和安全需要正式的保證,並且精確性會受到嚴重損失。
9.4 資源管理
由於ML訓練和學習通常需要大量計算,因此資源管理對於實現相關、可持續和高效的基於FL的解決方案起著重要作用。在這方面,很少有研究開始將邊緣計算集成到FL[8]、[73]、[74]中,以支援具有額外計算資源的終端設備。然而,在兩個主要方向上仍然需要魯棒系統。首先,由於FL的關鍵瓶頸在於通訊頻寬,邊緣節點之間的一些協作可以決定向雲發送的最佳客戶端更新、發送更新的頻率,以及有助於減少通訊周期的其他標準。其次,由於FL不僅包括行動電話,還包括範圍更廣的設備,如物聯網、車輛等,因此訓練任務可以移動或卸載到邊緣節點,以釋放資源受限設備的密集計算[136],[137]。
10 總結
FL已成為一種新興的學習範式,它可以應對智慧手機、可穿戴設備和自動駕駛車輛等設備不斷增長的計算能力,同時還可以保護私人數據。在減少數據通訊開銷的同時,本地存儲數據和將ML計算推送到終端設備的需求不斷增加,這促使研究人員做出了許多努力,將這種FL訓練設置應用於許多學科。在這種背景下,本文對FL體系結構、設計和部署進行了深入和廣泛的研究,並將其與基於ML的集中式和分散式現場系統進行了比較。此外,在全面文獻綜述的基礎上,對FL主題和研究領域進行了新的分類,並對其關鍵技術和新興方面進行了分類,包括核心系統模型和設計、應用領域、隱私和安全以及資源管理。最後,討論了為外語教學的未來前景量身訂製的一些挑戰和新的研究方向。我們相信,我們調查FL的擬議方法可以為未來的研究進展和領域進展提供基本見解。

