不care工具,在大數據平台中Hive能自動處理SQL
摘要:有沒有更簡單的辦法,可以直接將SQL運行在大數據平台?
本文分享自華為雲社區《Hive執行原理》,作者: JavaEdge 。
MapReduce簡化了大數據編程的難度,使得大數據計算不再是高不可攀的技術聖殿,普通工程師也能使用MapReduce開發大數據程式。但是對於經常需要進行大數據計算的人,比如從事研究商業智慧(BI)的數據分析師來說,他們通常使用SQL進行大數據分析和統計,MapReduce編程還是有一定的門檻。而且如果每次統計和分析都開發相應的MapReduce程式,成本也確實太高了。
有沒有更簡單的辦法,可以直接將SQL運行在大數據平台?
先看如何用MapReduce實現SQL數據分析。
MapReduce實現SQL的原理
常見的一條SQL分析語句,MapReduce如何編程實現?
SELECT pageid, age, count(1) FROM pv_users GROUP BY pageid, age;
統計分析語句,統計不同年齡用戶訪問不同網頁的興趣偏好,具體數據輸入和執行結果:
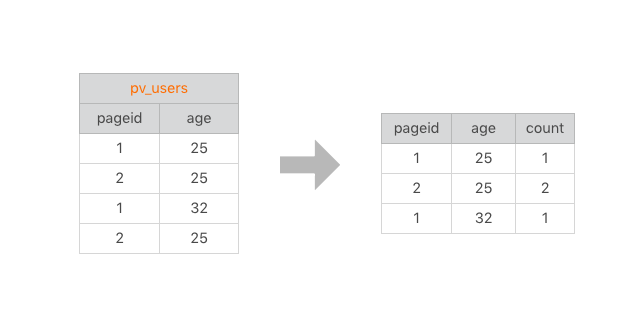
- 左邊,要分析的數據表
- 右邊,分析結果
把左表相同的行求和,即得右表,類似WordCount計算。該SQL的MapReduce的計算過程,按MapReduce編程模型
- map函數的輸入K和V,主要看V
V就是左表中每行的數據,如<1, 25>
- map函數的輸出就是以輸入的V作為K,V統一設為1
比如<<1, 25>, 1>
map函數的輸出經shuffle後,相同的K及其對應的V被放在一起組成一個<K, V集合>,作為輸入交給reduce函數處理。比如<<2, 25>, 1>被map函數輸出兩次,那麼到了reduce這裡,就變成輸入<<2, 25>, <1, 1>>,這裡的K是<2, 25>,V集合是<1, 1>。
在reduce函數內部,V集合里所有的數字被相加,然後輸出。所以reduce的輸出就是<<2, 25>, 2>
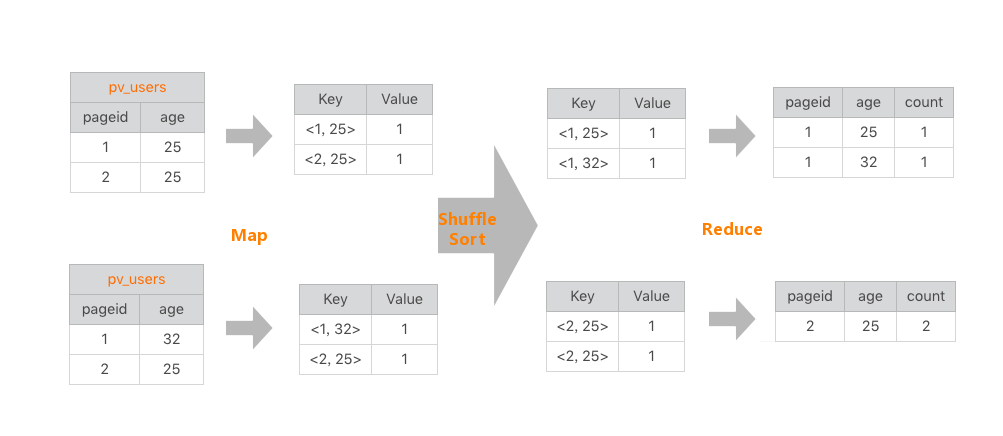
如此,一條SQL就被MapReduce計算好了。
在數據倉庫中,SQL是最常用的分析工具,既然一條SQL可以通過MapReduce程式實現,那有無工具能自動將SQL生成MapReduce程式碼?這樣數據分析師只要輸入SQL,即可自動生成MapReduce可執行的程式碼,然後提交Hadoop執行。這就是Hadoop大數據倉庫Hive。
Hive架構
Hive能直接處理我們輸入的SQL(Hive SQL語法和資料庫標準SQL略不同),調用MapReduce計算框架完成數據分析操作。
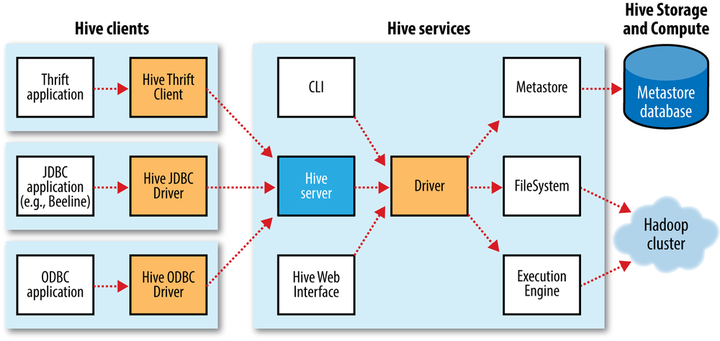
通過Hive Client(Hive的命令行工具,JDBC等)向Hive提交SQL命令:
- 若為DDL,Hive會通過執行引擎Driver將數據表的資訊記錄在Metastore元數據組件,該組件通常用一個關係資料庫實現,記錄表名、欄位名、欄位類型、關聯HDFS文件路徑等這些資料庫的元資訊
- 若為DQL,Driver就會將該語句提交給自己的編譯器Compiler進行語法分析、語法解析、語法優化等一系列操作,最後生成一個MapReduce執行計劃。然後根據執行計劃生成一個MapReduce的作業,提交給Hadoop MapReduce計算框架處理。
對一個簡單的SQL命令:
SELECT * FROM status_updates WHERE status LIKE 『michael jackson』;
其對應的Hive執行計劃:
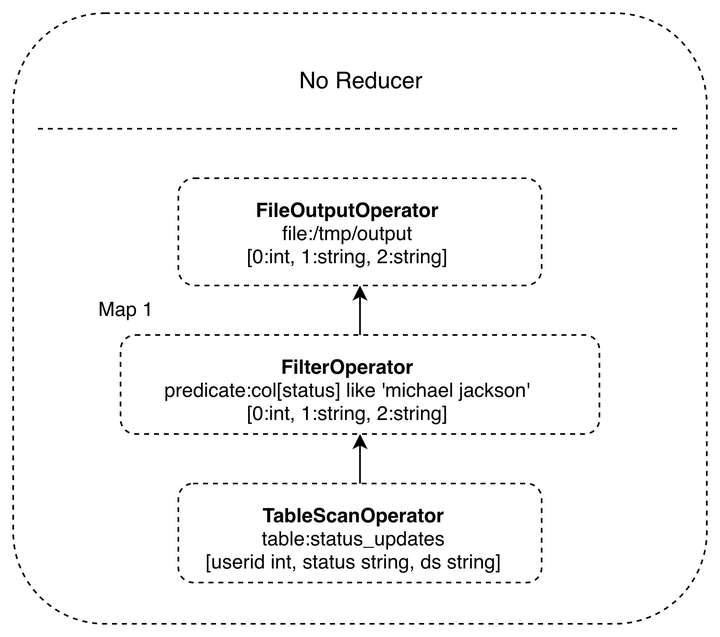
Hive內部預置了很多函數,Hive執行計劃就是根據SQL語句生成這些函數的DAG(有向無環圖),然後封裝進MapReduce的map、reduce函數。該案例中的map函數調用了三個Hive內置函數TableScanOperator、FilterOperator、FileOutputOperator,就完成了map計算,而且無需reduce函數。
Hive如何實現join操作
除了簡單的聚合(group by)、過濾(where),Hive還能執行連接(join on)操作。
pv_users表的數據在實際中無法直接得到,因為pageid數據來自用戶訪問日誌,每個用戶進行一次頁面瀏覽,就會生成一條訪問記錄,保存在page_view表中。而age年齡資訊則記錄在用戶表user。
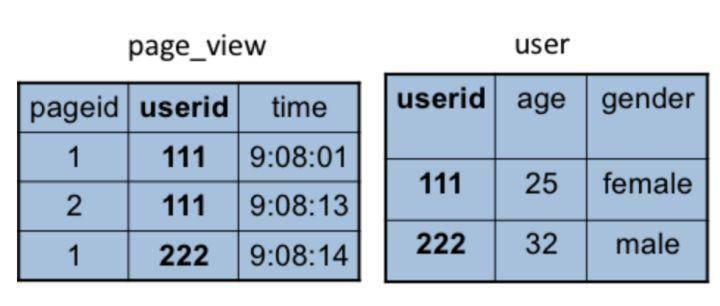
這兩張表都有一個相同的欄位userid,據該欄位可連接兩張表,生成前面例子的pv_users表:
SELECT pv.pageid, u.age FROM page_view pv JOIN user u ON (pv.userid = u.userid);
該SQL命令也能轉化為MapReduce計算,連接過程如下:
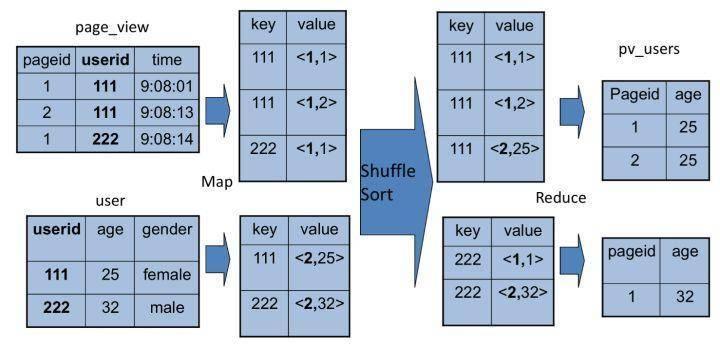
join的MapReduce計算過程和前面的group by稍有不同,因為join涉及兩張表,來自兩個文件(夾),所以需要在map輸出的時候進行標記,比如來自第一張表的輸出Value就記錄為<1, X>,這裡的1表示數據來自第一張表。這樣經過shuffle以後,相同的Key被輸入到同一個reduce函數,就可以根據表的標記對Value數據求笛卡爾積,用第一張表的每條記錄和第二張表的每條記錄連接,輸出就是join的結果。
所以打開Hive源碼,看join相關程式碼,會看到一個兩層for循環,對來自兩張表的記錄進行連接操作。
總結
開發無需經常編寫MapReduce程式,因為網站最主要的大數據處理就是SQL分析,因此Hive在大數據應用很重要。
隨Hive普及,我們對在Hadoop上執行SQL的需求越強,對大數據SQL的應用場景也多樣化起來,於是又開發了各種大數據SQL引擎。
Cloudera開發了Impala,運行在HDFS上的MPP架構的SQL引擎。和MapReduce啟動Map和Reduce兩種執行進程,將計算過程分成兩個階段進行計算不同,Impala在所有DataNode伺服器上部署相同的Impalad進程,多個Impalad進程相互協作,共同完成SQL計算。在一些統計場景中,Impala可做到ms級計算速度。
後來Spark誕生,也推出自己的SQL引擎Shark,即Spark SQL,將SQL語句解析成Spark的執行計劃,在Spark上執行。由於Spark比MapReduce快很多,Spark SQL也相應比Hive快很多,並且隨著Spark的普及,Spark SQL也逐漸被人們接受。後來Hive推出了Hive on Spark,將Hive的執行計劃轉換成Spark的計算模型。
我們還希望在NoSQL執行SQL,畢竟SQL發展幾十年,積累龐大用戶,很多人習慣用SQL解決問題。於是Saleforce推出了Phoenix,一個執行在HBase上的SQL引擎。
這些SQL引擎只支援類SQL語法,並不能像資料庫那樣支援標準SQL,特別是數據倉庫領域幾乎必然會用到嵌套查詢SQL:在where條件裡面嵌套select子查詢,但幾乎所有的大數據SQL引擎都不支援。然而習慣於傳統資料庫的使用者希望大數據也能支援標準SQL。
回到Hive。Hive本身的技術架構其實並沒有什麼創新,資料庫相關的技術和架構已經非常成熟,只要將這些技術架構應用到MapReduce上就得到了Hadoop大數據倉庫Hive。但是想到將兩種技術嫁接到一起,卻是極具創新性的,通過嫁接產生出的Hive極大降低大數據的應用門檻,也使Hadoop得到普及。
參考

