【面試普通人VS高手】Kafka的零拷貝原理?
- 2022 年 4 月 9 日
- 筆記
- 面試, kafka, 並發編程, 面試普通人vs高手系列
最近一個學員去滴滴面試,在第二面的時候遇到了這個問題:
"請你簡單說一下Kafka的零拷貝原理"
然後那個學員努力在大腦里檢索了很久,沒有回答上來。
那麼今天,我們基於這個問題來看看,普通人和高手是如何回答的!
普通人的回答:
零拷貝是一種減少數據拷貝的機制,能夠有效提升數據的效率
高手的回答:
在實際應用中,如果我們需要把磁碟中的某個文件內容發送到遠程伺服器上,如圖
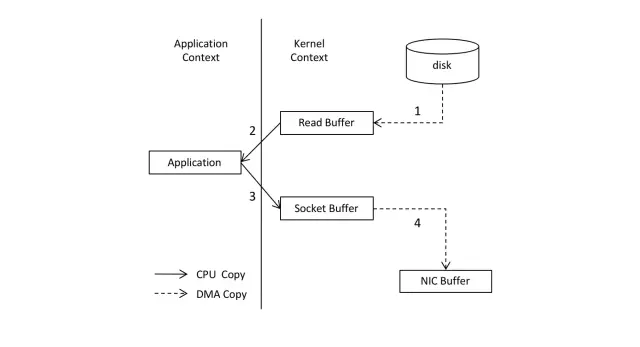
那麼它必須要經過幾個拷貝的過程:
- 從磁碟中讀取目標文件內容拷貝到內核緩衝區
- CPU控制器再把內核緩衝區的數據賦值到用戶空間的緩衝區中
- 接著在應用程式中,調用
write()方法,把用戶空間緩衝區中的數據拷貝到內核下的Socket Buffer中。 - 最後,把在內核模式下的SocketBuffer中的數據賦值到網卡緩衝區(NIC Buffer)
- 網卡緩衝區再把數據傳輸到目標伺服器上。
在這個過程中我們可以發現,數據從磁碟到最終發送出去,要經歷4次拷貝,而在這四次拷貝過程中,有兩次拷貝是浪費的,分別是:
- 從內核空間賦值到用戶空間
- 從用戶空間再次複製到內核空間
除此之外,由於用戶空間和內核空間的切換會帶來CPU的上線文切換,對於CPU性能也會造成性能影響。
而零拷貝,就是把這兩次多於的拷貝省略掉,應用程式可以直接把磁碟中的數據從內核中直接傳輸給Socket,而不需要再經過應用程式所在的用戶空間,如下圖所示。
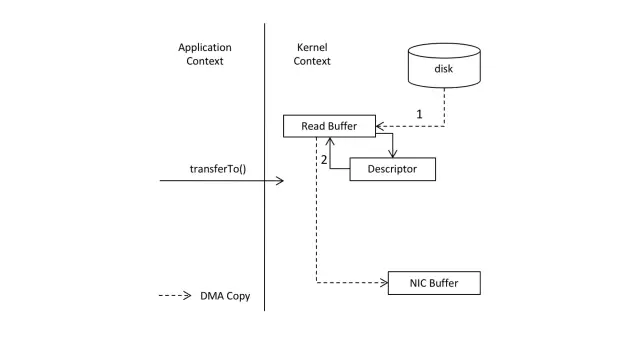
零拷貝通過DMA(Direct Memory Access)技術把文件內容複製到內核空間中的Read Buffer。
接著把包含數據位置和長度資訊的文件描述符載入到Socket Buffer中,DMA引擎直接可以把數據從內核空間中傳遞給網卡設備。
在這個流程中,數據只經歷了兩次拷貝就發送到了網卡中,並且減少了2次cpu的上下文切換,對於效率有非常大的提高。
所以,所謂零拷貝,並不是完全沒有數據賦值,只是相對於用戶空間來說,不再需要進行數據拷貝。對於前面說的整個流程來說,零拷貝只是減少了不必要的拷貝次數而已。
在程式中如何實現零拷貝呢?
- 在Linux中,零拷貝技術依賴於底層的sendfile()方法實現
- 在Java中,FileChannal.transferTo() 方法的底層實現就是 sendfile() 方法。
除此之外,還有一個 mmap 的文件映射機制
它的原理是:將磁碟文件映射到記憶體, 用戶通過修改記憶體就能修改磁碟文件。使用這種方式可以獲取很大的I/O提升,省去了用戶空間到內核空間複製的開銷。
以上就是我對於Kafka中零拷貝原理的理解
總結
本期的普通人VS高手面試系列就到這裡結束了。
本次的面試題涉及到一些電腦底層的原理,基本上也是業務程式設計師的知識盲區。
但我想提醒大家,做開發其實和建房子一樣,要想樓層更高更穩,首先地基要打牢固。
另外,如果你有任何面試相關的疑問,歡迎評論區給我留言。
我是Mic,一個工作了14年的Java程式設計師,咱們下篇文章再見。

