Python IO文件管理
- 2022 年 3 月 19 日
- 筆記
- python小白的成長之路
文件操作
我們可以使用python來操作文件,比如讀取文件內容、寫入新的內容等,因為任何電腦文件的本質都是一些有不同後綴的字元組成的。
python文件操作的兩種模式
打開模式
- while,寫入模式,簡寫為 w ,指定的文件不存在則創建文件,存在則打開並清空內容,並且將文件指針(游標)放在文件的開頭。
- read,讀取模式,簡寫為 r ,文件不存在則報錯,存在則打開文件,並且將文件指針放在文件的開頭。
- append,追加模式,簡寫為 a ,文件不存在則創建文件,存在則打開文件,並且將指針放在文件末尾。
- xor,異或模式,簡寫為 x ,文件存在則報錯,不存在則創建文件,將文件指針放在文件的開頭。
擴展模式
擴展模式是用來配合打開模式的輔助模式,擴展模式單獨不能使用。
- plus,增強模式,簡寫為 + ,可以讓打開模同時具有讀寫功能。
- bytes,bytes模式,簡寫為 b ,將文件按照二進位位元組流編碼進行讀寫。
因此我們根據這兩種大的模式可以組合成為16種操作文件的方法。
| 模式 | 作用 | 模式 | 作用 |
|---|---|---|---|
| w | 寫入模式,只可寫,不可讀。 | a | 追加模式,只可寫,不可讀。 |
| w+ | 寫入模式,可寫可讀。 | a+ | 追加模式,可寫可讀。 |
| wb | 寫入模式,按照二進位位元組流編碼可寫不可讀 | ab | 追加模式,按照二進位位元組流可寫不可讀 |
| wb+ | 寫入模式,按照二進位位元組流編碼可寫可讀 | ab+ | 追加模式,按照二進位位元組流可寫可讀。 |
| r | 讀取模式,只可讀,不可寫。(默認模式) | x | 異或模式,只可寫,不可讀。 |
| r+ | 讀取模式,可寫可讀。 | x+ | 異或模式,可寫可讀。 |
| rb | 讀取模式,按照二進位位元組流編碼可讀不可寫。 | xb | 異或模式,二進位位元組流可寫不可讀。 |
| rb+ | 讀取模式,按照二進位位元組流編碼可讀可寫。 | xb+ | 異或模式,二進位位元組流可寫可讀。 |
異或模式和寫入模式的區別在於,異或模式如果打開的文件在指定的路徑中如果存在,就會報錯;而寫入模式是直接打開不會報錯,但是會將源文件中的所有內容清空。因為寫入模式和讀取模式之間的互相配合,異或模式的使用頻率越來越少,正在逐步淘汰當中。
編碼格式的了解
編碼是資訊從一種形式或格式轉換為另一種形式的過程,就是用預先規定的方法將文字、數字或其它對象編成數碼,或將資訊、數據轉換成規定的電脈衝訊號。這樣做的目的是為了簡化資訊之間的傳遞。但是為保證編碼的正確性,編碼要規範化、標準化,即需有標準的編碼格式。常見的編碼格式有ASCII、ANSI、GBK、GB2312、Unicode、UTF-8等。
所有的編碼格式,都是將字元轉換成對應的二進位格式。將西方的字母文字和數字按照一個位元組的方式存儲,而將亞洲中中、日、朝等文字按照多位元組存儲。這是因為西方的字母語言,字母的數量遠少於東方的文字數量,因此編程工作中一般更加的傾向與盡量多的使用英文的原因,因為相對的來說使用漢字等字元較少的程式可以佔據更少的系統資源。
常用的編碼格式
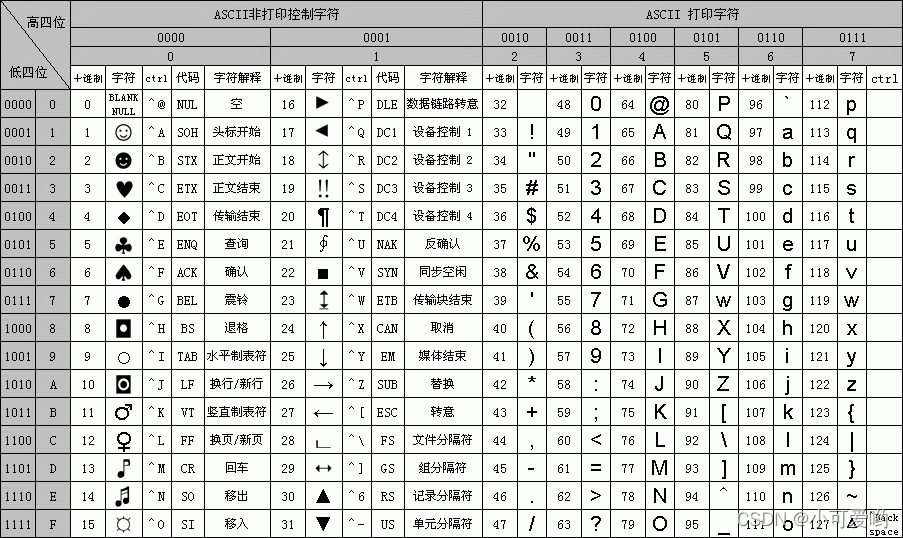
英文原始編碼:ASCII碼
ACSII編碼只有128個字元,26個英文字母的大小寫之外,還有一些常用的符號,還有一些不可或缺的系統控制字元等。ACSII編碼中沒有除了英文字母之外的其它語言字元。
中文國家標準編碼:GB系列編碼
凡是由GB開頭的編碼集都是屬於中國國家的標準編碼字符集,只是不同的版本而已,使用這個編碼的漢字佔用的系統資源最少,中文使用2個位元組的存儲空間。比如GB2312。
萬國碼:Unicode編碼
Unicode編碼包含世界上所有的文字,無論什麼字元都以4個位元組進行存儲。這是Unicode編碼的缺點,雖然擁有世界上最齊全的字元,但是佔用的系統資源很大,所以很少使用。
因此在這個基礎之上改進,創建了可變長的Unicode編碼集,UTF系列。這是目前世界上最主流的編碼字符集,在這個編碼集當中,不用擔心任何字元會亂碼,字母文字和數字使用一個位元組的存儲空間,中文等字元使用三個位元組的存儲空間,大大節省了空間的佔用。比如UTF-8。
open函數的使用
python中操作文件要使用到open函數,open函數的作用是用於打開一個文件,創建一個file對象,使用相關的方法調用它對文件進行讀寫操作。
語法:open(file, mode=None, encoding=None)
參數說明:
- file:文件的位置和名稱
- mode:操作的模式,使用簡寫,就是我們上述的16中操作方式
- encoding:指定編碼類型,比如UTF-8、GB2312、ACSII等
open函數指定這些資訊之後,返回一個TextIOWrapper對象,使用這個對象,我們可以按照指定的操作模式和編碼格式來操作我們指定的文件。
文件的寫入(寫入模式)
現在我們在使用open函數創建一個文件,並寫入內容。
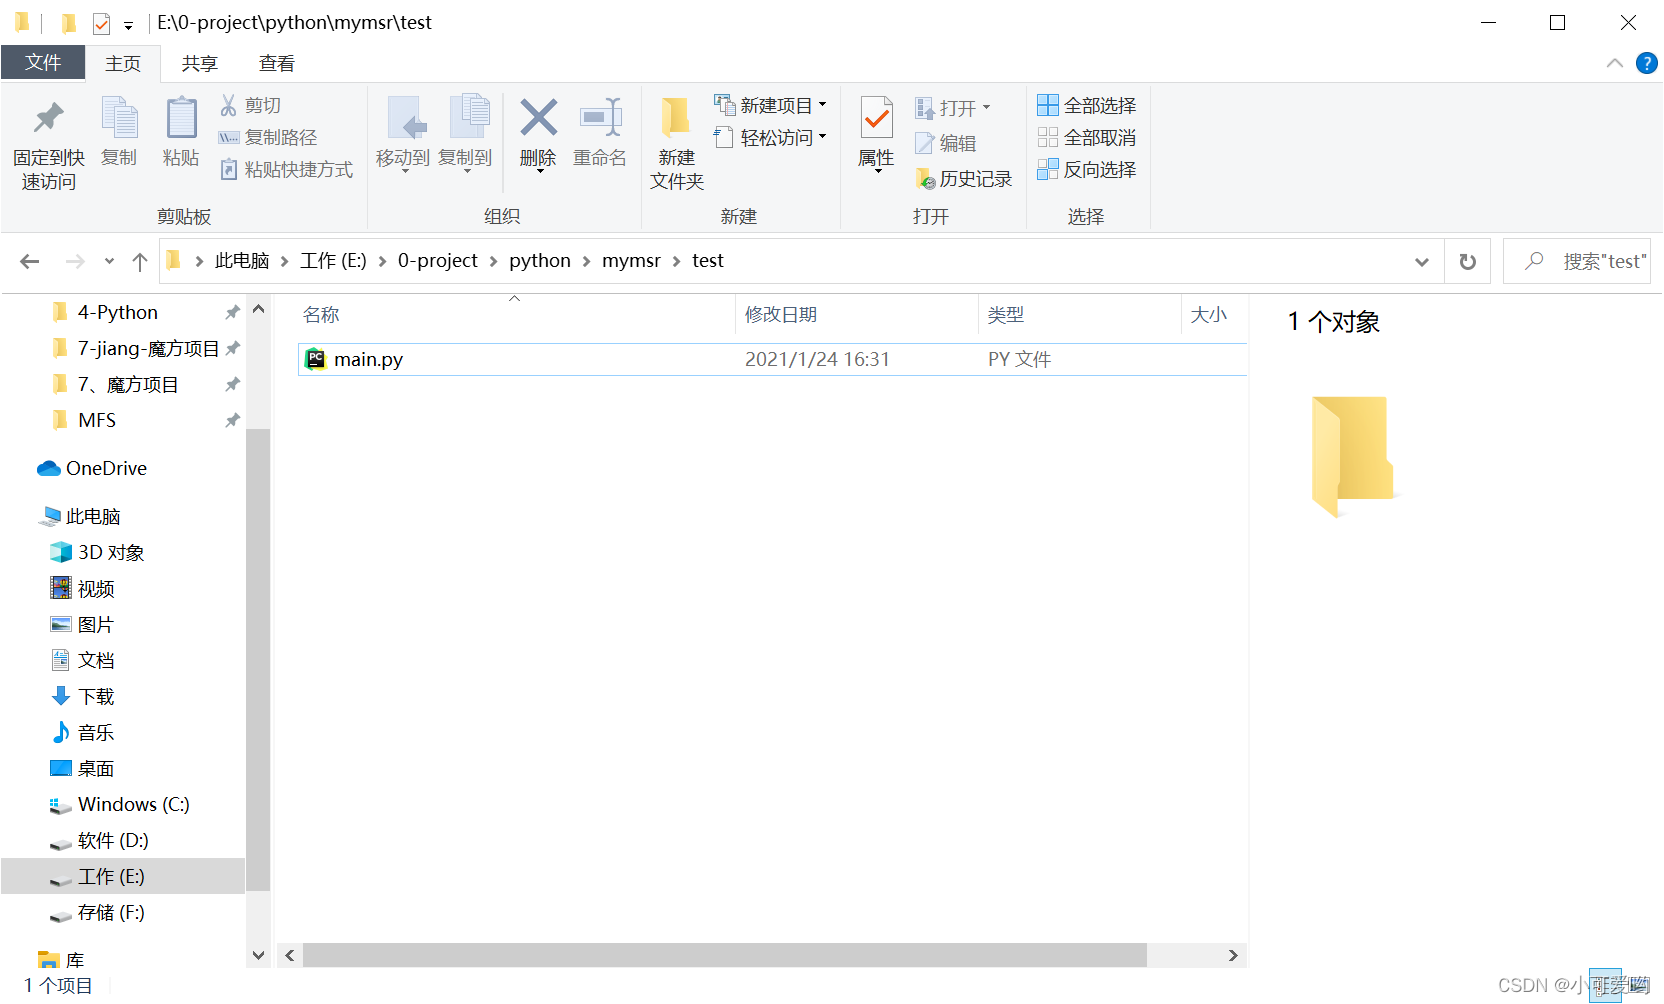
可以看到我們當前的目錄當中只有一個main.py文件,我們現在寫入程式碼。
# 指定文件的位置,要使用字元串,可以使用絕對路徑和相對路徑
# 操作模式的選擇,我們要創建一個新的文件並寫入內容,使用 w
# 指定編碼格式為UTF-8,這是最常使用的編碼格式

# fp就是文件的IO對象,問價句柄,用來操作文件
# i --- >   input  輸入
# o --- >   output 輸出
fp = open('test.txt', 'w', encoding='UTF-8')

# 使用write函數寫入內容
fp.write('Hello motherland')

# 使用close函數關閉文件
fp.close()
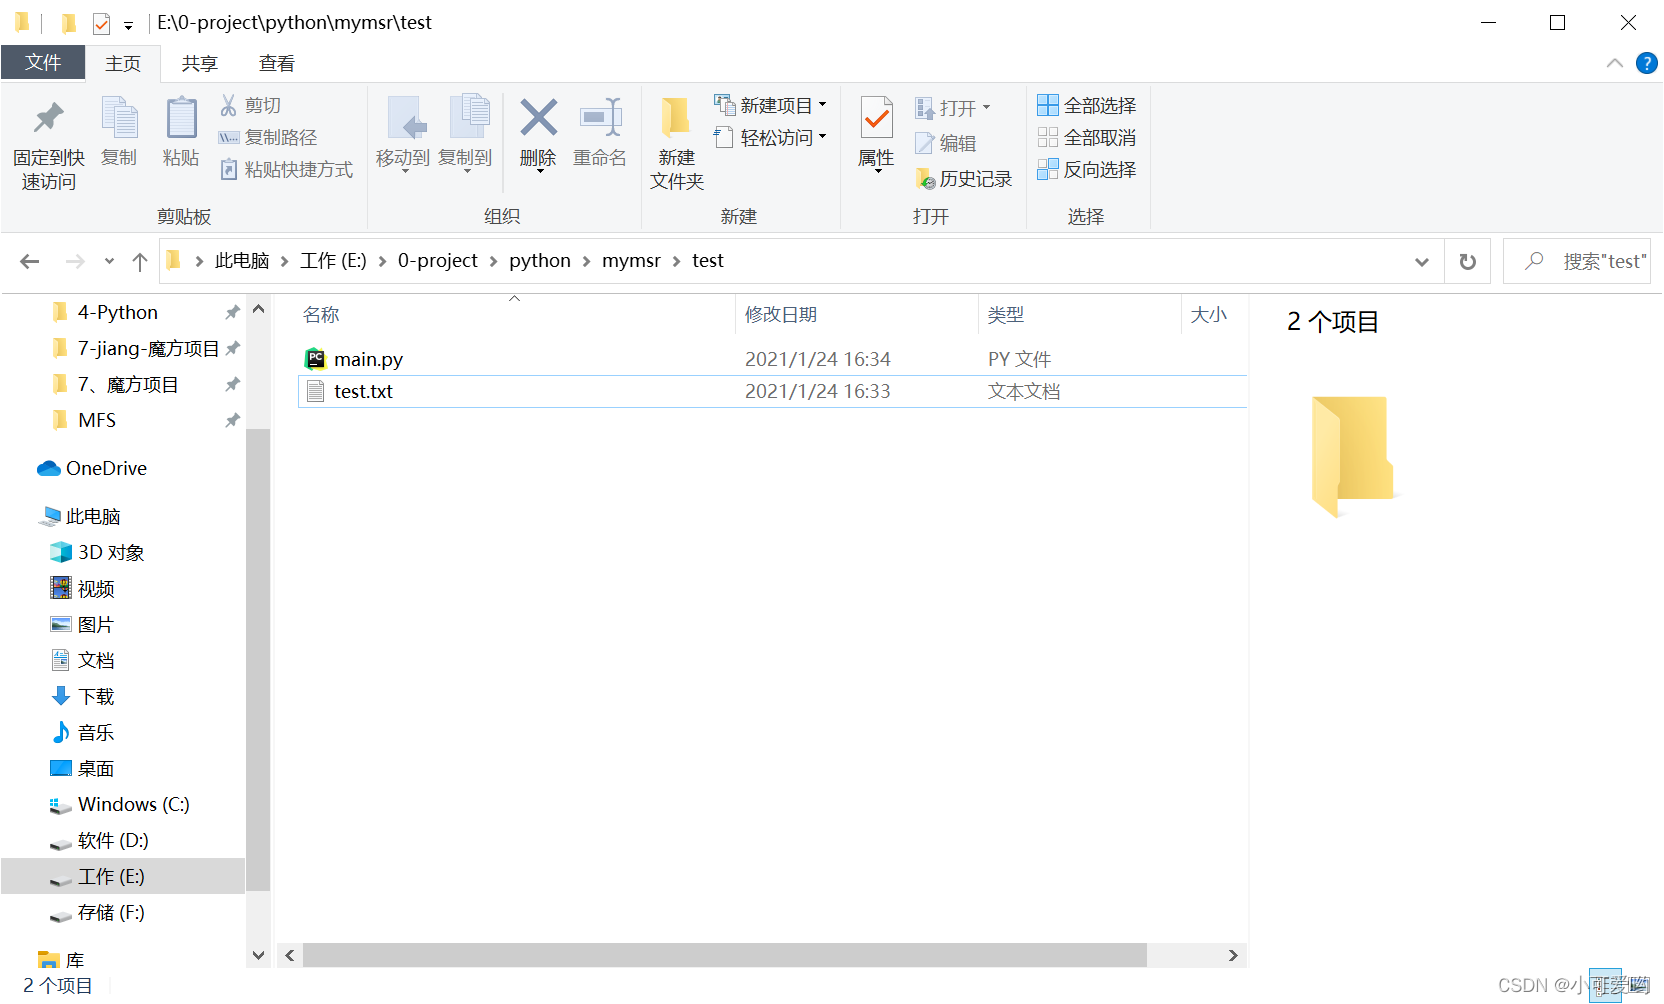
執行python程式碼之後,我們發現在原來的目錄下面多出了一個名為test.txt的文件。
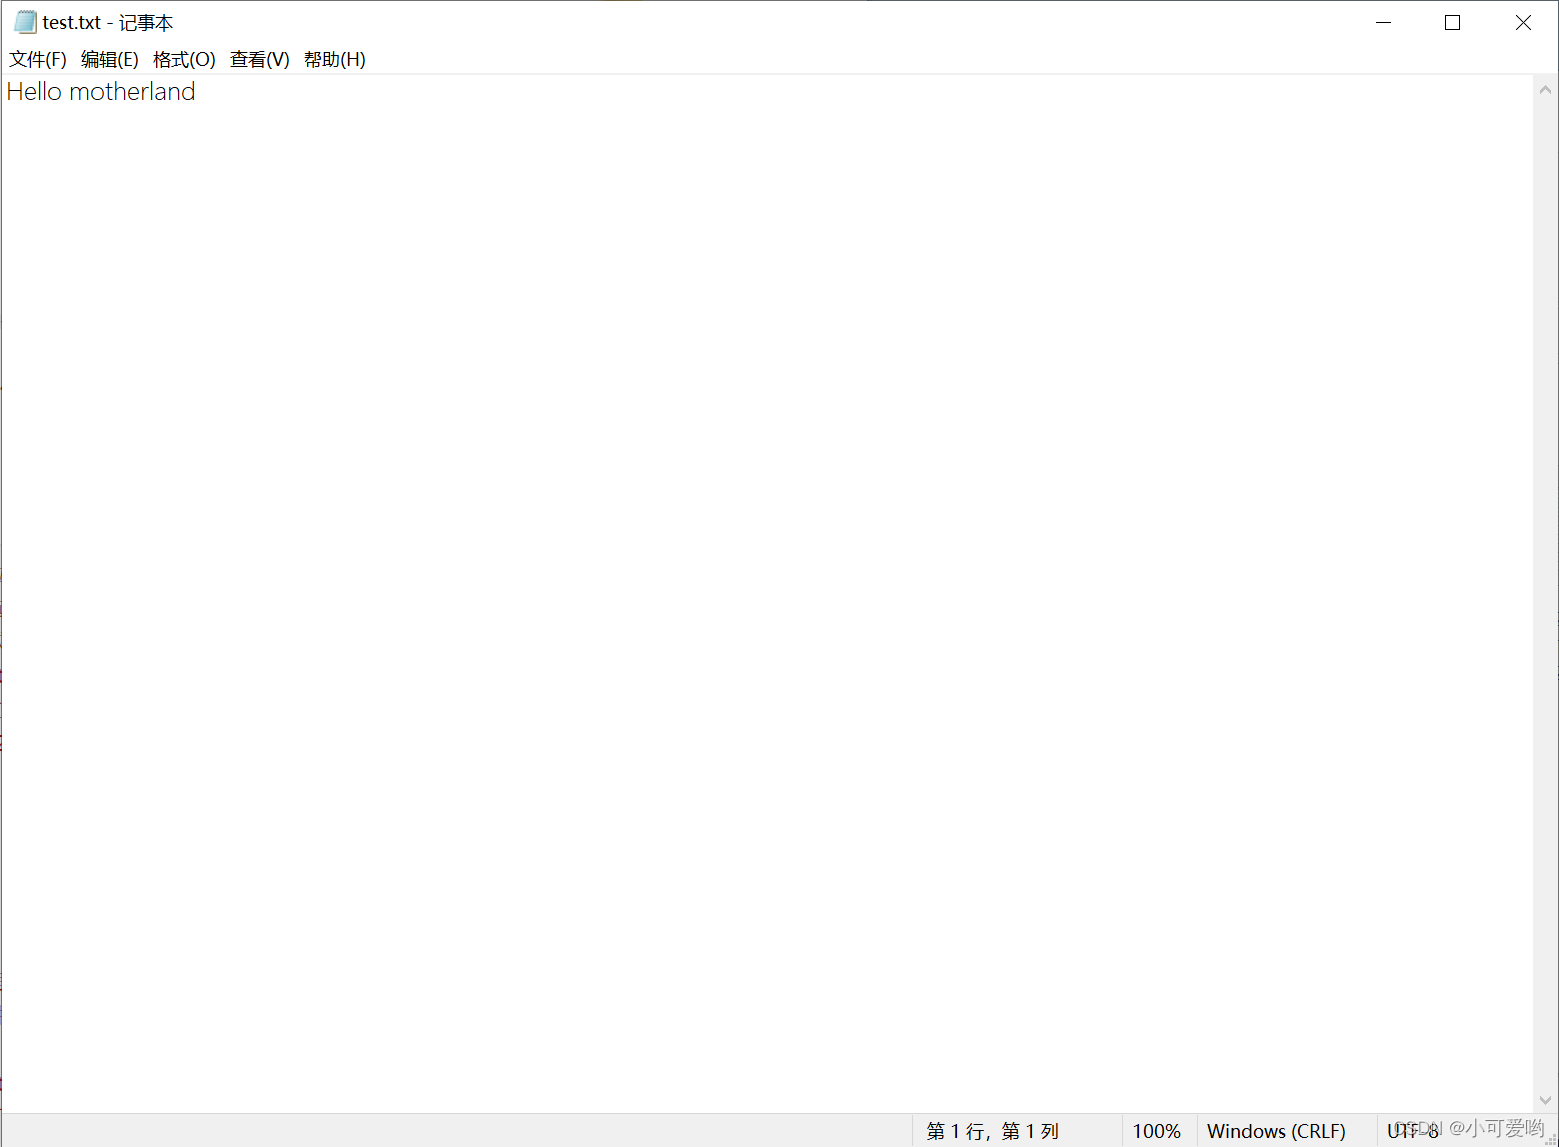
打開這個文件我們就會發現,文件中的內容就是我們寫下的內容。
現在我們重新使用 w 模式打開這個文件,但是不操作任何東西,讓我們看看結果如何。
fp = open('test.txt', 'w', encoding='UTF-8')
fp.close()
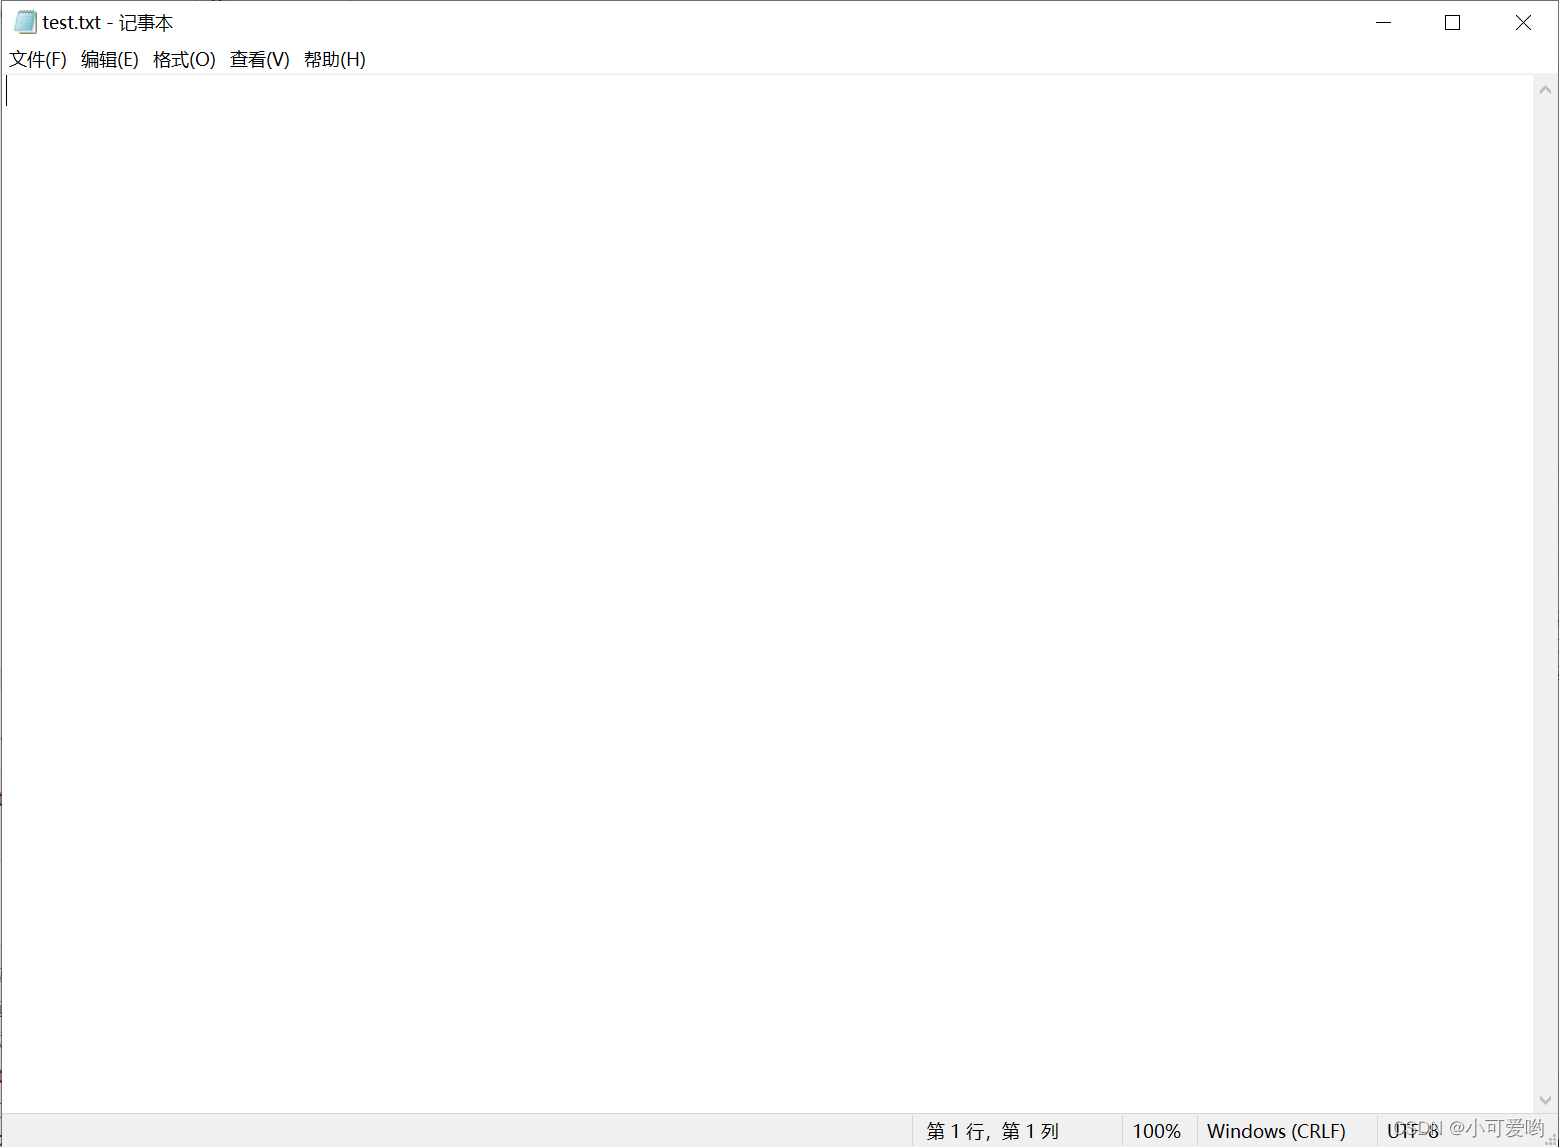
沒錯,這個文件中的內容被清空了,這就是w模式的如果文件存在,就打開文件並清空。
文件的讀取(讀取模式)
我們現在執行下面的程式碼,使用 r 模式讀取文件中的內容。
# 使用 r 模式打開msr.txt文件
fp = open('msr.txt', 'r', encoding='UTF-8')

# 讀取文件中的內容
res = fp.read()
print(res)

# 關閉文件
fp.close()
發現程式報錯了,這是為什麼?因為使用 r 模式如果指定的文件不存在就會報錯。
那我們先創建一個msr.txt文件在重新讀取一下。
# 先創建一個msr.txt文件
fp = open('msr.txt', 'w', encoding='UTF-8')
# 寫入內容
fp.write('劉德華太帥了。')
# 關閉文件
fp.close()


# 然後重新讀取這個文件
fp = open('msr.txt', 'r', encoding='UTF-8')

# 讀取文件中的內容
res = fp.read()

# 列印讀取的內容
print(res)   # 劉德華太帥了。

# 關閉文件
fp.close()
不再報錯了,而且也成功的列印出來文件中的內容。
文件內容追加(追加模式)
追加模式如果文件不存在就創建文件,反之就打開文件,但是可寫入模式的不同之處就在於,追加模式打開文件不會清空文件中的原有的數據內容。
打開msr.txt文件,我們看到只有一行文字。
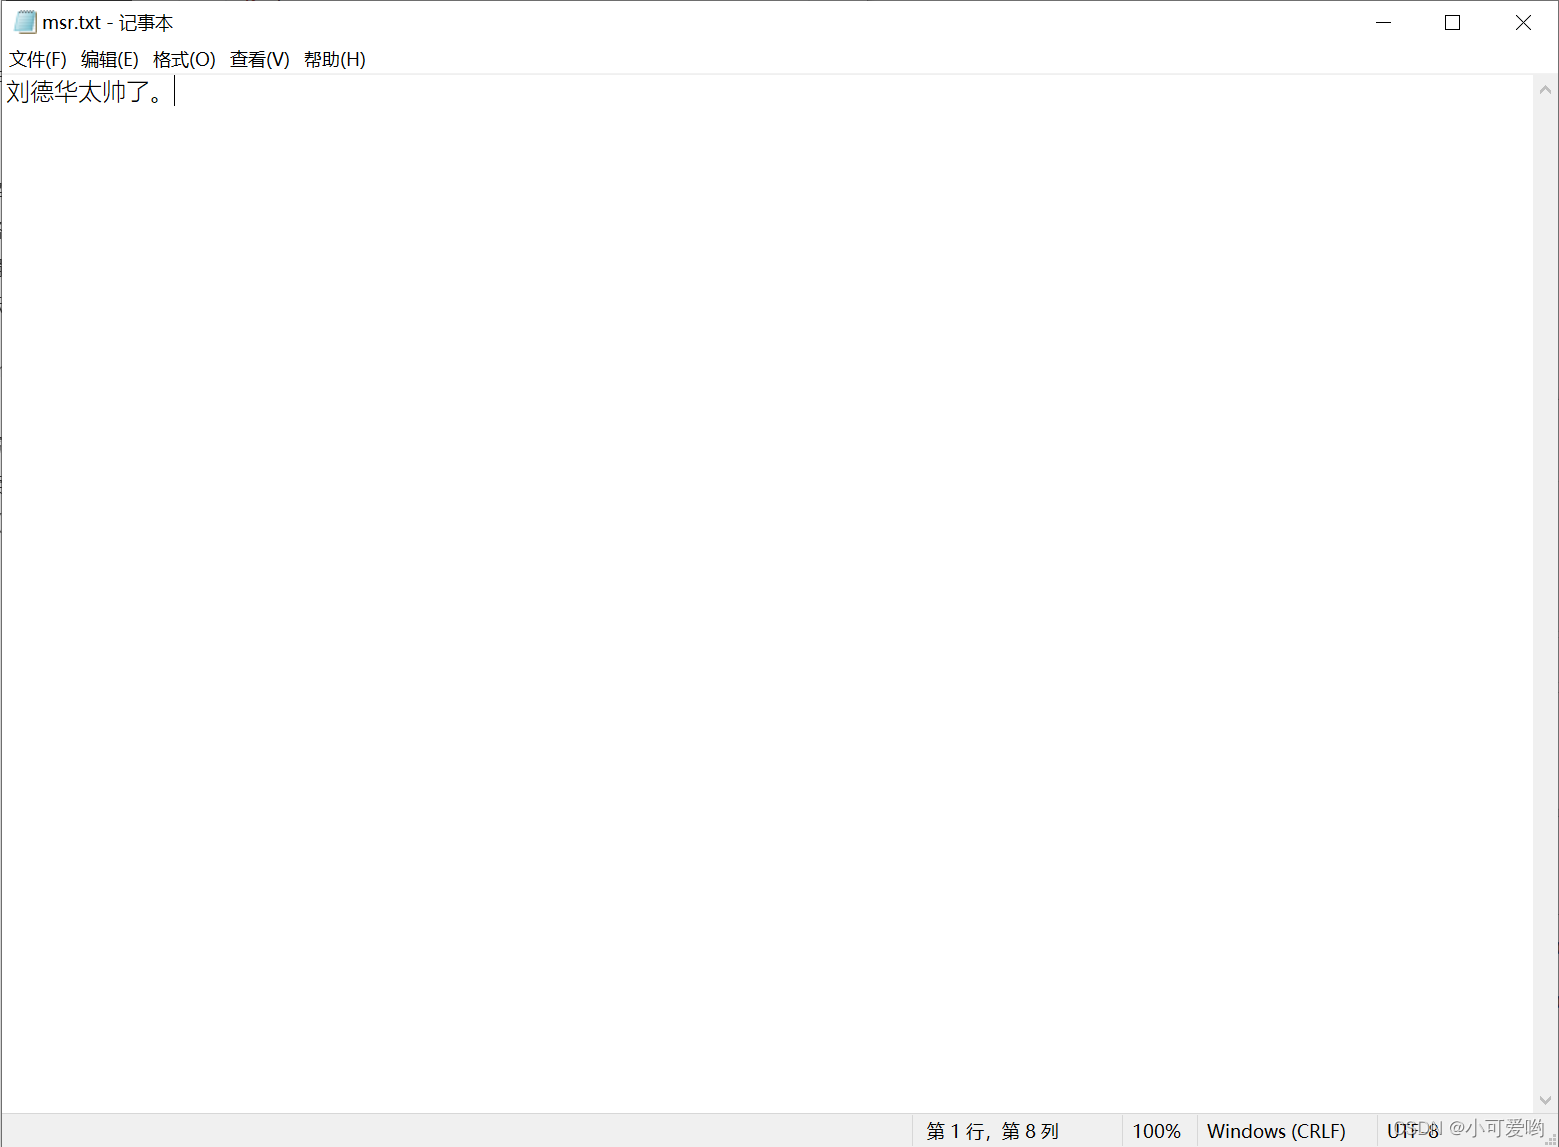
現在我們執行下面的程式碼
# 使用追加模式打開文件
fp = open('msr.txt', 'a', encoding='UTF-8')

# 在文件中寫入內容
fp.write('但是劉德華沒有部落客帥。')

# 關閉文件
fp.close()
打開文件我們看到,原有的數據並沒有被清空掉,並且寫入了新的內容。
[外鏈圖片轉存失敗,源站可能有防盜鏈機制,建議將圖片保存下來直接上傳(img-monzJF4R-1647692650673)(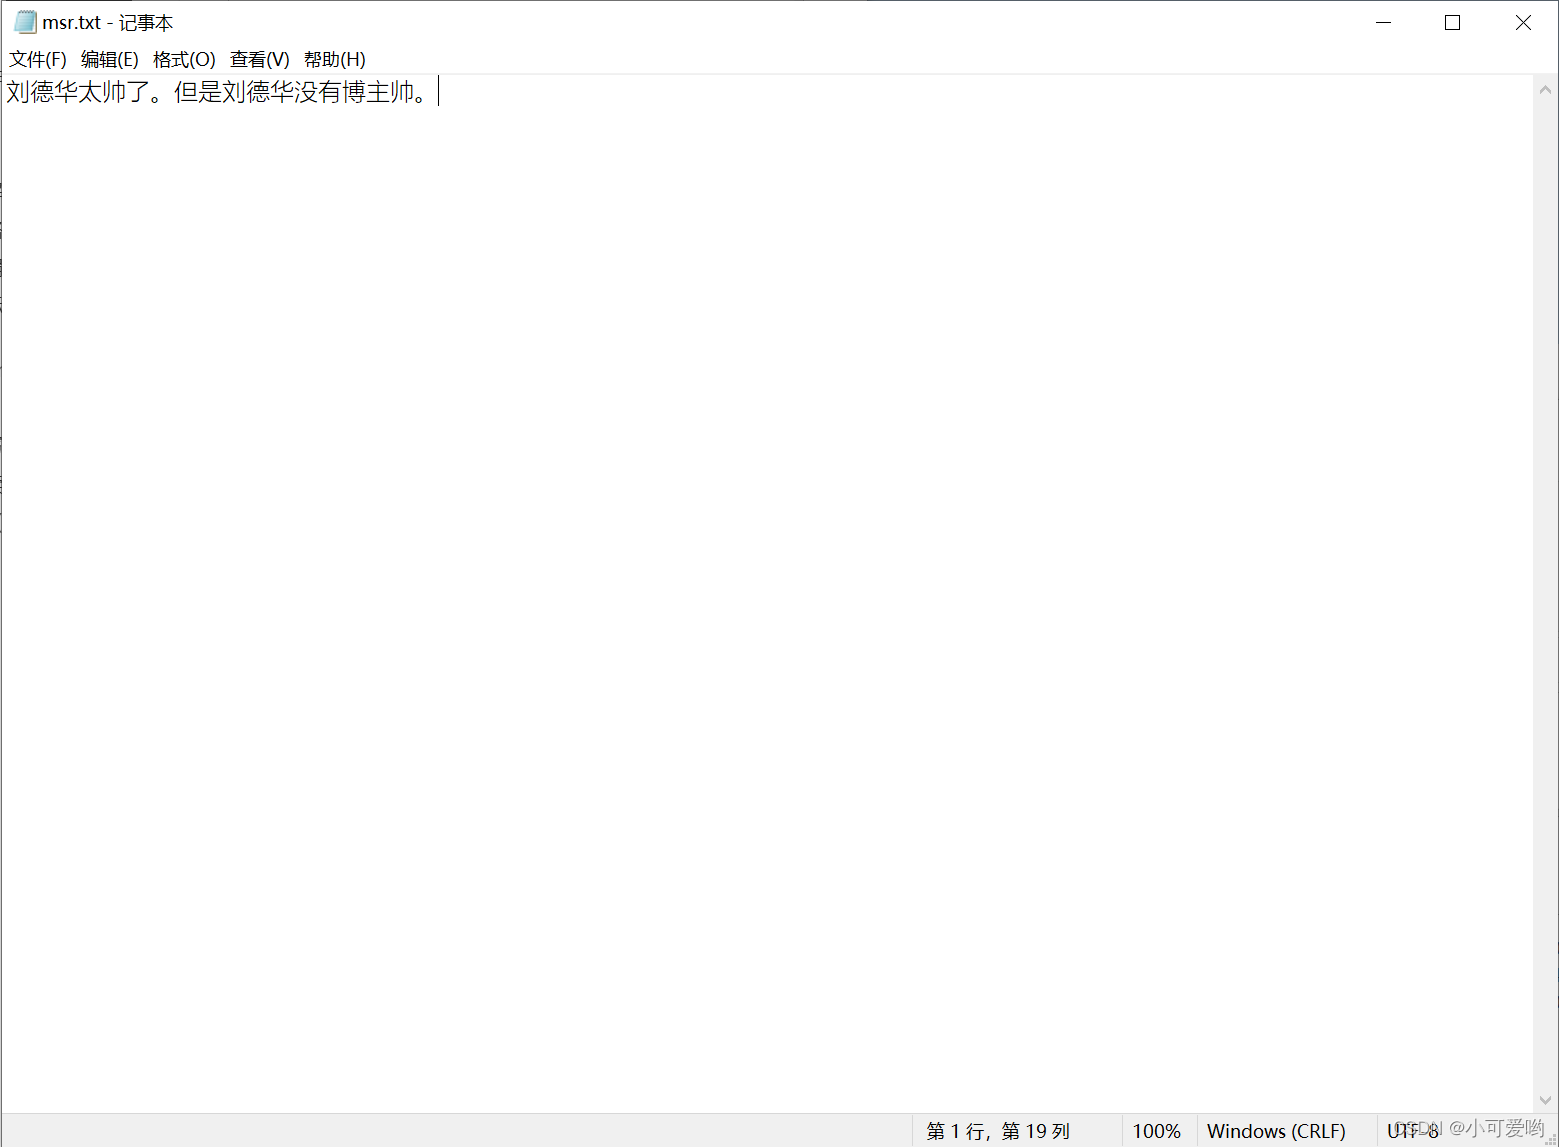
)]
位元組流的轉換
bytes是用來傳輸或者是存儲的數據格式,如果是在文件的操作過程中按照bytes的模式操作的話,就需要將數據格式轉換成為bytes流才可以。
二進位的位元組流就是底層的程式碼。
使用 b 前綴
在字元串之前加上字元 b 代表是二進位的位元組流,但是範圍只是ASCII編碼,也就是說這樣並不支援中文。
# 在字元串之前加上 b 前綴
bytechar = b'hello motherland'

print(bytechar)  # b'hello motherland'
# 該字元串的數據類型就變成了bytes流
print(type(bytechar))   # <class 'bytes'>

bytechar = b'你好祖國'	# error,只能將ACSII編碼中的字元變成bytes流
使用函數
使用encode函數和decode函數可以將字元串在普通字元串和位元組流的形式中來回的轉換,而且可以將所有的字元變成bytes位元組流,因為默認使用UTF-8編碼,當然你也可以指定轉換的編碼格式。
| 函數 | 作用 |
|---|---|
| encode | 將字元串轉換為二進位的位元組流 |
| decode | 將二進位的位元組流轉換為字元串 |
語法:
string.encode(encoding='UTF-8')
bytes.decode(encoing='UTF-8')
var = '我的祖國'

# 將字元串變成位元組流,默認使用UTF-8編碼
res = var.encode()
print(res)  # b'\xe6\x88\x91\xe7\x9a\x84\xe7\xa5\x96\xe5\x9b\xbd'
print(type(res))    # <class 'bytes'>


# 指定編碼格式UTF-8
res = var.encode(encoding='UTF-8')
print(res)  # b'\xe6\x88\x91\xe7\x9a\x84\xe7\xa5\x96\xe5\x9b\xbd'
# 可以看到指定為UTF-8編碼的和默認的結果是一樣的


# 指定編碼格式為ASCII
res = var.encode('ASCII')	# error
# 因為原字元串是中文,所以不能使用ASCII編碼


# 指定為GBK編碼
res = var.encode('GBK')
print(res)  # b'\xce\xd2\xb5\xc4\xd7\xe6\xb9\xfa'
# 可以看到GBK的編碼中文可以節省更多的空間


# 可以使用 len 函數檢測位元組流的長度
print(len(res))	# 8


# 解碼
var = res.decode()  # error
# 應為默認使用的UTF-8解碼,但是res的編碼格式是GBK,所以失敗


# 只能使用對應的編碼格式解碼
var = res.decode('GBK')
print(var)  # 我的祖國
存儲二進位的位元組流
如果在操作文件的時候要使用位元組流的方式,在使用open函數選擇模式的時候要加上 b ,表示進行位元組流的操作,然後open函數就不能在指定編碼格式了,因為現在的操作的都是位元組流,然而位元組流本身就已經是指定的編碼格式編碼過了。
# 如果指定了位元組流模式還要指定encoding參數就會報錯
fp = open('test.txt', 'wb', encoding='UTF-8')   # error


# 使用位元組流模式只能進行位元組流的寫入
fp = open('test.txt', 'wb')
# fp.write('hello motherland')    # error,不能直接使用字元串
fp.write(b'hello motherland')
fp.write('我的祖國'.encode())
fp.close()
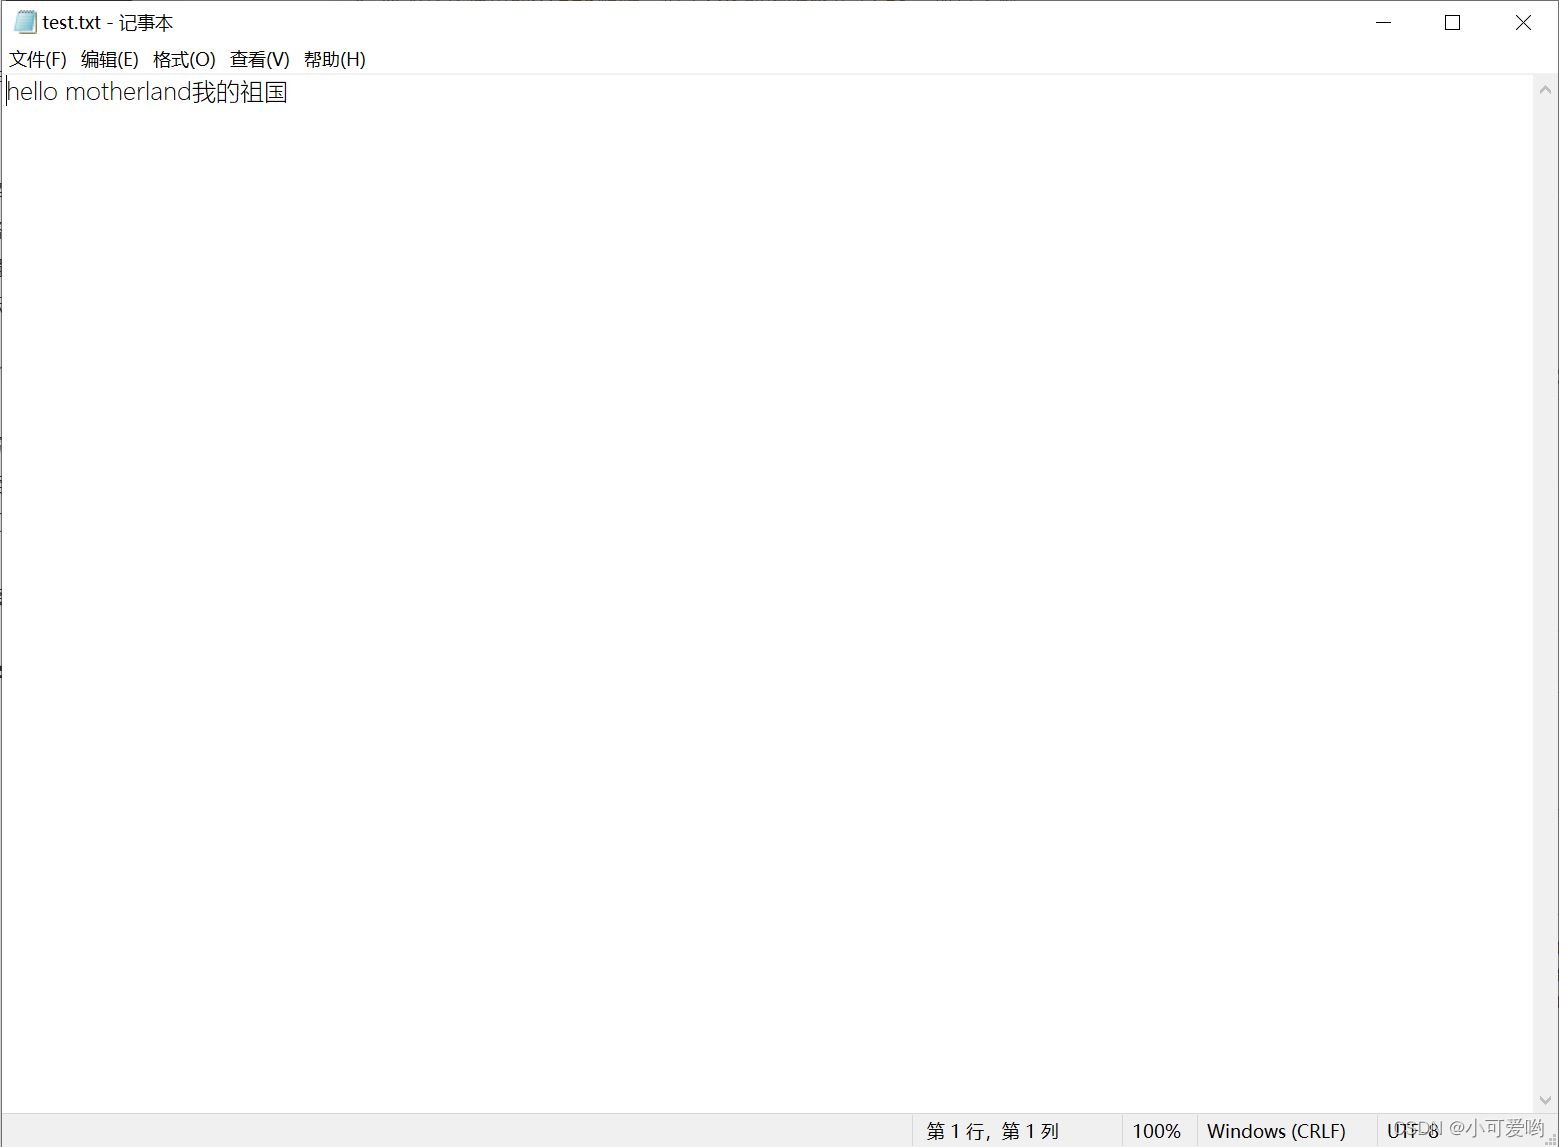
寫在文件中的內容還是原來的樣子,不是位元組流的形式
注意事項:
- 使用位元組流模式編輯過的文件只能使用位元組流模式去操作
- 使用什麼格式的位元組流寫入文件的內容,讀取的時候只能使用對應的編碼格式去解碼
- 任何文件都可以使用位元組流模式去讀取內容,讀取的內容是位元組流,如果這個文件是按照某個編碼格式寫入的,解碼需要使用對應的編碼格式;如果這個文件的內容不是使用位元組流模式寫入,讀取的位元組流默認是UTF-8格式的。
上下文管理器
在python中,有一些任務是當你開啟之後,結束的時候需要專門的關閉任務,比如文件操作,在結束操作的使用需要使用close()函數專門的關閉文件、結束任務,這樣就很繁瑣,所以python中推出了 with …… as ……的語法,在 with 程式碼塊中如果結束操作,不需要在專門的結束任務。
上下文管理器,任何需要進行上下文操作的對象,都可以使用此語法。
語法:with 任務 as 操作句柄:
# 不需要在使用close()函數專門的關閉文件,結束任務了
with open('test.txt', 'wb') as fp:
	fp.write(b'hello motherland')
刷新緩衝區
我們學習了這麼久,每次都一定要關閉文件、結束任務,這樣做的意義是什麼?
比較直觀的目的就是為了保存文件,但是好奇的我們早就測試了不使用close()關閉文件,寫入的內容一樣是保存了文件中的,這是怎麼回事?
看下面的程式碼,發現我們文件中依然是保存了我們寫入的內容。
fp = open('test.txt', 'w', encoding='UTF-8')
fp.write('我和我的祖國,就像是海和浪花一朵。')
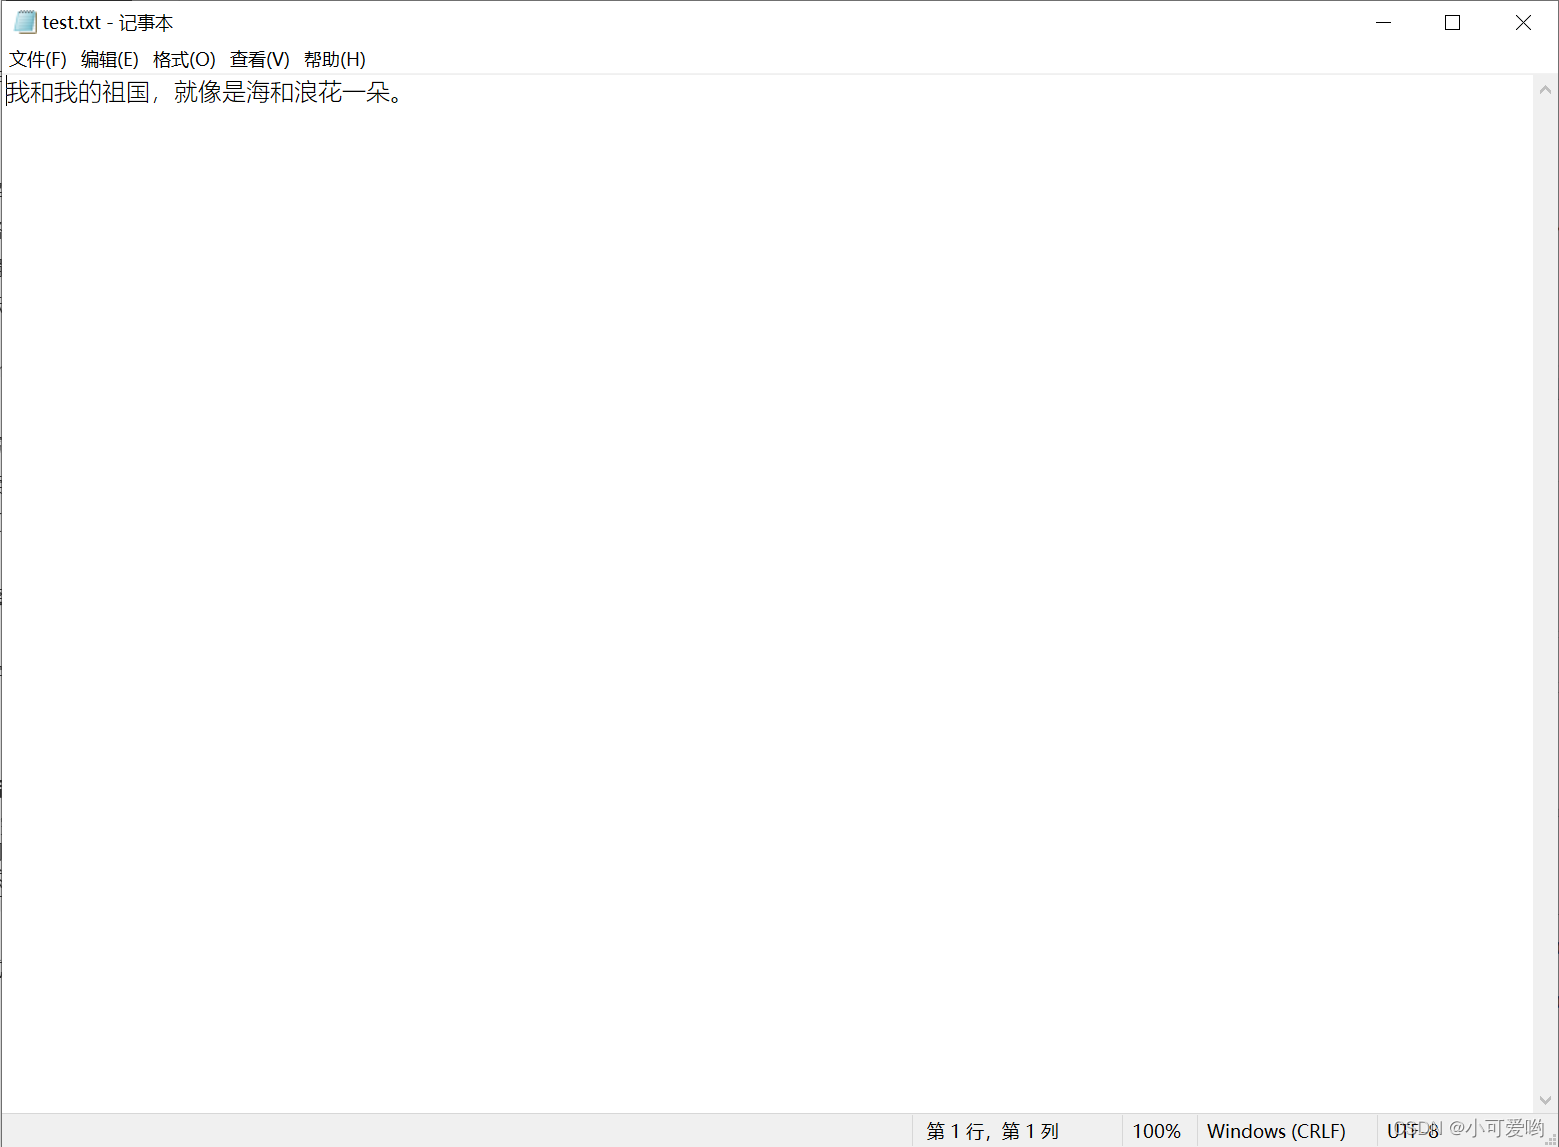
這是因為,關閉文件的根本目的是為了刷新緩衝區,然而刷新緩衝區的方法不止一種。
- 當文件關閉的時候自動刷新緩衝區
- 當整個程式運行結束的時候自動刷新緩衝區
- 當緩衝區寫滿還自動刷新緩衝區
- 手動刷新緩衝區
刷新緩衝區的意義在於最後的保存文件,就好像在使用文檔編輯器的時候,雖然寫滿內容,但最後不點擊保存按鈕內容也不會保存下來。
而我們上面的例子就是因為程式運行結束的時候自動刷新了緩衝區,所以才保存了寫入文件的內容,而close的作用就是關閉文件,關閉文件也可以刷新緩衝區,所以這就是每次要關閉文件的原因所在,為了防止自動刷新的失敗。
那麼什麼情況之下程式就沒有辦法執行完呢?
比如說程式的意外中斷、或者是死循環,下面的程式碼中就是因為死循環的原因導致程式沒有辦法執行完成,而沒有保存新寫入的內容。
下面的程式碼,先是寫入了內容,然後就是一個死循環,這樣程式永遠都不會執行完成,就不能自動的刷新緩衝區,如果程式意外中斷,內容也不會寫入文件當中,你可以將程式運行起來之後,強制中斷測試一下,會發現是一個空文件。
with open('test.txt', 'w', encoding='UTF-8') as fp:
	fp.write('我和我的祖國,一刻也不能分割。')
	while True:
		pass
手動刷新
上面的例子中,文件沒有辦法關閉,程式沒有辦法執行完成,貌似緩衝區也很難寫滿,難道我們的內容就沒有辦法保存了嗎?
你機智的寫上了一行程式碼,是close()函數,這樣就關閉了文件,就可以將死循環之前的內容保存了嘛。
with open('test.txt', 'w', encoding='UTF-8') as fp:
	fp.write('我和我的祖國,一刻也不能分割。')
	fp.close()	# 關閉文件
	while True:
		pass
你經過測試,上面的程式碼的確的保存了寫入的內容,但是我們關閉了文件,再次操作文件的時候就必須重新開啟文件,不然沒有辦法繼續操作。
with open('test.txt', 'w', encoding='UTF-8') as fp:
	fp.write('我和我的祖國,一刻也不能分割。')
	fp.close()
	fp.write('我和我的祖國,就像是海和浪花一朵。')   # error,文件已經關閉
	while True:
		pass
發現寫入的第二條內容根本就沒法執行了,怎麼辦?使用fiush()函數手動刷新緩衝區。
with open('test.txt', 'w', encoding='UTF-8') as fp:
	fp.write('我和我的祖國,一刻也不能分割。')
	fp.flush()
	fp.write('我和我的祖國,就像是海和浪花一朵。')
    fp.flush()
	while True:
		pass
發現手動刷新將內容保存了下來,而且沒有影響程式的執行。以後如果程式任務過大,沒有執行完成就意外中斷,這樣就有一點數據保存不下來的風險,我們就可以隔著一段任務手動刷新一下,就不至於將所有的數據全部丟失。
文件的擴展模式
我們經過上面的學習,用到了寫、讀、手動刷新、關閉文件等幾種操作文件的函數,但是除此之外,還有一些常用的相關函數。
| 函數 | 作用 |
|---|---|
| write | 寫入數據 |
| read | 讀取數據 |
| fiush | 手動刷新緩衝區 |
| close | 關閉文件 |
| seek | 調整指針(游標)的位置 |
| tell | 返回當前指針左側所有的位元組數 |
| readable | 判斷文件對象是否可讀 |
| writeable | 判斷文件對象是否可寫 |
| readline | 讀取文件的一行內容 |
| readlines | 將文件中的內容按照換行讀取到列表當中 |
| writelines | 將內容是字元串的可迭代數據寫入文件當中 |
| truncate | 把要截取的字元串提取出來,然後清空內容並將截取的內容重新寫入 |
read的使用
plus增強模式的使用
在open函數中,使用 + 號,進入增強模式,可讀可寫。
我們現在使用 r+ 模式打開之前的文件,讀取其中的內容。
with open('test.txt', 'r+', encoding='UTF_8') as fp:
	# 讀取內容
	res = fp.read()
	print(res)  # 我和我的祖國,一刻也不能分割。我和我的祖國,就像是海和浪花一朵。

	# 可以指定字元的個數,讀取指定個數的字元
	res = fp.read(5)
	print(res)  #
發現什麼第二遍沒有讀取出任何的內容,我們重新打開一遍文件,重新讀取。
with open('test.txt', 'r+', encoding='UTF_8') as fp:
	# 讀取五個字元
	res = fp.read(5)
	print(res)  # 我和我的祖

	# 再讀取五個字元
	res = fp.read(5)
	print(res)  # 國,一刻也
發現第二遍讀取的內容是接著第一遍讀取的內容之後的,我們重新打開一遍文件,寫一些內容。
with open('test.txt', 'r+', encoding='UTF_8') as fp:
	# 寫入內容
	fp.write('我永遠和我的祖國在一起')
	# 讀取其中的內容
	res = fp.read()
	print(res)  # 能分割。我和我的祖國,就像是海和浪花一朵。
讀取內容的時候,發現沒有我們寫入的內容,而且讀取的文件內容怎麼看起來好怪異的感覺啊,怎麼少了些內容?
我們重新打開文件讀取一遍
with open('test.txt', 'r+', encoding='UTF_8') as fp:
	res = fp.read()
	print(res)  # 我永遠和我的祖國在一起能分割。我和我的祖國,就像是海和浪花一朵。
為什麼我們的寫入的內容在文件的開頭,而且還替換掉了原有的一部分數據?我們上面的一系列操作為什麼那麼的奇怪?
這都是因為游標的作用在做怪。
游標的作用
還記得我們之前介紹四種打開模式的時候嗎?寫入模式游標在文檔最後,讀取模式游標在文檔最前,追加模式游標在文檔最前,異或模式游標在文檔最前。
寫入的內容和讀取的內容都是從游標的位置開始的。
read()函數默認讀取游標一右側所有的內容。而不是文檔中的所有內容,之前的測試之所以可以一次性的讀取出所有的內容是因為我們打開文檔使用的是讀取模式,游標的位置在文檔的開頭。游標會隨著讀取的內容而移動,讀取到哪個字元游標就移動到哪個字元的後面。
write()寫入內容的時候是覆蓋模式。我們都知道我們的電腦系統中的文本輸入方式是有兩種的,使用insert鍵就可以切換著兩種模式。一種是插入模式,一種是覆蓋模式。
插入模式是我們平常最經常使用的,比如說我們打開一個文本編輯軟體,隨便的寫入一段內容,然後把游標移動到文檔的開頭,寫入內容,發現新的內容是插入到了舊的內容之前的,舊的內容不會消失,而是後移,這就是插入模式;然後重新將游標移動到文檔的開頭,然後按下insert鍵,這個時候你的輸入方式就變成了覆蓋模式,現在的你每當輸入一個新的字元就會覆蓋掉後面的一個舊字元,這就是覆蓋模式,python的文本編輯就是這種覆蓋模式。游標隨著寫入的內容向後移動。
游標位置的移動
我們剛才的時候就了解到了有一個可以調整游標位置的函數,叫做seek,使用這個函數我們可以隨意的調節游標的位置,從而編輯文件的時候可以更加的隨心所欲。
seek(offset: int, [whence: int = 0])
seek(偏移量, [基準位置])
seek函數的兩個參數都是整型。
第一個參數表示的是偏移量,單獨使用時表示將游標移動到從文檔的開頭算起的第N個位元組的位置後;
第二個參數表示的游標的位置,使用的時候只有0、1、2三個選型,且偏移量必須為0;
0代表的是文檔的最開端
1代表的是游標的當前位置
2代表的是文檔的最後端
# 先使用 w+ 模式打開一個文件,這個時候的文件為空,游標在文檔的開頭位置
with open('test.txt', 'w+', encoding='UTF-8') as fp:

	# 我們寫入內容,這個時候游標的位置隨著寫入的內容到了文檔的最後
	fp.write('hello motherland.')

	# 所以現在的游標的右側沒有任何一個位元組符,所以讀不出任何的內容
	res = fp.read()
	print(repr(res))    # ''

	# 所以游標還是在最後的位置,使用seek切換游標的位置為開頭,讀取剛才寫入的內容
	fp.seek(0)
	res = fp.read()
	print(repr(res))    # 'hello motherland.'

	# 讀取完內容之後,游標又到了文檔的最後的位置,調整到開頭的第五個位元組符的位置
	fp.seek(5)

	# 再次讀取文件的內容,這一次只讀取5個字元,發現前五個字元沒有了
	res = fp.read(5)
	print(repr(res))    # ' moth'

	# 現在游標在文檔的第十個字元位置,我們將游標切換到文檔的最後,然後讀取文檔發現什麼內容也沒有
	fp.seek(0, 2)
	res = fp.read()
	print(repr(res))    # ''
注意到了嗎?我說的seek移動的是位元組的數量,什麼是位元組的數量?
我們之前說的不同的編碼格式對於不同的字元都是不一樣的,但是所有的編碼格式對於英文字母為主的一些的字元都是一個位元組的大小,但是漢字不一樣,漢字在GB中是兩個位元組、UTF中是三個位元組、Unicode中是四個位元組。
seek的偏移單位是位元組,不是字元,所以在使用seek在操作bytes位元組流時,要注意移動的間隔,因為移動的是位元組位數,而在GB編碼中一個漢字兩個位元組,在Unicode(UTF-8)中,一個漢字三個位元組,如果seek將指針移動至漢字之間,就會導致讀取時漢字的編碼不完整而導致錯誤。
# 重新寫入一個文件,注意我們的編碼格式
with open('test.txt', 'w+', encoding='UTF-8') as fp:

	fp.write('我和我的祖國,一刻也不能分割。我和我的祖國,就像是海和浪花一朵。')

	# 我們現在讀取除了第一句話之後的內容,前面的內容一共是15個字元,我們使用seek跳過去
	fp.seek(15)
	res = fp.read()
	print(repr(res))    # '國,一刻也不能分割。我和我的祖國,就像是海和浪花一朵。'

	# 咦?怎麼只跳過了五個漢字?因為我們使用的UTF-8的編碼,一個漢字由3個位元組,真好是15個單位

	# 你是幸運的,如果我們在右移一個位元組的單位,就是一個漢字都沒有完全遷移完會怎麼樣?
	fp.seek(1)
	# res = fp.read()
	# print(res)      # error, 報錯了,因為剩下的字元不是完整的,所以沒有辦法讀出,就報錯了
# 就像是你好的UTF-8編碼是六個位元組組成的,
print('你好'.encode())    # b'\xe4\xbd\xa0\xe5\xa5\xbd'

# 如果去掉了一個位元組,就是不完整的了,還能解碼出來嗎?
print(b'\xbd\xa0\xe5\xa5\xbd'.decode()) # error,解碼失敗
所以在使用seek函數的時候一定要慎用。
tell的使用
# tell 當前游標左側所有的位元組數(返回位元組數)

# 使用閱讀模式打開文件
with open('test.txt', 'r+', encoding='UTF-8') as fp:

   # 使用tell函數查看貫標左側的位元組數
   res = fp.tell()
   print(res)  # 0

   # 因為閱讀模式的游標在文件的開頭,所以返回0個位元組數

   # 使用seek將游標移動到文檔的末尾
   fp.seek(0, 2)

   # 使用tell查看整個文檔的位元組數,這就是文檔的大小
   res = fp.tell()
   print(res)  # 96

   # 快去看看你的文件資訊中的文件大小是不是96位元組的?
其它的相關函數
判斷文件對象可讀可寫
# 使用 r+ 模式打開文件
with open('test.txt', 'r+', encoding='UTF-8') as fp:
   # 使用readable 和 readable 查看這個文檔是否可讀可寫
   if fp.readable():
      print('本文檔可讀')
   if fp.writable():
      print('本文檔可寫')
'''
結果:
本文檔可讀
本文檔可寫
'''
readline
讀取一行內容
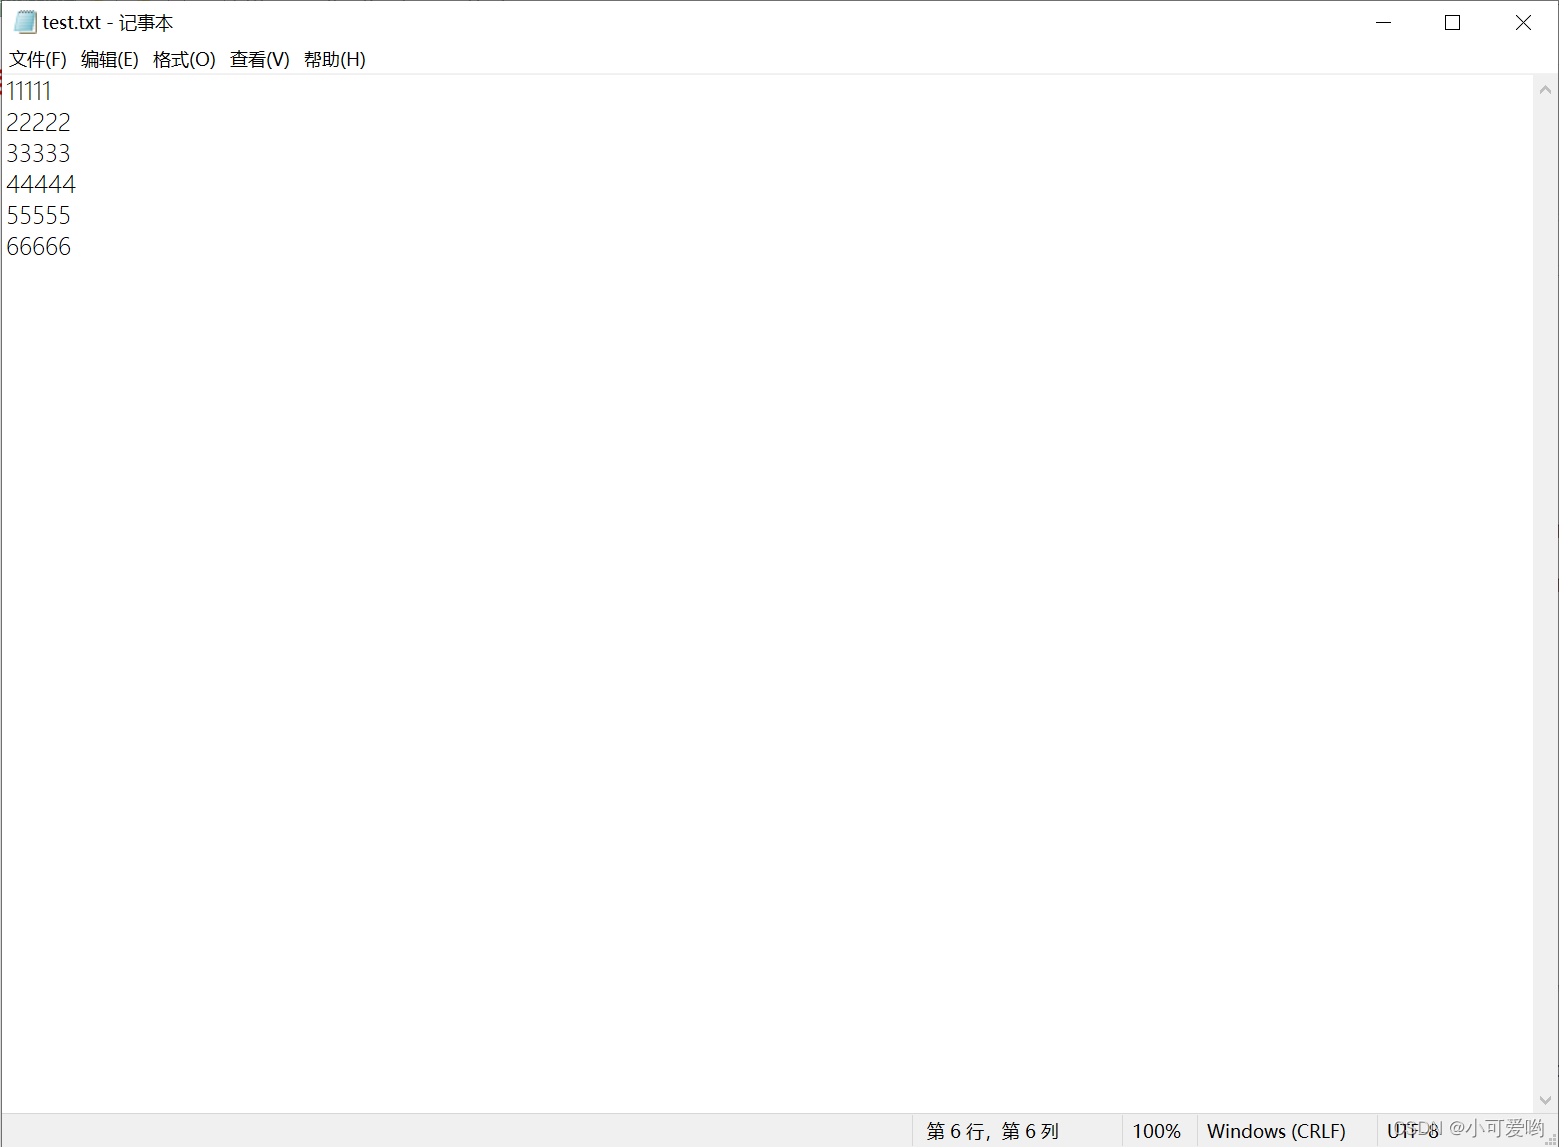
# 打開文件,重新寫入多行內容
with open('test.txt', 'w+', encoding='UTF-8') as fp:
   # 可以使用多行字元串
   fp.write('''11111
22222
33333
''')

   # 也可以使用轉義字元進行換行
   fp.write('44444\n55555\n66666')
with open('test.txt', 'r+', encoding='UTF-8') as fp:

   # 使用read讀取的整個文檔的內容
   res = fp.read()
   print(res)
   '''
   結果:
   11111
   22222
   33333
   44444
   55555
   66666
   '''

   # 使用readline讀取一一行的內容
   fp.seek(0)
   res = fp.readline()
   print(res)  # 11111

   # 再讀取一行
   res = fp.readline()
   print(res)  # 22222

   # 可以指定讀取的字元個數
   res = fp.readline(3)
   print(res)  # 333

   # 如果指定的個數大於本行的字元個數,就讀取本行所有的內容
   res = fp.readline(1000)
   print(res)  # 33

   # 為什麼是33不是44444?因為readline也要受到游標的影響
readlines
將文件中的內容按照換行讀取到列表中
with open('test.txt', 'r+', encoding='UTF-8') as fp:
	res = fp.readlines()
	print(res)  # ['11111\n', '22222\n', '33333\n', '44444\n', '55555\n', '66666'
注意:readlines不會影響游標的移動,但是讀取的是游標的右側數據;而且readlines的讀取將換行符也讀取上了,因為換行符本身也是一行的內容。
按行讀取內容我一般使用到readlines函數,但是也可以使用其它的方法,比如直接遍歷open實例化對象,open實例化對象本身就是一個可迭代對象,它將文件中的內容按照換行符分開。
with open('text.txt', 'r', encoding='UTF-8') as fp:
    for line in fp:
        print(line)
writelines
將內容是字元串的可迭代性數據寫入文件中,writelines不會根據元素換行。
lst = ['china', 'america', 'russia']

with open('test.txt', 'w+', encoding='UTF-8') as fp:
    # 使用writelines寫入內容
    fp.writelines(lst)
	fp.seek(0)
    # 讀取數據
	res = fp.readlines()
	print(res)	# ['chinaamericarussia']
truncate
文件中的內容只保留截取的內容。
從文件開頭開始,截取指定位元組長度的內容,然後將文件清空,然後將截取的內容重新填入文件中。
# 打開一個文件
with open('test.txt', 'w+', encoding='UTF-8') as fp:

	# 寫入一段內容
	fp.write('1234567890')

	# 保留截取的內容,只保留前5個位元組的內容
	fp.truncate(5)

	# 查看文件的內容
	fp.seek(0)
	res = fp.read()
	print(res)  # 12345
關於生成文件MD5心得
我在工作時需要給調用翻譯狗的一個API,用於上傳文獻並翻譯返回,但是對方需要文件MD5進行驗證,我們需要在接入介面的時候,需要將文件md5傳入,這個時候就出現了一些問題,我在傳入文件和文件MD5的時候,被對方回應文件MD5不匹配,我很好奇,為什麼會出現這樣的情況?
我在使用這個介面當中,有好幾處地方比如token的生成和文件md5的地方都會需要md5加密,所以為此我們專門將生成md5的程式碼封裝成為一個函數(將字元串輸入,返回md5,程式碼如下:
import hashlib

def enMD5(target):
    """ MD5加密 """
    res = hashlib.md5(target.encode()).hexdigest()
    return res
python中生成md5需要輸入位元組流格式的數據,而我一開始只有字元串的數據需要使用md5加密,所以我在函數中將字元串變成位元組流。token就是傳入字元串得到的。
但是文件md5的話可以直接讀出位元組流的格式,但是因為再使用這個函數不方便,所以我使用正常讀取文檔的方式讀取文件中的內容,然後放入函數中,結果就是上面說的,和對方得出的文件md5並不匹配。我自認為我的程式碼是沒有問題的,於是我們依次查找問題的所在,後來我發現網上很多部落客的方法都是直接從文件讀取二進位位元組流的方式獲取的,我實在是沒有辦法了,就想會不會就是讀取方式的問題呢?果然,我就發現不同格式讀取的出來的結果是不同的,測試的案例如下:
with open(file_path, 'w', encoding='UTF-8') as fp:
    fp.write('msr\nhello\r\nmotherland.')

with open(file_path, 'rb') as fp:
    print(fp.read())

with open(file_path, 'r', encoding='UTF-8') as fp:
    print(r'f', repr(fp.read()), sep='')
上述的結果為:
b'msr\r\nhello\r\r\nmotherland.'
f'msr\nhello\n\nmotherland.'
沒錯,我發現直接使用b模式和普通模式讀取內容然後轉化成為bytes的結果是不同的,那麼也必將導致最後文件md5是不正確的。大家也看到了,不管是哪一種讀取的方法其實和我寫入的內容都是不同的,在本次的測試案例當中對於換行有著不同的認知,讀取的原因我沒有深入了解,但是我注意到了官方文檔中說b模式就是專門讀取文件位元組流格式的,所以以後大家生成文件md5的時候,一定要直接使用b模式讀取文件內容。
上述的測試環境是:
python: python3.6.8_win_x64(Cpython)
system: windows_10_x64
