有效提升Python程式碼性能的三個層面
- 2022 年 3 月 12 日
- 筆記
- Python, 互聯網python編程

使用python進入一個熟練的狀態之後就會思考提升程式碼的性能,尤其是python的執行效率還有很大提升空間(委婉的說法)。面對提升效率這個話題,python自身提供了很多高性能模組,很多大牛開發出了高效第三方包,可謂是百花齊放。下面根據我個人使用總結出提升性能的幾個層面和相關方法。
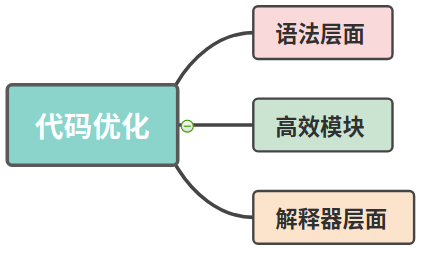
python程式碼優化:
- 語法層面
- 高效模組
- 解釋器層面
語法層面
- 變數定義
- 數據類型
- 條件判斷
- 循環
- 生成器
變數定義
- 多使用局部變數少使用全局變數,命名空間中局部變數優先搜索
條件判斷
- 可以使用字典的key value特性,直接用key命中條件,避免if判斷
- 用in操作替換if else判斷
- 使用any 或 all 將多個判斷一起處理,減少if else的分支
- if條件的短路特性。if a or b這種判斷中,如果a是True就不會判斷b,所以將True條件寫在前面可以節省判斷時間。同理 and 判斷將假寫在前面,後面一個條件不判斷
數據類型
- 使用dict 或set查找,替換list或tuple
- 集合的交並補差操作效率非常高。for循環和集合都可以處理的選擇集合解決,集合的效率遠高於循環
循環
- 用for循環代替while循環,for循環比while循環快
- 使用隱式for循環代替顯式for循環。如sum,map,filter,reduce等都是隱式for循環。隱式循環快於顯式循環
- 盡量不要打斷循環。打斷循環的放在外面。有判斷條件的語句和與循環不相關的操作語句盡量放在for外面
- 應當將最長的循環放在最內層,最短的循環放在最外層,以減少CPU跨切循環層的次數
- 使用生成式替換循環創建
合理使用迭代器和生成器
需要迭代出大量數據的場景,不需要將所有數據創建出來,合理使用生成器減少記憶體消耗
items_gen = (i for i in range(5000))
>>> items_gen.__sizeof__()
96
items_list = [i for i in ragne(5000)]
>>> items_list.__sizeof__()
43016
高效模組
- collections 數據增強模組
- itertools 高效迭代模組
- array 高效數組
- functool 用於處理函數的高階函數包
collections
- Counter: 高效的統計庫
- defaultdict:帶默認值的字典
- ChainMap:高效組合字典的庫
- deque: 雙端隊列,高效插入刪除
詳細使用參見另一篇專門講collections的文章 Python原生數據結構增強模組collections
itertools
- chain:多個可迭代對象構建成一個新的可迭代對象
- groupby:按照指定的條件分類,輸出條件和符合條件的元素
- from_iteratorable:一個迭代對象中將所有元素類似於chain一樣,統一返回
- islice:對迭代器進行切片,能指定start和stop以及步長
詳細使用參見另一篇專門講itertools的文章Python高性能工具迭代標準庫itertools
array
array 模組是python中實現的一種高效的數組存儲類型。
它和list相似,但是所有的數組成員必須是同一種類型,在創建數組的時候,就確定了數組的類型。
functool
functools.lru_cache 對函數做快取
lru_cache 是一個裝飾器,為函數提供快取功能。被裝飾的函數以相同參數調用時直接返回上一次的結果。
不做快取
import time

def fibonacci(n):
    """斐波那契函數"""
    if n < 2:
        return n
    return fibonacci(n - 2) + fibonacci(n - 1)


start = time.time()
res = fibonacci(40)
end = time.time()
print(res)
print(end - start)
102334155
32.14816737174988
做快取
import time
from functools import lru_cache

@lru_cache
def fibonacci(n):
    """斐波那契函數"""
    if n < 2:
        return n
    return fibonacci(n - 2) + fibonacci(n - 1)


start = time.time()
res = fibonacci(40)
end = time.time()
print(res)
print(end - start)
102334155
0.00020623207092285156
使用注意:
- 快取是按照參數作為鍵。調用函數時任意一個參數發生變化都不會返回之前快取結果
- 所有參數必須可哈希hash。也就是說參數只能是不可變對象
解釋器層面:
減少python執行過程
python 程式碼的執行過程為:
- 編譯器將源碼編譯成中間狀態的位元組碼
- 解釋器執行位元組碼,將位元組碼轉成機器碼在cpu上運行
python慢的原因主要是因為解釋器。解決辦法有兩個:
一是解決辦法是使用C/C++語言重寫Python函數,但是這要求程式設計師對C/C++語言熟悉,且調試速度慢,不適合絕大多數Python程式設計師。
另外一種非常方便快捷的解決辦法就是使用Just-In-Time(JIT)技術。
Just-In-Time(JIT)技術為解釋語言提供了一種優化,它能克服上述效率問題,極大提升程式碼執行速度,同時保留Python語言的易用性。使用JIT技術時,JIT編譯器將Python源程式碼編譯成機器直接可以執行的機器語言,並可以直接在CPU等硬體上運行。這樣就跳過了原來的虛擬機,執行速度幾乎與用C語言編程速度並無二致。
Numba是一個針對Python的開源JIT編譯器,由Anaconda公司主導開發,可以對Python原生程式碼進行CPU和GPU加速。
import time

def fun(x):
    total = 0
    start = time.time()
    for i in range(1,x+1):
        total += i
    end = time.time()
    print(total)
    print(end - start)

fun(100000000)
5000000050000000
5.934630393981934
import time
from numba import jit, int32

@jit(int32(int32))
def fun(x):
    total = 0
    start = time.time()
    for i in range(1,x+1):
        total += i
    end = time.time()
    print(total)
    print(end - start)

fun(100000000)
5000000050000000
0.1186532974243164
速度有60倍提升

