帶你認識FusionInsight Flink:既能批處理,又能流處理
摘要:本文主要介紹了FusionInsight Flink組件的基本原理、Flink任務提交的常見問題、以及最佳實踐FAQ。
本文分享自華為雲社區《FusionInsight HD Flink組件基本原理和常見問題解析》,作者:FI小粉絲 。
Flink是一個批處理和流處理結合的統一計算框架,其核心是一個提供數據分發以及並行化計算的流數據處理引擎。
它的最大亮點是流處理,是業界最頂級的開源流處理引擎。
Flink最適合的應用場景是低時延的數據處理(Data Processing)場景:高並發pipeline處理數據,時延毫秒級,且兼具可靠性。
本文主要介紹了FusionInsight Flink組件的基本原理、Flink任務提交的常見問題、以及最佳實踐FAQ。
基本概念
基本原理
簡介
Flink是一個批處理和流處理結合的統一計算框架,其核心是一個提供了數據分發以及並行化計算的流數據處理引擎。它的最大亮點是流處理,是業界最頂級的開源流處理引擎。
Flink最適合的應用場景是低時延的數據處理(Data Processing)場景:高並發pipeline處理數據,時延毫秒級,且兼具可靠性。
Flink技術棧如圖所示:
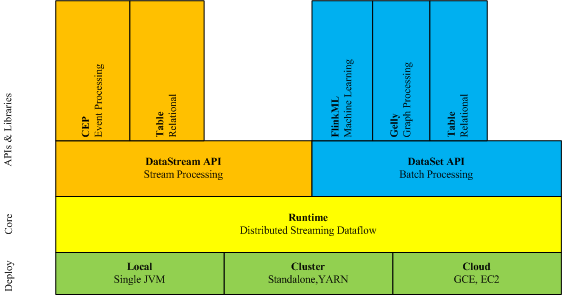
Flink在當前版本中重點構建如下特性,其他特性繼承開源社區,不做增強,具體請參考://ci.apache.org/projects/flink/flink-docs-release-1.4/
- DataStream
- Checkpoint
- Stream SQL
- 窗口
- Job Pipeline
- 配置表
架構
Flink架構如圖所示。
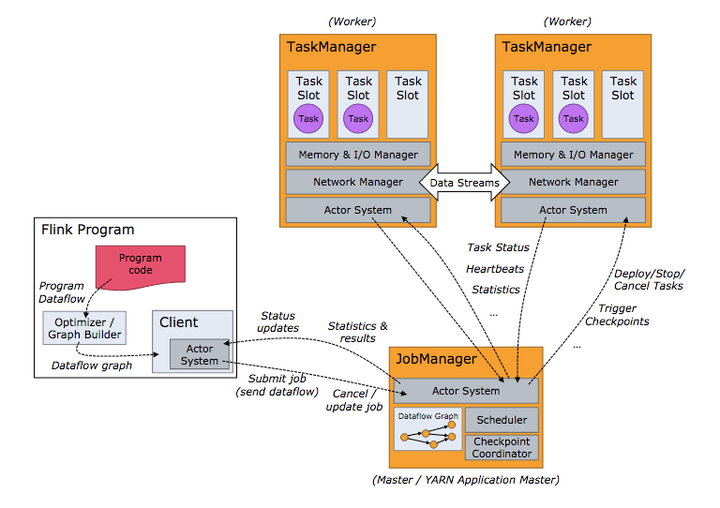
Flink整個系統包含三個部分:
- Client
Flink Client主要給用戶提供向Flink系統提交用戶任務(流式作業)的能力。
- TaskManager
Flink系統的業務執行節點,執行具體的用戶任務。TaskManager可以有多個,各個TaskManager都平等。
- JobManager
Flink系統的管理節點,管理所有的TaskManager,並決策用戶任務在哪些Taskmanager執行。JobManager在HA模式下可以有多個,但只有一個主JobManager。
Flink系統提供的關鍵能力:
- 低時延
提供ms級時延的處理能力。
- Exactly Once
提供非同步快照機制,保證所有數據真正只處理一次。
- HA
JobManager支援主備模式,保證無單點故障。
- 水平擴展能力
TaskManager支援手動水平擴展。
原理
- Stream & Transformation & Operator
用戶實現的Flink程式是由Stream和Transformation這兩個基本構建塊組成。
- Stream是一個中間結果數據,而Transformation是一個操作,它對一個或多個輸入Stream進行計算處理,輸出一個或多個結果Stream。
- 當一個Flink程式被執行的時候,它會被映射為Streaming Dataflow。一個Streaming Dataflow是由一組Stream和Transformation Operator組成,它類似於一個DAG圖,在啟動的時候從一個或多個Source Operator開始,結束於一個或多個Sink Operator。
下圖為一個由Flink程式映射為Streaming Dataflow的示意圖。

上圖中「FlinkKafkaConsumer」是一個Source Operator,Map、KeyBy、TimeWindow、Apply是Transformation Operator,RollingSink是一個Sink Operator。
- Pipeline Dataflow
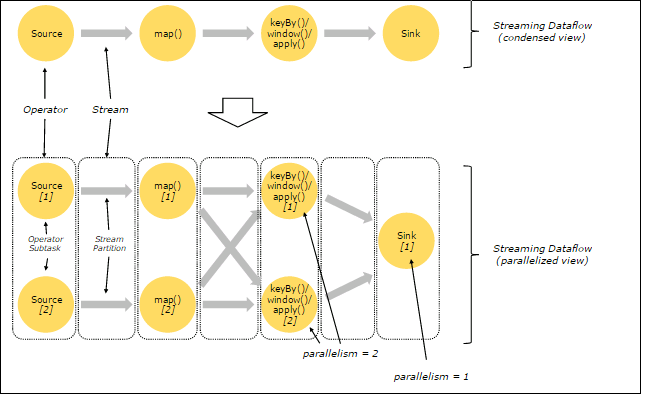
在Flink中,程式是並行和分散式的方式運行。一個Stream可以被分成多個Stream分區(Stream Partitions),一個Operator可以被分成多個Operator Subtask。
Flink內部有一個優化的功能,根據上下游運算元的緊密程度來進行優化。
- 緊密度低的運算元則不能進行優化,而是將每一個Operator Subtask放在不同的執行緒中獨立執行。一個Operator的並行度,等於Operator Subtask的個數,一個Stream的並行度(分區總數)等於生成它的Operator的並行度。如下圖所示。
Operator
- 緊密度高的運算元可以進行優化,優化後可以將多個Operator Subtask串起來組成一個Operator Chain,實際上就是一個執行鏈,每個執行鏈會在TaskManager上一個獨立的執行緒中執行,如下圖所示。
Operator chain
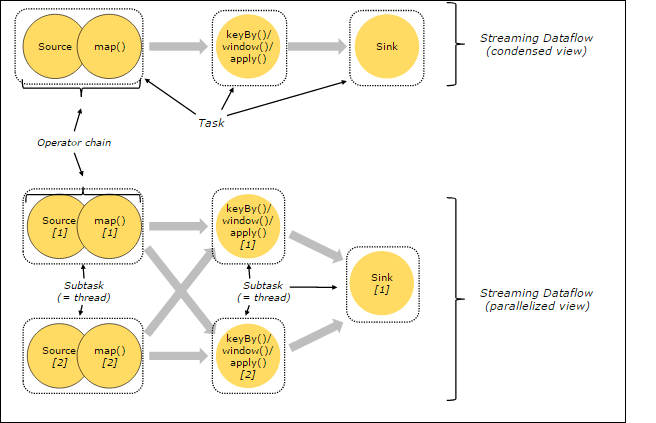
- 上圖中上半部分表示的是將Source和map兩個緊密度高的運算元優化後串成一個Operator Chain,實際上一個Operator Chain就是一個大的Operator的概念。圖中的Operator Chain表示一個Operator,keyBy表示一個Operator,Sink表示一個Operator,它們通過Stream連接,而每個Operator在運行時對應一個Task,也就是說圖中的上半部分有3個Operator對應的是3個Task。
- 上圖中下半部分是上半部分的一個並行版本,對每一個Task都並行化為多個Subtask,這裡只是演示了2個並行度,sink運算元是1個並行度。
日誌介紹
日誌描述
日誌存儲路徑:
- Executor運行日誌:「${BIGDATA_DATA_HOME}/hadoop/data${i}/nm/containerlogs/application_${appid}/container_{$contid}」
運行中的任務日誌存儲在以上路徑中,運行結束後會基於Yarn的配置確定是否匯聚到HDFS目錄中。
- 其他日誌:「/var/log/Bigdata/flink/flinkResource」
日誌歸檔規則:
- Executor日誌默認50MB滾動存儲一次,最多保留100個文件,不壓縮。
- 日誌大小和壓縮文件保留個數可以在FusionInsight Manager介面中配置。
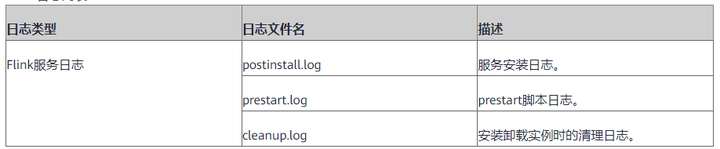
Flink日誌列表
日誌級別
Flink中提供了如下表所示的日誌級別。日誌級別優先順序從高到低分別是ERROR、WARN、INFO、DEBUG。程式會列印高於或等於所設置級別的日誌,設置的日誌等級越高,列印出來的日誌就越少。
日誌級別

如果您需要修改日誌級別,請執行如下操作:
- 登錄FusionInsight Manager系統。
- 選擇「服務管理 > Flink > 服務配置」。
- 「參數類別」下拉框中選擇「全部」。
- 左邊菜單欄中選擇所需修改的角色所對應的日誌菜單。
- 選擇所需修改的日誌級別。
- 單擊「保存配置」,在彈出窗口中單擊「確定」使配置生效。
配置完成後立即生效,不需要重啟服務。
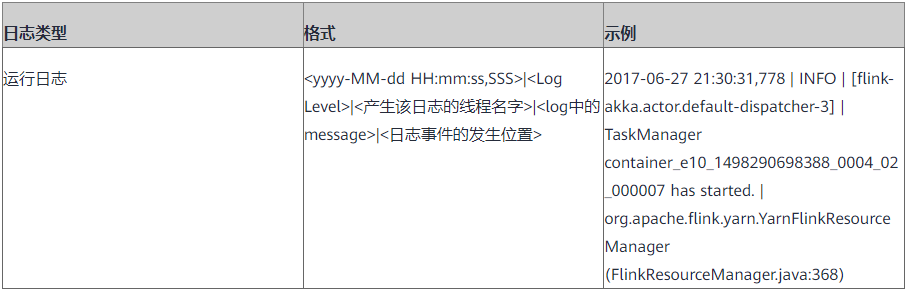
日誌格式
常見故障
1. Flink對接kafka-寫入數據傾斜,部分分區沒有寫入數據
問題現象與背景
使用FlinkKafkaProducer進行數據生產,數據只寫到了kafka的部分分區中,其它的分區沒有數據寫入
原因分析
- 可能原因1:Flink寫kafka使用的機制與原生介面的寫入方式是有差別的,在默認情況下,Flink使用了」並行度編號+分區數量」取模計算的結果作為topic的分區編號。那麼會有以下兩種場景:
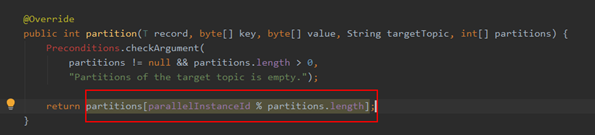
- 並行度%分區數量=0,表示並行度是kafkatopic分區數的一倍或者多倍,數據的寫入每個分區數據量是均衡的。
- 並行度%分區數量≠0,那麼數據量勢必會在個別分區上的數據量產生傾斜。
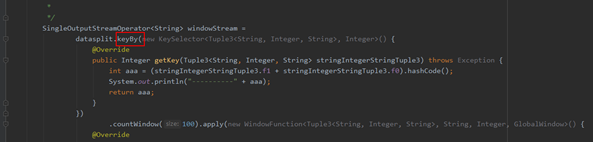
- 可能原因2:在業務程式碼的部分運算元中使用了keyby()方法,由於現網中的數據流中,每個key值所屬的數據量不一致(就是說某些key的數據量會非常大,有些又非常小)導致每個並行度中輸出的數據流量不一致。從而出現數據傾斜。
解決辦法
原因一:
方法1,調整kafka的分區數跟flink的並行度保持一致,即要求kafka的分區數與flink寫kafka的sink並行度保持強一致性。這種做法的優勢在於每個並行度僅需要跟每個kafka分區所在的 broker保持一個常鏈接即可。能夠節省每個並發執行緒與分區之間調度的時間。
方法2,flink寫kafka的sink的分區策略寫成隨機寫入模式,如下圖,這樣數據會隨即寫入topic的分區中,但是會有一部分時間損耗在執行緒向定址,推薦使用方法1。

原因二:
需要調整業務側對key值的選取,例如:可以將key調整為「key+隨機數」的方式,保證Flink的keyby()運算元中每個處理並行度中的數據是均衡的。
2. Flink任務的日誌目錄增長過快,導致磁碟寫滿
問題現象
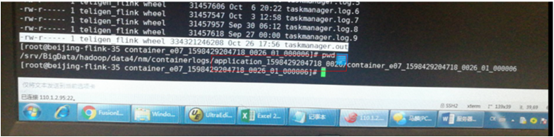
集群告警磁碟使用率超過閾值,經過排查發現是taskmanager.out文件過大導致
原因分析
程式碼中存在大量的print模組,導致taskmanager.out文件被寫入大量的日誌資訊,taskmanager.out 一般是,業務程式碼加入了 .print的程式碼,需要在程式碼中排查是否有類似於以下的程式碼邏輯:
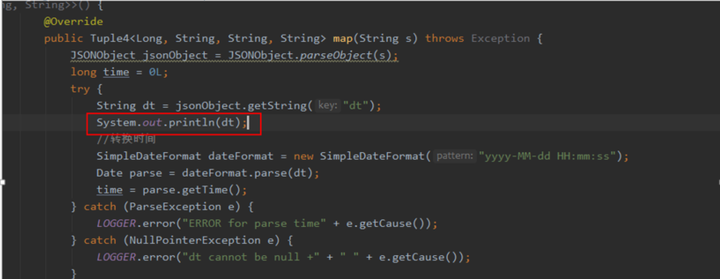
或者類似於這樣的列印:
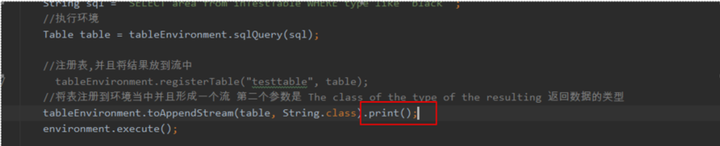
如果包含,日誌資訊會持續列印到taskmanager.out裡面。
解決方案
將上圖紅框中的程式碼去掉,或者輸出到日誌文件中。
3. 任務啟動失敗,報資源不足:Could not allocate all requires slots within timeout of xxxx ms
問題現象
任務啟動一段時間後報錯,例如如下日誌,需要60個資源實際上只有54個。
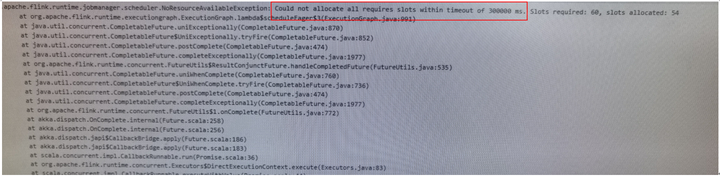
原因分析
Flink任務在啟動過程中的資源使用是先增長在下降到當前值的,實際在啟動過程中需要的資源量等於每個運算元並行度之和。等到任務開始運行後,Flink會對資源進行合併。
例如如下運算元,在啟動過程中需要「1+6+6+5+3=21」個資源。
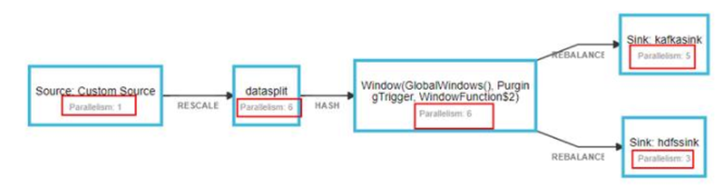
但是運行穩定後會降低到6。這個是Flink的機制。假如任務在啟動過程中不滿足21個資源的啟動資源量,任務就會出現NoResourceAvailableException的異常。
解決方案
減少任務的啟動並發,或者將其它任務kill掉再啟動Flink任務。
4. 運算元的部分節點產生背壓,其它節點正常
問題現象
業務運行一段時間以後,運算元的部分節點出現背壓。
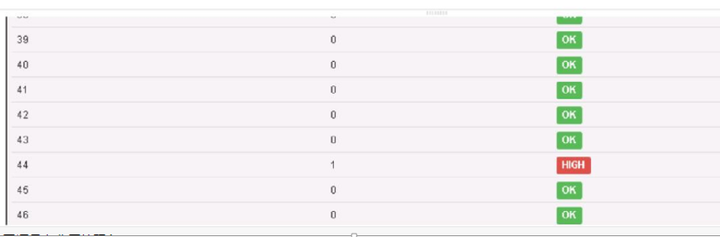
原因分析
通過Flink原生頁面排查這個並發的運算元所在的節點,通過上圖我們能夠看出是異常運算元的第44個並發。通過前台頁面能夠查看並確認第44並發所在的節點,例如下圖:

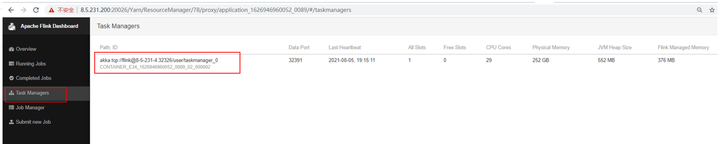
通過查找這個節點在taskmanager列表,例如下圖位置:
整理taskmanager在每個nodemanager節點的數量發現,背壓節點啟動的taskmanager數量過多。
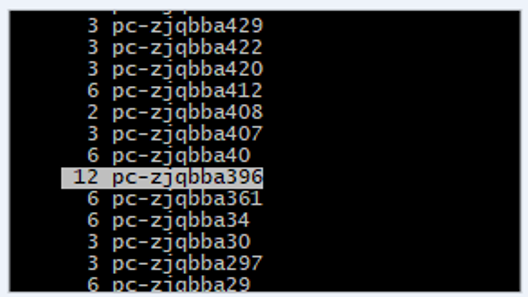
經過排查,該yarn集群資源相對比較緊張,每個節點啟動的taskmanager數量不一致,如果部分節點啟動的較多容易出現數據傾斜。
解決方案
建議一個節點啟動多個slot。避免多個taskmanager出現在一個nodemanager節點上。啟動方式見:slot優化。
FAQ
Flink如何載入其它目錄的jar包
需求描述
Flink業務一般在運行過程中默認載入的jar包路徑為:「xxx/Flink/flink/lib」的目錄下,如果添加其它路徑的jar包會報錯,如何添加其它外部依賴。
實現方案
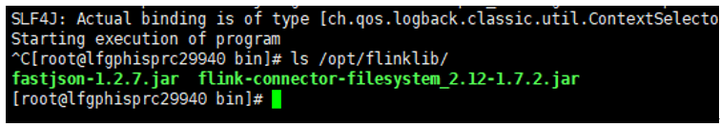
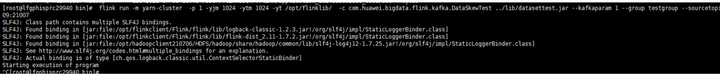
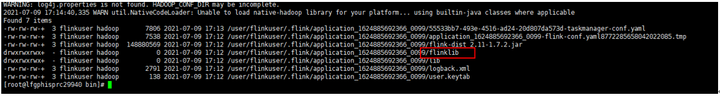
創建一個外部的lib目錄,將部分依賴包放到外部lib目錄下,如下圖:
修改啟動腳本的參數配置腳本,config.sh將jar包路徑傳給環境變數中。
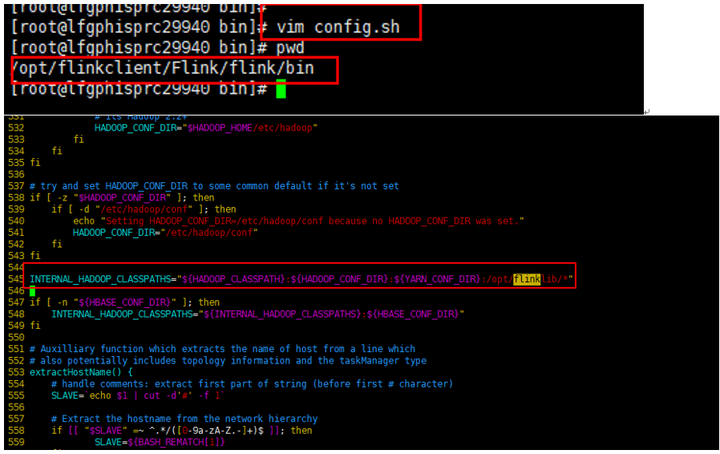
此時正常啟動任務即可,不需要加其它參數。
HDFS上也能看到第三方jar的目錄。
如何收集任務taskmanager的jstack和pstree資訊
需求描述
在任務運行過程中我們通常需要對taskmanager的進程進行查詢和處理,例如:打jstack,jmap等操作,做這些操作的過程中需要獲取任務的taskmanager資訊。
實現方案
獲取一個nodemanager節點上面所有taskmanager的進程資訊的方法如下:
ps -ef | grep taskmanager | grep -v grep | grep -v "bash -c"
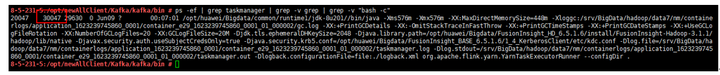
其中紅框中的內容就是taskmanager的進程號,如果一個節點上面存在多個taskmanager那麼這個地方會有多個進程號。獲取到進程號後我們可以針對這個進程號收集jstack或者pstree資訊。
收集jstack
1.通過上面流程獲取到進程資訊,然後從中獲取進程ID和application id,如上圖中進程id為「30047 applicationid為application_1623239745860_0001」。

2.從FI前台介面獲取這個進程的啟動用戶。如下圖為flinkuser。
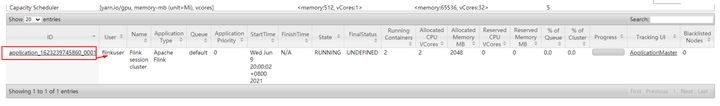
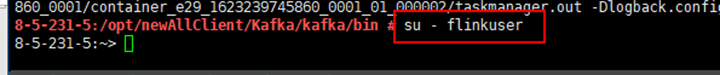
3.在對應的nodemanager節點後台切換到這個用戶,人機用戶機機用戶即可。
4. 進入到節點所在的jdk目錄下

5. 給taskmanager進程打jstack。

不同用戶提交的taskmanager只能由提交任務的用戶打jstack。
收集pstree資訊
使用pstree –p PID 的方式能夠獲取taskmanager的pstree資訊,這個地方提供一個收集腳本。內容如下:
#!/bin/bash
searchPID() {
   local pids=`ps -ef | grep taskmanager | grep -v grep | grep -v "bash -c" | grep -v taskmanagerSearch.sh | awk '{print $2}'`;
 time=$(date "+%Y-%m-%d %H:%M:%S")
 echo "checktime is  --------------------- $time" >> /var/log/Bigdata/taskManagerTree.log
  for i in $pids
    do
       local treeNum=$(pstree -p $i | wc -l)
       echo "$i 's pstree num is $treeNum" >> /var/log/Bigdata/taskManagerTree.log
    done
}
searchPID
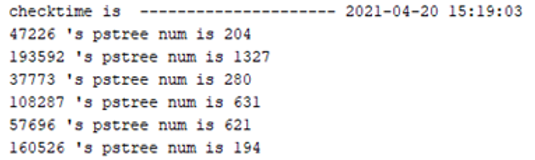
該腳本的功能為獲取節點上所有taskmanager pstree的數量,列印結果如下:
slot優化
需求描述
Slot可以認為是taskmanager上面一塊獨立分配的資源,是taskmanager並行執行的能力的體現。Taskmanager中有兩種使用slot的方法:
- 一個taskmanager中設置了一個slot。
- 一個taskmanager中設置了多個slot。
每個task slot 表示TaskManager 擁有資源的一個固定大小的子集。假如一個taskManager 有三個slot,那麼它會將其管理的記憶體分成三份給各個slot。資源slot化意味著一個subtask 將不需要跟來自其他job 的subtask 競爭被管理的記憶體,取而代之的是它將擁有一定數量的記憶體儲備。需要注意的是,這裡不會涉及到CPU 的隔離,slot 目前僅用來隔離task 的受管理的記憶體。通過調整task slot 的數量,允許用戶定義subtask 之間隔離的方式。如果一個TaskManager 一個slot,那將意味著每個task group運行在獨立的JVM 中(該JVM可能是通過一個特定的容器啟動的),而一個TaskManager 多個slot 意味著更多的subtask 可以共享同一個JVM。而在同一個JVM 進程中的task 將共享TCP 連接(基於多路復用)和心跳消息。它們也可能共享數據集和數據結構。因此,對於資源密集型任務(尤其是對cpu使用較為密集的)不建議使用單個taskmanager中創建多個slot使用,否則容易導致taskmanager心跳超時,出現任務失敗。如果需要設置單taskmanager多slot,參考如下操作。
單taskmanager多slot的設置方法
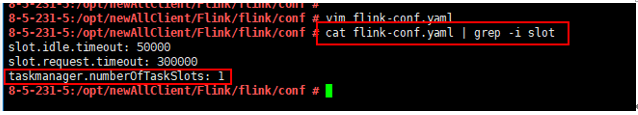
方式一:在配置文件中配置taskmanager.numberOfTaskSlots,通過修改提交任務的客戶端配置文件中的配置flink-conf.yaml配置,如下圖:將該值設置為需要調整的數值即可。
方式二:啟動命令的過程中使用-ys命令傳入,例如以下命令:
./flink run -m yarn-cluster -p 1 -ys 3 ../examples/streaming/WindowJoin.jar
在啟動後在一個taskmanager中會啟動3個slot。
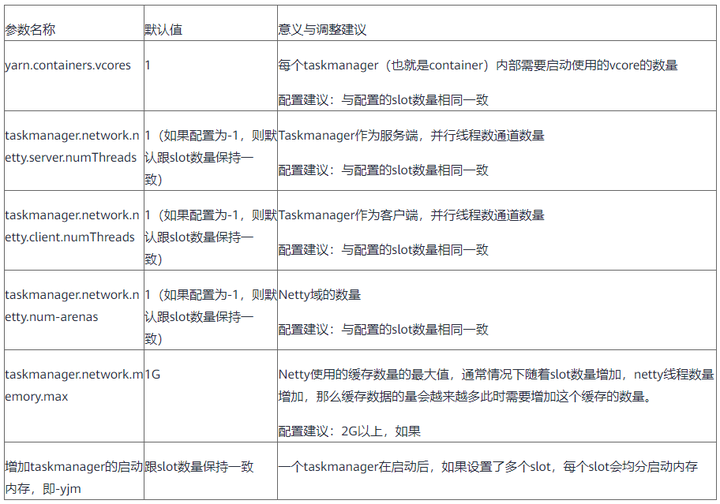
單taskmanager多slot需要優化哪些參數
設置單taskmanager多slot需要優化以下參數