知識增強的預訓練模型簡介
- 2021 年 12 月 28 日
- 筆記
©NLP論文解讀 原創•作者 | 楊健
1、專欄系列概覽
該專欄主要介紹自然語言處理領域目前比較前沿的領域—知識增強的預訓練語言模型。通過解讀該主題具備代表性的論文以及對應的程式碼,為大家揭示當前最新的發展狀況。為了能夠和大家更好的分享自己的收穫,筆者將遵循下面幾個原則。
1、理論講解盡量深入淺出,通過舉例子或者大白話講解論文,而非僅針對原文翻譯。
2、針對論文中一些重要的術語,適時的做出解釋。
3、理論和實踐相結合,除了理論講解,還會加入部分重要程式碼講解。並且分享個人認為重要的一些工程技巧。
2、知識增強的預訓練模型
工欲善其事必先利其器。今天的文章主要介紹 是什麼、它的背景知識以及分類。後續的文章將進一步深入,詳細介紹每一類知識增強的預訓練模型。
從哪裡來
自從神經網路成為主流以來,自然語言理解等任務大多基於神經網路為各個下游場景單獨設計模型。然而這類模型僅能夠適用於單一下游任務,通用性不足。
相比自然語言理解領域,由於影像處理領域擁有大量的有標籤數據,研究人員利用遷移學習的思想,在數年前就已經能訓練出具備一般性影像特徵的大規模預訓練模型。
然而,一方面自然語言處理領域缺少足夠的標註數據,另一方面循環神經網路架構也遭受梯度爆炸的困擾,使得該領域的大規模預訓練模型遲遲未能出現。
Transformer的出現為解決這一問題帶來了希望,一方面模型通過自注意力結構和殘差鏈接解決了循環神經網路架構梯度爆炸的問題,從而使模型得以堆疊多層神經網路,另一方面通過引入自監督的預訓練任務,也解決了標註數據不足的問題。
基於Transformer的BERT和GPT模型更是在當時橫掃了各大榜單,在各個下游任務的表現遠超為特定任務而設計的模型,其中BERT模型更是成為了自然語言理解發展過程中的里程碑。
在這一背景下,中國外提出了各種預訓練語言模型,比如國外的RoBERTa、XLNet、T5、BART,中國智源提出的CPM、華為的盤古模型、阿里的M6以及百度的ERNIE等等。
筆者在下文也會介紹預訓練語言模型的分類以及各自的特點。
到哪裡去
深度學習技術憑藉神經網路的分散式表示能力和層次結構泛化能力,實現了對大規模數據的學習和利用。
基於深度學習的預訓練模型能夠從大規模無監督數據中學習蘊含在文本中詞法、語法、語義等資訊,在自然語言領域中的下游任務中取得了重大突破。
然而預訓練模型也面臨著以下的問題,一是預訓練模型基於統計的方法建模,根據共現資訊學習文本中實體的隱式關聯,這造成了預訓練模型不具備深度理解和邏輯推理的能力。
其次,受到訓練數據長尾分布的影響,預訓練模型魯棒性差,容易受到攻擊,並被別有用心的人惡意使用。此外,預訓練模型缺乏常識知識,阻礙了預訓練模型在實際應用場景的大規模推廣。
知識能為預訓練模型提供更全面豐富的實體語義和實體關聯資訊,通過提供常識和領域知識,克服訓練數據長尾分布的限制,增強預訓練模型的魯棒性。
不僅如此,符號知識如知識圖譜,以三元組的形式表示,具有明確的語義,為知識如何在使用場景中發揮作用引入了可解釋性。
在這個背景下,自然語言處理領域湧現出了許多知識與預訓練模型想結合的研究工作,嘗試為預訓練模型注入知識,從而更好將預訓練模型應用於知識驅動和語義理解任務,這類模型也被稱之為知識增強的預訓練模型。
前行的途徑
什麼才算是知識,如何定義知識呢?給定知識,又應該如何注入到預訓練模型之中實現性能的提高呢?
維基百科將知識定義為對某個主題確信的認識,並且這些認識擁有潛在的能力為特定目的而使用。Bloom等人[1]將知識分為四大類,分別是事實性知識、概念性知識、程式性知識和元認知知識。
其中事實性知識指描述客觀事物的術語知識和具體細節及要素的知識,如事件、地點、人物、日期等;
概念性知識指一個整體結構基本要素間的關係,包括類別與分類的知識,原理與概括的知識,理論、模式和結構的知識;
程式性知識是指導行動的知識,一般與具體學科相關聯,包括學科技能和演算法知識、學科技術與方法知識、何時適當使用程式的知識;
元認知知識強調自我的主動性,是對自我認知和認知任務的知識。
從表現形式上分,則可以分為顯性的符號知識和隱性的模型和向量知識。比如知識圖譜、語言知識這一類通過三元組和語法樹等方式表現的知識,就是顯性的符號知識。
我們知道,針對對文本進行預訓練獲得的模型如BERT、通過對三元組使用Trans系列的模型(TransE、TransR等)生成的向量,都攜帶著語義資訊,然而這類知識不如符號知識的直觀性強,我們將其歸類為隱性知識。這一系列主要介紹基於顯性知識增強的模型。
考慮到符號知識主要以字元串的形式存在,而預訓練模型則基於神經網路。對符號知識的表示學習就成為了架接兩者的橋樑。
為此,大多數知識增強的預訓練模型往往使用圖神經網路、知識圖譜的表示學習方法,如基於張量或者平移的模型、又或者Transformer對符號知識編碼,將其轉換為表示向量(embedding)。
其次,知識的注入需要考慮預訓練的特性,注入的方法大多從預訓練的語料、模型採用的預訓練任務、模型結構、擅長的場景等角度綜合考慮。
以清華提出的ERNIE和KnowBERT為例,兩者都事先針對知識圖譜進行表示學習。由於兩者都採用BERT作為基礎模型,就仍然使用Transformer的架構作為編碼器編碼知識向量,並且為了能夠和BERT在預訓練期間所使用的預訓練任務保持一致,這兩個模型都使用預測經過掩碼的實體詞作為預訓練任務,以最大限度的利用模型已習得的能力。
再比如,BERT模型更擅長於語言理解任務,而GPT系列更擅長於生成任務,那麼對於生成場景,為了讓模型生成具備常識的內容,就需要選擇使用自回歸方式進行預訓練,也就是GPT這類模型作為基礎模型注入知識。
而對於實體分類、關係分類這類側重於理解能力的任務而言,選擇BERT、RoBERTa則更加合適。具體的注入方式筆者將會在後續的文章中逐步介紹。
3、預訓練語言模型的分類
對於知識增強的預訓練模型而言,知識的注入和預訓練模型密切相關。因此,筆者先在這部分對各類預訓練模型做一個簡單的介紹。
預訓練模型的分類方式有多種,推薦閱讀綜述論文[2-3]。筆者更傾向於從模型使用的架構來分類,因為採用不同的架構會影響模型能夠適用的場景,這種分類方式更具有實踐意義。
從這一個角度,可以將其分為三類,分別是採用Transformer的encoder架構、採用decoder架構、以及encoder-decoder架構的預訓練模型。第一類的代表模型有BERT、RoBERTa,第二類代表模型則是GPT系列,最後一類的代表模型則有T5、BART等。
事實上,encoder和decoder架構之間的差異僅僅在於是否適用了掩碼矩陣,decoder架構適用掩碼矩陣實現了下文的遮擋。
採用encoder架構的預訓練模型由於在預訓練階段就看到了上下文資訊,更擅長於理解型的任務,然而對於無法看到下文資訊的應用場景而言,由於和預訓練階段的訓練範式不一致,效果就會大打折扣。採用decoder架構僅僅利用上文預測,雖然能夠利用的資訊更少,但適用的場景更多。
而且,通過擴大參數量和訓練語料,這類模型的理解能力也不弱於第一類模型。最近一篇基於Prompt的論文也證明了GPT模型具有很強的理解能力[4],筆者更傾向於這類模型。
最後一類模型則是採用挖取一小段文本(span),打亂文字順序等方式來避免下文的泄露,如T5在encoder雖然能看到上下文,但是無法看到被挖取的部分文本,而這部分文本則需要decoder來預測。
這類模型能夠同時勝任語言理解和生成任務,但不足之處就是由於需要編碼器和解碼器,參數是前兩類模型的兩倍。
4、知識增強的預訓練模型分類
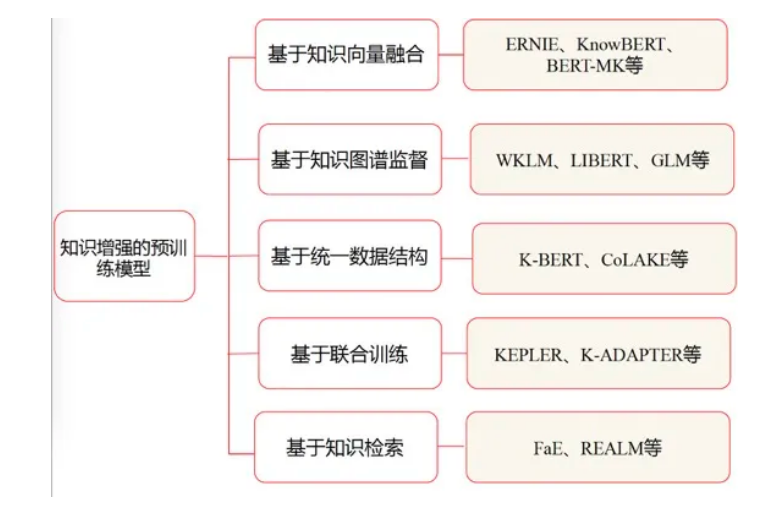
知識增強的預訓練模型可以從注入的知識以及粒度、以及注入的方法、應用場景等角度分類。為了讓大家更具啟發,筆者在這裡從知識的注入方法進行分類,將其分為基於知識向量融合的模型、基於知識圖譜監督的模型、基於統一知識和文本結構的模型以及基於聯合訓練的模型。
基於知識向量融合的模型對符號知識預先表示學習,然後針對文本中的指稱項(mention)對象的向量和實體向量加權求和、使用自注意機制等方式融合兩者。所謂指稱項可以理解為某一個實體非正式的別名。
基於圖譜監督的模型則是通過從知識圖譜中獲取實體的語義、情感等作為模型的額外特徵,又或者從中選擇同義、反義詞等作為監督語料,使預訓練模型學習顯式的實體關係。基於統一結構的模型則將符號知識和文本轉換為統一的結構,使用同一個編碼器,大多使用Transformer進行編碼。
最後一類模型則通過為知識設計額外的預訓練任務實現知識的注入。
最後附上一張模型的分類圖。
參考文獻:
[1]Taxonomy of educational objectives
//nancybroz.com/nancybroz/Literacy_I_files/Bloom%20Intro.doc
[2]Pre-trained models for natural language processing: A survey
//www.researchgate.net/profile/Xipeng-Qiu/publication/340021796_Pre-trained_Models_for_Natural_Language_Processing_A_Survey/links/5e7b1a05299bf1f3873fd11a/Pre-trained-Models-for-Natural-Language-Processing-A-Survey.pdf
[3]Pre-Trained Models: Past, Present and Future
//arxiv.org/pdf/2106.07139.pdf
[4]GPT Understands, Too
//arxiv.org/pdf/2103.10385.pdf

