搭建ELK日誌平台(單機)
系統版本:Ubuntu 16.04.7 LTS
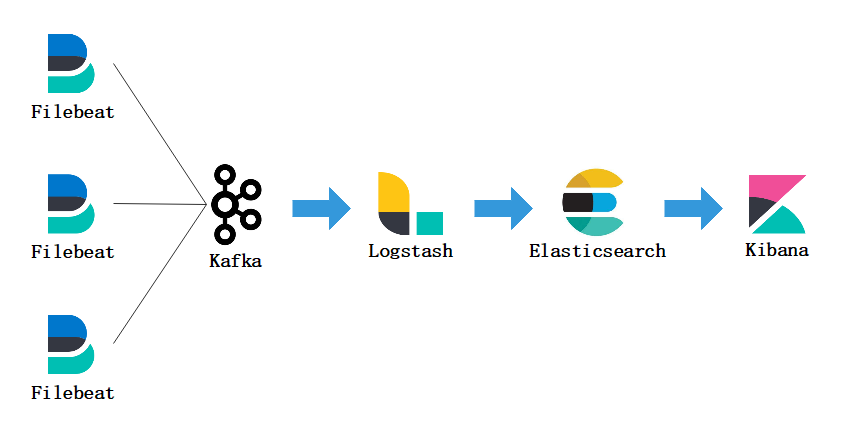
軟體架構:Filebeat+Kafka+Logstash+Elasticsearch+Kibana+Nginx
軟體版本:Filebeat-7.16.0、Kafka-2.11-1.0.0、Logstash-7.16.0、Elasticsearch-7.16.0、Kibana-1.76.0
主機性能:CPU:4c3.8Ghz、MEM:16GB、DISK:1TB
部署方式:單機
索引規劃:按[主機環境]-[項目名稱]-[日期]創建索引。
主題規劃:按[主機環境]-[項目名稱]創建主題。
注意事項:
ELK中所有服務組件建議使用兼容的相同版本。
由於Filebeat和Logstash對Kafka的兼容性,Kafka推薦使用1.0~2.0版本。
1. 在搭建之前的一些操作
1、創建工作目錄
root@yw-elk:~# mkdir /data/elk/elasticsearch
root@yw-elk:~# mkdir /data/elk/logstash
root@yw-elk:~# mkdir /data/elk/kafka
root@yw-elk:~# mkdir /data/elk/kibana
2. Elasticsearch(存儲日誌)
用於數據存儲。
通常存儲來自於Logstash處理後的日誌數據,以及Kibana管理控制台管理ES的交互數據,或者Beats擴展集成的數據。
Elasticsearch一個索引中可存儲的文檔數量為20億。
1、解壓二進位包
root@yw-elk:~# cd /data/elk/elasticsearch
root@yw-elk:/data/elk/elasticsearch# tar xzvf elasticsearch-7.16.0-linux-x86_64.tar.gz
2、配置Elasticsearch
默認情況下單節點的ES只允許創建999/1000個索引,我們生產+測試環境共有6個項目,每個項目的日誌按天存,一天一個索引,則一年的索引總數=365*6=2190。所以我們需要擴大"cluster.max_shards_per_node"該項的值。
root@yw-elk:/data/elk/elasticsearch# cd elasticsearch-7.16.0/
root@yw-elk:/data/elk/elasticsearch/elasticsearch-7.16.0# vim config/elasticsearch.yml
cluster.name: my-application
node.name: node-1
node.master: true
node.data: true
path.data: /data/elk/elasticsearch/elasticsearch-7.16.0/data
path.logs: /data/elk/elasticsearch/elasticsearch-7.16.0/logs
bootstrap.memory_lock: true
network.host: 127.0.0.1
http.port: 9200
transport.port: 9300
discovery.type: single-node
discovery.seed_hosts: ["127.0.0.1"]
gateway.recover_after_nodes: 1
action.destructive_requires_name: true
cluster.routing.allocation.disk.threshold_enabled: false
cluster.max_shards_per_node: 10000
# 設置集群中節點最大分片數量,即單個節點可創建的最大索引數量。默認為1000。

## x-pack ###
xpack.security.enabled: true
3、設置JVM堆記憶體大小為4GB
root@yw-elk:/data/elk/elasticsearch/elasticsearch-7.16.0# vim config/jvm.options
-Xms4g
-Xmx4g
4、創建運行用戶
root@yw-elk:/data/elk/elasticsearch/elasticsearch-7.16.0# useradd -M elk
root@yw-elk:/data/elk/elasticsearch/elasticsearch-7.16.0# chown -R elk.elk /data/elk/elasticsearch/elasticsearch-7.16.0
5、運行Elasticsearch
root@yw-elk:/data/elk/elasticsearch/elasticsearch-7.16.0# nohup sudo -u elk bin/elasticsearch &
root@yw-elk:~# netstat -lnupt |grep 9200
tcp6       0      0 127.0.0.1:9200          :::*                    LISTEN      19021/java
6、創建內置賬戶的密碼
內置賬戶說明:
- elastic,一個內置的超級用戶。關聯角色superuser。
- apm_system,用於Elastic APM在Elasticsearch中存儲監控資訊時使用的用戶。關聯角色apm_system。
- kibana,用於Kibana連接Elasticsearch並與之通訊(已過時的內置用戶)。關聯角色kibana_system。
- kibana_system,用戶Kibana連接Elasticsearch並與之通訊。關聯角色kibana_system。
- logstash_system,用於Logstash在Elasticsearch中存儲監控資訊時使用。關聯角色logstash_system。
- beats_system,用於Beats在Elasticsearch中存儲監控資訊時使用。關聯角色beats_system。
- remote_monitoring_user ,用於Metricbeat在Elasticsearch中收集和存儲監控資訊時使用。關聯remote_monitoring_agent和remote_monitoring_collector角色 。
root@yw-elk:/data/elk/elasticsearch/elasticsearch-7.16.0# bin/elasticsearch-setup-passwords interactive
password: xxxxx
7、使用帳號訪問Elasticsearch(列出所有索引)
無需手動創建索引,索引由Logstash自動創建。
Elasticsearch默認最大索引數量為999,所以在創建索引的時候,建議一個項目對應一個索引。
root@yw-elk:/data/elk/elasticsearch/elasticsearch-7.16.0# curl -X GET -u elastic:xxx //127.0.0.1:9200/_cat/indices?v
health status index            uuid                   pri rep docs.count docs.deleted store.size pri.store.size
green  open   .geoip_databases TCYNKgxLQCCzztI-5O410Q   1   0         42            0     41.1mb         41.1mb
green  open   .security-7      XkfwEgRVQcOnl3IpqKNOxg   1   0          7            0     25.7kb         25.7kb
3. Kibana(日誌搜索與展示)
Elasticsearch的Web圖形化操作管理控制台。
1、解壓二進位包
root@yw-elk:~# cd /data/elk/kibana
root@yw-elk:/data/elk/kibana# tar xzvf kibana-7.16.0-linux-x86_64.tar.gz
2、配置Kibana
root@yw-elk:/data/elk/kibana# cd kibana-7.16.0-linux-x86_64
root@yw-elk:/data/elk/kibana/kibana-7.16.0-linux-x86_64# vim config/kibana.yml
server.port: 5601
server.host: "127.0.0.1"
server.publicBaseUrl: "//elk.xxx.net"
elasticsearch.hosts: ["//127.0.0.1:9200"]
elasticsearch.username: "kibana_system"
elasticsearch.password: "xxx"
logging.dest: /data/elk/kibana/kibana-7.16.0-linux-x86_64/logs/kibana.log
i18n.locale: "zh-CN"
3、使用elk用戶啟動Kibana
root@yw-elk:/data/elk/kibana# chown -R elk.elk kibana-7.16.0-linux-x86_64
root@yw-elk:/data/elk/kibana# cd kibana-7.16.0-linux-x86_64/
root@yw-elk:/data/elk/kibana/kibana-7.16.0-linux-x86_64# nohup sudo -u elk bin/kibana &
root@yw-elk:/data/elk/kibana/kibana-7.16.0-linux-x86_64# netstat -lnupt |grep 5601
tcp        0      0 127.0.0.1:5601          0.0.0.0:*               LISTEN      13060/node
4、安裝並配置Nginx反代Kibana
root@yw-elk:~# apt-get -y install nginx
root@yw-elk:~# vim /etc/nginx/conf.d/elk.conf
server {
    listen       80;
    server_name  elk.xxx.net;
    location / {
            proxy_pass //127.0.0.1:5601;
            proxy_set_header Host $host;
            proxy_set_header X-Real-IP $remote_addr;
            proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
    }
    error_page 404 /404.html;
    location = /40x.html {
    }
    error_page 500 502 503 504 /50x.html;
    location = /50x.html {
    }
}
root@yw-elk:~# systemctl restart nginx
root@yw-elk:~# systemctl enable nginx
5、使用瀏覽器訪問
訪問地址://elk.xxx.com
使用超級管理員"elastic"帳號密碼登錄
4. Kafka(消息隊列)
Kafka是一個消息隊列MQ服務,非同步傳輸日誌數據。
Kafka減輕了Logstash的壓力,Logstash有多少能力處理消息,則就從Kafka中消費消息。
這裡為了安全性考慮,增加了SASL基礎認證功能。
SASL(Simple Authentication and Security Layer)簡單的身份驗證和安全層,使用明文用戶密碼的方式保證Kafka的安全。
1、安裝JDK
運行Kafka需要JDK環境的支援。
root@yw-elk:~# mkdir /data/elk/jdk
root@yw-elk:~# cd  /data/elk/jdk
root@yw-elk:/data/elk/jdk# tar xzvf Jdk-8u211-linux-x64.tar.gz
root@yw-elk:/data/elk/jdk# vim /etc/profile
# jdk
export JAVA_HOME=/data/elk/jdk/jdk1.8.0_211
export PATH=$JAVA_HOME/bin:$PATH
root@yw-elk:/data/elk/jdk# source /etc/profile
root@yw-elk:/data/elk/jdk# java -version
java version "1.8.0_211"
Java(TM) SE Runtime Environment (build 1.8.0_211-b12)
Java HotSpot(TM) 64-Bit Server VM (build 25.211-b12, mixed mode)
2、解壓二進位包
root@yw-elk:/data/elk# cd /data/elk/kafka/
root@yw-elk:/data/elk/kafka# tar xzvf kafka_2.11-1.0.0.tgz
3、創建相關數據目錄
root@yw-elk:/data/elk/kafka# cd kafka_2.11-1.0.0/
root@yw-elk:/data/elk/kafka/kafka_2.11-1.0.0# mkdir kafka_data
root@yw-elk:/data/elk/kafka/kafka_2.11-1.0.0# mkdir zk_data
4、配置並啟動Zookeeper
Kafka二進位包中已經集成Zookeeper了,Zookeeper是Kafka的註冊中心,用於實現消費者與代理節點之間的路由和負載平衡等工作,生產者將消息寫入到代理節點,由代理節點分發給消費者。
root@yw-elk:/data/elk/kafka/kafka_2.11-1.0.0# vim config/zookeeper.properties
dataDir=/data/elk/kafka/kafka_2.11-1.0.0/zk_data
# zookeeper的數據目錄。
clientPort=2181
# zookeeper監聽埠。
maxClientCnxns=0
# 最大客戶端並發連接數量。

### SASL ###
# 開啟ZookeeperClient支援SASL認證
authProvider.1=org.apache.zookeeper.server.auth.SASLAuthenticationProvider
requireClientAuthScheme=sasl
jaasLoginRenew=3600000

root@yw-elk:/data/elk/kafka/kafka_2.11-1.0.0# bin/zookeeper-server-start.sh -daemon /data/elk/kafka/kafka_2.11-1.0.0/config/zookeeper.properties
root@yw-elk:/data/elk/kafka/kafka_2.11-1.0.0# netstat -lnupt |grep 2181
tcp6       0      0 :::2181                 :::*                    LISTEN      1086/java
5、配置Kafka服務端(Broker)
Broker,代理節點,即Kafka服務端。
root@yw-elk:/data/elk/kafka/kafka_2.11-1.0.0# vim config/server.properties
############################# Server Basics #############################
broker.id=0
# BrokerID,用於Kafka集群中代理節點的全局唯一編號。
message.max.bytes=10000000
# 設置單個消息的最大值,默認為1M。
# delete.topic.enble=true
# 設置允許對Topic進行刪除操作,否則無法刪除Topic。只有開啟此項的時候Topic才會被真正刪除,否則Topic僅
# 只是被標記為刪除而已。為了安全性考慮的結果。
# auto.create.topics.enable=true
# 設置當生產者要推送消息的Topic不存在時自動創建對應的Topic。默認為true。
### SASL ###
security.inter.broker.protocol=SASL_PLAINTEXT
# Broker之間通訊所使用的的協議。
sasl.enabled.mechanisms=PLAIN
# 啟用Kafka伺服器簡單安全認證機列表。這個列表可以包括一個可用的安全提供者的任意機置。只有GSSAPI(通用安全服務應用介面)是默認啟用的。
sasl.mechanism.inter.broker.protocol=PLAIN
# 用於內部的broker通訊的簡單身份驗證和安全層機置。默認為通用安全服務應用程式介面。
# authorizer.class.name=kafka.security.auth.SimpleAclAuthorizer
# 開啟簡單的ACL訪問控制功能。
# allow.everyone.if.no.acl.found=true
# 在ACL中,如果列表中沒找到任何ACL規則,表默認允許所有用戶操作。
super.users=User:admin
# 設置Broker的超級管理用戶為admin。

############################# Socket Server Settings #############################
listeners=SASL_PLAINTEXT://:9092
# 設置套接字監聽器所使用的安全協議和埠。PLAINTEXT是Kafka默認使用的協議。這邊將其修改為SASL_PLAINTEXT協議,為了增加基於SASL的身份認證功能。
advertised.listeners=SASL_PLAINTEXT://47.96.96.60:9092
# 設置將Kafka的地址通告給生產者和消費者,如果不設置該項,則默認使用listeners的值。
# 由於我這邊是公網環境,想要生產者和消費者與Kafka正常通訊,則需要設置該項為公網地址,這才可以正常工
# 作。
num.network.threads=3
# Broker接收網路請求所開啟的執行緒數量。
num.io.threads=8
# Broker用於處理請求的執行緒數量,其中可能包括磁碟IO。
socket.send.buffer.bytes=102400
# 套接字發送數據的緩衝區大小,單位為位元組。
socket.receive.buffer.bytes=102400
# 套接字接受數據的緩衝區大小,單位為位元組。
socket.request.max.bytes=104857600
############################# Log Basics #############################
# 套接字接受單個請求的最大大小(防止OOM)。
log.dirs=/data/elk/kafka/kafka_2.11-1.0.0/kafka_data
# Broker日誌和數據存儲目錄路徑。
num.partitions=1
# 每個Topic的默認日誌分區數量,更多的分區將允許更多的並行度,這也將導致會產生更多的文件,但可以增加每個Topic的並發性能。默認為1
num.recovery.threads.per.data.dir=1
# 在啟動和關閉Broker伺服器時,每個數據目錄(log.dirs)中日誌恢復的執行緒數量。
############################# Internal Topic Settings  #############################
# 設置內部元數據Topic組的副本因子數量"__consumer_offsets"和"__transaction_state"。
# 除了開發測試之外,建議設置>1的值,比如3。
# 建議有幾個節點就設置為幾個副本數量。

offsets.topic.replication.factor=1
# 每個Topic的偏移值記錄都在"__consumer_offsets"這個Topic中存儲,該項用於設
# 置"__consumer_offsets"這個Topic的副本數量。以增加可靠性。
transaction.state.log.replication.factor=1
# 存儲事務狀態日誌的Topic"__transaction_state"的副本數量。
transaction.state.log.min.isr=1
# 覆蓋事務狀態日誌Topic中的min.insync.replicas配置。
# "min.insync.replicas"用於保證事務寫入認為成功的最小副本數量,如果寫入操作不能滿足該要求,則生產者會引發一個異常"NotEnoughReplicas或NotEnoughReplicasAfterAppend"。
############################# Log Retention Policy #############################
log.retention.hours=168
# 日誌(消息)保留時間,單位為小時。
# log.retention.bytes=1073741824
# 一個基於日誌(消息)大小的保留策略。每個Topic下每個分區保存數據的最大文件大小。
# 當log.retention.hours和log.retention.bytes都存在時,當滿足任何一個策略時都會刪除。
# 該項如果設置為-1,則表示不刪除。
log.segment.bytes=1073741824
# 日誌段文件的最大大小,當達到此大小的時候,將創建一個新的日誌段,單位為位元組。
log.retention.check.interval.ms=300000
# 日誌保留檢查間隔時間,單位ms。
############################# Zookeeper #############################
zookeeper.connect=127.0.0.0.1:2181
# zookeeper連接地址。
zookeeper.connection.timeout.ms=18000
# zookeeper連接超時時間。
############################# Group Coordinator Settings #############################
group.initial.rebalance.delay.ms=0
# 設置所有成員都加入到消費者組中需要的延遲時間,以避免出現再平衡"rebalance"事件的發生。
6、配置生產者和消費者客戶端
配置生產者和消費者客戶端,使其支援SASL安全機制。
root@yw-elk:/data/elk/kafka/kafka_2.11-1.0.0# vim config/producer.properties
### SASL ###
security.protocol=SASL_PLAINTEXT
sasl.mechanism=PLAIN
root@yw-elk:/data/elk/kafka/kafka_2.11-1.0.0# vim config/consumer.properties
### SASL ###
security.protocol=SASL_PLAINTEXT
sasl.mechanism=PLAIN
7、為Kafka添加用戶和密碼
註:在kafka_server_jaas.conf和kafka_client_jaas.conf配置文件中,"username"和"password"創建的用戶密碼用於Broker之間的SASL身份認證,而user_
# 創建Kafka伺服器所使用的的帳號密碼以用於基於用戶密碼的身份驗證
root@yw-elk:/data/elk/kafka/kafka_2.11-1.0.0# vim config/kafka_server_jaas.conf
KafkaServer {
    org.apache.kafka.common.security.plain.PlainLoginModule required
        username="admin"
        password="xxx"
        user_admin="xxx";
};
# 創建生產者或消費者客戶端登錄所使用的用戶密碼文件,用於登錄到Kafka伺服器(broker)。
root@yw-elk:/data/elk/kafka/kafka_2.11-1.0.0# vim config/kafka_client_jaas.conf
KafkaClient {
org.apache.kafka.common.security.plain.PlainLoginModule required
    username="admin"
    password="xxx";
};
# 修改啟動腳本文件
# 將內容寫入到文件的最頂部
root@yw-elk:/data/elk/kafka/kafka_2.11-1.0.0# vim bin/kafka-server-start.sh
export KAFKA_OPTS="-Djava.security.auth.login.config=/data/elk/kafka/kafka_2.11-1.0.0/config/kafka_server_jaas.conf"
root@yw-elk:/data/elk/kafka/kafka_2.11-1.0.0# vim bin/kafka-console-producer.sh
export KAFKA_OPTS="-Djava.security.auth.login.config=/data/elk/kafka/kafka_2.11-1.0.0/config/kafka_client_jaas.conf"
root@yw-elk:/data/elk/kafka/kafka_2.11-1.0.0# vim bin/kafka-console-consumer.sh
export KAFKA_OPTS="-Djava.security.auth.login.config=/data/elk/kafka/kafka_2.11-1.0.0/config/kafka_client_jaas.conf"
8、開啟Kafka JMX監控功能(可選的步驟)
創建JMX監控要使用的帳號密碼文件"jmxremote.password"和許可權控制"jmxremote.access"文件:
- jmxremote.password 內容格式:
- jmxremote.access 內容格式:
<readonly|readwrite>
註:這兩個文件僅能使用600許可權,否則服務無法啟動。
root@yw-elk:/data/elk/kafka/kafka_2.11-1.0.0# vim config/jmxremote.password
jmxuser xxx
root@yw-elk:/data/elk/kafka/kafka_2.11-1.0.0# vim config/jmxremote.access
jmxuser readonly
root@yw-elk:/data/elk/kafka/kafka_2.11-1.0.0# chmod 600 config/jmxremote.*
指定在的腳本文件中找到以下內容,添加並修改相關內容:
root@yw-elk:/data/elk/kafka/kafka_2.11-1.0.0# vim bin/kafka-run-class.sh
# JMX settings
if [ -z "$KAFKA_JMX_OPTS" ]; then
  KAFKA_JMX_OPTS="-Dcom.sun.management.jmxremote -Djava.rmi.server.hostname="127.0.0.1" -Dcom.sun.management.jmxremote.authenticate=true  -Dcom.sun.management.jmxremote.ssl=false  -Dcom.sun.management.jmxremote.password.file=/data/elk/kafka/kafka_2.11-1.0.0/config/jmxremote.password -Dcom.sun.management.jmxremote.access.file=/data/elk/kafka/kafka_2.11-1.0.0/config/jmxremote.access"
fi

# JMX port to use
if [  $JMX_PORT ]; then
  KAFKA_JMX_OPTS="$KAFKA_JMX_OPTS -Dcom.sun.management.jmxremote.port=$JMX_PORT"
fi
root@yw-elk:/data/elk/kafka/kafka_2.11-1.0.0# vim bin/kafka-server-start.sh
export JMX_PORT="12345"
9、啟動Kafka伺服器(Broker)
root@yw-elk:/data/elk/kafka/kafka_2.11-1.0.0# bin/kafka-server-start.sh -daemon /data/elk/kafka/kafka_2.11-1.0.0/config/server.properties
root@yw-elk:/data/elk/kafka/kafka_2.11-1.0.0# netstat -lnupt |grep 9092
tcp6       0      0 :::9092                 :::*                    LISTEN      28738/java
root@yw-elk:/data/elk/kafka/kafka_2.11-1.0.0# netstat -lnupt |grep 12345
tcp6       0      0 :::12345                :::*                    LISTEN      24280/java
10、手動創建項目使用的Topic
這裡無需手動建立Topic,Logstash會自動創建Topic。
創建Topic:
root@yw-elk:/data/elk/kafka/kafka_2.11-1.0.0# bin/kafka-topics.sh --zookeeper 127.0.0.1:2181 --create --partitions 5 --replication-factor 1 --topic production-xxx
查看Topic列表:
root@yw-elk:/data/elk/kafka/kafka_2.11-1.0.0# bin/kafka-topics.sh --zookeeper 127.0.0.1:2181 --list
__consumer_offsets
production-xxx
查看Topic狀態資訊:
root@yw-elk:/data/elk/kafka/kafka_2.11-1.0.0# bin/kafka-topics.sh --zookeeper 127.0.0.1:2181 --describe --topic production-xxx
Topic:test-th	PartitionCount:1	ReplicationFactor:1	Configs:
	Topic: test-th	Partition: 0	Leader: 0	Replicas: 0	Isr: 0
5、Filebeat(採集日誌)
Filebeart是Elastic家族中輕量級的基於文件的採集器,用於從多台主機上採集日誌,並傳送給Elasticsearch存儲或Logstash過濾處理。
安裝Filebeat以採集日誌,並將其傳送到Kafka消息隊列中,由Logstash連接到Kafka獲取日誌消息結構化處理後將其存儲到Elasticsearch。
示例日誌內容:
這是JAVA程式產生的日誌數據,其結構格式都是第一行通常都是以日期時間開頭的,當發生異常時後續的無日期開頭的行都將會屬於上一行日期開頭行的內容,這才是一條完整的JAVA日誌。
所以這裡我們使用Filebeat則需要配置多行日誌合併為一條日誌進行處理。
2018-12-03 02:15:28.049 c.t.f.w.common.stat.WebappStatUtil [INFO][WebappStatUtil.java:49][93926cbbdeca44f2b3f713b643df959a] - reqId=-8a26-1203021528-570,uri=/train/basic/station_info,code=0,duration=30,uid=-1,ip=139.214.244.179,stack=[TrainQueryService.getStationMap:0:4]
2018-12-03 18:07:36.183 c.t.f.w.c.f.ExceptionAndStatFilter [ERROR][ExceptionAndStatFilter.java:433][93926cbbdeca44f2b3f713b643df959a] - reqId=-8a26-1203180736-18, Request processing failed; nested exception is com.alibaba.fastjson.JSONException: syntax error, expect {, actual false, pos 0
org.springframework.web.util.NestedServletException: Request processing failed; nested exception is com.alibaba.fastjson.JSONException: syntax error, expect {, actual false, pos 0
	at org.springframework.web.servlet.FrameworkServlet.processRequest(FrameworkServlet.java:981) ~[spring-webmvc-4.2.4.RELEASE.jar:4.2.4.RELEASE]
1、解壓二進位包
root@jxota:~# cd /opt/ota/yw/filebeat
root@jxota:/opt/ota/yw/filebeat# tar xzvf filebeat-7.16.0-linux-x86_64.tar.gz
root@jxota:/opt/ota/yw/filebeat# cd filebeat-7.16.0-linux-x86_64/
2、配置Filebeat
我這邊是在測試環境下的一台主機上配置的,可以作為示例配置。
Filebeat應該在多台主機上運行,並所屬不同的主機環境和項目。
root@jxota:/opt/ota/yw/filebeat/filebeat-7.16.0-linux-x86_64# vim filebeat.yml
# ============================== Filebeat inputs ===============================
filebeat.inputs:
- type: log
  enabled: true
  paths:
    - /var/log/xxx/*/*.log

  ### 添加欄位
  # 添加一些欄位以識別項目和主機環境
  fields:
    hostenv: "production"  # 主機環境
    project: "xxx"  # 所屬項目

  ### 多行選項
  # 多行選項,期望輸出連續的多行日誌,比如Java日誌。
  multiline.type: pattern
  multiline.pattern: '^[0-9]{4}-[0-9]{2}-[0-9]{2}'
  # 使用正則表達匹配行。
  multiline.negate: true
  # 定義行是否被否定,若被否定,則執行"multiline.match"。
  multiline.match: after
  # 設置將匹配行與上一行(before)合併為一個事件輸出,還是將匹配行與下一行(after)合併為一個事件輸出。

# ================================== Outputs ===================================
# ...
# ------------------------------ Kafka Output -------------------------------
output.kafka:
  hosts: ["172.16.31.12:9092"]
  # 指定Kafka伺服器連接地址,我這邊由於網路環境問題,所以使用Kafka伺服器的公網主機IP地址。

  username: "admin"
  # 設置連接Kafka所使用的的用戶名
  password: "xxx"
  # 設置連接Kafka所使用的的用戶密碼

  topic: '%{[fields.hostenv]}-%{[fields.project]}'
  # 設置主題名稱
  partition.round_robin:
    group_events: 1
    reachable_only: false
  # 設置消息寫入主題的分區策略:默認使用hash方法。
  # random.group_events, 隨機寫入主題的任意一個分區,並設置寫入分區時消息事件的數量,默認為1。
  # round_robin.group_events,有序的輪詢的寫入主題分區,並設置寫入分區時消息時間的數量,默認為1。
  # hash.hash,通過哈希計算分區中的欄位列表,將匹配的欄位寫入到同一個分區中,如果沒有配置欄位,則使用事件鍵值。
  # - hash.random,如果無法計算哈希或鍵值,則隨機分發事件。
  # reachable_only: 默認分區都嘗試向所有分區發布事件,如果一個分區的leader在這個beat下變得不可用,輸出可能會阻塞,則開啟該項表示允許將事件發送到可用分區。
  required_acks: 1
  # 設置Kafka代理要求的ACK可靠性級別:
  # 0,無響應。
  # 1,等待本地提交。
  # -1,等待所有副本提交。
  # 註:如果設置為0,則Kafka不會返回任何ACK。出現錯誤時,消息可能會自動丟失。
  compression: gzip
  # 設置輸出壓縮編解碼器,默認為gzip。支援none、snappy、lz4和zip壓縮方式。
  compression_level: 4
  # 設置壓縮級別,默認為4。如果設置為0,則表示不壓縮。
  max_message_bytes: 10000000
  # JSON編碼消息最大允許大小。更大的資訊將被刪除。默認是1M。該值應該小於或等於Kafka代理伺服器
  # 的"message.max.bytes"。
3、添加Filebeat到系統服務
默認情況下Filebeat無法通過nohup這種方式讓其在後台運行,所以需要將其添加到系統服務才可後台運行。
root@jxota:/opt/ota/yw/filebeat/filebeat-7.16.0-linux-x86_64# vim /lib/systemd/system/filebeat.service
[Unit]
Description=filebeat
Wants=network-online.target
After=network-online.target
[Service]
User=root
ExecStart=/opt/ota/yw/filebeat/filebeat-7.16.0-linux-x86_64/filebeat -c /opt/ota/yw/filebeat/filebeat-7.16.0-linux-x86_64/filebeat.yml
Restart=always
[Install]
WantedBy=multi-user.target
root@jxota:/opt/ota/yw/filebeat/filebeat-7.16.0-linux-x86_64# systemctl daemon-reload
4、啟動Filebeat
可以先使用"./filebeat -e -c filebeat.yml -d "publist""在前台啟動,測試Filebeat(生產者)-> Kafka -> Logstash(消費方)的通訊情況。
root@jxota:/opt/ota/yw/filebeat/filebeat-7.16.0-linux-x86_64# systemctl start filebeat
root@jxota:/opt/ota/yw/filebeat/filebeat-7.16.0-linux-x86_64# systemctl status filebeat
● filebeat.service - filebeat
   Loaded: loaded (/lib/systemd/system/filebeat.service; enabled; vendor preset: enabled)
   Active: active (running) since Thu 2021-12-16 15:54:47 CST; 4min 30s ago
 Main PID: 10525 (filebeat)
   CGroup: /system.slice/filebeat.service
           └─10525 /opt/th/yw/filebeat-7.16.0-linux-x86_64/filebeat -c /opt/th/yw/filebeat-7.16.0-linux-x86_64/filebeat.yml
5、設置Filebeat開機自啟
root@agent:/opt/ota/yw/filebeat/filebeat-7.16.0-linux-x86_64# systemctl enable filebeat
Synchronizing state of filebeat.service with SysV init with /lib/systemd/systemd-sysv-install...
Executing /lib/systemd/systemd-sysv-install enable filebeat
6. Logstash(處理日誌)
Logstash用於讀取從Kafka+Filebeat採集來的日誌數據,結構化處理後存儲到Elasticsearch。
示例日誌內容:
2018-12-03 02:15:28.049 c.t.f.w.common.stat.WebappStatUtil [INFO][WebappStatUtil.java:49][93926cbbdeca44f2b3f713b643df959a] - reqId=-8a26-1203021528-570,uri=/train/basic/station_info,code=0,duration=30,uid=-1,ip=139.214.244.179,stack=[TrainQueryService.getStationMap:0:4]
2018-12-03 18:07:36.183 c.t.f.w.c.f.ExceptionAndStatFilter [ERROR][ExceptionAndStatFilter.java:433][93926cbbdeca44f2b3f713b643df959a] - reqId=-8a26-1203180736-18, Request processing failed; nested exception is com.alibaba.fastjson.JSONException: syntax error, expect {, actual false, pos 0
org.springframework.web.util.NestedServletException: Request processing failed; nested exception is com.alibaba.fastjson.JSONException: syntax error, expect {, actual false, pos 0
	at org.springframework.web.servlet.FrameworkServlet.processRequest(FrameworkServlet.java:981) ~[spring-webmvc-4.2.4.RELEASE.jar:4.2.4.RELEASE]
	at org.springframework.web.servlet.FrameworkServlet.processRequest(FrameworkServlet.java:981) ~[spring-webmvc-4.2.4.RELEASE.jar:4.2.4.RELEASE]
	at org.springframework.web.servlet.FrameworkServlet.processRequest(FrameworkServlet.java:981) ~[spring-webmvc-4.2.4.RELEASE.jar:4.2.4.RELEASE]
1、解壓二進位包
root@yw-elk:~# cd /data/elk/logstash/
root@yw-elk:/data/elk/logstash# tar xzvf logstash-7.16.0-linux-x86_64.tar.gz
2、安裝常用插件(可選的步驟)
查看已安裝插件,如果插件沒有安裝則需要手動安裝相關插件。
Logstash-7.16.0適用的Kafka插件版本是10.8.1。
註:由於默認的插件包地址下載較慢,需要修改為中國源。
root@yw-elk:/data/elk/logstash# cd logstash-7.16.0/
root@yw-elk:/data/elk/logstash/logstash-7.16.0# echo "54.235.82.130   artifacts.elastic.co" >> /etc/hosts
root@yw-elk:/data/elk/logstash/logstash-7.16.0# bin/logstash-plugin list --verbose
root@yw-elk:/data/elk/logstash/logstash-7.16.0# bin/logstash-plugin install <plugin_name>
3、調整JVM堆記憶體大小
root@yw-elk:/data/elk/logstash/logstash-7.16.0# vim config/jvm.options
-Xms4g
-Xmx4g
4、創建Kafka客戶端認證文件
root@yw-elk:/data/elk/logstash/logstash-7.16.0# vim config/kafka_client_jaas.conf
KafkaClient {
org.apache.kafka.common.security.plain.PlainLoginModule required
    username="admin"
    password="xxx";
};
5、調試Logstash
創建用於調試的Logstash管道配置文件,並啟動Logstash,查看控制台輸出以調試並編寫完整的Logstash管道配置。
我們期望將一些重要的關鍵的欄位存入到Elasticsearch中!
由於從Filebeat傳送過來的數據為JSON數據,所以需要將input中的編解碼器設置為JSON。
調試並創建Logstash管道配置文件:
root@yw-elk:/data/elk/logstash/logstash-7.16.0# vim config/logstash.conf
# -- 輸入
input {
  kafka {
    bootstrap_servers => "127.0.0.1:9092"
    topics => ["production-xxx"]
    consumer_threads => 1

    security_protocol => "SASL_PLAINTEXT"
    sasl_mechanism => "PLAIN"
    jaas_path => "/data/elk/logstash/logstash-7.16.0/config/kafka_client_jaas.conf"

    codec => "json"
  }
}

# -- 處理
filter {
}

# -- 輸出
output {
  stdout { codec => rubydebug }
}
前台啟動Logstash:
root@yw-elk:/data/elk/logstash/logstash-7.16.0# bin/logstash -f config/logstash.conf
未處理前的數據:
{
           "ecs" => {
        "version" => "1.12.0"
    },
      "@version" => "1",
          "host" => {
         "architecture" => "x86_64",
                  "mac" => [
            [0] "00:16:3e:12:0c:77"
        ],
        "containerized" => false,
             "hostname" => "xxx",
                   "os" => {
                "name" => "Ubuntu",
              "kernel" => "4.4.0-184-generic",
            "platform" => "ubuntu",
                "type" => "linux",
             "version" => "16.04.6 LTS (Xenial Xerus)",
            "codename" => "xenial",
              "family" => "debian"
        },
                   "id" => "92b8629fdc1ea4d3c82bfcad5eeac938",
                   "ip" => [
            [0] "172.17.0.16",
            [1] "fe80::216:3eff:fe12:c77"
        ],
                 "name" => "xxx"
    },
       "message" => "2018-12-03 18:07:36.183 c.t.f.w.c.f.ExceptionAndStatFilter [ERROR][ExceptionAndStatFilter.java:433][93926cbbdeca44f2b3f713b643df959a] - reqId=-8a26-1203180736-18, Request processing failed; nested exception is com.alibaba.fastjson.JSONException: syntax error, expect {, actual false, pos 0\norg.springframework.web.util.NestedServletException: Request processing failed; nested exception is com.alibaba.fastjson.JSONException: syntax error, expect {, actual false, pos 0\n        at org.springframework.web.servlet.FrameworkServlet.processRequest(FrameworkServlet.java:981) ~[spring-webmvc-4.2.4.RELEASE.jar:4.2.4.RELEASE]\n        at org.springframework.web.servlet.FrameworkServlet.processRequest(FrameworkServlet.java:981) ~[spring-webmvc-4.2.4.RELEASE.jar:4.2.4.RELEASE]\n",
           "log" => {
          "file" => {
            "path" => "/var/log/xxx/apache-tomcat-api/test.2021-10-12.log"
        },
         "flags" => [
            [0] "multiline"
        ],
        "offset" => 11557
    },
    "@timestamp" => 2021-12-13T09:55:42.278Z,
        "fields" => {
        "hostenv" => "production",
        "project" => "xxx"
    },
         "agent" => {
        "ephemeral_id" => "34bb5503-74c1-4885-9189-3ac0db6e8e2e",
            "hostname" => "xxx",
                "type" => "filebeat",
                  "id" => "8fda7277-3c33-4c05-8607-09b86bee8936",
             "version" => "7.16.0",
                "name" => "xxx"
    },
         "input" => {
        "type" => "log"
    }
}
6、使用Grok文本處理插件處理數據
使用Grok插件對"message"和"path"進行一些處理。
期望從"message"中得到以下欄位:
- logDateTime,當前日誌的時間戳
- logClassFilePath,類文件路徑
- logLevel,日誌級別
- logClassFileLine,類文件的第幾行報出來的日誌,用於問題定位
- logReqId,請求鏈ID
- logContent,日誌內容,具體的描述資訊
期望從"[log][file][path]"中獲取到日誌文件的名稱作為索引的名稱。 - logFileName,日誌文件名稱
自定義文本模式:可以使用Kibana中的開發工具中的GrokDebugger工具進行調試。
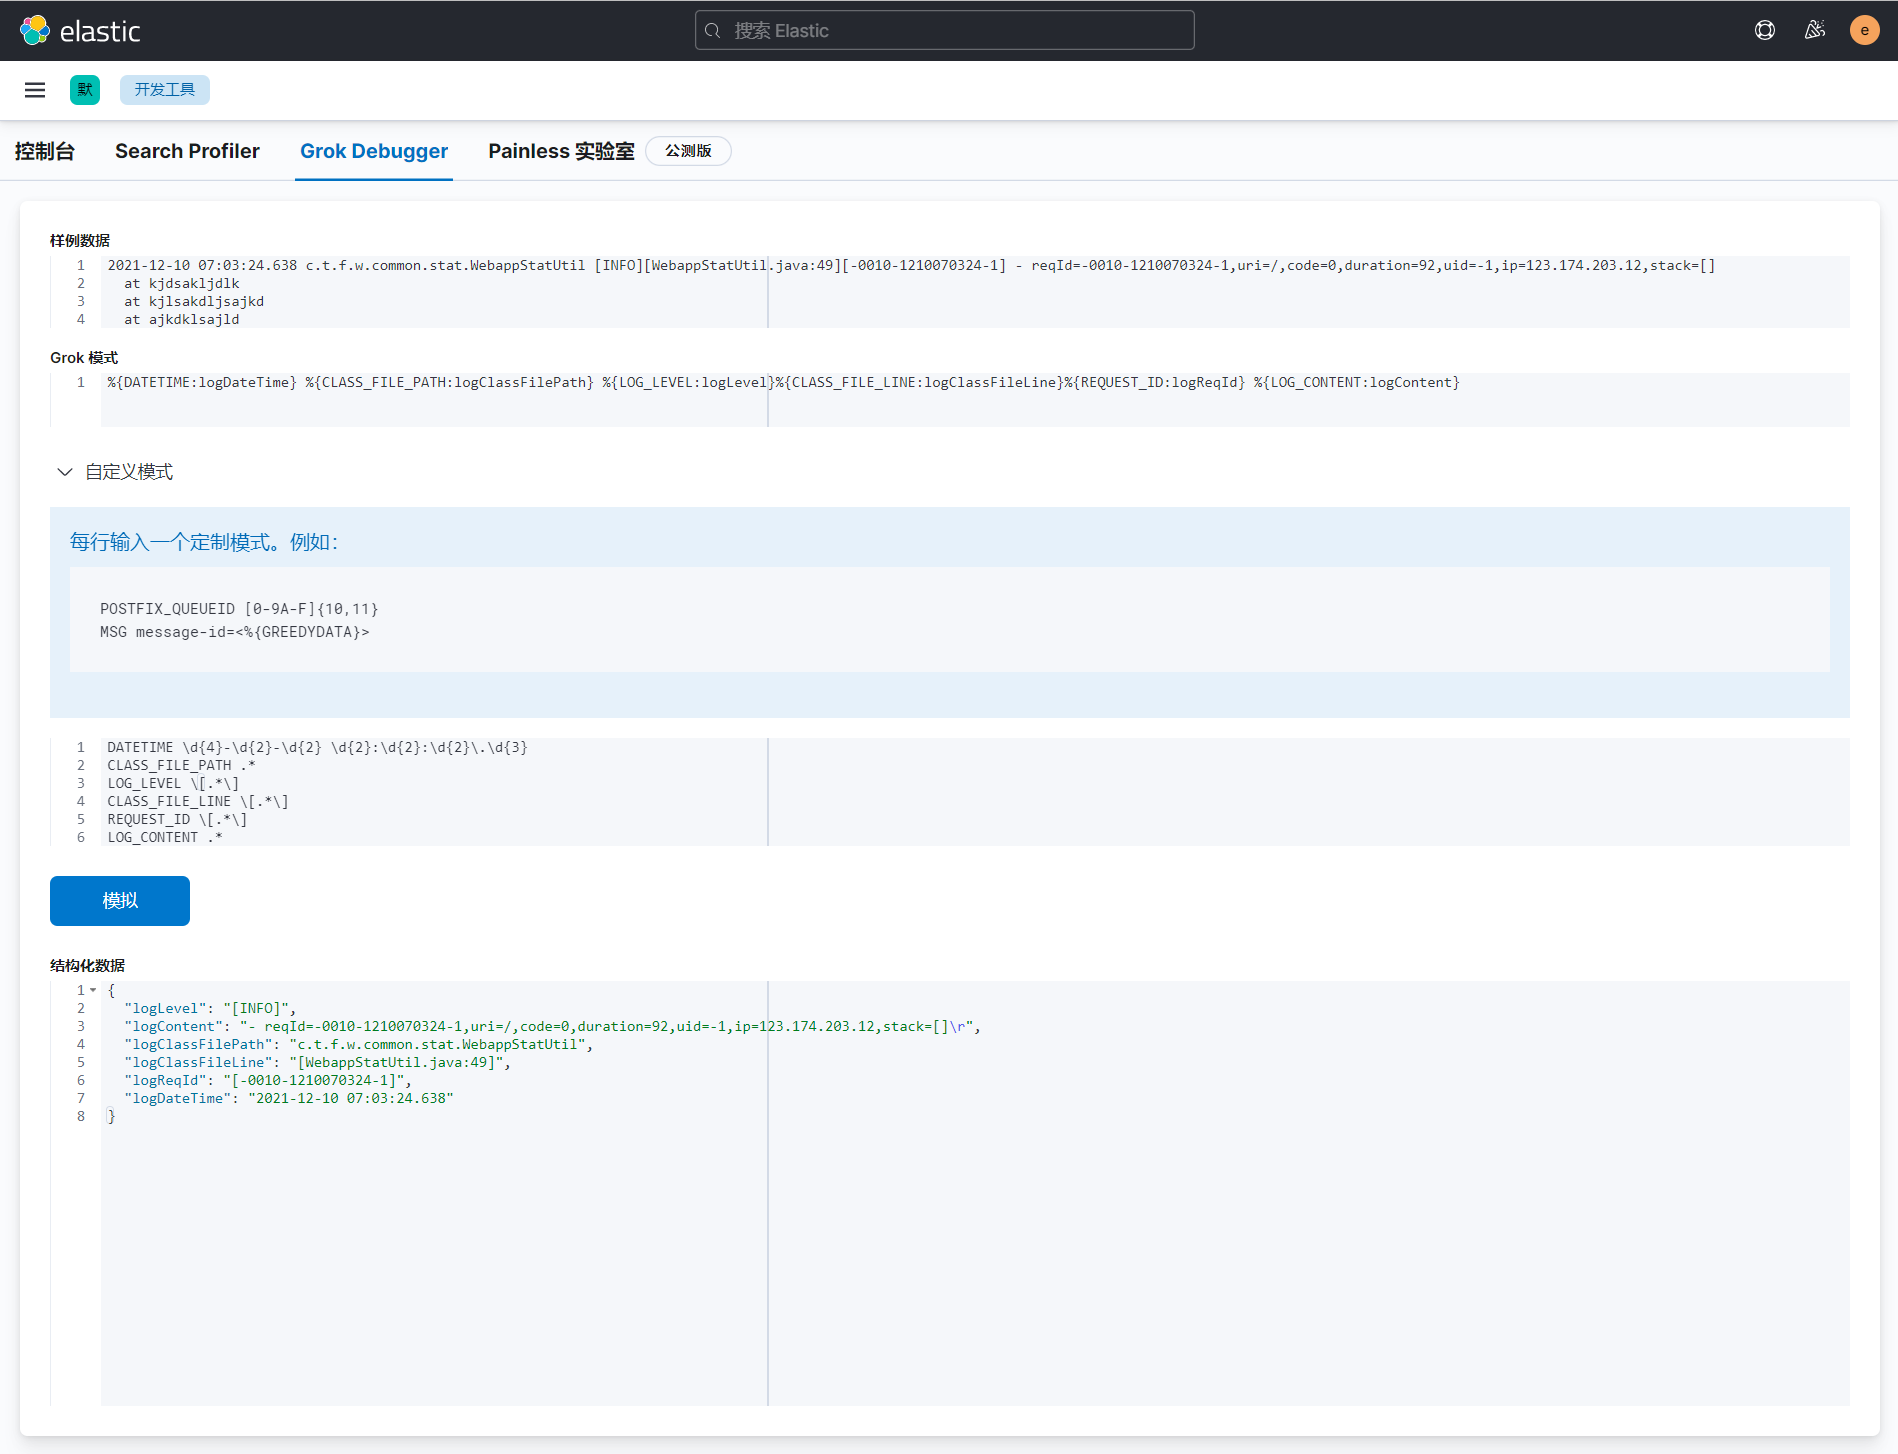
創建自定義文本模式文件:
root@yw-elk:/data/elk/logstash/logstash-7.16.0# vim config/patterns/patterns
# message
DATETIME \d{4}-\d{2}-\d{2} \d{2}:\d{2}:\d{2}\.\d{3}
CLASS_FILE_PATH .*
LOG_LEVEL \[.*\]
CLASS_FILE_LINE \[.*\]
REQUEST_ID \[.*\]
LOG_CONTENT .*
Logstash管道配置:
root@yw-elk:/data/elk/logstash/logstash-7.16.0# vim config/logstash.conf
# -- 輸入
input {
  kafka {
    bootstrap_servers => "127.0.0.1:9092"
    topics => ["production-xxx"]
    consumer_threads => 1

    security_protocol => "SASL_PLAINTEXT"
    sasl_mechanism => "PLAIN"
    jaas_path => "/data/elk/logstash/logstash-7.16.0/config/kafka_client_jaas.conf"

    codec => "json"
  }
}

# -- 處理
filter {
  # 使用Grok插件處理
  # 從"message"中提取:
  # - logDateTime,當前日誌的時間戳
  # - logClassFilePath,類文件路徑
  # - logLevel,日誌級別
  # - logClassFileLine,類文件的第幾行報出來的日誌,用於問題定位
  # - logReqId,請求鏈ID
  grok {
    patterns_dir => ["/data/elk/logstash/logstash-7.16.0/config/patterns"]
    match => {
      "message" => "%{DATETIME:logDateTime} %{CLASS_FILE_PATH:logClassFilePath} %{LOG_LEVEL:logLevel}%{CLASS_FILE_LINE:logClassFileLine}%{REQUEST_ID:logReqId} %{LOG_CONTENT:logContent}"
    }
  }

  # 使用Mutate插件處理
  # 從"[log][file][path]"中提取:
  # - logFileName,日誌文件名稱
  # 並刪除一些不重要的欄位"logContent"
  mutate {
    split => ["[log][file][path]", "/"]
    add_field => { "logFileName" => "%{[log][file][path][-1]}" }
    remove_field => ["logContent"]
  }
  mutate {
    join => ["[log][file][path]", "/"]
  }

  # 使用Mutate插件處理
  # 從"logDateTime"中提取:
  # - logDate,日誌記錄中的日期
  mutate {
    split => ["logDateTime", " "]
    add_field => { "logDate" => "%{[logDateTime][0]}" }
  }
  mutate {
    join => ["logDateTime", " "]
  }

   # 使用Date插件處理
   # 使用日誌的時間作為記錄的時間戳"@timestamp",保證日誌時序
   date {
     match => ["logDateTime", "ISO8601"]
     target => "@timestamp"
   }
}

# -- 輸出
output {
  stdout { codec => rubydebug }
}
結構化處理後結果:
{
            "logReqId" => "[93926cbbdeca44f2b3f713b643df959a]",
               "agent" => {
                "name" => "xxx",
            "hostname" => "xxx",
        "ephemeral_id" => "34bb5503-74c1-4885-9189-3ac0db6e8e2e",
             "version" => "7.16.0",
                "type" => "filebeat",
                  "id" => "8fda7277-3c33-4c05-8607-09b86bee8936"
    },
                 "ecs" => {
        "version" => "1.12.0"
    },
          "@timestamp" => 2021-12-13T09:51:02.255Z,
              "fields" => {
        "project" => "xxx",
        "hostenv" => "production"
    },
                 "log" => {
         "flags" => [
            [0] "multiline"
        ],
          "file" => {
            "path" => "/var/log/xxx/apache-tomcat-api/test.2021-10-12.log"
        },
        "offset" => 10784
    },
         "logDateTime" => "2018-12-03 18:07:36.183",
         "logDate" => "2018-12-03",
            "logLevel" => "[ERROR]",
               "input" => {
        "type" => "log"
    },
                "host" => {
                 "name" => "xxx",
                   "ip" => [
            [0] "172.17.0.16",
            [1] "fe80::216:3eff:fe12:c77"
        ],
                  "mac" => [
            [0] "00:16:3e:12:0c:77"
        ],
             "hostname" => "xxx",
        "containerized" => false,
                   "os" => {
                "name" => "Ubuntu",
              "kernel" => "4.4.0-184-generic",
            "codename" => "xenial",
            "platform" => "ubuntu",
              "family" => "debian",
             "version" => "16.04.6 LTS (Xenial Xerus)",
                "type" => "linux"
        },
         "architecture" => "x86_64",
                   "id" => "92b8629fdc1ea4d3c82bfcad5eeac938"
    },
             "message" => "2018-12-03 18:07:36.183 c.t.f.w.c.f.ExceptionAndStatFilter [ERROR][ExceptionAndStatFilter.java:433][93926cbbdeca44f2b3f713b643df959a] - reqId=-8a26-1203180736-18, Request processing failed; nested exception is com.alibaba.fastjson.JSONException: syntax error, expect {, actual false, pos 0\norg.springframework.web.util.NestedServletException: Request processing failed; nested exception is com.alibaba.fastjson.JSONException: syntax error, expect {, actual false, pos 0\n        at org.springframework.web.servlet.FrameworkServlet.processRequest(FrameworkServlet.java:981) ~[spring-webmvc-4.2.4.RELEASE.jar:4.2.4.RELEASE]\n        at org.springframework.web.servlet.FrameworkServlet.processRequest(FrameworkServlet.java:981) ~[spring-webmvc-4.2.4.RELEASE.jar:4.2.4.RELEASE]\n",
            "@version" => "1",
    "logClassFilePath" => "c.t.f.w.c.f.ExceptionAndStatFilter",
         "logFileName" => "test.2021-10-12.log",
    "logClassFileLine" => "[ExceptionAndStatFilter.java:433]"
}
7、將處理完成後的結果存儲到Elasticsearch中(最後完整的管道配置)
期望將日誌數據寫入到項目關聯的的索引中"%{[fields][hostenv]}-%{[fields][project]}"。
root@yw-elk:/data/elk/logstash/logstash-7.16.0# vim config/logstash.conf
# -- 輸入
input {
  kafka {
    bootstrap_servers => "127.0.0.1:9092"
    topics => ["production-xxx"]
    consumer_threads => 5

    security_protocol => "SASL_PLAINTEXT"
    sasl_mechanism => "PLAIN"
    jaas_path => "/data/elk/logstash/logstash-7.16.0/config/kafka_client_jaas.conf"

    codec => "json"
  }
}

# -- 處理
filter {
  # 使用Grok插件處理
  # 從"message"中提取:
  # - logDateTime,當前日誌的時間戳
  # - logClassFilePath,類文件路徑
  # - logLevel,日誌級別
  # - logClassFileLine,類文件的第幾行報出來的日誌,用於問題定位
  # - logReqId,請求鏈ID
  grok {
    patterns_dir => ["/data/elk/logstash/logstash-7.16.0/config/patterns"]
    match => {
      "message" => "%{DATETIME:logDateTime} %{CLASS_FILE_PATH:logClassFilePath} %{LOG_LEVEL:logLevel}%{CLASS_FILE_LINE:logClassFileLine}%{REQUEST_ID:logReqId} %{LOG_CONTENT:logContent}"
    }
  }

  # 使用Mutate插件處理
  # 從"[log][file][path]"中提取:
  # - logFileName,日誌文件名稱
  # 並刪除一些不重要的欄位"logContent"
  mutate {
    split => ["[log][file][path]", "/"]
    add_field => { "logFileName" => "%{[log][file][path][-1]}" }
    remove_field => ["logContent"]
  }
  mutate {
    join => ["[log][file][path]", "/"]
  }

  # 使用Mutate插件處理
  # 從"logDateTime"中提取:
  # - logDate,日誌記錄中的日期
  mutate {
    split => ["logDateTime", " "]
    add_field => { "logDate" => "%{[logDateTime][0]}" }
  }
  mutate {
    join => ["logDateTime", " "]
  }

   # 使用Date插件處理
   # 使用日誌的時間作為記錄的時間戳"@timestamp",保證日誌時序
   date {
     match => ["logDateTime", "ISO8601"]
     target => "@timestamp"
   }
}


# -- 輸出
output {
  # stdout { codec => rubydebug }
  # 如果"logDate"中的值不是日期,則將其存到指定的索引裡面
  if [logDate] =~ "^\d{4}-\d{2}-\d{2}" {
    elasticsearch {
      hosts => "127.0.0.1:9200"
      user => "elastic"
      password => "lgWZDNRmTaXwkO4s"
      manage_template => false
      index => "%{[fields][hostenv]}-%{[fields][project]}-%{[logDate]}"
      document_type => "%{[@metadata][type]}"
    }
  } else {
    elasticsearch {
      hosts => "127.0.0.1:9200"
      user => "elastic"
      password => "xxx"
      manage_template => false
      index => "%{[fields][hostenv]}-%{[fields][project]}-unkown"
      document_type => "%{[@metadata][type]}"
    }
  }
}
8、設置服務配置
修改Logstash的API監聽埠配置,避免默認的埠範圍隨機一個埠,埠可用於監控服務是否工作正常。
root@yw-elk:/data/elk/logstash/logstash-7.16.0# vim config/logstash.yml
api.http.port: 9600
9、啟動Logstash
root@yw-elk:/data/elk/logstash/logstash-7.16.0# nohup bin/logstash -f config/logstash.conf --config.reload.automatic &
root@yw-elk:/data/elk/logstash/logstash-7.16.0# netstat -lnupt |grep 9600
tcp6       0      0 127.0.0.1:9600          :::*                    LISTEN      27192/java
7、搭建完成
1、查看Elasticsearch
可以看到Elasticsearch中已經自動創建了索引,並且日誌已經存進去了。
root@yw-elk:~# curl -X GET -u elastic:xxxx //127.0.0.1:9200/_cat/indices?v
health status index uuid pri rep docs.count docs.deleted store.size pri.store.size
yellow open production-xxx-2021-12-12 NBrMgp9wS3-K_WsP9iUh-g 1 1 12 0 67.2kb 67.2kb
...
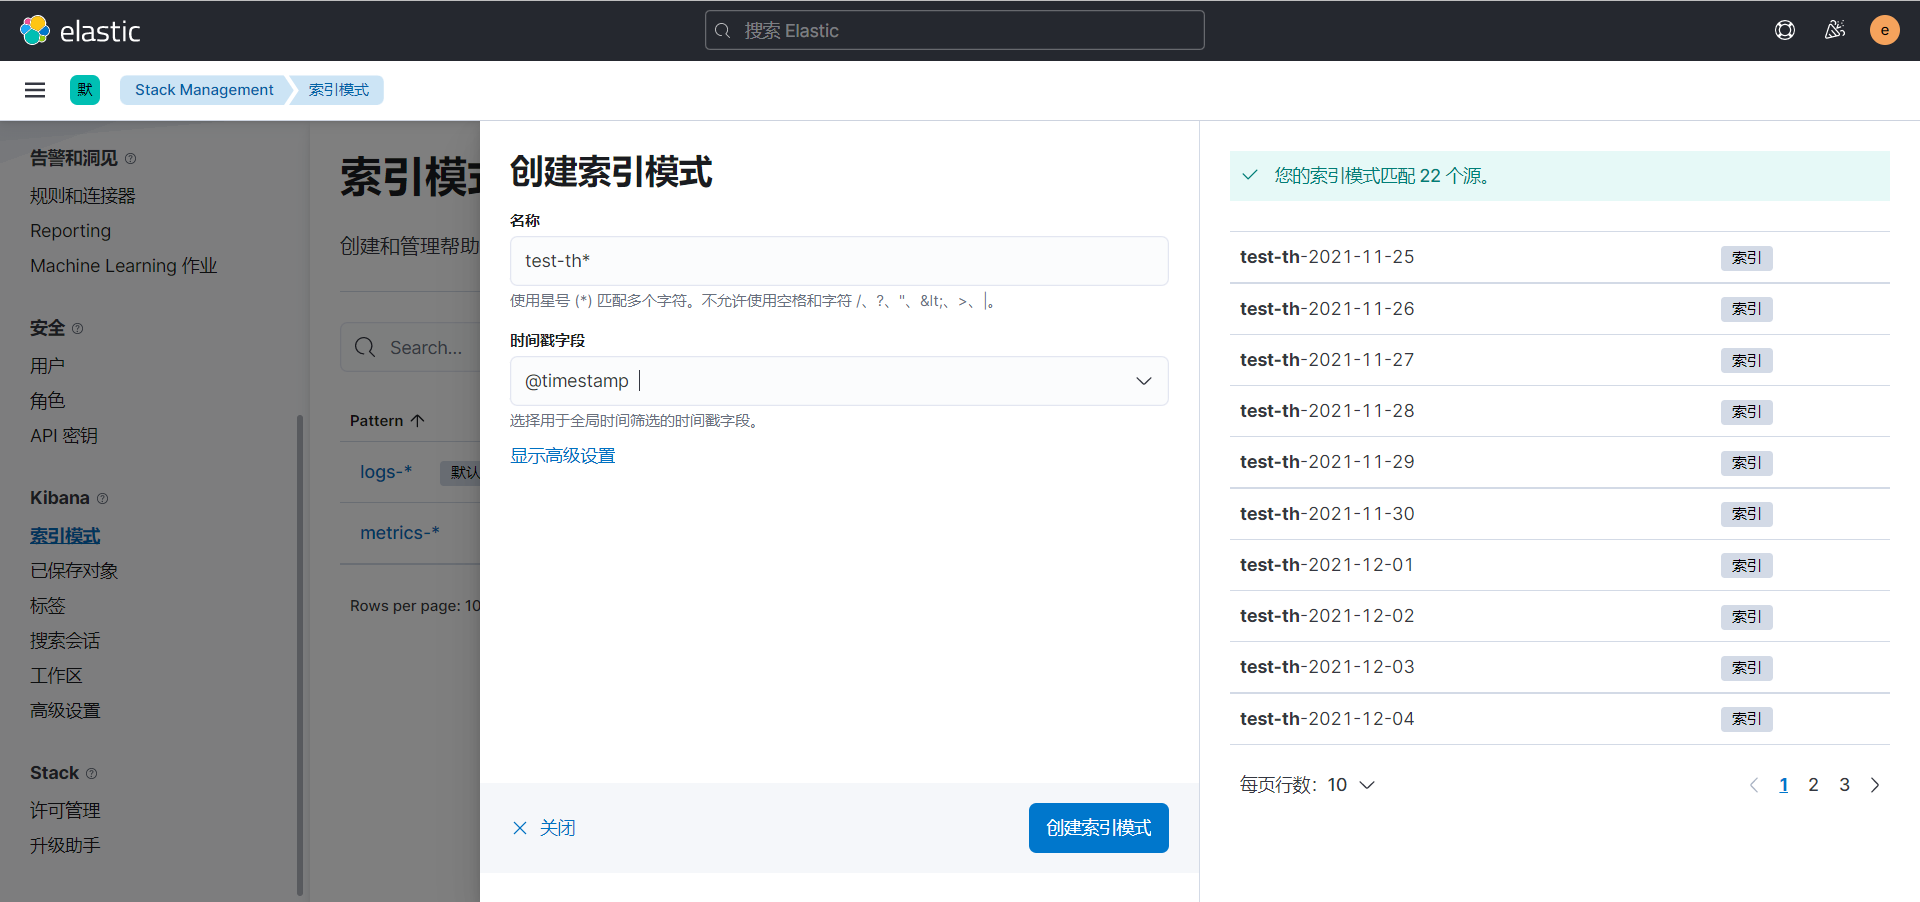
2、在Kibana上創建索引模式檢索日誌
索引模式是通過通配符表達式關聯的多個索引的集合。
操作步驟:Stack Management -> 索引模式 -> 創建索引模式
附錄-官方文檔
參考官方文檔://www.elastic.co/guide/index.html
附錄-工作組件關係圖
附錄-Kibana排序查看日誌(使用Logstash修改@timestamp)
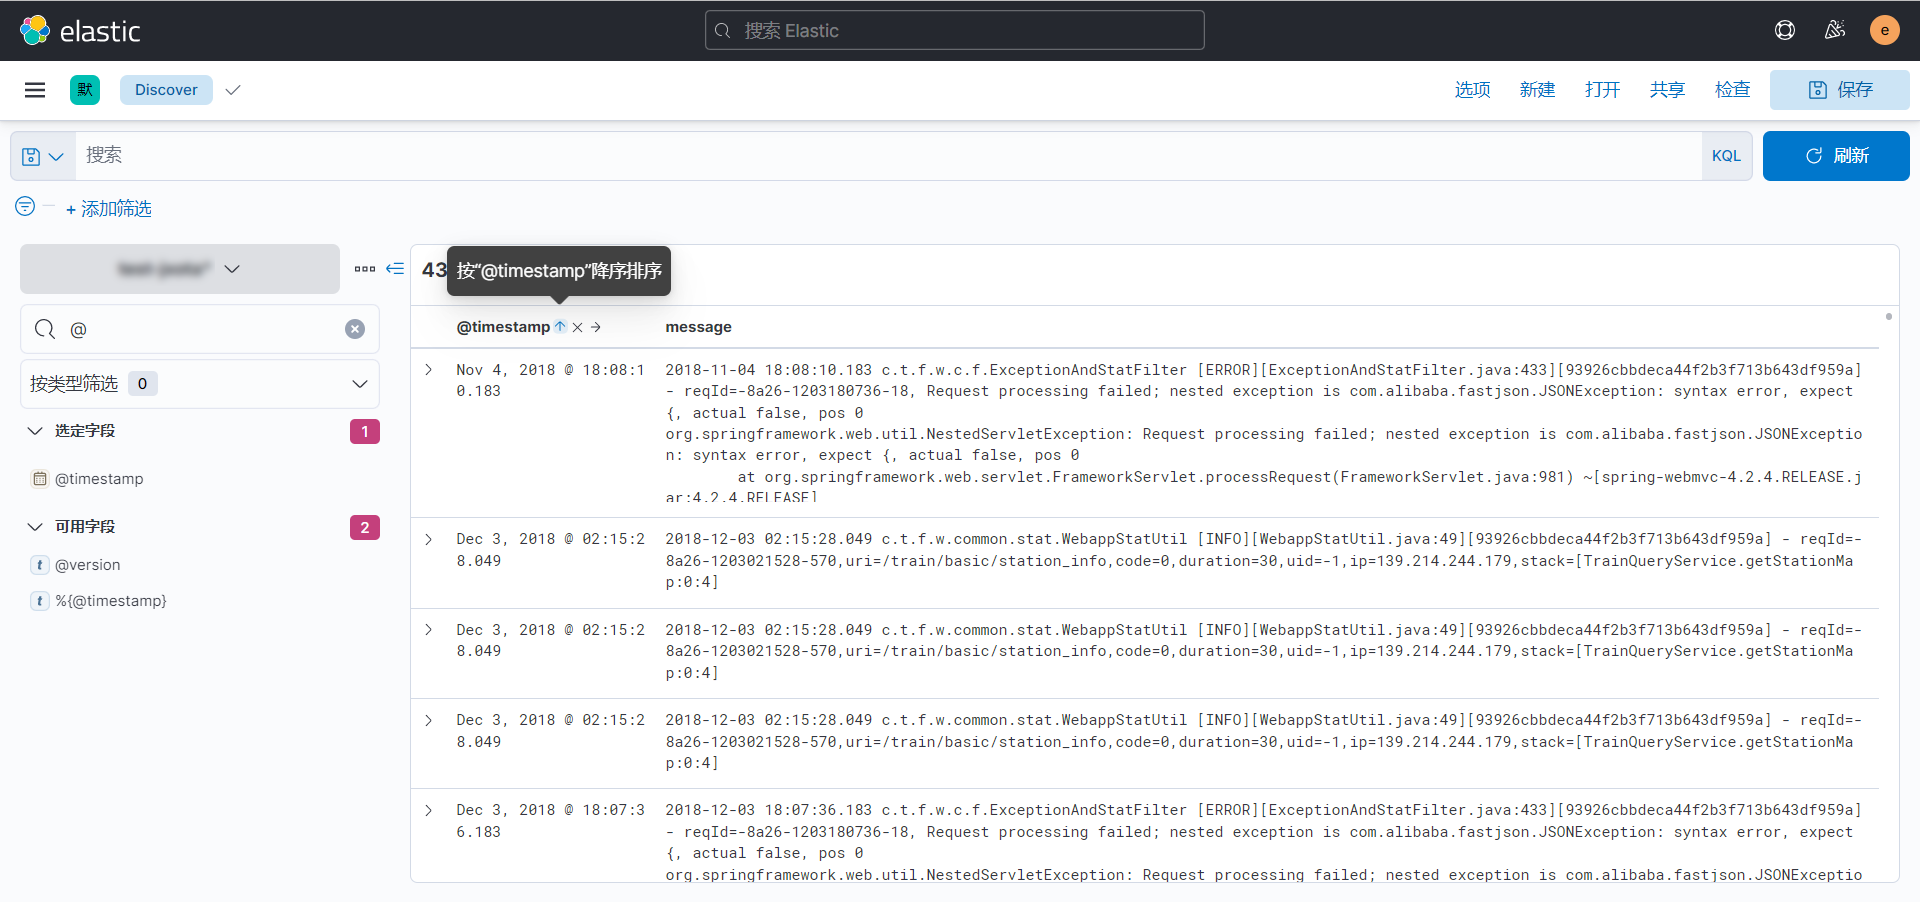
由於多個應用的日誌非同步向ES中寫入,對於寫入的記錄是無序的,Kibana僅提供一個@timestamp可操作排序。
由於默認記錄的時間戳是使用的當前系統時間,對採用系統時間戳記錄進行排序意義不大。
這個時候如果想要使用@timestamp排序後查看得到的日誌是有序的話,則只需要截取日誌中的時間戳將其轉換為內置欄位@timestamp所使用的即可,即日誌時間=@timestamp。
Logstash管道配置如下:
# -- 輸入
input {
  kafka {
    bootstrap_servers => "127.0.0.1:9092"
    topics => ["production-xxx"]
    consumer_threads => 1

    security_protocol => "SASL_PLAINTEXT"
    sasl_mechanism => "PLAIN"
    jaas_path => "/data/elk/logstash/logstash-7.16.0/config/kafka_client_jaas.conf"

    codec => "json"
  }
}

# -- 處理
filter {
  # 使用Grok插件處理
  # 從"message"中提取:
  # - logDateTime,當前日誌的時間戳
  # - logClassFilePath,類文件路徑
  # - logLevel,日誌級別
  # - logClassFileLine,類文件的第幾行報出來的日誌,用於問題定位
  # - logReqId,請求鏈ID
  grok {
    patterns_dir => ["/data/elk/logstash/logstash-7.16.0/config/patterns"]
    match => {
      "message" => "%{DATETIME:logDateTime} %{CLASS_FILE_PATH:logClassFilePath} %{LOG_LEVEL:logLevel}%{CLASS_FILE_LINE:logClassFileLine}%{REQUEST_ID:logReqId} %{LOG_CONTENT:logContent}"
    }
  }

  # 使用Mutate插件處理
  # 從"[log][file][path]"中提取:
  # - logFileName,日誌文件名稱
  # 並刪除一些不重要的欄位
  mutate {
    split => ["[log][file][path]", "/"]
    add_field => { "logFileName" => "%{[log][file][path][-1]}" }
    remove_field => ["logContent"]
  }
  mutate {
    join => ["[log][file][path]", "/"]
  }

   # 使用Date插件處理
   # 使用日誌的時間作為記錄的時間戳"@timestamp",保證日誌時序
   date {
     match => ["logDateTime", "ISO8601"]
     target => "@timestamp"
   }
}

# -- 輸出
output {
  elasticsearch {
    hosts => "127.0.0.1:9200"
    user => "elastic"
    password => "xxx"
    manage_template => false
    index => "%{[fields][hostenv]}-%{[fields][project]}-%{logFileName}"
    document_type => "%{[@metadata][type]}"
  }
}
Kibana中排序操作:
附錄-Filebeat重新收集之前的日誌
在Filebeat的工作目錄下的"data"目錄中記錄了filebeat收集日誌的偏移值記錄。
只需要清除"data"目錄下的所有文件,重啟Filebeat即可。
root@agent:/opt/ota/yw/filebeat/filebeat-7.16.0-linux-x86_64# rm -rf data/*
附錄-Kafka如何合理的設置Topic的分區數量
分區越多,則表示資料庫目錄下會存放更多的目錄和文件,並行的分區數也代表著在系統中會打開更多的句柄數量。
在生產者端的配置中有個batch.size大小,默認為16KB,它會為每個分區緩衝消息,當消息滿了以後再打包批量發送到Borker,分區數量越多也意味著會存在更多的緩衝區,即佔用更多的記憶體大小。
在消費者端會創建對應分區數量的執行緒去消費消息,則表示並行的執行緒,執行緒之間上下文切換也會造成系統資源的開銷。
所以合理的設置Topic的分區數量是非常重要的。
Kafka默認集成了性能測試的工具"kafka-producer-perf-test.sh"和"kafka-consumer-perf-test.sh"可以測試Topic的每秒可處理消息的吞吐量、延遲。可以根據測試結果合理的創建分區數量。
示例:
假定一條日誌消息的數據大小為2000位元組,業務系統一個節點每秒產生1000條日誌,則你期望在1秒鐘就可以存儲到Kafka中,則期望的吞吐量是20001000節點數量=目標吞吐量,我這邊有10個節點,則我期望的目標吞吐量為20MB/s。
下面我創建了一個分區的Topic,並使用生產端和消費端性能壓測工具進行壓力測試。
可以看到經過以下測試的結果,一個分區的Topic的處理消息的吞吐量是2.8MB/s,則分區數量=目標吞吐量/性能壓測的吞吐量。
1、創建測試用的Topic
root@yw-elk:~# cd /data/elk/kafka/kafka_2.11-1.0.0/
root@yw-elk:/data/elk/kafka/kafka_2.11-1.0.0# bin/kafka-topics.sh --zookeeper 127.0.0.1:2181 --create --partitions 1 --replication-factor 1 --topic test
Created topic "test".
2、使用生產者性能測試工具"kafka-producer-perf-test.sh"進行壓測
註:由於這邊使用SASL認證,所以需要修改下腳本。
root@yw-elk:/data/elk/kafka/kafka_2.11-1.0.0# vim bin/kafka-producer-perf-test.sh
export KAFKA_OPTS="-Djava.security.auth.login.config=/data/elk/kafka/kafka_2.11-1.0.0/config/kafka_client_jaas.conf"
root@yw-elk:/data/elk/kafka/kafka_2.11-1.0.0# bin/kafka-producer-perf-test.sh --producer.config config/producer.properties --topic test --num-records 10000 --throughput -1 --print-metrics   --record-size 2000 --producer-props acks=1
# 選項:
# --topic TOPIC                               指定要生產消息所使用的的Topic
# --num-records NUM-RECORDS                   要生產的消息的總數量
# --throughput THROUGHPUT                     設置最大消息吞吐量:總消息數量/秒。-1表示不設置。
# --producer.config CONFIG-FILE               指定生產者配置文件
# --producer-props                            手動指定配置,acks=1表示不允許丟消息
# --print-metrics                             在測試結束後列印指標
# --record-size RECORD-SIZE                   每條消息的大小,單位為位元組
7713 records sent, 1542.3 records/sec (2.94 MB/sec), 2059.4 ms avg latency, 4814.0 max latency.
10000 records sent, 1489.646954 records/sec (2.84 MB/sec), 2882.56 ms avg latency, 6501.00 ms max latency, 2814 ms 50th, 6132 ms 95th, 6430 ms 99th, 6497 ms 99.9th.
3、使用消費端性能測試工具"kafka-producer-perf-test.sh"進行壓測
註:由於這邊使用SASL認證,所以需要修改下腳本。
root@yw-elk:/data/elk/kafka/kafka_2.11-1.0.0# vim bin/kafka-consumer-perf-test.sh
export KAFKA_OPTS="-Djava.security.auth.login.config=/data/elk/kafka/kafka_2.11-1.0.0/config/kafka_client_jaas.conf"
root@yw-elk:/data/elk/kafka/kafka_2.11-1.0.0# bin/kafka-consumer-perf-test.sh --broker-list 127.0.0.1:9092 --consumer.config config/consumer.properties --threads 1 --topic test --messages 10000
# 選項:
# --broker-list            Kafka伺服器列表
# --consumer.config        消費者配置文件
# --threads                執行緒數量
# --topic                  測試使用的主題
# --messages               要處理的消息總數
start.time, end.time, data.consumed.in.MB, MB.sec, data.consumed.in.nMsg, nMsg.sec, rebalance.time.ms, fetch.time.ms, fetch.MB.sec, fetch.nMsg.sec
2021-12-15 10:31:43:790, 2021-12-15 10:31:49:541, 16.5634, 2.8801, 10484, 1822.9873, 34, 5717, 2.8972, 1833.8289
附錄-開啟Kafka JMX監控功能
1、創建JMX監控要使用的帳號密碼文件
創建JMX監控要使用的帳號密碼文件"jmxremote.password"和許可權控制"jmxremote.access"文件:
- jmxremote.password 內容格式:
- jmxremote.access 內容格式:
<readonly|readwrite>
註:這兩個文件僅能使用600許可權,否則服務無法啟動。
root@yw-elk:/data/elk/kafka/cmak-3.0.0.5# cd /data/elk/kafka/kafka_2.11-1.0.0/
root@yw-elk:/data/elk/kafka/kafka_2.11-1.0.0# vim config/jmxremote.password
jmxuser xxx
root@yw-elk:/data/elk/kafka/kafka_2.11-1.0.0# vim config/jmxremote.access
jmxuser readonly
root@yw-elk:/data/elk/kafka/kafka_2.11-1.0.0# chmod 600 config/jmxremote.*
2、修改相關腳本
在指定的腳本文件中找到以下內容,添加並修改相關內容。
root@yw-elk:/data/elk/kafka/kafka_2.11-1.0.0# vim bin/kafka-run-class.sh
# JMX settings
if [ -z "$KAFKA_JMX_OPTS" ]; then
  KAFKA_JMX_OPTS="-Dcom.sun.management.jmxremote -Djava.rmi.server.hostname="127.0.0.1" -Dcom.sun.management.jmxremote.authenticate=true  -Dcom.sun.management.jmxremote.ssl=false  -Dcom.sun.management.jmxremote.password.file=/data/elk/kafka/kafka_2.11-1.0.0/config/jmxremote.password -Dcom.sun.management.jmxremote.access.file=/data/elk/kafka/kafka_2.11-1.0.0/config/jmxremote.access"
fi

# JMX port to use
if [  $JMX_PORT ]; then
  KAFKA_JMX_OPTS="$KAFKA_JMX_OPTS -Dcom.sun.management.jmxremote.port=$JMX_PORT"
fi
root@yw-elk:/data/elk/kafka/kafka_2.11-1.0.0# vim bin/kafka-server-start.sh
export JMX_PORT="12345"
3、重啟Kafka
root@yw-elk:/data/elk/kafka/kafka_2.11-1.0.0# netstat -lnupt |grep 9092
tcp6       0      0 :::9092                 :::*                    LISTEN      12324/java
root@yw-elk:/data/elk/kafka/kafka_2.11-1.0.0# kill -15 12324
root@yw-elk:/data/elk/kafka/kafka_2.11-1.0.0# bin/kafka-server-start.sh  -daemon /data/elk/kafka/kafka_2.11-1.0.0/config/server.properties
root@yw-elk:/data/elk/kafka/kafka_2.11-1.0.0# netstat -lnupt |grep 9092
tcp6       0      0 :::9092                 :::*                    LISTEN      24280/java
root@yw-elk:/data/elk/kafka/kafka_2.11-1.0.0# netstat -lnupt |grep 12345
tcp6       0      0 :::12345                :::*                    LISTEN      24280/java
附錄-Kafka Manger(Kafka可視化監控管理工具)
Kafka Manger是一個由雅虎開源的Kafka可視化監控管理工具,由於商標的問題,與Apache產生了商業糾紛,現今階段已經更名為CMAK了。
1、安裝JDK11
CMAK-3.0.0.5需要JDK11的支援。
root@yw-elk:~# cd /data/elk/jdk/
root@yw-elk:/data/elk/jdk# tar xzvf jdk-11.0.13_linux-x64_bin.tar.gz
2、解壓CMAK二進位包
root@yw-elk:/data/elk/jdk/jdk-11.0.13# cd /data/elk/kafka/
root@yw-elk:/data/elk/kafka# unzip cmak-3.0.0.5.zip
3、配置CMAK
root@yw-elk:/data/elk/kafka# cd cmak-3.0.0.5
root@yw-elk:/data/elk/kafka/cmak-3.0.0.5# vim conf/application.conf
kafka-manager.zkhosts="127.0.0.1:2181"
# kafka-manager連接zookeeper的連接地址。
cmak.zkhosts="127.0.0.1:2181"
# cmak連接zookeeper的連接地址。
basicAuthentication.enabled=true
# 開啟基本認證功能。訪問CMAK時需要輸入帳號密碼。
basicAuthentication.username="admin"
# 設置基本認證時要使用的帳號
basicAuthentication.password="xxx"
# 設置基本認證時要使用的帳號密碼
4、配置消費者屬性
開啟消費者支援SASL認證。
Kafka沒有配置SASL認證,可以不用執行此步驟。
root@yw-elk:/data/elk/kafka/cmak-3.0.0.5# vim conf/consumer.properties
### SASL ###
security.protocol=SASL_PLAINTEXT
sasl.mechanism=PLAIN
5、啟動CMAK服務
啟動CMAK服務可能需要會兒時間,請耐心等待。
root@yw-elk:/data/elk/kafka/cmak-3.0.0.5# nohup bin/cmak -Dconfig.file=/data/elk/kafka/cmak-3.0.0.5/conf/application.conf -Dhttp.port=8080 -java-home /data/elk/jdk/jdk-11.0.13 &
root@yw-elk:/data/elk/kafka/kafka_2.11-1.0.0# netstat -lnupt |grep 8080
tcp6       0      0 :::8080                 :::*                    LISTEN      22868/java
6、配置Nginx反向代理
配置完成後,需要配置域名解析。
root@yw-elk:/data/elk/kafka/cmak-3.0.0.5# vim /etc/nginx/conf.d/elk.conf
# kafka-manager
server {
    listen       80;
    server_name  kafka-manager.xxx.net;
    location / {
            proxy_pass //127.0.0.1:8080;
            proxy_set_header Host $host;
            proxy_set_header X-Real-IP $remote_addr;
            proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
    }
    error_page 404 /404.html;
    location = /40x.html {
    }
    error_page 500 502 503 504 /50x.html;
    location = /50x.html {
    }
}
root@yw-elk:/data/elk/kafka/cmak-3.0.0.5# nginx -s reload
7、訪問到CMAK
8、添加Kafka集群
這裡一定要注意,填寫SASL配置的時候必須填寫內容,而不是指定配置文件
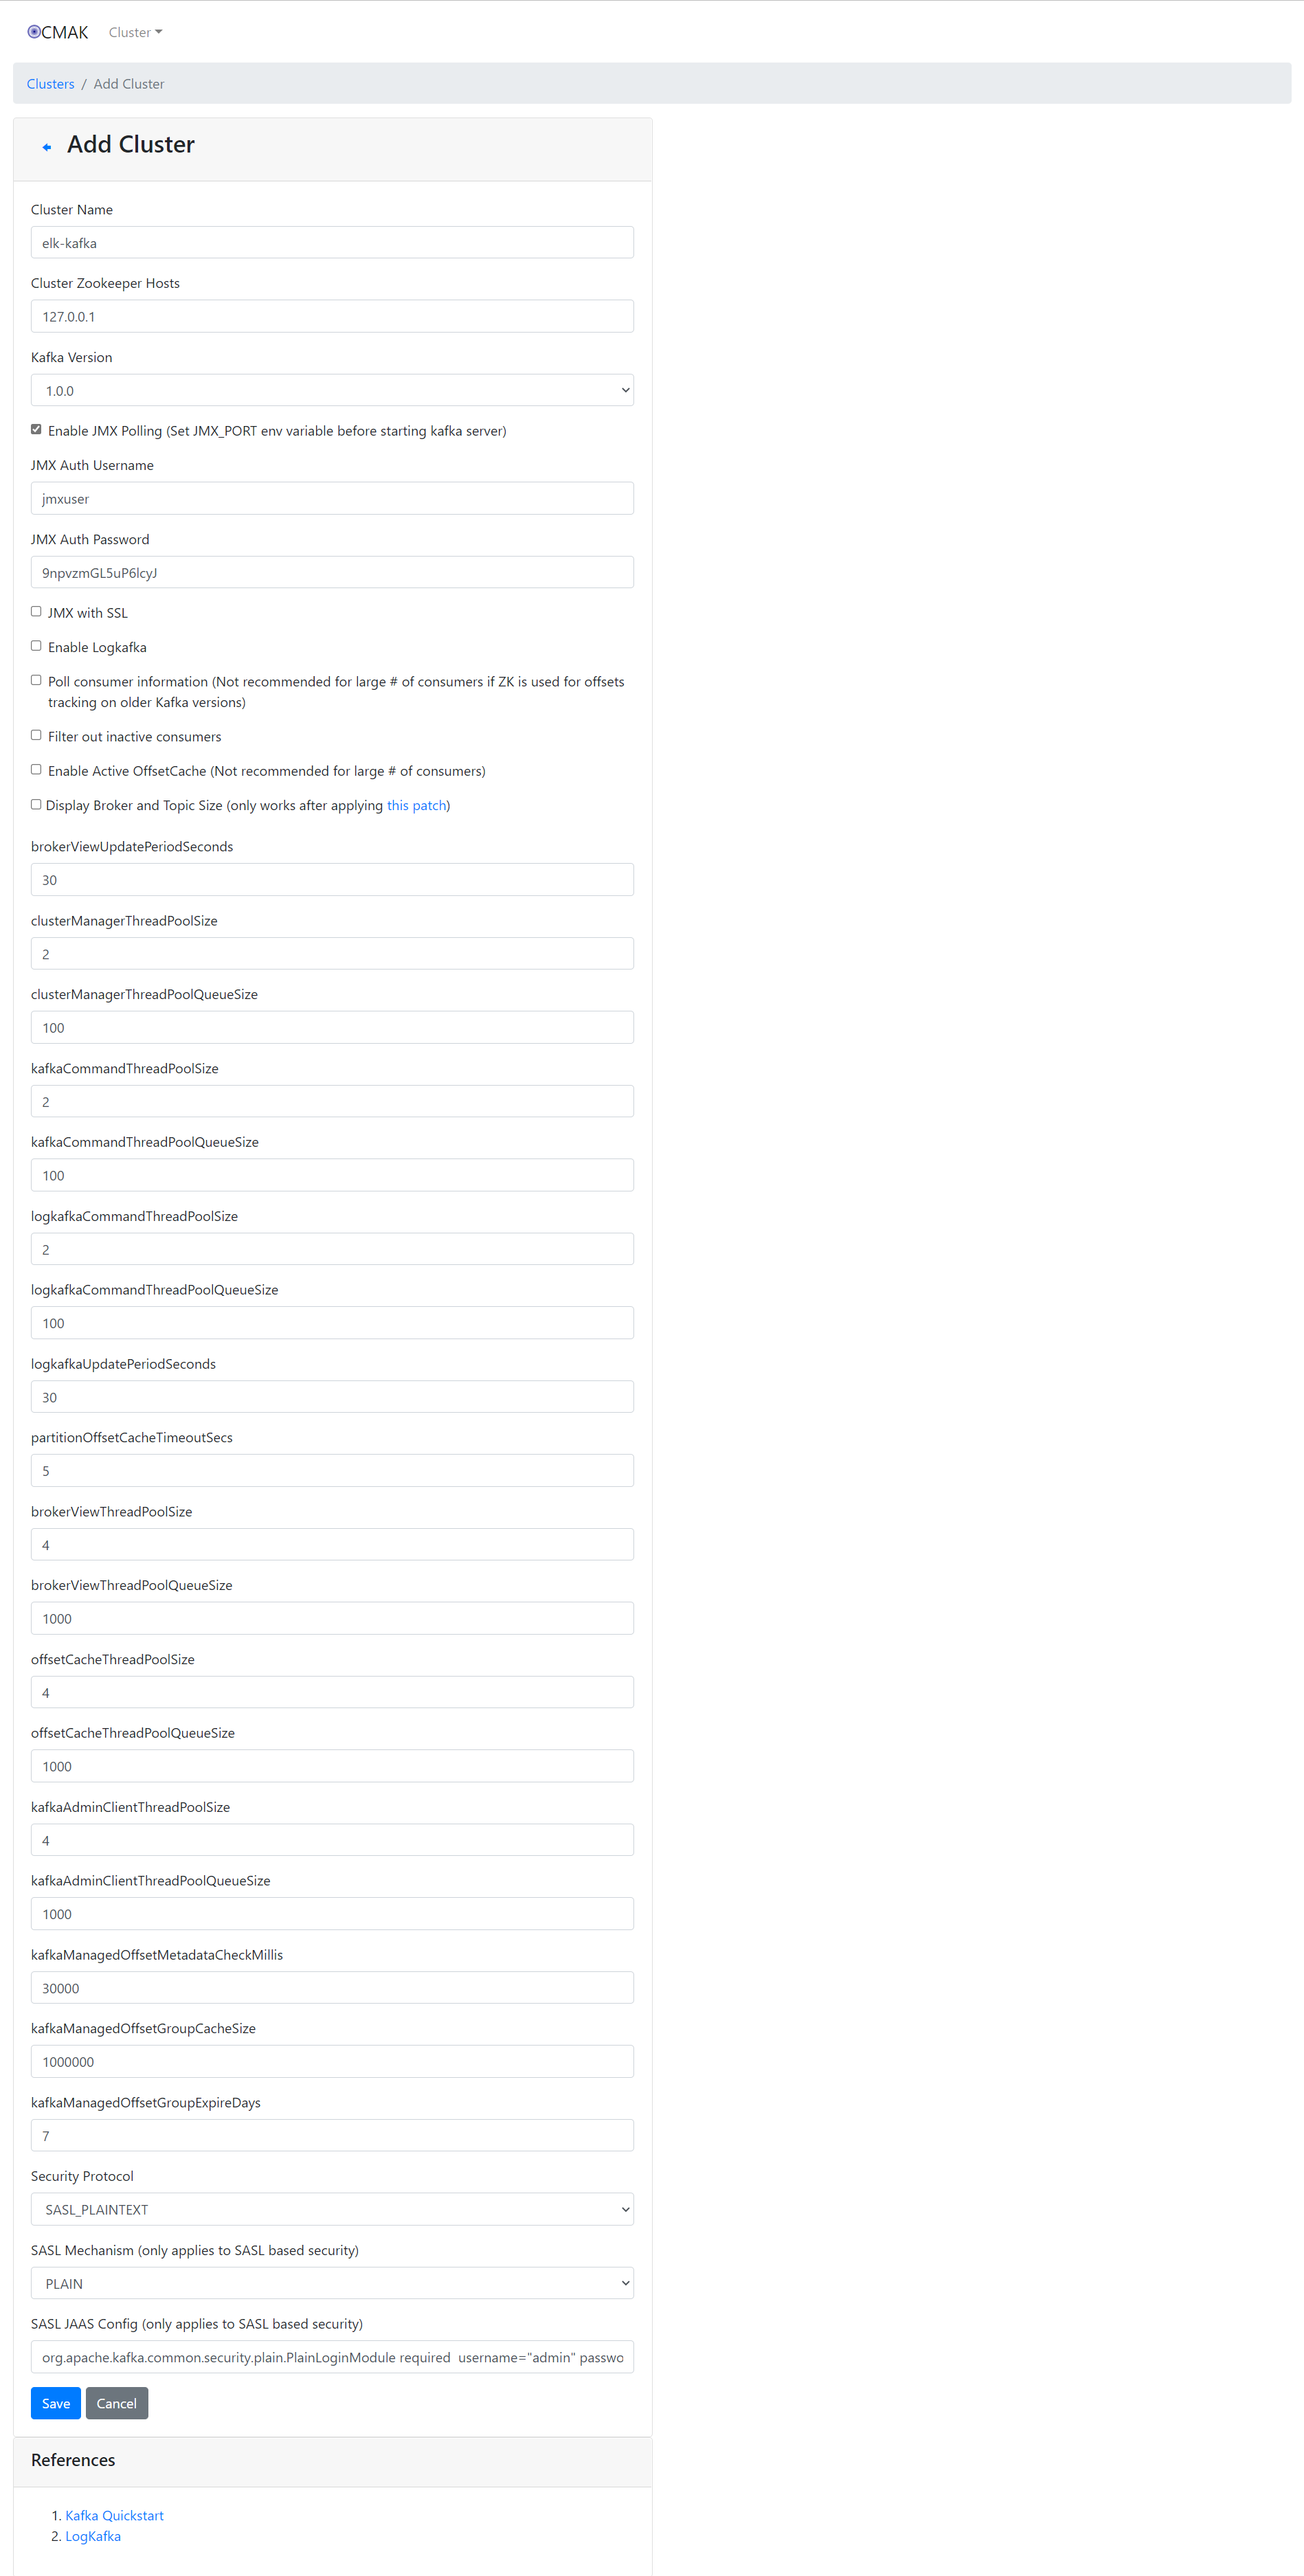
9、解決在CMAK添加Kafka集群的時候報以下錯誤問題
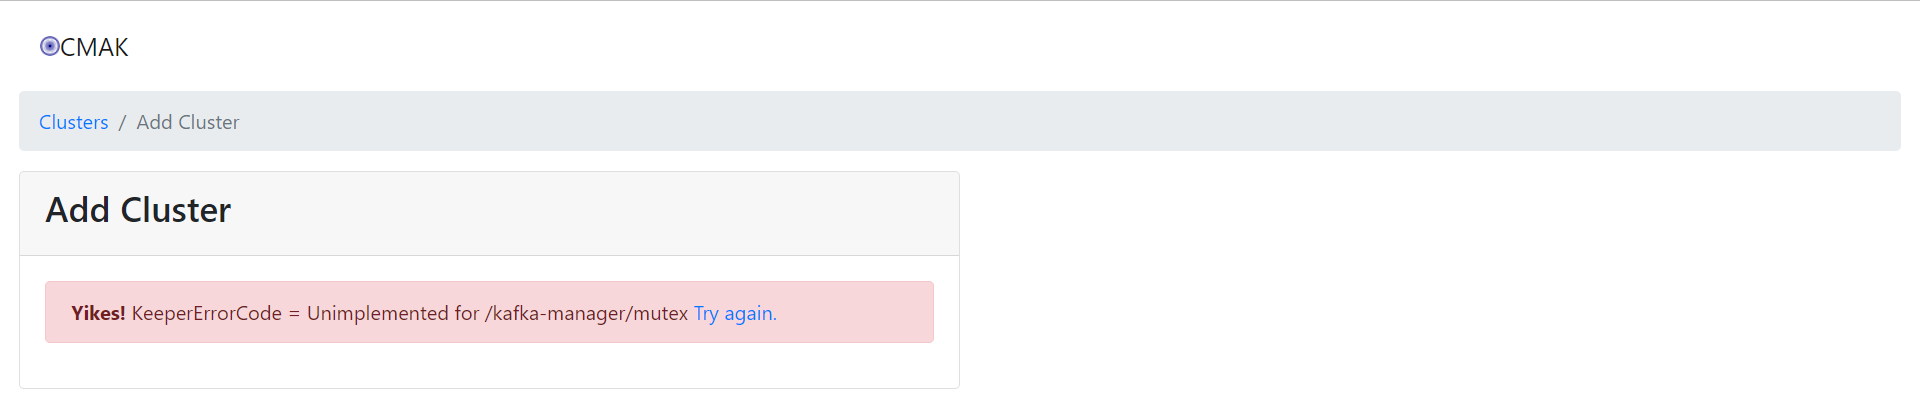
root@yw-elk:/data/elk/kafka/cmak-3.0.0.5# cd /data/elk/kafka/kafka_2.11-1.0.0/
root@yw-elk:/data/elk/kafka/kafka_2.11-1.0.0# bin/zookeeper-shell.sh 127.0.0.1:2181
Connecting to 127.0.0.1:2181
Welcome to ZooKeeper!
] create /kafka-manager/mutex ""
] create /kafka-manager/mutex/locks ""
] create /kafka-manager/mutex/leases ""
] ls /
[cluster, controller, brokers, zookeeper, kafka-acl, kafka-acl-changes, admin, isr_change_notification, log_dir_event_notification, controller_epoch, kafka-manager, consumers, latest_producer_id_block, config]
] quit
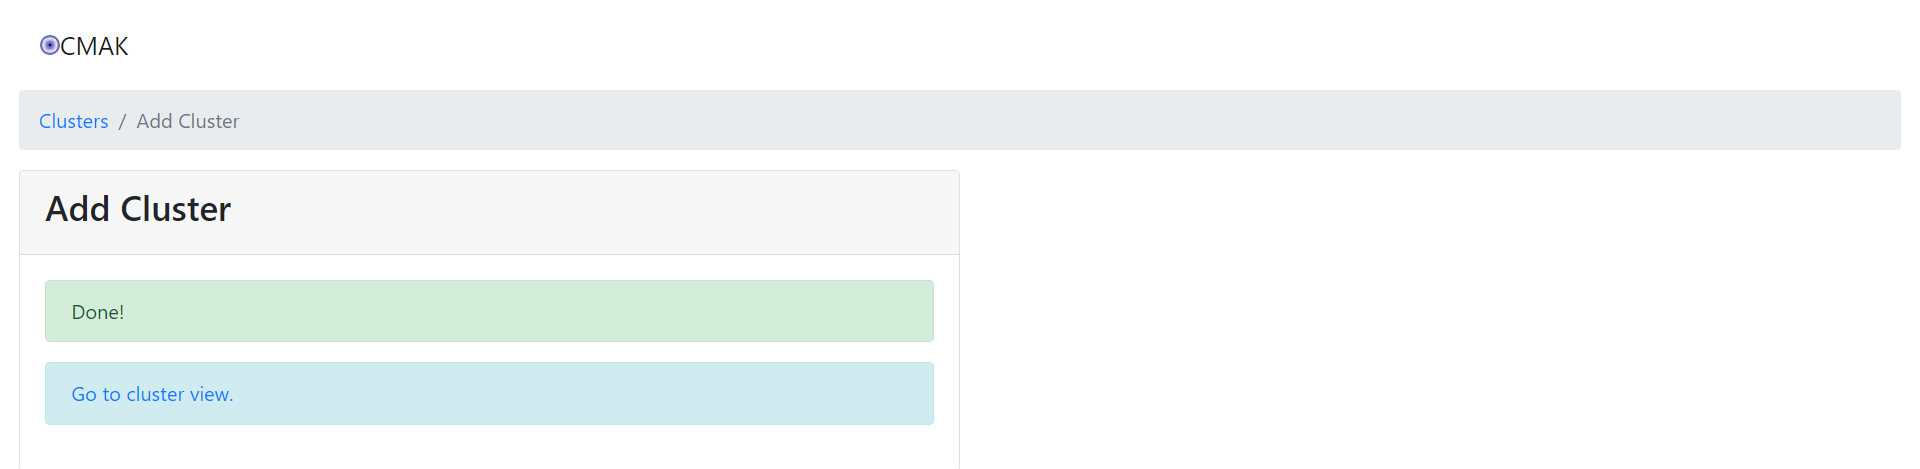
10、查看消費組中的消息堆積情況
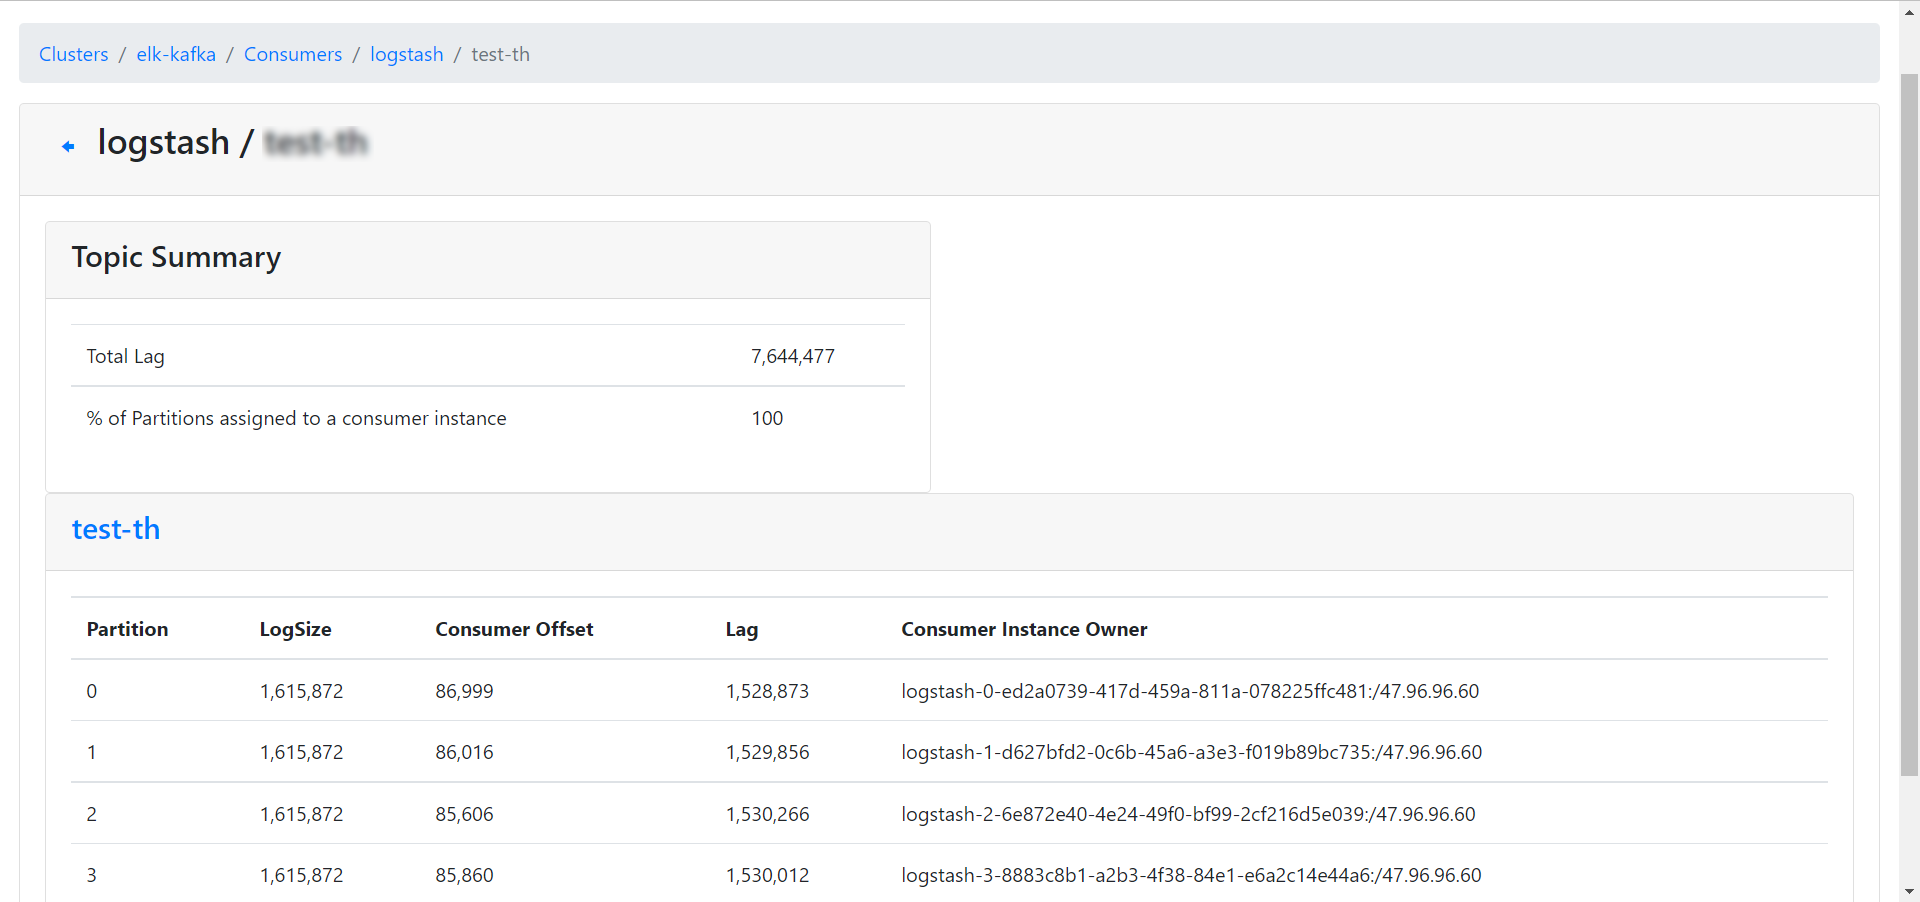
- LogSize,當前隊列大小偏移值。
- Consumer Offset,當前消費消息的偏移值。
- Lag,滯後的消息數量。