全鏈路數據血緣在滿幫的實踐
摘要:全鏈路數據血緣,指在數據的全生命周期內,數據與數據之間會形成各式各樣的關係,貫穿整個數據鏈路中。
本文分享自華為雲社區《全鏈路數據血緣在滿幫的實踐》,作者: 你好_TT。
什麼是全鏈路數據血緣
根據維基百科定義,數據血緣(Data Lineage)又叫做數據起源(Data Provenance)或者數據家譜(Data Pedigree)。其通常被定義為一種生命周期,主要包含數據的來源以及數據隨時間移動的位置。
數據血緣是數據資產的重要組成部分,用於分析表和欄位從數據源到當前表的血緣路徑,以及血緣欄位之間存在的關係是否滿足,並關注數據一致性以及表設計的合理。它描述了數據從收集,生產到服務的全鏈路的變化和存在形式。
全鏈路數據血緣,指在數據的全生命周期內,數據與數據之間會形成各式各樣的關係,貫穿整個數據鏈路中,如圖1所示。

圖1 全鏈路數據血緣
血緣構建方案調研
血緣解析
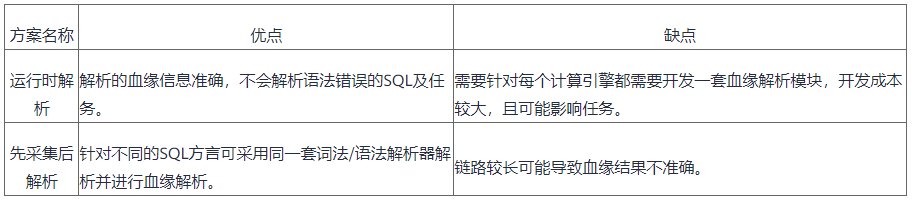
當前,數據血緣大多是對SQL語句進行解析,以發現上下游調用棧等資訊。主流方案可分為兩種:
- 運行時解析,即在任務運行時通過hook介面或者listener介面對SQL生成的邏輯技術樹(AST)進行解析。
- 先採集後解析,即通過採集程式把各個計算引擎的SQL統一採集到mq進行血緣解析。
上述兩類方案各有優劣,其對比如表1所示。
表1 數據血緣解析方案
血緣存儲
相比傳統關係型資料庫和ES等工具,圖資料庫在血緣資訊的查詢與分析方面具有如下優勢:
1、對複雜關係的存儲和分析更優
數據血緣刻畫了數據的完整生命周期,具有數據鏈路長的特點。傳統關係型資料庫和ES等,往往只能反映當前狀態或較短路徑內的狀態,在長鏈路血緣的檢索中存在明顯劣勢。而圖資料庫進行了複雜關係的有效組織,通過點邊結構將血緣的上下游進行了完美串聯,進而可實現更長鏈路血緣的存儲、檢索和分析。
2、能夠有效利用數據間的關聯性達成更精準可靠的決策
圖結構特徵對業務具有重要的指導意義。例如,圖的稠密程度可反映業務數據關聯的緊密程度,進而有助於識別高I/O或高吞吐量業務,識別鏈路瓶頸;圖數據間的共現性可反映出血緣中的共生關係,進行輔助進行血緣重要性劃分;圖可視化有助於幫助業務人員更清晰的了解血緣動態等。
相比開源圖資料庫Neo4j、Nebula Graph,華為雲GES具有如下優勢:
- 基於分散式記憶體計算,性能更高,速度更快,響應時間更短
- 集成30+高性能演算法,圖分析能力更強
- 對接華為雲大數據、AI服務,周邊支援更全面,服務對接更便利
- 基於實踐自研了查詢運算元Path-Query,支援複雜過濾查詢條件,且具備更優的查詢性能
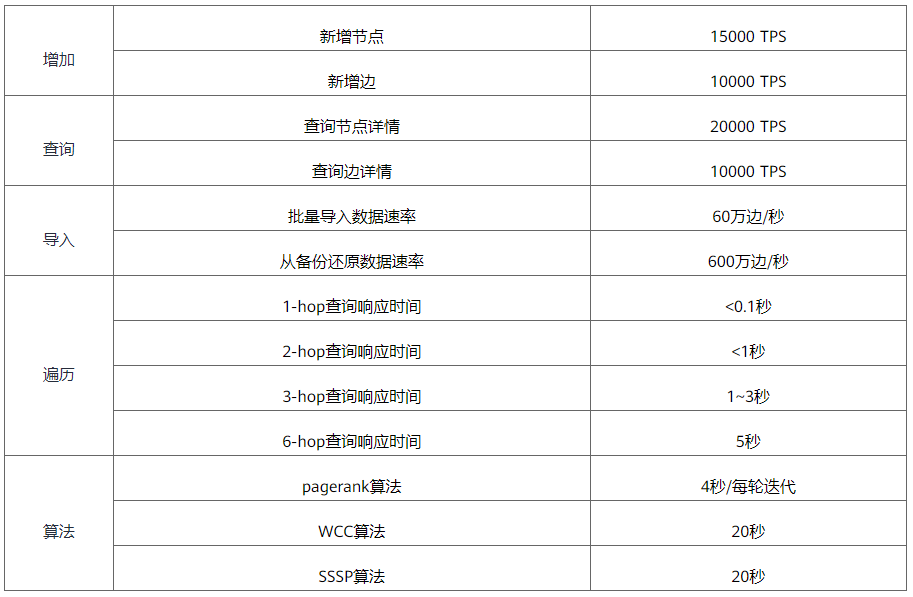
華為雲GES的基準測試數據如表2所示。
表2 華為雲GES的基準測試數據
滿幫數據血緣的實踐
滿幫數據血緣特點
滿幫數據血緣具備如下幾個特點:
- 採集覆蓋範圍廣。目前已覆蓋滿幫離線和實時絕大部分場景,涉及的組件有hive、spark、impala、flink、doris、kafka、clickhouse等。
- 多層次的血緣關係。根據血緣模型和血緣數據,形成了欄位與欄位、欄位與表、表與表、庫與庫、任務與任務等血緣關係,應用於不同的場景中。
- 豐富的應用場景。目前已應用於數據治理、數據品質、數據安全、應用告警等各個場景。
- 開放的血緣介面。目前基於血緣服務平台,對外提供了豐富的血緣介面,包括基礎的血緣資訊查詢和基於各種演算法的血緣路徑查詢。
數據血緣模型
定義豐富的血緣模型,有助於更真實有效的展示血緣關係。滿幫血緣模型主要包括實體和關係,其中,實體主要涵蓋了任務、庫、表、視圖、欄位、函數和其他實體。實體和關係的組合顯示了從一個表/列到其他表/列的血緣,包含表之間的依賴關係 INSERT INTO\CTAS,欄位之間的依賴關係PROJECTION\PREDICATE。
使用完整的數據血緣模型能夠展示血緣全貌,但存在以下問題:一是完整的血緣模型往往包含成千上萬個實體血緣關係,較難在前端展示;二是過量冗餘的資訊可能導致問題實體定位困難。為解決上述問題,滿幫基於數據血緣模型,開發了多個層次的血緣模型,主要包括完整血緣模型和高階血緣模型。完整的數據血緣模型是所有其他高級血緣模型的基礎,而高級血緣模型通過省略或聚合模型中的某些關係和實體對完整血緣進行了放縮操作。在實際業務中,可使用完整的血緣模型展示SQL查詢中數據是如何傳輸的,而表級數據的流動可通過高級血緣模型進行呈現。
整體架構方案
滿幫全鏈路數據血緣,實現了血緣數據數據採集開始到最終數據服務整個鏈路的貫穿,有助於高效地實現問題的快速定位以及影響面的快速評估。全鏈路血緣架構如圖2所示,主要包含5層:
- 血緣採集層:負責採集滿幫大數據平台各組件的任務血緣資訊,將血緣解析為統一格式;
- 血緣處理層:通過消息隊列Kafka,通過實時任務將血緣資訊統一處理並寫入GES和Hive,並提供血緣存儲介面和血緣管理功能;
- 血緣存儲層:通過GES和Hive分別提供血緣關係資訊存儲和血緣分析統計功能;
- 血緣介面層:提供血緣資訊功能介面,對接血緣應用服務;
- 血緣應用層:提供血緣服務,包括數據資產,數據治理,數據安全等。
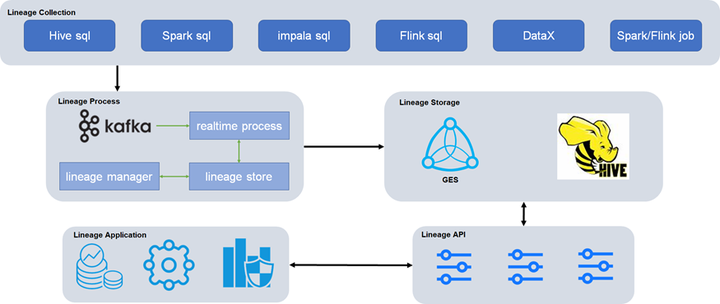
圖2 滿幫全鏈路血緣架構
血緣採集層
滿幫血緣採集層當前已覆蓋了滿幫內部擼數、離線調度、實時計算等平台的SQL任務和Spark\Flink任務。血緣關係包含了系統血緣關係、作業血緣關係、庫血緣關係、表級血緣關係和欄位血緣關係,其指向數據的上游來源,向上游追根溯源。通過血緣關係能清晰展現數據加工處理邏輯脈絡,快速定位數據異常欄位影響範圍,準確圈定最小範圍數據回溯,降低了理解數據和解決數據問題的成本。具體為:
- Hive SQL血緣解析主要參考org.apache.hadoop.hive.ql.hooks.LineageLogger通過Hive hook函數解析。
- Spark SQL是通過QueryExecutionListener的onSuccess方法來獲取邏輯計劃的Output,通過Output解析出欄位血緣關係。
- Flink SQL通過Cava cc來獲取SQL的邏輯計劃樹(AST),通過遍歷AST來獲取執行Input\Output,從而解析出表、欄位血緣關係。
- Spark\Flink任務通過分析DAG中關係,找出Input\Output,構建虛擬的輸入輸出表來構建血緣關係。
- Impala目前採用filebeat採集血緣日誌,非同步發送血緣資訊到Kafak。
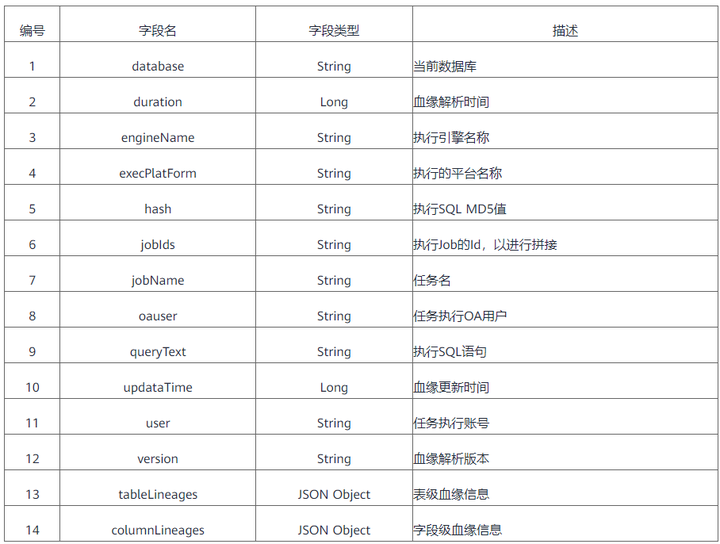
為了便於數據血緣的採集和處理,統一了各個組件的血緣格式,主要包含輸入輸出表、欄位等資訊。
血緣處理層
血緣處理層主要由血緣實時處理模組、血緣存儲介面模組、血緣管理模組組成。
為了滿足近實時的血緣查詢需求,滿幫採用了Flink作為血緣實時處理模組的核心組件,通過實時分析處理上游採集到的血緣資訊,快速的寫入到圖資料庫和Hive中。該模組支援批量刪除\查詢\更新以及模糊刪除\查詢\更新等功能。
血緣存儲介面模組主要開發快速寫入圖資料庫及Hive的相關介面。
血緣管理模組主要用於維護管理及統計分析血緣資訊。
血緣存儲層
血緣存儲層選用了華為雲圖引擎GES服務作為存儲引擎。GES使用華為自研的EYWA內核,是針對以「關係」為基礎的「圖」結構數據,進行查詢、分析的服務。GES目前提供豐富多樣的原生介面,包括批量讀寫點、邊以及各個路徑查詢演算法。
在滿幫全鏈路數據血緣場景中,對圖數據操作主要包括讀和寫操作兩塊。寫操作主要是將解析格式化好的血緣數據實時寫入圖資料庫。另一塊寫操作主要給應用方提供寫的請求,如表\欄位安全等級打標。讀操作主要是來源自滿幫內部各個應用場景,主要涵蓋了短途、CRM、客服、金融。
血緣介面層及血緣應用層
血緣介面層主要對接血緣應用層各個服務,通過開放血緣RPC介面,給各個應用服務提供豐富的介面選擇。
目前,滿幫血緣資訊主要用於數據資產、數據治理、數據安全、數據品質等各個場景。
1、數據資產
滿幫數據資產管理平台提供資產全景、數據地圖,數據品質,數據安全等功能,如圖4所示。數據地圖支援以扇形圖及圖表的形式進行可視化展示各類數據資產的佔比,通過不同層次的圖形展現粒度控制,滿足業務上不同應用場景的數據查詢和輔助分析需要。
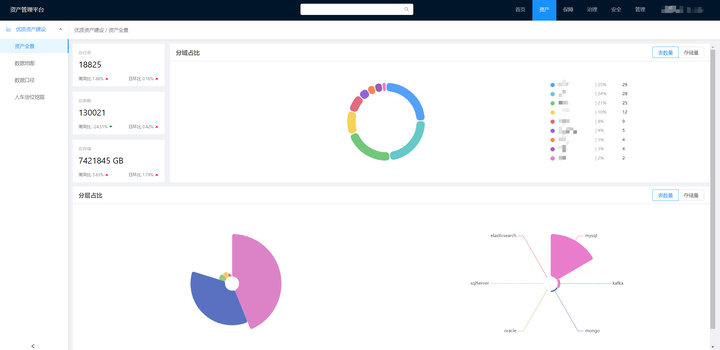
圖4 滿幫數據資產管理平台
數據地圖還支援血緣資訊的展示,用以分析數據在任務間的流向,如圖5所示。目前數據地圖支援任務、庫、表、欄位級血緣關係的展示。
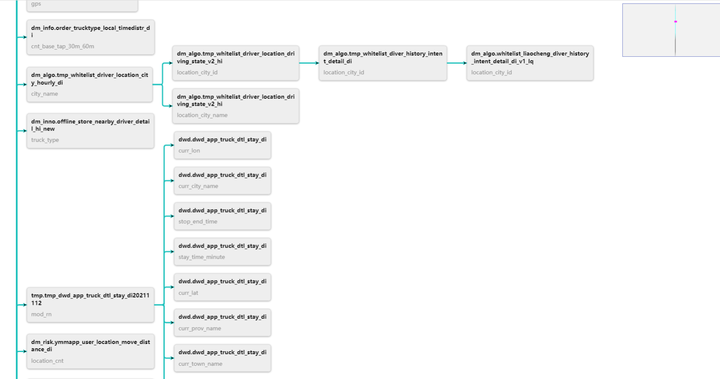
圖5 滿幫數據地圖
2、數據治理
數據治理是指在數據的全生命周期內,對其進行管理的原則性方法,其目標是為了確保數據的安全、及時、準確、可用和易用。滿幫數據治理主要圍繞「指標清晰,品質規範」「資源合理,厲行節約」原則開展。
如圖6所示,滿幫數據治理任務通過分析庫、表、欄位的血緣資訊,從價值密度、訪問頻次、使用方式、時效性等級等維度評估,從而評級出數據熱度,熱數據、溫數據、冷數據和冰數據。通過血緣資訊查看離線數倉某個任務鏈路的上下游任務依賴,可同時分析鏈路上表的使用冷熱程度,優化ods、dwd上相關任務和SQL,裁剪合併低價值表,縮短數據流ETL鏈路,從而降低維護成本,提升數據價值。
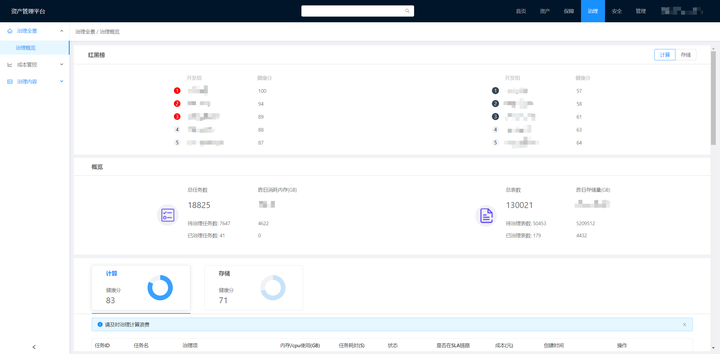
圖6 滿幫數據治理
3、數據品質
數據品質,旨在實現高效監控每一類作業的運行狀態,洞察關鍵資訊,形成事前預判、事中監控、事後跟蹤的品質管理閉環流程。在滿幫數據品質監管平台建設中,面臨如下幾個問題:
- 離線實時監控體系不完善,監控有盲點
- 全鏈路難以保障數據品質,數據不可信
- 數據依賴複雜,鏈路深,數據產出易延遲
針對上述問題,滿幫基於全鏈路數據血緣,從如下幾方面提升數據全生命周期內的數據品質:
- 流量數據owner主動通知,根據血緣關係,通知有調度依賴的任務,提供多層通知選項,以避免過渡干擾。
- 離線ETL鏈路,若ods\dwd層的某個表的關鍵欄位發生修改變更,通過血緣資訊,自動發告警給下游依賴表、任務負責人
- 實時Flink任務,若source端Kafka欄位結構發生變更,根據血緣關係,自動通知下游依賴表及任務負責人
4、數據安全
隨著國家對數據流通過程中數據的安全越來越重視,若沒有有效識別安全級別高的數據,可能產生安全合規風險。因此,滿幫上線了資產安全打標平台,支援通過「自動化+手動」打標實現資產安全定級打標,但存在打標覆蓋率不高,精準度較低等問題。
基於全鏈路血緣關係,可根據不同數據安全級別,先利用血緣打標介面對不同表欄位進行打標,然後識別出打標欄位的上下游血緣關係,進而自動打上安全等級標籤。如圖7所示,通過血緣打標平台給欄位city_name安全打標,定級為L3,根據血緣關係將自動給下游血緣鏈路的欄位進行染色打標,實現自動「染色」。
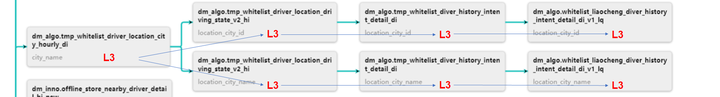
圖7 數據安全
未來展望
經過探索實踐,滿幫基於圖資料庫相關技術已基本實現全鏈路數據血緣建設,取得了一定成效。未來,將在如下方面進行更深層次的探索,實現業務進一步提升:
1、目前,血緣採集主要通過SQL、任務自動解析和人工整理的方式提高血緣覆蓋率,目前覆蓋率已達到95%以上。未來將探索使用人工智慧相關方法,基於數據集之間的依賴關係計算數據相似性,以提升覆蓋率。
2、Impala血緣採集方式鏈路較長,且依賴Filebeat。後續將逐步對接使用SQL語法解析AST的方案,實現解析歸一化。
3、目前血緣關係維度還不支援函數級別。
4、開發全鏈路血緣開放平台,快速對接應用方,為應用方提供血緣服務。
參考
[1] //en.wikipedia.org/wiki/Data_lineage
[2] //zhuanlan.zhihu.com/p/408737398
[3] //www.infoq.cn/article/fov6aewrgnofhd91yvcr
