🏆【Alibaba中間件技術系列】「Sentinel技術專題」分散式系統的流量防衛兵的基本介紹(入門源碼介紹)
- 2021 年 12 月 7 日
- 筆記
- 【技術專區-Alibaba】
推薦資料
Sentinel 是什麼?
隨著微服務的流行,服務和服務之間的穩定性變得越來越重要。Sentinel 以流量為切入點,從流量控制、熔斷降級、系統負載保護等多個維度保護服務的穩定性。
Sentinel 具有以下特徵:
豐富的應用場景:Sentinel 承接了阿里巴巴近 10 年的雙十一大促流量的核心場景,例如秒殺(即突發流量控制在系統容量可以承受的範圍)、消息削峰填谷、集群流量控制、實時熔斷下游不可用應用等。
完備的實時監控:Sentinel 同時提供實時的監控功能。您可以在控制台中看到接入應用的單台機器秒級數據,甚至 500 台以下規模的集群的匯總運行情況。
廣泛的開源生態:Sentinel 提供開箱即用的與其它開源框架/庫的整合模組,例如與 Spring Cloud、Apache Dubbo、gRPC、Quarkus 的整合。您只需要引入相應的依賴並進行簡單的配置即可快速地接入 Sentinel。同時 Sentinel 提供 Java/Go/C++ 等多語言的原生實現。
完善的 SPI 擴展機制:Sentinel 提供簡單易用、完善的 SPI 擴展介面。您可以通過實現擴展介面來快速地訂製邏輯。例如訂製規則管理、適配動態數據源等。
Maven的pom中配置
<dependency>
    <groupId>com.alibaba.csp</groupId>
    <artifactId>sentinel-core</artifactId>
    <version>x.y.z</version>
</dependency>
main函數
public class Demo {
    public static void main(String[] args) throws InterruptedException {
        initFlowRules();
        while (true) {
            Thread.sleep(10);
            Entry entry = null;
            try {
                entry = SphU.entry("HelloWorld");
                /*您的業務邏輯 - 開始*/
                System.out.println("hello world");
                /*您的業務邏輯 - 結束*/
            } catch (BlockException e1) {
                /*流控邏輯處理 - 開始*/
                System.out.println("block!");
                /*流控邏輯處理 - 結束*/
            } finally {
                if (entry != null) {
                    entry.exit();
                }
            }
        }
    }

    private static void initFlowRules(){
        List<FlowRule> rules = new ArrayList<>();
        FlowRule rule = new FlowRule();
        rule.setResource("HelloWorld");
        rule.setGrade(RuleConstant.FLOW_GRADE_QPS);
        // Set limit QPS to 20.
        rule.setCount(20);
        rules.add(rule);
        FlowRuleManager.loadRules(rules);
    }
}
介紹總結說明
- 當出現被阻塞和限流的情況會出現輸出進入BlockException區域
- 沒有被限流的場景會出現直接執行相關的操作業務邏輯。
自定義的rule
從demo中看,是由FlowRuleManager把規則load進來的:
FlowRuleManager.loadRules(rules);
點進去看,應該是註冊了一堆listener然後告知他們配置有更新
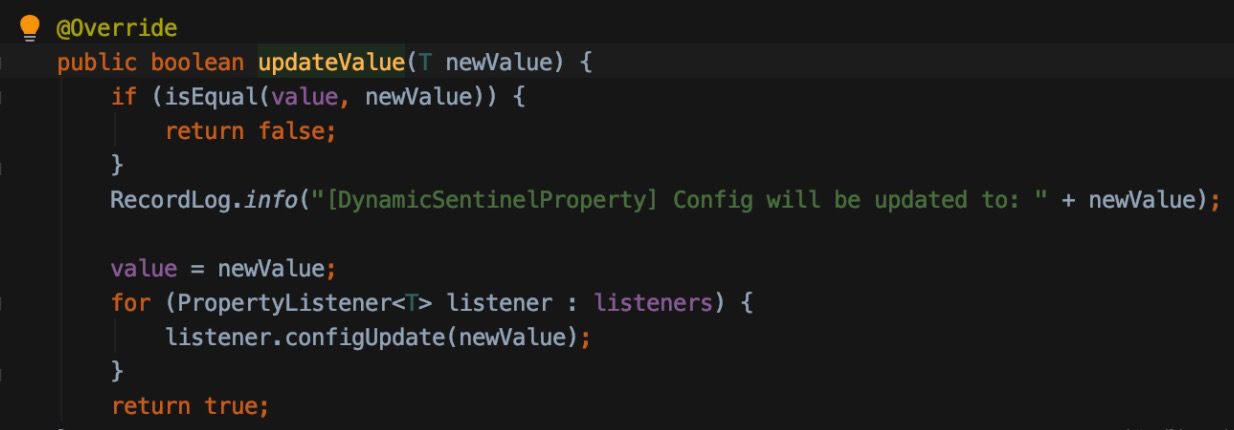
載入規則
demo中是通過新建
entry = SphU.entry(「HelloWorld」);
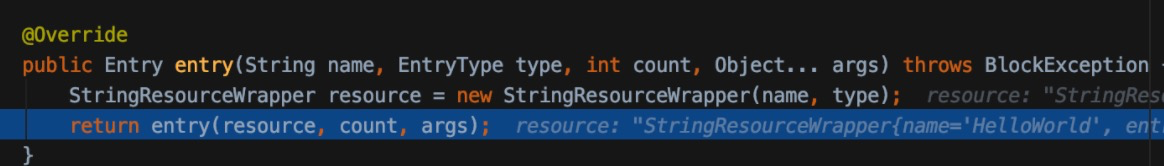
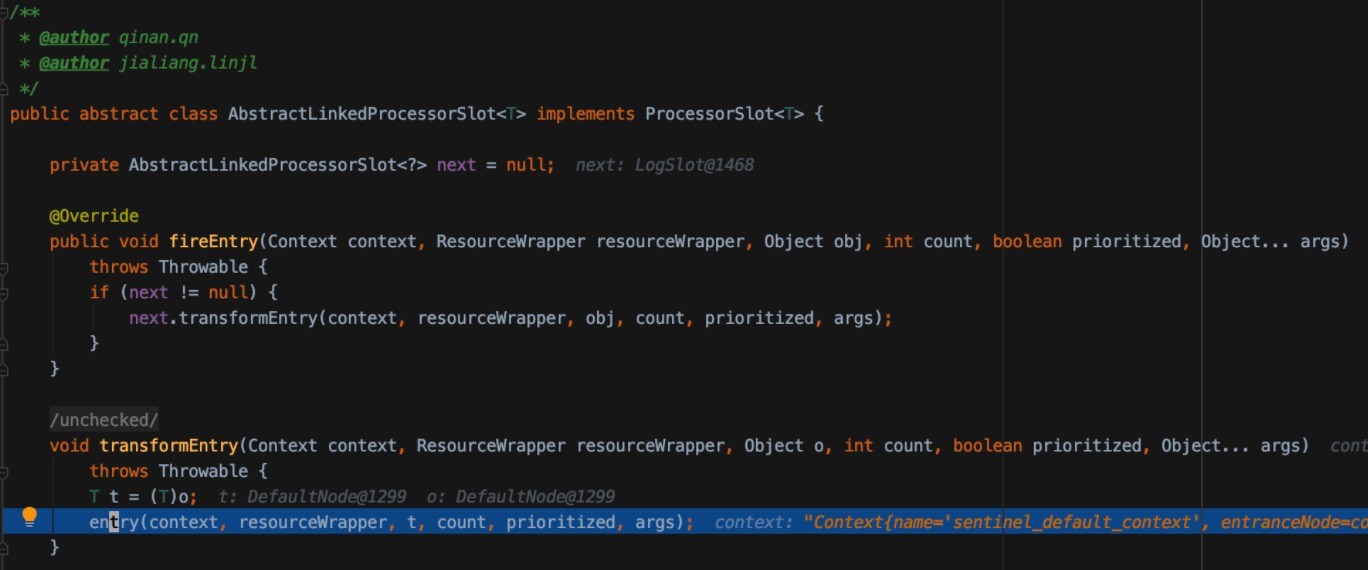
對資源名稱「HelloWorld」包裝了一下,然後跳進這個entry函數
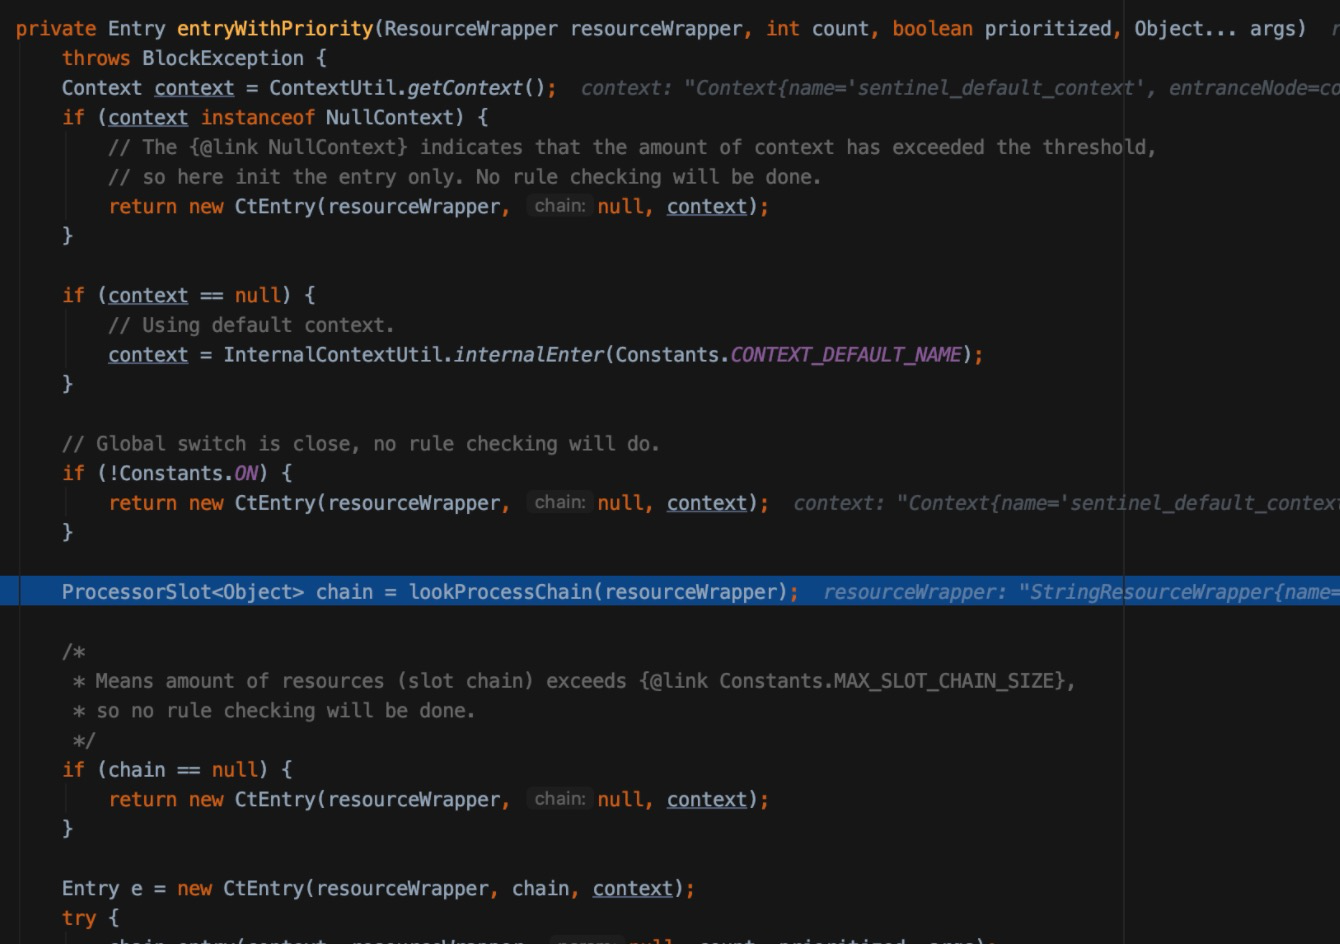
找一下處理鏈(責任鏈模式),這裡是DefaultProcessorSlotChain,然後chain.entry再跳進去:
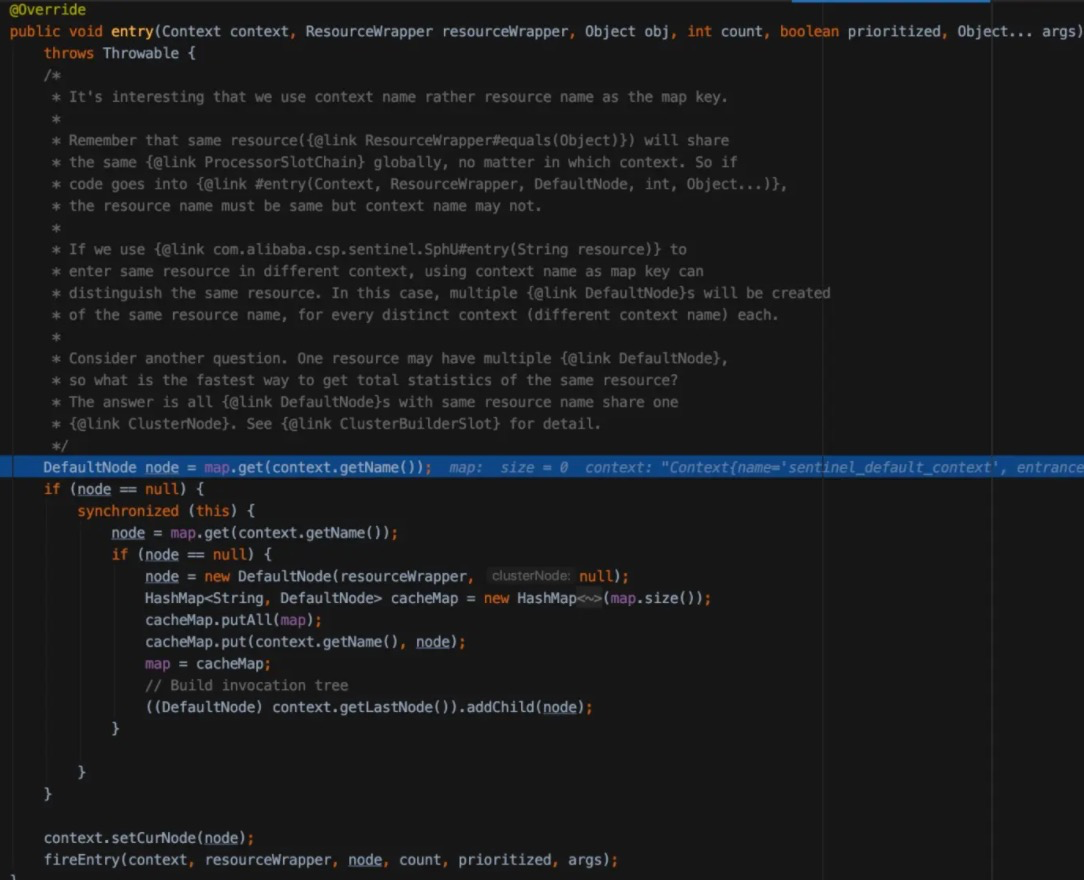
用context的名字而不是resource的名字作為key去查規則。
在這個最簡單的demo里,沒有context只有resource。所以以resource的名字作為key去查。發現也是null,然後創建了一個DefaultNode,然後把這個新的node放進去map里了。然後走到最後一行,最後調了SPI了,會在每個SPI的責任鏈里做不同的處理
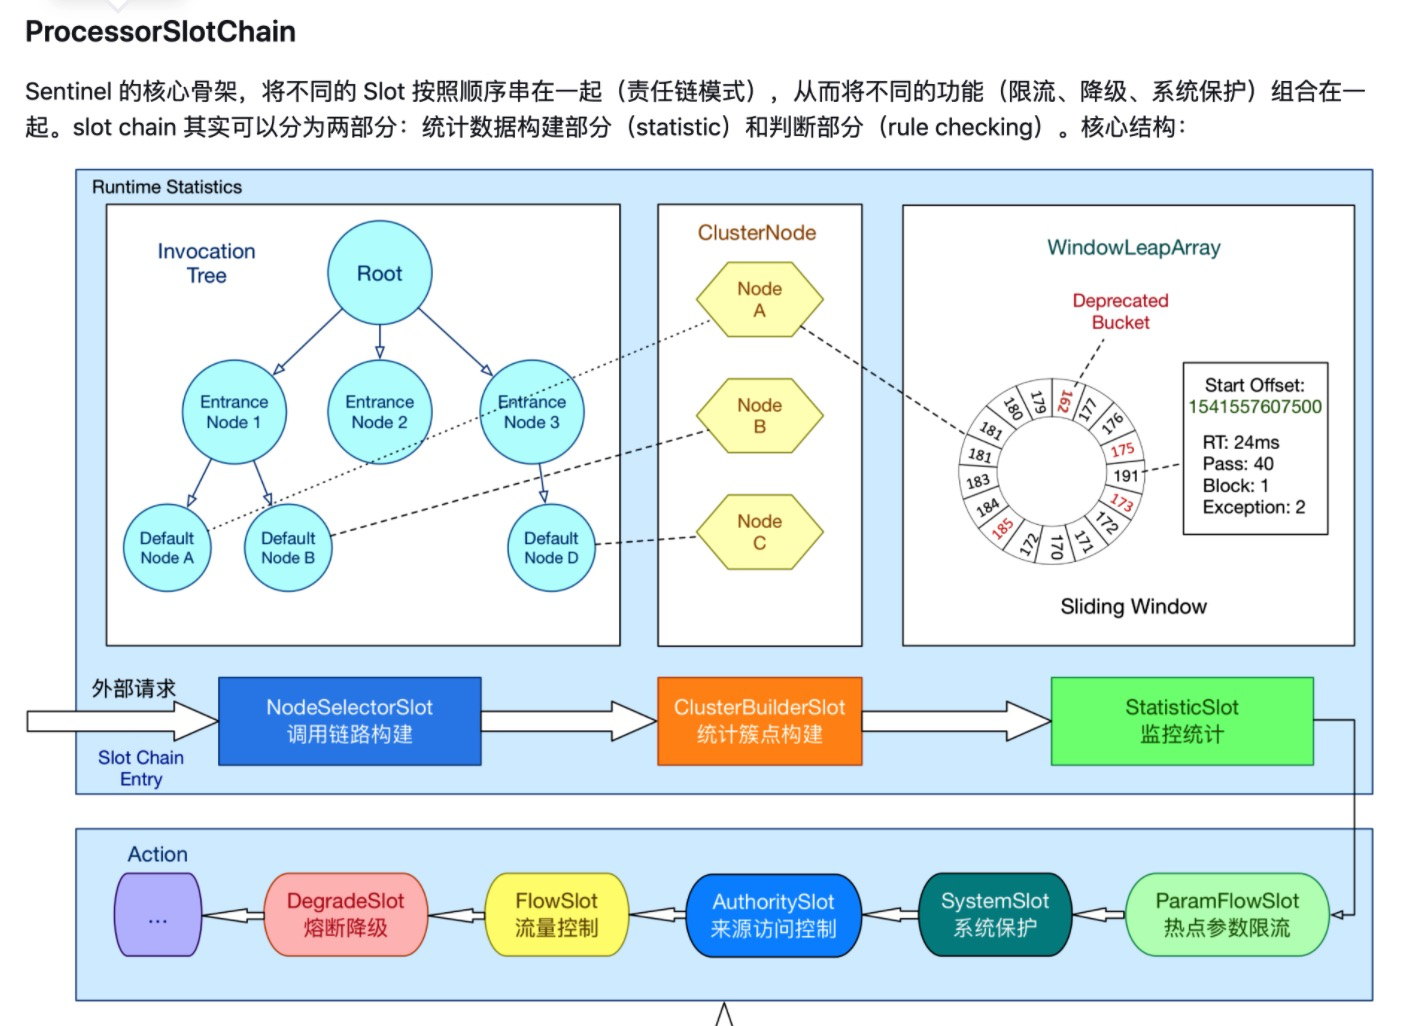
在 Sentinel 裡面,所有的資源都對應一個資源名稱(resourceName),每次資源調用都會創建一個 Entry 對象。Entry 可以通過對主流框架的適配自動創建,也可以通過註解的方式或調用 SphU API 顯式創建。Entry 創建的時候,同時也會創建一系列功能插槽(slot chain),這些插槽有不同的職責,例如:
- NodeSelectorSlot 負責收集資源的路徑,並將這些資源的調用路徑,以樹狀結構存儲起來,用於根據調用路徑來限流降級;
- ClusterBuilderSlot 則用於存儲資源的統計資訊以及調用者資訊,例如該資源的 RT, QPS, thread count 等等,這些資訊將用作為多維度限流,降級的依據;
- StatisticSlot 則用於記錄、統計不同緯度的 runtime 指標監控資訊;
- FlowSlot 則用於根據預設的限流規則以及前面 slot 統計的狀態,來進行流量控制;
- AuthoritySlot 則根據配置的黑白名單和調用來源資訊,來做黑白名單控制;
- DegradeSlot 則通過統計資訊以及預設的規則,來做熔斷降級;
- SystemSlot 則通過系統的狀態,例如 load1 等,來控制總的入口流量;
總體的框架如下:
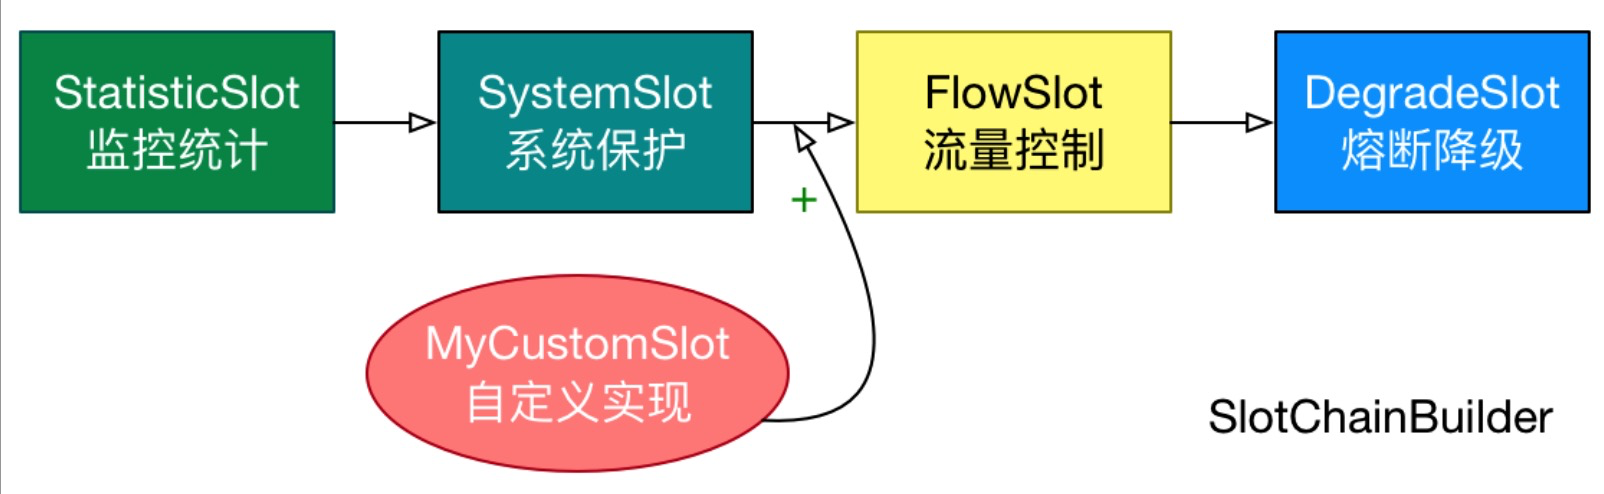
Sentinel 將 ProcessorSlot 作為 SPI 介面進行擴展(1.7.2 版本以前 SlotChainBuilder 作為 SPI),使得 Slot Chain 具備了擴展的能力。您可以自行加入自定義的 slot 並編排 slot 間的順序,從而可以給 Sentinel 添加自定義的功能。
Sentinel的限流原理
限流效果,對應有DefaultController快速失敗
- WarmUpController慢啟動(令牌桶演算法)
- RateLimiterController(漏桶演算法)
滑動時間窗口演算法
固定時間窗口演算法
即比如每一秒作為一個固定的時間窗口,在一秒內最多可以通過100個請求,那麼在統計數據的時候,如果0-500ms沒有請求,而500-1000ms有100個請求,那麼這一百個請求都能通過,在1000-1500ms的時候,又有100個請求過來了,它依然能夠通過,因為在1000ms的時候又開啟了一個新的固定時間窗口。
500-1500ms這一秒內有了200個請求,但是它依然能夠通過,所以這就會造成數據統計的不準確性,並不能保證在任意的一秒內都使得通過請求數小於100。
普通的滑動窗口做法
因為固定時間窗口帶來的數據同的不準確性,就會造成可能局部的時間壓力過高,所以就需要採用滑動窗口演算法來進行統計,滑動窗口時間演算法意思就是,從請求過來的時刻開始,統計往前一秒中的數據,通過這個數據來判斷是否進行限流等操作。
準確性就會有很大的提升,但是由於每一次請求過來都需要重新統計前一秒的數據,就會造成巨大的性能損失。所以這也是他的不合理的地方。
由於固定時間窗口帶來的不準確性和普通滑動窗口帶來的性能損失的缺點,所以Sentinel對這兩種方案採取了折中的方案。
Sentinel的滑動時間窗口演算法
在Sentinel中會將原本的固定的時間窗口劃分成很多更小的樣本窗口,每一次請求的數據都會被保存在小的樣本窗口中去,而每一次獲取的時候都會去獲取這些樣本時間窗口中的數據,從而不需要進行重新統計,就減小了性能損耗,同時時間窗口被細粒度化了,不準確性也會降低很多。
在統計插槽StatisticsSlot類中有ArrayMetric的類的成員變數,用於統操作和獲取統計數據,而ArrayMetric類有一個成員變數LeapArray data,並提供了一些操作這個成員變數data資訊的方法。
LeapArray提供兩個參數sampleCount樣本數量,intervalInMs 間隔時間,意思就是在這一段的間隔時間內,被分成了sampleCount個樣本去分別進行統計,默認間隔時間是1s,sampleCount是2。
下面看看LeapArray的一部分源碼,它也是實現滑動窗口最為重要的地方。
public abstract class LeapArray<T> {
    //每一個樣本窗口的時間長度
    protected int windowLengthInMs;
    //一個滑動窗口被劃分成了多少個樣本
    protected int sampleCount;
    //時間窗口的時間長度
    protected int intervalInMs;
    private double intervalInSecond;
    //一個樣本窗口數組,將一個滑動窗口劃分為sampleCount個樣本窗口的數組
    protected final AtomicReferenceArray<WindowWrap<T>> array;
    //部分程式碼省略
}
在LeapArray有這幾個成員變數:
- 每一個樣本窗口的時間長度
- 一個滑動窗口被劃分成的樣本數量
- 滑動時間窗口的時間長度
- 樣本窗口數組
    public WindowWrap<T> currentWindow(long timeMillis) {
        if (timeMillis < 0) {
            return null;
        }
        //計算當前樣本窗口的在array中的索引,以當前時間除以樣本時間長度,獲得timeId
        //再將TimeId對數組長度取余,得到索引,這就相當於把array當做了一個樣本窗口圓環,就像官網上的圖一樣
        int idx = calculateTimeIdx(timeMillis);
        // 計算當前時間的樣本窗口的開始時間
        long windowStart = calculateWindowStart(timeMillis);
        while (true) {
            WindowWrap<T> old = array.get(idx);
            if (old == null) {
            //如果原來這個位置的樣本窗口就是null的,就說明以前還沒有網array的這個位置放過樣本窗口,
            // 這時就新建一個樣本窗口用cas操作放到數組的這個位置,並返回該窗口
                WindowWrap<T> window = new WindowWrap<T>(windowLengthInMs, windowStart, newEmptyBucket(timeMillis));
                if (array.compareAndSet(idx, null, window)) {
                    // Successfully updated, return the created bucket.
                    return window;
                } else {
                    // Contention failed, the thread will yield its time slice to wait for bucket available.
                    Thread.yield();
                }
            } else if (windowStart == old.windowStart()) {
                //如果計算出來的窗口開始時間和現在存在的這個串口開始時間是一樣的,就說明目前正處於這個樣本窗口的時間內
                //直接返回當前樣本窗口
                return old;
            } else if (windowStart > old.windowStart()) {
                //如果計算出來的窗口開始時間大於現在存在的樣本窗口開始時間,就說明現存的樣本窗口已經過時了
                //這邊相當於在array數組圓環上不斷旋轉著設置新的樣本窗口,要去生成新的樣本窗口把以前的老的給覆蓋了
                if (updateLock.tryLock()) {
                    try {
                        // 獲取到鎖,再去覆蓋樣本窗口,防止並發更新問題
                        return resetWindowTo(old, windowStart);
                    } finally {
                        updateLock.unlock();
                    }
                } else {
                    // 沒有獲取到就讓出cpu一小段時間再回去重新嘗試獲取鎖
                    Thread.yield();
                }
            } else if (windowStart < old.windowStart()) {
                // Should not go through here, as the provided time is already behind.
                return new WindowWrap<T>(windowLengthInMs, windowStart, newEmptyBucket(timeMillis));
            }
        }
    }
LeapArray中有一個currentWindow方法,用於獲取當前樣本窗口,它的邏輯是這樣的:
-
計算當前樣本窗口的在array中的索引,以當前時間除以樣本時間長度,獲得timeId。
-
再將TimeId對數組長度取余,得到索引,這就相當於把array當做了一個樣本窗口圓環,就像官網上的圖一樣,這樣所有的時間窗口都會在這個數組裡進行循環。
-
獲取當前時間所對應的樣本窗口開始時間,與目前數組中的樣本窗口進行比較。
-
如果數組最終該索引不存在樣本窗口,就創建一個樣本窗口放到數組中
-
如果計算出來的窗口開始時間和現在存在的這個串口開始時間是一樣的,就說明目前正處於這個樣本窗口的時間內,直接返回該窗口就好了。
-
如果計算出來的窗口開始時間大於現在存在的樣本窗口開始時間,就說明現存的樣本窗口已經過時了,需要重新覆蓋一個新的樣本窗口。
在LeapArray里,最重要的就是這個樣本窗口數組,它將一個完整的滑動時間窗口劃分成了sampleCount個樣本窗口WindowWrap,而樣本窗口WindowWrap的結構如下:
public class WindowWrap<T> {

    /**
     * Time length of a single window bucket in milliseconds.
     */
    //該樣本窗口的長度
    private final long windowLengthInMs;

    /**
     * Start timestamp of the window in milliseconds.
     */
    //該樣本窗口開始的時間
    private long windowStart;

    /**
     * Statistic data.
     */
    //每一個樣本窗口裡統計的數據都存在這兒
    private T value;

    /**
     * 其餘程式碼省略
     */
}
每一個樣本窗口都包含了三個數據:
- 該樣本窗口的時間長度
- 該樣本窗口開始的時間
- 每一個樣本窗口裡統計的數據
這就是滑動窗口的原理,而每次需要對統計數據做操作的時候,就會獲取當前滑動窗口的樣本窗口,並對樣本窗口裡面的數據進行操作。簡單的示範一下調用的一個流程:
首先統計數據,直接可以去看StatisticSlot插槽,因為這個插槽本身就是做這個統計數據相關的事情的
    @Override
    public void entry(Context context, ResourceWrapper resourceWrapper, DefaultNode node, int count,
                      boolean prioritized, Object... args) throws Throwable {
        try {
            // Do some checking.
            //會一層一層的去執行完所有的slot規則檢查
            fireEntry(context, resourceWrapper, node, count, prioritized, args);
            // Request passed, add thread count and pass count.
            //如果到這裡了就說明規則檢查圈通過了,可以做成功的統計了
            //添加成功的執行緒數
            node.increaseThreadNum();
            //添加成功通過的請求數量
            node.addPassRequest(count);
            if (context.getCurEntry().getOriginNode() != null) {
                // Add count for origin node.
                context.getCurEntry().getOriginNode().increaseThreadNum();
                context.getCurEntry().getOriginNode().addPassRequest(count);
            }
            if (resourceWrapper.getEntryType() == EntryType.IN) {
                // Add count for global inbound entry node for global statistics.
                //一個資源對應一個ClusterNode,給他添加全局的統計
                Constants.ENTRY_NODE.increaseThreadNum();
                Constants.ENTRY_NODE.addPassRequest(count);
            }

            // Handle pass event with registered entry callback handlers.
            for (ProcessorSlotEntryCallback<DefaultNode> handler : StatisticSlotCallbackRegistry.getEntryCallbacks()) {
                handler.onPass(context, resourceWrapper, node, count, args);
            }
        } catch (PriorityWaitException ex) {
            node.increaseThreadNum();
            if (context.getCurEntry().getOriginNode() != null) {
                // Add count for origin node.
                context.getCurEntry().getOriginNode().increaseThreadNum();
            }
            if (resourceWrapper.getEntryType() == EntryType.IN) {
                // Add count for global inbound entry node for global statistics.
                Constants.ENTRY_NODE.increaseThreadNum();
            }
            // Handle pass event with registered entry callback handlers.
            for (ProcessorSlotEntryCallback<DefaultNode> handler : StatisticSlotCallbackRegistry.getEntryCallbacks()) {
                handler.onPass(context, resourceWrapper, node, count, args);
            }
        } catch (BlockException e) {
            //添加被Block的執行緒和請求數量的相關統計
            context.getCurEntry().setBlockError(e);
            // 添加被阻塞數量
            node.increaseBlockQps(count);
            if (context.getCurEntry().getOriginNode() != null) {
                context.getCurEntry().getOriginNode().increaseBlockQps(count);
            }
            if (resourceWrapper.getEntryType() == EntryType.IN) {
                // Add count for global inbound entry node for global statistics.
                Constants.ENTRY_NODE.increaseBlockQps(count);
            }
            // Handle block event with registered entry callback handlers.
            for (ProcessorSlotEntryCallback<DefaultNode> handler : StatisticSlotCallbackRegistry.getEntryCallbacks()) {
                handler.onBlocked(e, context, resourceWrapper, node, count, args);
            }
            throw e;
        } catch (Throwable e) {
            // Unexpected internal error, set error to current entry.
            context.getCurEntry().setError(e);
            throw e;
        }
    }
在StatisticSlot的Entry方法中,就會添加成功的數量統計,或者根據各種不同的異常,添加不同的數據統計,如請求成功通過的話,就會調用node.addPassRequest(count),而它最後會去調用ArrayMetric類的addPass方法,獲取當前的樣本時間窗口,並在當前的樣本時間窗口上進行數據統計操作。
    @Override
    public void addPass(int count) {
        //獲取當前樣本窗口,在它上面添加一個成功的統計
        WindowWrap<MetricBucket> wrap = data.currentWindow();
        wrap.value().addPass(count);
    }
總結介紹
內部的模組通過責任鏈的設計模式串聯起來,每個模組實現相應的功能。同時每個模組都是通過SPI實現的,我們可以自定義SPI然後插入到處理流程中間。
其中比較重要的模組,StatisticSlot,利用滑動窗口的演算法計算窗口時間內的運行數據(如qps),同時內部使用了高性能的數據結構LeapArray,支援高並發寫多讀少的場景