後綴自動機(SAM)奶媽式教程
後綴自動機(SAM)
為了方便,我們做出如下約定:
-
「後綴自動機」 (Suffix Automaton) 在後文中簡稱為 SAM 。
-
記 \(|S|\) 為字元串 \(S\) 的長度。
-
記 \(\sum\) 為字符集,記 \(|\sum|\) 為字符集大小。
關於 SAM 的複雜度證明在 OI Wiki 上已經很全面了,這裡只是希望可以幫助大家理解 SAM 是如何工作的以及一些應用,對這些不再多做證明。
在前幾個部分中,你只需要跟著筆者給出的構建好的 SAM 圖理解某些定義,不需要知道 SAM 為什麼像這樣。
Part 0 前言
-
馬上就要到聯賽了,想必再去學習新的演算法也已經來不及了吧。
本來以為將近兩年的 OI 生涯可以讓我學到很多,現在看來也不過如此。
既然這樣,不如來一個乾脆漂亮的收場:我決定把它作為我,作為一個 OIer 的最後一篇演算法學習部落格。
它將會是一個大工程。好,我們開始吧——後綴自動機奶媽式教學。
-
筆者認為,OI 是偏向工科的一門學科,比起 「為什麼」 ,我們更傾向於 「怎麼做」 。
譬如一個演算法,我們需要了解它是如何工作的,以及它可以解決什麼樣的問題,而對於它的正確性、時間複雜度的證明往往不太關心。
尤其是對於複雜演算法,我們掌握如何應用它們就足夠了,至於證明,那是數學家的事情,不是嗎?
純粹的 OI ,源於理論,重在應用。
所以在本篇文章中,我們會更加詳細地講解演算法原理,也就是 「源於理論」 。
然後再附加上一些例題以及解題技巧,即:「重在應用」 。
至於時空複雜度的證明等等對於應用沒有太大幫助的點,我們僅僅一提就好。
Part 1 SAM 的定義
在了解 SAM 的功能之前,先看看它的定義吧:
- 字元串 \(S\) 的 SAM 是一個可以接受 \(S\) 的所有後綴的最小 DFA (確定性有限狀態自動機)。
根據自動機理論,把上面那句話翻譯過來就是:
-
SAM 是一張 DAG 。DAG 上的結點被成為 「狀態」 ,而邊被稱為狀態間的 「轉移」 。
-
DAG 存在一個初始結點(狀態) \(P\) ,其他所有結點(狀態)均可從 \(P\) 出發到達。
-
每個邊(轉移)被標記上字符集中的一個字母(類似邊權),從一個結點出發的所有邊(轉移)所標記的字母都不同。
-
存在至少一個 「終止結點(狀態)」 。如果我們從 \(P\) 出發,通過若干次轉移到達了一個終止結點(狀態),則路徑上的所有邊(轉移)所標記的字母連接起來所形成的字元串 \(s\) 必定是字元串 \(S\) 的一個後綴。反之,字元串 \(S\) 的每一個後綴均可以表示成 DAG 中一條從 \(P\) 出發到某個終止結點(狀態)的路徑。
-
在所有滿足上述條件的自動機中, SAM 的結點數是最少的(空間最優秀)。
Part 2 SAM 的常用功能
作為一個 DFA ,它可以接受一個字元串所有的後綴。這是顯然的,不過它不僅僅是這樣。
SAM 最常用的功能是儲存一個文本串 \(S\) 的每一個子串,這也是我們在題目主要需要利用的性質。
值得注意的是,對於長度為 \(O(n)\) 的字元串 \(S\), SAM 可以在在 \(O(n)\) 的空間內儲存 \(S\) 所有子串的資訊,另外,構造 SAM 的演算法的時間複雜度僅為 \(O(n)\) 。
總結一下,SAM 最主要的功能之一就是在線性時空內儲存一個字元串的所有子串資訊。
壓縮子串資訊
- SAM 包含了字元串 \(S\) 的所有子串。
上面提到過這個性質,原理很簡單,既然每個後綴對應了 DAG 上的一條路徑,那麼考慮沿著某一個後綴 \(s\) 對應的路徑走 \(x\) 條邊。
設走過的這 \(x\) 條邊所標記的字元順次連接構成了字元串 \(s'\) 。顯然如果我們要把 \(s'\) 變成原串的一個後綴 \(s\) ,需要繼續沿著這條路徑走完剩下的邊,並把這條邊所標記的字元添加到 \(s'\) 的末尾,直到碰到了這條路徑對應的終止結點。
這說明什麼?說明 \(s'\) 是 \(s\) 的一個前綴啊!而 SAM 中正好包含了原串的所有後綴,一個字元串的所有後綴的所有前綴顯然是這個字元串的所有子串。
栗子
我們來展示一個簡單字元串的 SAM ,用藍色框起初始結點 \(P\) ,終止結點則用紅色框起。
譬如字元串 \(S=\text{\{「qwqaqwq」\}}\) ,它的 SAM 應該長成這樣子:

比如,我們要給 SAM 一個訊號串 "wqaqwq" ,那麼它會按照如下路徑走:
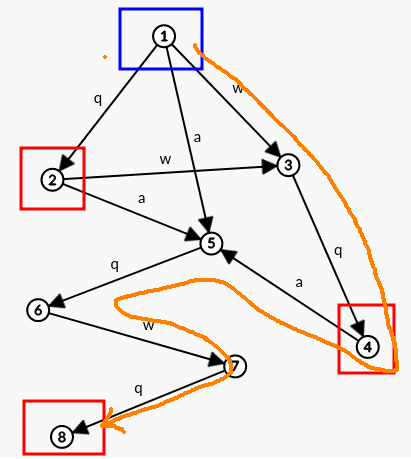
最後走到了終止結點 8 ,這說明 「wqaqwq」 是字元串 "qwqaqwq" 的一個後綴。
如果查詢子串呢?比如分別我們查詢串 「qaq」 和 「qwq」 ,那麼它會這樣走:
(其中藍色表示查詢 "qaq" ,粉色表示查詢 "qwq" 。)
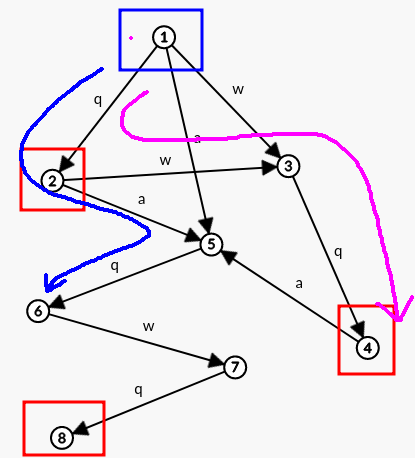
Part 3 後綴樹與後綴鏈接
-
注意此後綴樹非彼 「後綴樹」 !是因為它跳後綴鏈接訪問後綴的性質,導致我喜歡叫它後綴樹。實際上,後綴樹是一種與 SAM 無關的船新數據結構。
我在翻閱大部分的關於 SAM 的資料中,這棵樹被叫做 \(\text{parent}\) 樹(以後當著別人面千萬別說 SAM 里有後綴樹)。
不過我願意怎麼叫就怎麼叫,你打我啊?
細心的同學發現了,上面圖中可以走出 「qwq」 的路徑有兩條:\(5\rightarrow 6\rightarrow 7 \rightarrow 8\) 這條路徑構成的字元串也是 「qwq」 ,究其原因,是因為 「qwq」 在原串中出現了兩次。這說明從 \(P\) 開始的遍歷並不能保證可以找到所有可以形成 「qwq」 的路徑(實際上,根據我們之前的推導,從 \(P\) 出發只能找到 「qwq」 作為某個後綴的前綴出現的情況),也就是會漏掉一些資訊。
所以我們需要引進另一種數據結構——後綴樹(Suffix Tree),來統計所有本質相同子串的資訊。
首先,後綴樹是 SAM 的一部分,它是基於 SAM 構建起來的。SAM 中後綴樹的 DAG 的關係有點像 ACAM 中 失配樹和 Trie 圖的關係。
這部分是 SAM 最難理解的部分,如果描述比較勸退的話,可以手畫一下圖幫助理解,我會盡量多且詳細地說明、配圖、舉例子的。
結束位置 \(\text{endpos}\) 與 \(\text{endpos}\) 等價類
定義與實際意義
考慮字元串 \(S\) 的任意子串 \(s\) ,記 \(\text{endpos}(s)\) 為 \(s\) 在字元串 \(S\) 中每次出現的結束位置(編號從 1 開始),顯然 \(\text{endpos}(s)\) 應該是一個非空集合。
譬如字元串 「abab」
S="abab"
        s =  "a"  "b","ab"  "aba","ba"  "abab","bab"
endpos(s) = {1,3}  {2,4}        {3}          {4}
回到 SAM 的 DAG 上來,我們剛才已經證明過了 「 DAG 中從初始結點 \(P\) 出發,到任意結點 \(x\) 結束的路徑都是原串 \(S\) 的一個子串 \(s\) 」,對吧?那麼假設走到了任意結點 \(x\) ,那麼我們走過的邊所標記的字元會構成一個字元串 \(s\) ,\(s\) 是 \(S\) 的一個子串。 此時 \(\text{endpos}(s)\) 可以告訴我們 \(s\) 在哪裡出現了,以及出現了幾次。譬如我們查詢 \(\text{endpos}('ab')=\text{\{2,4\}}\) (實際上,我們一般把這個 \(\text{endpos}\) 的資訊記錄在結點 \(x\) 里。結點 \(x\) 的 \(\text{endpos}\) 表示從 \(P\) 走到 \(x\) 形成的子串 \(s\) 的 \(\text{endpos}\)),即得到字元 「ab」 出現了兩次,結尾分別為 2 和 4 。這樣解決了 Part 2 最後提出的 「統計相同子串」 的問題。
另外,顯然兩個子串 \(s_1,s_2\) 的 \(\text{endpos}\) 可能相等,即 \(\text{endpos}(s_1)=\text{endpos}(s_2)\) ,譬如上面的 「b」 和 「ab」 兩個字元串的 \(\text{endpos}\) 都是集合 \(\text{\{2,4\}}\) 。這樣,字元串 \(S\) 的所有非空子串 \(s\) 就可以根據它們的 \(\text{endpos}\) 集合被劃分為若干等價類。
-
每個等價類 \(E\) 是一個字元串構成的集合,且對於 \(\forall s_1,s_2\in E\) ,有 \(\text{endpos}(s_1)=\text{endpos}(s_2)\) 。
也就是說,同一個等價類中包含的所有字元串的 \(\text{endpos}\) 相同。
在下面,我們用 \(\text{endpos}(E)\) 代表等價類 \(E\) 對應的 \(\text{endpos}\) 集合(請務必區分,等價類是一個字元串集,而 \(\text{endpos}\) 是一個數集)。
舉例子之前,先把 SAM 的 DAG 畫出來:
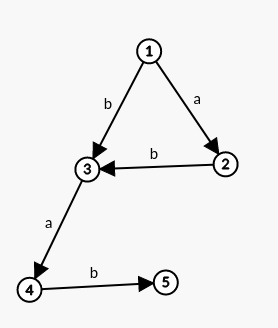
根據上面的對等價類的定義,我們可以得知:「b」 和 「ab」 屬於同一個等價類 \(E_x\) 。
把 「b」 和 「ab」 兩個子串對應到 DAG 上,發現這兩條路徑最終都走到了結點 3 。
這說明一個結點同時對應了多個字元串的 \(\text{endpos}\) 值,也就是說,一個結點 \(x\) 對應了一個 \(\text{endpos}\) 等價類 \(E_x\) ,其中包含了若干個 \(\text{endpos}\) 相同的子串(實際上,設從 \(P\) 出發有 \(n\) 條到 \(x\) 的不同路徑,則等價類 \(E_x\) 的大小為 \(n\) ,因為每一種路徑都表示一個不同的子串)。
相關引理與證明
引理 \(1\) :
考慮兩個非空子串 \(s_1,s_2\) ,令 \(|s_1|\geq|s_2|\) 。
\(1.1\) :若 \(s_1,s_2\) 的 \(\text{endpos}\) 相同,那麼 \(s_2\) 是 \(s_1\) 的一個後綴,且 \(s_2\) 在 \(S\) 中每一次都以 \(s_1\) 的後綴的形式出現。
\(1.2\) :若 \(s_2\) 是 \(s_1\) 的一個後綴,且 \(s_2\) 在 \(S\) 中每一次都以 \(s_1\) 的後綴的形式出現,那麼 \(s_1,s_2\) 的 \(\text{endpos}\) 相同。
證明 \(1.1,1.2\)
-
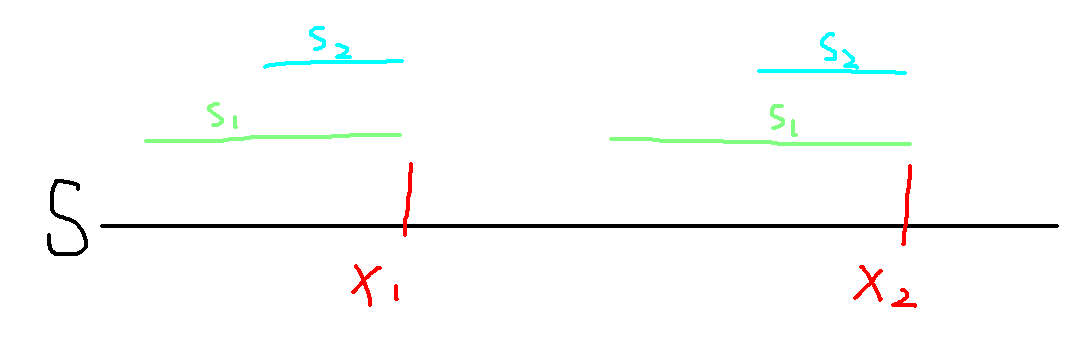
引理顯然成立,這個用一張圖就可以很直觀的說明了:
我們假設 \(\text{endpos}(s_1)=\text{endpos}(s_2)=\{x_1,x_2\}\) ,\(S\) 為原串。
一個簡單的事實是:如果 \(s_1\) 在 \(S\) 中出現,那麼它的所有後綴 \(s_2\) 一定也會在 \(S\) 中出現。
如果 \(s_2\) 僅僅作為 \(s_1\) 的後綴出現的話,那麼每次 \(s_1\) 出現則 \(s_2\) 出現,\(s_1\) 不出現則 \(s_2\) 也不出現,顯然它們的 \(\text{endpos}\) 應該相等(如圖)。
同理可證明 \(1.2\) (這個比較簡單而且好理解,就不再做嚴謹的證明了)。
Q.E.D
引理 \(2\) :
考慮兩個非空子串 \(s_1,s_2\) ,令 \(|s_1|\geq |s_2|\) 。
\(2.1\) :若 \(s_2\) 是 \(s_1\) 的一個後綴,則有 \(\text{endpos}(s_1)\subseteq \text{endpos}(s_2)\) 。
\(2.2\) :若 \(s_2\) 不是 \(s_1\) 的一個後綴,則有 \(\text{endpos}(s_1)\cap \text{endpos}(s_2)=\varnothing\) 。
還是繼續利用上面那張圖:
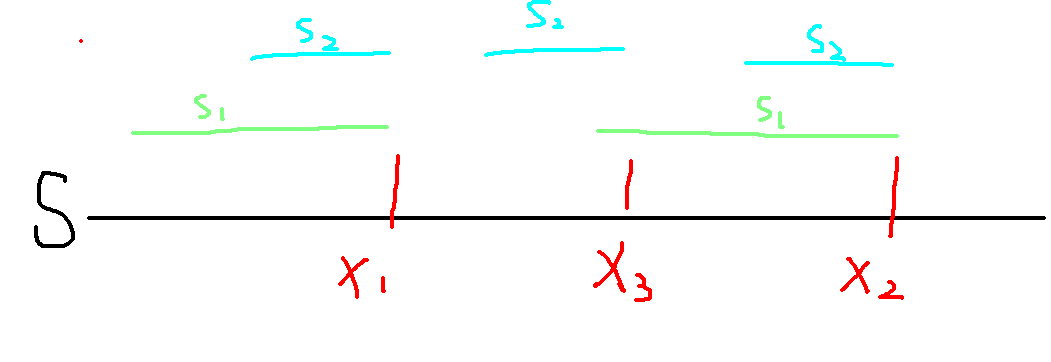
證明 \(2.1\) :
-
設 \(s_2\) 是 \(s_1\) 的一個後綴,那麼顯然每次 \(s_1\) 出現的時候 \(s_2\) 也必然出現,也就是說 \(\text{endpos}(s_2)\) 至少包含了 \(\text{endpos}(s_1)\) 中的所有元素。
但 \(s_2\) 每次出現的時候 \(s_1\) 卻不一定出現(如上圖,\(s_2\) 以 \(x_3\) 為結尾出現了一次,但 \(s_1\) 並沒有在那裡出現)。因此可能會出現一個元素 \(x\) ,使得 \(x\in \text{endpos}(s_2),x\notin \text{endpos}(s_1)\) 。
根據以上兩個條件以及集合的定義,推出 \(\text{endpos}(s_1)\subseteq \text{endpos}(s_2)\) 。
特別的,當且僅當不存在這樣的 \(x\) 時,有 \(\text{endpos}(s_1)=\text{endpos}(s_2)\),否則 \(\text{endpos}(s_1)\subsetneq \text{endpos}(s_2)\) 。
Q.E.D
證明 \(2.2\) :
-
反證法,設 \(\text{endpos}(s_1)\) 與 \(\text{endpos}(s_2)\) 至少有一個公共元素,且 \(s_2\) 不是 \(s_1\) 的後綴。
我們設這個公共元素為 \(x\) ,那麼 \(s_1\) 與 \(s_2\) 在相同位置 \(x\) 結束,觀察上圖,發現 \(s_2\) 與 \(s_1\) 一定有一方為另一方的後綴。
如果要滿足 「 \(s_2\) 不是 \(s_1\) 的後綴」 ,那麼只能讓 \(|s_2|>|s_1|\) ,使得 \(s_1\) 是 \(s_2\) 的後綴,但這與引理中 「令 \(|s_1|\geq |s_2|\) 」 的假設不符。
故 \(\text{endpos}(s_1)\) 與 \(\text{endpos}(s_2)\) 沒有公共元素,也即 \(\text{endpos}(s_1)\cap \text{endpos}(s_2)=\varnothing\) 。
Q.E.D
我們約定:記 \(S_l \rightarrow S_r\) 為在 \(S\) 中開頭下標為 \(l\) ,結尾下標為 \(r\) 的子串。
基於如上約定,我們來證明引理 \(3\) 的一個結論。
引理 \(3\) :
一個 \(\text{endpos}\) 等價類中不會包括兩個本質不同而長度相同的串。

證明:
-
如圖,反證法:假設 \(s_1,s_2\) 是同一個等價類 \(E\) 中本質不同的兩個子串,且 \(|s_1|=|s_2|=L\) ,原串為 \(S\) 。
那麼顯然 $s_1=S_{x_1-L+1}\rightarrow S_{x_1} $ ,\(s_2=S_{x_1-L+1}\rightarrow S_{x_1}\) ,發現這兩個等式右邊是相同的式子,於是推出 \(s_1=s_2\) 。
這個結論對於 \(\text{endpos}(E)\) 中包含的其他的 \(x_2,x_3...x_n\) 也同樣適用,不管使用哪個 \(x\) 的值,我們總能得出 \(s_1=s_2\) 的結論。
這與我們假定的 「 \(s_1,s_2\) 是同一等價類 \(E\) 中本質不同的兩個子串」 相矛盾,故假設不成立。
綜上,引理 3 成立,即一個 \(\text{endpos}\) 等價類中不會包括兩個本質不同而長度相同的串。
Q.E.D
我們約定:\(E_i\) 為字元串集合 \(E\) 中包含的第 \(i\) 個字元串(再提醒一下之前提到過的,一個 \(\text{endpos}\) 等價類是一個字元串集合) 。
基於如上約定,我們來證明引理 \(4\) 的兩個結論。
引理 \(4\) :
\(4.1\) :考慮一個 \(\text{endpos}\) 等價類 \(E\) ,對於 \(E\) 內任意兩個子串,它們要麼是相同的串,要麼較短者為較長者的真後綴。
\(4.2\) :設 \(l,r\) 分別為 \(E\) 內包含最短和最長子串的長度,則 \(\bigcup |E_i|=\{l\leq x\leq r,x\in N^*\}\) 。
若 \(card(E)=1\) ,兩條引理顯然成立,不做證明。現在考慮 \(card(E)>1\) 的情況。
證明 \(4.1\) :
- 由引理 \(1.1\) 、引理 \(3\) 結合可得: 在同一個等價類的任意兩個不相同子串中,較短者總是較長者的真後綴,引理 \(4.1\) 得證。
Q.E.D
證明 \(4.2\) :
-
分別設一個 \(\text{endpos}\) 等價類 \(E\) 中包含的最長的串為 \(s_1\) ,最短的串為 \(s_2\) 。
一個簡單的事實是 \(s_1\) 的所有後綴的長度為集合 \(\{1\leq x\leq |s_1|,x\in N^* \}\) (不考慮空串)。那麼一定存在一個字元串集合 \(Q\) ,使得 \(Q\) 中每個字元串都是 \(s_1\) 的後綴(不考慮空串)並且滿足 \(\bigcup |Q_i|=\{|s_2|\leq x \leq |s_1|,x\in N^*\}\) 。
我們發現, \(Q\) 集合的範圍就是需要證明的 \(E\) 的範圍,於是只要證明 \(E=Q\) 。
根據高中數學的知識,如果要證明兩集合 \(E=Q\),要分別證明 \(E\subseteq Q,Q\subseteq E\) 。
-
由引理 \(4.1\) ,我們可以得出 \(E\) 中所有的串都是最長串 \(s_1\) 的後綴,而根據我們做出的定義, \(Q\) 中所有的串也都是 \(s_1\) 的後綴。
我們又知道 \(E\) 中最長的串長度為 \(|s_1|\) ,最短的為 \(|s_2|\) ,而 \(Q\) 中包含了 \(s_1\) 的每一個長度在 \(|s_2|\) 到 \(|s_1|\) 之間的後綴,由此得出 \(E\subseteq Q\) 。
-
設 \(s_i\) 是 \(Q\) 中非 \(s_1,s_2\) 的一個串,顯然 \(s_2\) 應該是 \(s_i\) 的真後綴,\(s_i\) 是 \(s_1\) 的真後綴 。
反證法,我們已經知道 \(s_1,s_2\in E,s_1,s_2\in Q\) ,如果命題的第二部分不成立,那麼只要證明: \(\exists \ s_i\notin E\) 。
如果存在這樣一個 \(s_i\notin E\) ,設 \(s_i\in E'\) ,分別對 \(s_2,s_i\) 、\(s_i,s_1\) 使用引理 \(2.1\) ,得出 \(E\subseteq E'\subseteq E\) 。
根據集合的定義,\(E'=E\) ,即 \(\forall s_i\in E\) 。這與我們假設的 \(\exist \ s_i\notin E\) 不符,故原命題成立,即 \(Q\subseteq E\) 。
綜上所述,有 \(E=Q\) ,故 \(E\) 與 \(Q\) 的範圍相同,引理 \(4.2\) 得證。
-
Q.E.D
後綴鏈接 \(\text{link}\) 與後綴樹
定義與實際意義
考慮 SAM 中某個不是初始結點的結點 \(v\) 。上面已經說過,每個結點代表一個等價類,定義 \(w\) 為這個等價類所包含的字元串中最長的一個。
我們記串 \(t\) 為最長的、與 \(w\) 不屬於統一等價類的、\(w\) 的一個真後綴,把 \(v\) 的後綴鏈接連到 \(t\) 所屬的等價類 \(u\) 上(根據定義,\(u\) 也是一個結點)。
根據引理 \(4.2\) ,我們從某個等價類 \(E\) 不斷跳 \(\text{link}\) 到初始結點 \(P\) 就可以訪問 \(E\) 中最長子串 \(w\) 的每一個後綴,這就是後綴鏈接的實際意義。
相關引理與證明
引理 \(5\) :
設一個 \(\text{endpos}\) 等價類為 \(E\) ,\(E\) 中最短的串為 \(s\) 。
\(5.1\) :\(\text{link}(E)\) 中最長的串是 \(s\) 的長度為 \(|s|-1\) 的真後綴。
\(5.2\) :\(E\subsetneq \text{link}(E)\)
證明 \(5.1\) :
-
根據定義以及引理 \(4.2\) ,我們可以推出引理 \(5.1\) 。
這很簡單,不過這個結論不是我們想要的,我們對其做一步轉化——
\(E\) 中最短的串 \(\text{short}\) 的長度可以表示為 \(\text{link}(E)\) 中最長的串 \(\text{long}\) 的長度 +1 。
轉化的正確性也顯然,不過它告訴我們一個重要的資訊:我們可以通過 「最長」 求 「最短」 。
利用這個引理,後綴自動機的結點 \(v\) 中便只要記錄等價類 \(v\) 包含的最長的子串的長度了。
Q.E.D
證明 \(5.2\) :
-
下面是引理 \(2.1\) (一個顯然的條件是 \(\text{link}(E)\) 中的字元串都是 \(E\) 中的字元串的真後綴,這也是我們運用引理 \(2.1\) 的基礎):
\(2.1\) :若 \(s_2\) 是 \(s_1\) 的一個後綴,則有 \(\text{endpos}(s_1)\subseteq \text{endpos}(s_2)\) 。
顯然這裡單個字元串 \(s_1,s_2\) 可以用它所對應的 \(\text{endpos}\) 等價類 \(E\) 與 \(\text{link}(E)\) 替換掉。
把引理 \(2.1\) 用等價類 \(E\) 和 \(\text{link}(E)\) 替換掉之後,我們要做的就是證明 \(E\neq \text{link}(E)\) ,而這就是 \(\text{link}\) 的定義之一。
Q.E.D
引理 \(6\) :
所有後綴鏈接構成一棵以 \(P\) 為根的內向樹(後綴樹)。
下面的證明應該是沒什麼用,實際上,你只需要知道它是一棵樹就足夠了。
在題目中,我們一般是拿這棵樹去做一些樹形 DP 來統計子串資訊。
證明 \(6\) :
-
根據後綴鏈接的定義,我們從任意結點 \(A\) 沿著後綴鏈接訪問,總能訪問到結點 \(P\) ,於是可以得知 「後綴圖」 聯通。
現在只要證明後綴圖從任意結點 \(A\) 出發,到 \(P\) 的路徑有且只有一條,就可以證明它是一棵內向樹。
考慮 \(A\rightarrow P\) 有多條路徑存在的情況,大致如下:
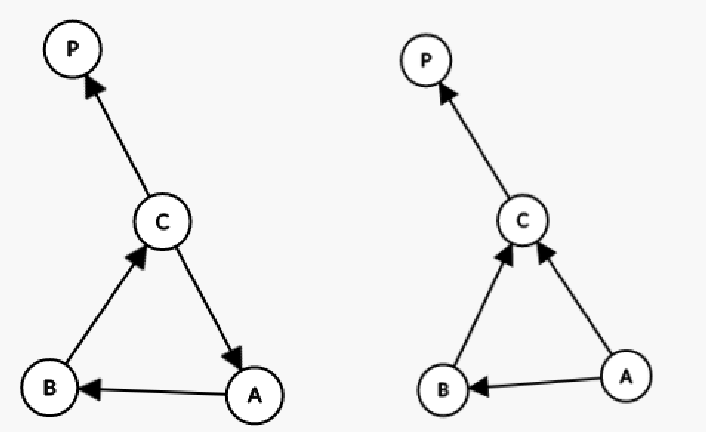
先來證明左邊的情況:
- 若出現這種情況,根據引理 \(5.2\) ,可以得出一個非常 naive 的結論—— \(A\subsetneq B\subsetneq C \subsetneq A\) ,而這是絕對不可能的。
再來證明右邊的情況:
-
繼續運用引理 \(5.2\) ,得出 \(A\subsetneq B \subsetneq C,A\subsetneq C\) ,這在數學上暫時還是說得過去的。
我們還知道 \(w\) 的前幾個後綴(按照長度降序考慮)可能和 \(w\) 屬於同一個等價類,且其他的後綴(至少一個——空串)一定屬於其他的等價類。
我們記串 \(t\) 為最長的 「其他的後綴」 ,把 \(v\) 的後綴鏈接 \(\text{link}\) 連到 \(t\) 所屬的 \(\text{endpos}\) 等價類 \(u\) 上(根據定義,\(u\) 應該也是 DAG 上的一個結點)。
上面是後綴鏈接的定義,顯然 \(w\) 的後綴鏈接只能連接到 「最長的其他的後綴串 \(t\) 」 所屬的等價類 \(u\) 上,也就是說,一個點只能有一條後綴鏈接。
在上圖中,\(A\) 擁有兩條後綴鏈接,這顯然是不可能的。
另外,\(P\) 對應空串,所以 \(P\) 不可能有後綴鏈接。
故原命題得證,即:所有後綴鏈接構成一棵以 \(P\) 為根的內向樹。
Q.E.D
栗子
理論的東西終於差不多了,把這棵後綴樹和 DAG 結合起來,SAM 就誕生了。
下面改一改 OI Wiki 上的兩張圖,我們具體看看後綴樹長成什麼樣(以字元串 「abcbc」 為例)。
後綴樹不是建立在 DAG 上的,而是與 DAG 公用結點,二者的邊都是獨有的,如下圖。
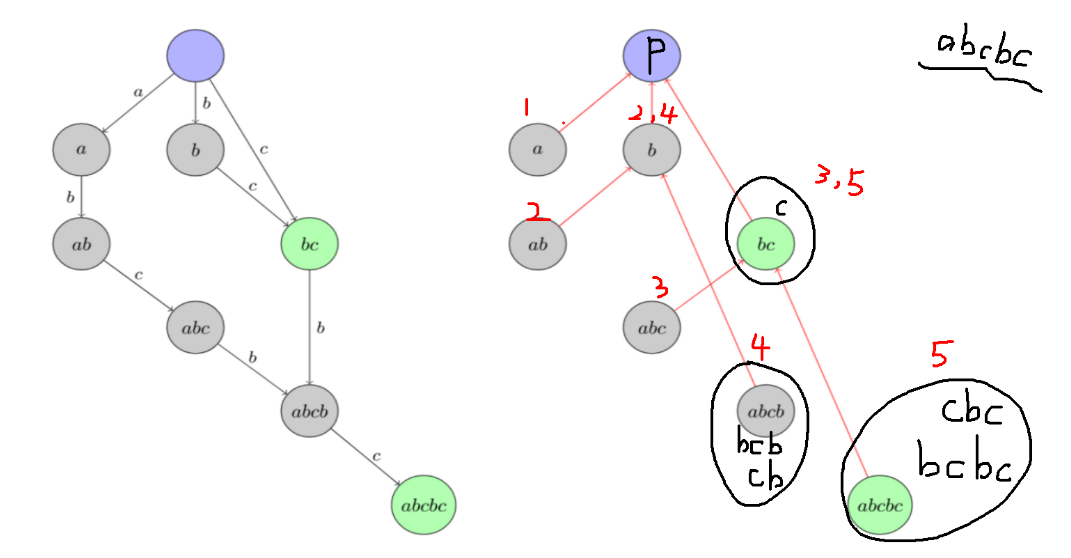
原圖只寫出了每個等價類(結點)內最長的字元串是誰,這裡用黑筆把每個等價類內其他的字元串補充出來了。
每個等價類(結點)上用紅筆標記的是這個等價類對應的 \(\text{endpos}\) 具體包含了哪些元素(譬如串 「bc」 的 \(\text{endpos}\) 是 \(\text{\{3,5\}}\) ,就在結點上寫了 3,5 )。
讀者可以結合這兩張圖驗證、加深理解一下之前證明過的引理。
小結
看了這麼多引理,是不是該總結一下呢?
在下面會引入一些輔助記號,作為介紹構造 SAM 演算法的基礎。
-
原串 \(S\) 的每一個子串可以根據它們的 \(\text{endpos}\) 被劃分為多個等價類,而每個等價類又對應了 DAG 以及後綴樹上的一個結點(\(\text{endpos}\) 的定義一節中提到)。
-
對於每一個結點 \(v\) ,它對應一個等價類 \(E\) 。我們記 \(\text{long}(v)\) 為 \(E\) 中最長的串,\(\text{len}(v)\) 為其長度;\(\text{short}(v)\) 為 \(E\) 中最短的串,\(\text{minlen}(v)\) 為其長度。那麼 \(E\) 中每個串都是 \(\text{long}(v)\) 的後綴,且所有字元串的長度的並集為 \(\{\text{minlen}(v)\leq x\leq \text{len}(v),x\in N^*\}\)(引理 \(2.1,3,4.2\) ,即不重不漏覆蓋整數區間)。
-
從任意結點 \(v_0\) 順著後綴鏈接遍歷,總可以訪問到 \(P\) 。途中會訪問到若干結點 \(v_i\) , \(v_i\) 中包含的字元串的長度恰好覆蓋一段區間 \([\text{minlen}(v_i),\text{len}(v_i)]\) 的每一個整數,並且每一個 \(v_i\) 恰好覆蓋的區間都不相交,這些區間的並為 \(\{0\leq x\leq \text{len}(v_0),x\in N^*\}\) (連續運用引理 \(3,4.2\))。
-
對於非 \(P\) 的一個結點 \(v\) ,可以用後綴鏈接的形式表達 \(\text{minlen}(v)\) ,即:\(\text{minlen}(v)=\text{len}(\text{link}(v))+1\) 。所以,我們在後綴自動機中,對於每個結點 \(v_i\) 通常只記錄 \(\text{len}(v_i)\)(引理 \(5.1\))。
-
設一個 \(\text{endpos}\) 等價類為 \(E\) ,\(E\) 中最短的串為 \(s\) ,則 \(\text{link}(E)\) 指向 \(s\) 的長度為 \(|s|-1\) 的真後綴所屬的等價類 \(E'\) (後綴鏈接定義)。所有的後綴鏈接形成一棵以 \(P\) 為根的內向樹(引理 \(6\))。後綴鏈接同時也可以表示 \(\text{endpos}\) 等價類之間的包含(子集)關係(引理 \(5.2\))。
Part 4 構造演算法
講了這麼多理論,終於該動手構造 SAM 了。
構造 SAM 的演算法是一個在線演算法,在這個演算法中,我們依次把字元加入 SAM ,並在每一步中動態維護它。
這個過程可能有些難以理解,所以下面會先展示演算法流程,稍後再逐步說明原理,最後給出程式碼實現。
演算法流程
一開始,SAM 中只有一個結點 \(P\) ,編號為 0 (其他結點編號 1、2 ... )。為了方便,我們欽定 \(\text{len}(P)=0,\text{link}(P)=-1\)( -1 表示虛擬狀態)。
現在我們的任務是實現給當前 SAM 添加一個字元 \(c\) 的過程,演算法流程如下:
-
令 \(last\) 為添加 \(c\) 之前整個字元串 \(S\) 所對應的結點(從 \(P\) 出發走到 \(last\) 的路徑上邊組成的串是 \(S\) ,一開始設 \(last=0\) ,演算法的最後一步更新它)。
-
創建一個新的狀態 \(cur\) ,並將 \(\text{len}(cur)\) 賦值為 \(\text{len}(last)+1\) 。
-
從 \(last\) 開始遍歷後綴鏈接,如果當前結點 \(v\) 沒有標記字元 \(c\) 的出邊,創建一條 \(v\rightarrow cur\) 的邊,標記為 \(c\) 。
-
如果遍歷到了 \(P\) ,賦值 \(\text{link}(cur)=0\) ,轉 8 。
-
如果當前結點 \(v\) 已經有了標記字元 \(c\) 的出邊,停止遍歷,並把這個結點標記為 \(p\) ,標記 \(p\) 沿著標記字元 \(c\) 的出邊到達的點為 \(q\) 。
-
如果 \(\text{len}(p)+1=\text{len}(q)\) ,賦值 \(\text{link}(cur)=q\) ,轉 8 。
-
否則情況會很複雜。
複製狀態 \(q\) 到一個新的狀態 \(copy\) 里(包括 \(\text{link}(q)\) 以及所有 \(q\) 在 DAG 上的出邊),將 \(\text{len}(copy)\) 賦值為 \(\text{len}(p)+1\) 。
複製之後,再賦值 \(\text{link}(q)=copy,\text{link}(cur)=copy\) 。
然後從 \(p\) 遍歷後綴鏈接,設當前遍歷到的點為 \(v\) ,若 \(v\) 有標記為 \(c\) 的出邊 \(v\rightarrow q\) ,則重定向這條邊為 \(v\rightarrow copy\) 。
若 \(v\) 沒有標記為 \(c\) 的出邊或者 \(v\) 的標記為 \(c\) 的出邊所到達的點不是 \(q\) ,停止遍歷,轉 8 。
-
把 \(last\) 賦值為 \(cur\) ,轉 1 。
演算法原理
我們將按照演算法的八個步驟依次說明。
-
找到 \(last\) ,為之後的更新做準備。
-
加入 \(c\) 之後,串就變成了 \(S+c\) ,這一步操作後顯然會出現一些新的等價類( \(\text{endpos}\) 包含新來的字元 \(c\) 的位置)我們創建這個新的等價類為 \(cur\) 。
根據我們上面對 \(last\) 的定義,顯然 \(last\) 中最長的字元串就是 \(S\) ,長度為 \(\text{len}(last)\) 。
因為新串是 \(S+c\) ,應該從 \(S\) 添加一條到 \(cur\) 的邊,標記為 \(c\) ,表示可以從 \(S\) 轉移到 \(S+c\) 。
等價類 \(cur\) 中包含的最長的字元串應該是 \(S+c\) ,故賦值 \(\text{len}(cur)=\text{len}(last)+1\) 。
-
遍歷後綴鏈接,嘗試添加到 \(cur\) 的轉移。
SAM 做的工作是記錄串的每一個後綴。現在新串是 \(S+c\) ,那麼我們只要在原來記錄的每一個後綴的後面添加一個 \(c\) 就可以了。
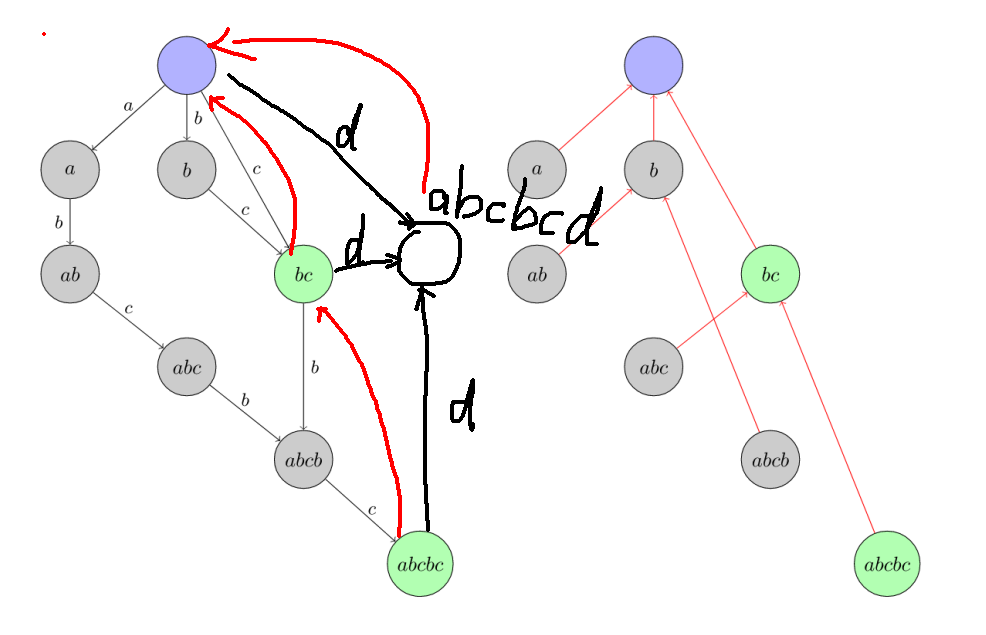
根據引理 \(4.2\) 以及 \(\text{link}\) 的定義,從 \(last\) 開始遍歷 \(\text{link}\) 可以訪問原串 \(S\) 的所有後綴,我們依次嘗試在這些等價類之後添加連向 \(cur\),標記為 \(c\) 的邊。
如下圖,這是一個向 SAM 中添加字元 「d」 的過程,紅色表示跳的後綴鏈接,黑筆標記的邊為新建邊。
引理 \(7\) :特別地,當且僅當跳後綴連接一直跳到了 \(P\) 結點,說明加入的字元 \(c\) 在之前的串 \(S\) 中沒有出現過。
證明 \(7\) :
-
還記得 SAM 是如何存下字元串的所有子串資訊的嗎?——沿著某一個後綴走 \(x\) 條邊對應的字元串是一個原串的子串。
我們現在遍歷了原串的每一個後綴,從這些後綴出發,我們找不到任何一條標記為 \(c\) 的邊。
也就是說,不存在任何一個後綴的前綴是單個字元 \(c\) ,由此得出 \(c\) 在 \(S\) 中沒有出現過。
Q.E.D
-
上面已經證明過,如果要執行 \(4\) ,說明這次添加的字元 \(c\) 在之前沒有出現過。
這也就說明,\(S\) 中不存在新串 \(S+c\) 的任何一個非空後綴,根據 \(\text{link}\) 的定義,應該把 \(cur\) 的 \(\text{link}\) 連向空串。
-
一個輔助性的步驟,不做過多說明。
-
步驟 \(6,7\) 本質上是在處理相同問題( \(cur\) 的後綴鏈接問題)的不同情況,我們放在一起討論。
首先,根據小結中的第 \(3,4\) 條 ,明確一點:從 \(last\) 開始跳後綴鏈接,每一次訪問到的某個等價類 \(p\) 中,\(p\) 包含的所有字元串都是原串 \(S\) 的後綴。並且 \(\text{long}(p)\) 的長度 \(\text{len}(p)\) 單調遞減,這樣我們推出 \(\text{long}(p)+c\) 的長度 \(\text{len}(p)+1\) 也單調遞減,我們在後面的證明中會用到這一點。
我們從 \(last\) 向 \(P\) 跳後綴鏈接,設第一次遇到的擁有一條 \(c\) 的出邊的結點為 \(p\) ,從 \(p\) 經 \(c\) 的出邊到達了 \(q\) 。
根據定義,\(p\) 中包含串 \(\text{long}(p)\) ,而 \(\text{long}(p)\) 再沿著這條 \(c\) 的出邊走就形成了串 \(\text{long}(p)+c\) ,換句話說——我們找到了串 \(\text{long}(p)+c\) 。
那麼這有什麼用呢? \(\text{long}(p)\) 是原串 \(S\) 的後綴,故 \(\text{long}(p)+c\) 是新串 \(S+c\) 的後綴。又因為 \(\text{long}(p)+c\) 長度的單調遞減性質,我們找到的第一個串 \(\text{long}(p)+c\) 對於 \(\text{long}(cur)\) 來說,不就是 「最長的、不與 \(\text{long}(cur)\) 屬於同一等價類的、\(\text{long}(cur)\) 的後綴」 嗎?這正是後綴鏈接的定義,於是 \(\text{long}(p)+c\) 就應該是 \(\text{link}(cur)\) 中最長的字元串。
現在問題來了:\(\text{link}(cur)\) 應該連向一個所包含最長串是 \(\text{long}(p)+c\) 的結點,而 \(q\) 包含了串 \(\text{long}(p)+c\) ,但 \(\text{long}(p)+c\) 是不是 \(q\) 中的最長字元串還不知道。
-
如果 \(\text{len}(q)=\text{len}(p)+1\) ,根據引理 \(3\) ,我們推斷出 \(q\) 中最長的字元串一定是 \(\text{long}(p)+c\) ,這時直接賦值 \(\text{link}(cur)=q\) 。
-
如果 \(\text{len}(q)\neq \text{len}(p)+1\) ,這說明 \(q\) 中最長的字元串不是 \(\text{long}(p)+c\) ,那麼我們就不能直接賦值。
既然我們需要一個包含最長字元串為 \(\text{long}(p)+c\) 的等價類,那麼我們可以把 \(\text{long}(p)+c\) 及其在 \(q\) 中的所有後綴從 \(q\) 中拿出來,讓它們單獨構成一個新的等價類 \(copy\) 。這時這個新的等價類 \(copy\) 就滿足了 \(\text{link}(cur)\) 的要求,賦值 \(\text{link}(cur)=copy\) 。
現在考慮分裂 \(q\) 造成的影響:
-
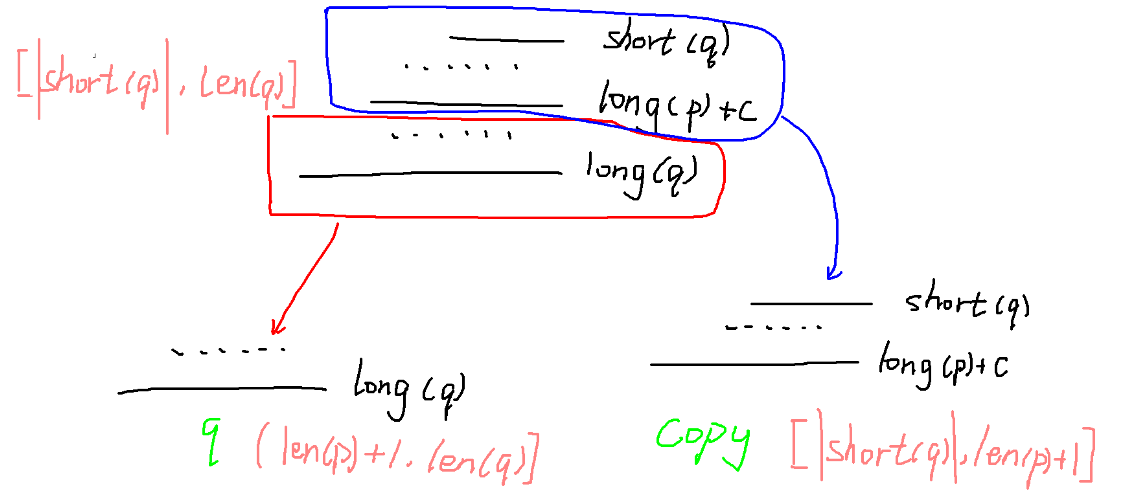
下面的 \(q\) 均指被拆分之前的等價類 \(q\),如有特殊需要,會使用 「新等價類 \(q\)」 加以區分。
如上圖,我們實際上是從一個包含的字元串的長度可以覆蓋區間 \([|\text{short}(q)|,\text{len}(q)]\) 中每一個整數的等價類 \(q\) 中拆分出一個包含的字元串的長度可以覆蓋區間 \([|\text{short}(q)|,\text{len}(p)+1]\) 中每一個整數的等價類 \(copy\) 。順便可以得出新等價類 \(q\)中包含的字元串的長度恰好覆蓋區間 \((\text{len}(p)+1,\text{len}(q)]\) 中每一個整數。
考慮 \(copy\) 的 \(\text{link}\) 該連向誰。\(\text{link}(q)\) 是 \(q\) 中所有字元串的後綴,也就必然是 \(\text{long}(copy)\) 的後綴。據引理 \(5.1\) 推出 \(\text{len}(\text{link}(q))=|\text{short}(q)|-1\) 。再對 \(copy\) 用一遍引理 \(5.1\) ,發現 \(\text{len}(\text{link}(copy))=|\text{short}(q)|-1\) 。也就是說,\(\text{link}(q)\) 恰好滿足了成為 \(\text{link}(copy)\) 的條件,於是 \(\text{link}(copy)=\text{link}(q)\) 。
據圖,\(copy\) 中的字元串都是新等價類 \(q\)中字元串的後綴。而 \(\text{len}(\text{link}(q))=|\text{short}(q)|-1<\text{len}(p)+1\) , 這說明 \(\text{long}(copy)\) 才是 「\(\text{long}(q)\) 的最長的、不與 \(\text{long}(q)\) 屬於同一等價類的、\(\text{long}(q)\) 的後綴」,也就是 \(\text{link}(q)=copy\) 。
考慮新等價類在 DAG 上的出邊如何分配。因為 \(copy\) 是從 \(q\) 中分裂出來的,\(copy\) 中的串在分裂之前與新等價類 \(q\) 中的串共用 \(q\) 的出邊,即使現在這些串被分出去了,它們也應該擁有之前的出邊。於是應該把 \(q\) 的所有出邊複製給 \(copy\) 。
除此之外,我們還要重定向一些出邊。
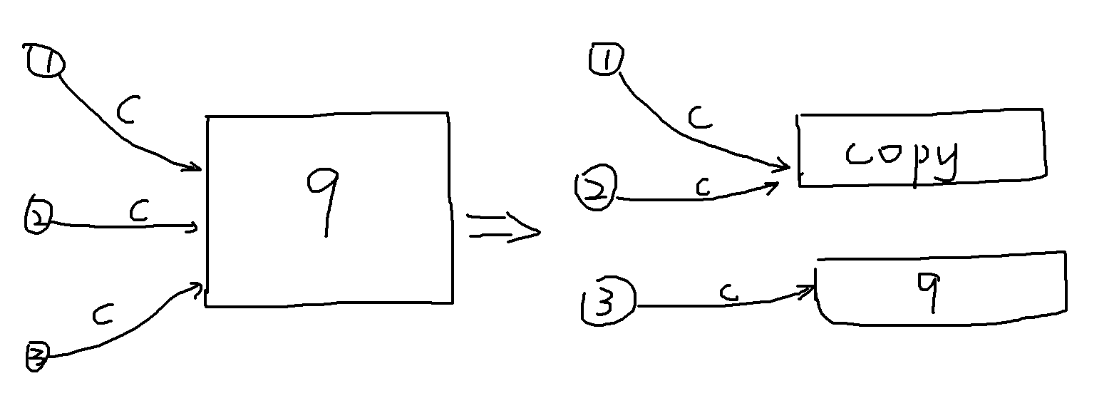
如上圖,相信重定向邊的原因大家看圖也能看個八九不離十吧。
原來的 \(q\) 有若干條入邊,每一條都構成了 \(q\) 中包含的一個字元串。但是現在 \(q\) 分家了,我們就必須要區分清楚,到底是哪些入邊構成了被分出去的串,哪些構成了還剩下在 \(q\) 中的串(如果不做修改,那麼我們的程式默認所有邊都指向了新等價類 \(q\) ,這樣顯然不對)。
那麼具體是哪些出邊呢?顯然只有 \(\text{long}(p)\) 的某個後綴加上 \(c\) 才可以構成 \(copy\) 中的某個串(\(copy\) 中的串都是 \(\text{long}(p)+c\) 的後綴)。那麼從 \(p\) 繼續向 \(P\) 遍歷後綴鏈接——
- 如果找到了一個結點 \(v\) 擁有一條標記 \(c\) 的出邊指向 \(q\) ,說明 \(v\) 中的串加上 \(c\) 構成了 \(copy\) 中的串,我們要把這條邊重定向到 \(copy\) 。
- 如果找到了一個結點 \(v\) 擁有一條標記 \(c\) 的出邊,但指向結點不是 \(q\) ,說明 \(v\) 中的串加上 \(c\) 構成了一個不在 \(copy\) 集合中的 \(\text{long}(copy)\) 的後綴(\(copy\) 在後綴樹上的某一級祖先中的一個串)。因為 \(v\) 中的串加上 \(c\) 無法構成 \(copy\) 中的串,那麼 \(v\) 的後綴加上 \(c\) 顯然也無法構成 \(copy\) 中的一個串。也就是說,我們已經把所有要重定向的邊完成重定向了,停止遍歷即可。
-
最後一步,把 \(last\) 設置為 \(cur\) ,表示要把本次加進來的新串作為原串 \(S\) ,以備加入下一個字元的需要。
-
實際上,關於分裂操作的原因,還有另一種證明方法(使用 \(\text{endpos}\) 等價類在被更新時的兼容性來說明),不過如果要再說明一遍,篇幅未免有點長了。如果讀者對它感興趣的話,我就在這裡給大家起個頭吧:
如果我們要加入 \(c\) ,此時 \(\text{long}(p)+c\) 及其所有後綴應該作為 \(S+c\) 的後綴出現一次,這些字元串的 \(\text{endpos}\) 集合內應該被添加一個新的元素—— \(|S|+1\) 。但是如果 \(\text{len}(q)\neq \text{len}(p)+1\) ,也就是說,\(q\) 中包含的字元串除了 \(\text{long}(p)+c\) 還有一些更長的串 \(x\) 。\(x\) 並沒有作為 \(S+c\) 的後綴出現,故 \(x\) 的 \(\text{endpos}\) 內不應該被添加 \(|S|+1\) 這個元素。此時一個等價類 \(q\) 內出現了兩類 \(\text{endpos}\) 不相同的字元串,這不符合等價類的定義,故 \(q\) 註定分裂。
……
下面將用圖展示 SAM 的構造過程(以串 「abcbc」 為例):
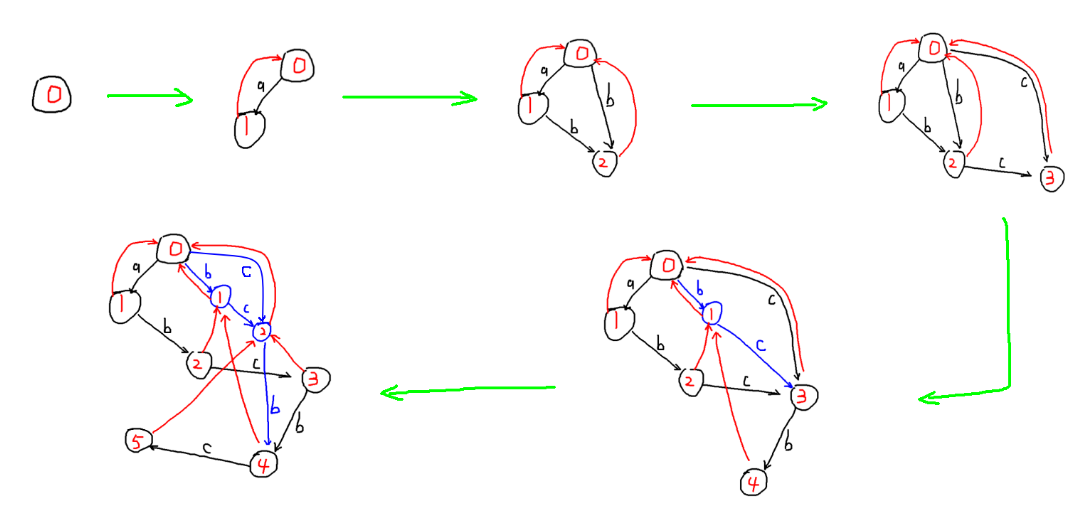
食用指南:
- 黑色點表示 DAG 中的結點,黑色邊表示 DAG 中的出邊,邊上標記了字母。
- 藍色點表示這個點是分裂得到的,藍色邊表示這條邊是複製過來的或者重定向過的。
- 紅色邊表示後綴樹上的邊。
- 每個點內的數字表示這個點包含的最長字元串的長度( \(P\) 到該結點的最長路長度)。
我們來模擬一下這個後綴自動機的建立過程吧:
- 初始時,只有一個結點 \(P\) ,表示初始結點。
- 添加 「a」 ,滿足構造演算法的第 \(4\) 步,後綴鏈接到 \(0\) 。
- 添加 「b」 ,滿足構造演算法的第 \(4\) 步,後綴鏈接到 \(0\) 。
- 添加 「c」 ,滿足構造演算法的第 \(4\) 步,後綴鏈接到 \(0\) 。
- 添加 「b」 ,跳後綴鏈接到 \(P\) ,發現 \(P\) 有標記 「b」 的出邊,到達的結點 \(q\) 的最長串長度是 2 ,分裂 \(q\) ,重定向邊。
- 添加 「c」 ,跳後綴鏈接到 \(5\) 中分裂出來的點,發現該點有標記 「c」 的出邊,到達的結點 \(q\) 的最長串長度是 3 ,分裂 \(q\) ,重定向邊。
這樣,你就得到了和 OI Wiki 上給出的一模一樣的後綴自動機啦,好耶!
複雜度與其他必要資訊
時空複雜度
上面我們提到過,SAM 的複雜度是線性的,這是建立在字符集大小 \(|\sum|\) 為常數的情況下,如果 \(|\sum|\) 不是常數,那麼 SAM 的複雜度就不是線性的。
如果字符集過大,那麼我們需要在每個結點維護一個 map 存下從該點出發經過字元 \(x\) 所到達的結點編號(利用 map 建立 char 到 int 的映射)。因此,如果不能忽略字符集大小的話,演算法的漸進複雜度應為 \(O(n\log |\sum|)\) ,空間複雜度 \(O(n)\) 。
如果字符集足夠小(例如 26 個英文字母),可以不用寫 map ,用空間換時間在每個結點存為一個大小為 \(|\sum|\) 的 int 數組,直接存該邊到達結點編號。這樣演算法的時間複雜度為 \(O(n)\) ,空間複雜度升至 \(O(n|\sum|)\) 。
結點數
對於一個長度為 \(n\) 的字元串,它的 SAM 中的結點數不會超過 \(2n-1\)(假設 \(n\geq 2\))。
這是一個必要的結論,它可以告訴我們寫 SAM 的時候代表結點的數組大小要開 2 倍。
具體地,字元串 「abbb...bbb」 可以使得這個值達到上限 \(2n-1\) 。
邊數
對於一個長度為 \(n\) 的字元串,它的 SAM 中的邊數不會超過 \(3n-4\)(假設 \(n\geq 3\))。
如果使用 map 實現 SAM ,那麼這條結論可以讓我們預估 SAM 的空間複雜度。
具體地,字元串 「abbb...bbbc」 可以使得這個值達到上限 \(3n-4\) 。
程式碼實現
下面給出三種實現的方式,一種是直接使用數組實現,一種則封裝在了結構體內。另外,筆者再給出一種使用 map 的實現方式。
PS:對於一些毒瘤題目,我們可能需要寫兩個或者更多後綴自動機,這時使用封裝在結構體內的實現方式比較方便。
/*---------- 結構體封裝版本 ----------*/
struct Suffix_Automaton{
  int len[maxn<<1],link[maxn<<1];//和說明中提到的意義相同
  int ch[maxn<<1][26];//每個結點開字符集大小的數組
  int siz,last;//siz 用來新建結點,last 同說明中的意義
  std::vector<int>v[maxn<<1];
  inline void init(){
    memset(len,0,sizeof len);
    memset(link,0,sizeof link);
    memset(ch,0,sizeof ch);
    memset(mx,0,sizeof mx);
    for(int i=0;i<200000;++i) v[i].clear();
    siz=last=0;//初始化不能忘
    link[0]=-1;//這一句很重要,我們要初始化 link(0) 為虛擬結點
  }
  inline void extend(const char *str){//在當前變數中建立 str 的 sam
    int n=std::strlen(str);
    for(int _=0;_<n;++_){
      int cur=++siz,p=last,c=str[_]-'a';//意義同證明中提到的
      len[cur]=len[p]+1;//初始化新結點的 len
      while(p!=-1 && !ch[p][c]){//跳 link 嘗試添加邊
        ch[p][c]=cur;
        p=link[p];
      }
      if(p==-1) link[cur]=0;//直接跳到了 0 (初始結點),賦值 link(cur)=0
      else{
        int q=ch[p][c];//找到了 q 為 p 的 c 出邊
        if(len[q]==len[p]+1) link[cur]=q;//len(q)=len(p)+1 的情況
        else{//分裂結點的情況
          int copy=++siz;
          len[copy]=len[p]+1;
          link[copy]=link[q];
          for(int i=0;i<26;++i) ch[copy][i]=ch[q][i];//初始化分裂的結點 copy
          while(p!=-1 && ch[p][c]==q){
            ch[p][c]=copy;
            p=link[p];//重定向路徑
          }
          link[q]=link[cur]=copy;//修改 q 和 cur 的 link 為 copy
        }
      }
      last=cur;//最後一步更新 last
    }
    for(int i=1;i<=siz;++i) v[link[i]].push_back(i);//建立後綴樹
  }
}sam;

/*---------- 不封裝版本 ----------*/

struct Suffix_Automaton{
  int link,len;
  int ch[26];
}SAM[maxn<<1];
int siz,last;
std::vector<int>Suffix_Tree[maxn<<1];
void SAM_extend(const int c){
  int cur=++siz,p=last;
  SAM[cur].len=SAM[p].len+1;
  while(p!=-1 && !SAM[p].ch[c]){
    SAM[p].ch[c]=cur;
    p=SAM[p].link;
  }
  if(p==-1) SAM[cur].link=0;
  else{
    int q=SAM[p].ch[c];
    if(SAM[q].len==SAM[p].len+1) SAM[cur].link=q;
    else{
      int copy=++siz;
      SAM[copy].len=SAM[p].len+1;
      SAM[copy].link=SAM[q].link;
      for(int i=0;i<26;++i) SAM[copy].ch[i]=SAM[q].ch[i];
      while(p!=-1 && SAM[p].ch[c]==q){
        SAM[p].ch[c]=copy;
        p=SAM[p].link;
      }
      SAM[q].link=SAM[cur].link=copy;
    }
  }
  last=cur;
}
//在主函數中
link[0]=-1;
int lenth=strlen(str);
for(int i=0;i<lenth;++i) SAM_extend(str[i]-'a');

/*---------- map 版本 ----------*/

struct Suffix_Automaton{
  int len,link;
  std::map<int,int>ch;
}SAM[maxn<<1];
int siz,last;
void SAM_extend(int c){
  int cur=++siz,p=last;
  SAM[cur].len=SAM[last].len+1;
  while(p!=-1 && !SAM[p].ch.count(c)){
    SAM[p].ch[c]=cur;
    p=SAM[p].link;
  }
  if(p==-1) SAM[cur].link=0;
  else{
    int q=SAM[p].ch[c];
    if(SAM[q].len==SAM[p].len+1) SAM[cur].link=q;
    else{
      int copy=++siz;
      SAM[copy].len=SAM[p].len+1;
      SAM[copy].link=SAM[q].link;
      SAM[copy].ch=SAM[q].ch;
      while(p!=-1 && SAM[p].ch.count(c)){
        if(SAM[p].ch[c]==q) SAM[p].ch[c]=copy,p=SAM[p].link;
        else break;
      }
      SAM[q].link=SAM[cur].link=copy;
    }
  }
  last=cur;
}
更多性質
下面的內容基於讀者已經對前面的引理以及後綴樹有一個比較全面的認識和了解(其實是懶得寫證明了)。
分配結束標記
說了這麼多,後綴自動機的初心還是一個可以接受一個字元串所有後綴的最小 DFA 。
要構造這個 DFA ,我們就要分配結束標記,表示在 DAG 上走到這個結點的時候,出現了該字元串的一個後綴。
先構建整個字元串的 SAM ,找到構建完成後的 \(last\) ,從 \(last\) 向根結點跳後綴鏈接,把路上遇到的每一個結點都打上結束標記。
這個做法的原理很簡單:我們剛才討論過了,從 \(last\) 跳後綴鏈接,可以訪問字元串的所有後綴組成的每一個等價類( 「演算法原理」 一節中第 \(6\) 條第二段)。
最長公共後綴
原串 \(S\) 的兩個子串的最長公共後綴是這兩個子串所屬 \(\text{endpos}\) 等價類對應結點在後綴樹上 LCA 結點對應等價類中包含的最長的字元串。
跳後綴鏈接可以訪問後綴,那麼兩條鏈的公共節點就是公共後綴啦。
統計子串
我們想要知道某個子串出現了幾次,只需要知道它的 \(\text{endpos}\) 集合包含了幾個元素就可以了。
顯然,一個字元串的每一個前綴的所有後綴構成了這個字元串的所有子串,於是每一個子串只要成為原串某個前綴的後綴,出現次數就應該 +1 。
我們訪問一個串的所有後綴十分方便——只要從它所屬等價類對應的結點出發,跳後綴鏈接就行了。
注意到我們構建 SAM 的時候實際上是構建了串的每個前綴(按次序一位一位構造)。這樣,我們可以在創建每一個新結點 \(cur\) 的時候給這個結點打上一個標記,表示這個結點是原串的一個前綴。
在建立好 SAM 之後,我們從剛才每一個打好標記的結點開始跳後綴鏈接,並把路徑訪問到的結點的標記 +1 ,表示這個前綴的所有後綴各出現了一次。操作完之後,每個結點被標記的次數就是這個結點的等價類對應的 \(\text{endpos}\) 集合大小了。不過這樣做,最壞複雜度是 \(O(n^2)\) 的,顯然不可以接受。
其實這個過程就是樹上某個結點到根的路徑點權 +1 ,考慮到每個結點的答案貢獻一定來自它子樹內的結點(只有它子樹內的結點到根的路徑才會經過它)。於是問題變成了子樹求和,用樹形 DP 可以做到 \(O(n)\) 的複雜度。
Part 5 解決問題
其實上面求每個子串的出現次數已經偏應用了,不過因為它太重要了,就把它放在了 「更多性質」 一節。
由於下面的題目是作者在不同時期寫出的程式碼,馬蜂(實現方式)略有不同,大家見諒。
下面的題目如果不做特殊說明,字元串均由嚶文小寫字母組成。
Problem A 【模板】後綴自動機
題目鏈接:Link
- 給你一個字元串 \(S\) ,求出每一個出現次數不為 1 的子串的出現次數乘上它的長度的最大值。
- \(1\leq |S|\leq 2\times 10^6\)
Solution
看到 「子串」 二字很容易聯想到 SAM 吧,先對 \(S\) 建立起 SAM 。
在上面 「統計子串」 一節中,我們提到了計算一個子串出現次數的方式,現在考慮答案可能來自哪些子串。
顯然在同一個等價類中,每一個子串的出現次數都相同,那麼在這一堆相同的串中,顯然只有最長的那個串可能構成答案。
那麼我們可以在樹形 DP 中順便維護更新答案,總時間複雜度 \(O(n)\) ,轉移方程如下:
Code
const int maxn=1000005;

char str[maxn];
int ans;
struct Suffix_Automaton{
  int len[maxn<<1],link[maxn<<1];
  int ch[maxn<<1][26];
  int f[maxn<<1];
  std::vector<int>v[maxn<<1];
  int last,siz;
  inline const void init(){
    for(int i=0;i<=maxn*2-5;++i) v[i].clear();
    memset(len,0,sizeof len);
    memset(link,0,sizeof link);
    memset(ch,0,sizeof ch);
    link[0]=-1;
    siz=last=0;
  }
  inline const void extend(char *str){
    int n=std::strlen(str);
    for(int _=0;_<n;++_){
      int c=str[_]-'a',p=last,cur=++siz;
      len[cur]=len[p]+1;
      f[cur]=1;
      while(p!=-1 && !ch[p][c]){
        ch[p][c]=cur;
        p=link[p];
      }
      if(p==-1) link[cur]=0;
      else{
        int q=ch[p][c];
        if(len[q]==len[p]+1) link[cur]=q;
        else{
          int copy=++siz;
          len[copy]=len[p]+1;
          link[copy]=link[q];
          for(int i=0;i<26;++i) ch[copy][i]=ch[q][i];
          while(p!=-1 && ch[p][c]==q){
            ch[p][c]=copy;
            p=link[p];
          }
          link[q]=link[cur]=copy;
        }
      }
      last=cur;
    }
    for(int i=1;i<=siz;++i) v[link[i]].push_back(i);
  }
  inline const int dfs(const int x){
    for(int i=0;i<v[x].size();++i){
      int y=v[x][i];
      dfs(y);
      f[x]+=f[y];
    }
    if(f[x]>1) ans=std::max(ans,f[x]*len[x]);
    return f[x];
  }
}sam;

signed main(){
  scanf("%s",str);
  sam.init();
  sam.extend(str);
  sam.dfs(0);
  write(ans),putchar('\n');
  return 0;
}
Problem B 【SDOI 2016】 生成魔咒
題目鏈接:Link
-
給你一個初始為空串 \(S\) ,\(n\) 次操作,每次向 \(S\) 的末尾添加一個數字 \(x_i\) 。
求每次添加 \(x_i\) 之後,串 \(S\) 中總共有多少個本質不同的子串。
譬如 「10,10,10」 有 3 個本質不同的子串:「10」,「10,10」,「10,10,10」 。
而 「1,2,1」 有 5 個本質不同的子串:「1」,「2」,「1,2」,「2,1」,「1,2,1」 。
-
\(1\leq x_i\leq 10^9,1\leq n\leq 10^5\)
Solution
還是子串問題,考慮 SAM 。
首先明確一個性質,向某個字元串末尾添加一個字元,一定不會導致子串數量減少,也就是原串 \(S\) 的子串不會消失。
於是我們只需要統計加入 \(x_i\) 產生的新子串有多少個,用 \(S\) 的不同子串數加上產生的新子串的數量得到答案。
考慮 \(\text{endpos}\) 集合,如果一個串是新產生的串,那麼它在原串中一定沒有出現過——它的 \(\text{endpos}\) 中一定只包含 \(|S|+1\) 這一個元素。同樣,如果一個串的 \(\text{endpos}\) 並非只有 \(|S|+1\) 這一個元素,那麼說明它在 \(S\) 中出現過,也就不是新產生的串。綜上,可以得知:當且僅當一個串的 \(\text{endpos}\) 集合內有且僅有 \(|S|+1\) 這一個元素的時候,它是新產生的串。
現在任務變成了:找到 \(\text{endpos}\) 中只包含 \(|S|+1\) 這一個元素的串有幾個。
顯然,整個新串 \(S+x_i\) 的 \(\text{endpos}\) 一定只包含 \(|S|+1\) ,它是符合條件的一個串。考慮串 \(S+x_i\) 所屬的等價類 \(cur\)(在 SAM 中,\(S+x_i\) 所屬的結點是新建的 \(cur\) ,這裡索性叫 \(cur\) 吧),\(cur\) 中包含的其他字元串的 \(\text{endpos}\) 一定和串 \(S+x_i\) 相同,這些串顯然也符合條件。根據引理 \(2.2\) ,如果一個串不是 \(S+x_i\) 的後綴,那麼它的 \(\text{endpos}\) 與 \(\text{endpos}(cur)\) 無交,這些串不可能成為答案。考慮 \(S+x_i\) 的不屬於 \(cur\) 的後綴,設這些串屬於等價類 \(cur'\) 。根據引理 \(2.1\) 有 \(\text{endpos}(cur)\subsetneq\text{endpos}(cur')\) ,也就是 \(cur'\) 至少包含一個非 \(|S|+1\) 的元素,這些串也不可能成為答案。
綜上所述,\(\text{endpos}\) 中只包含 \(|S|+1\) 的串的數量就是 \(cur\) 中包含的字元串數量。
根據引理 \(4.2\) 的 「恰好覆蓋」 性質,我們可以得出 \(cur\) 內包含的串的數量就是這些串長度覆蓋的值域區間的長度,即 \(\text{len}(cur)-\text{minlen}(cur)+1\)。再用引理 \(5.1\) 轉化一下,得到 \(\text{len}(cur)-\text{len}(\text{link}(cur))\) ,於是每次插入產生的新串數量就是 \(\text{len}(cur)-\text{len}(\text{link}(cur))\) 。
回到本題上來,我們知道了每次加入字元後產生的新子串數目,於是每次的答案可以遞推得到,即:
總時間複雜度 \(O(n)\) 。
Code
const int maxn=100005;

struct Suffix_Automaton{
  int len,link;
  std::map<int,int>nxt;
}SAM[maxn<<1];
int siz,last,n,ans;

int SAM_extend(int c){
  int cur=++siz;
  SAM[cur].len=SAM[last].len+1;
  int p=last;
  while(p!=-1 && !SAM[p].nxt.count(c)){
    SAM[p].nxt[c]=cur;
    p=SAM[p].link;
  }
  if(p==-1) SAM[cur].link=0;
  else{
    int q=SAM[p].nxt[c];
    if(SAM[q].len==SAM[p].len+1) SAM[cur].link=q;
    else{
      int copy=++siz;
      SAM[copy].len=SAM[p].len+1;
      SAM[copy].link=SAM[q].link;
      SAM[copy].nxt=SAM[q].nxt;
      while(p!=-1 && SAM[p].nxt.count(c)){
        if(SAM[p].nxt[c]==q) SAM[p].nxt[c]=copy,p=SAM[p].link;
        else break;
      }
      SAM[q].link=SAM[cur].link=copy;
    }
  }
  last=cur;
  return SAM[cur].len-SAM[SAM[cur].link].len;
}

signed main(){
  read(n);
  SAM[0].link=-1;
  for(int i=1,q;i<=n;++i){
    read(q);
    ans+=SAM_extend(q);
    write(ans),putchar('\n');
  }
  return 0;
}
Problem C 最長公共子串
題目鏈接:Link
- 給你兩個字元串 \(s_1,s_2\) ,求這兩個字元串的最長公共子串。
- \(1\leq |s1|,|s_2|\leq 2.5\times 10^5\)
題外話
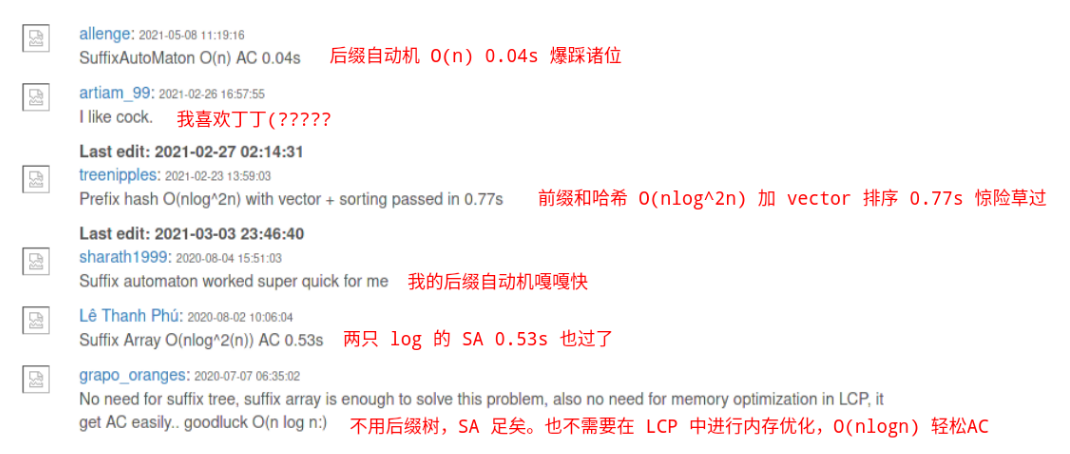
講道理,這個題其實在放 \(O(n\log n)\) 的 SA 做法,甚至有神仙用 \(O(n\log^2 n)\) 的前綴哈希過了的。
如下是這個題在 SPOJ 的討論區:
Solution
對於這類統計多串子串類題目,我們有一個比較通用的做法:(偽)廣義 SAM 。
廣義 SAM 是指把 SAM 搬到 Trie 樹上,類似於把 KMP 搬到 Trie 上變成 AC 自動機的原理,不過筆者不會 GSAM ,這裡不做過多討論。
偽廣義 SAM 是指把多串用特殊字元分隔開,拼在一起建立一個 SAM ,然後通過做特殊標記的方式區分各個串,並統計多串資訊。
譬如兩個串 「abcbc」 和 「cbcab」 拼接後變成 「abcbc{cbcab」(這裡用 「{」 分隔的原因是它的 ASCII 值緊隨 「z」 之後,方便寫程式碼)。
我們把它拼接在一起之後,情況就變成了這樣:
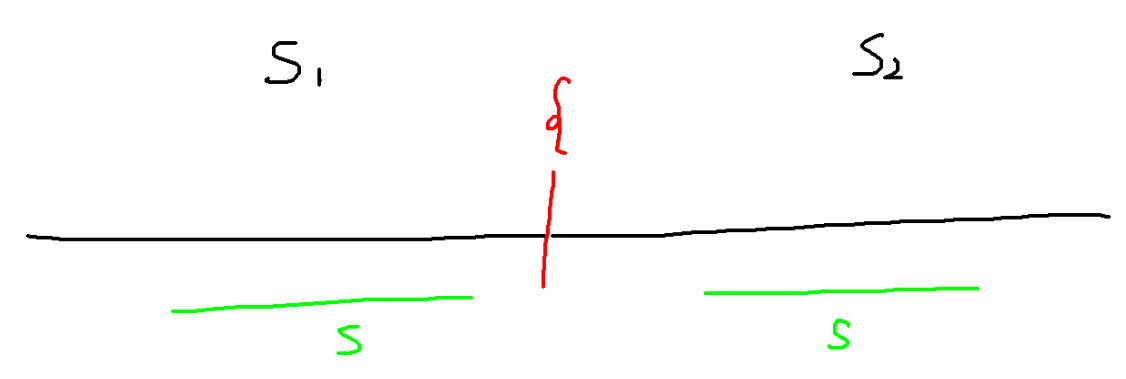
發現 「求公共子串」 變成了 「求出現 2 次及以上的最長子串」 ,這個利用 \(\text{endpos}\) 的定義可以很簡單的求出來。
寫好程式碼,交了一發,WA 掉了,為什麼呢?因為有這種毒瘤情況:
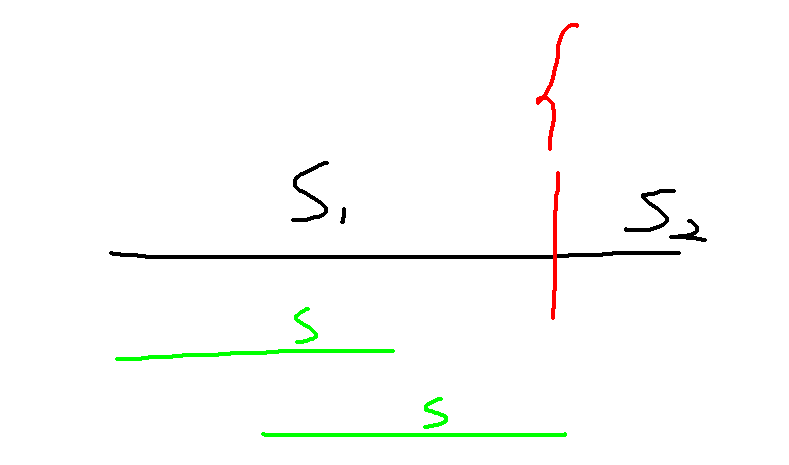
在這種情況下,這個出現兩次的串都來自 \(s_1\) ,不能算作 「公共子串」 ,但是我們的程式會把它統計上。
我們需要給來自 \(s_1,s_2\) 的串打上不同的標記,只有一個串的 \(\text{endpos}\) 內同時擁有兩種標記,它才可以嘗試去更新答案。
打標記和上傳標記的方式和 「統計子串」 一節中提到的方式相同,即:樹形 DP 。
這個演算法的複雜度瓶頸在於樹形 DP 的轉移,對於 \(T\) 個串我們就要上傳 \(T\) 種標記,花費 \(T\) 倍空間,不過由於這裡 \(T=2\) 所以可以忽略掉啦。
如果 \(T\) 更多導致時空複雜度不可以接受,可以把標記數組壓成一個 bitset ,帶 \(\frac{1}{w}\) 的常數( \(w\) 是電腦位長),這是一個相當不錯的優化。
總時間複雜度 \(O(\sum|s_i|+T\sum |s_i|)\) ,使用 bitset 則可以達到 \(O(\sum |s_i|+\frac{T\sum |s_i|}{w})\)。
Code
const int maxn=250005;

char s1[maxn],s2[maxn];
int ans;
struct Suffix_Automaton{
  int len[maxn<<2],link[maxn<<2];
  int ch[maxn<<2][27];
  bool f[maxn<<2][2];
  std::vector<int>v[maxn<<2];
  int last,siz;
  inline void init(){
    link[0]=-1;
    siz=last=0;
  }
  inline bool check(const int x){ return f[x][0]&f[x][1]; }//同時擁有兩種標記
  inline void extend(char *str,const int op){
    int n=std::strlen(str);
    for(int _=0;_<n;++_){
      int c=str[_]-'a',p=last,cur=++siz;
      len[cur]=len[p]+1;
      f[cur][op]=1;
      while(p!=-1 && !ch[p][c]){
        ch[p][c]=cur;
        p=link[p];
      }
      if(p==-1) link[cur]=0;
      else{
        int q=ch[p][c];
        if(len[q]==len[p]+1) link[cur]=q;
        else{
          int copy=++siz;
          len[copy]=len[p]+1;
          link[copy]=link[q];
          for(int i=0;i<27;++i) ch[copy][i]=ch[q][i];
          while(p!=-1 && ch[p][c]==q){
            ch[p][c]=copy;
            p=link[p];
          }
          link[q]=link[cur]=copy;
        }
      }
      last=cur;
    }
  }
  inline void dfs(const int x){
    for(int i=0;i<v[x].size();++i){
      int y=v[x][i];
      dfs(y);
      f[x][0]|=f[y][0],f[x][1]|=f[y][1];//合併所有兒子的標記
    }
    if(check(x)) ans=std::max(ans,len[x]);//更新答案
  }
}sam;

signed main(){
  scanf("%s%s",s1,s2);
  sam.init();
  sam.extend(s1,0);
  char qwq[1]={'{'};
  sam.extend(qwq,0);
  sam.extend(s2,1);
  for(int i=1;i<=sam.siz;++i) sam.v[sam.link[i]].push_back(i);
  sam.dfs(0);
  write(ans),putchar('\n');
  return 0;
}
Problem D 【TJOI 2015】弦論
題目鏈接:Link
-
給你一個字元串 \(s\) ,和兩個參數 \(t,k\) ,求 \(s\) 中字典序第 \(k\) 小的子串,若不存在,輸出 -1 。
若 \(t=0\) ,表示不同位置的相同子串算作一個。
若 \(t=1\) ,表示不同位置的不同子串算作多個。
-
\(1\leq |s|\leq 5\times 10^5,1\leq k\leq 10^9,0\leq t\leq 1\)
Solution
先構建 SAM 。我們知道,從 \(P\) 出發的 DAG 上的所有不同路徑構成了字元串的所有子串,那麼詢問相當於找到 DAG 中第 \(k\) 小的路徑。
考慮維護經過一個結點 \(v\) 的不同子串的數量,設為 \(f_v\) 。
在下面的過程中,初始的 \(u=P\) 。
-
初始的時候,要掃描 \(P\) 的每個兒子 \(v\) ,若 \(\sum f_v< k\) ,則無論如何也找不到 \(k\) 個不同的串,這說明無解,輸出 -1 。
-
假設現在在點 \(u\) ,枚舉 \(u\) 的每條出邊,假設出邊到達的結點是 \(v\) 。檢查經過 \(v\) 的串的數量 \(f_v\) 是不是大於 \(k\) ,如果大於等於 \(k\) ,說明走 \(v\) 結點至少可以找到 \(k\) 個串,也就是第 \(k\) 小的串經過了 \(v\) ,去 \(v\) 繼續尋找;否則說明經過 \(v\) 結點的不到 \(k\) 個串,第 \(k\) 小的串不經過 \(v\) 。如果 \(k\) 小串不經過 \(f_v\) ,那麼 \(k\) 要減去 \(f_v\) ,表示我們已經找到了 \(f_v\) 個串,還要再找 \(k-f_v\) 個(這類似於使用主席樹查詢 \(k\) 小的原理)。
-
如果在某個結點,\(k=0\) ,說明我們已經找到了答案,退出程式即可。
到這裡這個題就差不多了,現在考慮參數 \(t\) 對 \(f_v\) 的影響:
- 若 \(t=0\) ,那麼對於每個串 \(m\) ,它所有的出現只算一次,也就是把它的 \(\text{endpos}\) 集合大小視為 1 。
- 若 \(t=1\) ,那麼對於每個串 \(m\) ,它所有的出現每次都算,也就是按照正常的方式計算 \(\text{endpos}\) 大小。
最後一步,算 \(f_v\) 。根據定義,我們要求所有經過點 \(v\) 的路徑的終點結點的 \(\text{endpos}\) 大小的和,這可以通過拓撲或者記憶化搜索快速求出。
總時間複雜度 \(O(n)\) 。
Code
char ch[maxn];
int t,k;

int f[maxn<<1],g[maxn<<1];//f 意義同上,g 表示 endpos 大小
struct Suffix_Automaton{
  int link,len;
  int ch[27];
}SAM[maxn<<1];
int siz,last;
void SAM_extend(const int c){
  int cur=++siz,p=last;
  g[cur]=1;
  SAM[cur].len=SAM[p].len+1;
  while(p!=-1 && !SAM[p].ch[c]){
    SAM[p].ch[c]=cur;
    p=SAM[p].link;
  }
  if(p==-1) SAM[cur].link=0;
  else{
    int q=SAM[p].ch[c];
    if(SAM[q].len==SAM[p].len+1) SAM[cur].link=q;
    else{
      int copy=++siz;
      SAM[copy].len=SAM[p].len+1;
      SAM[copy].link=SAM[q].link;
      for(int i=0;i<26;++i) SAM[copy].ch[i]=SAM[q].ch[i];
      while(p!=-1 && SAM[p].ch[c]==q){
        SAM[p].ch[c]=copy;
        p=SAM[p].link;
      }
      SAM[q].link=SAM[cur].link=copy;
    }
  }
  last=cur;//正常構建 SAM
}
bool vis[maxn<<1];
std::vector<int>to[maxn<<1];
void dfs(const int x,const int type){
  for(int i=0;i<to[x].size();++i){
    int y=to[x][i];
    dfs(y,type);
    if(type) g[x]+=g[y];//根據參數 t 求出 endpos 的大小
    else g[x]=1;
  }
}
int memory_search(const int x){//記憶化搜索,求 f
  if(vis[x]) return f[x];
  vis[x]=1;
  for(int i=0;i<26;++i){
    int y=SAM[x].ch[i];
    if(y) f[x]+=memory_search(y);
  }
  f[x]+=g[x];//最後別忘了加上自己的 endpos 值!
  return f[x];
}
void Build_parent(const int type){
  for(int i=1;i<=siz;++i)
    to[SAM[i].link].push_back(i);//建立後綴樹
  dfs(0,type);
  g[0]=f[0]=0;//初始結點的 endpos 應該是空才對(雖然根據 SAM 的定義它應該是全集)
  memory_search(0);
}
void Query(const int x){
  if(k>f[x]){//實際上這個只有 x=P 的時候才會執行,因為 f[P] 最大,如果 k<f[P] ,那麼一定有解
    puts("-1");
    exit(0);
  }
  if(k<=g[x]) exit(0);//到這個點之後已經找到了 k 個串,退出
  k-=g[x];//減掉自身包含的串的數量
  for(int i=0;i<26;++i){
    int y=SAM[x].ch[i];//掃描每個兒子
    if(!y) continue;
    if(k>f[y]) k-=f[y];//減掉該兒子的 f 值
    else{
      putchar(i+'a');//目標串在這個兒子里,輸出這條轉移邊對應的字母
      Query(y);
    }
  }
}

signed main(){
  scanf("%s",ch);
  int len=std::strlen(ch);
  read(t),read(k);
  SAM[0].link=-1;
  for(int i=0;i<len;++i) SAM_extend(ch[i]-'a');
  Build_parent(t);
  Query(0);
  return 0;
}
Problem E 【AHOI 2013】差異
題目鏈接:Link
-
給定一個長度為 \(n\) 的字元串 \(S\) ,令 \(T_i\) 為它從第 \(i\) 個字元開始的後綴。求:
\[\sum_{1\leq i<j\leq n}\text{lenth}(T_i)+\text{lenth}(T_j)-2\times \text{lcp}(T_i,T_j) \]其中 \(\text{lenth}(a)\) 表示字元串 \(a\) 的長度,\(\text{lcp}(a,b)\) 表示字元串 \(a,b\) 的最長公共前綴。
-
\(1\leq n\leq 5\times 10^5\) 。
Solution
上面那個式子簡單來說就是求所有子串長度之和減去所有子串的最長公共前綴之和。
由於 \(\sum_{1\leq i <j\leq n}\text{lenth}(T_i)+\text{lenth}(T_j)\) 是定值,可以先求出它來,剩下要處理的就是 \(2\times \text{lcp}(T_i,T_j)\) 。
至於定值的求法,利用高中數學 「數列」 一節中的知識可以得到,前面的式子等價於 \(\frac{n^3-n}{2}\) 。
現在考慮 \(2\times \text{lcp}(T_i,T_j)\) 怎麼求,這個式子與 「所有子串」 相關,很自然的可以想到 SAM ,但是問題在於後綴樹求的是 「最長公共後綴」,並不是題目中所求的 「最長公共前綴」 。
這個時候,如果我們把整個串翻轉一下再插入 SAM ,就可以把 「最長公共後綴」 轉換成 「最長公共前綴」 了,這也是 SAM 相關題目中的一個常用做法。
前面我們提到,後綴樹上的每個結點包含的最長串是它不同子樹中任意兩個結點包含的所有串的最長公共後綴。那麼顯然可以考慮樹形 DP ,即把每個點作為 LCA 考慮,求出這個結點對答案的貢獻,然後對每個結點的貢獻求和,就是所需的答案了。
注意到這個方法其實會重複計入答案,也就是說 \(T_i,T_j\) 和 \(T_j,T_i\) 都對答案有貢獻,不過介於 \(T_i,T_j\) 和 \(T_j,T_i\) 的貢獻相同,而題目中所求恰好是 2 倍的貢獻。所以我們在求最後答案的時候,做樹形 DP 求出來的這個差值不用乘 2 ,直接用定值減去即可。
總複雜度 \(O(n)\) 。
Code
const int maxn=500005;

int lenth;
char ch[maxn];
struct Suffix_Automaton{
  int link,len;
  int ch[27];
}SAM[maxn<<1];
int siz,last;
int f[maxn<<1],g[maxn<<1],sumdif;//f 標記了 endpos ,g 是子樹求和
std::vector<int>Suffix_Tree[maxn<<1];//後綴樹
void SAM_extend(const int c){
  int cur=++siz,p=last;
  SAM[cur].len=SAM[p].len+1;
  f[cur]++;//標記
  while(p!=-1 && !SAM[p].ch[c]){
    SAM[p].ch[c]=cur;
    p=SAM[p].link;
  }
  if(p==-1) SAM[cur].link=0;
  else{
    int q=SAM[p].ch[c];
    if(SAM[q].len==SAM[p].len+1) SAM[cur].link=q;
    else{
      int copy=++siz;
      SAM[copy].len=SAM[p].len+1;
      SAM[copy].link=SAM[q].link;
      for(int i=0;i<26;++i) SAM[copy].ch[i]=SAM[q].ch[i];
      while(p!=-1 && SAM[p].ch[c]==q){
        SAM[p].ch[c]=copy;
        p=SAM[p].link;
      }
      SAM[q].link=SAM[cur].link=copy;
    }
  }
  last=cur;
}//SAM 板子

void DP_on_Suffix_Tree(const int x){
  g[x]=f[x];//先把子樹和賦值為自己的 endpos
  for(int i=0;i<Suffix_Tree[x].size();++i){
    int y=Suffix_Tree[x][i];
    DP_on_Suffix_Tree(y);
    g[x]+=g[y];//子樹求和
  }
  sumdif+=(g[x]-f[x])*f[x]*SAM[x].len;
  //先算自己和所有子樹之間產生的貢獻
  for(int i=0;i<Suffix_Tree[x].size();++i)
    sumdif+=g[Suffix_Tree[x][i]]*(g[x]-g[Suffix_Tree[x][i]])*SAM[x].len;
  //再算每一個子樹和根以及其他子樹的貢獻
}

signed main(){
  SAM[0].link=-1;
  scanf("%s",ch);
  std::reverse(ch,ch+(lenth=std::strlen(ch)));
  for(int i=0;i<lenth;++i) SAM_extend(ch[i]-'a');
  for(int i=1;i<=siz;++i) Suffix_Tree[SAM[i].link].push_back(i);
  //翻轉,建 SAM ,建後綴樹
  DP_on_Suffix_Tree(0);
  //DP
  write((lenth*lenth*lenth-lenth)/2-sumdif),putchar('\n');
  // write(pow(lenth,3)/2-sumdif),putchar('\n');
  //這樣寫就炸了 qwq
  return 0;
}
最後提示一下大家,大整數冪千萬不要偷懶使用 pow 函數。這是因為 pow 函數的實現基於牛頓迭代法,它求出的是一個逐漸逼近的近似解,如果答案過於巨大,便會由於精度問題,產生較大的誤差(別問我為什麼知道的,我對拍+Debug了 3h 才查出這個錯來)。
Part 6 尾聲
知識是無上限的,但是筆者的精力有。其實一開始我也只是想做一個簡單的總結,不過本著 「做學問要嚴謹」 的信條,為了講明白某些東西,這篇文章被一次又一次的加長、修改,直到今天的 18k 多字。
聯賽在即,退役在即,我不想就這麼無聲無息的離去。我希望在我 OI 生涯的最後一段時光里,留下點什麼……至少證明我存在過。
不知道以後看到這篇博文的我會不會對以前的自己豎起大拇指呢?不管怎麼說,2 年的 OI 生涯,總是一段難忘的時光。
修改了保送政策以後,現在大部分老師家長都把競賽扔進了垃圾堆,尤其是 OI 這種對文化課幾乎無幫助的科目。我在身邊人一遍又一遍重複著 「競賽無用」 的情況下,堅持了兩年。其實我心裡很清楚,我並不具備保送的資格和潛質,OI 於我來說確實好像無用,但是這又有什麼關係呢?
畢竟,人如果不趁著年輕去追求自己的熱愛,那要青春做什麼?這是一種熱愛,一種信仰,而不是單純的利益相關。
如果一個人是真正熱愛 OI 的話,那麼他應該是幸福的。因為他有機會放肆地去追求自己的熱愛並為其獻上最美好的年華。恰好,你我都是這樣的人。
僅以此文,獻給我的 17 歲。祝諸位 CSP 2021,NOIp 2021,rp++ 。
