transformers---BERT
transformers---BERT
BERT模型主要包括兩個部分,encoder和decoder,encoder可以理解為一個加強版的word2vec模型,以下是對於encoder部分的內容
預訓練任務
- MLM任務
MLM任務通過單詞表示來表示上下文關係 - NSP任務
NSP任務通過句子向量表示句間的關係
1. BERT模型的輸入
- wordpiece embedding 單詞向量
- position embedding 位置編碼向量
兩種生成方式:- 相對位置編碼\[PE_{(pos,2i)}=sin(\frac{pos}{10000^{\frac{2i}{model}}}) \]\[PE_{(pos,2i+1)}=cos(\frac{pos}{10000^{\frac{2i}{model}}}) \]
- 通過模型學習生成
- 相對位置編碼
- segment embedding 區分文中的上下句,應用在問答匹配中
2. self-attention
-
句子向量
\(\downarrow \ \ \ \ \downarrow\) -
Input Embedding + Position Embedding
\(\downarrow\) -
\[X_{embedding}\in R^{batch size\ *\ seq len\ *\ embed dim} \]
\(\downarrow\) 線性映射(學到多重含義,分配三個權重(\(W_Q,W_k,W_v\))
-
\(Q=Linear(X_{embedding})=X_{embedding}W_Q\)
\(K=Linear(K_{embedding})=K_{embedding}W_K\)
\(V=Linear(V_{embedding})=V_{embedding}W_V\)
\(\downarrow\) multi head atention(\(head size=embed dim/head size\)) -
\(Q,K,V \rightarrow[batch size,seq len,head size,embed dim/h\)
\((Q,K,V)^T \rightarrow[batch size,head size, seq len,embed dim/h]\)head_size:即多頭注意力機制中的head, \(head size=embed dim/head num\)
embed_size:句子中每個字的編碼向量的長度
seq_len:句子的長度
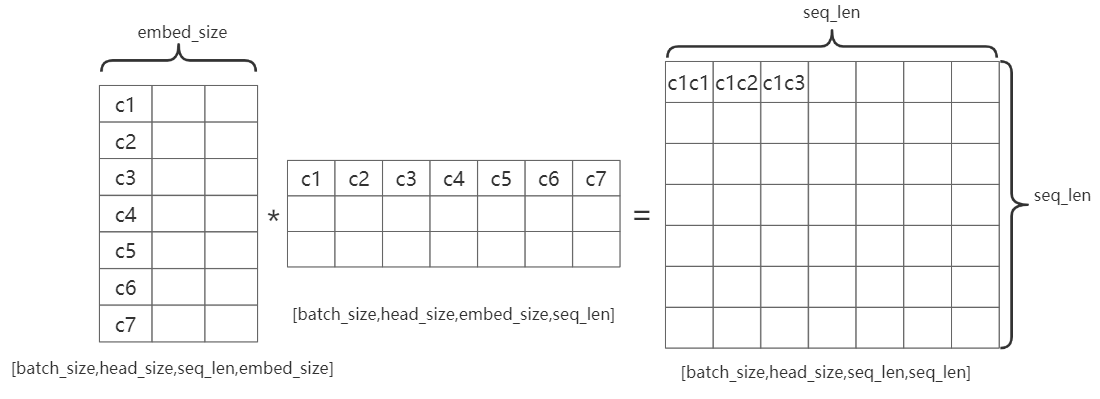
如圖:C1C2表示第一個字和第二個字的注意力機制結果
\(Attention(Q,K,V)=softmax(\frac{QK^T}{\sqrt{d_k}})V\)
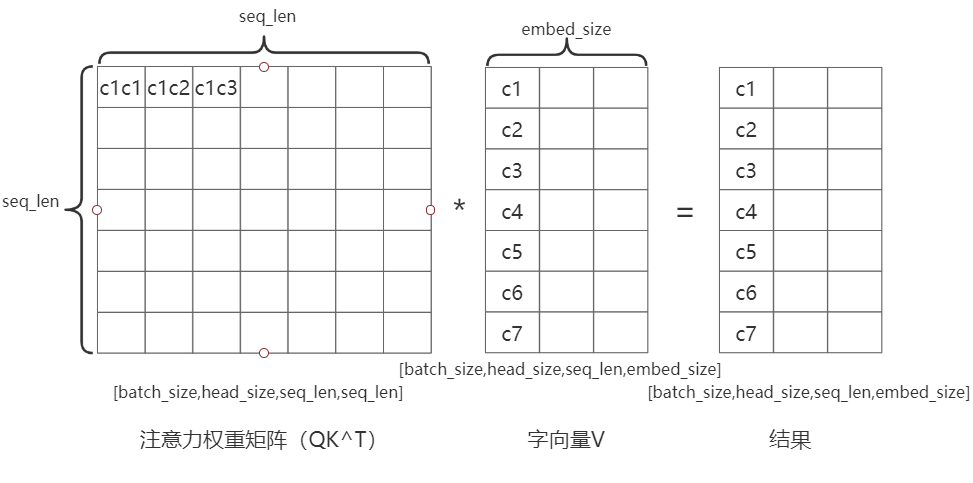
\(\frac{QK^T}{\sqrt{d_k}}\)的第一列和\(V\)的第一行決定了結果中的第一個值,這樣保證了結果向量中每個元素包含了該句中所有字的特徵note:
Attention mask
在encoder的過程中,輸入句子的\(seq len\)是不等長的,此時需要對句子進行補全,如果使用0補全,使用softmax函數\(softmax=\sigma(z)=\frac{e^{z_i}}{\sum^{k}_{j=1}e^{z_j}}\),e=0時,將導致補0的部分參與到運算中
解決辦法:給補0的部分添加偏置\(Z_{illeagl}=Z_{illeagl}+bias ,\ bias\rightarrow -\infty\)
此時,\(e^{-\infty}=0 ,\ e^{Z_{illegal}}=0\),便面了無效區參與運算。
3. Layer Normalization 殘差連接
- \(X=X_{embedding}+Attention(Q,K,V)\)

