Sentry 監控 - Snuba 數據中台架構簡介(Kafka+Clickhouse)
- 2021 年 10 月 9 日
- 筆記
系列
- 1 分鐘快速使用 Docker 上手最新版 Sentry-CLI - 創建版本
- 快速使用 Docker 上手 Sentry-CLI - 30 秒上手 Source Maps
- Sentry For React 完整接入詳解
- Sentry For Vue 完整接入詳解
- Sentry-CLI 使用詳解
- Sentry Web 性能監控 - Web Vitals
- Sentry Web 性能監控 - Metrics
- Sentry Web 性能監控 - Trends
- Sentry Web 前端監控 - 最佳實踐(官方教程)
- Sentry 後端監控 - 最佳實踐(官方教程)
- Sentry 監控 - Discover 大數據查詢分析引擎
- Sentry 監控 - Dashboards 數據可視化大屏
- Sentry 監控 - Environments 區分不同部署環境的事件數據
- Sentry 監控 - Security Policy 安全策略報告
- Sentry 監控 - Search 搜索查詢實戰
- Sentry 監控 - Alerts 告警
- Sentry 監控 - Distributed Tracing 分散式跟蹤
- Sentry 監控 - 面向全棧開發人員的分散式跟蹤 101 系列教程(一)
Snuba 是一種在 Clickhouse 之上提供豐富數據模型以及快速攝取消費者(直接從 Kafka 獲取數據)和查詢優化器的服務。
Snuba 最初的開發目的是取代 Postgres 和 Redis 的組合,以搜索和提供有關 Sentry 錯誤的聚合數據。從那時起,它已經演變成目前的形式,在多個數據集上支援大多數與時間序列相關的 Sentry 功能。
功能
- 為
Clickhouse分散式數據存儲提供資料庫訪問層。 - 提供一個圖形邏輯數據模型,客戶端可以通過
SnQL語言查詢,該語言提供類似於SQL的功能。 - 在單個安裝中支援多個單獨的數據集。
- 提供基於規則的查詢優化器。
- 提供一個遷移系統,將
DDL更改應用於單節點和分散式環境中的Clickhouse。 - 直接從
Kafka攝取數據 - 支援時間點查詢和流式查詢。
Sentry 中的一些用例:
events數據集為Issue Page等功能提供支援。此處的搜索功能由Snuba以及所有聚合(aggregation)函數提供支援。discover數據集為所有性能監控(Performance Monitoring)相關功能提供支援。sessions數據集為發布(Releases)功能提供支援。 具體來說,該數據集會攝取大量數據點並存儲預先聚合的數據,以允許對大量數據進行快速查詢。outcomes數據集為統計頁面(Stats page)提供支援。
開始使用 Snuba
這是在 Sentry 開發環境中快速啟動 Snuba 的指南。
必要條件
Snuba 假設如下:
- 一個
Clickhouse伺服器端點位於CLICKHOUSE_HOST(默認localhost)。 - 在
REDIS_HOST(默認localhost)上運行的redis實例。在埠6379上。
讓這些服務運行的快速方法是設置 sentry,然後使用:
sentry devservices up --exclude=snuba
請注意,Snuba 假設一切都在 UTC 時間運行。否則,您可能會遇到時區不匹配的問題。
Sentry + Snuba
在 ~/.sentry/sentry.conf.py 中添加/更改以下幾行:
SENTRY_SEARCH = 'sentry.search.snuba.EventsDatasetSnubaSearchBackend'
SENTRY_TSDB = 'sentry.tsdb.redissnuba.RedisSnubaTSDB'
SENTRY_EVENTSTREAM = 'sentry.eventstream.snuba.SnubaEventStream'
運行:
sentry devservices up
訪問原始 clickhouse client(類似於 psql):
docker exec -it sentry_clickhouse clickhouse-client
數據寫入表 sentry_local: select count() from sentry_local;
設置
設置可以在 settings.py 中找到
CLUSTERS:提供集群列表以及應該在每個集群上運行的主機名(hostname)、埠(port)和存儲集(storage sets)。每個集群也設置了本地與分散式(Local vs distributed)。REDIS_HOST:redis正在運行此處。
Snuba 架構概述
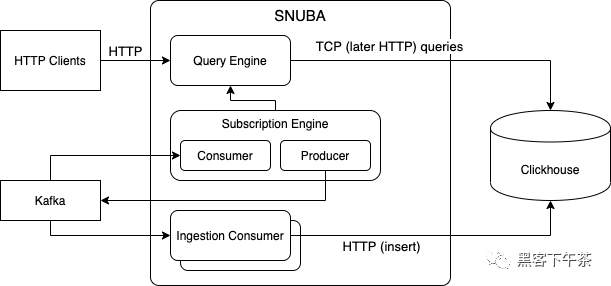
Snuba 是一個由 Clickhouse 支援的面向時間序列的數據存儲服務,它是一個列式存儲分散式資料庫,非常適合 Snuba 服務的查詢類型。
數據完全存儲在 Clickhouse 表和物化(materialized)視圖中,它通過輸入流(目前只有 Kafka topic)攝取,並且可以通過時間點查詢或流式查詢(subscriptions)進行查詢。
存儲
之所以選擇 Clickhouse 作為後備存儲,是因為它在 Snuba 需要的實時性能、分散式和複製性質、存儲引擎方面的靈活性和一致性保證之間提供了良好的平衡。
Snuba 數據存儲在 Clickhouse 表和 Clickhouse 物化視圖(materialized views)中。根據表的目標使用多個 Clickhouse 存儲引擎。
Snuba 數據組織在多個數據集中,這些數據集表示數據模型的獨立分區。更多細節見 Snuba 數據模型部分。
攝取
Snuba 不提供用於插入行的 api 端點(除非在調試模式下運行)。 數據從多個輸入流載入,由一系列消費者處理並寫入 Clickhouse 表。
一個 consumer 消費一個或多個 topic 並寫入一個或多個表。到目前為止,還沒有多個消費者寫入表。 這允許下面討論的一些一致性保證。
數據攝取(Data ingestion)在批處理中最有效(對於 Kafka 但尤其是對於 Clickhouse)。 我們的 consumer 支援批處理並保證從 Kafka 獲取的一批事件至少傳遞給 Clickhouse 一次。通過正確選擇 Clickhouse 表引擎對行進行重複數據刪除,如果我們接受最終一致性,我們可以實現恰好一次語義。
查詢
最簡單的查詢系統是時間點。查詢以 SnQL 語言(SnQL 查詢語言)表示,並作為 HTTP post 調用發送。 查詢引擎處理查詢(Snuba 查詢處理中描述的過程)並將其轉換為 ClickHouse 查詢。
流式查詢(通過訂閱引擎完成)允許客戶端以推送方式接收查詢結果。在這種情況下,HTTP 端點允許客戶端註冊流查詢。然後訂閱 Consumer 消費到用於填充相關 Clickhouse 表以進行更新的 topic,通過查詢引擎定期運行查詢並在訂閱 Kafka topic 上生成結果。
數據一致性
不同的一致性模型在 Snuba 中並存以提供不同的保證。
默認情況下,Snuba 是最終一致的。 運行查詢時,默認情況下,不能保證單調讀取(monotonic reads),因為 Clickhouse 是多領導者(multi-leader),查詢可以命中任何副本,並且不能保證副本是最新的。此外,默認情況下,不能保證 Clickhouse 會自行達到一致狀態。
通過強制 Clickhouse 在執行查詢之前達到一致性(FINAL keyword),並強制查詢命中 consumer 寫入的特定副本,可以在特定查詢上實現強一致性。這本質上使用 Clickhouse,就好像它是一個單一的領導系統(single leader system),它允許順序一致性(Sequential consistency)。
Sentry 部署中的 Snuba
本節解釋了 Snuba 在展示主要數據流的 Sentry 部署中扮演的角色。如果您單獨部署 Snuba,這對您沒有用處。

Errors 和 Transactions 數據流
圖表頂部的主要部分說明了 Events 和 Transactions 實體的攝取過程。這兩個實體為 Sentry 和整個 Performance 產品中的大多數問題/錯誤(issue/errors)相關功能提供服務。
只有一個 Kafka topic(events)在 errors 和 transactions 之間共享,為這條管道提供資訊。此 topic 包含 error 消息和 transaction 消息。
Errors consumers 使用 events topic,在 Clickhouse errors 表中寫入消息。提交後,它還會生成關於 snuba-commit-log topic 的記錄。
錯誤警報由 Errors Subscription Consumer 生成。這是同步消費者(synchronized consumer),它同時消費主 events topic 和 snuba-commit-log topic,因此它可以與主 consumer 同步進行。
synchronized consumer 然後通過查詢 Clickhouse 生成警報,並在 result topic 上生成結果。
transactions 存在於一個相同但獨立的管道。
Errors 管道還有一個額外的步驟:寫入 replacements topic。Sentry 在 events topic 上產生 Errors mutations(合併/取消合併/再處理/等等)。然後,Errors Consumer 將它們轉發到 replacements topic,並由 Replacement Consumer 執行。
events topic 必須按 Sentry project id 在語義上進行分區,以允許按順序處理項目中的事件。 目前為止,這是 alerts 和 replacements 的要求。
Sessions 與 Outcomes
Sessions 和 Outcomes 以非常相似和更簡單的方式工作。特別是 Sessions 增強 Release Health 功能,而 Outcomes 主要向 Sentry 統計頁面提供數據。
兩個管道都有自己的 Kafka topic,Kafka consumer,它們在 Clickhouse 中寫自己的表。
變更數據捕獲管道
這條管道仍在建設中。它使用 cdc topic 並填充 Clickhouse 中的兩個獨立表。

