【電腦組成原理】第2章 電腦系統的硬體結構
系統匯流排
匯流排的基本概念

❔ 為什麼要用匯流排
早期電腦外部設備少時大多采原分散連接方式,不易實現隨時增減外部設備。為了更好地解決I/O設備和主機之間連接的靈活性問題,電腦的結構從分散連接發展為匯流排連接。
🔔 知識點:
1️⃣ 匯流排是連接多個部件的資訊傳輸線,是各部件共享的傳輸介質。
2️⃣ 在某一時刻,只允許有一個部件向匯流排發送資訊,而多個部件可以同時從匯流排上接收相同的資訊。如果系統中有多個部件,那它們只能分時地向匯流排發送資訊
匯流排的分類

匯流排的特性及性能指標
匯流排特性
1️⃣ 機械特性:匯流排在機械連接方式上的一些特性(尺寸、形狀、引腳個數、排列順序……)
2️⃣ 電氣特性:匯流排的每一根傳輸線上訊號的傳遞方向和有效的電平範圍
3️⃣ 功能特性:匯流排中每根傳輸線的功能(地址、數據、控制訊號)
4️⃣ 時間特性:訊號與時序的關係
匯流排的性能指標
1️⃣ 匯流排寬度:數據線的根數(bit)
2️⃣ 匯流排頻寬:每秒傳輸最大位元組數(MBps)=匯流排工作頻率×匯流排寬度(bit/s)=匯流排工作頻率×(匯流排寬度/8)(B/s)= 匯流排寬度/匯流排周期(bit/s) = (匯流排寬度/8)/匯流排周期(B/s)
3️⃣ 時鐘同步/非同步:匯流排上數據與時鐘是否同步
4️⃣ 匯流排復用:地址線與數據線復用並在線路上分時傳輸地址訊號和數據訊號,可提高匯流排利用率
5️⃣ 訊號線數:地址匯流排、數據匯流排、控制匯流排的總和
6️⃣ 匯流排控制方式:突發工作、自動配置、仲裁、邏輯、計數
7️⃣ 其他指標:負載能力、電源電壓……
8️⃣ 匯流排周期:一次匯流排操作所需的時間(包括申請階段、定址階段、傳輸階段和結束階段),通常由若干個匯流排時鐘周期構成。
9️⃣ 匯流排的工作頻率:匯流排上各種操作的頻率,為匯流排周期的倒數。若匯流排周期=N個時鐘周期,則匯流排的工作頻率=時鐘頻率/N。實際上指一秒內傳送幾次數據。
1️⃣0️⃣ 匯流排的時鐘周期:即機器的時鐘周期。電腦有一個統一的時鐘,以控制整個電腦的各個部件,匯流排也要受此時鐘的控制。
1️⃣1️⃣ 匯流排的時鐘頻率:即機器的時鐘頻率,為時鐘周期的倒數。若時鐘周期為T,則時鐘頻率為1/T。實際上指一秒內有多少個時鐘周期。
🔔 注意:
1️⃣ 匯流排頻寬是指匯流排本身所能達到的最高傳輸速率。
2️⃣ 在計算實際的有效數據傳輸率時,要用實際傳輸的數據量除以耗時。
匯流排標準

匯流排結構
單匯流排結構

雙匯流排結構

三匯流排結構

匯流排控制
匯流排判優控制
主設備:獲得匯流排控制權的設備。
從設備:被主設備訪問的設備,只能響應從主設備發來的各種匯流排命令。

🌈 鏈式查詢


🌈 計數器定時查詢


🌈 獨立請求方式


匯流排通訊控制
1️⃣ 目的:解決通訊雙方 協調配合問題
2️⃣ 匯流排傳輸周期

🌈 匯流排通訊的四種方式

🌈 同步通訊方式

🌈 非同步通訊方式
1️⃣ 分類

2️⃣ 優缺點

3️⃣ 數據傳輸率

🌈 半同步通訊方式

🌈 分離式通訊

存儲器
存儲器分類

存儲器的層次結構
存儲器三個主要特性的關係
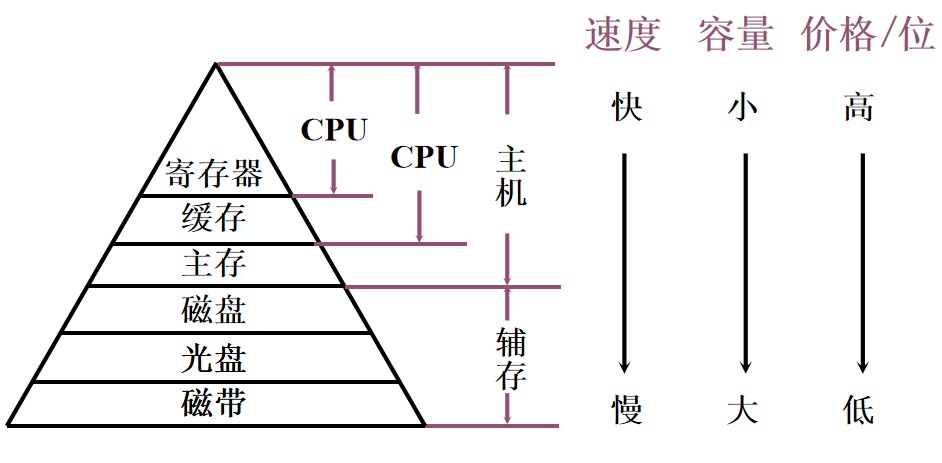
快取——主存層次和主存——輔存層次
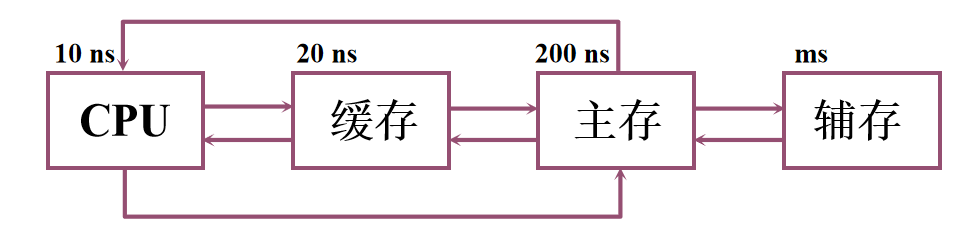
1️⃣ 快取——主存層次主要解決CPU和主存速度不匹配的問題
2️⃣ 主存——輔存主要解決存儲系統的容量問題
3️⃣ 主存——輔存層次發展形成虛擬存儲系統。
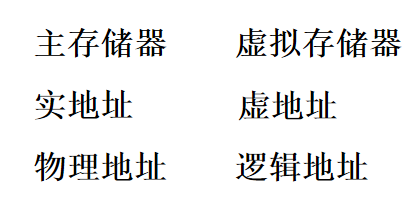
主存儲器
概述
主存的基本組成
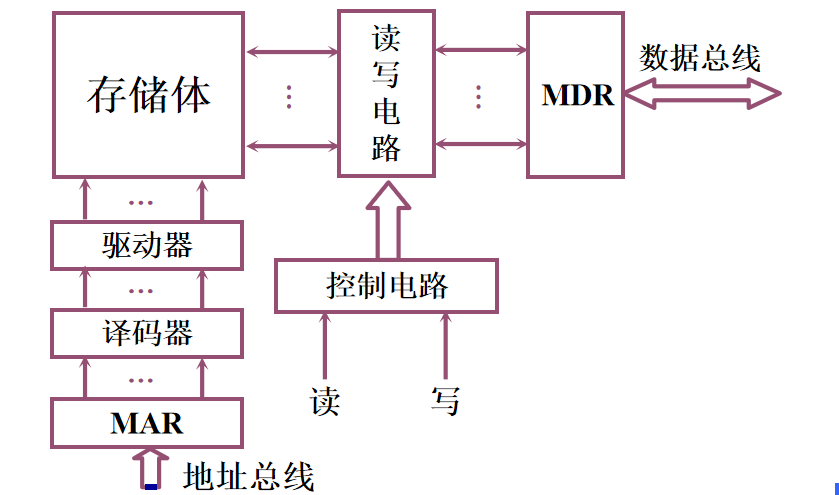
主存和CPU的聯繫
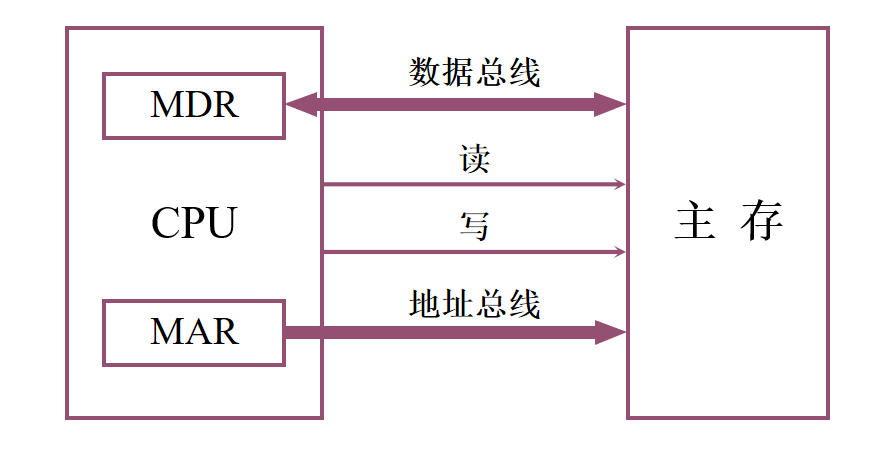
1️⃣ 驅動器、解碼器和讀寫電路在存儲晶片中
2️⃣ MAR和MDR在CPU晶片中
3️⃣ 存儲晶片和CPU晶片可通過匯流排連接
主存中存儲單元地址的分配
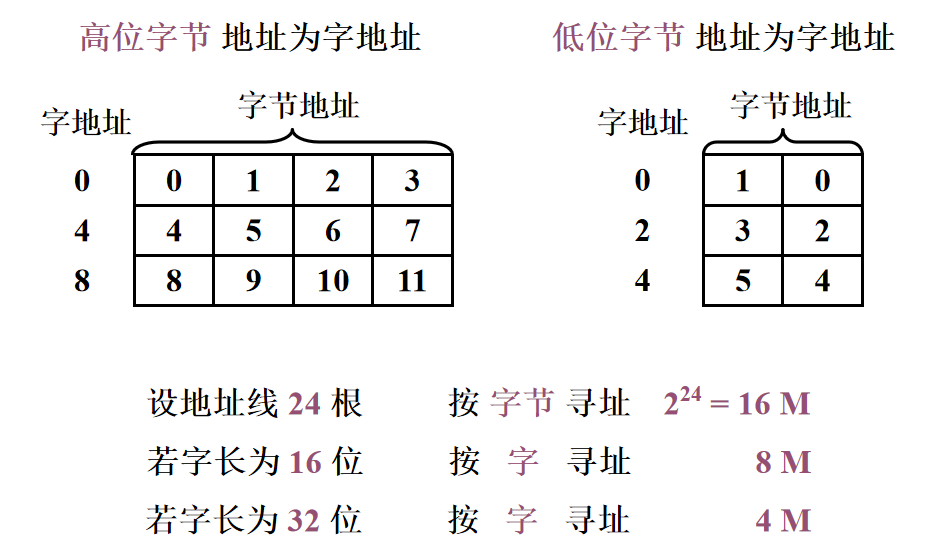
主存的技術指標
1️⃣ 存儲容量:主存存放二進位程式碼的總位數,存儲容量(位)=存儲單元個數*存儲字長,存儲容量(位元組)=存儲單元個數*存儲字長 / 8
2️⃣ 存儲速度
- 存取時間:存儲器的訪問時間=讀出時間+寫入時間
- 存取周期:連續兩次獨立的存儲器操作(讀或寫)所需的 最小間隔時間
3️⃣ 存儲器的頻寬:單位時間記憶體儲器存取的資訊量,每個存儲周期可以訪問的位(位元組)數 / 存儲周期
提高存儲器頻寬的措施
- 縮短存儲周期
- 增加存儲字長
- 增加存儲體
半導體存儲晶片簡介
半導體存儲晶片的基本結構
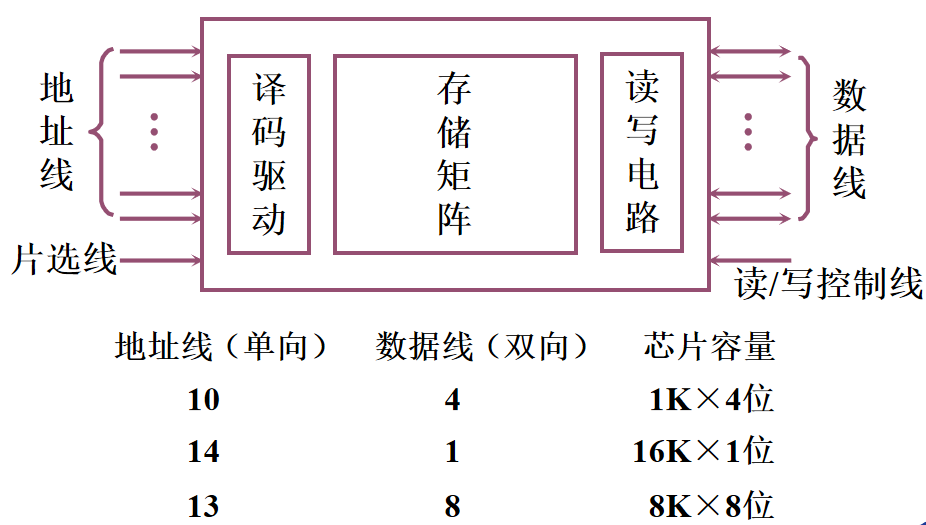
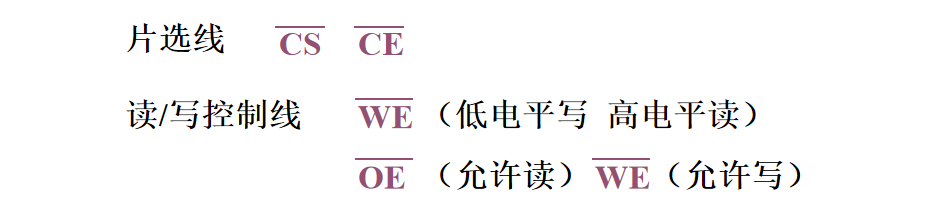
1️⃣ 地址線:單向輸入,位數與存儲字的個數有關
2️⃣ 數據線:雙向的,位數與讀/寫的數據位數有關
3️⃣ 控制線
- 讀/寫控制線:決定晶片進行讀/寫操作
- 片選線:選擇存儲晶片
半導體存儲晶片的解碼驅動方式
🌈 線選法
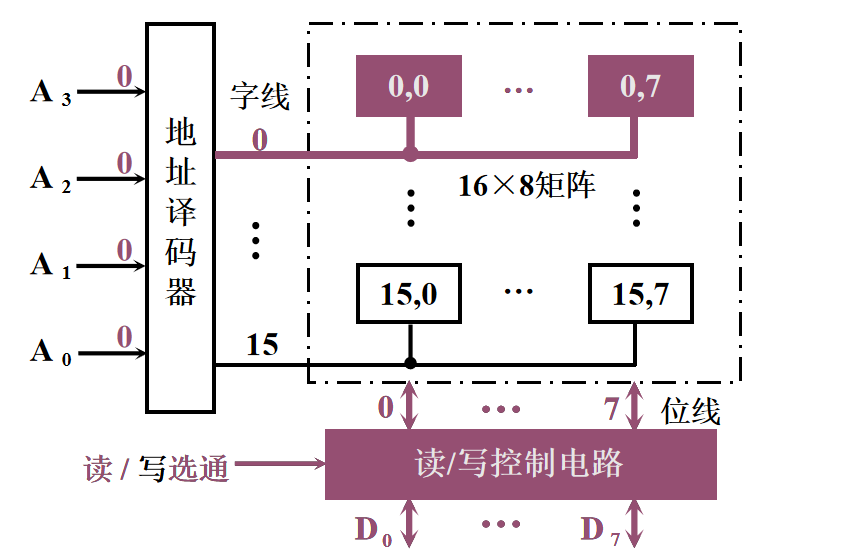
1️⃣ 特點:一根字選擇線(字線),直接選中一個存儲單元的各位
2️⃣ 結構簡單,只適於容量不大的存儲晶片
🌈 重合法
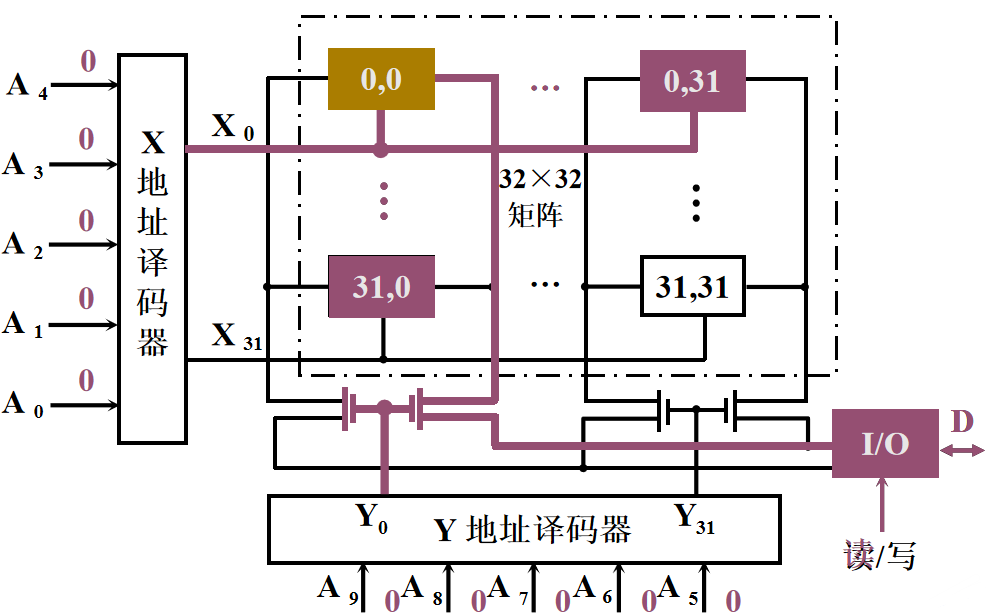
1️⃣ 特點:被選單元是由X、Y兩個方向的地址決定的
2️⃣ 適合容量較大的存儲晶片
隨機存取存儲器 ( RAM )
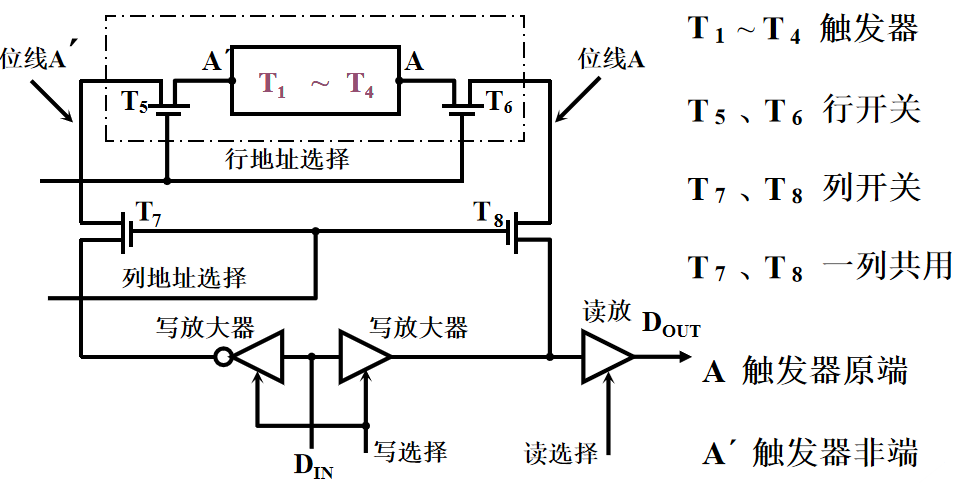
靜態 RAM (SRAM)
基本電路
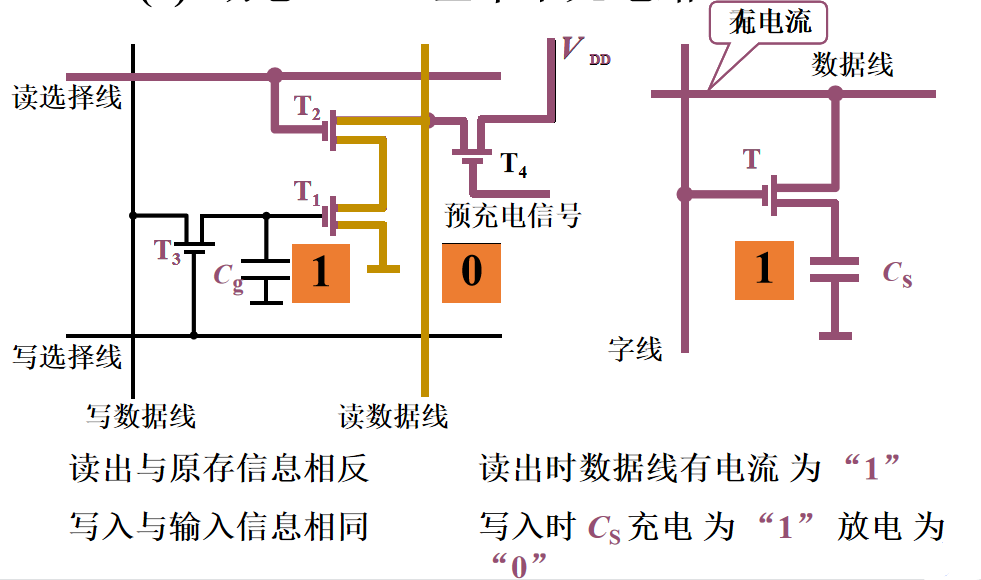
動態 RAM ( DRAM )
基本電路
動態 RAM 刷新
1️⃣ 多久需要刷新一次:刷新周期一般為 2 ms
2️⃣ 每次刷新多少存儲單元:以行為單位,每次刷新一行存儲單元
————為什麼要使用行列地址:減少選通線的數量
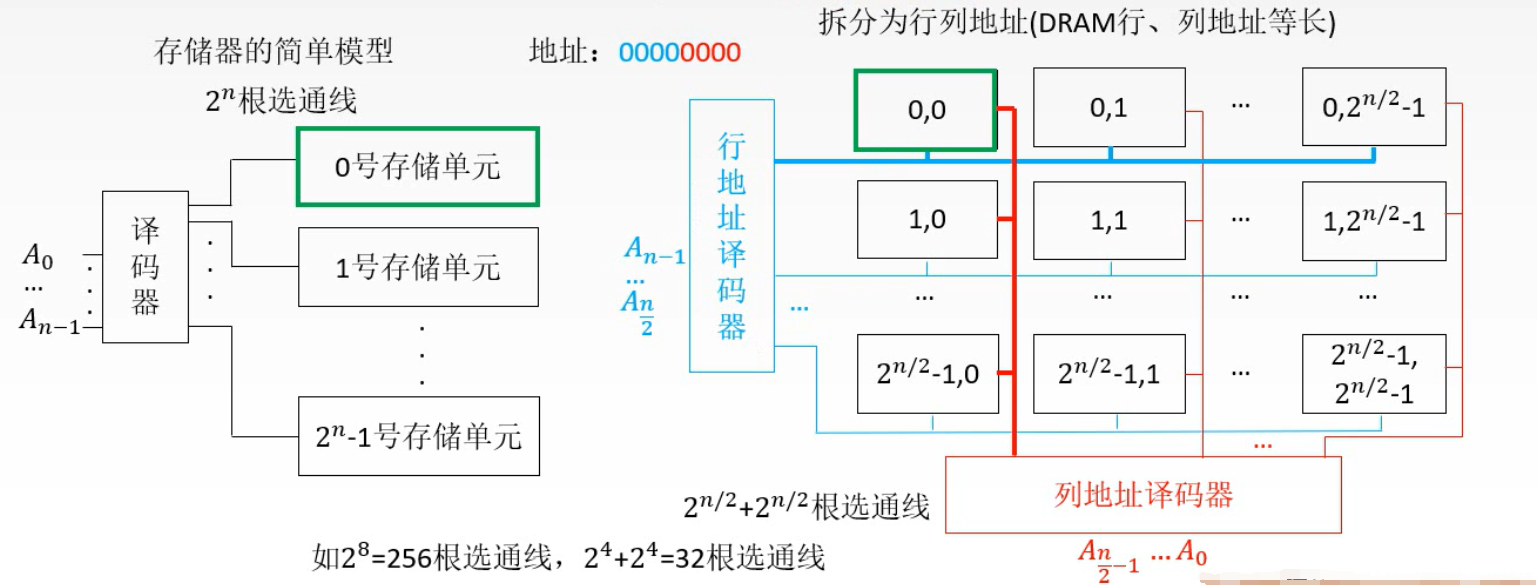
3️⃣ 如何刷新:有硬體支援,讀出一行的資訊後重新寫入,佔用1個讀/寫周期
4️⃣ 在什麼時候刷新:

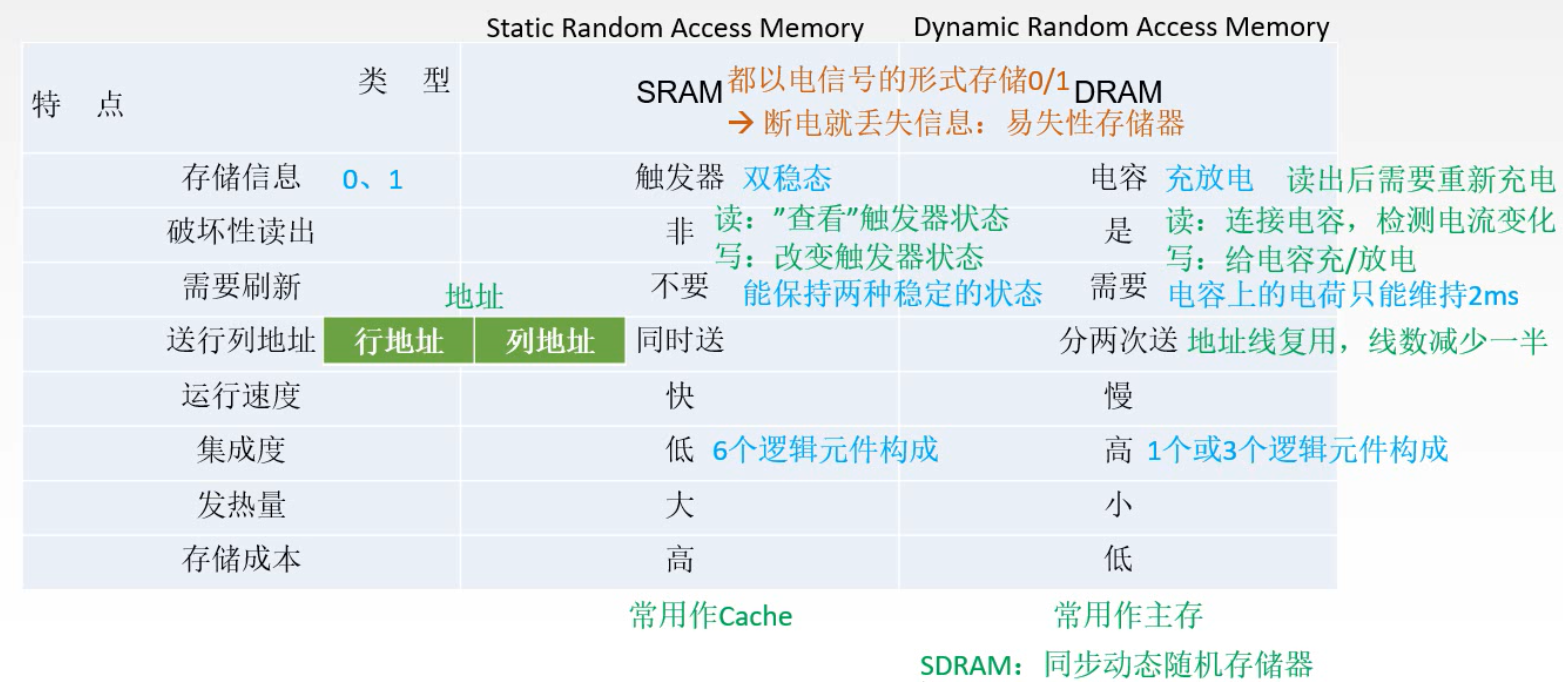
動態 RAM 和靜態 RAM 的比較
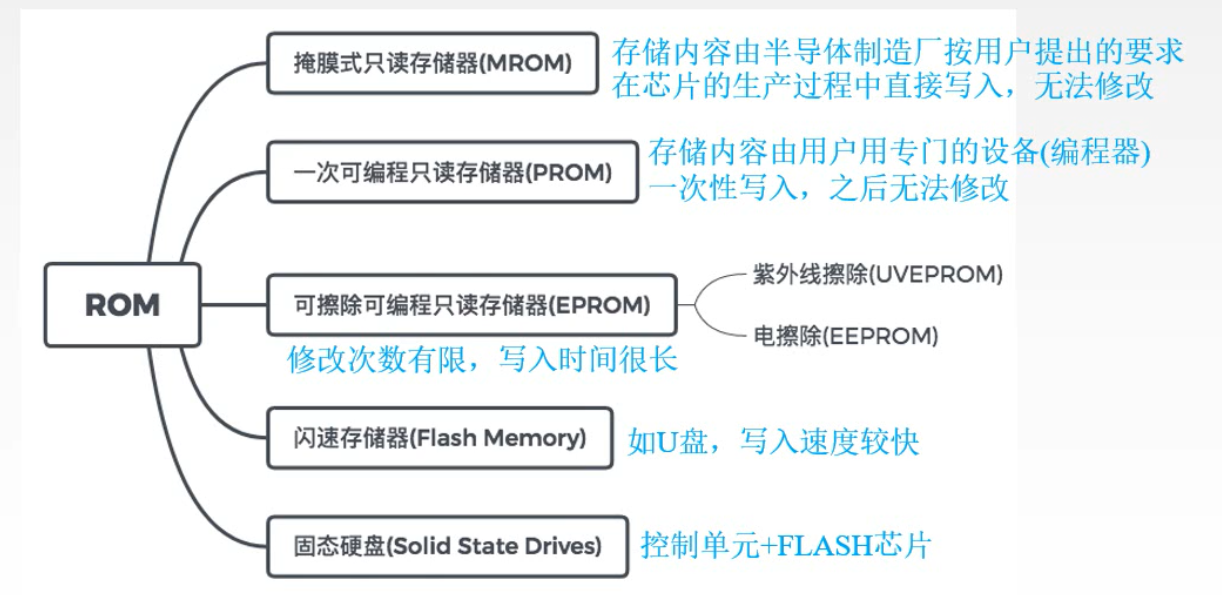
只讀存儲器(ROM)
存儲器與 CPU 的連接
存儲器容量的擴展
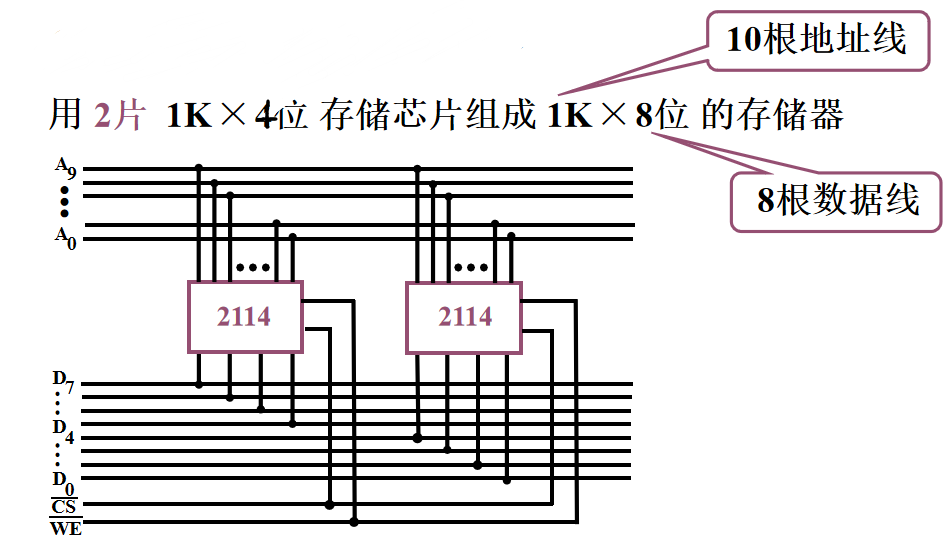
位擴展(增加存儲字長)
片選線相同,分配數據線
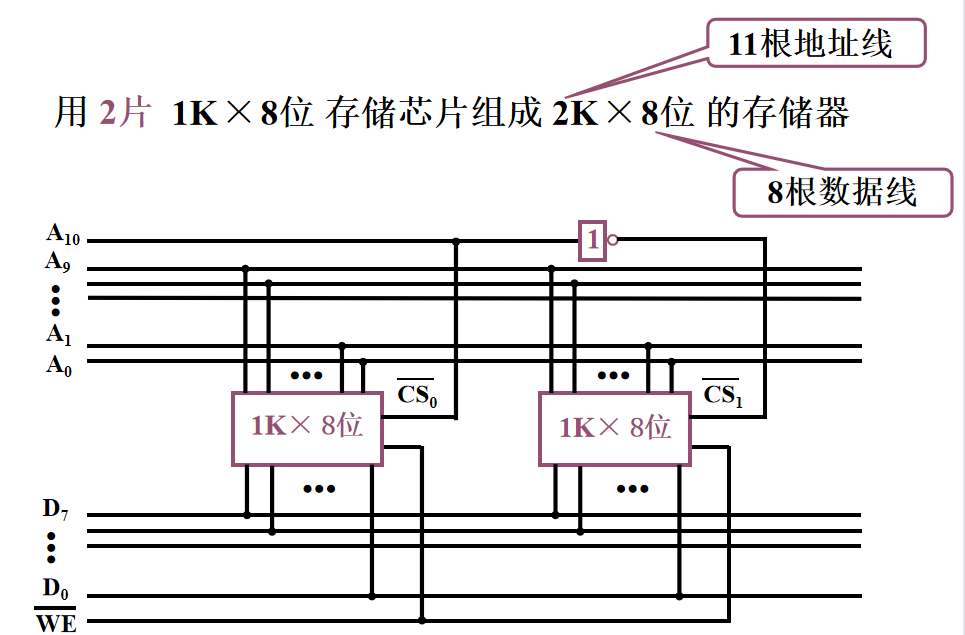
字擴展(增加存儲字的數量)
數據線相同,設置片選線
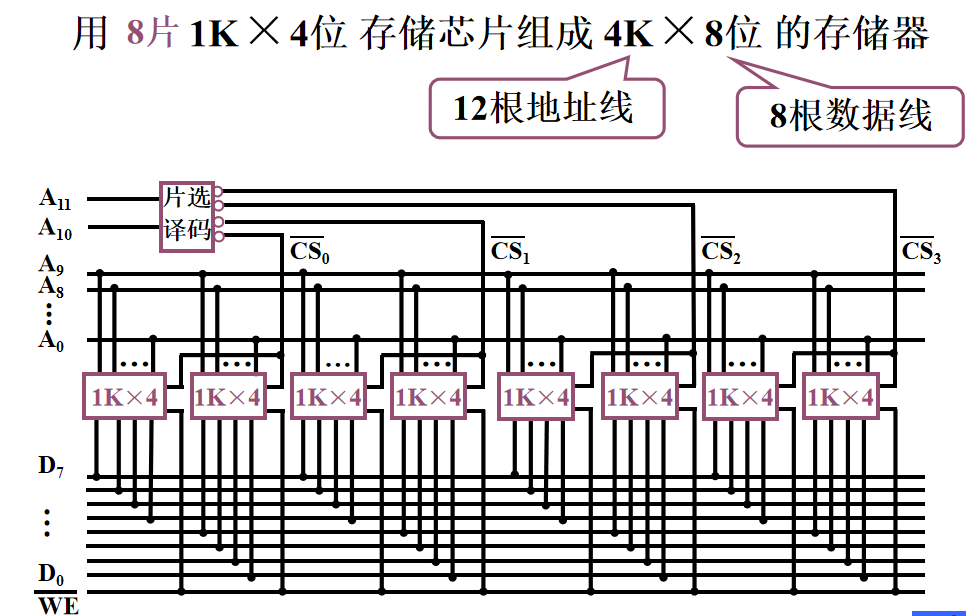
字、位同時擴展
數據線和片選線都要重新考慮
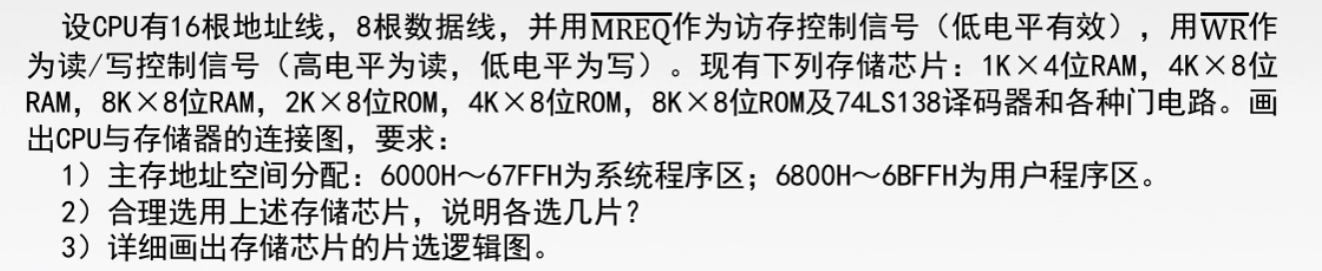
例題以及解題步驟
🔔 系統程式區用ROM,用戶程式區用RAM
1️⃣ 寫出對應的二進位地址碼
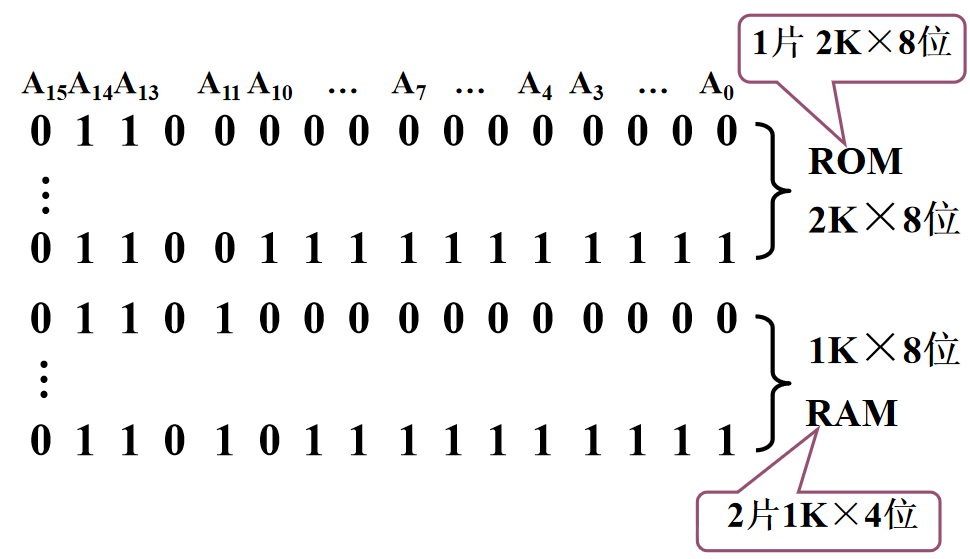
:two: 確定晶片的數量及類型
由題目知 CPU 數據線8根,則存儲器位數應擴展為8位。再根據題目所給的存儲晶片
系統程式區選擇一片 2 K * 8 位的存儲晶片
用戶程式區選擇兩片 1 K * 4 位的存儲晶片
3️⃣ 分配地址線
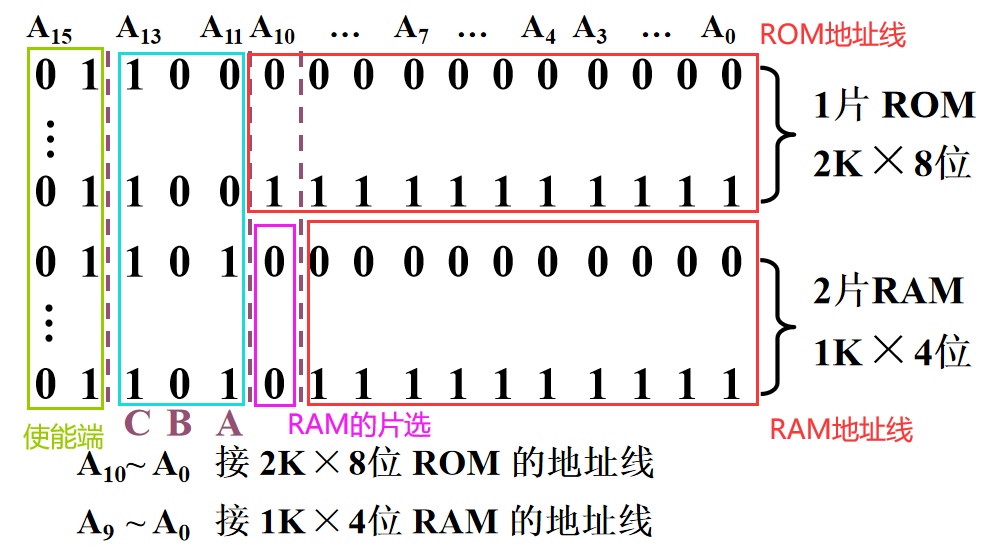
4️⃣ 確定片選訊號
RAM 是位拓展,共享片選線,分配數據線
而 ROM 和 RAM 需要考慮片選線的設置
解碼器的 Y4 端可以作為 ROM 的片選線埠
解碼器的 Y5 端和 RAM 的 A10 地址線可以聯合作為 RAM 的片選控制
🔔 有一個默認的原則:不要有任何地址線空著不用!!!
5️⃣ 連接圖
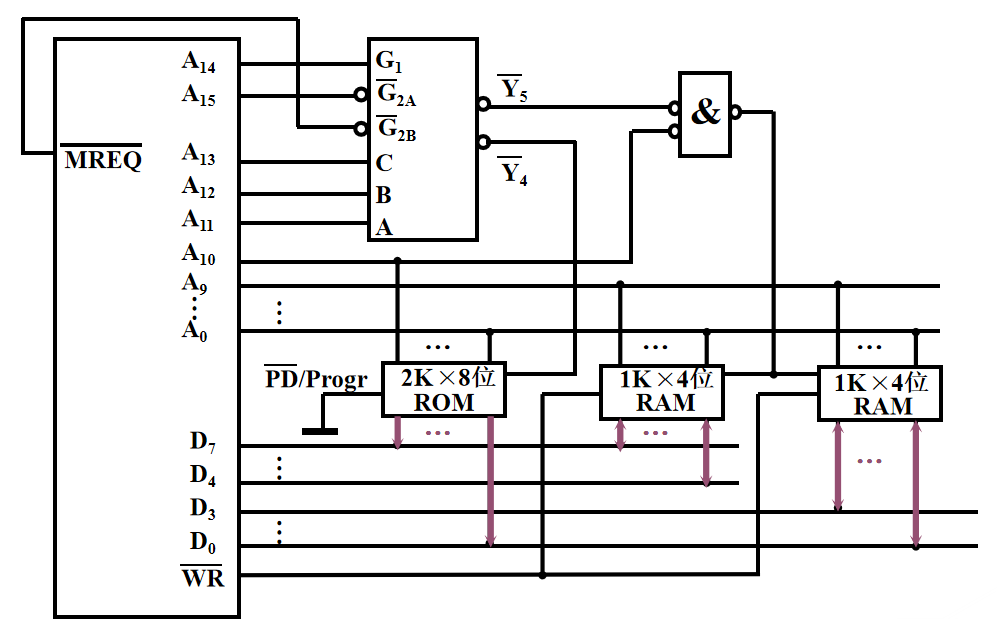
6️⃣ 注意的細節
ROM 要接地
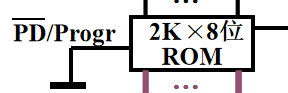
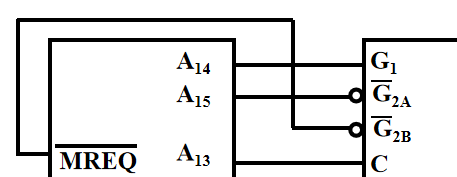
與門都取了非,也就是說輸入的數據都為 0 時,輸出為 1
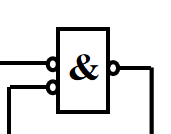
RAM 的地址線分配,RAM 要連接讀寫控制線 WR

使能端只有輸入訊號為 G1 G2A G2B: 1 0 0 時才工作
真題
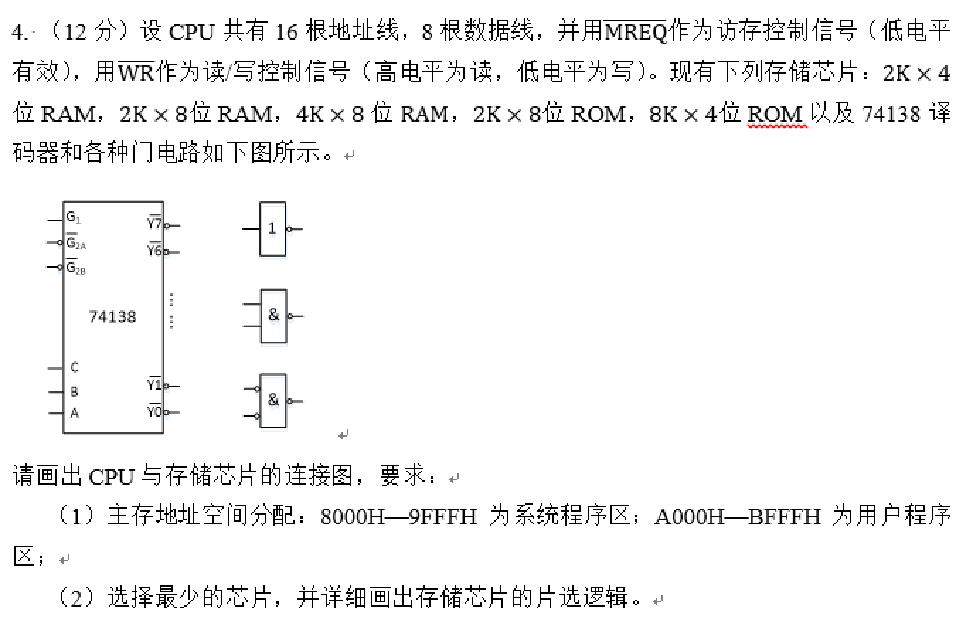
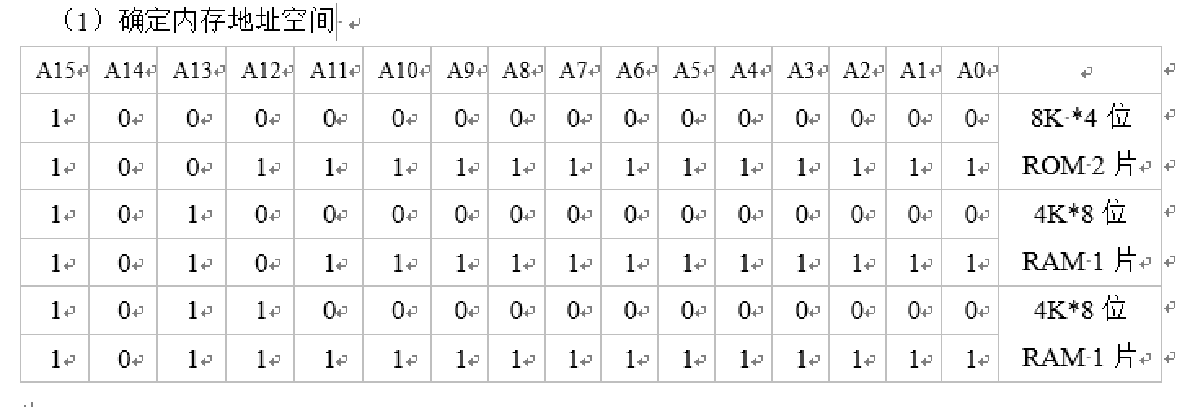
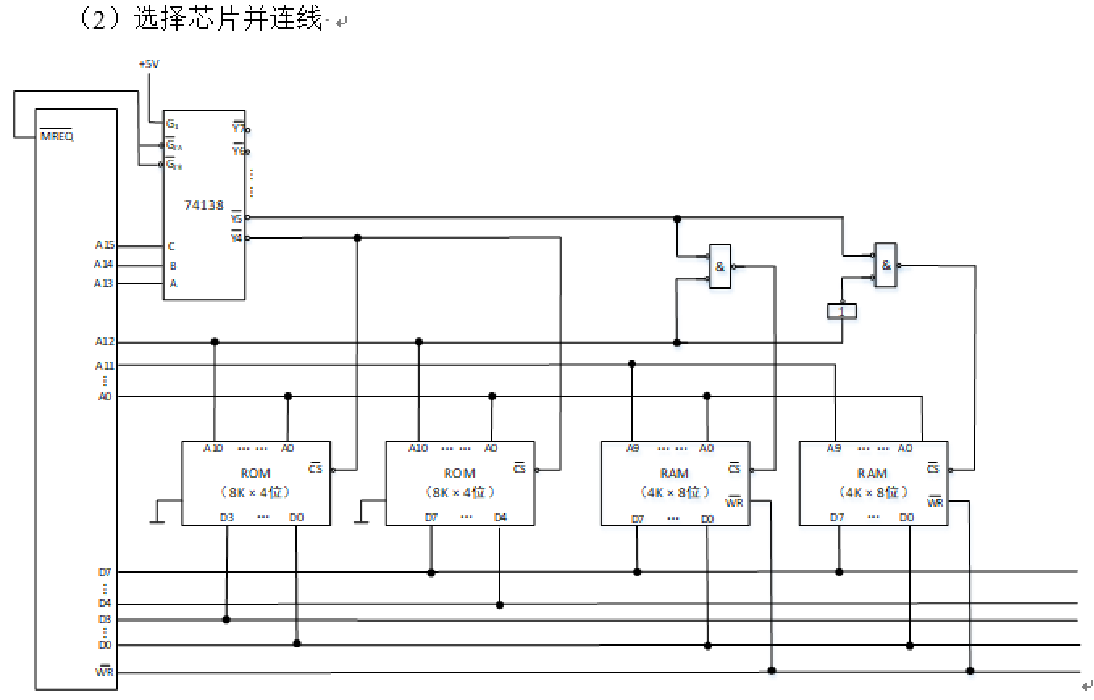
該題與上一個題的區別就是 RAM 是字拓展而不是位拓展,所以數據線相同,片選線要配置,用 A12 作為劃分
存儲器的校驗
海明碼
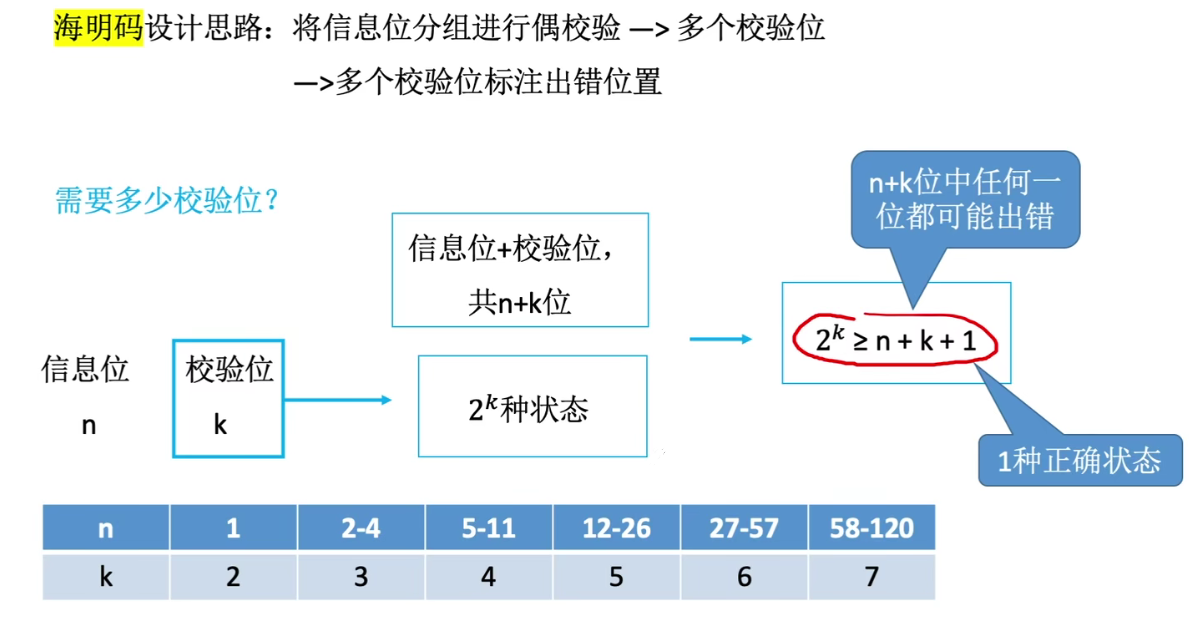
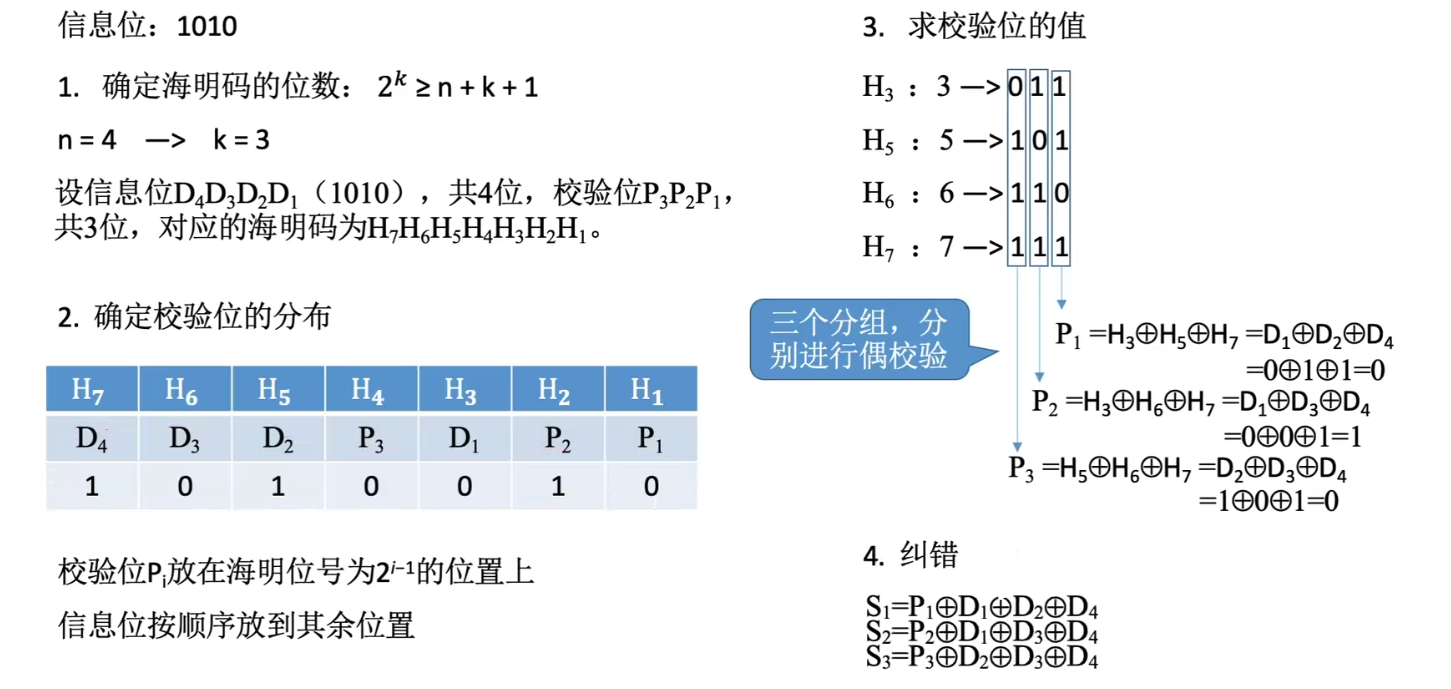

🔔 默認是偶校驗,如果題目要求是奇校驗,那不論是求海明碼還是糾錯,每個運算最後都要多異或一個 1 。
提高訪存速度的措施
-
採用高速器件
-
採用層次結構 Cache - 主存
-
調整主存結構
單體多字系統
普通存儲器:每行為一個存儲單元
🌈 單體多字存儲器
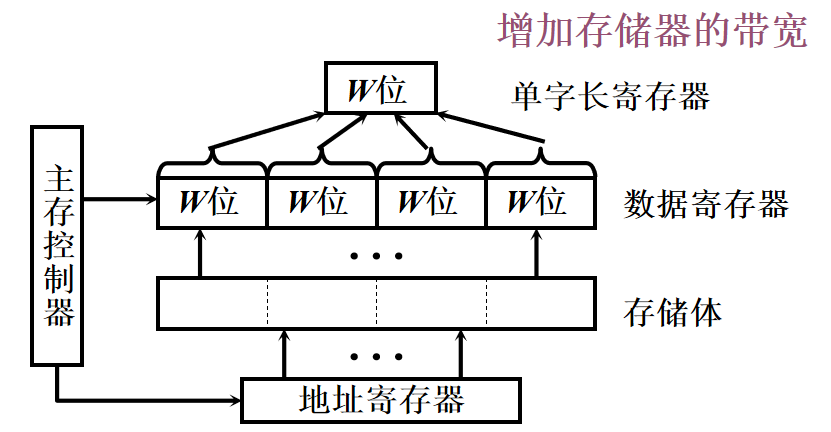
每個存儲單元存儲 m 個字,每個字 w 位,匯流排寬度為 m 個字。一個存取周期內可以讀出 m 個字,也就是 m * w 位的指令或數據,使主存頻寬提高到 m 倍
🔔 缺點:指令和數據在主存內必須是連續存放的,一旦遇到轉移指令,或者操作數不能連續存放,這種方法的效果就不明顯
多體並行系統

-
高位交叉(順序存儲)
-
存儲體的存儲單元通過地址的高位進行分組,高位地址相同的存儲單元屬於同一個存儲體
-
CPU 有較大概率需要連續訪問同一個存儲體,效率較低
-
-
低位交叉(交叉存儲)
-
存儲體的存儲單元通過地址的低位進行分組,低位地址相同的存儲單元屬於同一個存儲體
-
CPU 可以較大概率同時訪問多個存儲體,效率高,屬於流水線方式
-
可以在不改變每個模組存取周期的前提下,提高存儲器的頻寬
-
可以並行工作,如匯流排寬度為 mw 時,可以同時取出長度為 mw 的數據。等同於高位交叉存儲方式的 m 個存儲體並行工作
-
流水線的概念
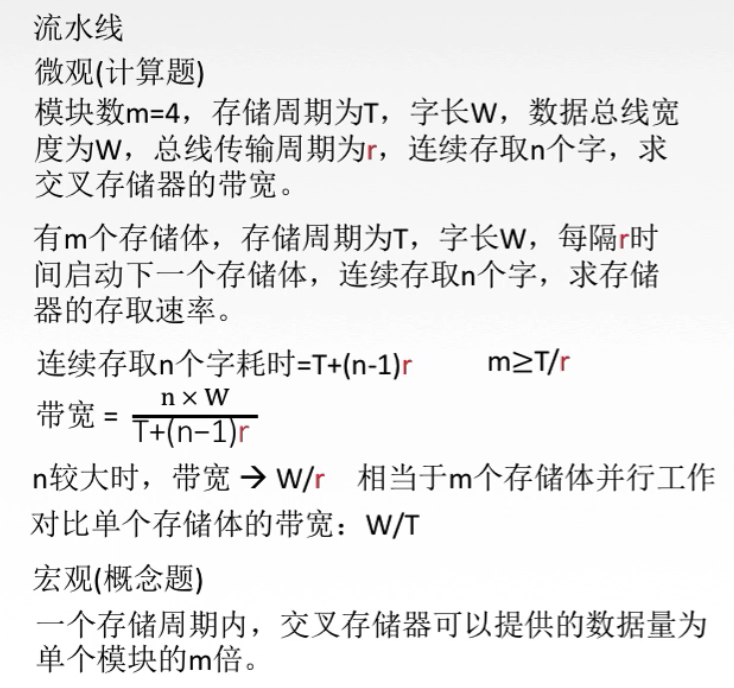
例題
設有 4 個模組組成的四體存儲器結構,每個體的存儲字長為 32 位,存儲周期為 200 ns。假設數據匯流排寬度為 32 位,匯流排傳輸周期為 50 ns,試求順序存儲和交叉存儲的存儲器頻寬。
解:順序存儲和交叉存儲連續讀出 4 個字的資訊量是 32 * 4 = 128 位。
順序存儲器連續讀出 4 個字的時間是 200 ns * 4 = 800 ns
交叉存儲其連續讀出 4 個字的時間是 200 ns + 50 ns * (4 - 1) = 350 ns
順序存儲器的頻寬是 128 b / 800 ns = 16 * 10 ^ 7 bps
交叉存儲器的頻寬是 128 b / 350 ns = 37 * 10 ^ 7 bps
高速緩衝存儲器
概述
局部性原理
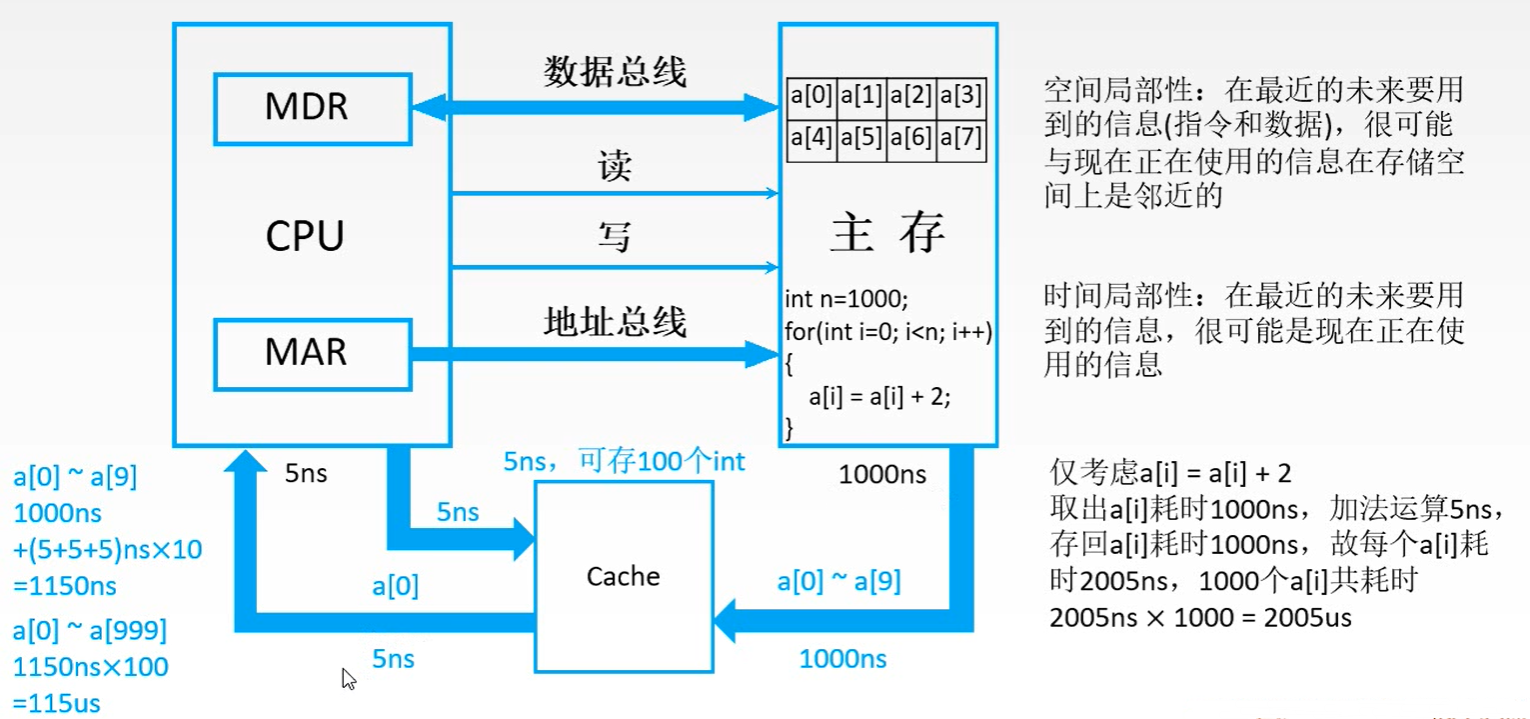
CPU 和主存(DRAM)的速度存在差異,為了避免 CPU 可能存在的「空等」現象
性能分析
1️⃣ 命中:
1.主存塊調入快取
2.主存塊與快取塊建立了對應關係
3.用標記記錄與某快取塊建立了對應關係的主存塊號
2️⃣ 未命中:
1.主存塊未調入快取
2.主存塊與快取塊未建立對應關係
3️⃣ Cache 的命中率:
1.CPU 欲訪問的資訊在 Cache 中的 比率
2.命中率 與 Cache 的 容量 與 塊長 有關
4️⃣ 主存系統的效率
1.效率 e 與 命中率 有關
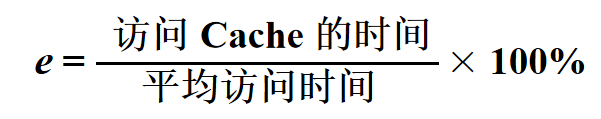
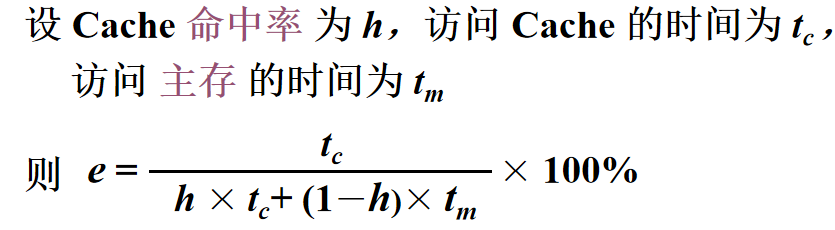
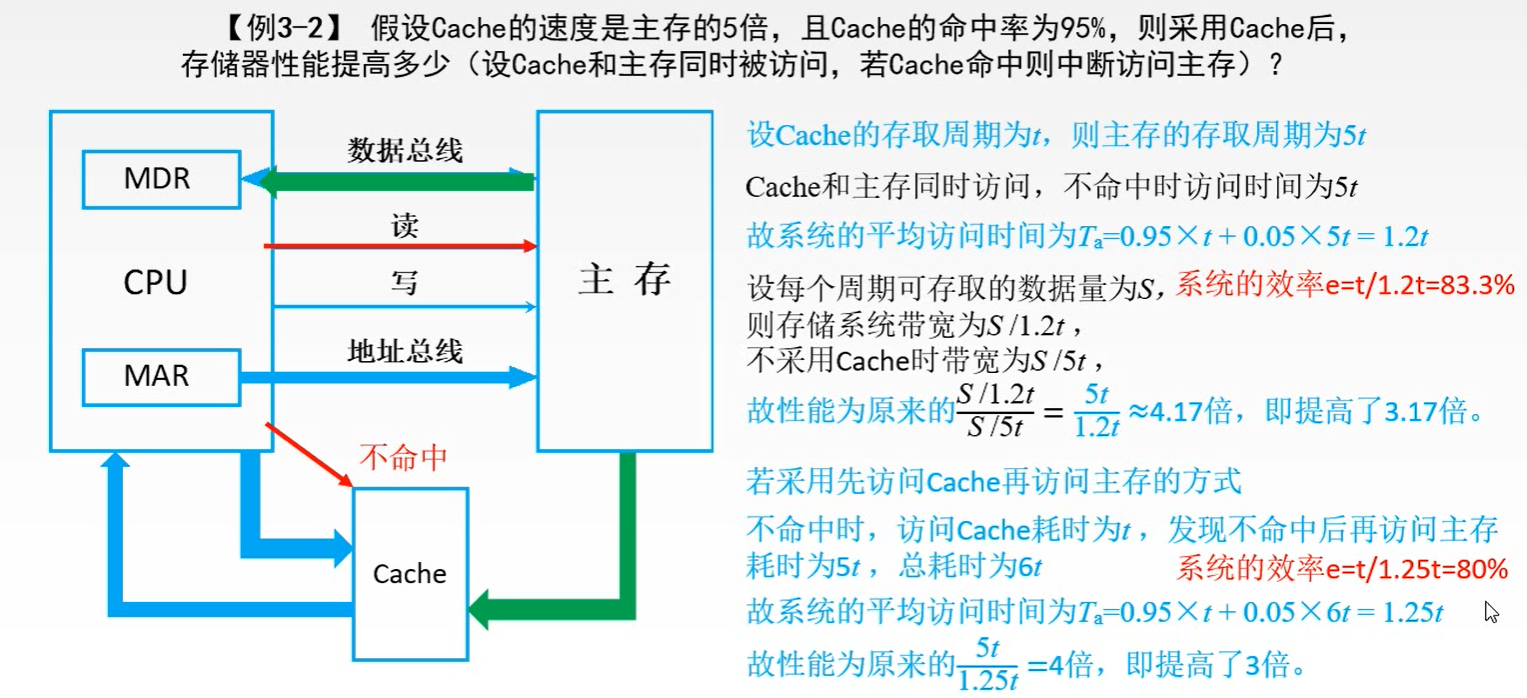
🌈 例題
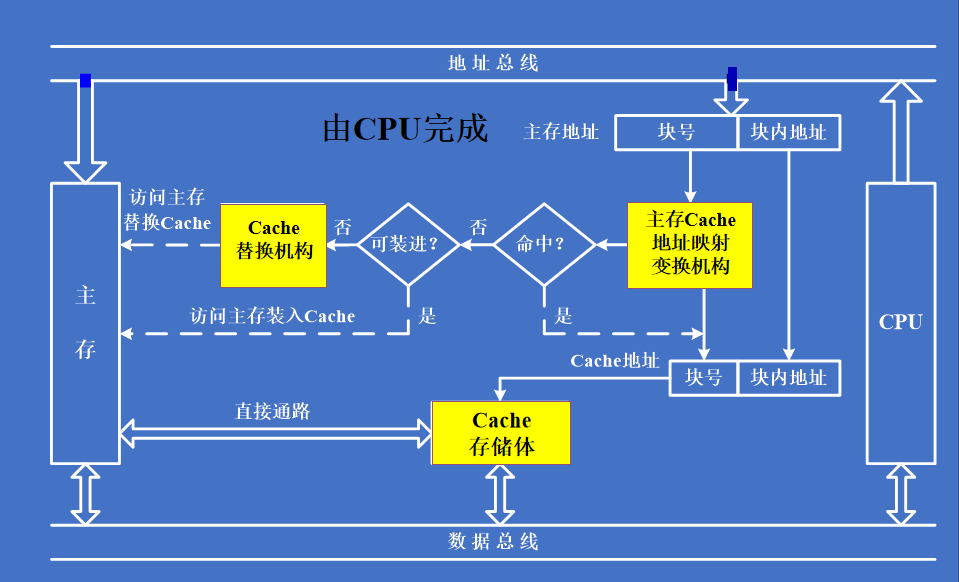
Cache 的基本結構
Cache 的讀寫操作
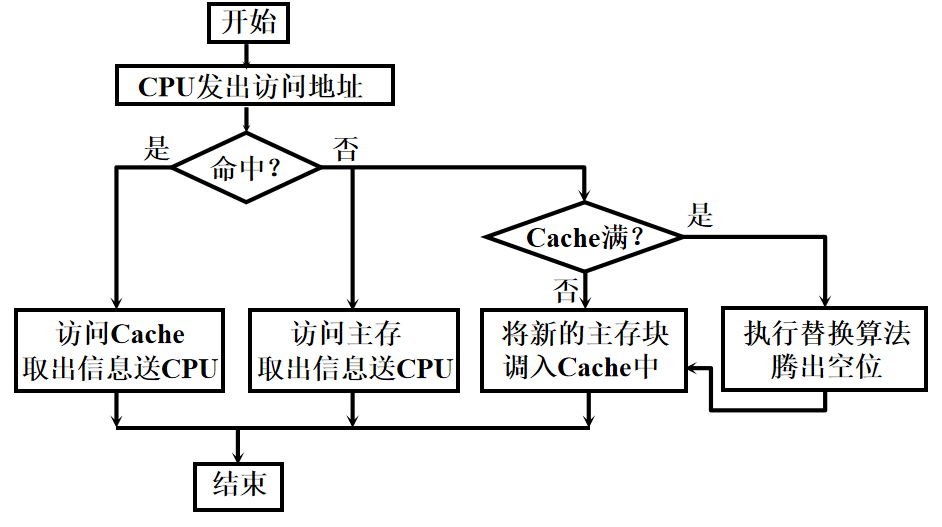
🌈 讀
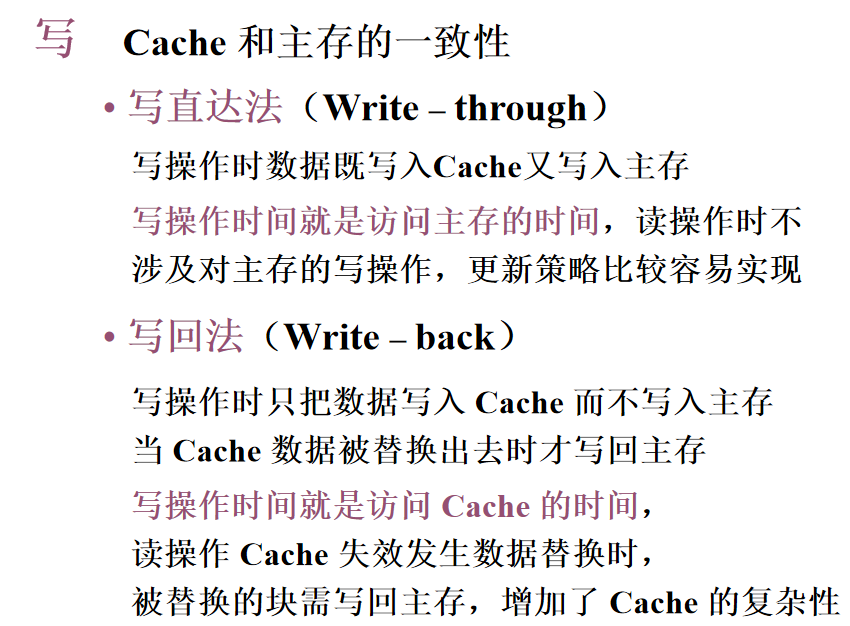
🌈 寫
Cache 的改進
1️⃣ 單一快取和二級快取
2️⃣ 統一快取和分立快取
Cache – 主存的地址映射
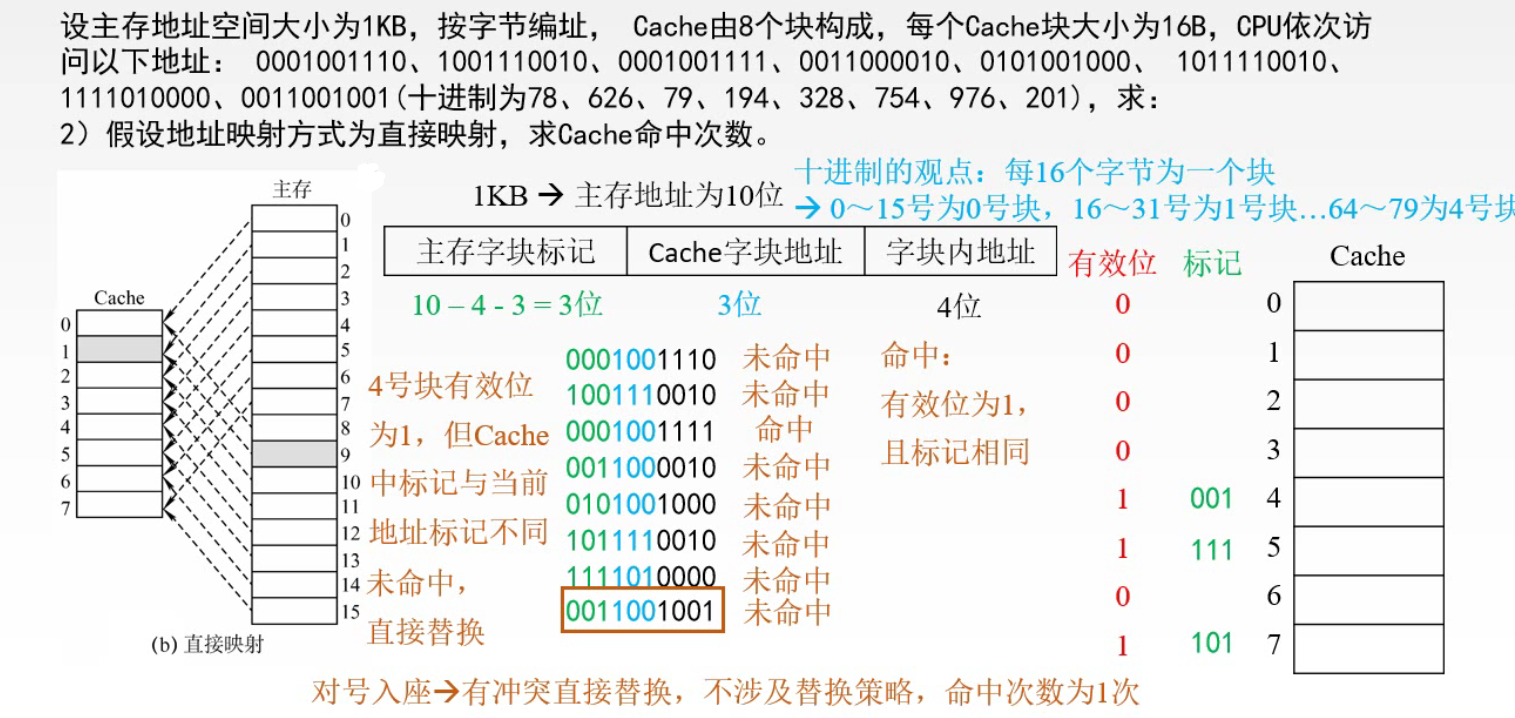
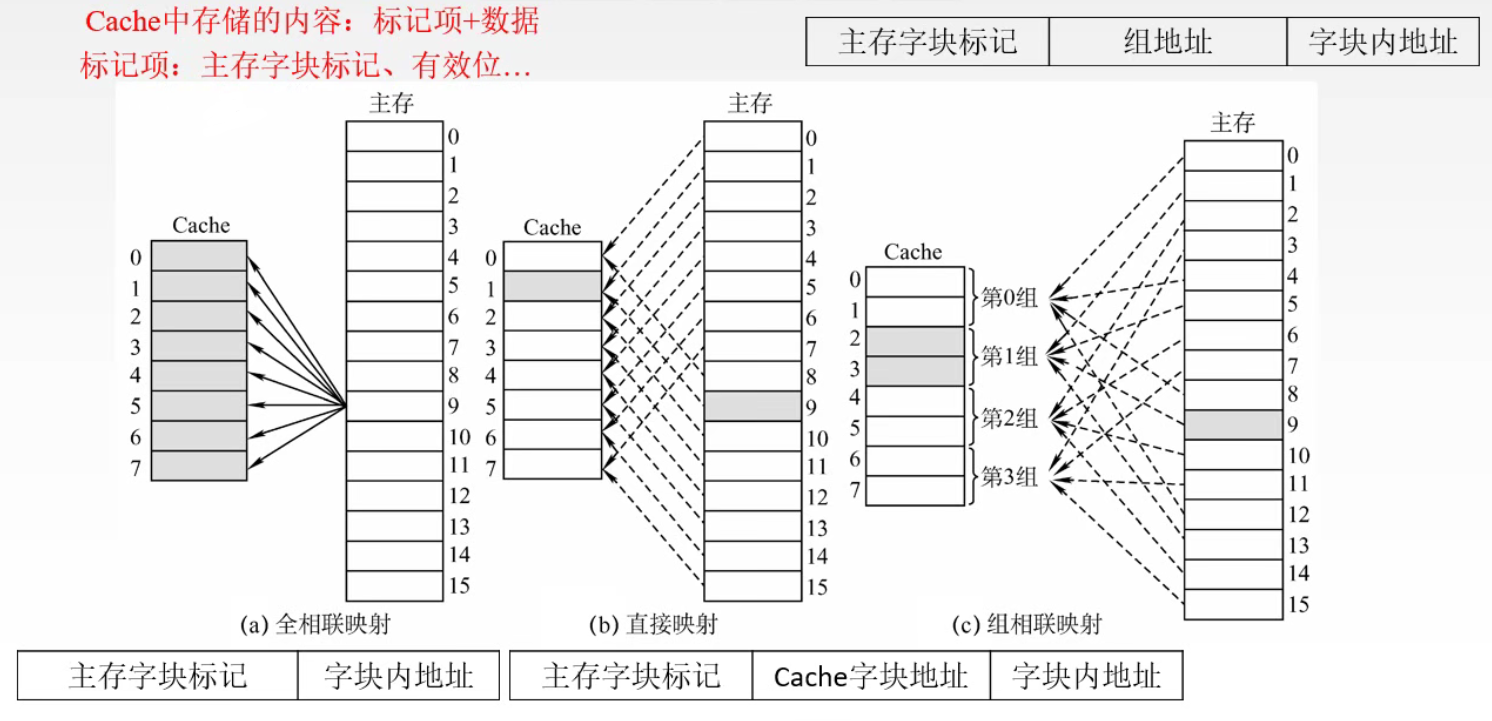
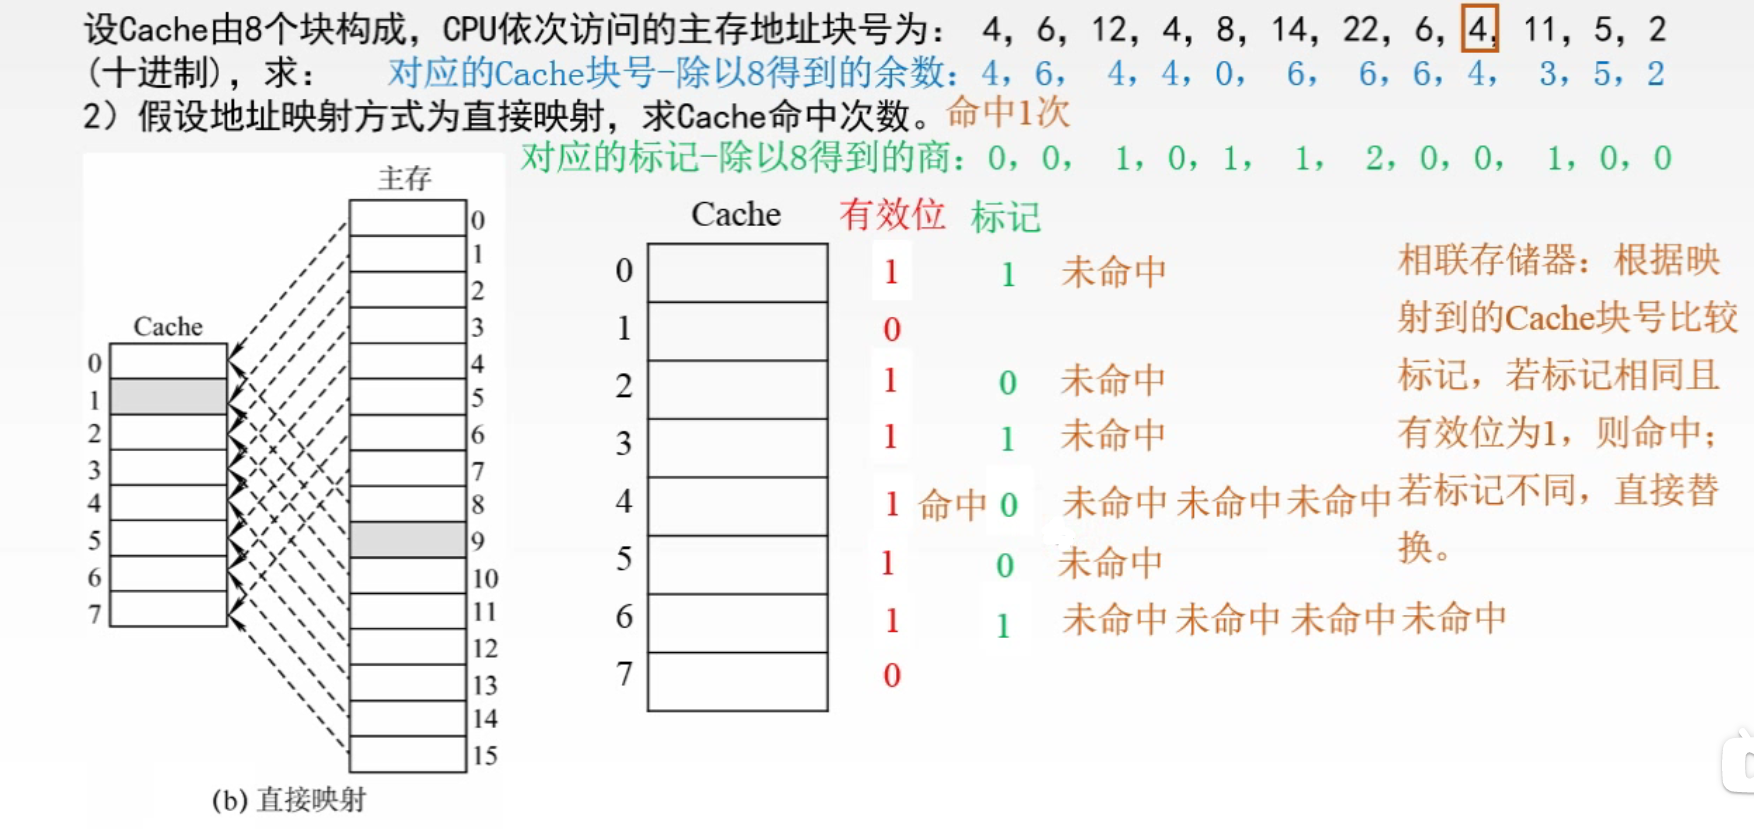
直接映射
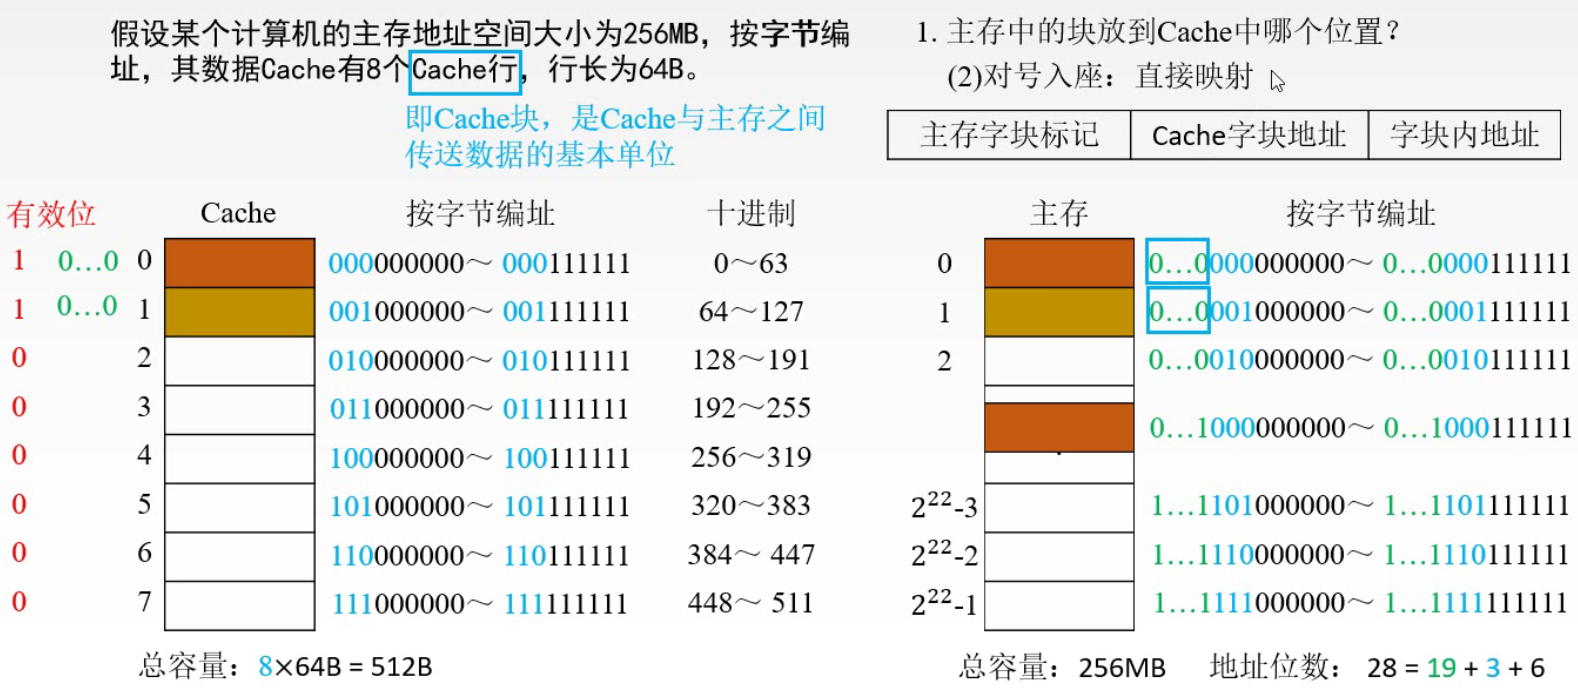
1️⃣ 每個快取塊 i 可以和若干個主存塊對應
2️⃣ 每個主存塊 j 只能和一個快取塊對應
3️⃣ i = j mod C (C 是 Cache 塊總數)
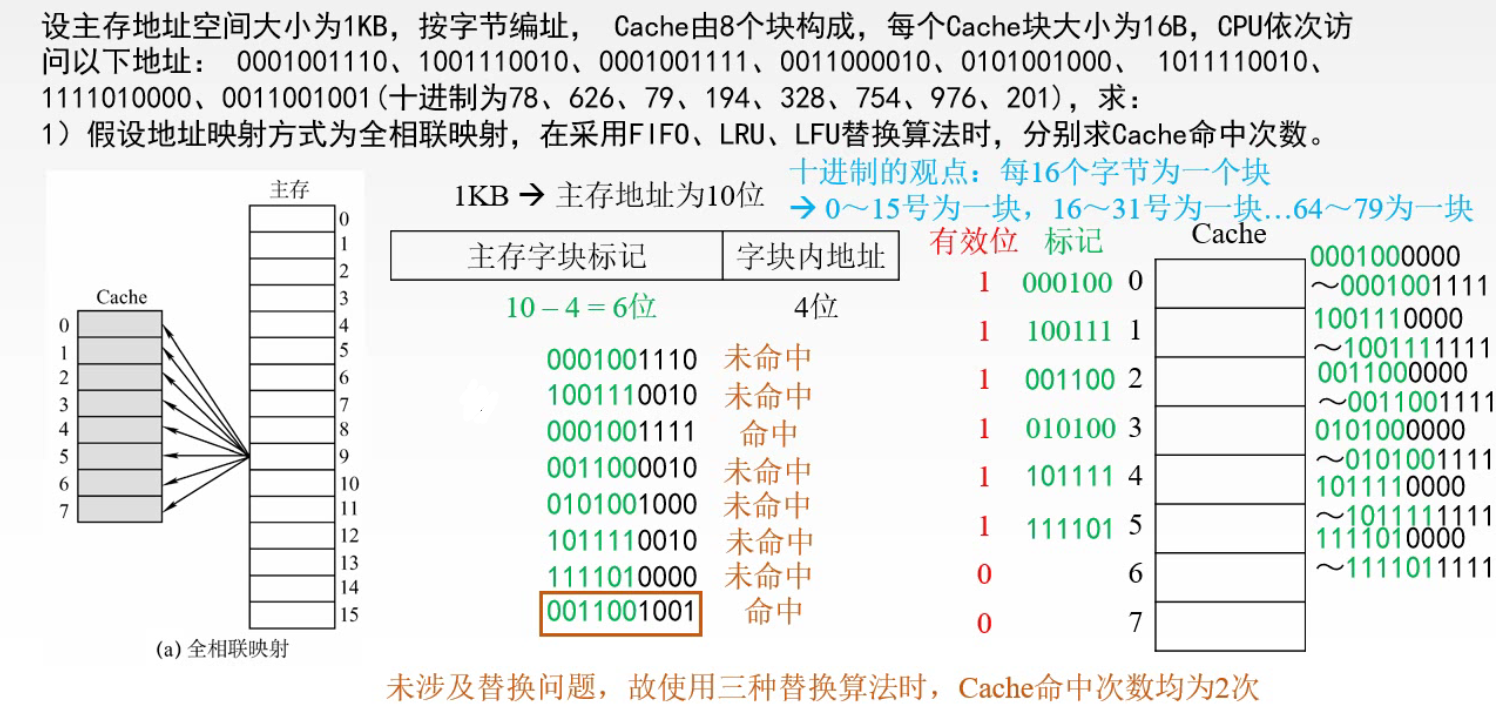
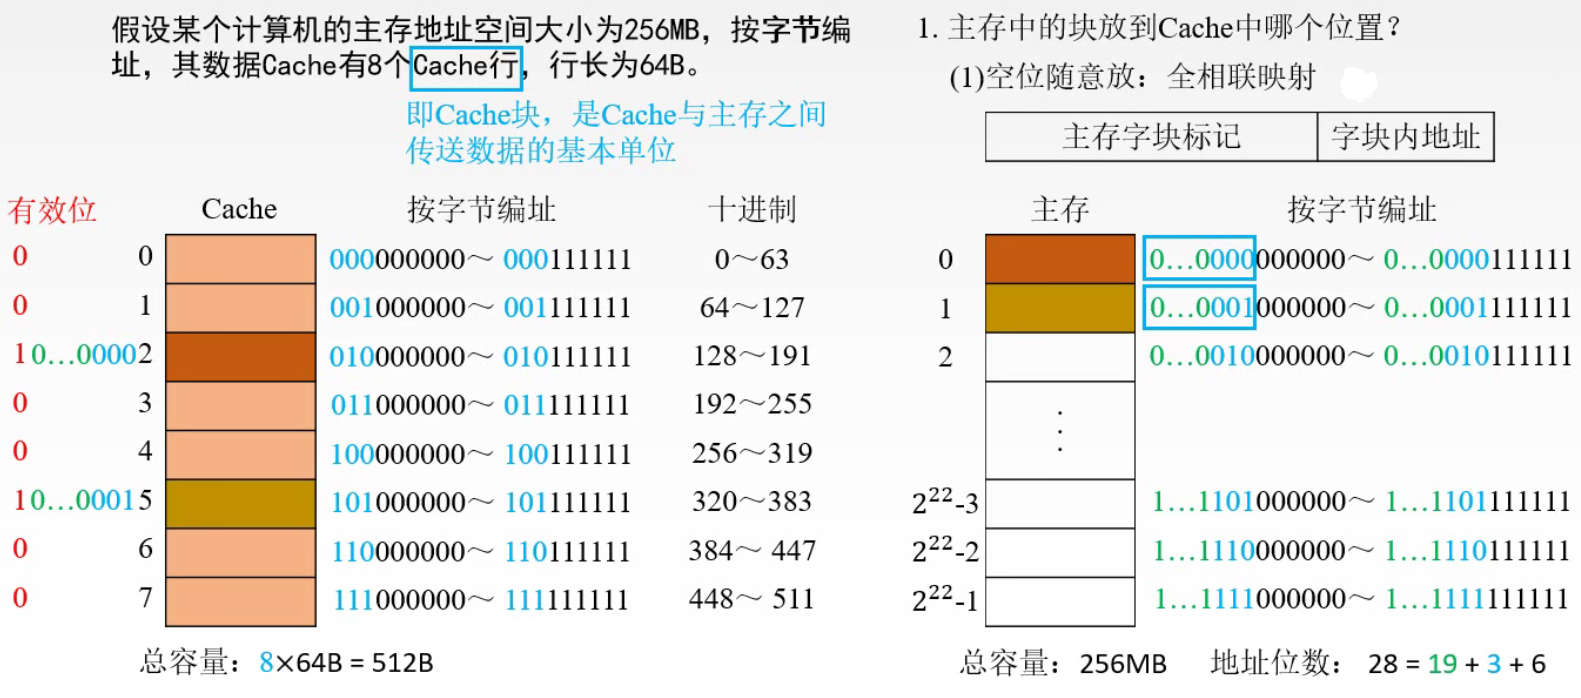
全相聯映射
主存中的任一塊可以映射到快取中的任一塊
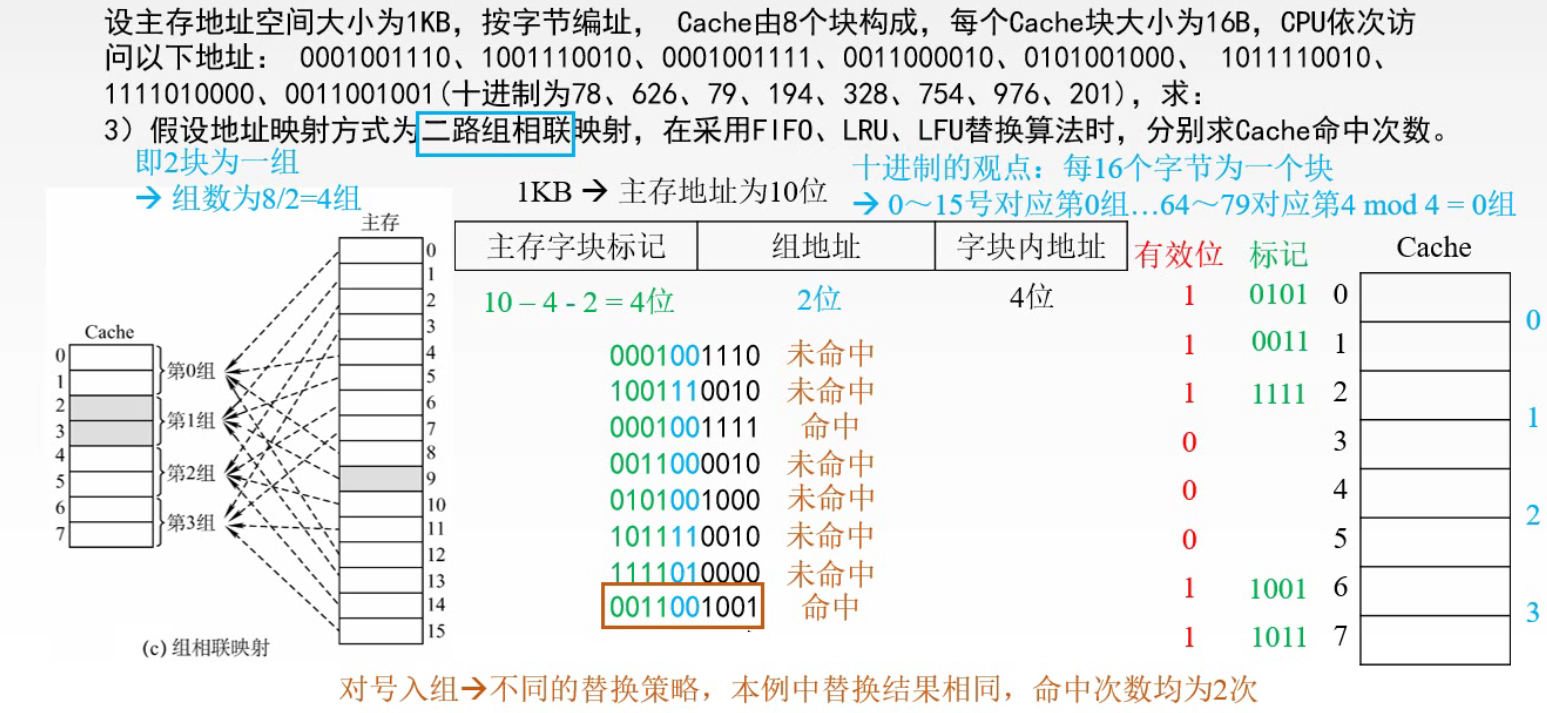
組相聯映射

某一主存塊 j 按模 Q 映射到 快取 的第 i 組中的任一塊
🔔 n 路組相聯:Cache n 個塊為一組,即 Q = n
1️⃣ 當 n = 1 時,Cache 分成 1 組,相當於全相聯映射
2️⃣ 當 n = Cache 塊行數時,Cache 的每個塊都是一組。相當於直接映射
三種映射方式的總結
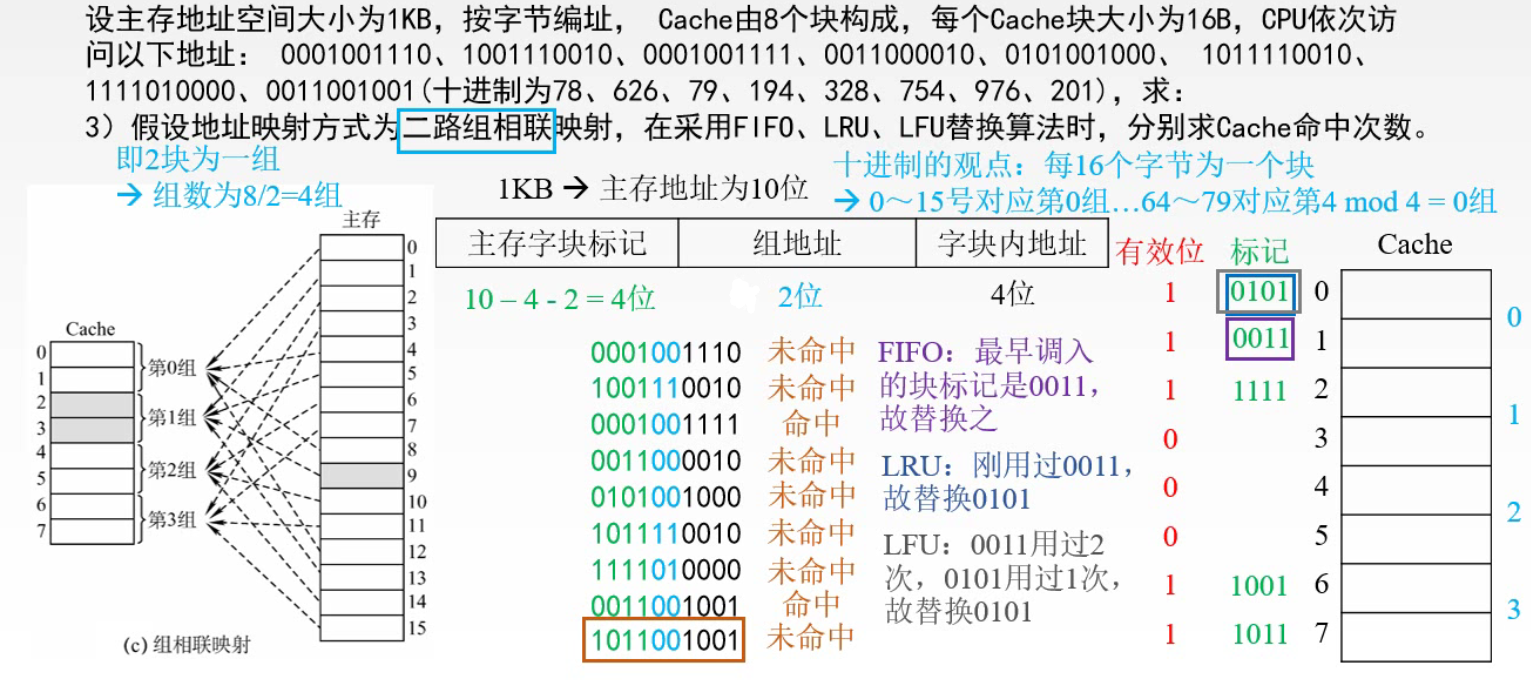
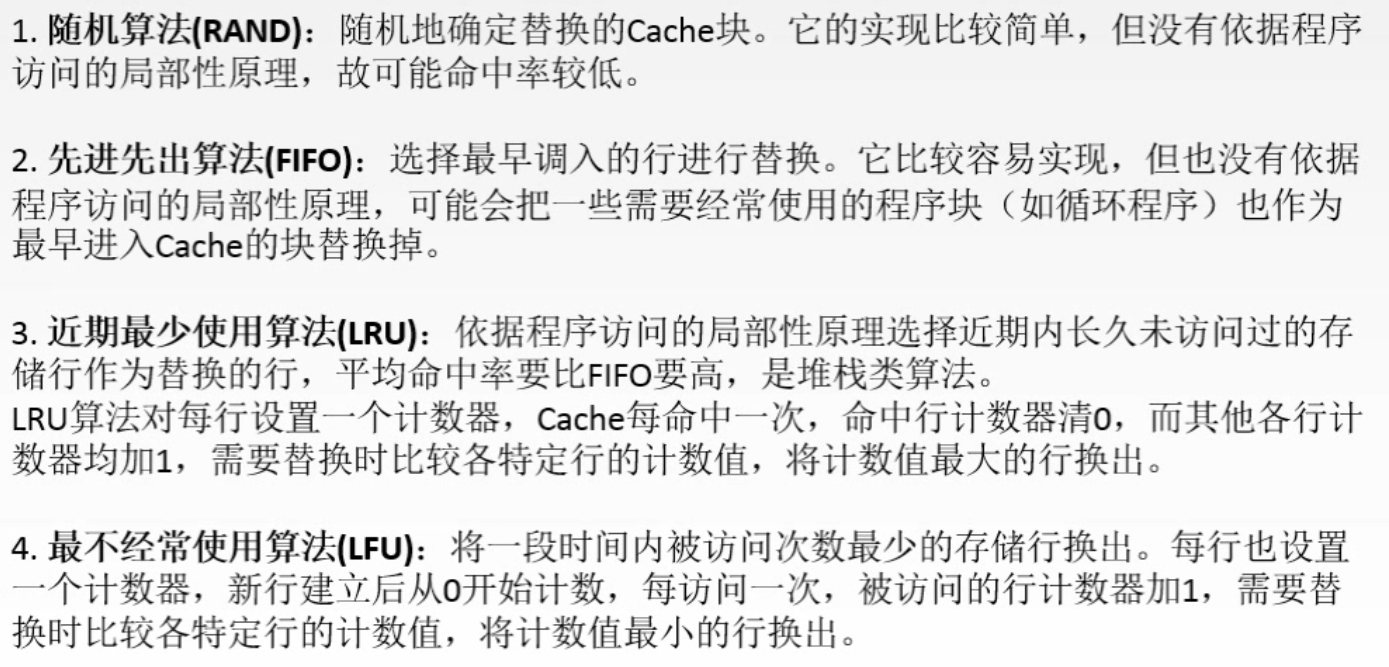
替換演算法
例題一
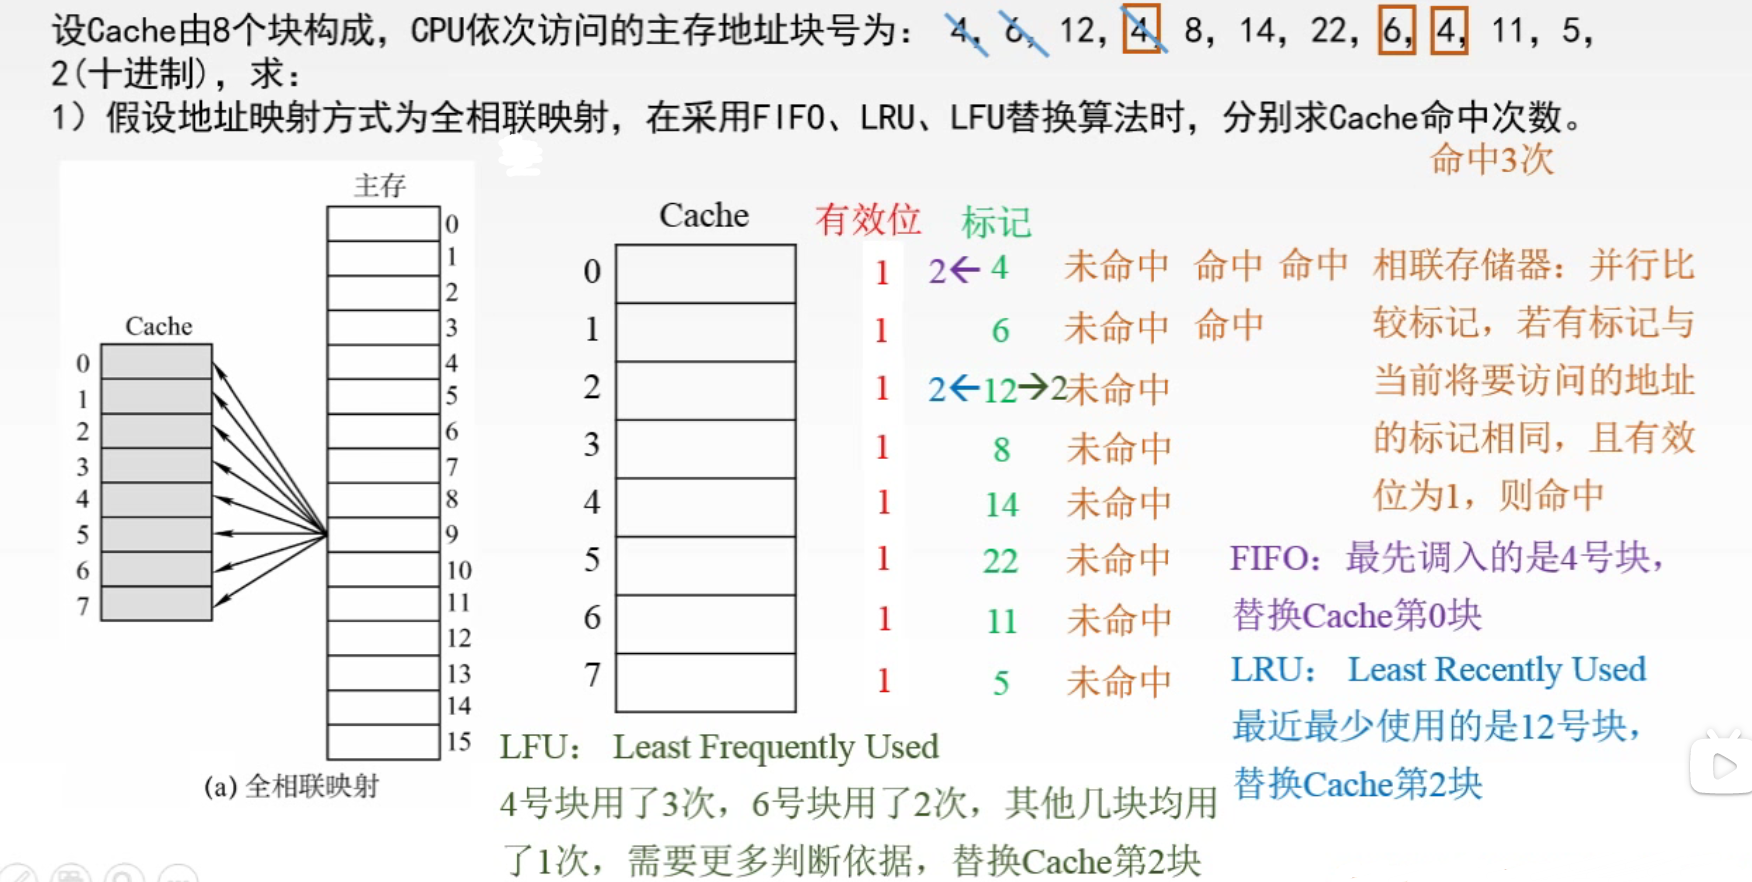
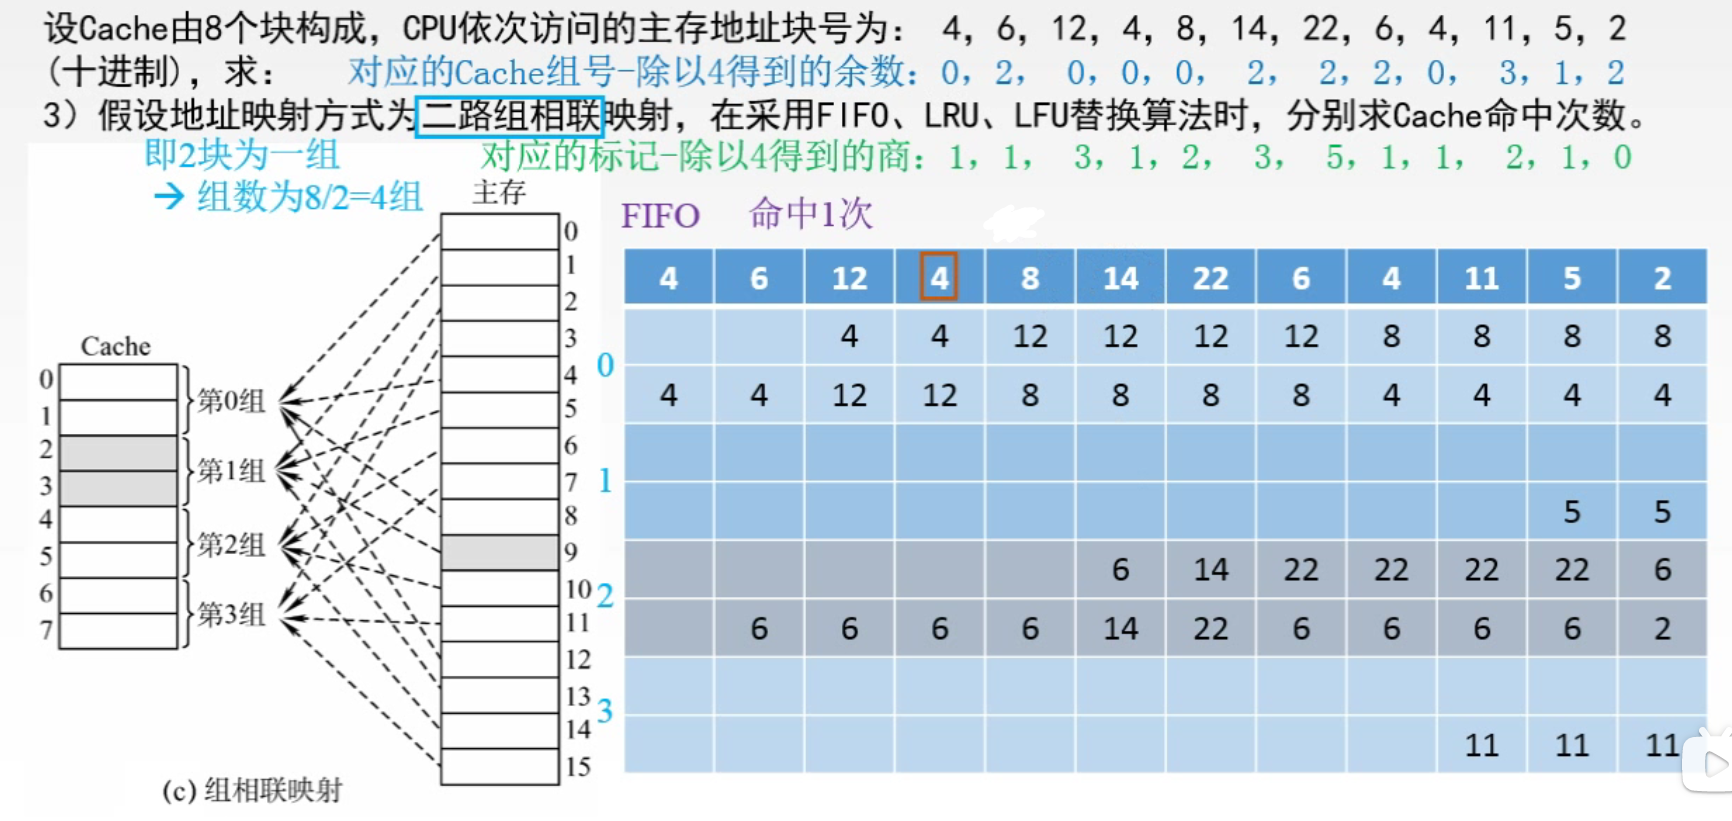
🌈 FIFO:每個組內,就是一個小的隊列,組內整體向上移動一個單位,新元素放下面,彈出最上面的元素
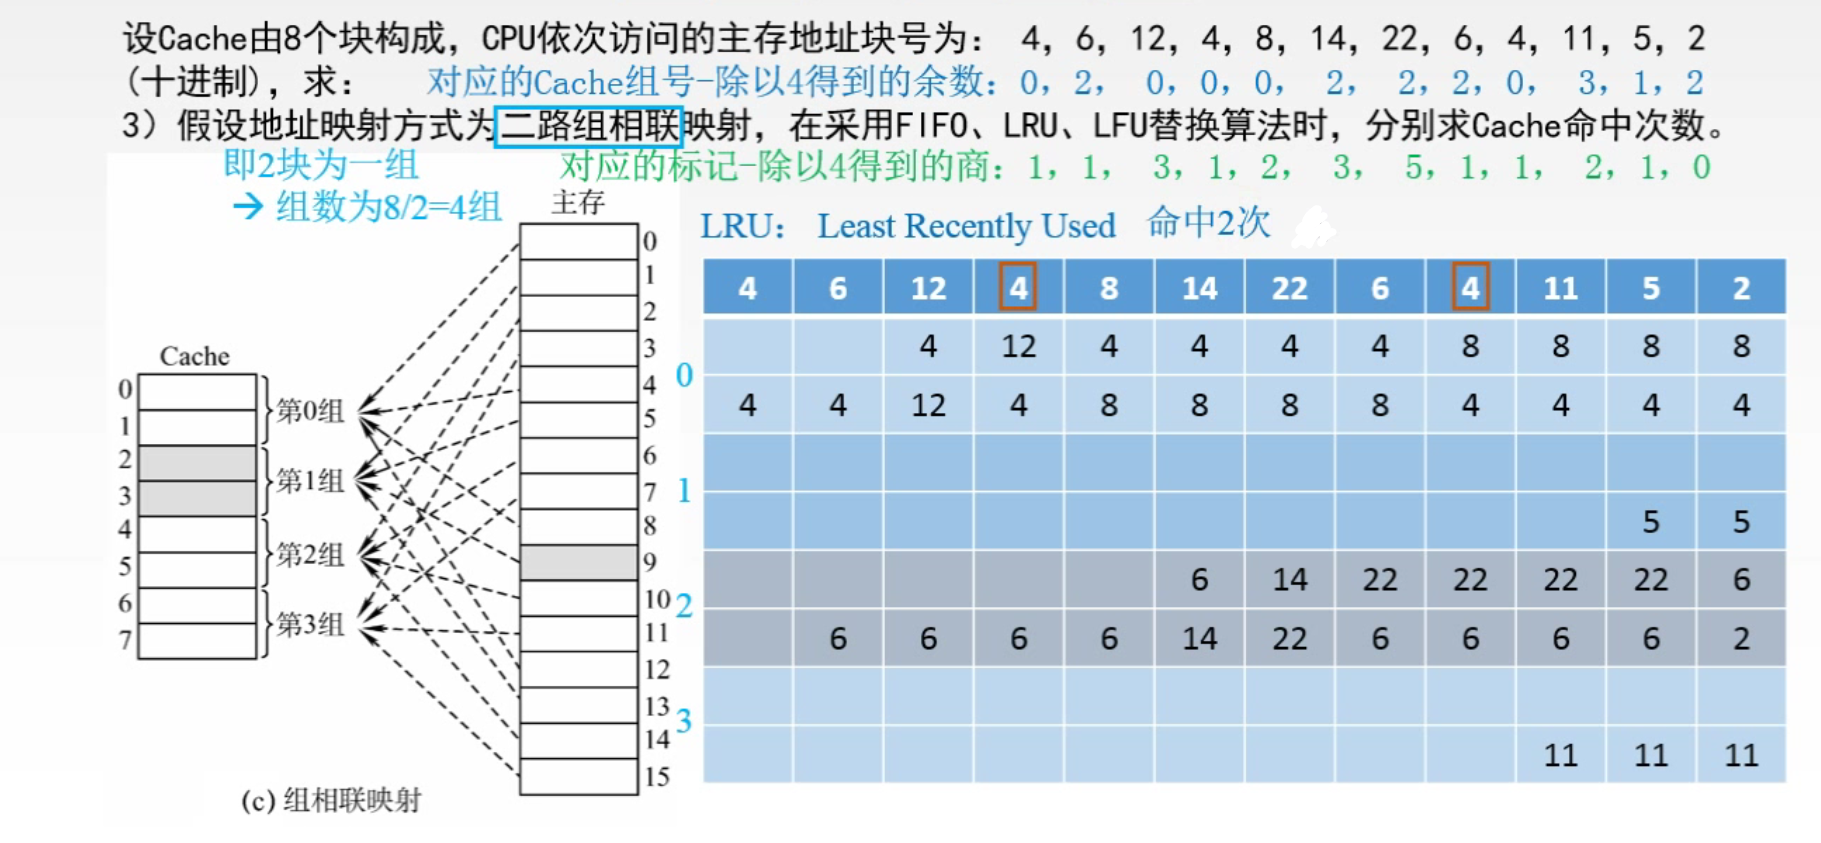
🌈 LRU:每個組中,最不常用的放最上,剛剛用到的(命中)的放最下;遇到新的元素且組滿,則組內整體向上移動一個單位,新元素放最下,彈出最上面的元素
例題二