pandas.DataFrame的groupby()方法的基本使用
- 2019 年 10 月 3 日
- 筆記
pandas.DataFrame的groupby()方法是一個特別常用和有用的方法。讓我們快速掌握groupby()方法的基礎使用,從此數據分析又多一法寶。
首先導入package:
import pandas as pd import numpy as np
groupby的最基本操作
df = pd.DataFrame({'A':[1,2,3,1],'B':[2,3,3,6],'C':[3,1,5,7]}) df 
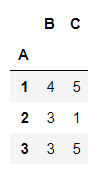
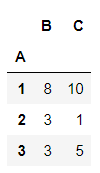
按照A列來進行分組(其實說白了就是將A列中重複的值和成同一個值,然後把A當成索引來進行重新的數據分組)
df.groupby('A').mean() #mean是取平均值
df.groupby('A').sum() #sum是求和
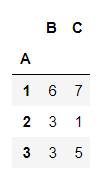
df.groupby(['A']).first() #取第一個出現的數據

df.groupby(['A']).last() #取最後一個出現的數據
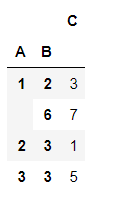
也可以按照多組進行分組
df.groupby(['A','B']).sum()
統計數據的數量
size跟count的區別: size計數時包含NaN值,而count不包含NaN值
df = pd.DataFrame({'A':[1,2,3,1],'B':[2,3,3,6],'C':[3,np.nan,5,7]}) df 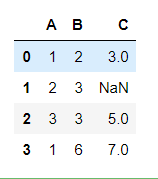
df.groupby(['A']).count()
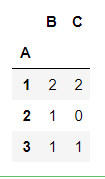
df.groupby(['A']).size()
