Flume初見與實踐
- 2019 年 10 月 3 日
- 筆記

Photo by Janke Laskowski on Unsplash
參考書籍:《Flume構建高可用、可擴展的海量日誌採集系統》 ——Hari Shreedharan 著
以下簡稱「參考書籍」,文中部分資料和圖片會標註引用自書中。官方文檔簡稱「官文」。
文章為個人從零開始學習記錄,如有錯誤,還請不吝賜教。
Flume 初見
### · 簡介 ###
Flume是Cloudera提供的一個高可用的,高可靠的,分散式的海量日誌採集、聚合和傳輸的系統,可以高效地收集、聚合和移動大量的日誌數據。它具有基於流數據流的簡單靈活的體系結構。它具有魯棒性(Robust)和容錯性,具有可調的可靠性機制和多種故障轉移和恢復機制。它使用了一個簡單的、可擴展的數據模型,允許在線分析應用程式。
### · Data flow model ###
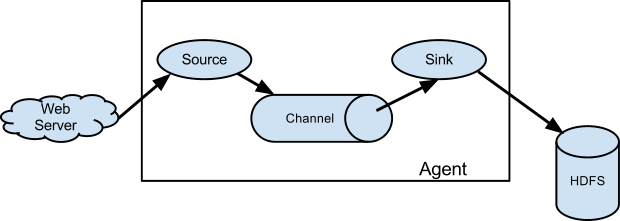
- Source:從外部數據Source(如Web伺服器)接收數據,並將接收的數據以Flume的event格式傳遞給一個或者多個Channel,Flume提供多種數據接收的方式,比如Avro,Thrift,twitter1%等
- Channel:channel是一種短暫的存儲容器,它將從source處接收到的event格式的數據快取起來,直到它們被sinks消費掉,它在source和sink間起著橋樑的作用,channel是一個完整的事務,這一點保證了數據在收發的時候的一致性. 並且它可以和任意數量的source和sink鏈接. 支援的類型有: JDBC channel , File System channel , Memort channel等.
- Sink:sink將數據存儲到集中存儲器比如Hbase和HDFS,它從channals消費數據(events)並將其傳遞給目標地. 目標地可能是另一個sink,也可能HDFS,HBase。
基本工作原理:

圖片取自參考書籍
### · 啟動配置 ###
Flume Agent配置存儲在本地配置文件中。這是一個遵循Java Properties文件格式的文本文件。可以在同一個配置文件中指定一個或多個Agent的配置。配置文件包括Agent中每個Source、Sink和Channel的屬性以及它們如何連接在一起形成數據流。
Source
source是負責接收數據到Flume Agent的組件,它可以從其他系統中接收數據,像 Java消息服務(JMS)或者其他處理的輸出結果,或其他Flume Agent的Sink通過RPC發送的數據。數據源從外部系統或者其他Agent(或者自身生產)接收數 據,並將數據寫人到一個或多個Channel中,這些Channel是提前為Source配置過的。這也是Source最基本的職責。
Flume的配置系統驗證每個Source的配置和屏蔽錯誤配置的Source,可以確保:
- 每個Source至少有一個正確配置的Channel連接它。
- 每個source有一個定義的type參數。
- source是在Agent中Sources裡面的活躍列表。
source一旦成功配置, Flume的生命周期管理系統將會嘗試啟動Source.只有Agent自身停止或被殺死、或者 Agent被用戶重新配置,source才會停止。
Flume最重要的特性之一就是Flume部署水平擴展的簡單性。可以很容易完成擴展的原因是,很容易為Flume調度添加新的Agent,也很容易配置新的這些Agent發送數據給其他FlumeAgent.類似地,一旦添加了新的Agent,僅僅通過更新配置文件,就能很簡單地配置已經運行的Agent來寫入這個新的Agent。下面簡單的概括官文中提到的幾種Flume Source,詳細的介紹可參考其他資料,文章後半部分也有一些練習例子。
- Avro Source:Flume主要的RPC Source,Avro Source被設計為高擴展的RPC伺服器端,能從其他的Flume Agent的Avro Sink或者使用Flume的SDK發送數據的客戶端應用接收數據到一個Flume Agent中。Avro Source使用Netty-Avro inter-process的通訊(IPC)協議來通訊。
- Thrift Source:由於Avro Source不能接收非JVM語言的數據,Flume加入了Apache Thrift RPC的支援來支援跨語言通訊,Thrift Source可以被簡單的定義為多執行緒、高性能的Thrift伺服器。
- HTTP Source:Flume自帶的HTTP source可以通過HTTP POST接收Event。GET請求方式只用於實驗。HTTP請求被可插拔的「handler」轉換為Flumeevent,該處理程式必須實現HTTPSourceHandler介面。這個處理程式接受一個HttpServletRequest,並返回一個Flumeevent列表。從客戶端的角度來看,HTTP Source表現得像web伺服器一樣能接收Flumeevent。
- Spooling Directory source:監視讀取event的目錄。 Source期望目錄中的文件是不變的,文件一旦被移入到該目錄就不應該被再次寫入。文件一旦被Source完全使用完且所有的event被成功寫入Source的 Channel中,Source就可以基於配置重命名文件或刪除文件。當文件被重命名,Source 只是給文件名添加一個後綴,而不是完全改變它。
- Syslog Source:讀取syslog數據並生成Flume Event。Flume提供的syslog Source入: Syslog UDP Source、Syslog TCP Source、Multiport Syslog,UDP Source將整個消息視為單個event。TCP Source為以換行符(『n』)分隔的每個字元串創建一個新event。
- Exec Source:執行用戶配置的命令,且基於命令的標準輸出來生成event。它還可以從命令中讀取錯誤流,將event轉換為Flumeevent,並將它們寫人Channel. Source希望命令不斷生產數據,並且吸收其輸出和錯誤流。只要命令開始運行,Source就要不停地運行和處理,不斷讀取處理的輸出流。
- JMS Source:Flume自帶的Source,可以獲取來自Java消息服務隊列或Subject的數據。
- 自定義的Source:由於各種生產環境的不同,難免需要使用訂製的通訊格式寫入到Flume,用戶需要自行實現Source介面來完成自定義Source。
Channel
Channel是位於Source和Sink之間的緩衝區。因此,Channel允許source和Sink運作在不同的速率上。Channel是Flume保證數據不丟失的關鍵,當然這是在正確配置的情況下。Source寫入數據到一個或多個Channel中,再由一個或多個Sink讀取。Sink 只能從一個Channel讀取數據,而多個Sink可以從相同的Channel讀取以獲得更好的性能。
Channel允許source 在同一Channel上操作,以擁有自己的執行緒模型而不必擔心Sink從Channel讀取數據,反之亦然。位於Source和Sink之間的緩衝區也允許它們工作在不同的速率,因為寫操作發生在緩衝區的尾部,讀取發生在緩衝區的頭部。這也使得Flume Agent能處理 source 「高峰小時」的負載,即使Sink無法立即讀取Channel.
Channel允許多個Source和Sink在它們上面進行操作。Channel本質上是事務性的。每次從Channel中寫人和讀取數據,都在事務的上下文中發生。只有當寫事務被提交,事務中的event才可以被任意Sink讀取。同樣,如果一個Sink已經成功讀取了一個event,該event對於其他Sink是不可用的,除非該Sink回滾事務。
Flume官文中的幾種Channel:
- Memory Channel:Event存儲在具有可配置最大大小的記憶體隊列中。Source從它的尾部寫入,Sink從它的頭部讀取。Memory Channel支援很高的吞吐量,因為它在記憶體中保存所有的數據。Channel是執行緒安全的,可以同時處理幾個Source的寫入操作和幾個Sink的讀取操作。Memory Channel在不需要關心數據丟失的情景下適用,因為該類Channel沒有將數據持久化到磁碟。
Memory Channel支援Flume的事務性模型,並為每個程式中的事務維護單獨的隊列。如果事務失敗,event將以相反的順序被重新插入到Channel的頭部,所以event將以相同的順序被再次讀取,就像它們當初被插入時一樣。用這種方法,儘管Flume不能保證順序性,但是Memory Channel能保證event以它們被寫入的順序進行讀取。然而,當某些事務回滾,後寫入的event有可能更早寫出到目的地。 - File Channel :File Channel是Flume的持久Channel,它將所有event寫到磁碟,因此在程式關閉或機器宕機的情況下不會丟失數據。File Channel保證了即使機器或Agent宕機或重啟,只有當Sink取走了event並提交給事務時,任何提交到Channel的event才從Channel移除。
File Channel被設計用於數據需要持久化和不容忍數據丟失的場景下。因為Channel將數據寫到磁碟,它不會由於宕機或失敗造成數據丟失。一個額外的好處,因為它寫數據到磁碟,Channel可以有非常大的容量,尤其是和Memory Channel相比。 - Spillable Memory Channel:見名知義,可溢出的Memory Channel,記憶體中的隊列充當主存儲,磁碟作為溢出。磁碟存儲使用嵌入式File Channel進行管理。當記憶體中的隊列已滿時,其他傳入event將存儲在File Channel中。看起來似乎挺好,當然官文中有明確提到該Channel目前是試驗性的,不推薦用於生產環境。
- Custom Channel:自定義的Channel。
Sink
從Flume Agent移除數據並寫人到另一個Agent或數據存儲或一些其他系統的組件被稱為Sink。Sink是完全事務性的。在從Channel批量移除數據之前,每個Sink用Channel啟動一個事務。批量event一旦成功寫出到存儲系統或下一個Flume Agent, Sink就利用Channel 提交事務。事務一旦被提交,該Channel從自己的內部緩衝區刪除event。
Sink使用標準的Flume配置系統進行配置。每個Agent可以沒有Sink或若干Sink.每個Sink只能從一個Channel中讀取event。如果Sink沒有配置Channel,那麼Sink就會從Agent中被移除。配置系統保證:
- 每個Sink至少有一個正確配置的Channel連接它。
- 每個Sink有一個定義的type參數。
- Sink是在Agent中Sink活躍列表中的。
Flume可以聚合執行緒到Sink組,每個Sink 組可以包含一個或多個Sink.如果一個Sink沒有定義Sink組,那麼該Sink可以被認為是在一個組內,且該Sink是組內的唯一成員。簡單概括:
- HDFS Sink:HDFS Sink將event寫入Hadoop分散式文件系統(HDFS)。目前支援創建文本和序列文件,可以根據經過的時間、數據大小或event數周期性地滾動文件(關閉當前文件並創建新文件)。它還根據event起源的時間戳或機器等屬性對數據進行存儲/分區。HDFS目錄路徑可能包含格式轉義序列,這些轉義序列將被HDFSSink替換,以生成目錄/文件名來存儲event。使用此Sink需要安裝Hadoop,以便Flume可以使用HadoopJAR與HDFS集群通訊。
- Hive Sink:Hive Sink將包含分隔文本或JSON數據的event直接流到Hive表或分區中。event是使用Hive事務編寫的。一旦一組event被提交到Hive,它們就會立即對Hive查詢可見。傳入event數據中的欄位映射到Hive表中的相應列。
- Logger Sink:在INFO level記錄event。通常用於測試/調試目的。
- Avro Sink:Flume event被轉換為Avro event並發送到配置的 hostname/port 對。event按配置批處理大小的批次從配置的Channel中取出。
- Thrift Sink:Flume事件被轉換為Thrift事件並發送到配置的 hostname/port 對。event按配置批處理大小的批次從配置的Channel中取出。
- IRC Sink:接收來自attached channel的消息,並將這些消息中繼到配置的IRC目的地。
- File Roll Sink:在本地文件系統上存儲event
- Null Sink:丟棄接收的event
- HTTP Sink:接收來自Channel的Event,並使用HTTP POST請求將這些Event發送到遠程伺服器。event內容作為POST content發送。
- Custom Sink:自定義的Sink
另外,還有一些沒有提到的Sink,比如Kafka Sink、ElasticSearch Sink等之後視情況補充。
其他組件
### Interceptors ###
Flume Interceptors(攔截器)是設置在Source和Channel之間的插件式組件。Source將Event寫入到Channel之前可以使用Interceptors對數據進行過濾和一些處理。每個Interceptors實例只處理同一個Source接收到的Event。在一個 Flume處理流程中可以添加任意數量的Interceptors來鏈式處理數據,由攔截器鏈的最後一個攔截器寫入數據到Channel。
- Timestamp Interceptor:將時間戳插入到事件報頭中,通常用在第一層Agent來過濾數據。
- Host Interceptor:插入伺服器的IP地址或者HostName到事件報頭。
- Static Interceptor:允許用戶向所有事件追加具有靜態值的靜態標頭。當前該攔截器的實現不允許一次指定多個標頭。用戶可能會鏈接多個靜態攔截器,每個攔截器定義一個靜態頭。
- Remove Header Interceptor:通過刪除一個或多個標頭來操作Flume事件標頭。它可以刪除靜態定義的標頭、基於正則表達式的標頭或列表中的標頭。如果只需要刪除一個標頭,則按名稱指定它比其他兩個方法具有更高的性能。
- UUID Interceptor:為所有被截獲的事件設置一個通用的唯一標識符。
- Morphline Interceptor:通過Morphline配置文件定義了從一個命令到另一個命令的管道記錄的轉換鏈,但攔截器中不應該出現複雜的操作。如果需要重量級的處理,最好使用Morphline Solr Sink。
- Regex Filtering Interceptor:將事件體轉換為UTF-8的字元使用正則表達式來過濾事情。
- Search and Replace Interceptor:提供了基於Java正則表達式的簡單的基於字元串的搜索和替換功能。
- Custom Interceptor:自定義的攔截器,實現 org.apache.flume.interceptor.Interceptor 介面。
Channel選擇器
Channel選擇器決定了Source接收的事件寫入哪些Channel。如果Flume寫入一個Channel時發生故障而發生在其他Channel的事件無法被回滾就會拋出ChannelException導致事務失敗。
Flume內置了兩種Channel選擇器:
- Replicating Channel Selector (default):如果Source沒有指定Channel選擇器則默認為複製,該選擇器複製每個事件到通過Source的Channels參數指定的所有Channel中。
- Multiplexing Channel Selector:多路復用選擇器是專門為動態路由事件的Channel選擇器,通過選擇事件應該寫入的Channel,基於一個特定的事件頭的值來進行路由,通常結合攔截器使用。
- Custom Channel Selector:自定義的Channel選擇器,實現ChannelSelector介面或繼承AbstractChannelSelector抽象類。啟動Flume代理時,必須將自定義通道選擇器的類及其依賴項包含在代理的類路徑中。
Sink grou和Sink Processors
Flume為每個Sink組實例化一個Sink Processors來執行Sink組內的任務,Sink組可以包含任意個Sink,一般這用於RPC Sink,在層之間以負載均衡或故障轉移的方式傳輸數據。每個Sink組在活躍列表中被聲明為一個組件,就像Source、Sink和Channel一樣,使用sinkgroups關鍵字。每個Sink組是一個需要命名的組件,因為每個Agent可以有多個Sink組。需要注意的是Sink組中所有Sink是不會在同時被激活,任何時候只有它們中的一個用來發送數據。因此,Sink組不應該用來更快地清除Channel,在這種情況下,多個Sink應該只是設置為自己操作自己,而沒有Sink組,且它們應該配置從相同的Channel進行讀取。
- Default Sink Processor:Default Sink Processor只接受一個Sink。用戶不必為單個Sink創建處理器(Sink組)。
- Failover Sink Processor:Failover Sink Processor維護一個優先的Sink列表,確保每個可用的事件到達就會被處理。 故障轉移機制的工作方式是將失敗的Sink降級到池中,在池中為它們分配一個冷卻周期,在重試之前隨著順序故障的增加而增加。一旦Sink成功地發送了一個Event,它就被還原到活動池中。如果Sink在發送Event時失敗,則下一個優先順序最高的Sink將嘗試發送Event。例如,具有優先順序100的Sink在具有優先順序80的Sink之前被激活。如果沒有指定優先順序,則根據在配置中指定Sinks的順序確定該優先順序。
- Load balancing Sink Processor:Load balancing Sink Processor供了在多個Sink上負載均衡的能力。它維護必須在其上分配負載的活動Sink的索引列表。實現支援使用round_robin或random選擇機制。選擇機制的選擇默認為round_robin類型,但可以通過配置重寫。調用時,此選擇器使用其配置的選擇機制選擇下一個Sink並調用它。此實現沒有黑名單失敗的Sink,而是樂觀地嘗試每一個可用的Sink。
一些入門練習
### · 官文基礎例子 ###
```
vim HelloFlume.conf //創建Agent配置文件
# example.conf: A single-node Flume configuration
# Name the components on this agent
a1.sources = r1
a1.sinks = k1
a1.channels = c1
# Describe/configure the source
# 這個例子監聽了本機的44444埠netcat服務
a1.sources.r1.type = netcat
a1.sources.r1.bind = localhost
a1.sources.r1.port = 44444
# Describe the sink
a1.sinks.k1.type = logger
# Use a channel which buffers events in memory
a1.channels.c1.type = memory
a1.channels.c1.capacity = 1000
a1.channels.c1.transactionCapacity = 100
# Bind the source and sink to the channel
a1.sources.r1.channels = c1
a1.sinks.k1.channel = c1
#### 配置內容到此結束 ####
bin/flume-ng agent --name a1 --conf conf/ --conf-file learn/part1/HelloFlume.conf -Dflume.root.logger=INFO,console
# 注意幾個參數
# --name 表示啟動的agent name ,因為上面配置文件里寫了a1,所以這裡寫a1,key可以簡寫為-n
# --conf 表示flume的conf目錄 ,key可以簡寫為-c
# --conf-file 表示啟動當前agent使用的配置文件,指向上面創建的配置文件,key可以簡寫為 -f
# 啟動成功會發現當前終端被阻塞,啟動另一個終端
nc localhost 44444
hello flume
回到阻塞的終端看最新的日誌
2019-9-18 09:52:55,583 (SinkRunner-PollingRunner-DefaultSinkProcessor)
[INFO - org.apache.flume.sink.LoggerSink.process(LoggerSink.java:95)]
Event: { headers:{} body: 68 65 6C 6C 6F 20 66 6C 75 6D 65 hello flume }
### · 監控本地log文件變化並輸出到不同的目的地 ### 直接貼出配置內容# file-flume.conf 從本地文件系統監控變化並通過avro sink將數據傳輸給另外兩個flume #
#name
a1.sources = r1
a1.channels = c1 c2
a1.sinks = k1 k2
#configure the source
# 使用TailDir的方式監視文件變化,這種方式可以以較高效率實現斷點續傳
a1.sources.r1.type = TAILDIR
a1.sources.r1.filegroups = f1
a1.sources.r1.filegroups.f1 = /root/public/result/t2.txt
a1.sources.r1.positionFile = /usr/local/soft/flume-1.9.0/learn/part2/position.json
#將選擇器設置為複製,其實不寫也可以,因為這是默認值,熟悉一下
a1.sources.r1.selector.type = replicating
#channel
a1.channels.c1.type = memory
a1.channels.c1.capacity = 1000
a1.channels.c1.transactionCapacity = 100
a1.channels.c2.type = memory
a1.channels.c2.capacity = 1000
a1.channels.c2.transactionCapacity = 100
#sink
# 兩個sink分別綁定不同埠
a1.sinks.k1.type = avro
a1.sinks.k1.hostname = master
a1.sinks.k1.port = 12345
a1.sinks.k2.type = avro
a1.sinks.k2.hostname = master
a1.sinks.k2.port = 12346
#bind
a1.sources.r1.channels = c1 c2
a1.sinks.k1.channel = c1
a1.sinks.k2.channel = c2
# flume-hdfs.conf 從avro source接收數據並上傳到hdfs sink #
#name
a2.sources = r1
a2.channels = c1
a2.sinks = k1
#source
a2.sources.r1.type = avro
a2.sources.r1.bind = master
a2.sources.r1.port = 12345
#channel
a2.channels.c1.type = memory
a2.channels.c1.capacity = 1000
a2.channels.c1.transactionCapacity = 100
#sink
a2.sinks.k1.type = hdfs
#上傳到hdfs的路徑
a2.sinks.k1.hdfs.path = hdfs://master:9000/flume/part2/events/%y-%m-%d/%H%M/%S
#上傳文件的前綴
a2.sinks.k1.hdfs.filePrefix = events
#是否按照時間滾動文件夾
a2.sinks.k1.hdfs.round = true
#多少時間單位創建一個新的文件夾
a2.sinks.k1.hdfs.roundValue = 1
#重新定義時間單位
a2.sinks.k1.hdfs.roundUnit = hour
#是否使用本地時間戳
a2.sinks.k1.hdfs.useLocalTimeStamp = true
#積攢多少個 Event 才 flush 到 HDFS 一次,這裡因為是學習測試,所以設置的值比較小方便查看
a2.sinks.k1.hdfs.batchSize = 100
#設置文件類型,可支援壓縮
a2.sinks.k1.hdfs.fileType = DataStream
#多久生成一個新的文件
a2.sinks.k1.hdfs.rollInterval = 30
#設置每個文件的滾動大小,這裡最好設置成比HDFS塊大小小一點
a2.sinks.k1.hdfs.rollSize = 134217000
#文件的滾動與 Event 數量無關
a2.sinks.k1.hdfs.rollCount = 0
#bind
a2.sources.r1.channels = c1
a2.sinks.k1.channel = c1
# file-local.conf 從avro source接收數據並存儲到本地 #
#name
a3.sources = r1
a3.channels = c1
a3.sinks = k1
#source
a3.sources.r1.type = avro
a3.sources.r1.bind = master
a3.sources.r1.port = 12346
#channel
a3.channels.c1.type = memory
a3.channels.c1.capacity = 1000
a3.channels.c1.transactionCapacity = 100
#sink
a3.sinks.k1.type = file_roll
#注意這裡寫出的本地文件路徑要提前創建好文件夾,否則flume不會幫你創建導致異常錯誤
a3.sinks.k1.sink.directory = /usr/local/soft/flume-1.9.0/learn/part2/localResult/
#bind
a3.sources.r1.channels = c1
a3.sinks.k1.channel = c1
配置完成即可開啟flume,注意啟動的參數要和選擇的配置文件中的Agent Name相同
bin/flume-ng agent --name a1 --conf conf/ --conf-file learn/part2/file-flume.conf
bin/flume-ng agent --name a2 --conf conf/ --conf-file learn/part2/flume-hdfs.conf
bin/flume-ng agent --name a3 --conf conf/ --conf-file learn/part2/flume-local.conf
由於監控的是本地的某個文件,所以以任意方式向該文件添加資訊即可,結果:
[root@master localResult]# hadoop fs -ls -R /flume
drwxr-xr-x - root supergroup 0 2019-9-18 14:33 /flume/part2
drwxr-xr-x - root supergroup 0 2019-9-18 14:33 /flume/part2/events
drwxr-xr-x - root supergroup 0 2019-9-18 14:33 /flume/part2/events/19-9-18
drwxr-xr-x - root supergroup 0 2019-9-18 14:33 /flume/part2/events/19-9-18/1400
drwxr-xr-x - root supergroup 0 2019-9-18 14:35 /flume/part2/events/19-9-18/1400/00
-rw-r--r-- 1 root supergroup 3648 2019-9-18 14:34 /flume/part2/events/19-9-18/1400/00/events.1569911635854
-rw-r--r-- 1 root supergroup 2231 2019-9-18 14:35 /flume/part2/events/19-9-18/1400/00/events.1569911670803
[root@master localResult]# ls -lh /usr/local/soft/flume-1.9.0/learn/part2/localResult/
總用量 8.0K
-rw-r--r--. 1 root root 2.5K 9月 18 14:34 1569911627438-1
-rw-r--r--. 1 root root 3.4K 9月 18 14:34 1569911627438-2
-rw-r--r--. 1 root root 0 9月 18 14:34 1569911627438-3
-rw-r--r--. 1 root root 0 9月 18 14:35 1569911627438-4
-rw-r--r--. 1 root root 0 9月 18 14:35 1569911627438-5
```
### · 官文負載均衡、故障轉移、SinkGroup、Sink Processor ###
故障轉移
```
#name
a1.sources = r1
a1.channels = c1
a1.sinks = k1 k2
#configure the source,以命令的方式監控本地文件變動
a1.sources.r1.type = exec
a1.sources.r1.command = tail -F /root/public/result/t2.txt
#channel
a1.channels.c1.type = memory
a1.channels.c1.capacity = 1000
a1.channels.c1.transactionCapacity = 100
#sink
a1.sinkgroups = g1
a1.sinkgroups.g1.sinks = k1 k2
a1.sinkgroups.g1.processor.type = failover
a1.sinkgroups.g1.processor.priority.k1 = 5
a1.sinkgroups.g1.processor.priority.k2 = 10
a1.sinkgroups.g1.processor.maxpenalty = 10000
a1.sinks.k1.type = avro
a1.sinks.k1.hostname = master
a1.sinks.k1.port = 12345
a1.sinks.k2.type = avro
a1.sinks.k2.hostname = master
a1.sinks.k2.port = 12346
#bind
a1.sources.r1.channels = c1
a1.sinks.k1.channel = c1
a1.sinks.k2.channel = c1
另外兩個Flume啟動的配置只有port和name參數不一樣,所以只貼出一份
#name
a2.sources = r1
a2.channels = c1
a2.sinks = k1
#source
a2.sources.r1.type = avro
a2.sources.r1.bind = master
a2.sources.r1.port = 12345
#channel
a2.channels.c1.type = memory
a2.channels.c1.capacity = 1000
a2.channels.c1.transactionCapacity = 100
#sink
a2.sinks.k1.type = logger
#bind
a2.sources.r1.channels = c1
a2.sinks.k1.channel = c1
bin/flume-ng agent -n a1 -c conf -f learn/part3/file-flume.conf
bin/flume-ng agent -n a2 -c conf -f learn/part3/flume-sink1.conf -Dflume.root.logger=INFO,console
bin/flume-ng agent -n a3 -c conf -f learn/part3/flume-sink2.conf -Dflume.root.logger=INFO,console
```
由於配置了Sink k2的優先順序比k1高,所以一開始日誌資訊會全部發送到k2,使用Ctrl+c結束掉k2後資訊被轉移到k1
至於負載均衡配置,只需要修改幾個參數即可
a1.sinkgroups = g1 a1.sinkgroups.g1.sinks = k1 k2 a1.sinkgroups.g1.processor.type = load_balance a1.sinkgroups.g1.processor.backoff = true a1.sinkgroups.g1.processor.selector = random
因為每個Avro Sink對Avro Source保持持續開放的連接,擁有寫人到相同Agent的多個Sink會增加更多的socket連接,且在第二層Agent上佔據更多的資源。對相同Agent增加大量Sink之前必須要謹慎考慮。
### · 多節點資訊聚合 ###
現在計劃讓Node1和Node2節點生產數據,採集的日誌資訊一起聚合到Master機器上,直接上配置
```
# flume-node1.conf #
#name
a2.sources = r1
a2.channels = c1 c2
a2.sinks = k1 k2
#source
a2.sources.r1.type = exec
a2.sources.r1.command = tail -F /usr/local/soft/flume-1.9.0/learn/part4/input/t1.txt
a2.sources.r1.selector.type = replicating
#channel
a2.channels.c1.type = memory
a2.channels.c1.capacity = 1000
a2.channels.c1.transactionCapacity = 100
a2.channels.c2.type = memory
a2.channels.c2.capacity = 1000
a2.channels.c2.transactionCapacity = 100
#sink
a2.sinks.k1.type = avro
a2.sinks.k1.hostname = master
a2.sinks.k1.port = 12345
a2.sinks.k2.type = logger
#bind
a2.sources.r1.channels = c1 c2
a2.sinks.k1.channel = c1
a2.sinks.k2.channel = c2
# flume-node2.conf #
#name
a3.sources = r1
a3.channels = c1 c2
a3.sinks = k1 k2
#source
a3.sources.r1.type = TAILDIR
a3.sources.r1.positionFile = /usr/local/soft/flume-1.9.0/learn/part4/taildir_position.json
a3.sources.r1.filegroups = f1
a3.sources.r1.filegroups.f1 = /usr/local/soft/flume-1.9.0/learn/part4/input/t1.txt
a3.sources.r1.selector.type = replicating
#channel
a3.channels.c1.type = memory
a3.channels.c1.capacity = 1000
a3.channels.c1.transactionCapacity = 100
a3.channels.c2.type = memory
a3.channels.c2.capacity = 1000
a3.channels.c2.transactionCapacity = 100
#sink
a3.sinks.k1.type = avro
a3.sinks.k1.hostname = master
a3.sinks.k1.port = 12345
a3.sinks.k2.type = logger
#bind
a3.sources.r1.channels = c1 c2
a3.sinks.k1.channel = c1
a3.sinks.k2.channel = c2
#name
a1.sources = r1
a1.channels = c1 c2
a1.sinks = k1 k2
#configure the source
a1.sources.r1.type = avro
a1.sources.r1.bind = master
a1.sources.r1.port = 12345
a1.sources.r1.selector.type = replicating
#channel
a1.channels.c1.type = memory
a1.channels.c1.capacity = 1000
a1.channels.c1.transactionCapacity = 100
a1.channels.c2.type = memory
a1.channels.c2.capacity = 1000
a1.channels.c2.transactionCapacity = 100
#sink
a1.sinks.k1.type = file_roll
a1.sinks.k1.sink.directory = /usr/local/soft/flume-1.9.0/learn/part4/result/
a1.sinks.k2.type = logger
#bind
a1.sources.r1.channels = c1 c2
a1.sinks.k1.channel = c1
a1.sinks.k2.channel = c2
配置如上,其實既然跨機器那麼Agent name 是否相同都無所謂了,每個配置文件中的兩個channel和sink是為了將資訊列印到控制台,假如出現了錯誤方便觀察。來一段簡單的腳本慢慢的生成數據。
#!/bin/bash
hs=hostname
for i in ((seq 1 20) do echo "來自){hs}的第${i}條日誌" >> /usr/local/soft/flume-1.9.0/learn/part4/input/t1.txt
sleep 1
done
MASTER:FLUME_HOME/bin/flume-ng agent -n a1 -c conf -f learn/part4/flume-master.conf -Dflume.root.logger=INFO,console
NODE1:FLUME_HOME/bin/flume-ng agent -n a2 -c conf -f learn/part4/flume-node1.conf -Dflume.root.logger=INFO,console
NODE2:FLUME_HOME/bin/flume-ng agent -n a3 -c conf -f learn/part4/flume-node2.conf -Dflume.root.logger=INFO,console
NODE1:FLUME_HOME/learn/part4/input/generate.sh
NODE2:FLUME_HOME/learn/part4/input/generate.sh
### 數據生成和傳輸完成後 ###
MASTER:FLUME_HOME/learn/part4/result ls -l
總用量 8
-rw-r--r--. 1 root root 368 9月 18 20:38 1569933489286-1
-rw-r--r--. 1 root root 774 9月 18 20:38 1569933489286-2
```
### · 攔截器 + 自定義攔截器 ###
通過一些小例子結合著不同的攔截器進行理解消化,現在有如下結構

則有如下配置
```
#flume-master.conf
#name
a1.sources = r1
a1.channels =c1 c2
a1.sinks =k1 k2
#configure the source
a1.sources.r1.type = exec
a1.sources.r1.command = tail -F /usr/local/soft/flume-1.9.0/learn/part6/input/info.txt
a1.sources.r1.interceptors = i1 i2 i3
a1.sources.r1.interceptors.i1.type = static
#使用靜態攔截器為每個事件添加鍵值對
a1.sources.r1.interceptors.i1.key = des
a1.sources.r1.interceptors.i1.value = UsingStaticInterceptor
a1.sources.r1.interceptors.i2.type = host
a1.sources.r1.interceptors.i2.useIP = false
a1.sources.r1.interceptors.i3.type = priv.landscape.interceptorDemo.LevelInterceptor$Builder
#自定義攔截器
a1.sources.r1.selector.type = multiplexing
a1.sources.r1.selector.header = level
a1.sources.r1.selector.mapping.error = c1
a1.sources.r1.selector.mapping.other = c2
#channel
a1.channels.c1.type = memory
a1.channels.c1.capacity = 1000
a1.channels.c1.transactionCapacity = 100
a1.channels.c2.type = memory
a1.channels.c2.capacity = 1000
a1.channels.c2.transactionCapacity = 100
#sink
a1.sinks.k1.type = avro
a1.sinks.k1.hostname = node1
a1.sinks.k1.port = 12345
a1.sinks.k2.type = logger
#bind
a1.sources.r1.channels = c1 c2
a1.sinks.k1.channel = c1
a1.sinks.k2.channel = c2
#其中自定義攔截器的關鍵Java程式碼 :
public class LevelInterceptor implements Interceptor {
private List
@Override public void initialize() { eventList = new ArrayList<>(); } @Override public Event intercept(Event event) { Map<String, String> headers = event.getHeaders(); String body = new String(event.getBody()); if (body.contains("ERROR")) { headers.put("level", "error"); } else { headers.put("level", "other"); } return event; } @Override public List<Event> intercept(List<Event> events) { eventList.clear(); for (Event event : events) { eventList.add(intercept(event)); } return eventList; }.......
## flume-node1.conf
#name
a2.sources = r1
a2.channels = c1 c2
a2.sinks = k1 k2
#source
a2.sources.r1.type = avro
a2.sources.r1.bind = node1
a2.sources.r1.port = 12345
a2.sources.r1.selector.type = multiplexing
a2.sources.r1.selector.header = host
a2.sources.r1.selector.mapping.Master = c1
a2.sources.r1.selector.mapping.Node2 = c2
a2.sources.r1.selector.mapping.default = c2
#channel
a2.channels.c1.type = memory
a2.channels.c1.capacity = 1000
a2.channels.c1.transactionCapacity = 100
a2.channels.c2.type = memory
a2.channels.c2.capacity = 1000
a2.channels.c2.transactionCapacity = 100
#sink
a2.sinks.k1.type = logger
a2.sinks.k2.type = null
#bind
a2.sources.r1.channels = c1 c2
a2.sinks.k1.channel = c1
a2.sinks.k2.channel = c2
#flume-node2.conf
#name
a3.sources = r1
a3.channels = c1 c2
a3.sinks = k1 k2
#source
a3.sources.r1.type = exec
a3.sources.r1.command = tail -F /usr/local/soft/flume-1.9.0/learn/part6/input/info.txt
a3.sources.r1.interceptors = i1 i2
a3.sources.r1.interceptors.i1.type = regex_filter
a3.sources.r1.interceptors.i1.regex = [ERROR]
a3.sources.r1.interceptors.i2.type = host
a3.sources.r1.interceptors.i2.useIP = false
#channel
a3.channels.c1.type = memory
a3.channels.c1.capacity = 1000
a3.channels.c1.transactionCapacity = 100
a3.channels.c2.type = memory
a3.channels.c2.capacity = 1000
a3.channels.c2.transactionCapacity = 100
#sink
a3.sinks.k1.type = avro
a3.sinks.k1.hostname = node1
a3.sinks.k1.port = 12345
a3.sinks.k2.type = logger
#bind
a3.sources.r1.channels = c1 c2
a3.sinks.k1.channel = c1
a3.sinks.k2.channel = c2
```
### · 構建基礎Event 和 RPC Client ###
Event是flume中數據的基本形式,在IDE中添加Flume SDK的Maven依賴,查看Event介面
```
public interface Event {
public Map<String, String> getHeaders();
public void setHeaders(Map<String, String> headers);
public byte[] getBody();
public void setBody(byte[] body);
}
```
Event介面的默認實現有 SimpleEvent 和 JSONEvent,內部結構不盡相同,可以通過EventBuilder類中的靜態方法來快速構建一個Event。
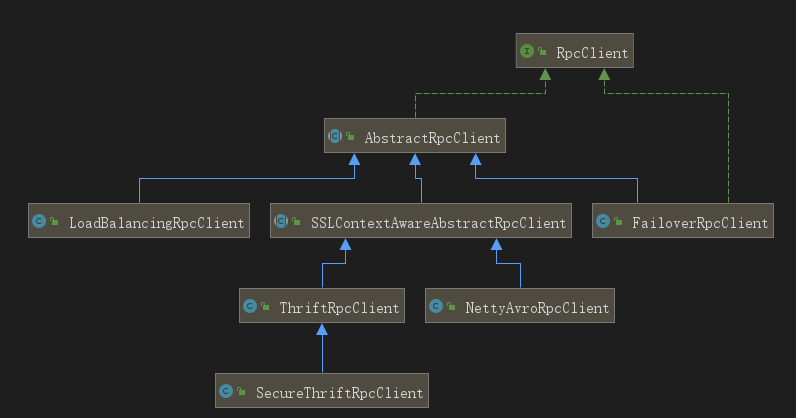
再看RpcClient介面,其中通過append方法來發送一個flume event,也可以通過繼承AbstractRpcClient來實現一個RpcClient。
```
public interface RpcClient {
public int getBatchSize();
public void append(Event event) throws EventDeliveryException;
public void appendBatch(List
public boolean isActive();
public void close() throws FlumeException;
}
```
其實現結構如圖:
那麼嘗試使用最簡單的程式碼向Agent發送一次event
```
public class FlumeClient {
public static void main(String[] args) throws EventDeliveryException {
RpcClient client = RpcClientFactory.getDefaultInstance("master", 12345); client.append(EventBuilder.withBody("hello , 這裡是RPC Client".getBytes())); client.close(); }}
——————————————————————————————————————————————————————————————————————————————
Flume Agent:
2019-9-20 19:37:21,576 (SinkRunner-PollingRunner-DefaultSinkProcessor)
[INFO - org.apache.flume.sink.LoggerSink.process(LoggerSink.java:95)]
Event: { headers:{} body: 68 65 6C 6C 6F 20 2C 20 E8 BF 99 E9 87 8C E6 98 hello , ........ }
```
### · 待補充 ###
規劃、部署、監控Flume
看書ing.....