Redis應用場景及快取問題
1.應用場景
(1) 快取
快取機制幾乎在所有的大型網站都有使用,合理地使用快取不僅可以加快數據的訪問速度,而且能夠有效地降低後端數據源的壓力。Redis 提供了鍵值過期時間設置,並且也提供了靈活控制最大記憶體和記憶體溢出後的淘汰策略。可以這麼說,一個合理的快取設計能夠為一個網站的穩定保駕護航。
(2) 排行榜系統
排行榜系統幾乎存在於所有的網站,例如按照熱度排名的排行榜,按照發布時間的排行榜,按照各種複雜維度計算出的排行榜, Redis 提供了列表和有序集合數據結構,合理地使用這些數據結構可以很方便地構建各種排行榜系統。
(3) 計數器應用
計數器在網站中的作用至關重要,例如影片網站有播放數、電商網站有瀏覽數,為了保證數據的實時性,每一次播放和瀏覽都要做加1 的操作,如果並發量很大對千傳統關係型數據的性能是一種挑戰。Redis 天然支援計數功能而且計數的性能也非常好,可以說是計數器系統的重要選擇。
(4) 社交網路
贊/踩、粉絲、共同好友/喜好、推送、下拉刷新等是社交網站的必備功能,由於社交網站訪問量通常比較大,而且傳統的關係型數據不太適合保存這種類型的數據, Redis 提供的數據結構可以相對比較容易地實現這些功能。
(5) 消息隊列系統
消息隊列系統可以說是一個大型網站的必備基礎組件,因為其具有業務解耦、非實時業務削峰等特性。Redis 提供了發布訂閱功能和阻塞隊列的功能,雖然和專業的消息隊列比還不夠足夠強大,但是對於一般的消息隊列功能基本可以滿足。
2.使用快取的收益和成本
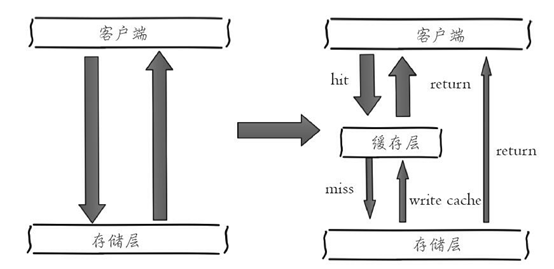
如圖左側為客戶端直接調用存儲層的架構,右側為比較典型的快取層+存儲層架構,下面分析一下快取加入後帶來的收益和成本。
收益:
l 加速讀寫:因為快取通常都是全記憶體的(例如Redis、Memcache),而存儲層通常讀寫性能不夠強悍(例如MySQL),通過快取的使用可以有效地加速讀寫,優化用戶體驗。
l 降低後端負載:幫助後端減少訪問量和複雜計算(例如很複雜的SQL語句),在很大程度降低了後端的負載。
成本:
l 數據不一致性:快取層和存儲層的數據存在著一定時間窗口的不一致性,時間窗口跟更新策略有關。
l 程式碼維護成本:加入快取後,需要同時處理快取層和存儲層的邏輯,增大了開發者維護程式碼的成本。
l 運維成本:以Redis Cluster為例,加入後無形中增加了運維成本。
3. 快取問題
3.1 快取穿透
3.1.1 問題描述
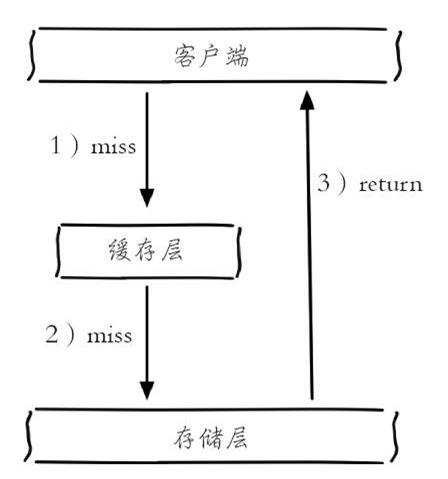
快取穿透是指查詢一個根本不存在的數據,快取層和存儲層都不會命中,通常出於容錯的考慮,如果從存儲層查不到數據則不寫入快取層,如下圖所示
整個過程分為如下3步:
1) 快取層不命中。
2) 存儲層不命中,不將空結果寫回快取。
3) 返回空結果。
快取穿透將導致不存在的數據每次請求都要到存儲層去查詢,失去了快取保護後端存儲的意義。
快取穿透問題可能會使後端存儲負載加大,由於很多後端存儲不具備高並發性,甚至可能造成後端存儲宕掉。通常可以在程式中分別統計總調用數、快取層命中數、存儲層命中數,如果發現大量存儲層空命中,可能就是出現了快取穿透問題。
3.1.2解決方案
造成快取穿透的基本原因有兩個。第一,自身業務程式碼或者數據出現問題,第二,一些惡意攻擊、爬蟲等造成大量空命中。下面我們來看一下如何解決快取穿透問題。
(1) 快取空對象
如圖所示,當第2步存儲層不命中後,仍然將空對象保留到快取層中,之後再訪問這個數據將會從快取中獲取,這樣就保護了後端數據源。
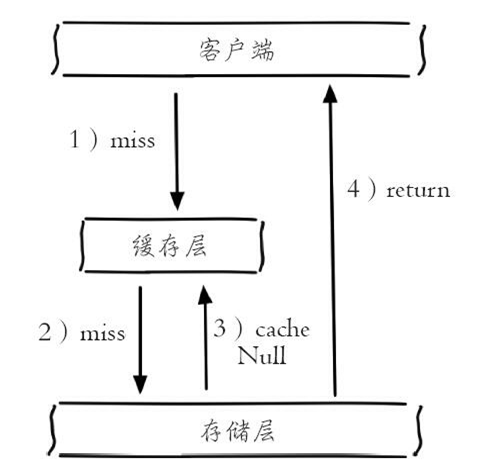
快取空對象會有兩個問題:第一,空值做了快取,意味著快取層中存了更多的鍵,需要更多的記憶體空間,比較有效的方法是針對這類數據設置一個較短的過期時間,讓其自動剔除。第二,快取層和存儲層的數據會有一段時間窗口的不一致,可能會對業務有一定影響。例如過期時間設置為5分鐘,如果此時存儲層添加了這個數據,那此段時間就會出現快取層和存儲層數據的不一致,此時可以利用消息系統或者其他方式清除掉快取層中的空對象。
(2) 布隆過濾器攔截
布隆過濾器:實際上是一個很長的二進位向量和一系列隨機映射函數。布隆過濾器可以用於檢索一個元素是否在一個集合中。它的優點是空間效率和查詢時間都比一般的演算法要好的多,缺點是有一定的誤識別率和刪除困難。可以告訴你某樣東西一定不存在或者可能存在。
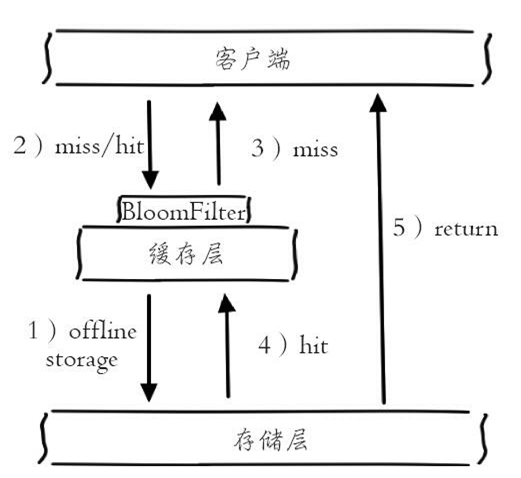
如圖所示,在訪問快取層和存儲層之前,將存在的key用布隆過濾器提前保存起來,做第一層攔截。例如:一個推薦系統有4億個用戶id,每個小時演算法工程師會根據每個用戶之前歷史行為計算出推薦數據放到存儲層中,但是最新的用戶由於沒有歷史行為,就會發生快取穿透的行為,為此可以將所有推薦數據的用戶做成布隆過濾器。如果布隆過濾器認為該用戶id不存在,那麼就不會訪問存儲層,在一定程度保護了存儲層。
(3) 兩種方案比對
|
解決快取穿透 |
適用場景 |
維護成本 |
|
快取空對象 |
l 數據命中不高 l 數據頻繁變化實時性高 |
l 程式碼維護簡單 l 需要過多的快取空間 l 數據不一致 |
|
布隆過濾器 |
l 數據命中不高 l 數據相對固定實時性低 |
l 程式碼維護複雜 l 快取空間佔用少 |
3.2 快取雪崩
如圖描述了什麼是快取雪崩:由於快取層承載著大量請求,有效地保護了存儲層,但是如果快取層由於某些原因不能提供服務,於是所有的請求都會達到存儲層,存儲層的調用量會暴增,造成存儲層也會級聯宕機的情況。
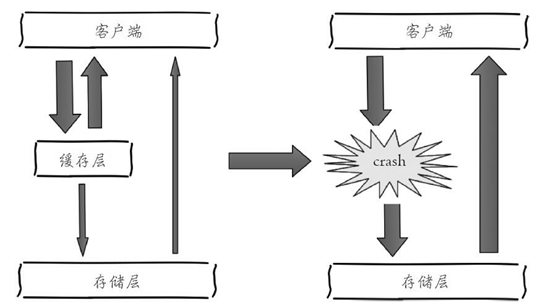
預防和解決快取雪崩問題,可以從以下三個方面進行著手。
(1) 保證快取層服務高可用性。如果快取層設計成高可用的,即使個別節點、個別機器、甚至是機房宕掉,依然可以提供服務,例如前面介紹過的Redis Sentinel和Redis Cluster都實現了高可用。
(2) 依賴隔離組件為後端限流並降級。無論是快取層還是存儲層都會有出錯的概率,可以將它們視同為資源。作為並發量較大的系統,假如有一個資源不可用,可能會造成執行緒全部阻塞在這個資源上,造成整個系統不可用。降級機制在高並發系統中是非常普遍的。實際項目中,我們需要對重要的資源(例如Redis、MySQL、HBase、外部介面)都進行隔離,讓每種資源都單獨運行在自己的執行緒池中,即使個別資源出現了問題,對其他服務沒有影響。但是執行緒池如何管理,比如如何關閉資源池、開啟資源池、資源池閥值管理,這些做起來還是相當複雜的。這裡推薦使用Java依賴隔離工具Hystrix,他是解決依賴隔離的利器。
(3) 提前演練。在項目上線前,演練快取層宕掉後,應用以及後端的負載情況以及可能出現的問題,在此基礎上做一些預案設定。
3.3 快取擊穿(熱點數據集中失效)
3.3.1 問題描述
當一個key是熱點key,並發量很大,而且重建快取不能在短時間完成,在快取失效的一瞬間,就會有大量的執行緒來重建快取,造成後端負載加大,甚至讓應用崩潰,這就叫快取擊穿。如下圖:
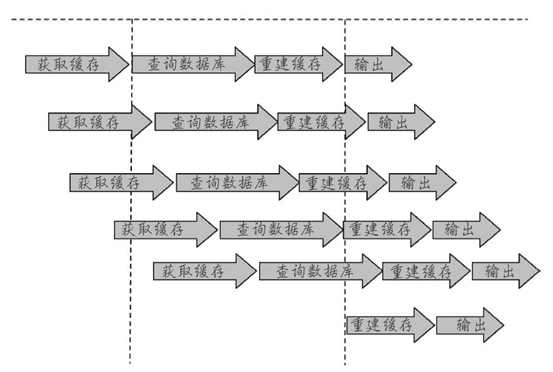
3.3.2 解決方案
(1) 互斥鎖
此方法只允許一個執行緒重建快取,其他執行緒等待重建快取的執行緒執行完,重新從快取獲取數據即可,整個過程如圖所示。
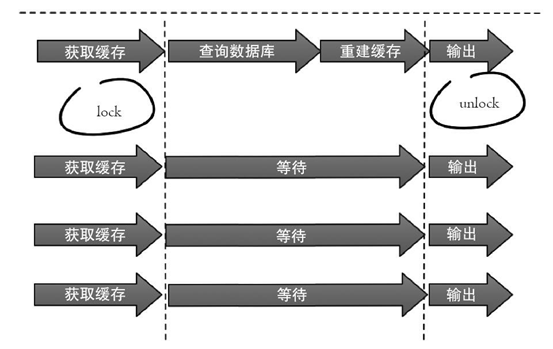
(2) 永遠不過期
「永遠不過期」包含兩層意思:
l 從快取層面來看,確實沒有設置過期時間,所以不會出現熱點key過期後產生的問題,也就是「物理」不過期。
l 從功能層面來看,為每個value設置一個邏輯過期時間,當發現超過邏輯過期時間後,會使用單獨的執行緒去構建快取。
整個過程如圖所示:
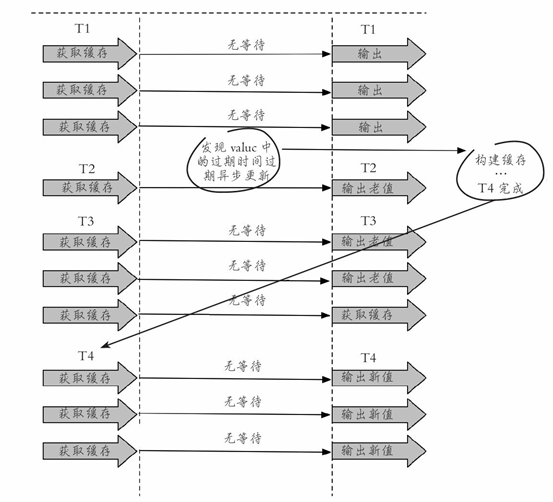
此方法有效杜絕了熱點key產生的問題,但唯一不足的就是重構快取期間,會出現數據不一致的情況,這取決於應用方是否容忍這種不一致。
(3) 兩種方案對比
|
解決方案 |
優點 |
缺點 |
|
互斥鎖 |
l 思路簡單 l 保持一致性 |
l 程式碼複雜度大 l 存在死鎖風險 l 存在執行緒阻塞風險 |
|
永遠不過期 |
基本杜絕熱點key問題 |
l 不保證一致性 l 邏輯過期時間增加程式碼維護成本和記憶體成本 |
