統計學習:樸素貝葉斯模型
模型
生成模型介紹
我們定義樣本空間為\(\mathcal{X} \subseteq \mathbb{R}^n\),輸出空間為\(\mathcal{Y} = \{c_1, c_2, ..., c_K\}\)。\(\textbf{X}\)為輸入空間上的隨機向量,其取值為\(\textbf{x}\),滿足\(\textbf{x} \in \mathcal{X}\);\(Y\)為輸出空間上的隨機變數,設其取值為\(y\),滿足\(y \in \mathcal{Y}\)。我們將容量為\(m\)的訓練樣本表示為:
我們遵循機器學習的一個基本假設,即訓練樣本是從一個未知的總體分布\(P(\textbf{X} = \textbf{x}, Y=y)\)中取樣產生,且訓練樣本獨立同分布。
我們採取概率模型的視角,即將分類模型表示為條件概率分布\(P(Y=y|\textbf{X}=\textbf{x})\)。而依據分布\(P(Y=y|\textbf{X}=\textbf{x})\)的求解可將模型分為判別模型和生成模型。判別模型直接對條件概率分布\(P(Y=y|\textbf{X}=\textbf{x})\)進行參數估計(估計方法可採用極大似然估計或貝葉斯估計);而生成模型則利用條件概率公式\(P(Y=y|\textbf{X}=\textbf{x}) = \frac{P(\textbf{X}=\textbf{x}, Y=y)}{P(\textbf{X}=\textbf{x})}\)來計算分布。分子\(P(\textbf{X}=\textbf{x}, Y=y)\)是一個聯合概率分布,能夠還原出聯合概率分布\(P(\textbf{X}=\textbf{x}, Y=y)\)是生成模型的一大特性。
樸素貝葉斯模型推導
我們對分子繼續運用條件概率公式,進一步得到
這個公式即大名鼎鼎的貝葉斯公式。 這裡我們採用貝葉斯學派的視角,將\(P(Y=y)\)稱為先驗概率分布,表示在數據觀測之前對\(Y\)的信念;\(P(Y = y|\textbf{X}=\textbf{x})\)稱為後驗概率分布,表示經過觀測數據\(\textbf{X}\)(也稱「證據」)校正後對\(Y\)的信念。注意不要和和貝葉斯估計中參數\(\theta\)的先驗和後驗分布搞混了,貝葉斯估計也應用了貝葉斯公式,但先驗概率分布和後驗概率分布的實際含義與這裡完全不同。
我們再將分母運用全概率公式展開,我們得到
這意味著我們只需要學習概率分布\(P(Y=y)\)和\(P(\textbf{X}=\textbf{x}|Y=y)\),而無需關心\(P(\textbf{X}=\textbf{x})\)。
將隨機向量\(\textbf{x}\)沿著其特徵維度展開,我們繼續得到
這裡我們為了簡單起見,假設樣本屬性是離散的,\(x_j\)的屬性集為\(A_j=\{a_1, a_2,..., a_{N_j}\}\),滿足\(x_j \in A_j\)。可以看出,條件概率分布\(P(\textbf{X}=\textbf{x}|Y=y)\)的參數總量是指數級的(\(x_j\)的屬性集\(A_j\)大小為\(N_j\),\(j=1, 2, ..., n\),\(Y\)可取值有\(K\)個,那麼參數個數為\(K \prod_{j=1}^{n}N_j\)),不能對其直接進行參數估計。
因此,我們決定對原本擁有指數級參數數量的分布進行拆分。這裡,樸素貝葉斯法做出了條件獨立性假設:樣本特徵在類確定的條件下條件獨立(這也是「樸素」(Naive)一詞的得名)。這樣我們就能將原本擁有龐大參數的概率分布進行拆分:
這樣,我們就可以對\(P(\textbf{X} | Y=y)\)分布進行高效的參數估計。之後,我們對於輸入樣本\(\textbf{x}\),計算概率分布\(P(Y=y|\textbf{X}=\textbf{x})\):
我們採取後驗概率最大化原則(即最終的輸出分類取使條件概率最大的那個),設\(f(\textbf{x})\)為分類決策函數,即
我們發現,不管\(y\)取何值,式\((7)\)中分母總是恆定的,因此我們可以將式\((7)\)化簡為
這就是樸素貝葉斯模型分類決策函數的最終表達式。
參數估計
極大似然估計
如式\((8)\)中所述,我們需要對先驗概率分布\(P(Y=y)\)和條件概率分布\(P(X_j = x_j|Y=y)\)進行參數估計。根據極大似然估計(具體的推導過程可以參見李航《統計學習方法》中的習題解答),我們可以運用訓練集\(D\)將先驗概率分布\(P(Y=y)\)估計為
同樣,條件概率分布\(P(X_j = x_j|Y=y)\)的估計為
貝葉斯估計(平滑修正)
觀察式\((10)\)可知,如果訓練集中屬性值\(x_j\)和類\(y\)沒有同時出現過,即\(P(X_j=x_j, Y=y)=0\),那麼\(P(X_j = x_j | Y=y)=0\)會直接導致連乘式。這就意味著不管其他屬性如何,哪怕其他屬性明顯符合要求,樣本\(\prod_{j=1}^nP(X_j = x_j | Y=y)=0\) ,\(\textbf{x}\)屬於類\(y\)的概率都會被判為0,這明顯不太合理。
因此,為了避免其他屬性攜帶的資訊被訓練集中未出現的屬性值「抹去」,我們採用貝葉斯估計,等價於在估計概率值時通常進行「平滑」(smoothing)(具體的推導過程可以參見李航《統計學習方法》中的習題解答)。即令式\((10)\)修正為
我們常取\(\lambda=1\),這時稱為拉普拉斯平滑(Laplacian smoothing)。
類似地,式\((9)\)中先驗概率被修正為:
可以看出,拉普拉斯平滑解決了訓練集樣本數不足導致的概率值為 0 的問題。拉普拉斯修正實際上假設了屬性值與類別均勻分布,這是在參數估計的過程中額外引入的關於數據的先驗 (prior)。當樣本容量趨近於無窮時,我們發現修正過程所引入的先驗的影響也趨近於 0,使得計算的概率值趨近於實際的概率值。
演算法
在實際的應用中,樸素貝葉斯模型有兩種訓練方式。
若使用的場景對模型的預測速度要求較高,在給定訓練集\(D\)的情況下,我們將概率分布\(P_\lambda(Y=y)\)和概率分布\(P_{\lambda}(X_j = x_j|Y=y)\)所有可能的取值(\(y\in \mathcal{Y}\),\(x_j \in A_j\),\(A_j\)為樣本屬性取值集合)都計算出來存好,然後在測試樣本\(\textbf{x}^{*}\)來了之後,通過「查表」的方式將對應的概率值檢索出來,然後再對其類別進行判別。這樣,我們計算概率分布\(P_\lambda(Y=y)\)和概率分布\(P_{\lambda}(X_j = x_j|Y=y)\)所有可能取值的過程即對樸素貝葉斯模型進行顯式訓練的過程。訓練演算法如下:
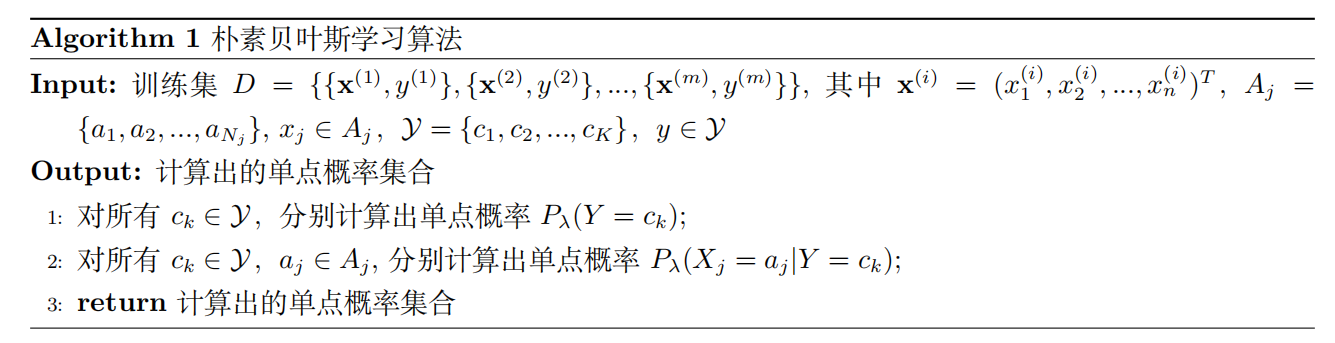
然後,在對給定輸入樣本\(x^{*}\)進行判別時,按照下式進行判別:
如果我們不斷有新的訓練數據產生,可以採用「懶惰學習」(lazy learning)的方法,先不進行任何訓練,測試樣本來了之後再依照測試樣本的屬性\(x_j^{*}\)和當前數據集的狀況來計算單點概率,這樣可以避免對所有可能的屬性都計算單點概率。若訓練數據不斷增加,則可在現有計算結果的基礎上,僅僅對新增樣本的屬性值所涉及的單點概率進行計數修正,這樣可以實現「增量學習」。